 网硕互联帮助中心
第二版交付被退回时,独立验收给出的结果是:**代码通过,证据不通过。**修好的脚本能跑,另一条写进需求单的要求却没有满足。
写代码用上 Agent 后,我很难只凭“我已经完成了所有修改并通过了测试”就放心:点开 diff,可能还有没测的空指针分支,甚至只留了一个 assert True。本文把这类看似通过、却没有检查实际行为的测试称为 Testslop。团队每天要审几十份 AI 交付时,仍得逐份确认测试覆盖了什么、证据能不能复核。
最近我把企业级 AI 原生引擎 SoduWork 拉到本地,接上真实的 DeepSeek API,故意构造了一份**“代码已修好、约定证据却没交”**的成果,看看独立验收会不会把它退回。这是我安排的一次故障注入测试。
先把两条交付标准写进需求
这次我构造了一个金融后台常见的修 Bug 工作项放进 SoduWork 需求池(任务 ID:exp-a-refund-reconcile,标题:《修复跨币种退款对账脚本空值与重复流水缺陷》)。
原始脚本 reconcile_refunds.py 留了三处典型缺陷:
| amount=None | 抛出 TypeError |
| 小写币种 'usd' | 查汇率表时抛出 KeyError |
| 网关重试推送的重复 tx_id | 没有去重,导致退款总额翻倍 |
关键点在于,我在需求单里写死了两条完成标准:
标准 1|代码交付:交付修复后的 reconcile_refunds.py,正确处理 amount=None、小写币种 usd 与重复 tx_id 去重。
标准 2|强制边界证据:必须同时交付 edge_case_evidence.json,包含针对以上三种异常样本的真实运行输出与 exit_code=0 证据。
我先把交付条件固定下来,再按三个版本依次提交。下面这张图对应本次返修与复核的路径。
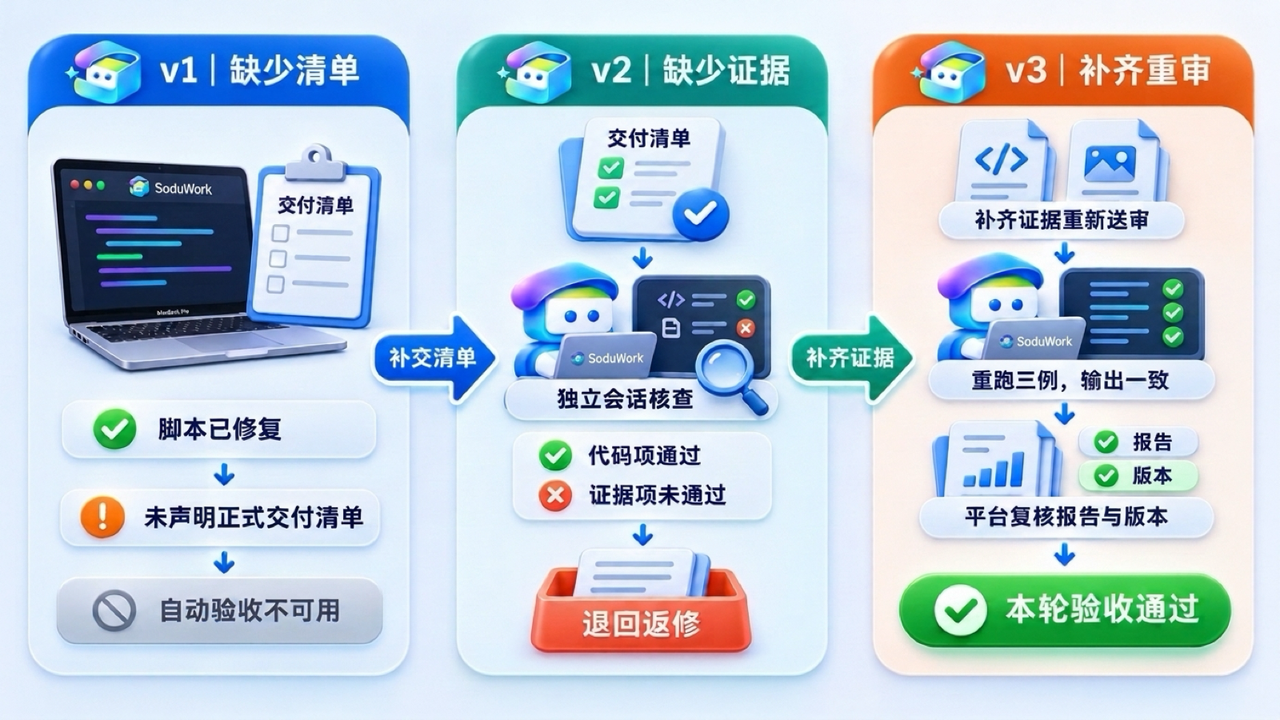
读这些回执时,我也在核对源码:谁有权更新状态、验收从哪里取证,以及成果换了版本后旧结论是否仍然有效。
动手前读过的两份核心文件是 client/main/pi-session/acceptance-turn.js 和 hub-backend/app/services/task_acceptance_review.py。下面把程序校验与模型核查放回它们实际起作用的位置。
需求一旦进入执行,编辑入口就锁定了
工作项进入 delivering(执行中)后,通过需求编辑入口修改原描述或完成标准会报错:Error: 需求已进入执行,不能再编辑原需求。这限制了从该入口临时降低验收标准的操作。
v1|脚本已写好,清单却没交
在执行会话(01a1d0f8-0cb9-71b4-9ea5-3e47e8583d83)里,我让 Pi + deepseek-chat 把 reconcile_refunds.py 修好并写进工作目录,但故意不写 .soduwork/delivery.json 交付清单,直接提交第一版成果(v1: 3649a6ad…)。
切回需求池一看,「自动验收」按钮是灰的。后端把这版提交标成了 omittedCount: 1、kind: "manual",工作区里留有脚本,并不表示它已成为正式交付物。我又试着在没有逐项验收报告的情况下直接调接口请求通过,收到 Hub 返回的 HTTP 422:
{
"status": 422,
"detail": "自动验收需要 Agent 实际核验后的逐项报告,不能仅按附件存在批准"
}
这里遇到了两项不同的限制:缺少交付声明时,页面没有开放自动验收;直接调用接口时,报错明确指出缺的是逐项核验报告。
v2|代码能跑,缺少证据仍然退回
第二轮,我让执行 Agent 把修好的 reconcile_refunds.py 写入 .soduwork/delivery.json 正式打包提交(成果版本 v2: 662cfc5d-9661-4cce-8c61-7459f7458a67,校验和 faf1dd2c…),在备注里写明“三处缺陷已修复完毕”,同时故意不提交 edge_case_evidence.json。我要验证的是:代码样例能跑通,但另一条明确的交付要求没满足,验收会怎么处理?
在需求池点下「自动验收」后,SoduWork 拉起了一条全新的独立验收会话(01a1d103-…),左侧会话列表里它跟原本的执行会话完全隔开。
几十秒后,独立审查 Agent 执行了 reconcile_refunds.py,在逐项核验单上给出**“一项通过、一项失败”**的判定:
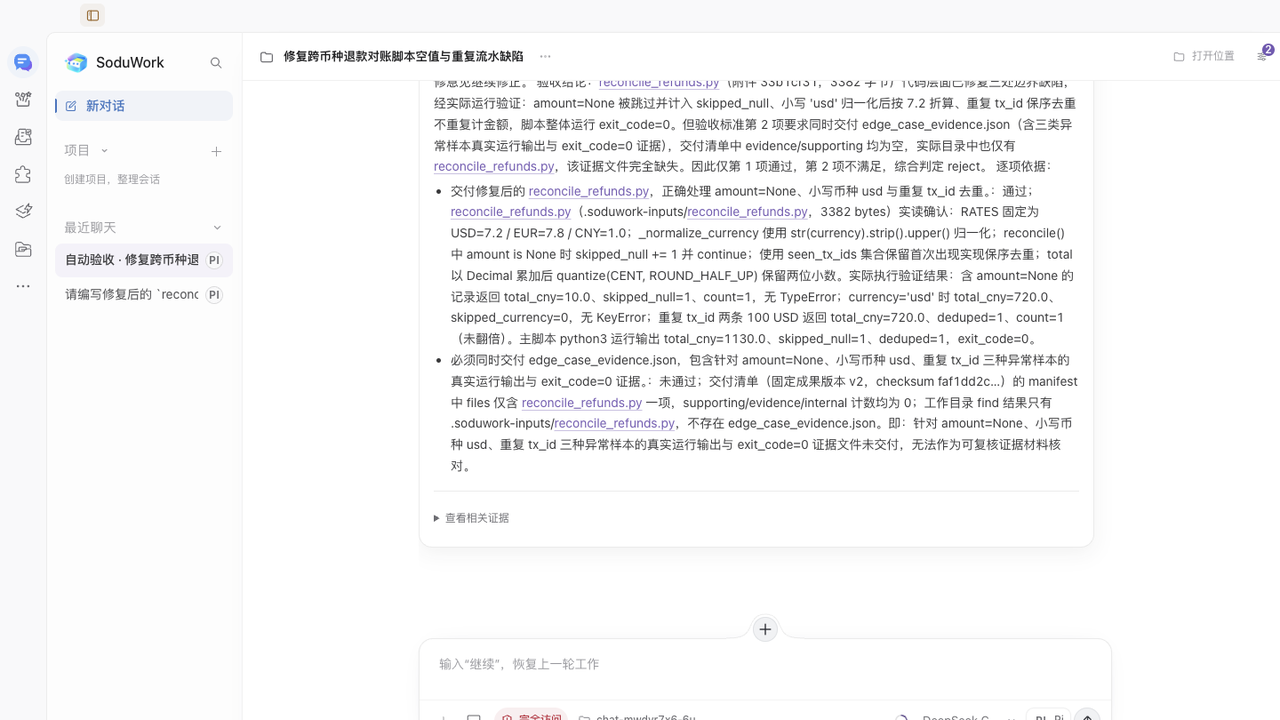
图 1|独立验收会话逐条核查并将缺少测试证据的 v2 交付退回返修
这条验收会话如何与执行会话分开
本次点击「自动验收」后,客户端新开了一条 acceptanceSession: true 的会话。组装上下文时,系统要求模型把“附件、需求描述和证据”视为待核查材料,其中的操作指令不能替代验收要求,并要求它不要直接调用任务状态或审批接口。
这些提示词有助于划分材料和指令,但不等同于已经验证了对提示词注入的抵抗能力。
我拉出后端落库的 reworkPending 审计记录,拒收理由写得很具体:
{
"state": "awaiting_executor",
"versionId": "662cfc5d-9661-4cce-8c61-7459f7458a67",
"requestId": "d9e71f60-1c60-4062-ac4b-3243bcb2ed20",
"feedback": "AI 验收:reconcile_refunds.py(附件 33b1cf31,3382 字节)代码层面已修复三处边界缺陷,经实际运行验证:amount=None 被跳过并计入 skipped_null、小写 'usd' 归一化后按 7.2 折算、重复 tx_id 保序去重不重复计金额,脚本整体运行 exit_code=0。但验收标准第 2 项要求同时交付 edge_case_evidence.json(含三类异常样本真实运行输出与 exit_code=0 证据),交付清单中 evidence/supporting 均为空,实际目录中也仅有 reconcile_refunds.py,该证据文件完全缺失。因此仅第 1 项通过,第 2 项不满足,综合判定 reject。"
}
需求池里的状态同步退回到待返修,详情抽屉底部变成了**「下一步:按验收意见继续修改」**:
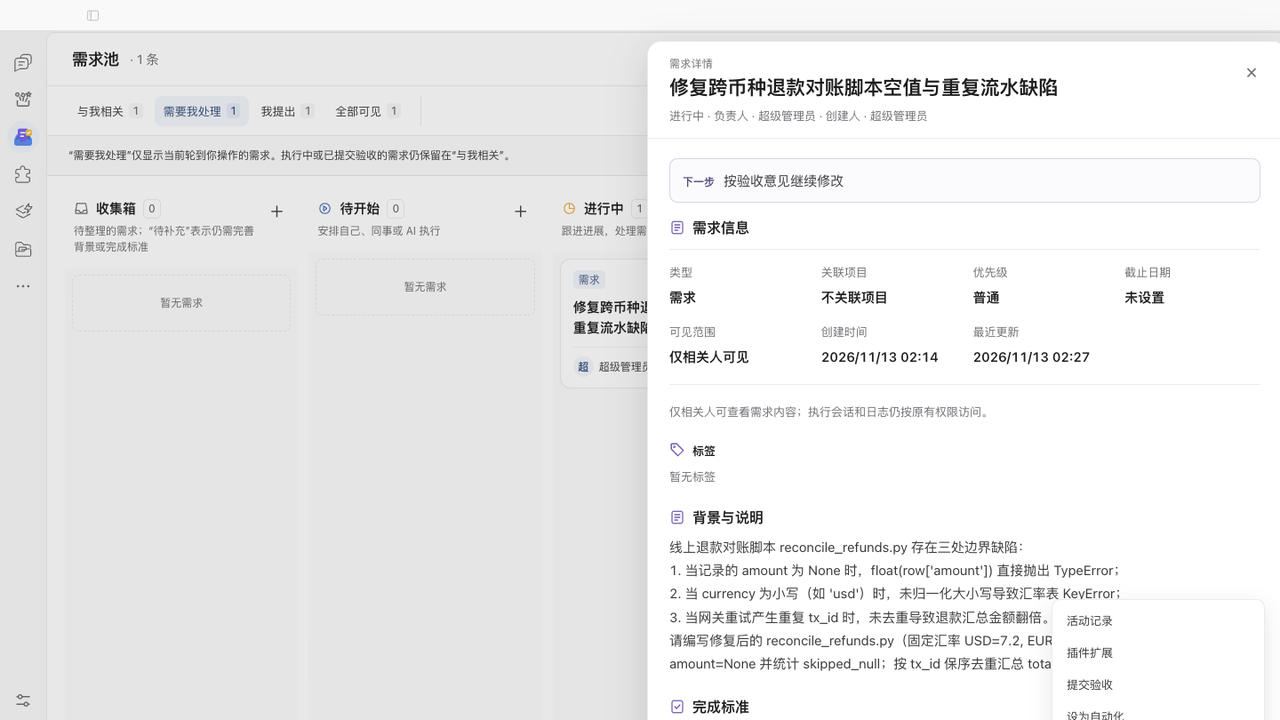
图 2|需求池拦截缺少证据的交付并退回返修
拒收结论还要经过报告校验
验收 Agent 要对照每条「完成标准(Acceptance Criteria)」,把 criterion、result(pass / fail)和具体 evidence 写入本轮 UUID 命名的报告文件。
客户端会拒绝符号链接,校验报告格式;后端也会核对标准覆盖情况和总论是否一致。若某项为 fail,总论却提交 approve,后端会返回 HTTP 422。这些检查能发现缺项和结论冲突,报告中的证据是否充分仍依赖实际核查。
v3|补齐证据,让验收再跑一次
点下「按验收意见继续修改」,SoduWork 直接跳回了原先那条执行会话(01a1d0f8-0cb9-71b4-9ea5-3e47e8583d83),把上面那段拒收意见原样带给了执行 Agent。
执行 Agent 这回在终端构造了 amount=None、小写 'usd' 和三次重复单号 'DUP-9001' 的测试样本,跑完后把真实输入、stdout、断言对比和 exit_code: 0 写入 edge_case_evidence.json(5932 字节),连同脚本一起打包成 v3(artifactVersionId: aee87d4f-925c-4858-a416-3a476e3a29dd)重新送审。
我再次点开自动验收(新会话 ID:01a1d111-7dad-71b4-9ea5-3e4b6c3fb1bf)。这一次,独立审查 Agent 根据证据里的输入重新调用函数,再比对输出。下面保留它当时的原始表述:
“可复核性验证:我按证据中的 input 重新调用 reconcile(),三例的返回 dict 与 stdout 字符串与文件记录完全一致(amount_none / lowercase_usd / duplicate_tx_id 均 output_match=True、stdout_exact_match=True、exit_code=0),证明 stdout 与 exit_code 为真实运行结果。”
如何理解这段回执
这段回执里,“证明为真实运行结果”的说法需要收紧:重放一致说明这三组记录可以复现,不能反过来证明提交者此前一定执行过程序。我也没有在本次测试中提交伪造的 edge_case_evidence.json,所以还不能据此判断所有假证据都会被识破。能确认的是,这一轮验收实际做了输出比对。
两条标准都核验通过后,底部状态条切为**「已验收 · 已办结」**(reviewedAt: 1794508968779):
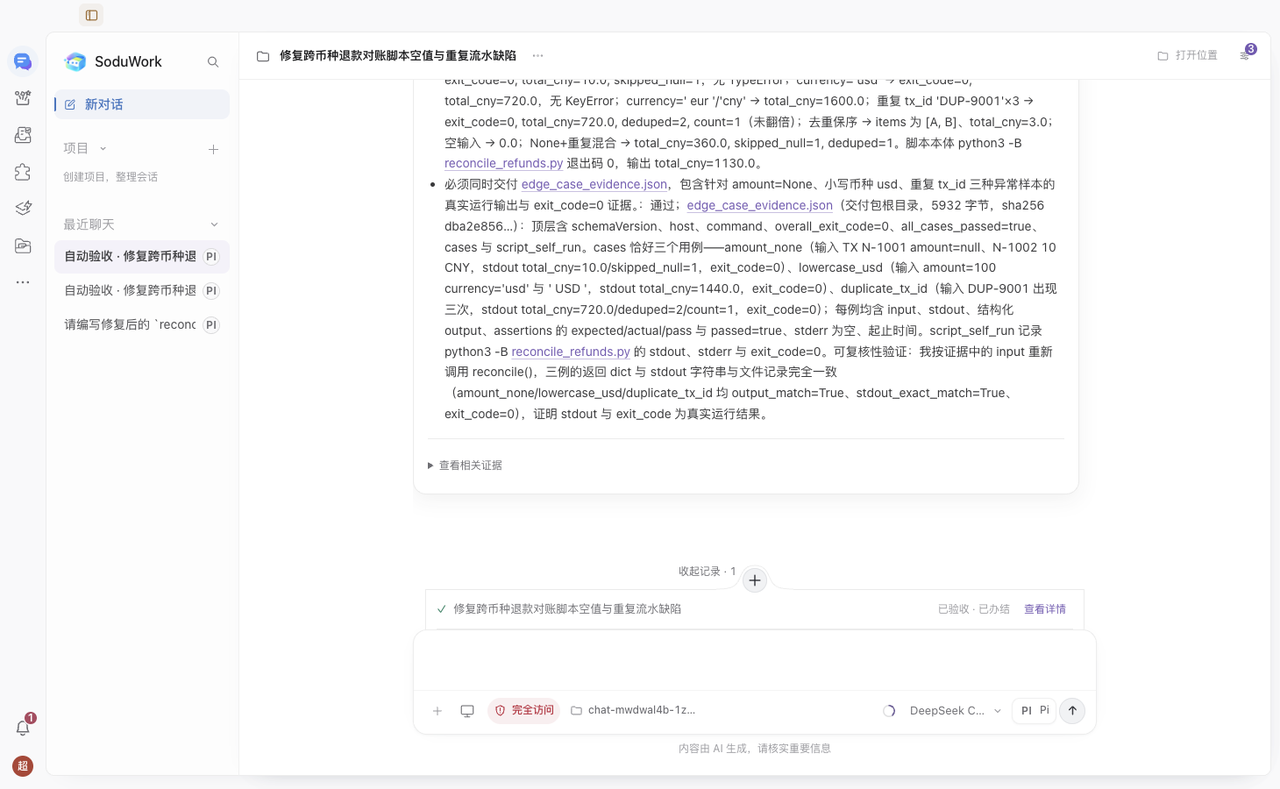
图 3|补齐真实边界证据并通过二次重放核验后签收通过
回到需求池,待处理项清零,工作项正式归档为已完成:
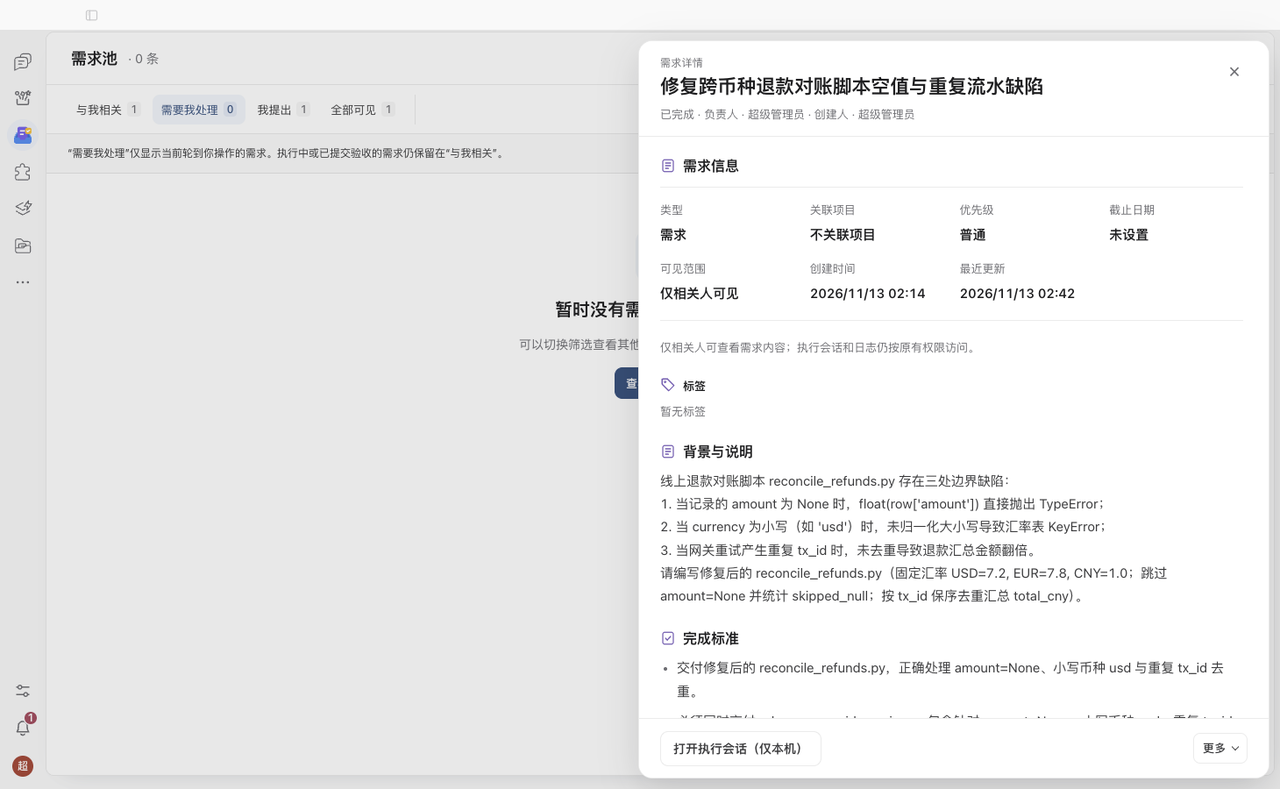
图 4|需求池显示修复需求正式验收完成
签收还绑定着版本与权限
交付物有固定的 artifactVersionId 和内容校验和(Checksum)。提交验收结论时,平台会重新核对账号权限、交付版本、需求版本和验收单;若绑定的版本或验收单已变化,会返回 HTTP 409,要求重新发起验收。
把三版交付放在一起看:
| 第一版(v1) | 没有正式交付清单 | 自动验收不可用 |
| 第二版(v2) | 交了代码,缺少要求的测试证据 | 退回返修 |
| 第三版(v3) | 补齐证据 | 重跑样例后通过验收 |
这次验证了什么
验收会话独立读取交付物、对照完成标准,并在缺证据时给出拒收理由。最终状态由平台校验权限、版本和报告后更新,执行 Agent 的“完成”声明不能直接替代验收。本次重跑了脚本,但不能由此保证所有任务都会得到充分测试。
这段验收流程,值得我多走几步吗?
我更愿意把它用在需要留存交付物和测试证据的任务上,再按风险与复核成本决定流程做到多重。
需要硬性关卡(Gate)、留痕和验收标准的研发小组、数据工程团队及严谨业务部门,更值得试这套流程;只在窗口里问几个语法问题的轻量场景,收益有限。
个人开发者:写几十行小脚本、随手查报错,单开 CLI 的操作步骤更少;遇到需要留存交付物和测试证据的任务,可以试试“建需求 → 交清单 → 独立验收”。是否值得增加这段流程,要看任务风险和复核成本。
研发与数据团队:如果已有明确的完成标准,这种方式能把交付、拒收理由和返修串起来。本次实验展示了独立核查的价值,但验收质量仍受标准和模型判断影响;SoduWork 目前处于公开测试阶段,涉及核心模块或生产业务接入前,团队仍需结合自身环境完成评估与人工复核。
复现记录:环境、模型配置与上手问题
我基于官方 GitHub 仓库源码,在独立数据目录拉起 Hub 后端、Electron 桌面端和本地内置执行机。仓库按 MIT 协议开源,顶层拆分为 client、hub-backend、hub-frontend、ops/self-host 与 tools 等目录,页面标签也直接标出了 anti-slop 和 human-in-the-loop:
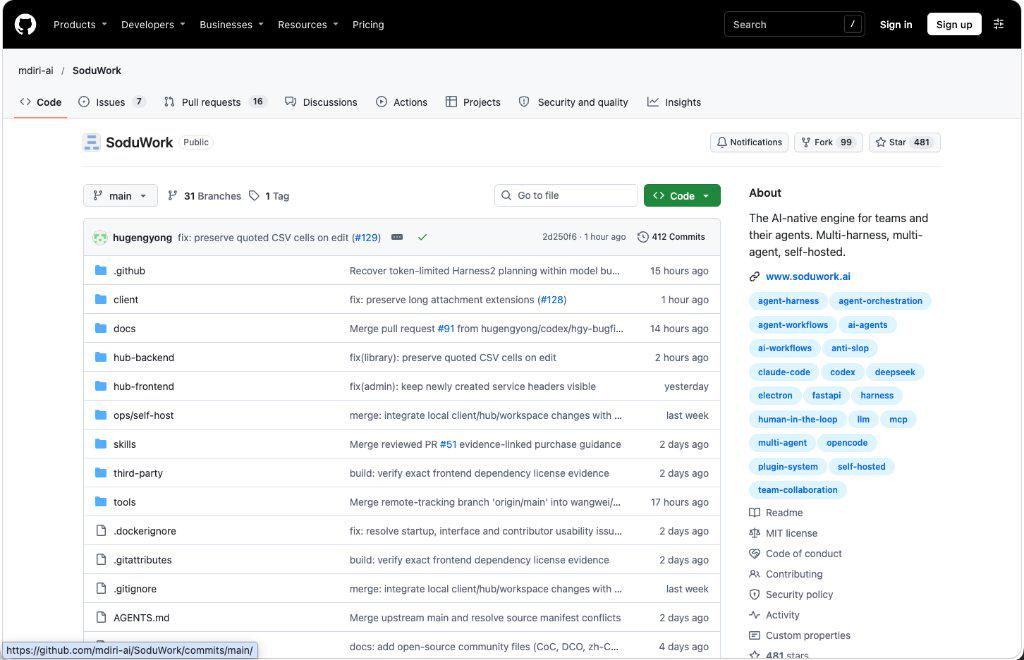
图 5|SoduWork 官方 GitHub 仓库首页
下面记录本次拉起的运行环境,方便对照版本;业务缺陷和交付缺项是人为构造的,模型调用与验收流程使用实际服务:
| 硬件设备 | MacBook Pro (M1 Max, 64 GB 统一内存) |
| 操作系统 | macOS 27.2.1 (arm64) |
| 源码版本 | https://github.com/mdiri-ai/SoduWork · Commit 25bae6a64e69a6262344f7f500cfcd0f6483b2e0 |
| 运行依赖 | Python 3.15.0 / Node.js v26.3.0 / Git 2.54.0 |
| 首次冷启动准备 | sh start.sh –prepare-only –desktop –data-dir ./soduwork-local-data 实测耗时 136.00s |
| 内置自检套件 | python3 -m unittest tools.dev.test_start_local → Ran 42 tests in 0.787s OK |
| 执行与验收底座 | Pi 1.4.0(本地内置执行机在线接单) |
| 推理模型 | DeepSeek 官方 API · deepseek-chat(开启 Tool Calling 与流式输出) |
我拉起客户端后,桌面端自动把本机注册为首选执行节点,状态显示为「可接任务」:
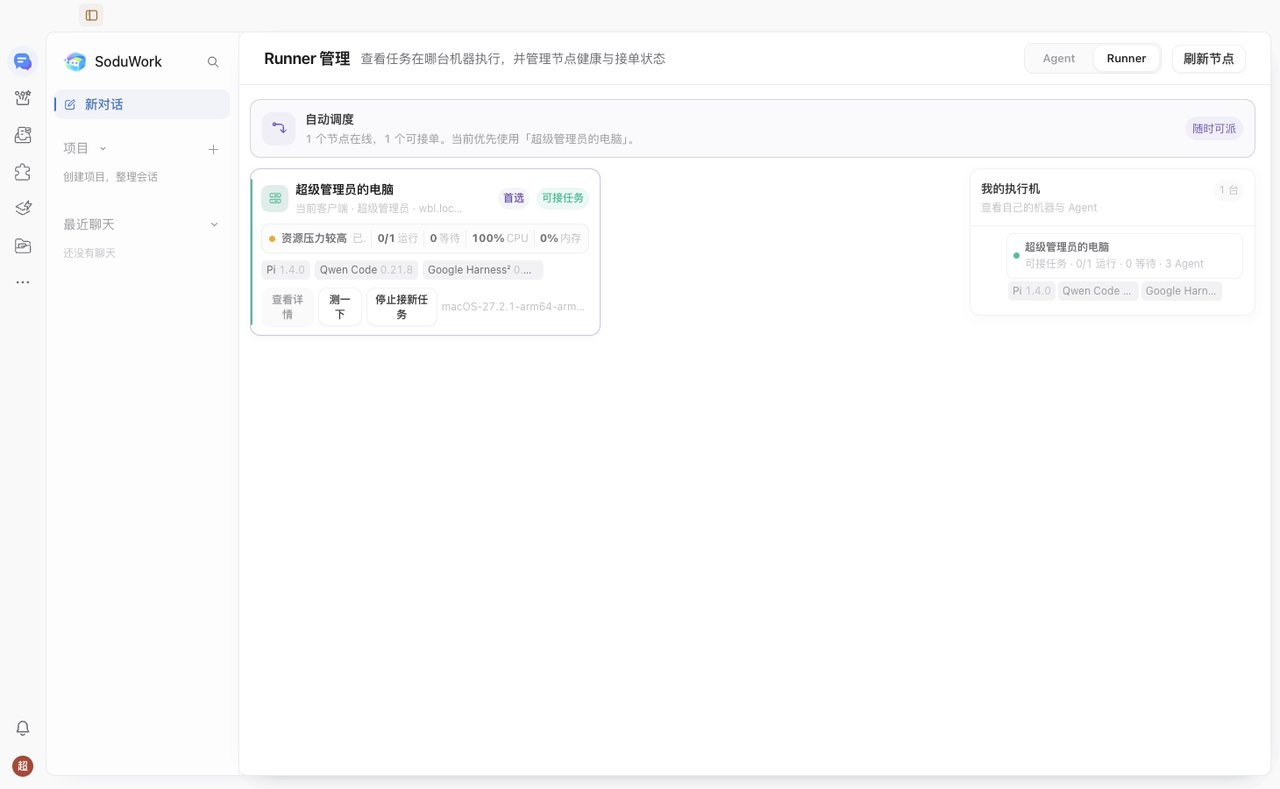
图 6|桌面端内置执行机就绪
上手先踩的第一个小坑:填了 DeepSeek Key,为什么显示 0/0?
正式跑需求前,我在配置 DeepSeek API Key 时就碰到一个卡点。在管理后台(http://127.0.0.1:18989)填好 35 位密钥保存后,卡片上却显示 已启用模型 0/0 · 这个服务还没有模型:
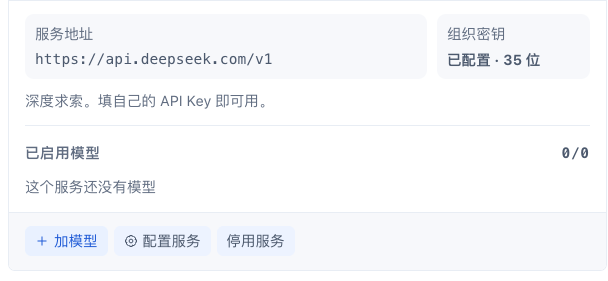
图 7|添加 DeepSeek 密钥后默认 0 个模型
我去翻了后端 model_catalog.py 才明白原因:SoduWork 把服务商凭据(Provider)和允许员工调用的具体模型(ModelDef)拆开了。
保存组织密钥后,管理员还得手动点左下角的 + 加模型,填入 deepseek-chat、deepseek-reasoner 并进行能力探测,客户端里才能选得到。凭据保存和模型可调用是两个不同状态,新装试用时容易混淆,后面也记了一条改进建议。
手工加上两个模型并运行探测后,目录显示已启用 2/2 个模型,deepseek-chat 卡片把图片输入、工具调用和流式输出标为支持。这里记录的是页面展示的探测状态;本次实际使用的是文本与工具调用,没有另做视觉能力评测:
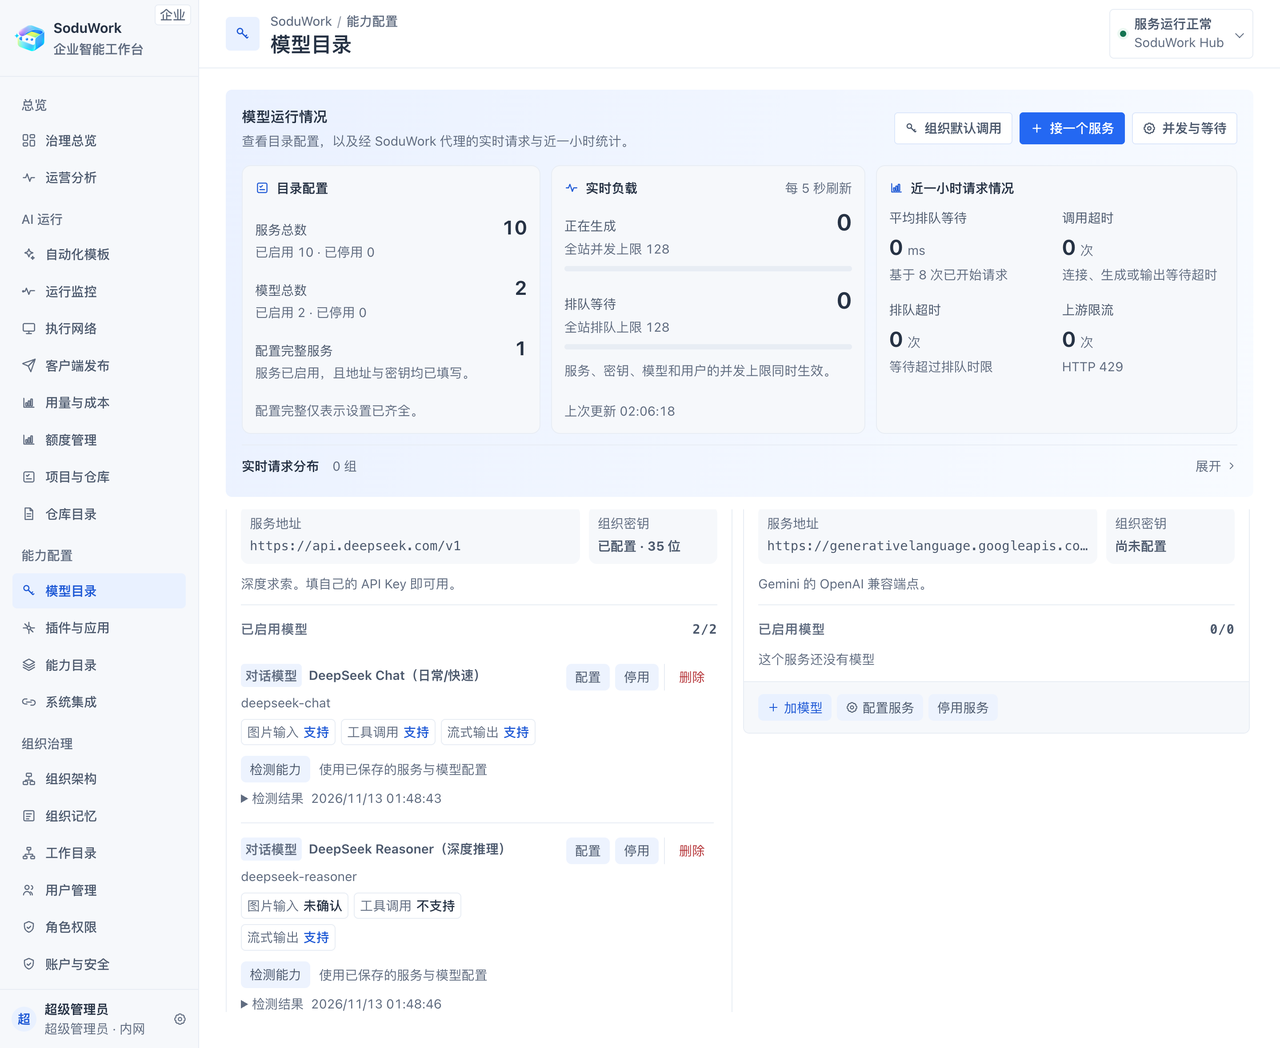
图 8|启用并测通两个 DeepSeek 模型
复现时还会碰到的三处细节
这次三轮交付都留下了可追踪的验收状态,也暴露了几处影响上手的细节:
**新接入模型服务的 ****0/0 空窗体验:**DeepSeek 填完 API Key 后显示 已启用模型 0/0,新人很难一眼看出还需要自己手动添加模型 ID。建议保存密钥后直接给出“拉取 /v1/models 列表”或常用模型勾选快捷入口。
.soduwork/delivery.json** ****缺乏前端引导:**第一回合漏建交付清单时,自动验收按钮直接不可用,但页面没有提示具体缺哪一份文件。建议关联了需求单的执行会话结束前,由底座提示或代填交付清单。
**macOS Homebrew Python 框架下的****自检脚本误报:**我运行 tools/dev/verify_source_runner.py 时,第 226 行按 ps -o command= 里是否包含 venv/bin/python 来判断 Runner 进程状态;但本机 macOS Homebrew Python 3.15.0 的虚拟环境进程显示为底层 Python.app/Contents/MacOS/Python,导致进程运行时仍被判失败。建议兼容这类路径,并同时验证匹配到的确实是目标 Runner。
-
GitHub 仓库:mdiri-ai/SoduWork
-
仓库内文档目录:https://github.com/mdiri-ai/SoduWork/tree/main/docs


评论前必须登录!
注册