 网硕互联帮助中心
日志汇总时,同一个事件标识出现两份记录,错误码却不同。若程序按标识直接构造字典,前一份会被后一份覆盖。分类器随后只看到一个错误码,看似没有冲突,实际上是冲突证据已经丢失。
给模型补错误类别依据之前,先检查整理阶段有没有替它作了一个没有根据的选择。
用调换顺序暴露覆盖行为
构造四条记录:事件N的码为0,表示本文约定的正常;事件M的码缺失;事件C有两份副本,分别为E1和E2。
本次先按原顺序构造“事件标识到错误码”的字典,再把输入逆序处理。原顺序留下E2,逆序留下E1。两次都有合法字典,却留下不同的分类输入。
latest = {row["event"]: row["code"] for row in rows}
Python官方字典文档说明,重复出现的键会由后面的对应值覆盖。本例实际验证的正是这种行为,不是某个模型自行判断了来源优先级。
输入标识与码值均为合成材料,没有访问真实日志或调用模型。
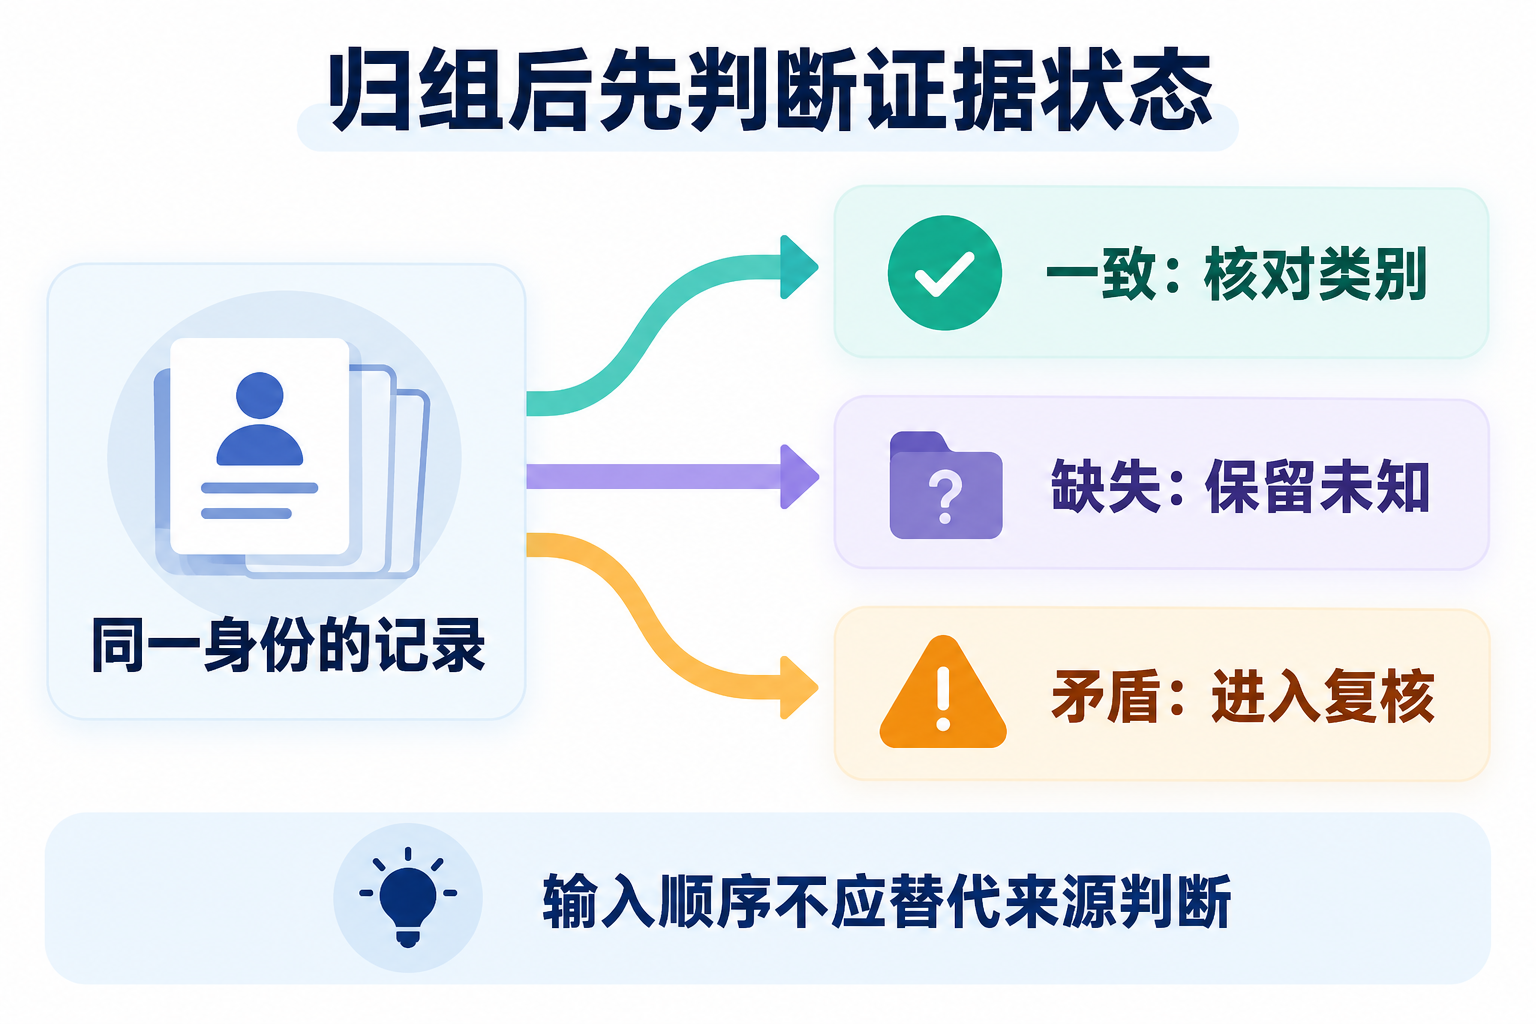
先保留同一身份下的不同取值
本次另用归组方式,保留同一事件出现过的码值集合,再分别判断正常、缺失、单一码和冲突。
实际检查中,N保持正常,M保持缺失,C保持冲突;输入逆序后这些状态完全相同。这里的顺序不变性,只对应本例的证据状态判断,不代表所有事件处理都不该考虑时间。
如果记录本来是不同时间的状态更新,后一个值可能有明确意义。那就需要时间、版本和事件模型的约定,而不是单凭列表靠后的位置认定它更权威。
归组也有前提:身份必须确实相同
本文预先声明C是同一个构造事件的两份副本。真实系统中,不同设备、不同启动批次可能复用同一个短标识,直接归组也可能把两件事误报成冲突。
因此要先确认事件身份包含哪些范围,再谈同一身份内的证据。若身份尚无法对应,就保留对应关系待确认,不能为得到完整分类而强行合并。
本次没有验证真实事件去重、跨设备身份或时间排序。这些限制不能因为集合检查通过而省略。
冲突状态不是一个错误类别
E1和E2矛盾,表示目前依据不足以在两者间裁决,不等于设备发生了“冲突故障”。产品应把证据状态与故障类别分开,让使用者知道需要核对哪两份原始记录。
如果来源有明确优先级或更正规则,可以按经过确认的规则处理,但仍应保留原始材料与采用理由。本文没有定义这种优先级,也不凭出现次数较多就选择一个码。
缺失码同样不应默认成正常。本文把None单独保留;示例只覆盖纯缺失组,没有覆盖某组同时含缺失与具体码的全部业务含义,不能把简化状态函数直接当作生产分类器。
集合只能帮助发现差异
集合会合并相同取值,丢掉副本数量与来源顺序。若需要判断重复上报或来源可靠性,还必须保留原记录。本文中的集合用于差异检查,没有替代日志存档。
正常码0也只是本例约定,不能推广到所有设备协议。真实类别映射需对应正确版本与来源,不能凭常见习惯填表。
验收可以先确认整理阶段不会静默覆盖矛盾,再检查类别映射是否有依据,以及未知情况能否退回原文。本文完成正逆序覆盖反例和归组状态检查,没有测模型分类准确率、用户复核时间或生产收益。
让后一条记录覆盖前一条,是容器行为;让某份证据决定类别,是业务判断。把这两件事分开,才不会由输入顺序悄悄裁决一次诊断。


评论前必须登录!
注册