 网硕互联帮助中心
日志读取器通常会保留尚未遇到换行的片段,等待下一批字节补齐。但轮转之后,下一批字节可能来自新文件。如果残留缓冲没有来源身份,就可能把两份不同文件拼成一条新记录。
更麻烦的是,这条记录有时能够顺利解析,语法检查也发现不了来源错误。
用两份自有片段演示
本次在macOS上创建自有临时app.log,内容只有一段未完成JSON:
{"event":"old","status":"
读取并保留片段后,将文件重命名为app.log.old,再创建新的app.log,内容为:
ok"}
实际检查确认新旧文件的设备号与inode组合不同。两段各自交给json.loads,都触发JSONDecodeError;直接跨文件连接后,却解析成event为old、status为ok的对象。
这条完整对象没有出现在任何一份原文件里。它来自错误的跨来源拼接,不能被当作真实事件交给诊断摘要。
语法合法,不会替你核对来源
Python官方json文档描述JSON编码和解码接口。解析器处理收到的内容,并不知道这些字节来自同一个文件,还是应用刚拼在一起的两份材料。
所以不能只用“能够解析”验收轮转读取。还要核对这条记录的全部片段是否属于约定的同一输入范围。
本文的例子是人为构造,未声称真实日志曾出现这种事件。没有启动轮转守护进程、真实日志写入器或模型。
缓冲状态要带着来源走
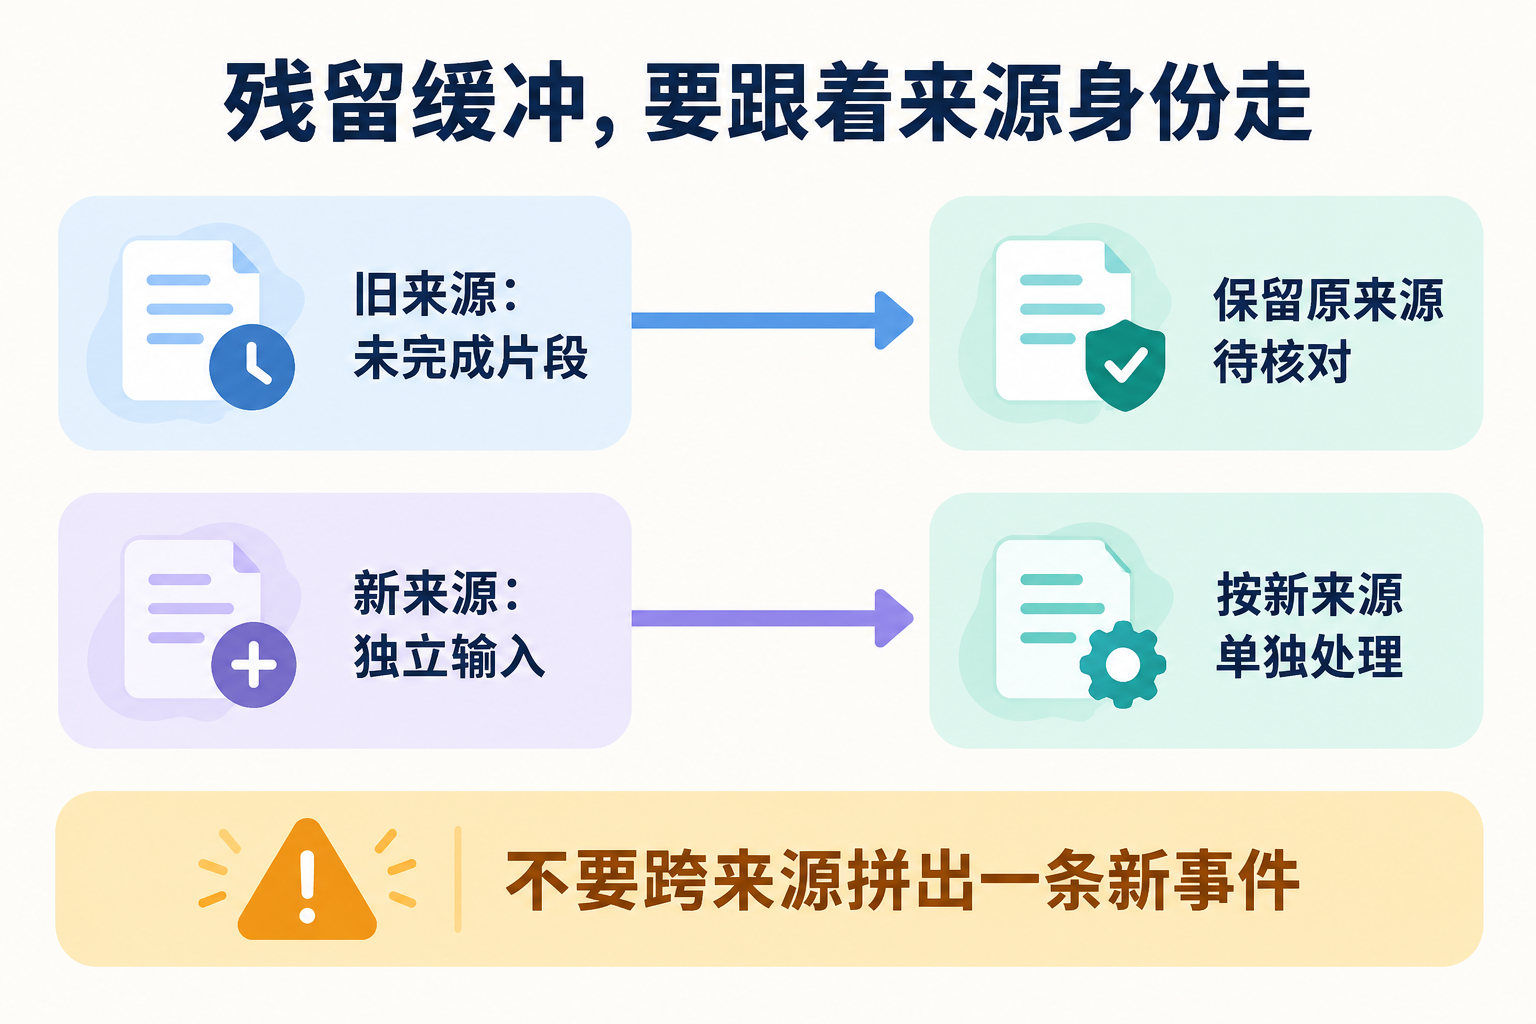
当来源切换时,旧的未完成片段可以按产品规则保留为待核对材料;新来源则建立自己的输入状态。不能因为两个文件使用过同一个路径名,就默认它们的内容连续。
本次演示把旧未完成片段和新不匹配片段分别保留,输出事件数为0。它没有实现生产读取器,只验证两份片段不应成为本文那条完整事件。
真实系统如果明确采用跨文件分段格式,需要有相应协议与来源关联证据。本文没有这类协议,因此不作跨文件补齐。
记录身份也需要范围
本次设备号与inode只用于受控临时文件身份对比。它们不是永久全局标识,不能单独覆盖长期复用、跨设备或所有文件系统情形。重启恢复还需要按实际设计记录偏移、来源与观察范围。
偏移也不能脱离缓冲讨论:如果检查点只记已经读取多少字节,却丢了未完成片段,恢复后可能漏内容;若把旧片段套到新文件,又可能制造内容。
本文没有实现检查点持久化、重复运行恢复或任意中断后的去重,不把单次片段实验写成完整轮转方案。
未完成片段不应被悄悄修成事实
看到缺少引号或换行,应用或AI可能尝试补齐。这样的内容可以作为明确标注的修复建议,但不能冒充原始记录。尤其当新文件片段恰好能补成合法对象时,更要保留它来自哪里。
如果需要展示未完成内容,应让使用者知道其状态,不把缺失字段填成确定诊断。本次没有自动修复,也没有输出恢复状态结论。
验收材料除了完整行,还应包含文件末尾半行、来源切换、片段无法匹配等情况,并检查输出是否能退回对应原文。本文实际完成自有文件重命名、新文件创建、身份差异与JSON拼接反例,没有强杀或生产服务测试。
轮转改变的不只是路径上的文件。残留缓冲如果没有跟着来源身份走,读取器就可能替日志作者写出一条从未存在的事件。


评论前必须登录!
注册