 网硕互联帮助中心
文章目录
-
- 1. 先把问题讲清楚:为什么“能推理”不等于“能训练”
- 2. 训练显存账本:到底哪些东西占显存
- 3. 普通数据并行为什么浪费
- 4. ZeRO-1:先切优化器状态
- 5. ZeRO-2:优化器状态和梯度都切
- 6. ZeRO-3:连参数也切
- 7. 用代码估算 ZeRO 阶段的参数状态节省
- 8. DeepSpeed 配置怎么读
- 9. ZeRO-3 配置和几个关键开关
- 10. Offload:把状态放到 CPU 或 NVMe
- 11. 如何选择 ZeRO 阶段
- 12. 常见问题排查
- 13. 常见误区
- 14. 小结
- 大模型视角
- 下一篇
摘要:大模型训练显存贵,不只是因为模型参数多,还因为训练时要保存梯度、优化器状态、激活值和通信缓冲区。普通数据并行会让每张 GPU 都保存一份完整训练状态,显存浪费严重。DeepSpeed ZeRO 的核心思想是把这些训练状态分片到多张 GPU 上:ZeRO-1 切优化器状态,ZeRO-2 再切梯度,ZeRO-3 连参数也切。本文会从显存账本开始讲清 ZeRO 为什么有效、每个阶段省什么、代价是什么,并给出可读的配置示例和排查清单。
- 前置知识:专栏一分布式训练、 AdamW、混合精度;专栏二预训练流程
- 阅读时间:50-65 分钟
- 代码环境:Python 3.10+,示例只依赖标准库;配置示例使用 JSON
- 读完目标:能估算训练显存的主要组成,能解释 ZeRO-1/2/3 的差别,能根据模型规模和硬件选择 ZeRO 阶段
1. 先把问题讲清楚:为什么“能推理”不等于“能训练”
很多开发者第一次接触大模型训练时,会这样估算:7B 模型用 BF16 权重存储,每个参数 2 字节,所以权重大约 14GB。那一张 24GB 或 48GB 的卡是不是就能训练? 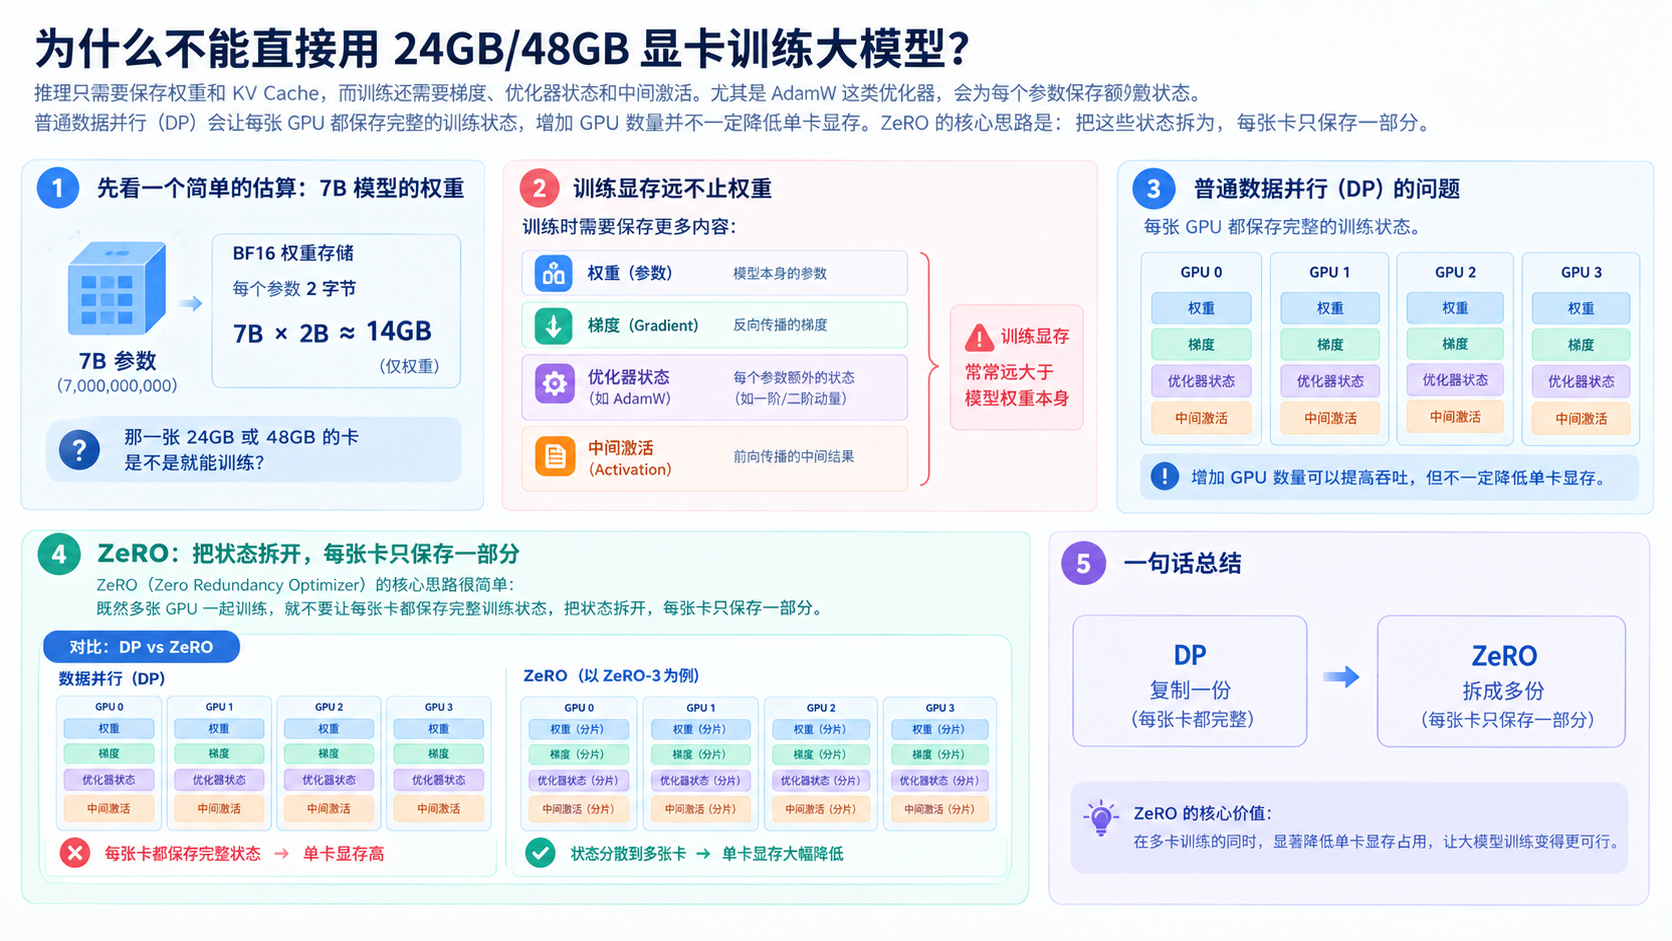
通常不能。因为推理主要保存权重和 KV Cache,而训练还要保存梯度、优化器状态和前向传播中间激活。尤其是 AdamW 这类优化器,会为每个参数保存额外状态。训练显存常常远大于模型权重本身。
普通数据并行(Data Parallel, DP)还有一个问题:每张 GPU 都保存完整模型、完整梯度和完整优化器状态。增加 GPU 数量可以提高吞吐,但不一定降低单卡显存。
ZeRO(Zero Redundancy Optimizer)要解决的就是这个“重复存储”问题。它的核心思路很朴素:既然多张 GPU 一起训练,就不要让每张卡都保存完整训练状态,把状态拆开,每张卡只保存一部分。
2. 训练显存账本:到底哪些东西占显存
先把训练时的显存拆开。以混合精度 AdamW 为例,参数相关状态常见包括:
| 模型参数 | 前向和反向计算 | BF16/FP16 约 2 bytes |
| 梯度 | 反向传播得到的更新方向 | BF16/FP16 约 2 bytes |
| FP32 master weights | 优化器更稳定地更新参数,视方案而定 | 4 bytes |
| Adam 一阶动量 m | 梯度滑动平均 | 4 bytes |
| Adam 二阶动量 v | 梯度平方滑动平均 | 4 bytes |
粗略相加,每个参数可能需要 12 到 16 字节的参数相关训练状态。还没算激活值、临时张量、通信 buffer 和框架开销。
下面写一个估算器。它不是精确容量规划工具,只用于建立直觉:
# Python 3.10+
def param_state_memory_gb(params_billion, master_weights=True):
params = params_billion * 1_000_000_000
bytes_per_param = 2 # bf16/fp16 params
bytes_per_param += 2 # gradients
bytes_per_param += 4 # Adam m
bytes_per_param += 4 # Adam v
if master_weights:
bytes_per_param += 4
return params * bytes_per_param / 1024**3
for n in [1, 7, 13, 70]:
print(f"{n:>2}B params -> param states ≈ {param_state_memory_gb(n):.1f} GB")
运行后你会发现,7B 模型的参数相关训练状态就可能接近百 GB 级别。单卡放不下,就需要分布式训练和状态切分。
激活值也很重要。序列长度越长、micro batch 越大、层数越深,激活值越大。梯度检查点(activation checkpointing)可以通过重新计算部分前向结果来节省激活显存,但会增加计算时间。
所以训练显存可以粗略看成:
训练显存 = 参数相关状态 + 激活值 + 通信 buffer + 临时张量 + 框架开销
ZeRO 主要优化参数相关状态。激活值还要靠 micro batch、seq_len、activation checkpointing、FlashAttention 等手段配合。
3. 普通数据并行为什么浪费
普通数据并行的流程是:每张 GPU 都有一份完整模型,处理不同 batch,反向传播后同步梯度,再各自更新参数。
可以想象 4 张 GPU:
GPU0: 参数 W + 梯度 G + Adam状态 O
GPU1: 参数 W + 梯度 G + Adam状态 O
GPU2: 参数 W + 梯度 G + Adam状态 O
GPU3: 参数 W + 梯度 G + Adam状态 O
这里的 W、G、O 在每张卡上都是完整副本。计算上它们处理不同数据,显存上却重复保存同样状态。
普通数据并行的优点是简单、吞吐高、通信模式成熟;缺点是单卡显存压力不会因为 GPU 数量增加而明显下降。对于大模型训练,优化器状态和梯度副本会成为主要瓶颈。
ZeRO 的名字里有 “Zero Redundancy”,意思就是尽量消除这些冗余副本。
4. ZeRO-1:先切优化器状态
ZeRO-1 切分的是优化器状态。每张卡不再保存完整 Adam 的 m、v 和可能的 master weights,而只保存其中一部分。
简化后可以理解为:
GPU0: 完整参数 W + 完整梯度 G + 1/4 优化器状态 O
GPU1: 完整参数 W + 完整梯度 G + 1/4 优化器状态 O
GPU2: 完整参数 W + 完整梯度 G + 1/4 优化器状态 O
GPU3: 完整参数 W + 完整梯度 G + 1/4 优化器状态 O
为什么先切优化器状态?因为 AdamW 状态很大。对于每个参数,Adam 至少保存 m 和 v 两个 FP32 张量,显存开销很可观。
ZeRO-1 的优点:
- 改动相对小;
- 通信复杂度较低;
- 能节省一大块优化器状态显存;
- 对训练吞吐影响通常比更高阶段小。
ZeRO-1 的限制:参数和梯度仍然完整复制在每张卡上。如果模型参数本身就放不下,ZeRO-1 不够。
5. ZeRO-2:优化器状态和梯度都切
ZeRO-2 在 ZeRO-1 基础上继续切分梯度。反向传播时,梯度不再每张卡保留完整副本,而是通过 reduce-scatter 等通信把梯度分片到对应 GPU。
简化图:
GPU0: 完整参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU1: 完整参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU2: 完整参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU3: 完整参数 W + 1/4 梯度 G + 1/4 优化器状态 O
这通常是很多微调和中等规模训练的实用起点。因为它在显存节省和通信复杂度之间比较平衡。
ZeRO-2 适合:
1. 模型参数能完整放进单卡;
2. 梯度和优化器状态导致 OOM;
3. 希望比 ZeRO-3 更简单、更快;
4. LoRA/QLoRA 以外的较大规模 SFT 或 CPT。
但如果完整参数 W 都放不下,ZeRO-2 仍然不够,因为每张卡还保留完整参数。
6. ZeRO-3:连参数也切
ZeRO-3 进一步切分模型参数。每张 GPU 只保存一部分参数,需要计算某一层时,再临时 all-gather 所需参数,计算完后释放或重新分片。
简化图:
GPU0: 1/4 参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU1: 1/4 参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU2: 1/4 参数 W + 1/4 梯度 G + 1/4 优化器状态 O
GPU3: 1/4 参数 W + 1/4 梯度 G + 1/4 优化器状态 O
这就是 ZeRO-3 最省显存的原因。它让模型参数本身也不再完整复制,单卡显存压力大幅下降。
代价也很明显:
- 前向和反向过程中更频繁通信;
- 对网络带宽和延迟更敏感;
- checkpoint 保存和加载更复杂;
- 小 batch 或低带宽环境下吞吐可能明显下降;
- 排查问题时日志和分片状态更难理解。
因此 ZeRO-3 不是“永远更好”。它是容量优先的方案。当显存够用时,ZeRO-2 甚至普通 DDP 可能更快。
7. 用代码估算 ZeRO 阶段的参数状态节省
下面用一个简化估算器感受 ZeRO 对参数相关状态的影响。注意这只估算参数、梯度、优化器状态,不包括激活值。
# Python 3.10+
def zero_memory_estimate(params_billion, num_gpus, stage, master_weights=True):
params = params_billion * 1_000_000_000
param_bytes = 2
grad_bytes = 2
optim_bytes = 4 + 4 + (4 if master_weights else 0)
if stage == 0: # 普通数据并行
per_gpu = params * (param_bytes + grad_bytes + optim_bytes)
elif stage == 1:
per_gpu = params * (param_bytes + grad_bytes + optim_bytes / num_gpus)
elif stage == 2:
per_gpu = params * (param_bytes + grad_bytes / num_gpus + optim_bytes / num_gpus)
elif stage == 3:
per_gpu = params * (param_bytes + grad_bytes + optim_bytes) / num_gpus
else:
raise ValueError("stage must be 0, 1, 2, or 3")
return per_gpu / 1024**3
for stage in [0, 1, 2, 3]:
mem = zero_memory_estimate(params_billion=13, num_gpus=8, stage=stage)
print(f"ZeRO stage {stage}: ≈ {mem:.1f} GB per GPU for param states")
这段代码可以帮你理解每个阶段切了什么:
- stage 0 不切,所有状态完整复制;
- stage 1 只切优化器状态;
- stage 2 切优化器状态和梯度;
- stage 3 参数、梯度、优化器状态都按 GPU 数切分。
真实显存会更高,因为还有激活值和临时张量。估算器的用途不是给采购报价,而是帮助你判断:OOM 主要来自参数状态,还是来自激活和 batch。
8. DeepSpeed 配置怎么读
一个 ZeRO-2 的简化配置可能长这样:
{
"train_micro_batch_size_per_gpu": 1,
"gradient_accumulation_steps": 16,
"bf16": {
"enabled": true
},
"zero_optimization": {
"stage": 2,
"allgather_partitions": true,
"reduce_scatter": true,
"overlap_comm": true,
"contiguous_gradients": true
},
"gradient_clipping": 1.0
}
逐项解释:
| train_micro_batch_size_per_gpu | 单张 GPU 一次前向处理多少条序列 |
| gradient_accumulation_steps | 累积多少次梯度再做一次优化器更新 |
| bf16.enabled | 使用 BF16 混合精度,通常比 FP16 更稳定 |
| zero_optimization.stage | ZeRO 阶段,1/2/3 对应不同切分范围 |
| allgather_partitions | 聚合分片参数或状态的通信策略 |
| reduce_scatter | 梯度归约时直接散射分片 |
| overlap_comm | 尝试让通信和计算重叠,提高吞吐 |
| contiguous_gradients | 让梯度内存更连续,减少碎片 |
| gradient_clipping | 限制梯度范数,提升训练稳定性 |
真实项目还会配置 optimizer、scheduler、checkpoint、activation checkpointing、offload、日志和评估。不要把网上配置直接复制到生产训练。配置必须结合模型规模、GPU 显存、网络、seq_len、batch 和目标任务调整。
9. ZeRO-3 配置和几个关键开关
ZeRO-3 常见配置会更复杂,例如:
{
"train_micro_batch_size_per_gpu": 1,
"gradient_accumulation_steps": 8,
"bf16": {
"enabled": true
},
"zero_optimization": {
"stage": 3,
"overlap_comm": true,
"contiguous_gradients": true,
"reduce_bucket_size": 500000000,
"stage3_prefetch_bucket_size": 50000000,
"stage3_param_persistence_threshold": 100000,
"stage3_gather_16bit_weights_on_model_save": true
},
"gradient_clipping": 1.0
}
几个字段的直觉:
- reduce_bucket_size:梯度通信分桶大小,影响通信效率和显存峰值;
- stage3_prefetch_bucket_size:提前拉取参数分片的大小,影响通信隐藏和内存;
- stage3_param_persistence_threshold:小参数是否常驻,减少频繁 gather;
- stage3_gather_16bit_weights_on_model_save:保存模型时是否聚合完整 16-bit 权重。
ZeRO-3 的核心调参思路是:在显存峰值、通信效率和保存加载便利性之间平衡。桶太大可能显存峰值高,桶太小通信开销多。不同硬件和网络下,最佳值会变化。
10. Offload:把状态放到 CPU 或 NVMe
当 ZeRO 切分后 GPU 显存仍然不够,可以把参数或优化器状态 offload 到 CPU 内存,甚至 NVMe。Offload 的直觉是:GPU 放不下,就把一部分状态放到更慢但容量更大的地方。
一个简化配置示例:
{
"zero_optimization": {
"stage": 3,
"offload_optimizer": {
"device": "cpu",
"pin_memory": true
},
"offload_param": {
"device": "cpu",
"pin_memory": true
}
}
}
Offload 的取舍:
| GPU-only | 速度最快,通信路径简单 | 显存要求高 |
| CPU offload | 大幅降低 GPU 显存 | 受 PCIe/CPU 内存带宽影响 |
| NVMe offload | 容量更大 | 速度更慢,对磁盘和配置要求高 |
要特别强调:offload 通常不是性能优化,而是容量兜底。 能在 GPU-only 跑通且吞吐可接受时,不要为了“看起来更高级”开启 offload。
11. 如何选择 ZeRO 阶段
可以用下面的决策顺序:
1. 先估算参数状态和激活值显存;
2. 如果普通 DDP 能跑且吞吐好,先不用 ZeRO;
3. 如果优化器状态导致显存紧张,考虑 ZeRO-1;
4. 如果梯度和优化器状态导致 OOM,优先试 ZeRO-2;
5. 如果完整参数也放不下,使用 ZeRO-3;
6. 如果 ZeRO-3 仍放不下,再考虑 offload;
7. 每次只改一个主要变量,记录吞吐、显存和稳定性。
更工程化的判断表:
| 小模型全参数微调,显存充足 | DDP 或 ZeRO-1 |
| 7B/13B SFT,显存紧张 | ZeRO-2 |
| 训练/微调较大模型,单卡放不下完整参数 | ZeRO-3 |
| 单机多卡网络一般 | 尽量避免过重 ZeRO-3 通信 |
| 只有少量任务数据 | 先考虑 LoRA/QLoRA,而不是全参数 ZeRO |
| 极限低显存 | ZeRO-3 + offload,但接受吞吐下降 |
ZeRO 阶段越高,显存越省,但通信和系统复杂度越高。选择时不要只看“能不能跑”,还要看 tokens/s、故障恢复、checkpoint 时间和调试成本。
12. 常见问题排查
ZeRO 训练出问题时,不要只盯着 OOM 报错。可以按层次排查:
| 启动就 OOM | micro batch 太大、seq_len 太长、ZeRO 阶段不够 | 降 micro batch、开 checkpointing、升 ZeRO 阶段 |
| 训练中途 OOM | 长样本、内存碎片、评估阶段峰值 | 检查长度分布、bucket、eval batch |
| 吞吐很低 | 通信瓶颈、offload、数据加载慢 | 看 GPU 利用率、网络、CPU、dataloader |
| checkpoint 很慢 | ZeRO-3 聚合权重、磁盘带宽不足 | 调整保存频率、分片保存、检查存储 |
| 恢复后 loss 异常 | optimizer/scheduler/data state 未恢复 | 核对 checkpoint 完整性和配置版本 |
| 多卡不一致 | 随机种子、数据分片、通信异常 | 检查 rank 日志和数据 sampler |
建议训练日志至少记录:
1. 每步 loss 和 learning rate;
2. tokens/s 和 samples/s;
3. 每张 GPU 显存峰值;
4. gradient norm;
5. ZeRO stage 和 offload 状态;
6. checkpoint 保存/恢复耗时;
7. 数据加载耗时;
8. 通信等待或 GPU 利用率。
没有这些日志,排查 ZeRO 问题会变成猜配置。
13. 常见误区
误区一:ZeRO 阶段越高越好。 ZeRO-3 更省显存,但通信复杂、吞吐可能下降。显存够时,ZeRO-2 或 DDP 可能更好。
误区二:用了 DeepSpeed 就不用理解显存。 DeepSpeed 帮你切状态,但你仍然要知道参数、梯度、优化器、激活值分别占多少。
误区三:Offload 是加速手段。 Offload 主要是用速度换容量,通常会降低吞吐。
误区四:OOM 一定靠 ZeRO 解决。 OOM 也可能来自 seq_len、micro batch、激活值、评估配置、数据异常和临时张量。
误区五:训练配置可以直接复制。 同样模型在不同 GPU、网络、batch、seq_len 下,最佳 ZeRO 配置可能完全不同。
14. 小结
DeepSpeed ZeRO 的核心是消除数据并行中的重复训练状态。ZeRO-1 切优化器状态,ZeRO-2 再切梯度,ZeRO-3 连参数也切。它能让更大模型在有限显存下训练,但代价是通信、checkpoint 和调试复杂度上升。工程上要先建立显存账本,再根据瓶颈选择阶段,而不是盲目追求最高阶段。
大模型视角
从专栏主线看,前面几篇讲的是数据如何进入训练,这一篇讲的是训练状态如何放进硬件。ZeRO 是“用通信换显存”的典型工程取舍,也是大模型训练基础设施和模型规模之间最重要的中间层之一。
下一篇
下一篇会继续讨论训练稳定性:即使显存问题解决了,loss spike、梯度爆炸、混合精度溢出和坏 batch 仍然可能让训练失败。


评论前必须登录!
注册