 网硕互联帮助中心
第 9 步查到的同事账号,第 33 步才用上。第 21 步看到的 Discover 卡记录,第 26 到 28 步被挤出上下文,第 29 步又得重新捞回来——论文的案例里,正是这张卡让余额充值成功、七笔付款全部发出。
长时程 Agent 的上下文难题,表面看是「历史太长」,实际是「不知道哪一条会在后面被用到」。全留,输入成本随步数线性上涨;摘要,关键词可能刚好被摘掉;按整步选择,又常常留下一堆与当前动作无关的记录。CarryOn 这篇论文的做法是把问题拆成两半:一份 128 token 的紧凑控制状态负责「走到哪了、下一步做什么」,一个可回查的证据架负责「做这一步需要哪个具体值」。前者求稳,后者求准。
论文在 AppWorld、OfficeBench、Tau2 Telecom 三个基准、三个 Actor 上共 9 个设置里平均任务成功率 75.7%,比最强基线 SWE-Pruner 高 6.7 个百分点,比全上下文高 13.3 个百分点;平均 S0.8 为 68.45,平均 NCS 为 0.792。它不微调 Actor,上下文管理过程也不额外调用 LLM。
但先把边界说清楚:三个基准都是文本交互,每个基准训练一个单独的选择器,每个设置只跑了一次;在 Tau2 配 Claude 的那一格,它的成功率是 75.0%,低于 LLMLingua-2 的 80.0%。这篇论文值得读的地方,是它把「留什么」拆成了两个可训练、可消融的部件,而不是某个可以直接抄去上线的数字。
先给结论
- 保留的单位不是整步,也不是摘要,而是观察里的细粒度片段,片段带原文、来源交互引用和产生它的动作。
- 保留的信号来自一个 0.6B 的打分器:相关性排序分加「下一步会不会用到」的概率分,两者共享骨干。
- 监督不是任务回报,也不是人工逐条标注,而是成功轨迹里「证据后来被状态注释引用或被后续动作复用」这件事。
- 丢弃并不删除,只是把片段移出当前上下文;没被选中的片段留在 archive 里,后面的步骤可以重新选回来。
- 拿掉 128 token 的控制状态,AppWorld 配 Claude 的成功率从 79.8% 掉到 66.1%,是全部消融里最大的一项。
- 保留错了的代价很具体:少留两条合格请求 ID,七项要求只过六项;少留两个字段,九项要求只过七项。
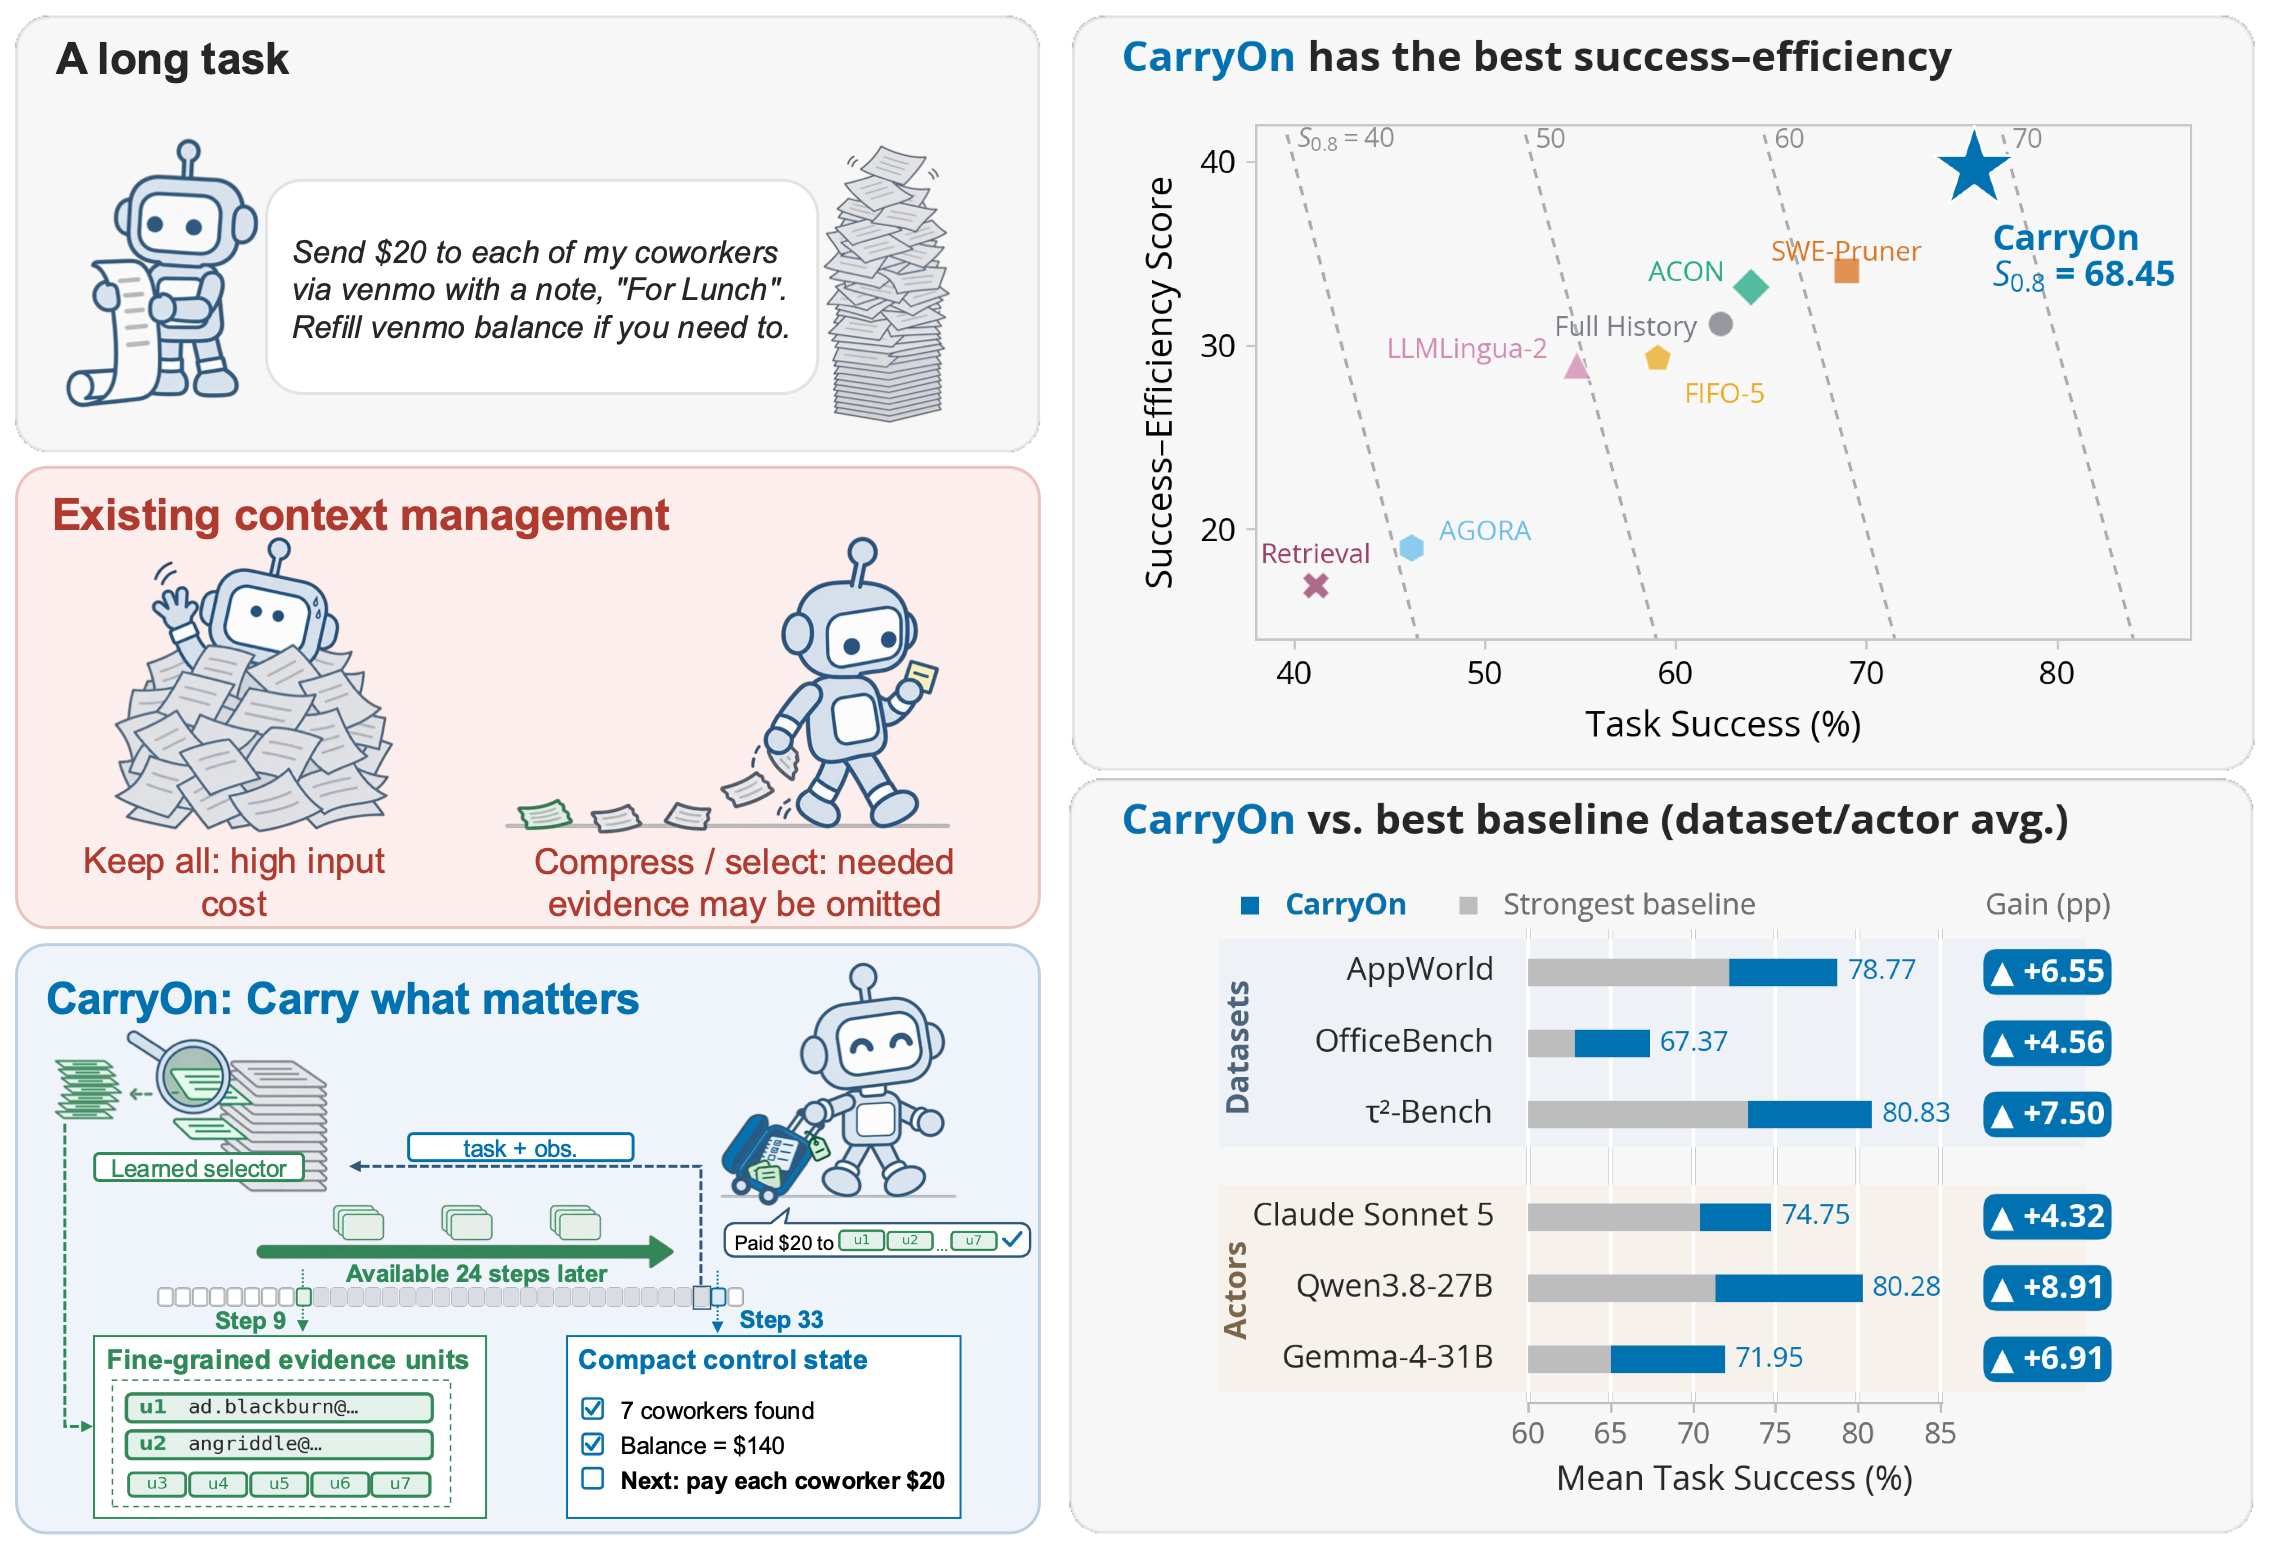
图 1|左栏把三种上下文策略摆在一起:全留会把输入撑大,压缩会丢掉后面才用的细节,CarryOn 用紧凑状态管进度、用细粒度证据管具体值;右栏是九个设置的成功率与效率分布,以及按基准和按 Actor 平均后的增益。
长时程 Agent 的上下文,为什么越留越贵、越压越丢
结论先放这儿:长时程任务的上下文不是「容量问题」,而是「时机关联问题」——第 9 步拿到的信息,可能到第 33 步才变成行动的必需输入。任何在中间步骤做的压缩,只要不可逆,就有概率把后面要用的那个值压没。
一个 33 步的付款任务,把问题摊开了
论文开篇举的任务很日常:给每位同事通过 Venmo 转 20 美元,附言 For Lunch,余额不够就先充值。听起来是三步操作,实际要先把同事找出来、核对账号、查余额、加卡、充值、再逐个发起转账。论文记录的轨迹里,付款在第 33 步完成,而同事账号是第 9 步就查到的,卡记录是第 21 步才出现的。
这三个时间点构成了长时程 Agent 的典型结构:信息产生的时间和它被使用的时间隔得很远,中间还夹着大量与最终动作无关的工具返回。如果每一步都把完整历史喂给 Actor,第 33 步的输入里会塞进二十多次工具调用;如果每隔几步做一次摘要,第 21 步那张卡的六个字段很可能在摘要里变成一句「已获取支付方式」。
论文开篇那张对比图的左侧把三种处境画在一起:全留,输入成本高;压缩或选择,需要的证据可能被省略;CarryOn 则把紧凑状态和细粒度证据分开,让第 9 步的账号在第 33 步仍然「伸手可及」。
四条旧路线各自漏在哪
论文的基线基本覆盖了工程上会选的四条路,每条都有自己的漏点:
- 全上下文(Full History):什么都不丢,成本随步数增长。AppWorld 配 Claude 时总 token 是 27.567M,成功率 43.5%,是九格里最低的一档。
- 滑动窗口(FIFO-5):只留最近五组动作与观察。近期上下文很干净,但早期约束一旦滑出窗口就再也回不来。
- 摘要压缩(LLMLingua-2、ACON):把历史压成更短的文本。压得越狠,越容易丢精确值,案例里丢的就是 ID 和字段。
- 检索记忆(Retrieval、AGORA):按相似度或学习到的打分挑历史交互。挑的是「像不像当前问题」,不是「下一步会不会用到」,噪声和漏检同时存在。
这四条路有一个共同假设:上下文管理是一次性的取舍,留了就一直在,丢了就永远丢。CarryOn 的出发点不一样——它把「当前这一步看什么」当成一个每步重算的决策,历史本身不销毁。这个差别听起来小,但它让「第 21 步的卡在第 29 步回来」成为可能。
把四条路线压成一张表,差别就更清楚:
| 全上下文 | Full History | 整段历史 | 输入随步数线性增长,无关记录占满预算 |
| 滑动窗口 | FIFO-5 | 最近五组交互 | 早期约束滑出后无法回来 |
| 摘要压缩 | LLMLingua-2、ACON | 生成式摘要 | 精确 ID 与字段被转述掉,错误不可见 |
| 检索记忆 | Retrieval、AGORA | 相似的历史交互 | 按语义相似选,不按下一步是否用得上选 |
CarryOn 的分工:128 token 的便签,加一个可回查的证据架
结论:CarryOn 把「进度」和「证据」拆成两种表示,前者用自然语言写死在一段很短的状态里,后者保留原始观察并按需选取。这个拆分是整篇论文的地基,后面的消融也证明它比任何单一表示都稳。
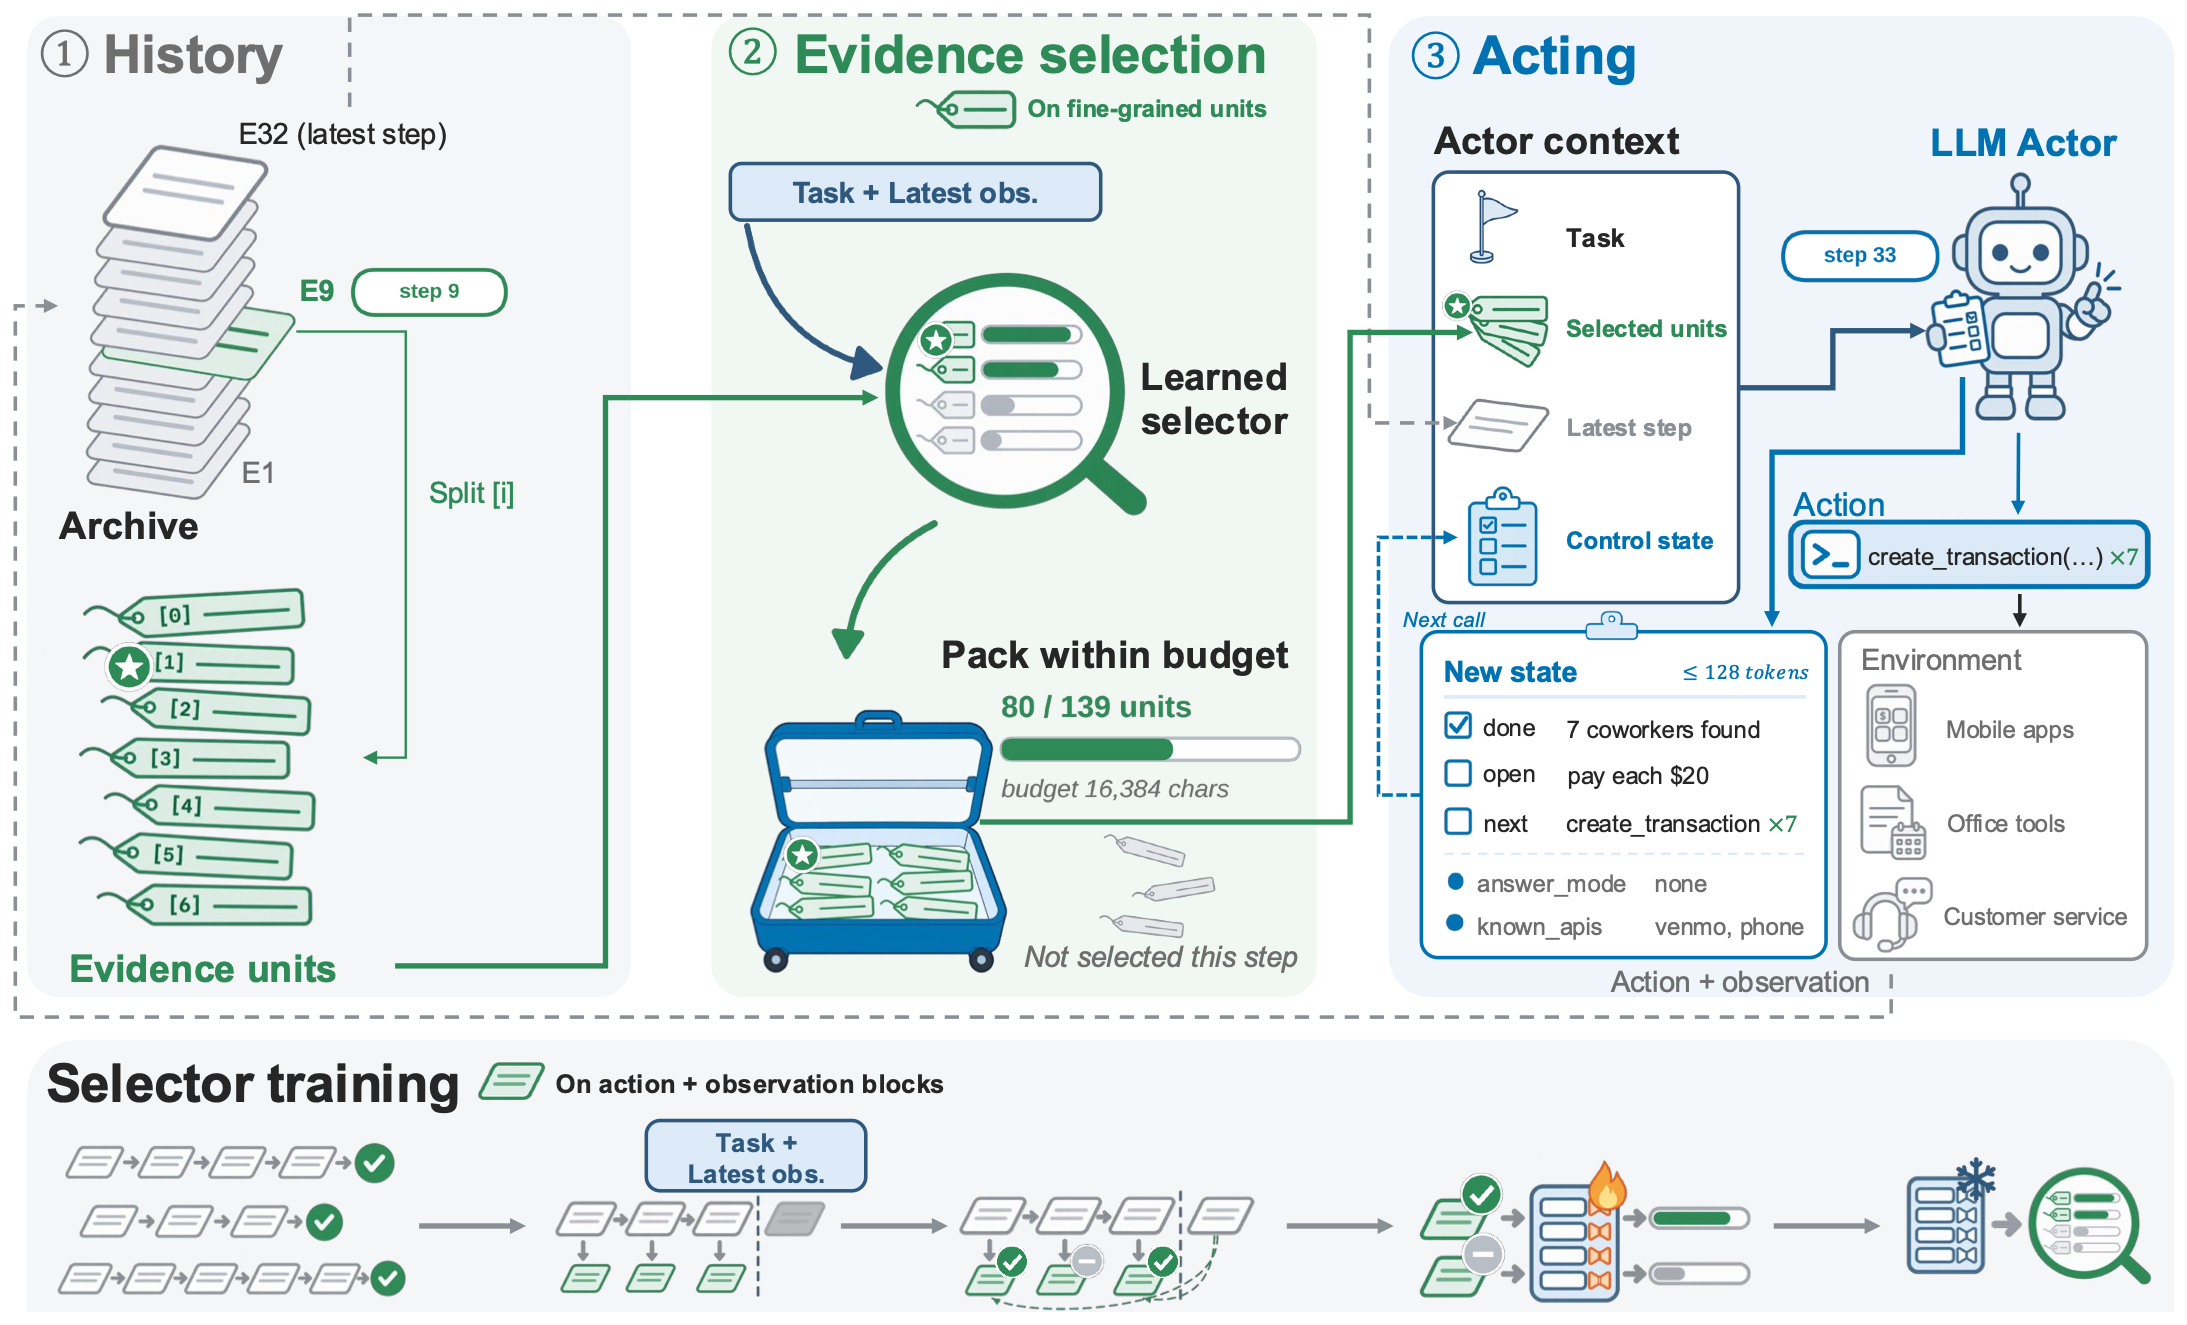
图 2|上半部分是四个区域:历史档案把观察切成片段,选择器按任务与最新观察打分,Actor 把选中证据、最近交互和五字段状态拼成输入,环境返回新的动作与观察;下半部分是选择器训练,从成功轨迹构造候选,用状态注释引用和后续复用打标签,LoRA 微调后冻结。
输入里到底有什么
每一步,Actor 收到的上下文由四部分组成:任务 q、控制状态 m_t、选中的旧证据 W_t、最近交互 R_t。论文把它写成一次组合:
Xt=Compose(q,mt,Wt,Rt)
X_t = \\mathrm{Compose}(q, m_t, W_t, R_t)
Xt=Compose(q,mt,Wt,Rt)
Compose 里还包含系统指令和工具定义。Actor 的输出不是单一动作,而是「动作 a_t 加一份状态更新建议」,状态更新通过校验后才进入下一步。这里的关键设计是:状态是 Actor 自己写的,但写入格式被约束成五个字段,长度被限制在 128 个代理 token。
控制状态为什么只要五个字段
MEMORY 只有五个字段:done 记录已完成的工作,open 记录仍未解决的义务,next 记录下一步操作,answer_mode 记录这次任务是否需要返回值,known_apis 记录已经查过的接口名。论文的提示词里还专门写了一句话:不要把密码、访问令牌、长 ID、列表或工具回执抄进状态,精确值留在证据里。
这个分工很实用。状态负责「别忘了要做什么」,它天然是短的、可改写的、允许模糊的;证据负责「做的时候填什么值」,它必须是原始的、精确的、可追溯的。把两者混在一起,就会出现两种典型故障:状态里塞满 ID,长度爆掉被截断;或者证据被摘要成一句话,填参数时发现少了字段。
论文的状态容量实验也支持这个判断:64、128、256 个代理 token 分别对应 77.4%、79.8%、78.0% 的成功率,64 token 那一档发生了 284 次截断,128 token 只有 48 次。状态不是越大越好,够放「进度加下一步」就行。
证据为什么要带来源
每个证据片段保留三样东西:原始内容、它来自哪一次交互的引用、产生这条观察的动作。第三样最容易被忽略,但没有它,Actor 看到一条孤立记录时无法判断「这是谁在什么操作之后返回的」。
带来源还有一个直接好处:证据可以只选片段,而动作只附一次。论文的预算规则里写明,如果多个片段来自同一次观察,产生它的动作只算一次。这让「细粒度」在 token 上真的更省,而不是把同一条工具回执切碎后重复计费。
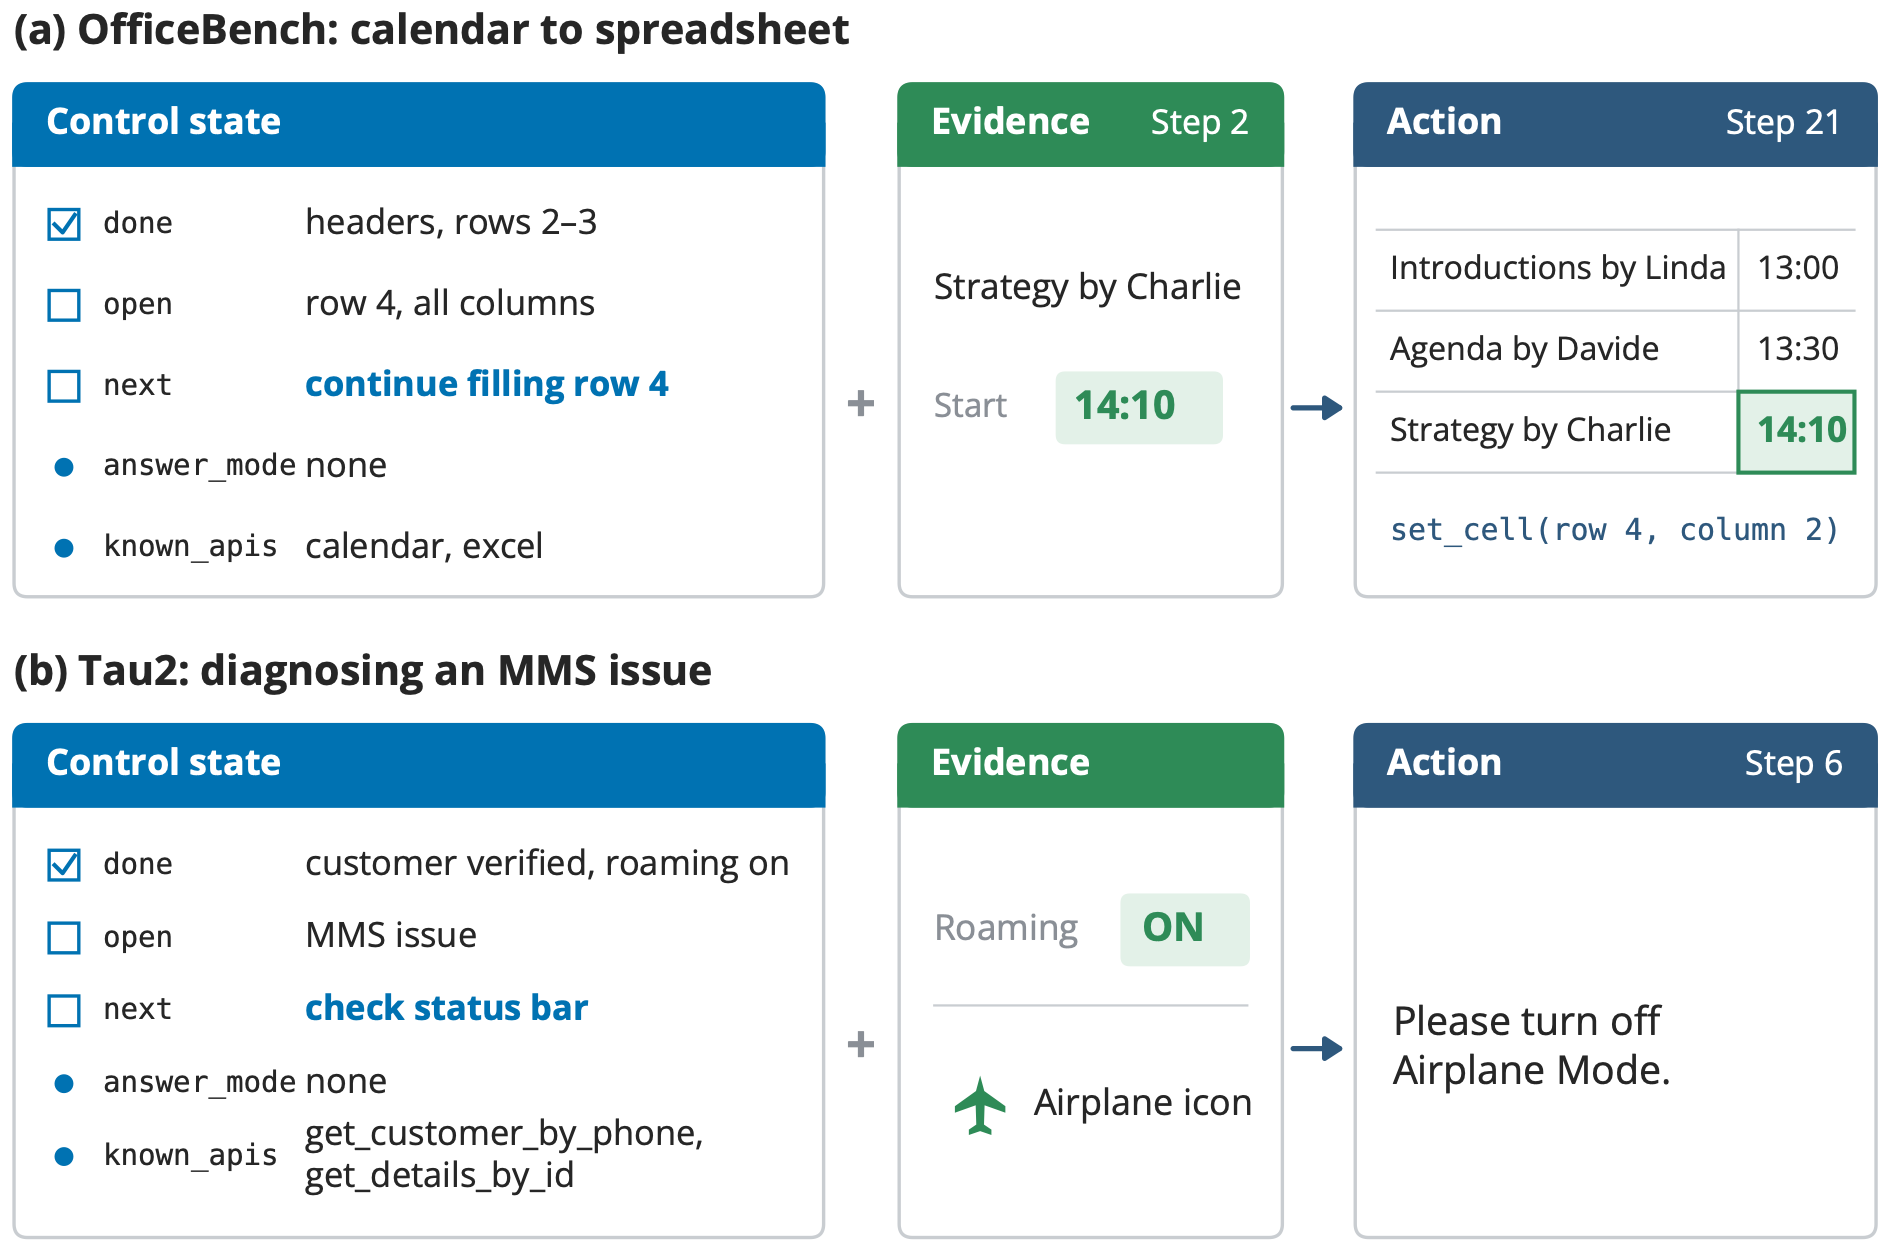
图 3|两个真实轨迹的片段:OfficeBench 里,第 2 步日历记录的 14:10 在第 21 步被用来填表格;Tau2 里,账户信息与用户新报的飞行模式图标一起支持第 6 步的诊断回复。左边是五字段状态,中间是证据,右边是动作。
保留的单位:不是整步,也不是摘要,而是观察片段
结论:CarryOn 的最小保留单位是 observation 里的「一条记录」,不是一整步交互,也不是一段生成式摘要。这个粒度选择,是它同时赢过「整步选择」和「摘要压缩」的原因。
Split:把一次 observation 拆成一条条记录
论文用 Split[i] 表示把观察切成单元。以 AppWorld 为例,一次 get_payment_requests 可能返回几十条请求记录,每条有 ID、金额、状态;以 OfficeBench 为例,一次读文件可能返回一个 note 的 note_id、content、tags、pinned。这些字段在同一次返回里,但它们的「保质期」完全不同:ID 列表可能整段都要用,tags 可能只在创建新 note 时用一次。
按整步保留,会把「有用的那条」和「同一次返回里没用的九十条」绑在一起;按摘要保留,会把 tags 这种低显著性但必需的字段压掉。按片段保留,才有机会只带九条 ID、不带其余三十八条。
片段自带的三样东西
前面说过,片段带原文、来源引用和产出动作。论文还补了一条:没有被选中的证据不会消失,它留在 archive 里等下一次决策。这一点决定了后面所有的「回查」能力——如果选择器第一次判断错了,系统还有第二次机会。
论文的案例研究里,检索式基线失败的方式正好相反:它选中的是「与当前查询相似」的交互,一旦某条记录在语义上不相似,就永远不会被选回来,哪怕它在下一步就是必需的。
为什么片段比整步更省、比摘要更准
省,是因为只带需要的字段;准,是因为带的是原文而不是转述。论文的对比案例把这两点都量化了:ACON 的压缩摘要把九条合格请求压成七条,CarryOn 保留完整九条;SWE-Pruner 把 note 的 tags 和 pinned 过滤掉,CarryOn 原样保留。前者导致六项要求只过六项,后者导致九项要求只过七项。
换句话说,摘要压缩的误差是「不可见的」:它不会报错,只会让后面的动作少一个参数。等到评测时你才发现少过了一项要求,而那时已经无法回溯是哪一步压掉的。
保留信号从哪来:0.6B 打分器,用「后来用没用上」监督
结论:选择器不是用任务回报训练的,也不是人工标注「哪条重要」,而是在成功轨迹上学习「这条证据后来有没有被引用或被复用」。这是一个便宜、可自动构造、且与「下一步动作」直接相关的信号。
两个分数:排序与下一步使用概率
选择器读入任务 q、当前观察 o_t 和候选片段 u,输出两个分数:
rt(u)=fϕ(q,ot,u)
r_t(u) = f_\\phi(q, o_t, u)
rt(u)=fϕ(q,ot,u)
pt(u)=σ(gϕ(q,ot,u))
p_t(u) = \\sigma(g_\\phi(q, o_t, u))
pt(u)=σ(gϕ(q,ot,u))
r_t(u) 是相关性排序分,用来在预算内排序填包;p_t(u) 是「下一步会用到」的概率,经过 sigmoid 压到 0 到 1。两个函数共享同一个预训练骨干,只是指令不同,第二个分数额外接一个线性头。
为什么需要两个分数?因为「相关」和「马上要用」不是一回事。一条三个月前的账单记录与当前任务高度相关,但下一步大概率用不到;一条同事的电话号码在当前任务里语义相关性很低,但下一步发消息就要用它。前者靠排序分保留在候选池,后者靠使用概率挤进当前上下文。
标签从哪来:状态注释引用加后续动作复用
监督信号有两个来源。第一个是离线状态注释里的证据引用:用 Claude Sonnet 5 在成功轨迹上生成状态注释,注释里会引用它依据了哪条证据。第二个是后续动作的实际复用:AppWorld 会追踪哪些早期观察为下一次工具调用提供了值,OfficeBench 会把早期证据与下一步动作的参数做匹配,Tau2 则追踪后续公共交互里的证据复用。
两者合起来构成排序的正例;既没被引用、也没被复用的候选,作为弱负例。注意这里的「弱」:没被用不等于没用,所以论文不把它当硬负例,只当排序里的对照。
三个基准的复用信号各有各的取法,但都只看公开交互:
- AppWorld 追踪值的来源:下一次工具调用的参数是从哪条早期观察里取出来的。
- OfficeBench 做参数匹配:下一步动作的实参能否在早期证据里找到原文。
- Tau2 追踪后续公共交互里的证据复用,不读模拟器的私有状态。
训练只要成功轨迹,不要人工标注
训练分两段。第一段用 LoRA 把 Qwen3-Reranker-0.6B 适配成成对排序器,损失是:
ℓrank=log(1+exp(γ+r−−r+))
\\ell_{\\mathrm{rank}} = \\log\\left(1 + \\exp\\left(\\gamma + r_- – r_+\\right)\\right)
ℓrank=log(1+exp(γ+r−−r+))
其中 r+ 和 r- 是同一决策步上正例与弱负例的相关性分,γ 是排序间隔,论文取 0.2。第二段把排序损失和「下一步使用」的二分类交叉熵联合优化,同时更新排序适配器和新加的分类头。
这套流程对数据的要求是:官方训练集上的成功轨迹、一次 Claude Sonnet 5 的离线注释、一块 H100。论文报告两个阶段合计在 AppWorld 上约 4.87 小时,OfficeBench 0.59 小时,Tau2 0.79 小时。不需要人工逐条标注,也不需要跑强化学习。
冻结的打分器可以跨 Actor 复用
训练在整块 action-observation block 上做,部署时打分打到更细的片段上。论文的说法是「把块级监督迁移到片段选择」,不需要为每个片段单独标注。同一基准内,一个冻结的选择器可以同时服务 Claude Sonnet 5、Qwen3.8-27B 和 Gemma-4-31B 三个 Actor。
这也是它和 ACON、AGORA 的一个实际差别:ACON 要用 Claude 迁移优化过的提示,AGORA 要把 Claude 标注的打分器迁到另外两个模型;CarryOn 的选择器本身不依赖 Actor,跨 Actor 复用是设计的一部分,不是事后补的实验。
怎么决定丢弃:预算先给近窗,再按分数填,最后开一条临时缝
结论:CarryOn 的「丢弃」是四步流水线——保近窗、按相关性填预算、按使用概率临时扩容、非法动作时加长近窗。没有一步是永久删除,全部是「这一步先不给」。
四步拆开看是这样的:
一步的装配流程可以写成下面这段示意代码,公式和分支都能在论文 Algorithm 1 里找到对应:
仅示意:CarryOn 一步的上下文装配,对应论文 Algorithm 1
输入: 任务 q, 档案 H, 状态 m, 当前观察 o, 预算 B=16384, 阈值 τ=0.5
R = 近窗(H) # 接受响应后 1 组;动作非法时 2 组
U = H 中 R 之外的证据片段
score_r, score_p = Selector(q, o, U) # 相关性分 + 下一步使用概率
P = []
for u in 按 score_r 降序(U): # 先给近窗留座,再按分数填
if len(P) + len(u) <= B – len(R): P.append(u)
D = [u for u in U if u not in P and score_p[u] >= τ]
X = Compose(q, m, P + D, R) # 任务、状态、证据、近窗
a, m_new = Actor(X)
if 合法(m_new): m = m_new # 非法更新保留上一版状态
执行 a,把 (a, 新观察) 写入 H
基础包:16,384 字符里先留座
基础证据包 P_t 的预算是 16,384 个字符。装配时先扣掉最近交互 R_t 占用的字符数,剩下的才是旧证据的容量:
Btbold=max(0,B−c(Rt))
B_t^{\\mathrm{bold}} = \\max\\left(0, B – c(R_t)\\right)
Btbold=max(0,B−c(Rt))
然后按 r_t(u) 从高到低填,放不下的片段跳过。近窗永远保留,即使它自己就超过了基础预算;如果多个片段来自同一次观察,动作只附一次。这一步决定了「常规情况下看什么」。
临时扩容:τ 等于 0.5 的那条缝
基础包之外还有一条扩容通道。对于那些没进 P_t、但「下一步使用概率」超过阈值的片段,直接加进来:
Dt={u∈Ut−Pt:pt(u)≥τ}
D_t = \\{u \\in U_t – P_t : p_t(u) \\geq \\tau\\}
Dt={u∈Ut−Pt:pt(u)≥τ}
Wt=Pt∪Dt
W_t = P_t \\cup D_t
Wt=Pt∪Dt
τ 取 0.5,扩容可以超出基础预算,而且每一步重算。论文报告它在 AppWorld 的 4.4% 决策步上触发,在 OfficeBench 是 12.2%。触发频率不高,但触发时往往是关键一步:附录里的例子是联系人记录因为基础预算快满而被挤出,扩容把电话号码加回来,Actor 在同一步把菜谱名发了出去,任务完成。
近窗只在动作非法时变长
最近交互的窗口不是固定的。正常接受一次响应后,只保留最新一组交互;如果动作没通过校验、状态更新非法或被截断,窗口就扩展到最近两组。这个设计的意图很直接:解析失败通常意味着 Actor 需要更多上下文来纠正格式,而不是更多证据来推理。
未通过校验的状态更新会保留上一版状态,不会被半截覆盖。这个细节在工程上很重要——状态是长时程任务里唯一跨步传递的东西,一旦被坏更新污染,后面的步骤会一路错下去。
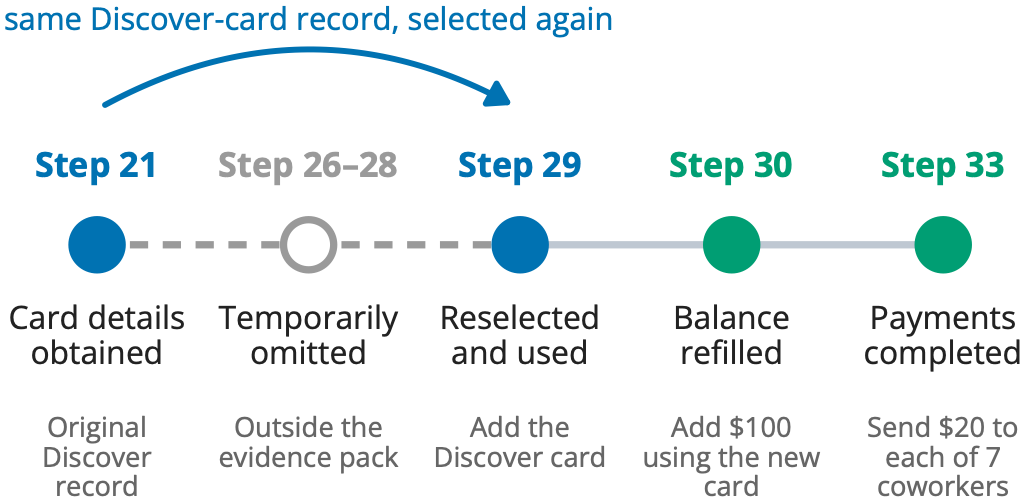
图 4|一张 Discover 卡记录的生命周期:第 21 步获取,第 22 到 25 步可见,第 26 到 28 步移出证据包,第 29 步被学习排序重新选回并用来加卡,第 30 步充值 100 美元,第 33 步七笔付款全部完成。
「丢弃」其实是移出上下文,不是删除
这一点值得单独说。CarryOn 从不销毁 archive 里的观察,所谓丢弃只是「这一步不放进 W_t」。论文的证据年龄统计显示,被选中的证据里有 30.7%(AppWorld)、31.2%(OfficeBench)、48.8%(Tau2)来自至少十步之前;40.2% 的任务运行里,某条证据在被移出上下文至少一步之后又被重新选中。
如果把「丢弃」理解成删除,这些数字就无法解释。CarryOn 的真正主张是:上下文是每步重建的工作集,历史是不可变的档案。工作集可以小,档案不能丢。
实验:三个基准、三个 Actor,75.7% 与 0.792
结论:CarryOn 在 9 个设置里平均成功率 75.7%,S0.8 与 NCS 的平均值都是第一;但它在 Tau2 配 Claude 的一格输给 LLMLingua-2,在 AppWorld 配 Qwen 的一格 NCS 高于全上下文,这两处必须一起看。
比谁、在哪、怎么算分
三个基准分别是 AppWorld 的 168 个任务(57 简单、48 中等、63 困难)、OfficeBench 的 95 个任务(42 个 L1、22 个 L2、31 个 L3)、Tau2 Telecom 的 40 个任务。三个 Actor 是 Claude Sonnet 5、Qwen3.8-27B、Gemma-4-31B。基线包括全上下文、FIFO-5、Retrieval、LLMLingua-2、ACON、AGORA、SWE-Pruner。
论文用了两个指标。TGC 就是成功率,等于 100 乘以成功任务数除以总任务数。S0.8 先用 token 和调用数对成功率打折,再加权回成功率:
S0=TGC1+12Tˉ/BT+12Cˉ/BC
S_0 = \\frac{\\mathrm{TGC}}{1 + \\frac{1}{2}\\bar{T}/B_T + \\frac{1}{2}\\bar{C}/B_C}
S0=1+21Tˉ/BT+21Cˉ/BCTGC
Sα=α TGC+(1−α) S0
S_\\alpha = \\alpha\\,\\mathrm{TGC} + (1-\\alpha)\\,S_0
Sα=αTGC+(1−α)S0
T̄ 和 C̄ 是平均 token 与平均调用数,B_T 和 B_C 是全上下文在同一任务集上的对应均值,α 取 0.8,也就是八成看成功率、两成看成本折扣。NCS 则是「每次成功花了多少」:把总调用数和总 token 数分别除以成功数,再各自对全上下文归一化,两项各占一半。注意分母只算成功数,分子包含失败任务的消耗,所以早早失败的方法不会因为「省了 token」而占便宜。
主表:赢在哪,哪里没赢
论文主表的九格结果,可以压成下面这张对照表。每格左边是 CarryOn,右边是该格最强的基线。
| AppWorld | Claude Sonnet 5 | 79.8% | 79.2%(SWE-Pruner) | 0.556 | 0.652 |
| AppWorld | Qwen3.8-27B | 84.5% | 68.5%(SWE-Pruner) | 1.634 | 1.553(ACON) |
| AppWorld | Gemma-4-31B | 72.0% | 69.0%(SWE-Pruner) | 0.885 | 0.769(SWE-Pruner) |
| OfficeBench | Claude Sonnet 5 | 69.5% | 67.4%(ACON) | 0.530 | 0.625(LLMLingua-2) |
| OfficeBench | Qwen3.8-27B | 66.3% | 66.3%(全上下文,并列) | 0.476 | 0.841(ACON) |
| OfficeBench | Gemma-4-31B | 66.3% | 61.1%(SWE-Pruner) | 0.338 | 0.565(ACON) |
| Tau2 Telecom | Claude Sonnet 5 | 75.0% | 80.0%(LLMLingua-2) | 1.121 | 0.982(LLMLingua-2) |
| Tau2 Telecom | Qwen3.8-27B | 90.0% | 87.5%(ACON) | 0.803 | 0.858(ACON) |
| Tau2 Telecom | Gemma-4-31B | 77.5% | 65.0%(SWE-Pruner) | 0.782 | 0.864(SWE-Pruner) |
九格里赢了七格的成功率、平了一格、输了一格;S0.8 八格第一,NCS 六格第一。平均下来就是 75.7%、68.45、0.792。
但有两处必须点名。第一处是 Tau2 配 Claude:CarryOn 75.0%,LLMLingua-2 80.0%,NCS 也是 1.121 对 0.982,两项都输。论文没有解释这一格为什么输,只在正文里如实写了「LLMLingua-2 更高」。第二处是 AppWorld 配 Qwen:成功率从 68.5% 拉到 84.5%,但 NCS 1.634 比全上下文的 1.000 还高,也比 ACON 的 1.553 高——它用了更多调用和更多 token,只是换来更高的成功率。换句话说,NCS 的均值 0.792 主要由 OfficeBench 那三格的低值撑起来,不是每一格都省。
按任务组拆开看,增益集中在「步骤多、每步明确」的组:AppWorld 简单组高 12.28 点、中等组高 9.72 点,困难组反而低 1.06 点;OfficeBench 的 L3 高 8.60 点,L1 低 0.79 点;Tau2 的 MMS 组高 6.25 点,移动数据与服务组分别是 0.00 和 −2.22 点。这说明它擅长的是「做到第十步还记得第一步拿到了什么」,而不是「难在单步推理」的任务。
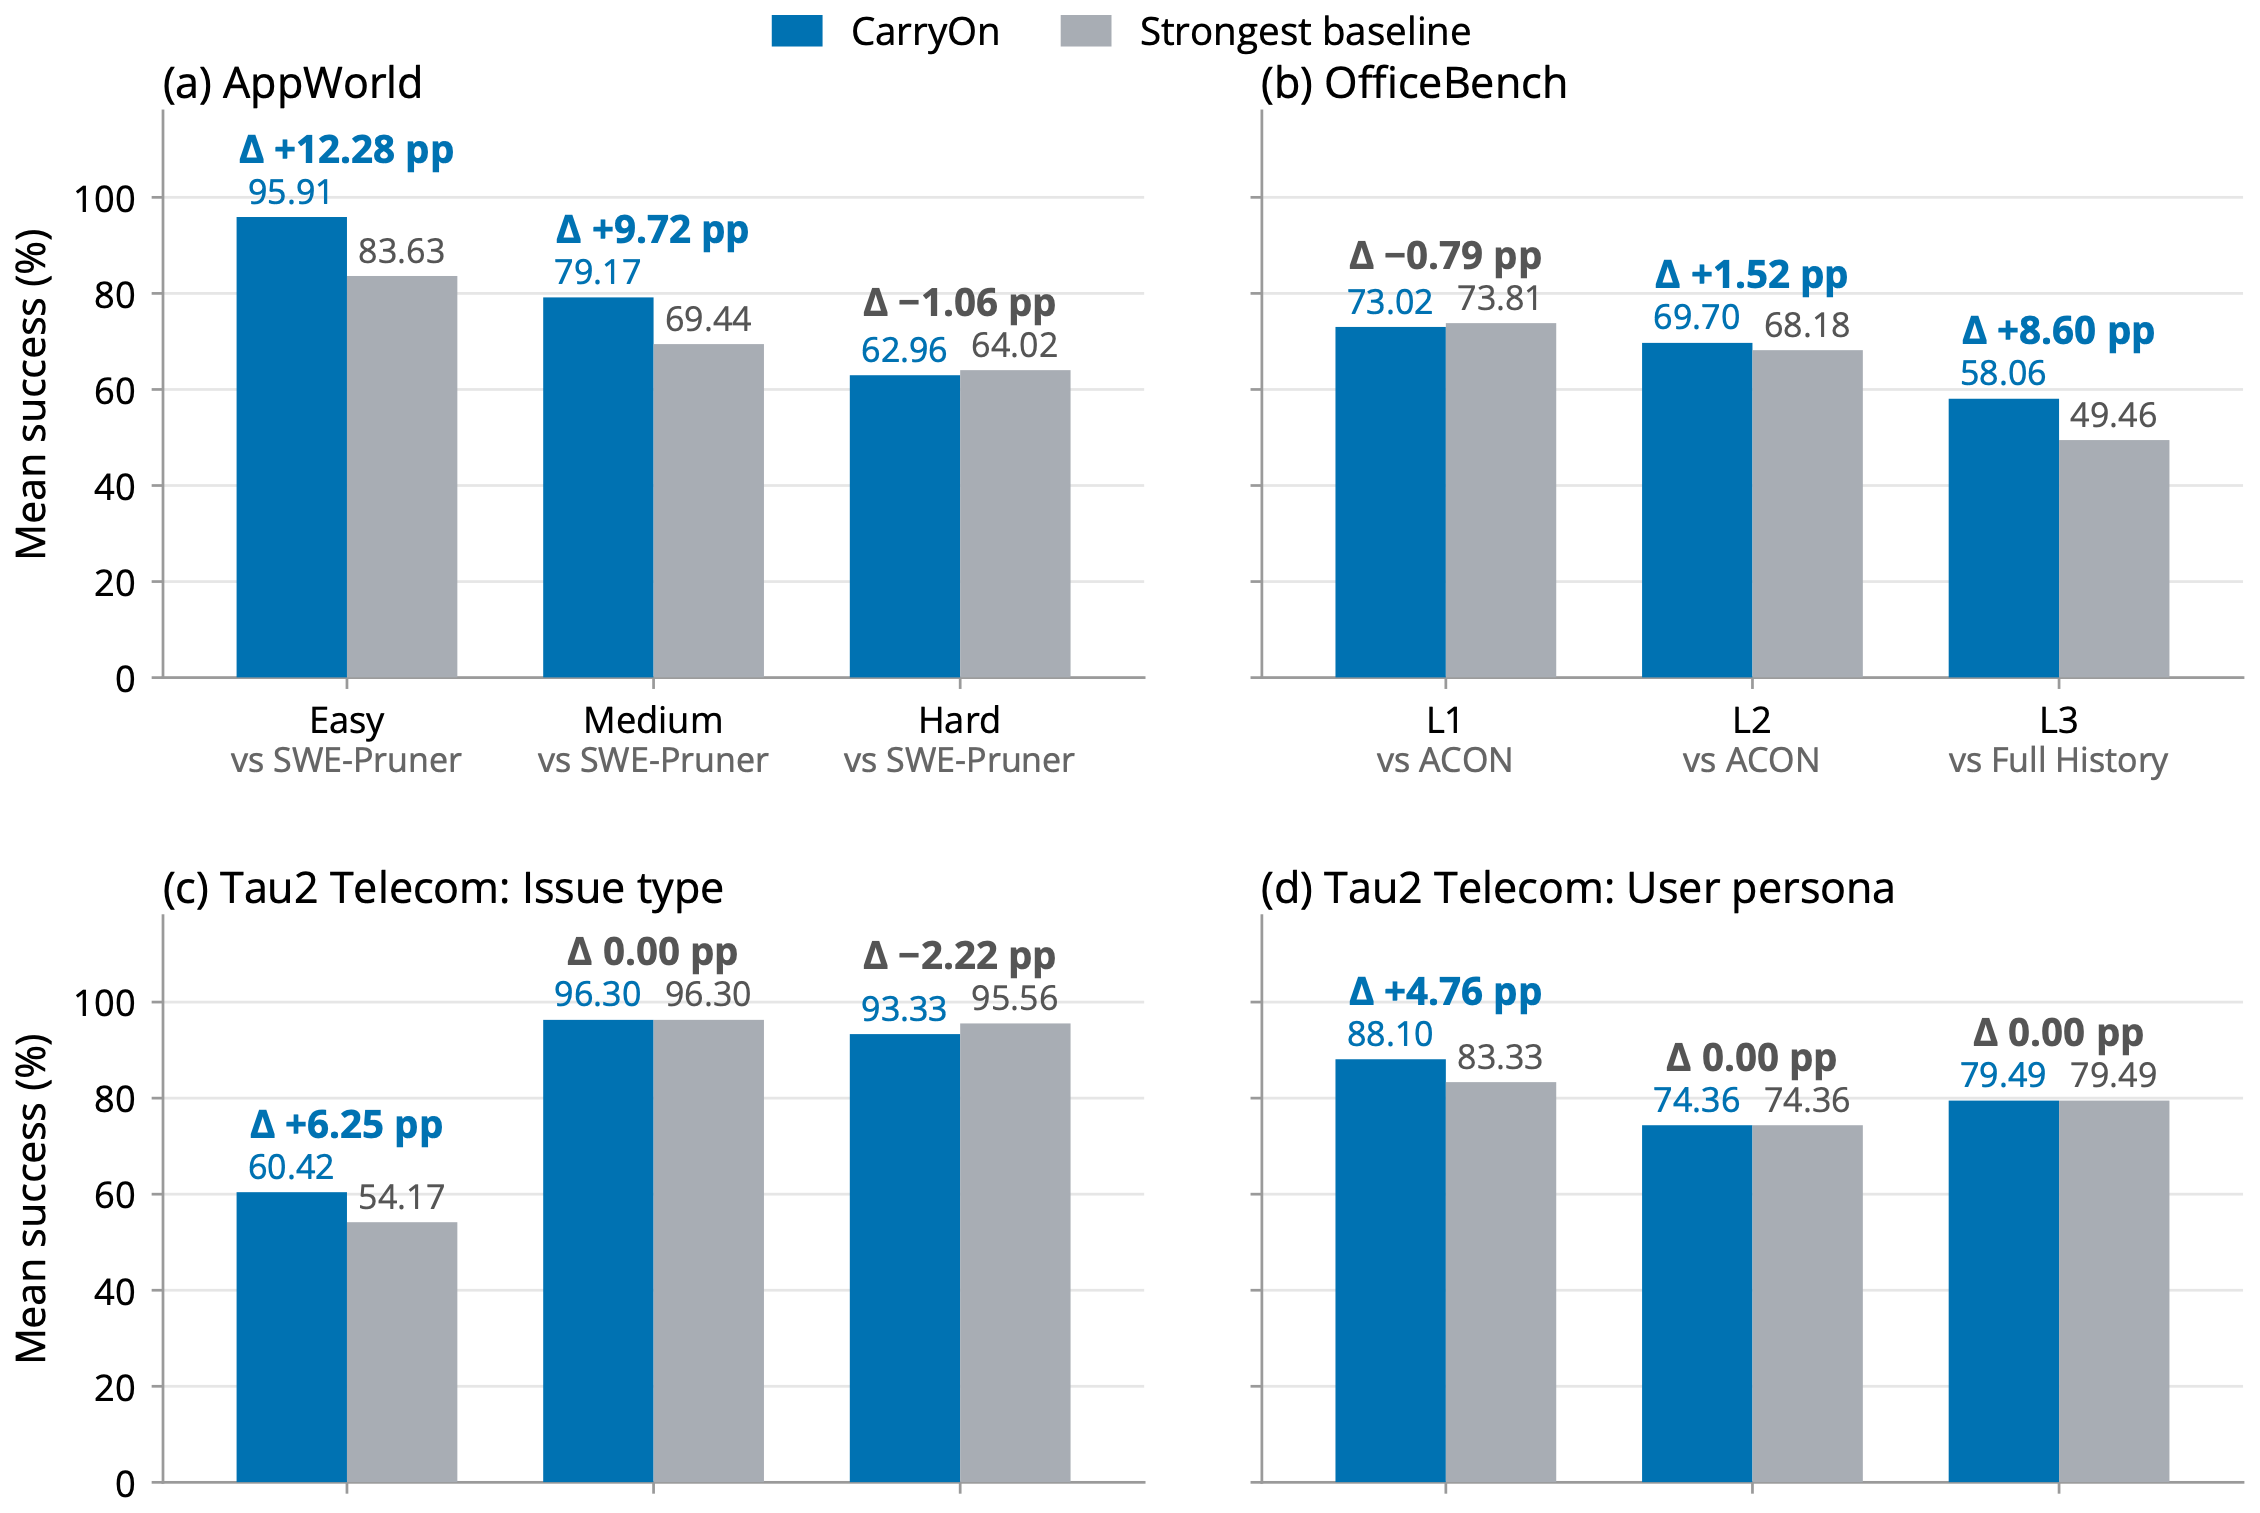
图 5|按任务组平均的成功率:AppWorld 简单组高 12.28 点、中等组高 9.72 点、困难组低 1.06 点;OfficeBench 的 L3 高 8.60 点;Tau2 的 MMS 组高 6.25 点,移动数据与服务组基本持平。
调用数、token 与证据年龄
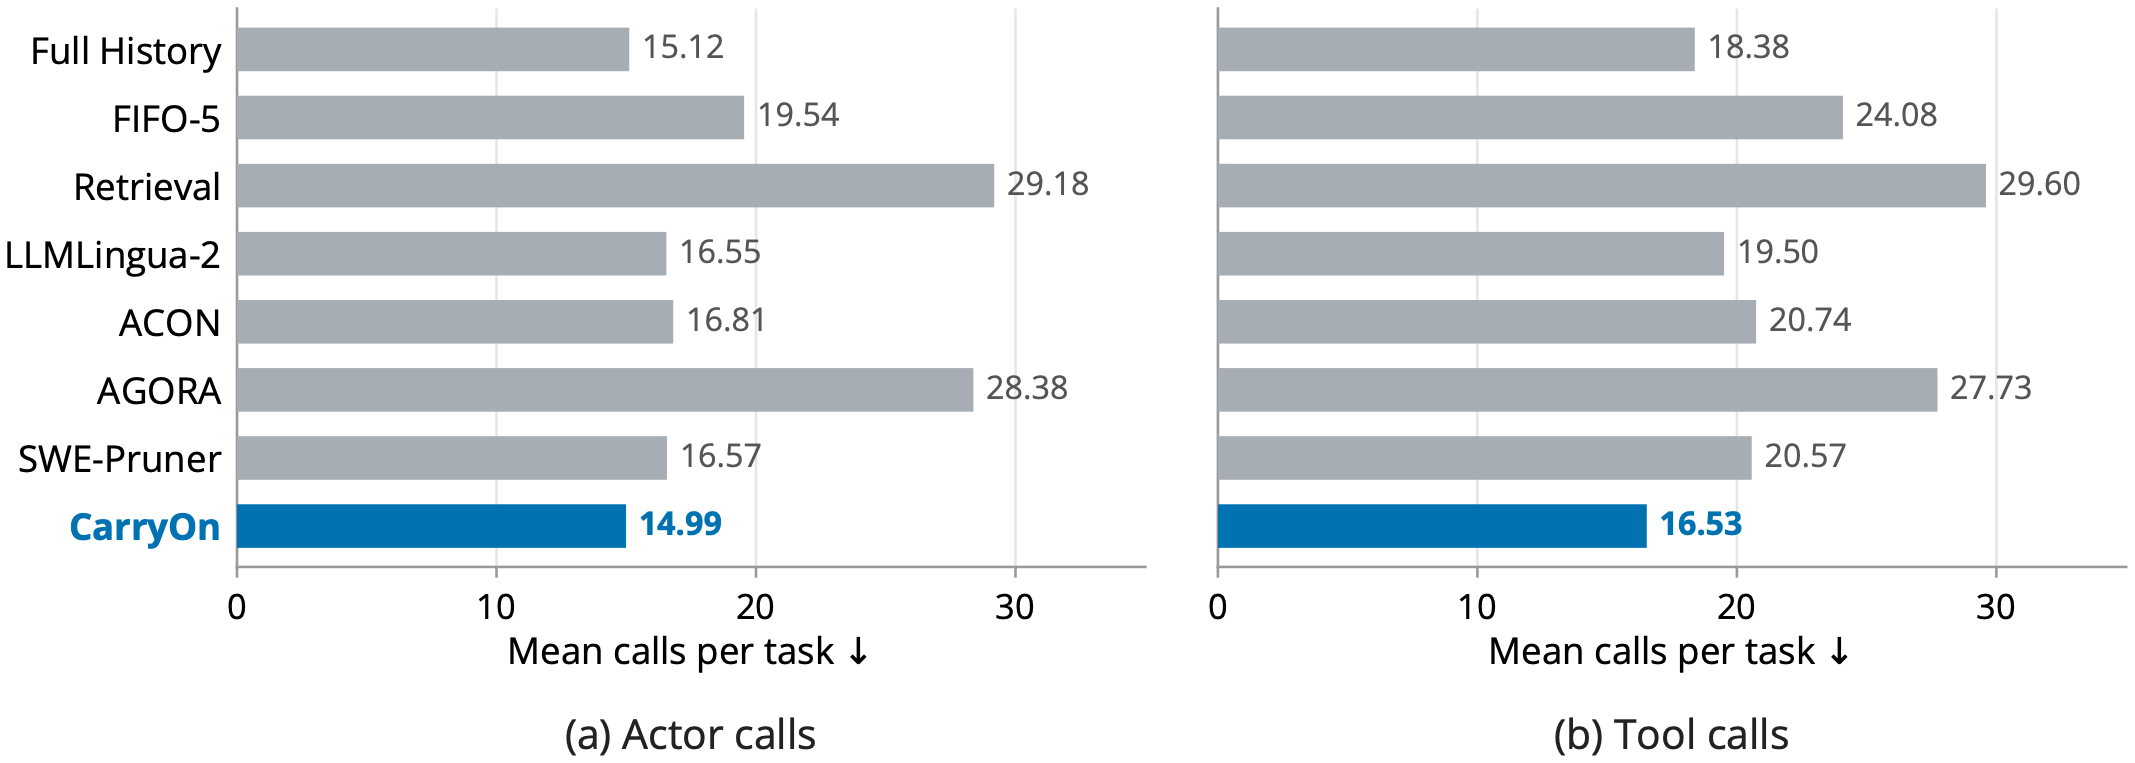
图 6|八种方法的平均每任务调用数,失败任务也计入:CarryOn 的两根柱子都最短,工具调用从 18.38 次降到 16.53 次,Actor 调用只从 15.12 次降到 14.99 次。
平均到每个任务,CarryOn 的 Actor 调用是 14.99 次,全上下文是 15.12 次;工具调用是 16.53 次对 18.38 次,少 10.1%。这个降幅不算惊人,但方向一致:它完成了更多任务,同时工具调用更少。
在 AppWorld 配 Claude 这一格,细节更值得看:CarryOn 的 Actor 调用是 3,098 次,比全上下文的 2,727 次多,但总 token 是 24.906M,比 27.567M 少约 9.6%;通过的要求数是 962/1077,全上下文是 774/1077。也就是说,它用更多的短调用换掉了更少的长调用,单次输入更小,总账更低。
证据年龄的分布是这套机制最直接的证据:十步以上的老证据占选中次数的三成上下,Tau2 甚至接近一半;四成左右的任务运行出现过「移出后又被选回」。这些数字说明「可回查」不是纸面设计,而是在实际轨迹里经常发生。
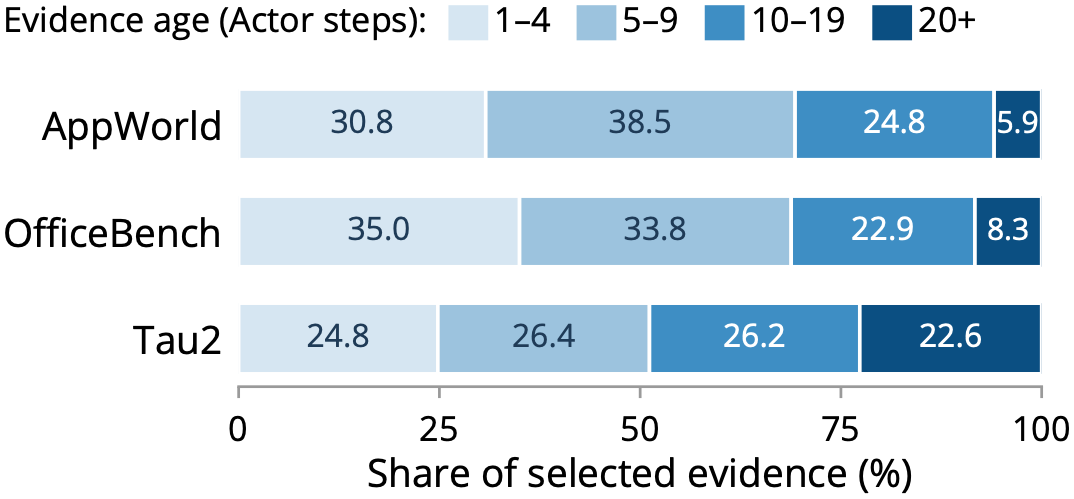
图 7|被选中证据的年龄分布,不含自动保留的近窗:AppWorld 约三成、OfficeBench 约三成、Tau2 近一半来自至少十步之前;Tau2 的 20 步以上占到 22.6%。
消融:拿掉便签掉 13.7 个点
在 AppWorld 配 Claude 上做的四组消融,结论非常干脆:
| 去掉 MEMORY | 66.1% | 58.72 | 0.824 | −13.7 点 |
| 只保留排序 | 76.8% | 69.09 | 0.568 | −3.0 点 |
| 细粒度训练 | 73.2% | 65.68 | 0.629 | −6.6 点 |
| 近期打包 | 76.2% | 68.36 | 0.603 | −3.6 点 |
| CarryOn | 79.8% | 71.71 | 0.556 | — |
「只保留排序」是去掉下一步使用训练和临时扩容,还剩 76.8%,说明扩容和第二个分数合起来值 3 个点。「近期打包」是用最近的片段代替学习选择,还有 76.2%,说明在这个基准上「近」本身就是个不弱的先验,学习选择多值 3.6 个点。「细粒度训练」只用后续 API 复用标片段、不用状态注释引用,掉到 73.2%,说明块级监督迁移到片段这件事确实有损耗,两类标签都必要。
最大的一项还是状态:去掉 MEMORY 直接掉 13.7 个点。这个结果有点反直觉——大家通常把注意力放在「选哪些证据」上,但论文的数据说,先有一份可靠的进度记录,比选得更准更重要。
容量与指标权重的敏感性
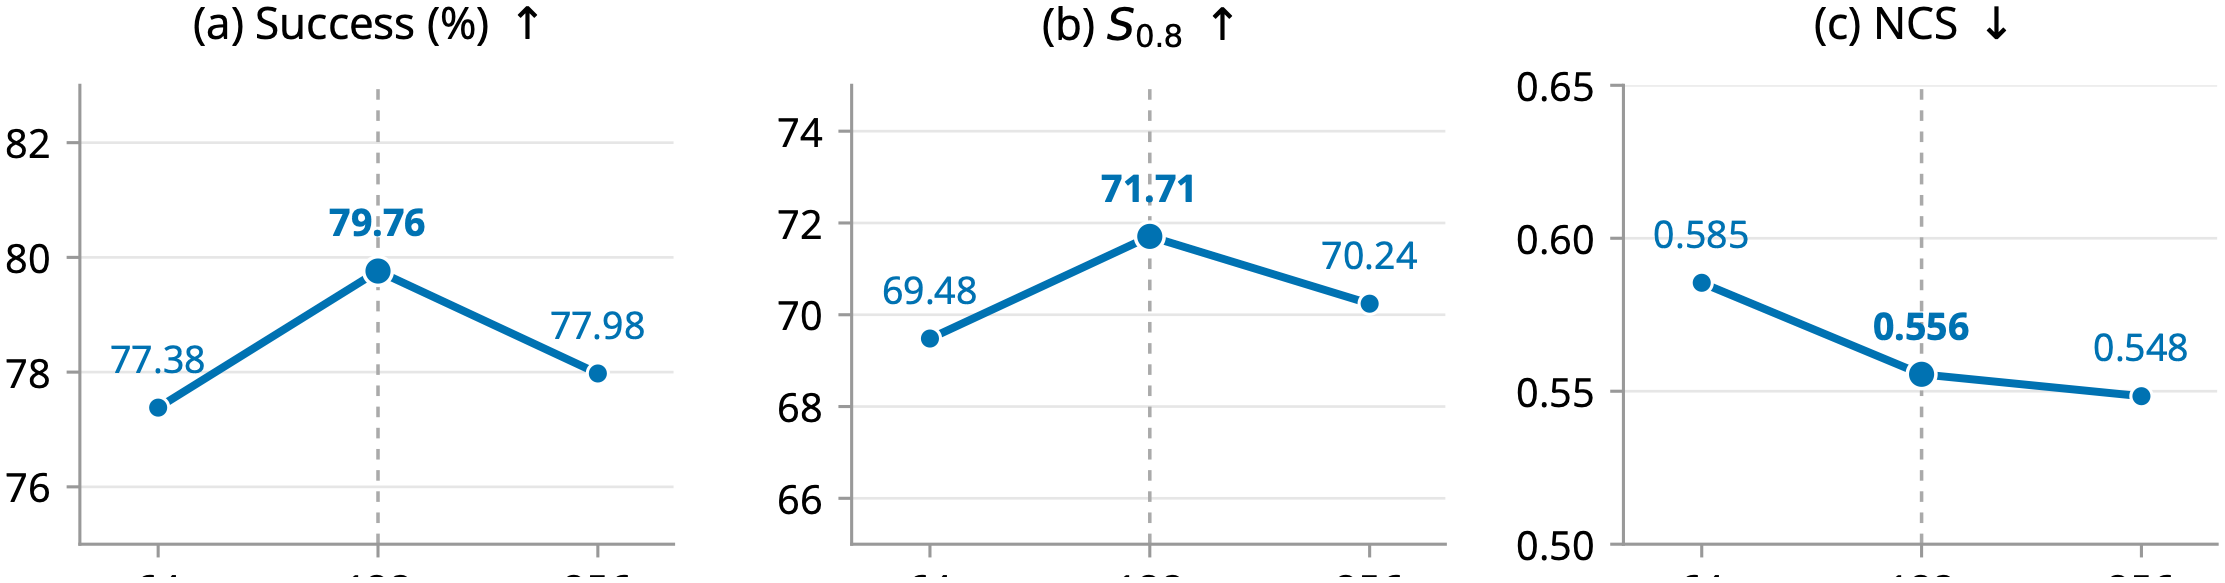
图 8|AppWorld 配 Claude 的状态容量扫描:64、128、256 个代理 token 对应成功率 77.4%、79.8%、78.0%,NCS 0.585、0.556、0.548;128 是成功率的峰值,64 token 的截断次数高达 284 次。
控制状态容量在 64、128、256 之间,成功率是 77.4%、79.8%、78.0%,NCS 是 0.585、0.556、0.548。128 是成功率的峰值,256 的 NCS 最低但成功率回落,64 则因为频繁截断而明显吃亏(284 次截断对 48 次)。
指标权重也做了扫描:Sα 里的成功率权重从 0 到 1 变化,NCS 里的 token 权重从 0 到 0.75 变化,CarryOn 的平均 Sα 始终最高、平均 NCS 始终最低。这说明它的领先不是靠某一组权重挑出来的,但这只是同一批 run 的重加权,不是新的实验。
保留错了会怎样:丢一条 ID,和丢两个字段
结论:保留错的代价不是「答得差一点」,而是「动作本身做错」。论文没有单列失败分析章节,下面这些证据来自它的对比案例、消融和局限说明,我按「丢关键约束」和「留噪声」两类整理。
先看最直接的一组对照。同一个任务,压缩摘要与原文证据的差别不在措辞,而在「九条里的哪几条」:
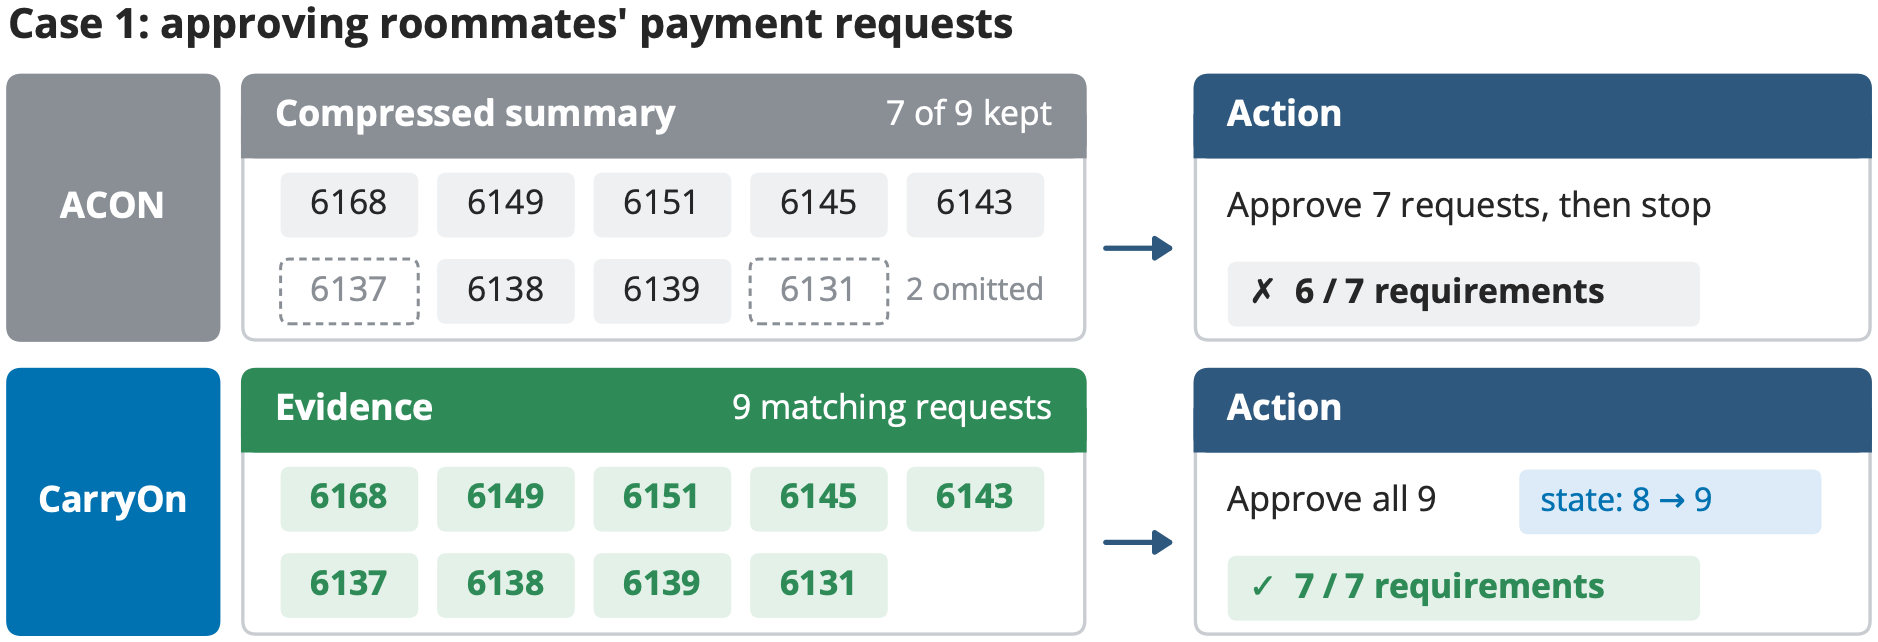
图 9|同一个 AppWorld 任务上 ACON 与 CarryOn 的对照:ACON 的压缩摘要只留下九条合格请求中的七条,漏掉 6137 与 6131,动作批准七条、七项要求过六项;CarryOn 保留完整九条,全批、七项全过,并把状态里的数量从 8 改成 9。
Case 1:九条合格请求,摘要只留下七条
任务是批准本月室友发来的所有付款请求。47 条待处理里有 9 条符合条件。ACON 的压缩摘要保留了 7 条,漏掉 ID 6137 和 6131;Actor 批准了剩下的 7 条就停了,七项要求过了六项。CarryOn 把过滤后的九条 ID 列表整段留作证据,并且把状态里的预期数量从 8 改成 9,最后九条全批,七项全过。
这个案例的关键不是「摘要不好」,而是「摘要把可验证的清单变成了不可验证的概括」。当九条 ID 变成「若干条符合条件的请求」,Actor 就失去了核对的依据:它无法知道自己是漏了两条,还是本来就只有七条。CarryOn 保留的是清单本身,所以数量对不上时能自我纠正——状态从 8 改成 9 这个动作,就是证据反过来修正状态的例子。
Case 2:标签与置顶被过滤掉
任务是把昨天的习惯记录复制成今天的新 note,只改「自制餐」这一项。SWE-Pruner 在剪枝时把 tags 和 pinned 两个字段过滤掉了;Actor 把餐食那一项改对了,但创建新 note 时没带这两个字段,九项要求过了七项。CarryOn 保留原始 note,连字段一起复制,九项全过。
这类失败最隐蔽:动作看起来完全正确,参数也填了,只是少了两个「不影响语义」的字段。如果没有逐字段的评测,这种错误在线上会一直存在,而且很难归因到上下文管理。
Case 3:答案检查也会被上下文拖累
第三个案例是往一个按时间倒序排列的支出 note 里加本月支出。CarryOn 保留原始 note,把新月份插在标题正下方,十项全过;ACON 也把 note 更新对了,但最后一步的答案检查没过,九项过十项。
这个案例说明「保留原文」不只影响工具参数,也影响最终答案的格式与位置。摘要能保住语义,但保不住「标题下面第一行」这种结构信息。
把噪声留下来:8.549 倍的代价
另一侧的失败是留得太多、太杂。Retrieval 在 AppWorld 配 Claude 上成功率只有 11.9%,NCS 高达 8.549——每成功一次花的资源是全上下文的 8.5 倍。原因不复杂:它每次按相似度取四条历史交互,取到的常常是语义相近但值不对的记录,Actor 于是在错误的值上反复试错,调用数冲到 7,284 次。
FIFO-5 是另一种留错:只留最近五组,成功率 42.9%,NCS 1.592。它不缺噪声,缺的是早期约束;一旦第 9 步的账号滑出窗口,后面只能重新查,或者猜。
把这两侧放在一起看,上下文管理的目标不是「越短越好」,而是「让该在的那条在,不该在的那条别占位」。短只是结果,不是目标。
状态记错也会传导
还有一个容易被忽略的失败模式:状态本身写错。CarryOn 的 Case 1 里,状态一开始记的是 8 条,实际是 9 条;如果不修正,Actor 会按 8 条去核对,最后仍然漏一条。论文的提示词里专门要求「不要把即将执行的动作标成已完成」「工具回执只证明这一次操作,不证明全部要求」,就是在防这类状态污染。
同理,如果证据被误读——比如把卡号的后四位当成完整卡号——错误会直接进入工具参数。论文在局限里承认:缺失或误读的证据会导致错误动作,部署时需要用户确认关键操作。
局限与失效场景
结论:这篇论文的结论在「文本交互、工具接口稳定、能拿到成功轨迹」这三个前提下成立;离开这三个前提,收益会明显缩水,论文自己也把大部分边界写进了 Limitations。
只有文本、只有三个基准、每个基准一个选择器
三个基准都是文本交互。论文明确说,扩展到视觉或多模态观察,需要重新设计证据的表示和选择方式——图像片段怎么切、来源怎么引用、相关性怎么打分,都不是现成答案。
更实际的限制是「每个基准训练一个选择器」。跨 Actor 复用是成立的,但跨环境复用没有验证。换一套工具接口、换一种观察结构,选择器就要重新收集成功轨迹、重新标注、重新训练。论文把这一点写成「泛化到新环境仍有待探索」。
峰值输入可能更高,NCS 也可能大于 1
论文附录 E 承认,在 Tau2 上 CarryOn 的平均峰值输入高于全上下文。原因是它保留了固定预算的证据包,而 Tau2 的对话在某些 run 里很短,全上下文的峰值反而不高。这意味着「上下文管理」不保证每次调用的输入都更小,它保证的是「在需要长历史时,输入不随步数线性爆炸」。
NCS 也一样。AppWorld 配 Qwen 的 1.634、Tau2 配 Claude 的 1.121,都高于全上下文的 1.000。成功率的提升是真的,单位成功的成本也真的更高;这两件事可以同时为真。
单一 run、没有误差棒
论文写明「每个设置只跑一次」,没有报告方差。九个设置的平均值能说明趋势,但不能说明某一格的 0.6 个百分点差距是否显著。AppWorld 配 Claude 的 79.8% 对 79.2%,只差 0.6 个点,这种差距在单次运行里基本无法区分。
对于要拿这套方法做决策的团队,这意味着:主表的方向可信,单格的微小胜负不可信。读主表时至少要打四个折扣:
- 单次运行的方差未知,0.6 个点的差距不能当结论。
- 九个设置等权平均,OfficeBench 只有 95 个任务,权重却和 168 个任务的 AppWorld 一样。
- S0.8 的 0.8 是人为选的权重,论文只验证了排序在权重扫描下稳定,没有验证这个绝对值的含义。
- 选择器的训练依赖成功轨迹,线上成功率本来就低时,正例会明显变少。
敏感信息与错误证据
保留原始观察意味着保留账号、卡号、地址、对话记录。论文在局限里写得很直白:真实部署需要对存储的历史做访问控制,对后果严重的动作要求用户确认。这不是一句套话——CarryOn 的设计天然把「原始证据」放在可回查的位置,一旦 archive 泄露,泄露的是原文而不是摘要。
另一侧是错误证据的放大:摘要错一次,可能只是丢一个细节;原文错一次,Actor 会当成事实去执行。两种错误的性质不同,防护手段也不同。
CarryOn-E:9B 本地部署的 47.0%
论文还给了一个本地部署的扩展:把 Qwen3.8-27B 的 CarryOn Actor 蒸馏到 Qwen3.5-9B,选择器和保留策略不变。结果是在 AppWorld、OfficeBench、Tau2 上分别是 47.0%、46.3%、67.5%,训练累计耗时 54.00、23.06、54.28 小时(单卡 H100)。
这个数字要放在正确的参照系里看:同基准下 27B 的 Qwen Actor 是 84.5%、66.3%、90.0%。9B 学生保留了「状态加证据」的接口,但能力差距仍然很大。论文把它定位成「本地部署的一个选项」,不是「用小模型替代大模型」的证明。
落地判断:什么团队该试,什么团队先别碰
结论:如果你的 Agent 有大量工具调用、需要精确 ID 或字段、任务动辄二三十步,CarryOn 的分工值得直接借用;如果你的场景是多模态、工具接口频繁变、或者拿不到成功轨迹,先别整套上。
值得试的三个信号
- 任务里反复出现「第 N 步拿到的值,第 N+K 步才用」。这是片段级证据最直接的收益场景,也是整步选择最容易浪费 token 的场景。
- 失败往往表现为「少了一个参数」「漏了一条记录」,而不是「推理方向错了」。这类失败用状态加原文证据能救,用更强的模型不一定能救。
- 你已经有成功轨迹的日志,或者愿意用一次强模型做离线注释。选择器的训练成本是单卡 H100 上的数小时,不是数周。
先别碰的三种情况
- 观察以图像、音频、视频为主。论文没有验证多模态,片段怎么切、来源怎么引用都要重新设计。
- 工具接口每个季度都换。选择器是按基准训练的,接口一变,监督信号的可迁移性没有保证。
- 对峰值输入或延迟有硬约束。CarryOn 的平均 token 可能更低,但峰值输入可能更高,扩容还会临时超出基础预算。
最小可行改造:先把五个字段写上
如果只想拿走一个部件,就拿状态。消融里去掉 MEMORY 掉 13.7 个点,是所有变体里最大的一项,而它的实现成本最低:在系统提示里加一段格式约束,要求 Actor 每轮输出 done、open、next、answer_mode、known_apis 五个字段,长度控制在 128 个 token 左右,并明确要求「不要把长 ID、列表、回执抄进状态」。
第二步才是证据选择。先做「原文片段加来源引用」,用最简单的相关性排序填预算;等有了成功轨迹,再训练下一步使用概率和临时扩容。这个顺序的好处是每一步都能单独验证:状态有没有减少「忘了下一步」,证据有没有减少「参数填错」。
还有一笔账要算进去:选择器是 0.6B 的模型,每次决策都要跑一遍重排序,这是额外的一次本地前向。论文的 token 统计只算发给 Actor 的系统请求,选择器自己消耗的 token 被明确排除在外。所以表里的 0.792 是「Actor 侧的成本」,不是「整个系统的成本」;真实部署时要把这层本地推理和它的显存、延迟一起算。
术语速查表
| Actor | 执行任务的 LLM,本文指 Claude Sonnet 5、Qwen3.8-27B、Gemma-4-31B | 真正动手调工具的那个模型 |
| MEMORY | 128 个代理 token 的紧凑控制状态,含五个字段 | 贴在屏幕边上的便签 |
| 控制状态 | done、open、next、answer_mode、known_apis | 走到哪、还差什么、下一步做什么 |
| 证据单元 | 观察里的一条细粒度片段,带原文、来源引用和产出动作 | 从工具回执里剪下来的一行 |
| 选择器 | 0.6B 的 Qwen3-Reranker,输出相关性分与下一步使用概率 | 决定这一步带哪几行的图书管理员 |
| 基础包 | 在 16,384 字符预算内按相关性排序选出的证据集合 | 常规工作集 |
| 临时扩容 | 使用概率超过 0.5 的片段被额外加入,可超出基础预算 | 临时插队的那一条 |
| 近窗 | 始终保留的最近交互,非法动作时扩展到两组 | 手边最近发生的几件事 |
| TGC | 任务目完成率,等于成功数除以总数 | 成功率 |
| S0.8 | 八成看成功率、两成看成本折扣的综合分 | 既看对不对也看贵不贵 |
| NCS | 每次成功消耗的调用与 token,对全上下文归一化 | 成功一次的相对价钱 |
| CarryOn-E | 把 27B Actor 蒸馏到 9B 的本地部署版本 | 小模型加同一套上下文管理 |


评论前必须登录!
注册