 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
AI越强,数据产品越没用?可能恰恰相反
模型越来越强,企业数据却依然"连不上、信不过"。一个老问题正被 AI 重新放大:为什么数据平台越成功越臃肿?新需求越做越慢?另一个流行误解是——有了强模型,数据产品是不是就没用了?面对此类困扰,我们不妨从下面这个问题开始思考:我们手里的数据,究竟是业务的副产品,还是被认真设计和运营的产品?
01 一个老问题:平台越成功,为什么越难以为继?
即便我们先不谈 AI。现在不少数据团队都经历过这样的循环:
平台刚上线时又快又好用,业务方排着队来接数;接入的数据和用户一多,接口越叠越厚、口径越理越乱,新需求越做越慢,最后平台陷入"维护成本高、演进速度慢"的泥潭。
颇具讽刺意味的是,那些为企业创造最大价值、最成功的数据平台,往往最先撞上瓶颈。 成功带来规模,规模推高复杂性,复杂性最终拖慢平台本身——这条走向自我消耗的路径,常被称为"失败循环"。
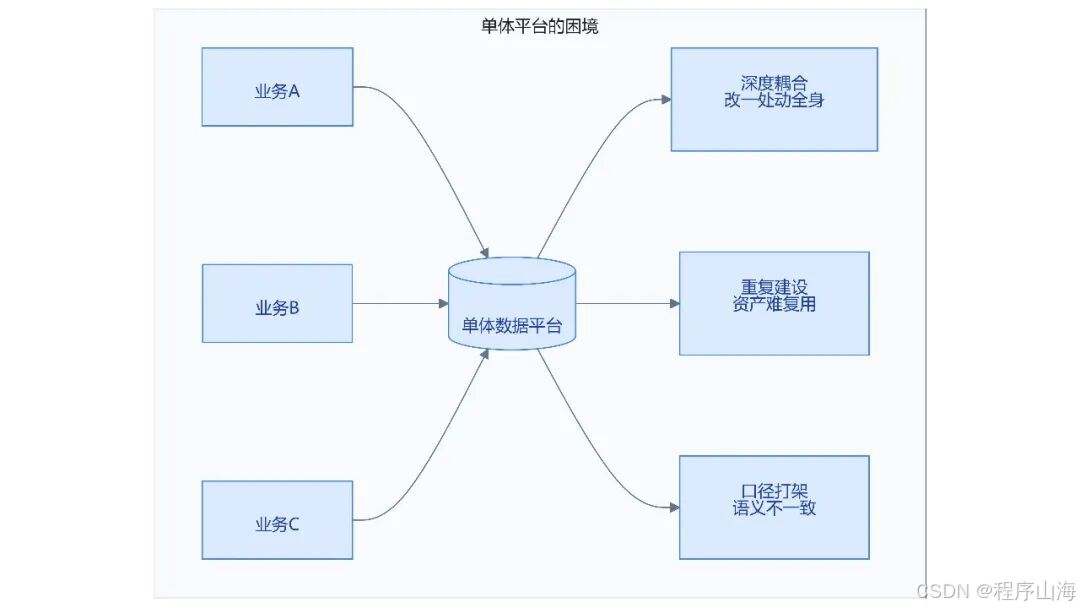
问题的根子往往不在工具,而在架构思路:所有数据被堆进一个庞大的单体平台,模块深度耦合,改动一处牵动全身;新业务用例倾向从零取数、从零建模,已有数据资产很难被复用。于是规模越大,负担越重。
02 新流行的误解:AI 越强,数据产品越没用?
随着 Agent、NL2SQL、RAG 走向企业场景,一种看法开始流行:既然模型足够强,把原始数据直接喂给它就行了,先做数据产品化、数据治理是不是多余?
这个判断,很可能把方向搞反了。
模型不会消除数据问题,它只是把"人读不懂"变成了"Agent 用错"。 过去口径不一致、元数据缺失、数据孤岛这些问题,至少还要经过人这道关卡;而当 Agent 自动找数、自动取数、自动编排下游流程时,一次错误被放大的速度只会更快:
- 同一指标在不同系统里口径打架,模型只能在多个语义之间猜测,结果看似流畅,实则错误;
- 缺少元数据和业务上下文,Agent 找不到正确的数据,或组合了错误字段;
- 数据重复、孤岛并存,模型拿到的是互相冲突的几个版本;
- 模型越强、自动化环节越多,错误向下游传导得越快、越难追溯。
今年以来的产业动向,其实指向同一结论:AI 的瓶颈正从模型转向数据与知识。语义层被陆续引入 AI 分析链路,沉淀业务术语、指标口径与规则;Gartner 预测到 2029 年将有七成企业部署专为 AI 推理和 RAG 知识库设计的专用数据存储;图智能等技术则在为 Agent 提供一层连接业务数据、流程与关系的共享知识层。企业 AI 投入的重心,也在从"选模型"转向"底层知识体系怎么建"。
换句话说,AI 不仅没有让数据产品变得多余,反而抬高了对它的要求:数据必须可被发现、可被信任、可被组合,并且带着模型能理解的语义上下文。模型负责推理,而可信、有序、可复用的数据基础,决定了推理能不能落地。
03 回到方法论:把数据当作产品来管理
这些问题,在《数据即产品》这本书里,是从范式层面被系统回答的。
 核心是一次观念转换:数据不是业务运转之后剩下的副产品,而是需要被设计、被运营、对消费者负责的产品。这不仅是技术改变,更涉及团队分工、数据所有权与治理方式的调整。
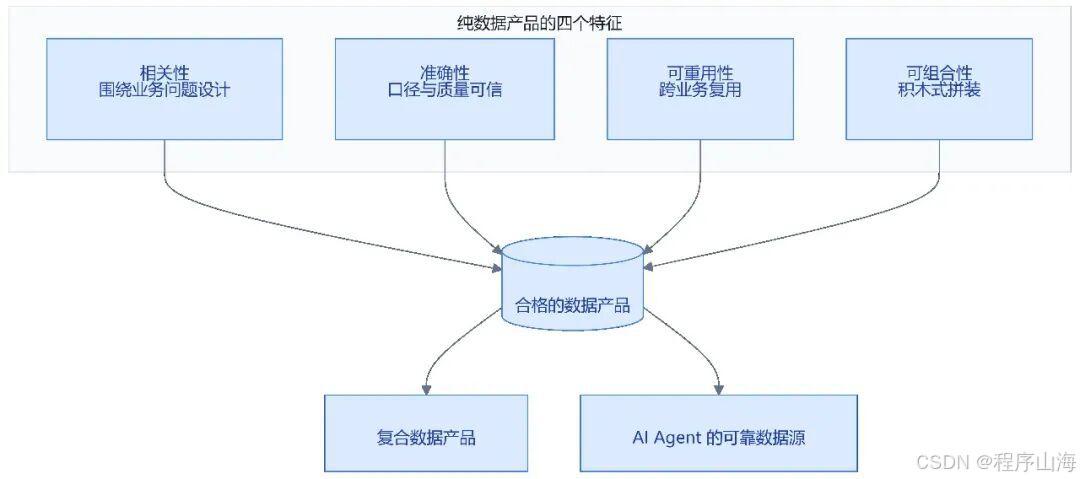
书中把一个合格的纯数据产品概括为四个特征:
- 相关性:围绕明确的业务问题和消费场景设计,而非为存而存;
- 准确性:口径与质量可信,可被依赖;
- 可重用性:不绑定单一业务,能被多个消费者复用;
- 可组合性:多个产品像积木一样,拼成更复杂的复合数据产品。
 支撑这套范式的是三条原则:模块化、可组合性、可持续性——把复杂性分解并隔离成更小、可管理的单元,让已交付的数据沉淀为可灵活重组的"构建块",使平台复杂性随规模增长而保持稳定。
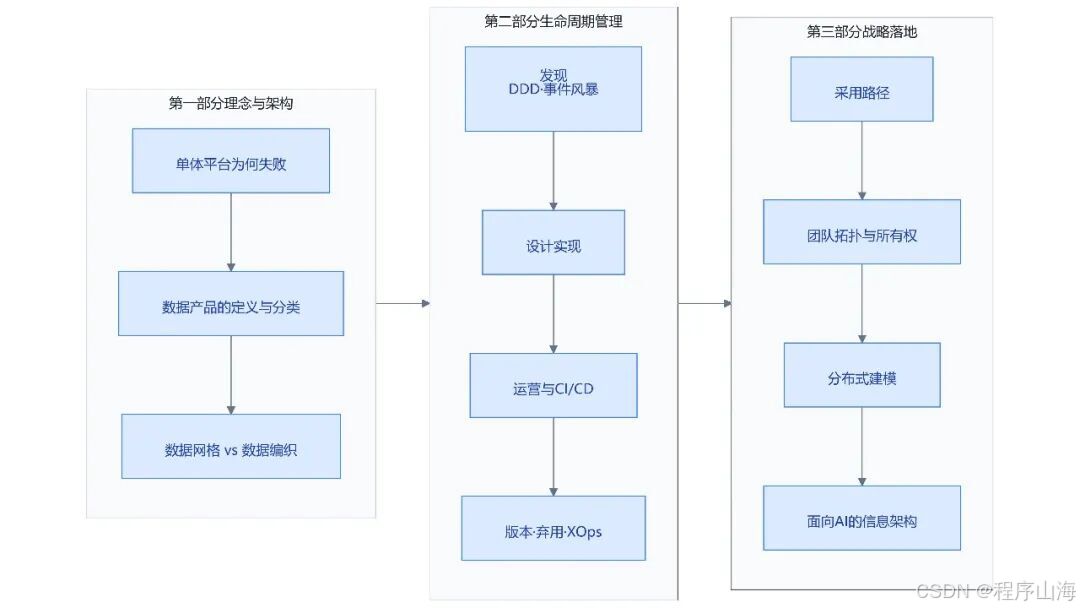
全书分三部分展开:
- 理念与架构(第 1–3 章):剖析单体平台失败的根因,定义数据产品的结构与分类,并横向对比数据网格、数据编织等主流方法的适用边界;
- 生命周期管理(第 4–7 章):从业务战略出发,借领域驱动设计与事件风暴发现产品;再到设计实现、CI/CD 运营、版本与弃用,以及 XOps 自助平台对开发者、运营者和消费者三类体验的支撑;
- 战略落地(第 8–12 章):范式采用的阶段路径、团队拓扑与数据所有权、分布式建模,以及面向 AI 的信息架构。
值得一提的是第 11 章:共享的概念模型(企业本体)保证数据产品间的语义互操作,数据平面与知识平面链接成企业知识图谱——这与当下"为 Agent 建共享知识层"的趋势正好呼应。
 作者在收尾处提醒:做反思型实践者而非教条主义者;聚焦整体系统而非局部组件;为扩展而去中心化,而非为去中心化而扩展。
- 适合谁读?
数据工程师、架构师、数据产品经理、CDO 与企业数字化负责人,以及关注数据治理与数据资产化的专业人士。本书从业务视角切入,不绑定特定技术栈,没有某一具体技术背景也能读懂。
《数据即产品》: JD:https://item.jd.com/14801759.html


评论前必须登录!
注册