 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
引言
有一个信号,五分位单调递减,置换检验 p<0.001,“留一年”检验 9 次全部保持为负。在量化研究里,这几乎是“挖到金矿”的标准像。
我把它做成策略,年化收益是 −2.34%。
这个矛盾逼我停下来查根因。查出来的东西比信号本身值钱得多——它让我发现,过去 30 多轮实验里,我至少五次差点被统计学的假象骗过去,其中两次已经写进了“结论”,一次差点被当成“策略有效”发布。
这篇文章不复盘策略,只复盘那五个陷阱。它们不限于金融:任何做数据分析的人,只要你在跟时间序列、分组比较、回测或 A/B 测试打交道,都会撞上同款。
如果说数据是原材料,那么统计检验就是一把尺子——问题是,有些尺子只有“看多”刻度,有些尺子量的是日历,不是市场。
前置知识
买入持有(Buy & Hold):买入后不再交易,收益完全来自标的本身涨跌与分红。
全收益指数 vs 价格指数:前者含分红再投资,后者只反映价格变动。A 股宽基指数两者年化差约 2.5 个百分点。
置换检验(Permutation Test):打乱标签重算统计量,看真实值在随机分布中的位置,p 值即“随机也能这么极端”的概率。
有效样本量(n_eff):重叠样本会虚增样本数。用日频数据预测未来 N 天,独立样本约等于总样本数除以 N。
回测口径:调仓频率、再平衡假设、费用计算方式,三者合起来决定回测数字是否可信。
第一章:陷阱一——尺子只有“看多”刻度
核心问题:你收集了 13 万条数据,结果发现它们说的是同一句话。
1.1 一个“喂给模型 13 万条研报”的实验
我做的第一件事很直觉:把 2018 年以来的券商研报全部抓下来,用词表情绪法给每条打分,然后预测次日涨跌。数据量 138,023 条(去重后),覆盖 2018~2026 年。
结果出来,准确率 34.5%。我一开始以为模型有问题,直到我算了“永远猜涨”的基线——也是 34.5%。两者一模一样。情绪分与次日收益的相关系数 0.006,约等于零。
1.2 根因不在模型,在数据源头
我去翻了研报评级的分布:
| 买入 | 71.9% | 约 99,238 |
| 增持 | 22.6% | 约 31,193 |
| 中性/其他 | 约 5.5% | 约 7,578 |
| 卖出 | 约 0.01% | 14 |
13 万条研报里,“卖出”只有 14 条。这不是我的数据抓漏了,是卖方研究本身的结构性偏向:分析师几乎从不写“卖出”。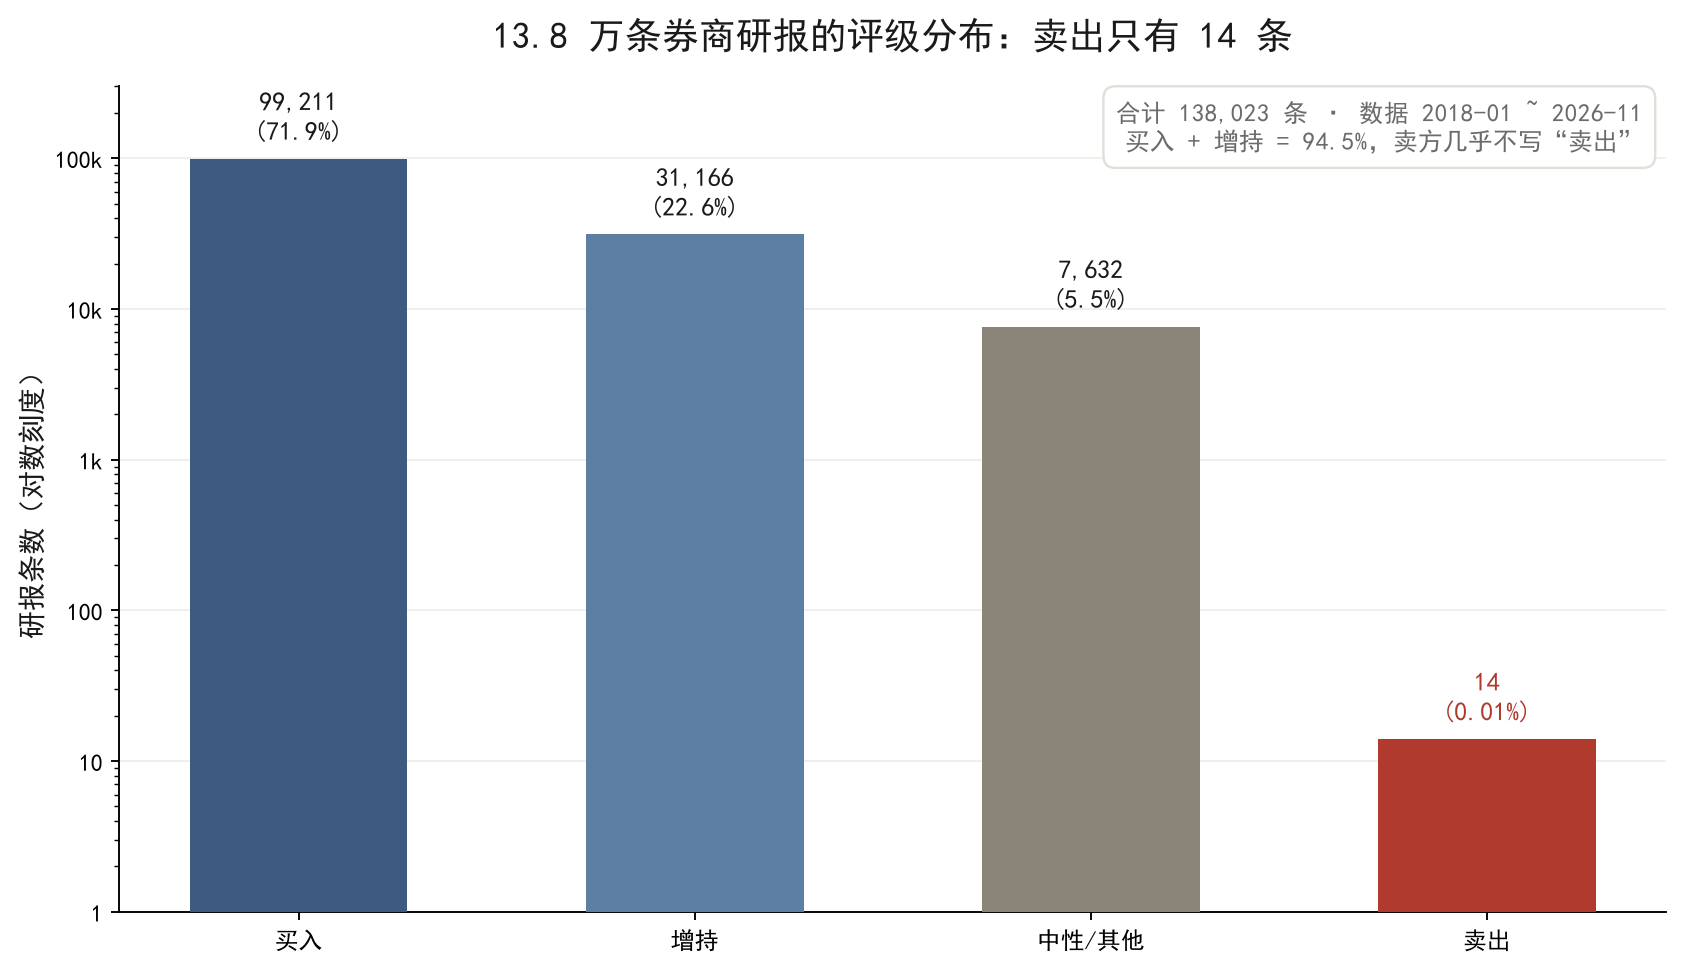
1.3 可迁移的教训
数据的结构性偏向,比模型选择更决定结果。 拿一把只有“看多”刻度的尺子去量市场,测出来的东西当然和市场无关。这不是金融独有的问题:用户评分只有五星没有一星、客服记录只留投诉不留表扬、传感器在量程端点饱和——任何“单侧截断”的数据,都会让下游模型看起来“不工作”,而真正的问题在上游。
不是模型不聪明,是数据从源头就没有区分度。
第二章:陷阱二——基准不同口径,赢了也是输
核心问题:你一直在跟一个错误的基准比,而且它不会报错。
2.1 一个不会报错的错误
早期回测里,我拿“不含分红的价格指数”当基准,却用“含分红的基金净值”算策略收益。听起来是个低级错误,但它极其隐蔽——代码跑得通,曲线画得出,结论看起来也合理。
修正基准后,同一段区间的买入持有年化从 1.72% 变成 4.24%,差价 2.52%/年,全是分红。一改基准,原来“跑赢”的策略全部由赢转输。
更狠的是成本墙。场外基金 7 天内赎回费 1.5%,如果每天调仓,年化摩擦成本 28.7%~188.6%——收益还没开始算,本金先被费用吃掉。
2.2 用代码把“口径”钉死
下面这段不是收益曲线,是“口径自检”的通用写法:同一段逻辑,换一个基准列,结论就可能反转。
python
# 基准口径自检:价格指数 vs 全收益指数
# 关键:策略收益和基准收益必须来自同一口径
price_ret = price_index.pct_change() # 不含分红
total_ret = total_return_index.pct_change() # 含分红再投资
# 买入持有年化(复利口径,非对数)
def annualized(ret):
return (1 + ret).prod() ** (252 / len(ret)) – 1
print("价格指数口径:", annualized(price_ret)) # 约 1.72%
print("全收益口径: ", annualized(total_ret)) # 约 4.24%
# 同一策略,换个基准,超额从正变负
2.3 可迁移的教训
基准不公平会让所有结论作废,而且不会报错。 做任何对照实验,先问三件事:对照组和实验组是不是同一口径?费用算没算进去?空仓收益按什么利率计?我在项目里犯过两次“cash 基准不同口径”的错:策略空仓吃短债 1.58%,买入持有吃全债 4.54%,直接比会得出完全反向的结论。
基准错了,后面全错,而且安静得可怕。
第三章:陷阱三——核心假设从没被正面检验
核心问题:优化了 13 轮,优化的可能是一个从未验证过的错觉。
3.1 波动率目标化:听起来很对
思路很直观:波动率高时减仓,波动率低时满仓。市面上常见,逻辑上也说得通。我围绕它做了 13 轮迭代——换锚、加闸门、状态机、核心-卫星、风险预算——年化从 6.22% 微调到 6.35%,回撤基本没动。
13 轮,听起来很努力。但有一个问题我一直没正面回答:“高波动预示下跌”这个核心假设,到底成立吗?
3.2 正面一查,假设在近十年失效
用 21.85 年数据算“高波动”与“未来下跌”的相关性:2008 年那波确实相关,系数 0.758;但 2016 年之后掉到 0.295。这个策略赖以生存的核心假设,在最近十年基本失效了。
再看策略解剖:它 83% 的时间是满仓、平均仓位 94%——大部分时候它就是买入持有。那 17% 的减仓有用吗?减仓日次日平均比满仓低 0.058%,置换检验 p=0.251,不显著;21 次减仓事件后 20 日平均涨 +0.37%,反而高于全样本的 +0.24%。减仓砍在了上涨前。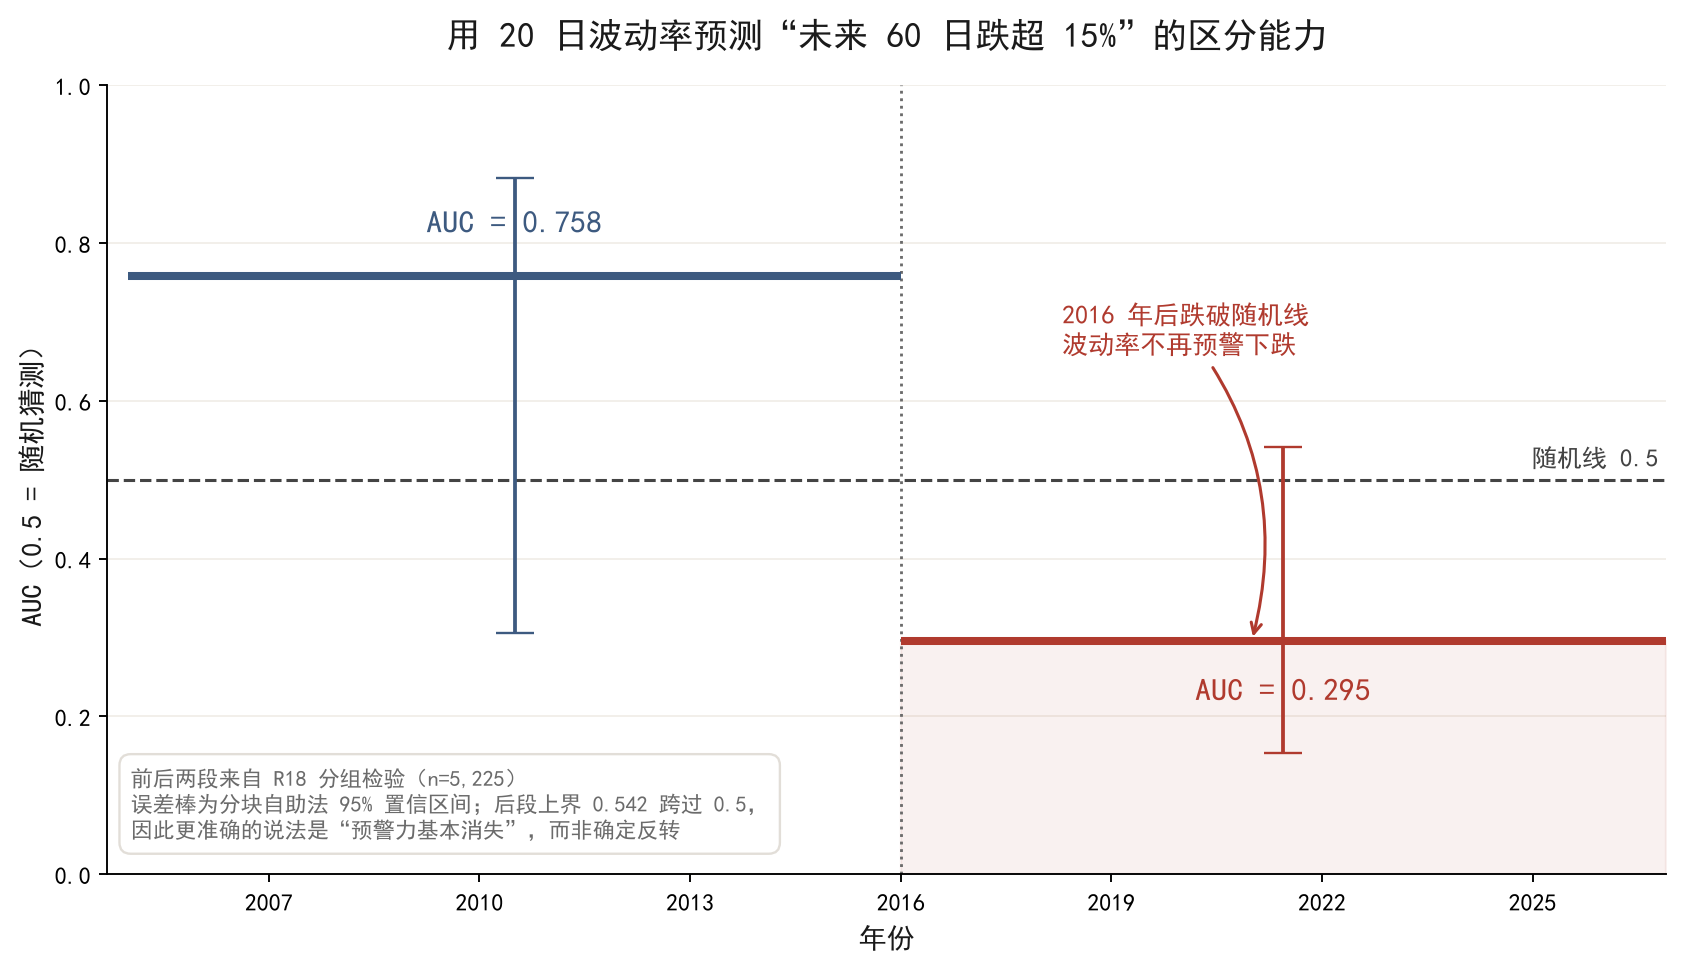
3.3 可迁移的教训
如果核心假设没被正面检验过,优化 13 轮也只是在原地打磨一个错觉。 这在工程里同样常见:调了 20 版参数,却没验证过“这个指标和业务目标到底相不相关”。先验证假设,再优化参数。
优化之前,先问一句“我这个策略赖以生存的假设,最近还成立吗?”
第四章:陷阱四——p<0.001 挡不住季节性混淆
核心问题:统计显著 + 滚动稳定,仍然可能是一个日历假象。
4.1 一个“好得吓人”的信号
换思路:研报数量本身能不能预测?信号 = 近 5 日研报量 / 近 250 日均量。
结果好得吓人:五分位单调递减(Q1 +0.62% → Q5 −0.55%),置换检验 p<0.001,“留一年”检验 9 次全部保持为负。按任何常规标准,这都是一个真信号。
但做成策略,年化 −2.34%。信号显著,策略亏钱——这个矛盾逼我去查极值出现在哪。
4.2 真相:峰值全在披露截止日
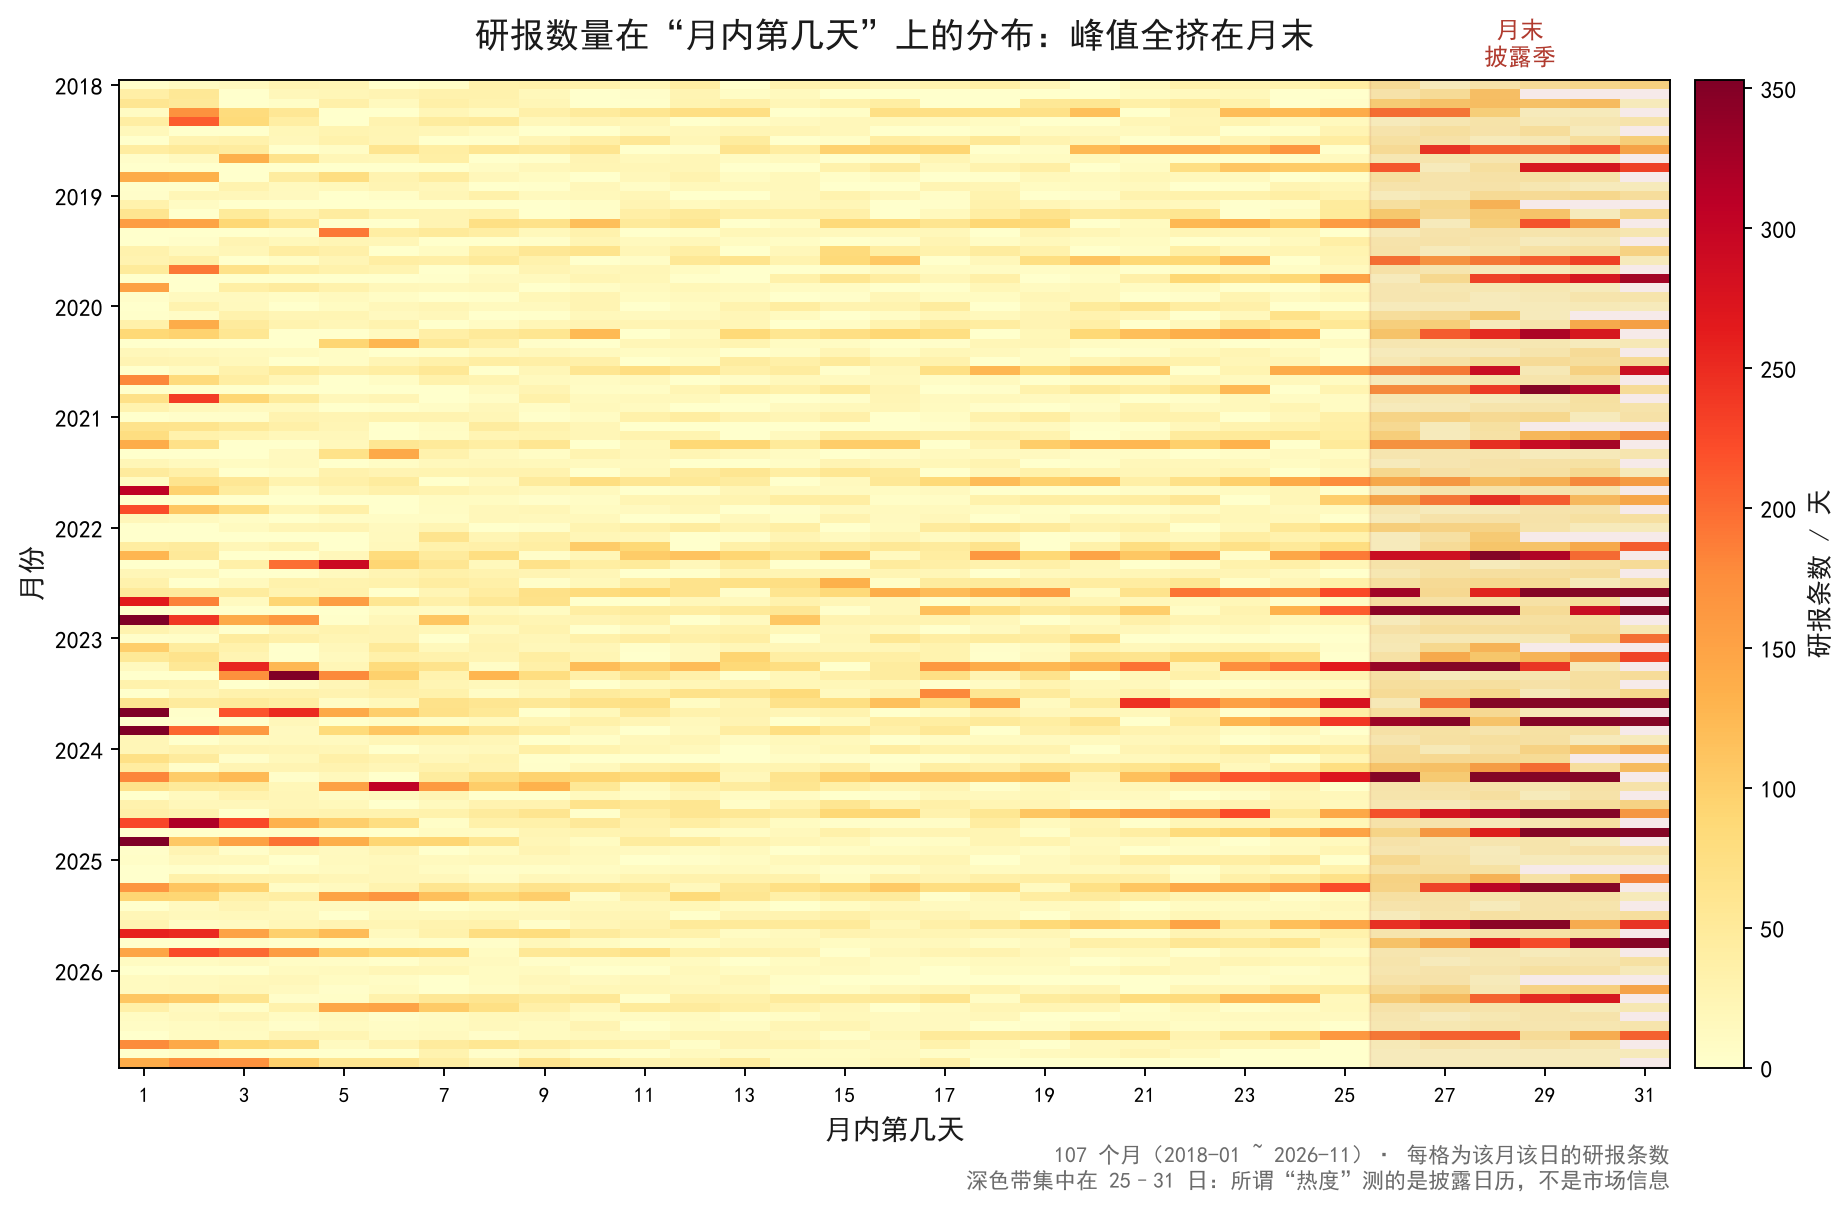
研报量有强烈的季节性,高峰全在月末。最忙的 5 天是 2023-05-04(576 条)、2024-10-31(552 条)……全是年报/季报披露截止日。而策略正在月末取信号,所谓“热度分位”测的其实是“这个月末赶没赶上披露季”。
去季节性后,方向直接翻转:未去季节 −1.15pp → 去季节 +0.55pp。信号不存在。
4.3 用代码问“极值出现在哪些日历位置”
python
# 发现季节性混淆的最小检查:看信号极值的日历分布
# 不要只看 p 值,先看极值落在哪
sig = report_count.rolling(5).mean() / report_count.rolling(250).mean()
# 取信号最高的 5 天,打印日期和条数
top5 = report_count.loc[sig.nlargest(5).index]
print(top5)
# 输出会显示:2023-05-04(576), 2024-10-31(552), …
# 全是月末披露截止日 -> 信号测的是日历,不是市场
# 去季节性:按“月末/非月末”分层后再检验
sig_deseason = sig.groupby(sig.index.is_month_end).transform(lambda x: x – x.mean())
4.4 可迁移的教训
“p<0.001”和“留一年 9/9 稳定”都挡不住一个结构性混淆。 要发现它,必须问“这个信号的极值出现在哪些日历位置”,而不是只看统计显著性。任何有周期性的业务数据——电商大促、财报季、周末效应——都可能把日历伪装成信号。
显著性回答的是“随机能否解释”,回答不了“是不是日历在解释”。
第五章:陷阱五——回测口径幻觉:逐日调仓 vs 月末调仓
核心问题:一个“多久调一次仓”的参数,能差 9 倍收益,而且不报错。
5.1 反向实验的漂亮数字
既然减仓砍在上涨前,“波动高就加仓”是否就对了?第一版按“每天算仓位”回测:年化 +2.27%,曲线很漂亮。
但这是逐日调仓,隐含一个现实中不存在的假设——每天调仓不花钱、不滑点、不设赎回费。换成真实的月末调仓口径,同一策略变成 +0.25%——差了 9 倍,差别全在“多久调一次仓”。
5.2 重叠样本再把显著性虚增一次
还有一个更隐蔽的口径问题:用 5,000 根日线预测未来 60 天,独立样本只有约 87 个(n_eff = 5000 / 60)。如果按 5,000 个样本来算 p 值,显著性会被系统性高估。波动率五分位对未来 20 日收益完全不单调,置换检验 p=0.999——判死。
python
# 有效样本量折算:重叠样本不能当独立样本用
n_raw = 5000 # 日频样本数
horizon = 60 # 预测未来 60 天
n_eff = n_raw / horizon # 约 87 个独立样本
# 用 n_eff 而非 n_raw 去查显著性阈值,否则 p 值会被高估
5.3 可迁移的教训
回测口径就是策略的一部分。 调仓频率、再平衡假设、费用模型,三者任一不同,结论就可能反转。做任何“历史回放”类评估——推荐系统离线回测、A/B 实验历史重放——都要先钉死口径,再谈效果。
逐日调仓的回测,隐含的是“每天免费再平衡”——现实里没有这种好事。
总结
这个项目最后没有做出能赚钱的策略。但 30 多轮实验留下的不是一条收益曲线,而是一套“怎么发现自己被骗”的检查清单。数据量从 13 万条涨到 37 万条,真正稀缺的从来不是数据,是纪律。
三个关键点:
先看数据分布,再看模型效果:13 万条研报只有 14 条“卖出”,尺子只有看多刻度,模型再换也没用。
先验证核心假设,再优化参数:13 轮优化之前,高波动与未来下跌的相关性已经从 0.758 掉到 0.295。
先钉死统计口径,再相信显著性:基准口径、调仓频率、有效样本量,任一个不同,p<0.001 都可能翻转。
“数据不是不够多,是不够有用;显著性不是不够强,是没问对问题。”
本文所有数字来自项目实际运行结果,文章为研究方法复盘,不构成任何投资建议。


评论前必须登录!
注册