 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
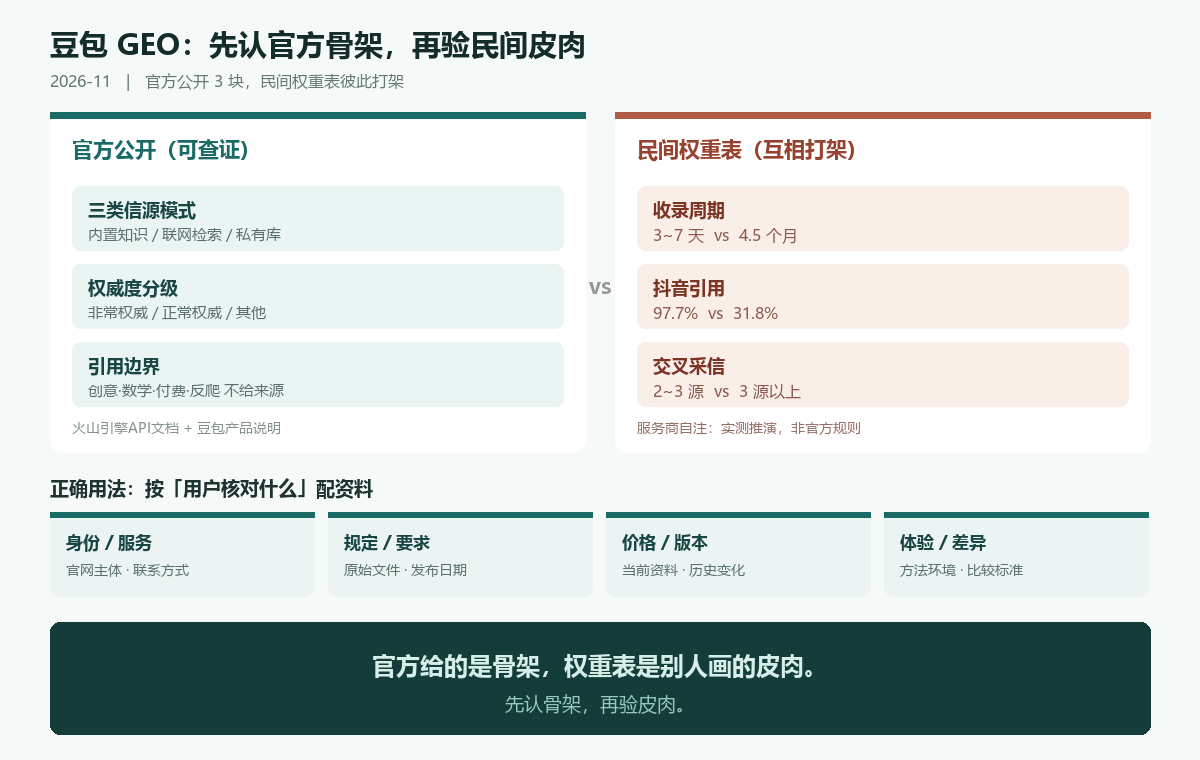
搜「豆包 GEO 权重」,你会看到一堆漂亮的数字:EEAT 占 30%、原创 25%、时效 20%;T0 政府官网 100% 强制采信、T1 字节生态 80~90%;抖音引用率 97.7%;收录 3~7 天;首发 24~48 小时是黄金窗口。问题在于——没有一张这样的表出自字节或豆包官方。多家发布这些数字的服务商自己就在脚注里写明「外部观测总结,不是官方发布规则」「具体权重属平台内部机制,以可观察现象描述」。本期不跟着复读这些表格,只做两件事:把官方真正公开过的东西摊清楚,再看那些民间数字到底能不能当你做内容的依据。豆包已是国内最大的 AI 搜索阵地之一(QuestMobile 2026 年 9 月数据:移动端独立 App 月活 4.19 亿、居 AI 原生 App 第一;第三方监测、不含网页与内嵌入口),所以这件事值得一次正本清源。
一、官方到底公开了什么:三块,都能查到
豆包没有放出算法白皮书,但产品侧的引用机制说明与火山引擎的搜索 API 文档是公开的,且两者口径一致。把能查证的部分归拢,只有三块:
| 信源模式(产品说明) | 模型内置知识(无引用标注,有知识截止边界)/联网检索(识别到时效、查证需求或用户主动开启 AI 搜索时调用豆包搜索,由火山方舟提供,答案附 [数字] 上标、可点击溯源)/企业私有知识库(豆包工作 / 企业版,检索飞书云文档与企业知识,遵循权限体系,不对外公开) | 先分清你要进的是哪一个池:公开网页进联网检索,内部文档进私有库,两者优化动作完全不同 |
| 权威度分级(火山引擎搜索文档) | 「非常权威」含政府、官方机构、主流官方媒体;「正常权威」示例含优质行业站点、中小企业 / 机构官网及部分认证作者;普通 UGC 另列。接口字段:Global 用 AuthorityLevel,Custom 用 AuthInfoLevel / AuthInfoDes,Custom 另有可选「非常权威」范围筛选 | 这是开发者搜索服务的公开能力,不是消费者 App 的逐行业权重;能用来判断「哪类资料配哪类事实」 |
| 过滤与引用边界(产品说明) | 过滤违法违规、低质广告、软文、恶意站点;政府官网 / 央媒 / 权威协会 / 学术期刊 / 官方公告设更高召回优先级,UGC / 普通博客 / 营销站更严格降权。创意写作、数学、翻译等一般不挂来源;私有 / 付费 / 需登录内容、反爬或 robots 限制的页面无法引用。标注引用≠豆包背书 | 它直接决定「什么内容做了也白做」——边界之外的形态,再优化结构也进不了引用 |
还有一条容易被忽略的时间线,能帮你判断哪些是老能力、哪些是近期新增:火山引擎 2025 年 9 月已有权威标签,2026 年 1 月加入权威分级搜索,3 月记录官网搜索与标签改进,8 月继续增加能力,10 月新增的是 Custom 版 ICP 备案筛选。注意——这些是搜索 API 的能力演进,不是豆包 App 的算法更新日志,两者经常被自媒体混着写。
二、民间权重表为什么不能当公式:数字自己就在打架
判断一套数字能不能用,有个简单办法:看不同来源给出的同一指标是否自洽。把最近几个月流传的豆包「权重」摆在一起,结论很清楚:
| 抖音引用占比 | 目的地 / 攻略类 97.7%;商品推荐「接近九成」 | 5 月 10.79% → 8 月 31.8%;App 端抖音域名 28.62%、Web 端 11.85% |
| 收录 / 首发周期 | 算法调整后「3~7 天」,首发 24~48h 黄金窗口 | 另两份观测写「平均 4.5 个月」「约 3~5 个月」 |
| 交叉采信门槛 | 至少 2~3 个独立异源一致 | 需 3 个以上独立权威渠道佐证 |
| 权重表本身 | EEAT 30% / 原创 25% / 时效 20% / 信源 15% / 地域 10% | 实体一致性 28% / EEAT 25% / 语义+结构化 20% / 时效 12% / LBS 10% / 其他 5% |
收录周期从「3~7 天」到「4.5 个月」差了一个数量级,两张权重表连维度都不重合,却都自称「当前最新」。这不是谁在撒谎,而是各自采样场景、入口(App / Web / API)、时间窗口和分类口径都不同——把任一张当通用公式,等于拿别人的单次抽样当你家的 KPI。更关键的是,发布这些数字的服务商大多自己标注了「实测推演、非官方源码」「信心指数 8 分」「机制细节待验证」。一句话:数字可以参考,但不能升格成规则。
三、那官方框架怎么用:按「用户核对什么」配资料
官方公开的是分级框架,不是权重公式;它的正确用法是做一个资料分工表——先看用户在核对哪一类事实,再给这类事实配对应资料,而不是列一份「统一发稿平台名单」。可直接照抄的分工如下:
| 企业身份与服务范围 | 当前官网主体、联系方式、服务说明 | 落在官方「正常权威」的机构官网档,是实体对齐的锚点 |
| 规定或行业要求 | 有效原始文件、适用范围、发布日期 | 政府 / 官方公告享更高召回优先级,转述不如原文 |
| 产品价格与版本 | 当前产品资料、资格条件、历史变化 | 价格类冲突易触发实体一致性降分,要能说明变化 |
| 真实使用过程 | 方法、环境、对象、时间明确的体验记录 | 对照参考「内容资讯、垂类专业站点」的正常权威档,条件写清才可被引用 |
| 多个方案的差异 | 比较标准、可核实事实、适用条件 | 比较是结构化抽取的高频形态,但要带标准与边界 |
配合这张表,再补三个动作就够落地:① 官网做实体锚点——名称、成立时间、业务范围、资质、案例口径全网一致,加装 Article / FAQPage 结构化标记;② 一手证据可溯源——实测、报告、案例写清方法与出处,让「异源交叉」有东西可对;③ 承认民间数字是假设——想验证「抖音权重是不是变高了」,用你自己同一组问句在 App 端、Web 端、API 三处做同条件采样,记录来源域名与入口,而不是直接采用某张表。
四、引用边界:先排除「做了也白做」的内容
比起研究「怎么被引用」,先搞清楚「哪类回答根本不给引用」更省预算。按官方说明,创意写作 / 文案 / 诗歌 / 故事 / 头脑风暴 / 纯主观建议默认不联网、不加引用;数学计算 / 逻辑推理 / 基础编程 / 翻译靠模型能力,一般不挂网页来源;私有文档 / 付费数据库 / 需登录内容无法抓取;存在反爬或 robots 限制的页面无法被收录为信源。把这四类从豆包 GEO 的目标内容里划掉,剩下的「时效信息 / 事实查证 / 公开产品与官方资料」才是值得投入的地盘。这也是 180 期讲 robots.txt 训练退出时的另一面:那一行令牌管的是训练,这里管的是联网检索能不能抓到你。
五、三个最容易踩的坑
- 把 API 文档的分级当成 App 的权重表。火山引擎公开的是开发者搜索服务的权威度分级与接口字段,消费者豆包 App 在具体问题上选哪类来源,官方没有逐行业公告;两者混用,等于用尺子量温度。
- 看到「97.7%」「3~7 天」就改策略。这些是特定场景、特定入口的观测,彼此数量级都对不上;不先对齐口径就照做,是拿别人的样本当自己的基线。
- 以为「带引用」等于「官方背书」。官方明确标注引用≠背书,第三方网页内容仍可能错误、过时、有偏见;医疗、法律、投资、金融、食品安全等事项不能只靠 AI 回答与检索信源,仍需持证专业人员。
FAQ
Q:豆包到底有没有官方权重表? A:没有。公开的是三类信源模式、过滤与召回优先级(政府 / 央媒 / 协会 / 学术 / 官方公告更高,UGC / 博客 / 营销站降权),以及火山引擎搜索 API 的权威度分级字段。流传的 T0/T1 百分比、EEAT 权重、抖音占比都是第三方观测或推演,多家发布方自己标注了「非官方规则」「待验证」。
Q:那站内之前写的豆包抖音引用、收录周期文章还作数吗? A:作数,但要正确定位。它们记录的是特定时间、入口、场景下的采样(如 10-27 期记抖音视频信源、10-26 期记收录变慢),是可验证的观测,不是官方公式。本篇不是推翻它们,而是给它们加一层口径说明:先用官方框架决定配什么资料,再用自己的多端采样去检验这些观测是否仍成立。
Q:企业官网在豆包 GEO 里到底是什么角色? A:实体锚点与「正常权威」档的可核验资料源,不是唯一信源。官方要求同一实体在多信源字段一致;单靠官网自述采信分低,至少要有两三个独立异源一致(具体门槛各方说法不一,自己采样验证)。官网要做的是把名称、资质、参数、更新时间写成机器可读、可交叉核对的形态。
Q:为什么我的内容豆包一个引用都不给? A:先查引用边界。创意 / 主观建议类默认不联网,数学 / 翻译靠模型能力,付费 / 登录 / 反爬页面抓不到——这几类无论怎么写都不会挂来源。剩下的再看是否被过滤(软文、营销站、低质 UGC 降权)与实体一致性(多渠道打架直接降置信分)。
延伸阅读
- 豆包每引用 3 条内容就有 1 条来自抖音:视频信源正在接管 AI 引用——本篇给这类观测加口径说明(25044 期)
- 豆包「精采信」模式对企业官网运营有什么影响——7 月信源重构的观测,本篇补官方框架(20118 期)
- GEO 到底多久见效:收录、召回、采信、推荐四段拆开看——把「收录周期」放到正确环节(25084 期)
官方给的是骨架,权重表是别人画的皮肉——先认骨架,再验皮肉。


评论前必须登录!
注册