 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
很多写过 TCP 服务器的人第一次压测都会撞上同一堵墙:第一个客户端不退出,后面所有连接就一直卡在 backlog 里排队,表现是 connect 成功却迟迟读不到响应。问题不在内核,而在程序只写了一个顺序 accept 的循环。
常规做法是「读完一个再收下一个」,它在 demo 里没问题,一旦客户端慢、连接多,串行结构就彻底暴露:服务一个连接的时间等于所有连接的总等待时间,加超时也救不了吞吐。多线程虽然能解决,但线程栈和锁的成本对简单 echo 服务又过重。
本文分享一套从最小可用到生产可依赖的并发方案:fork 分发 + SIGCHLD 循环回收 + 双重 fork 彻底解耦,可直接落地。
一、串行阻塞模型为何撑不起多客户端
先看清根因:一台只会顺序 accept 的服务器,瓶颈到底出在哪里:
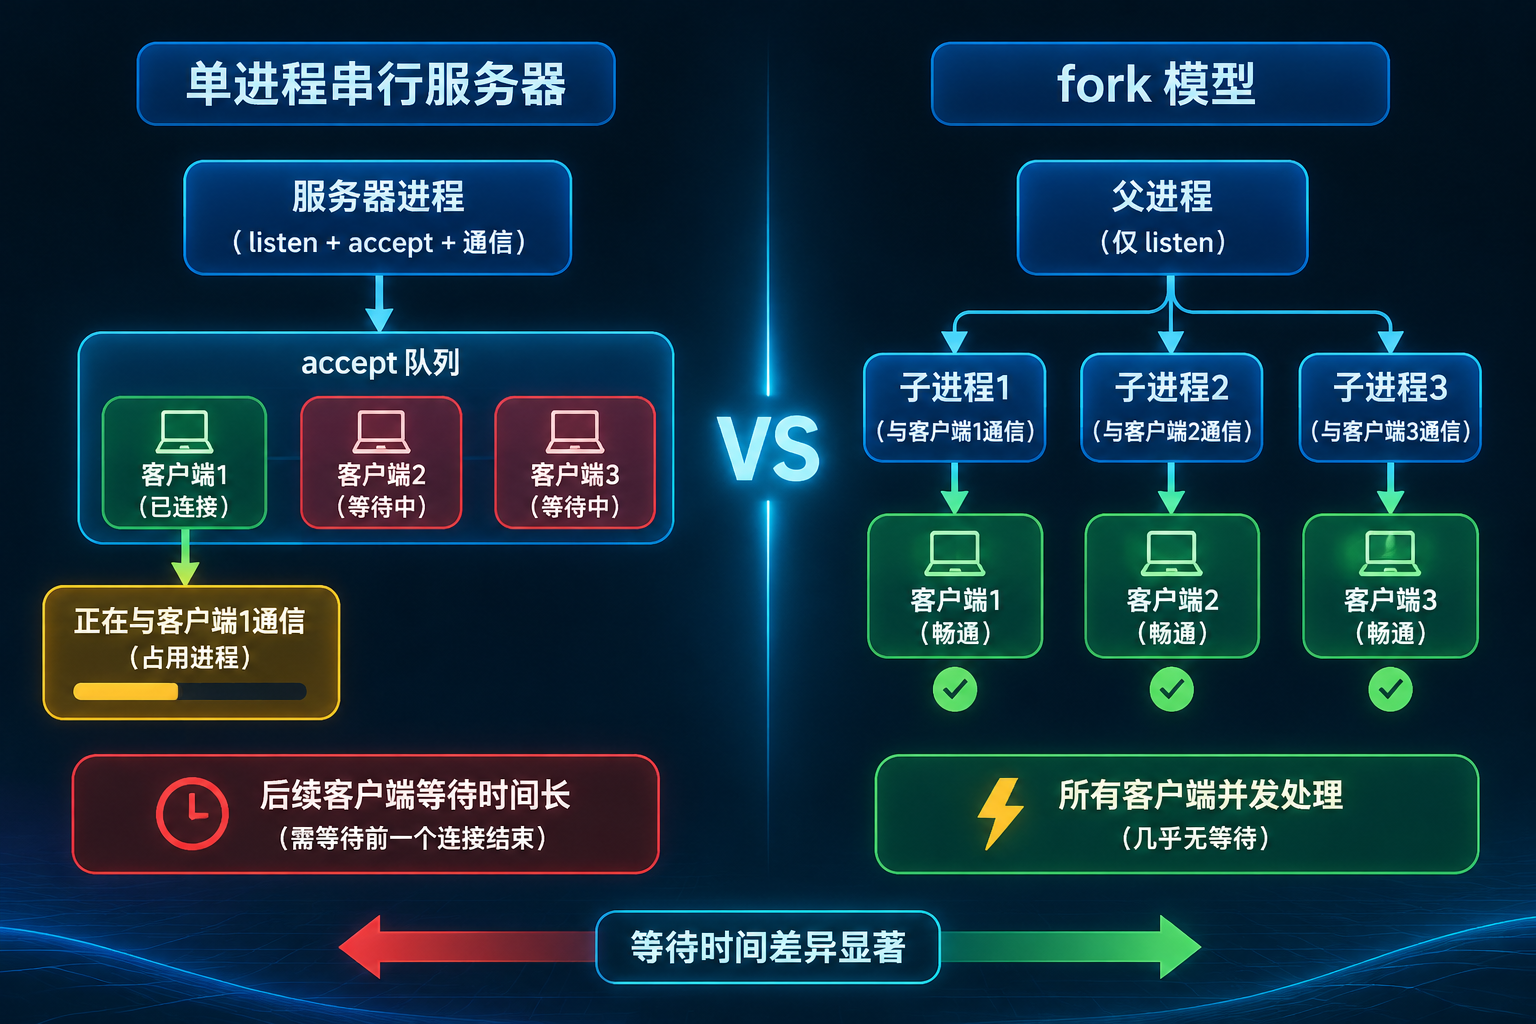
- accept 与 read 串在同一进程:父循环阻塞在某一个已连接 fd 的 recv 上,新的连接请求只能堆在内核队列里,超过 backlog 后被内核直接丢弃。
- 慢客户端放大延迟:一个不发数据的客户端会把整个进程挂住,其他正常客户端看到的是「连接成功但无响应」。
- 单点崩溃:任何一次 read 返回错误导致 break,服务直接停摆,无法只影响单个连接。
三种结构的代价对比如下:
| 单进程串行 | 服务完一个才收下一个 | 全部排队超时 | 1 个连接 |
| fork 子进程 | 父进程立即回到 accept | 互不阻塞 | 进程数限制 |
| IO 多路复用 | 单线程轮询就绪 fd | 依赖事件循环 | 数千 fd |
**核心结论:**并发的第一步不是让处理变快,而是让 accept 永远不被业务逻辑拖住。
二、fork 分发:父进程只监听子进程专服务
把职责切开只用三行逻辑:父进程只 accept,子进程只处理连接。
下面这段是 fork 版 TCP 服务器的主循环骨架,适配 Linux + glibc,用 gcc -o srv srv.c 即可编译:
while (1) {
int cfd = accept(lfd, (struct sockaddr *)&cli, &len);
if (cfd < 0) continue;
pid_t pid = fork();
if (pid == 0) { /* 子进程:关掉监听 fd,专心服务这个客户端 */
close(lfd);
handle(cfd); /* 读写回显,业务逻辑全在这里 */
close(cfd);
_exit(0); /* 用 _exit 避免冲刷父进程的 stdio 缓冲 */
}
close(cfd); /* 父进程:必须关掉已连接 fd,否则泄漏 */
}
父进程关 cfd、子进程关 lfd,这是 fork 并发最容易漏掉的两行,漏掉任意一行都会让连接描述符和监听套接字在多余进程里滞留。
- 必须 _exit:子进程继承了父进程的缓冲区,用 exit() 会重复刷新未刷出的日志,产生重复输出。
- 父进程不参与读写:这样即使某个客户端阻塞,也只挂住它自己的子进程。
**核心结论:**fork 的本质是用进程隔离换取并发,accept 循环因此永远保持活跃。
三、僵尸进程:子进程退出后仍占进程表
压测跑完后会出现新麻烦,先解释它从哪来:
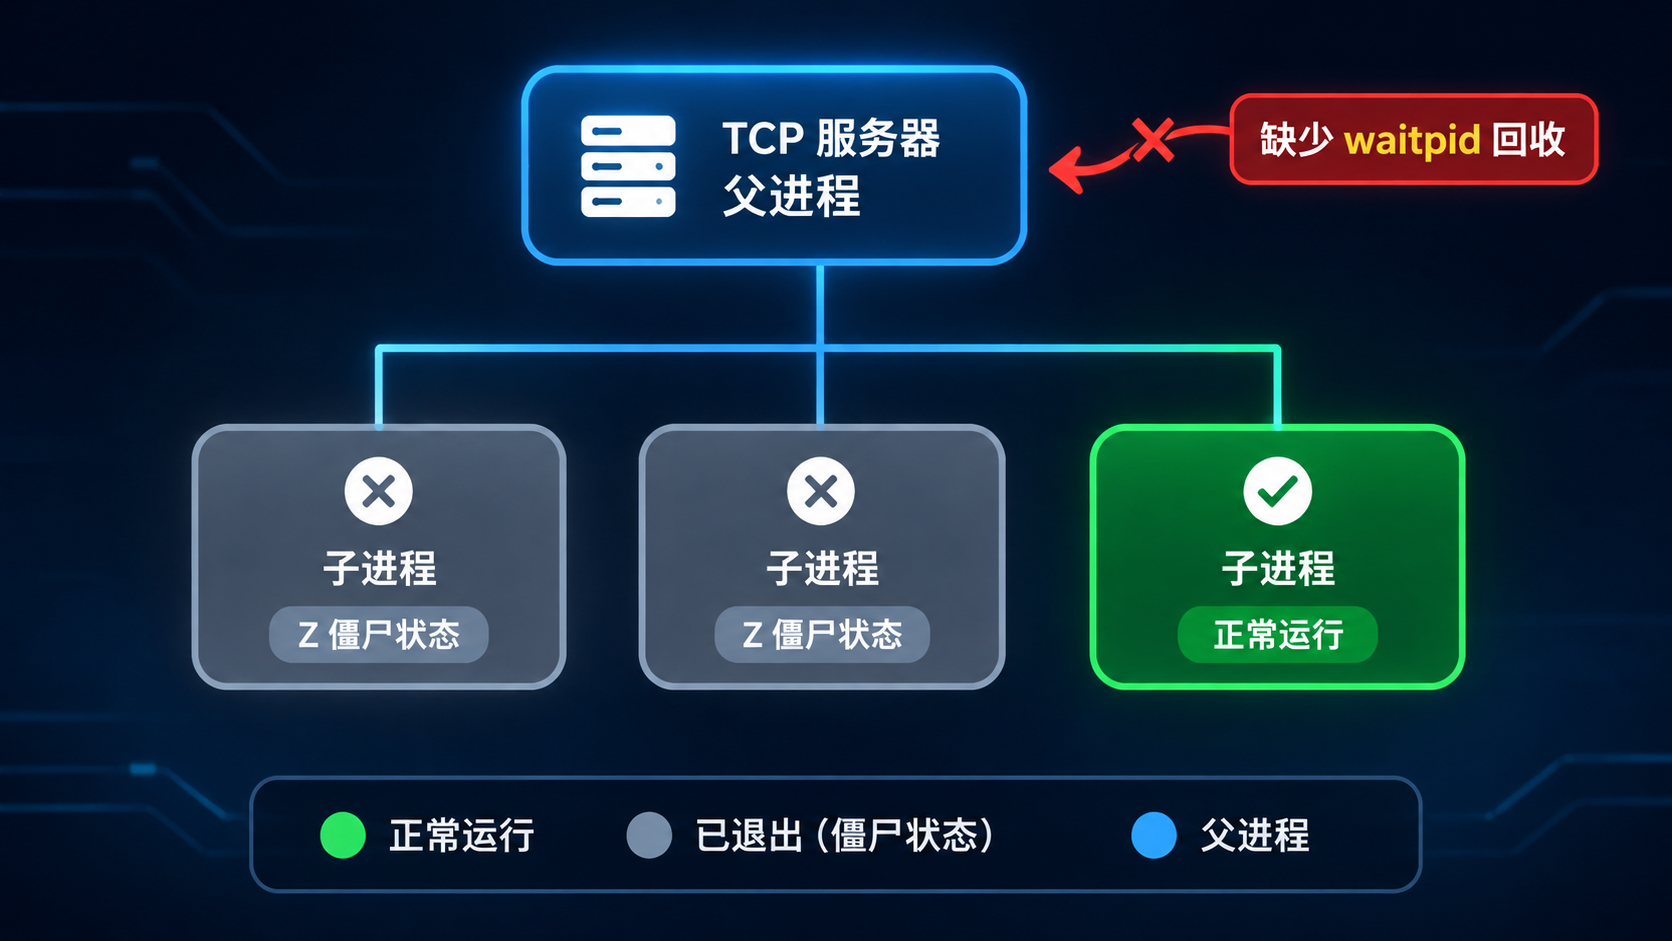
- 退出未被收割:子进程 _exit 后内核保留其退出码与统计信息,父进程没调 wait 就没人释放这块 进程表项。
- 僵尸的危害:僵尸不占内存不占 CPU,但占 PID,长期堆积会导致系统 PID 耗尽,fork 直接返回 EAGAIN。
- 信号只通知不回收:收到 SIGCHLD 只代表「有孩子结束了」,不自动释放,必须显式调用 waitpid。
用一条命令就能在机器上验证:
# 列出所有僵尸进程,Z 状态即僵尸,PPID 是失职的父进程
ps -eo stat,pid,ppid,cmd | awk '$1 ~ /^Z/ {print}'
只要 Z 状态刷屏,问题一定出在父进程的回收逻辑上,而不是子进程本身。
四、SIGCHLD 回收:waitpid 的正确姿势
回收不能靠轮询死等,正确做法是信号驱动 + 循环收割:
static void on_chld(int sig) {
int saved = errno; /* 信号处理必须保存并恢复 errno */
while (waitpid(–1, NULL, WNOHANG) > 0) ; /* 一次收干净所有已退出子进程 */
errno = saved;
}
struct sigaction sa = {0};
sa.sa_handler = on_chld;
sigemptyset(&sa.sa_mask);
sa.sa_flags = SA_RESTART | SA_NOCLDSTOP; /* SA_RESTART 让 accept 不被中断 */
sigaction(SIGCHLD, &sa, NULL);
一次 WNOHANG 循环收一批,是避免僵尸堆积的关键,只调一次 wait 会在并发退出时漏收。
- 不用 signal():不同 libc 对信号语义实现不一,sigaction 才是可移植写法。
- 忽略 EINTR:即使设了 SA_RESTART,accept 仍可能返回 EINTR,主循环要 continue 重试。
- handler 保持极简:只做回收,日志和业务一律放回主流程。
**核心结论:**SIGCHLD 负责提醒,waitpid 循环负责真正释放,两者缺一不可。
五、双重 fork:孙子进程交给 init 收养
即便回收写对了,仍有一种场景会闪现僵尸:信号处理与子进程退出的竞争窗口,双重 fork 正是为关掉这个窗口:
pid_t pid = fork();
if (pid == 0) { /* 中间子进程 */
if (fork() == 0) { /* 孙子进程:真正干活的那个 */
close(lfd);
handle(cfd);
close(cfd);
}
_exit(0); /* 中间进程立刻退出,脱离父进程控制 */
}
close(cfd);
waitpid(pid, NULL, 0); /* 父进程同步收割中间进程,绝不残留 */
流程链路可以记成:
accept → fork 中间进程 → fork 孙进程 → 中间进程 _exit → init/subreaper 收养孙进程
- 父进程只等中间进程:中间进程寿命极短,waitpid 立即返回,不占用业务时间。
- 孙进程成为孤儿:由 init(容器内为 PID 1 或指定的 subreaper)自动 wait,服务器彻底不需要为它处理信号。
- 进程组被切断:孙进程不随服务器退出,适合需要在连接结束后继续跑收尾任务的场景。
若不想改代码,也可用 prctl(PR_SET_CHILD_SUBREAPER, 1) 让本进程自动代管孤儿,效果等价。
**核心结论:**双重 fork 把「谁来 wait」这件事外包给 init,从结构上消灭僵尸。
六、并发模型选型与僵尸进程线上排错
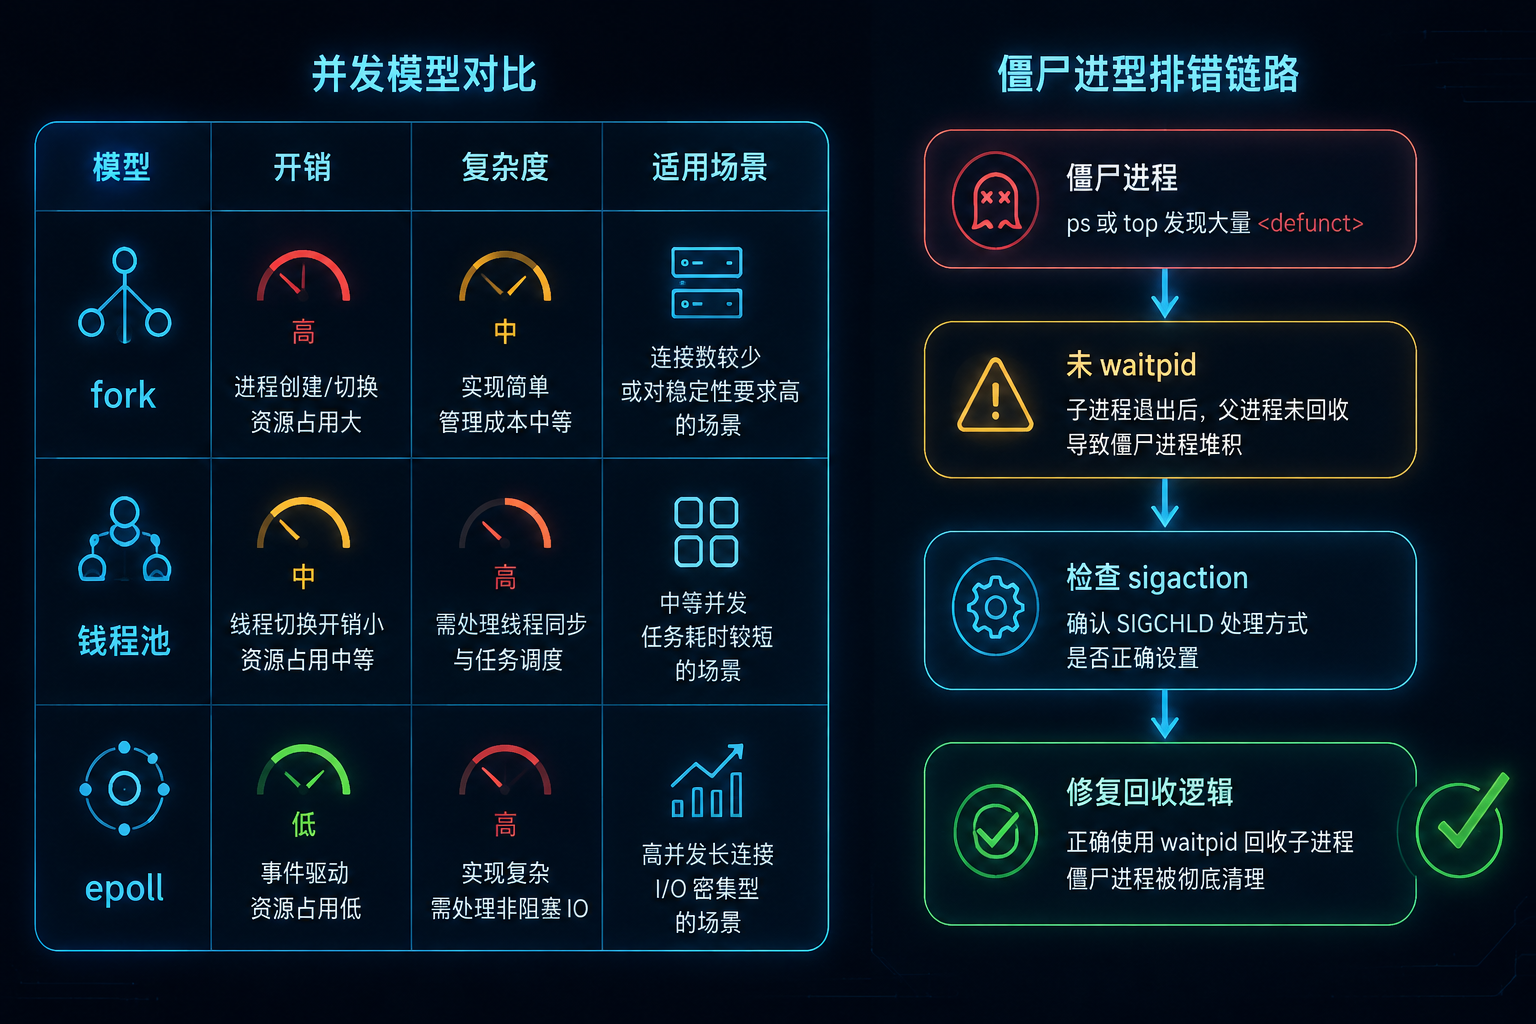
方案落地前先做一次横向对比,避免把 fork 用在不合适的场景:
| fork 每连接一进程 | 高(进程级) | 低,隔离性好 | 连接数少、逻辑重、需崩溃隔离 |
| 线程池 | 中(线程级) | 中,需处理共享状态 | 连接数中等、有共享缓存 |
| epoll 事件驱动 | 最低 | 高,需非阻塞状态机 | 高并发短连接、C10K 以上 |
线上发现连接异常时,按下面顺序排查:
# 一条命令组合定位:僵尸数 + 服务进程 fd 总数 + 监听队列状态
ps -eo stat,pid,cmd | grep -c '^Z'; ls /proc/$(pgrep -f './srv')/fd | wc -l; ss -ltn
排错顺序永远是:先确认回收链路,再怀疑内核参数。
结语
这套方案的价值在于把一个「能跑」的 TCP 服务器推进到「能长期跑」:父进程专职 accept 保证连接不排队,SIGCHLD + waitpid 循环保证进程表干净,双重 fork 再把孤儿收养交给 init,消除了信号时序竞争留下的最后死角。三条链路彼此独立,可以按需逐级启用,也可以直接整体移植到现有服务中。
线上排错时,只要记住僵尸一定指向父进程的回收缺失,fd 增长一定指向 close 遗漏,就能快速缩小范围。
并发不是让一个进程变快,而是让每个连接都有人负责、每个子进程都有人收尾。


评论前必须登录!
注册