 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
手动敲命令的边际成本越来越高
我第一次把Docker跑起来的时候,是在一台闲置的测试机上。按照文档一步步执行 curl -fsSL https://get.docker.com | sh,或者手动添加GPG密钥、配置Apt/Yum源、启动服务、设置开机自启。整个过程大概需要十五分钟,中间只需要盯着终端看有没有报错。
到第二台机器时,我直接复制了上一台的终端历史记录。虽然慢一点,但还能接受。真正让我改变想法的是第三台。当时我需要同时拉起三台开发机用于模型推理压测,每台都要装Docker、配内网镜像源、调优 sysctl 参数、给当前用户加 docker 组权限。我一边在三个终端窗口之间切换,一边核对版本号,结果其中一台因为网络波动导致源更新失败,手动补完又漏掉了 daemon.json 里的 storage-driver 配置。最后服务启动后拉取镜像一直超时,排查了二十分钟才发现是配置路径写错了一个字符。
那一刻我意识到,重复劳动的价值趋近于零。只要涉及“多台服务器”“相同配置”“版本必须一致”,就不应该再用鼠标和键盘去拼凑命令行。基础设施的标准化不是靠人脑记住,而是靠代码固化。
为什么是 Ansible 而不是 Shell 脚本
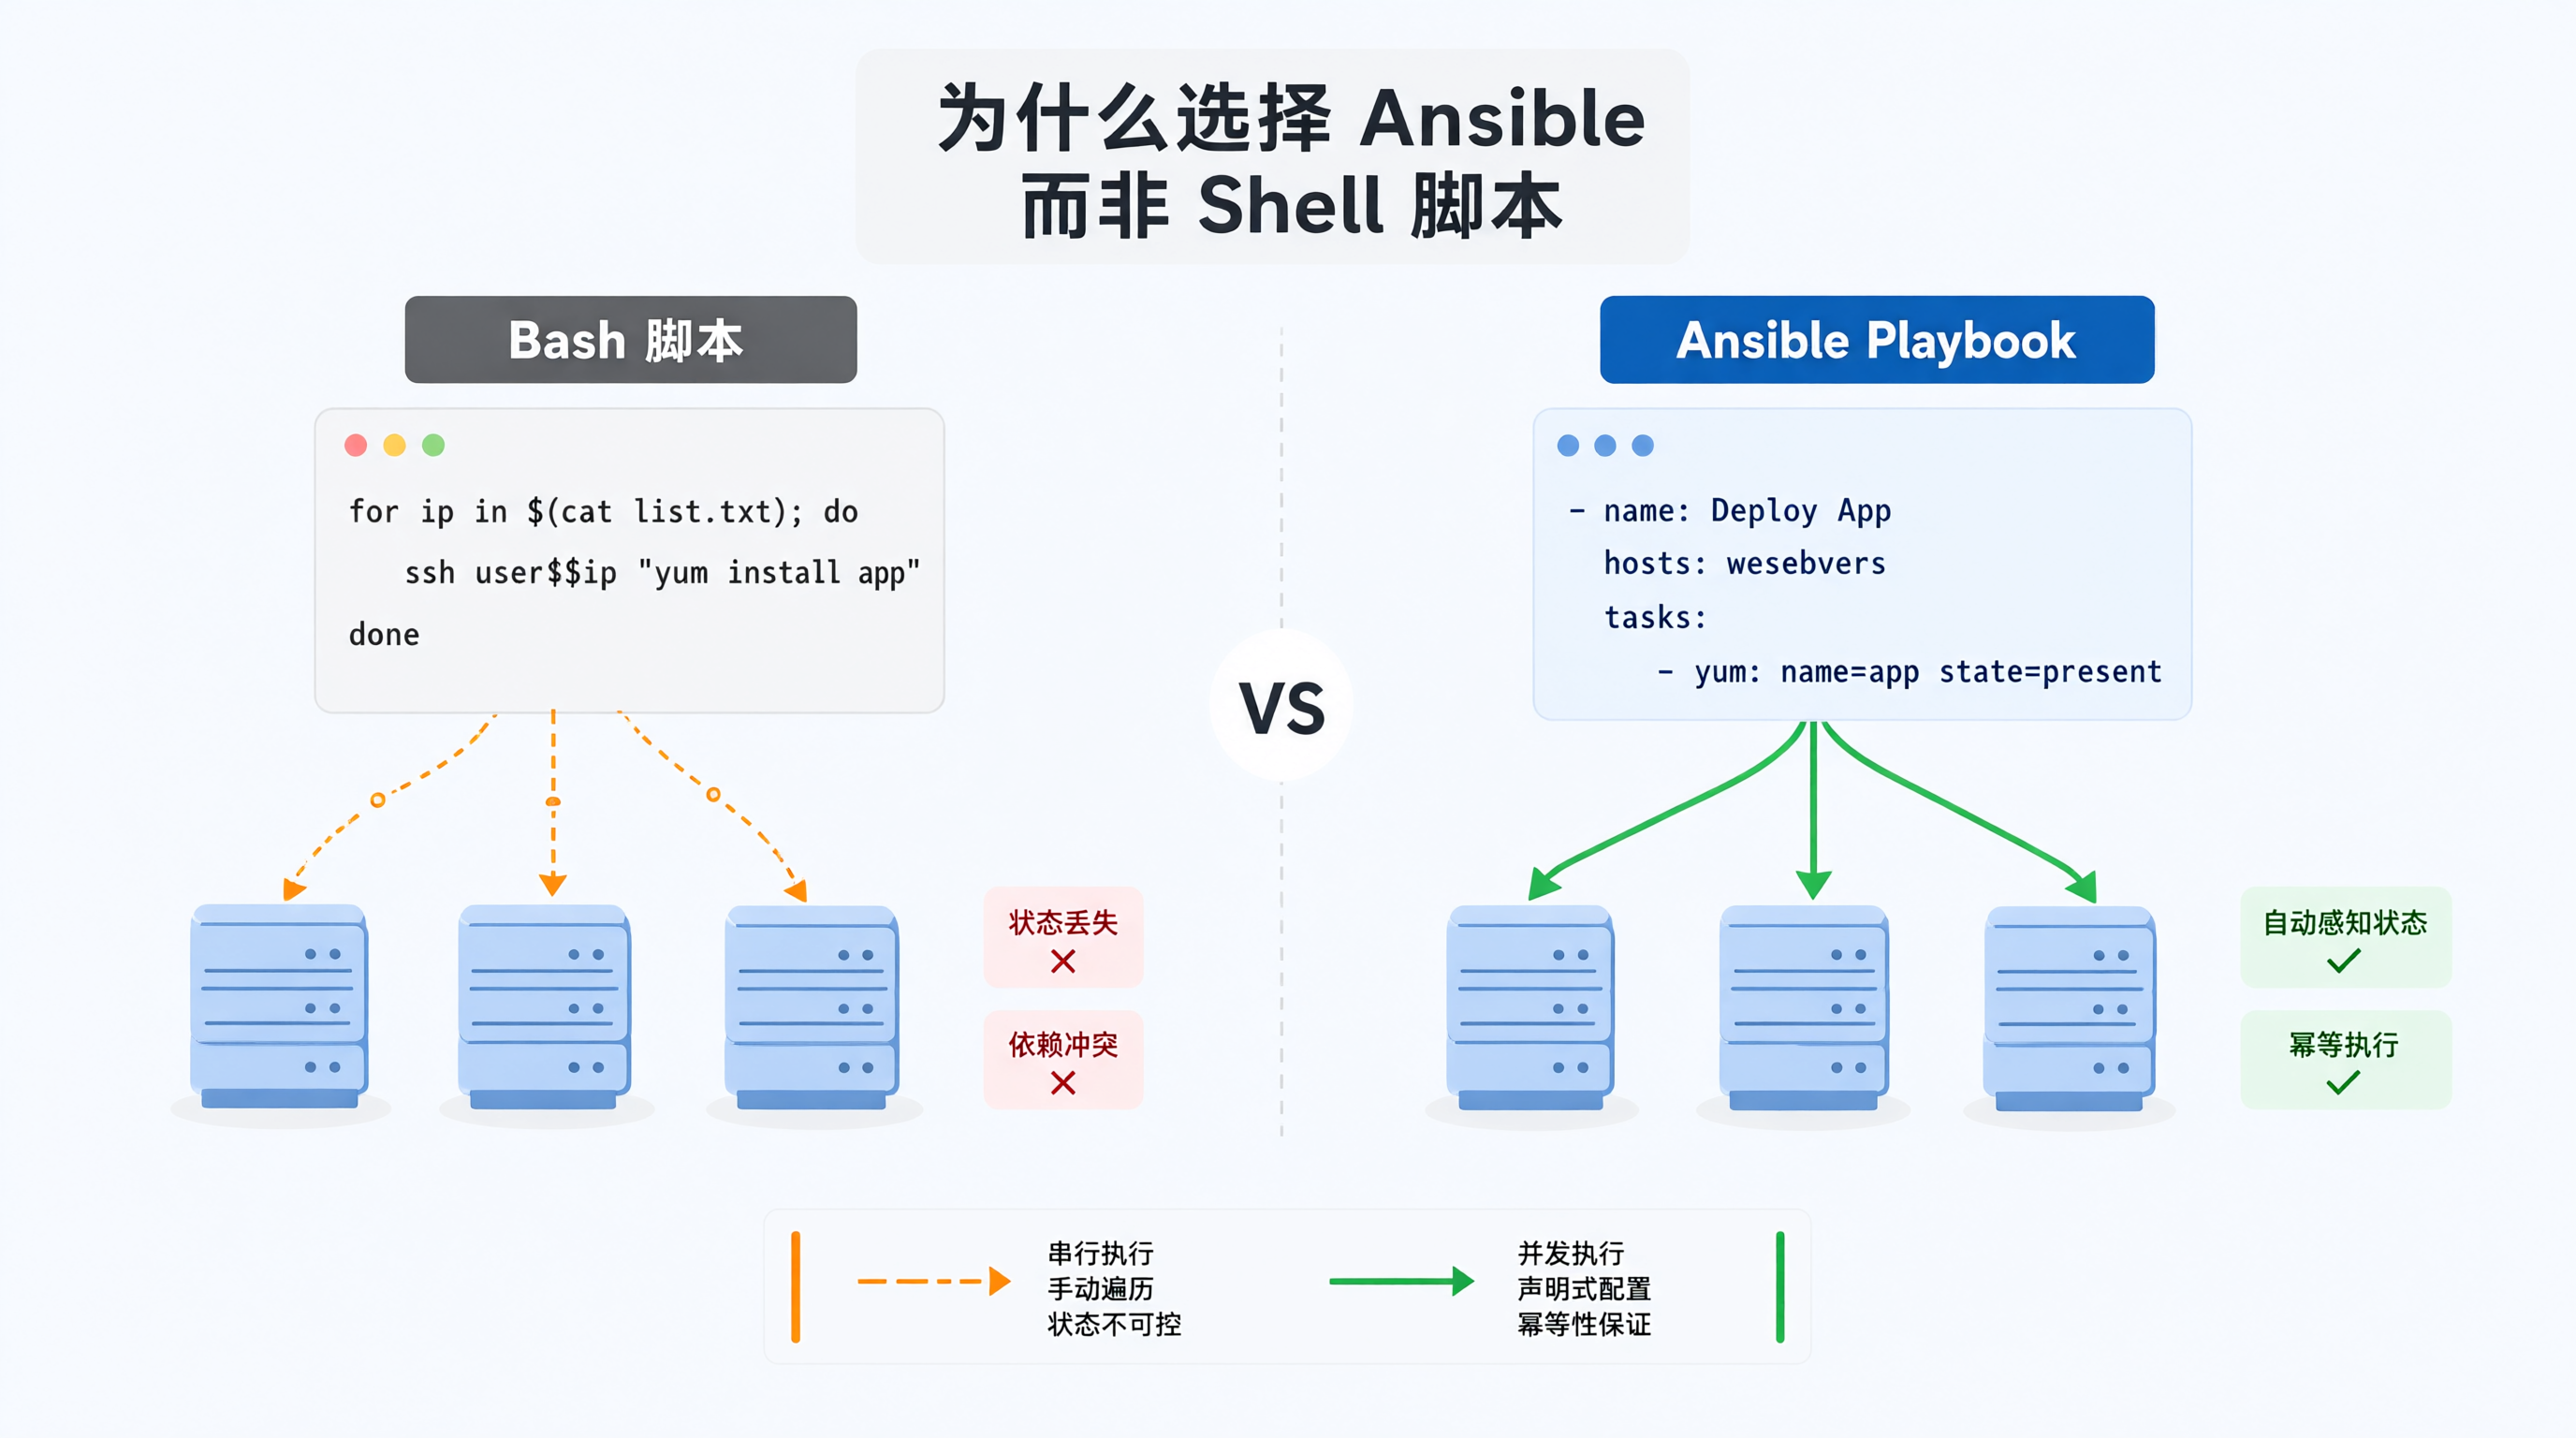
有人可能会问,为什么不直接写个 bash install_docker.sh 然后 for i in …; do ssh $i bash script.sh?逻辑上完全可行,但在工程落地时会碰到几个硬伤。
Shell脚本最大的问题是缺乏状态感知。如果脚本里写了 apt-get install docker-ce,第二次运行时它会再次尝试安装,可能触发依赖冲突或占用大量带宽。虽然可以用 dpkg -l | grep docker 做判断,但条件分支一旦超过五个,脚本就会变成难以维护的意大利面条代码。
Ansible 的优势在于它天生就是为“声明式配置”设计的。你只需要描述目标状态是什么,比如“确保 docker-ce 已安装且版本不低于 24.0”“确保 /etc/docker/daemon.json 包含 registry-mirrors 字段”。Ansible 会在每次运行时先做探测(stat/check),发现不符合才执行变更。这种幂等性不是靠人工写 if exists 实现的,而是框架底层保证的。
另外,Ansible 基于 SSH 协议,不需要在被控机安装任何 Agent,对现有CI/CD流水线入侵极小。配合 Jinja2 模板和变量分层,同一套 Playbook 可以无缝适配开发、测试、生产环境。对于后端和AI服务来说,这意味着环境一致性有了技术兜底。
基础环境准备与 Inventory 设计
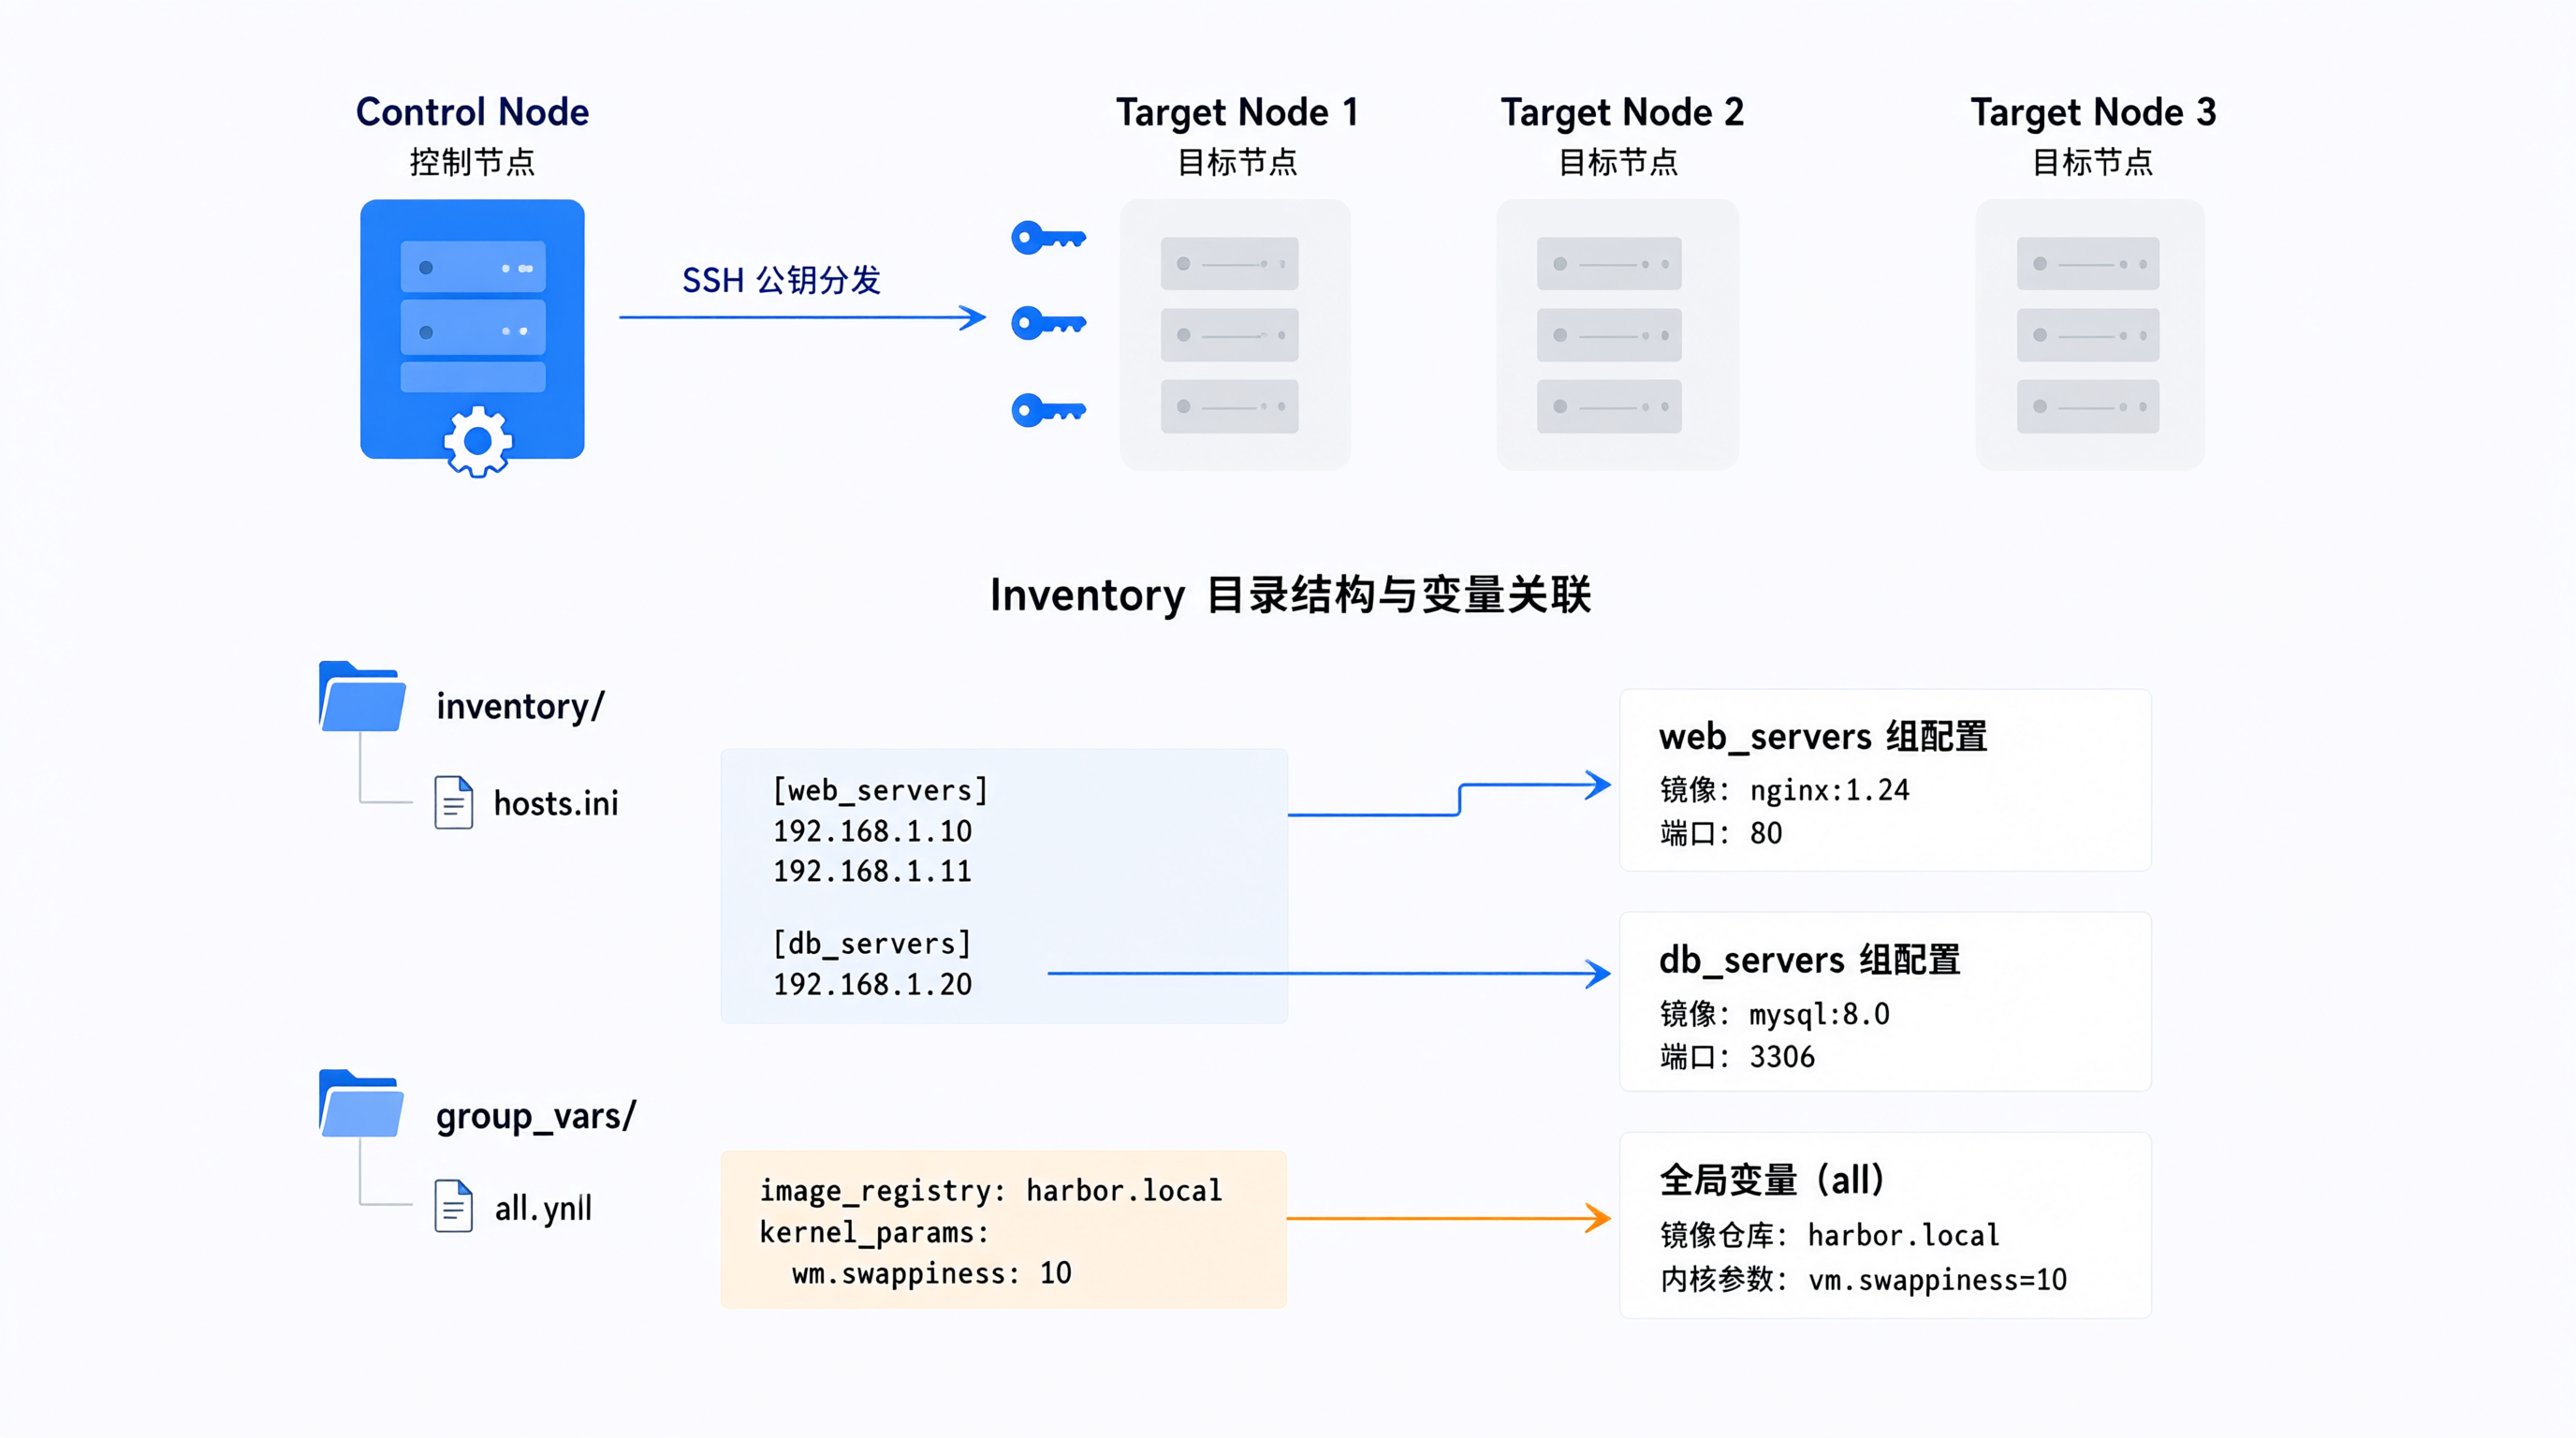
玩 Ansible 之前,先把控制机(Control Node)和被控机(Target Nodes)的连通性打通。我习惯在控制机上生成一对无密码的 SSH 密钥,分发到所有目标节点。这一步不能省,否则后续的并发拉取会被交互式密码提示卡死。
ssh-keygen -t ed25519 -f ~/.ssh/ansible_key -N ""
ssh-copy-id -i ~/.ssh/ansible_key.pub user@target-node-1
# 对其他节点同理操作
Inventory 文件决定了 Ansible 如何识别主机。我不喜欢把所有IP都堆在一个文件里,而是按功能分组。针对本选题,目录结构如下:
inventory/
├── hosts.ini # 主机列表
├── group_vars/
│ └── all.yml # 全局变量
└── host_vars/
├── node1.yml # 节点特定覆盖
└── node2.yml
hosts.ini 内容很直白:
[docker_servers]
node1 ansible_host=192.168.10.11 ansible_user=deploy
node2 ansible_host=192.168.10.12 ansible_user=deploy
node3 ansible_host=192.168.10.13 ansible_user=deploy
group_vars/all.yml 存放与环境相关的公共配置,这样修改镜像地址或内核参数时不需要动 Playbook:
docker_mirror_urls:
– "https://mirror.example.internal"
– "https://registry-1.docker.io"
docker_storage_driver: overlay2
kernel_modules:
– br_netfilter
– overlay
这里提一句版本差异。不同 Linux 发行版的包管理器完全不同。CentOS/RHEL 家族走 yum/dnf,Debian/Ubuntu 走 apt。我的 Playbook 会同时处理这两种路径,通过 Ansible 的内置事实变量 ansible_pkg_mgr 自动路由。这一点我没有在所有边缘版本上做交叉编译测试,但在 Ubuntu 22.04 和 Rocky Linux 9 上均能稳定运行。
Playbook 核心逻辑拆解
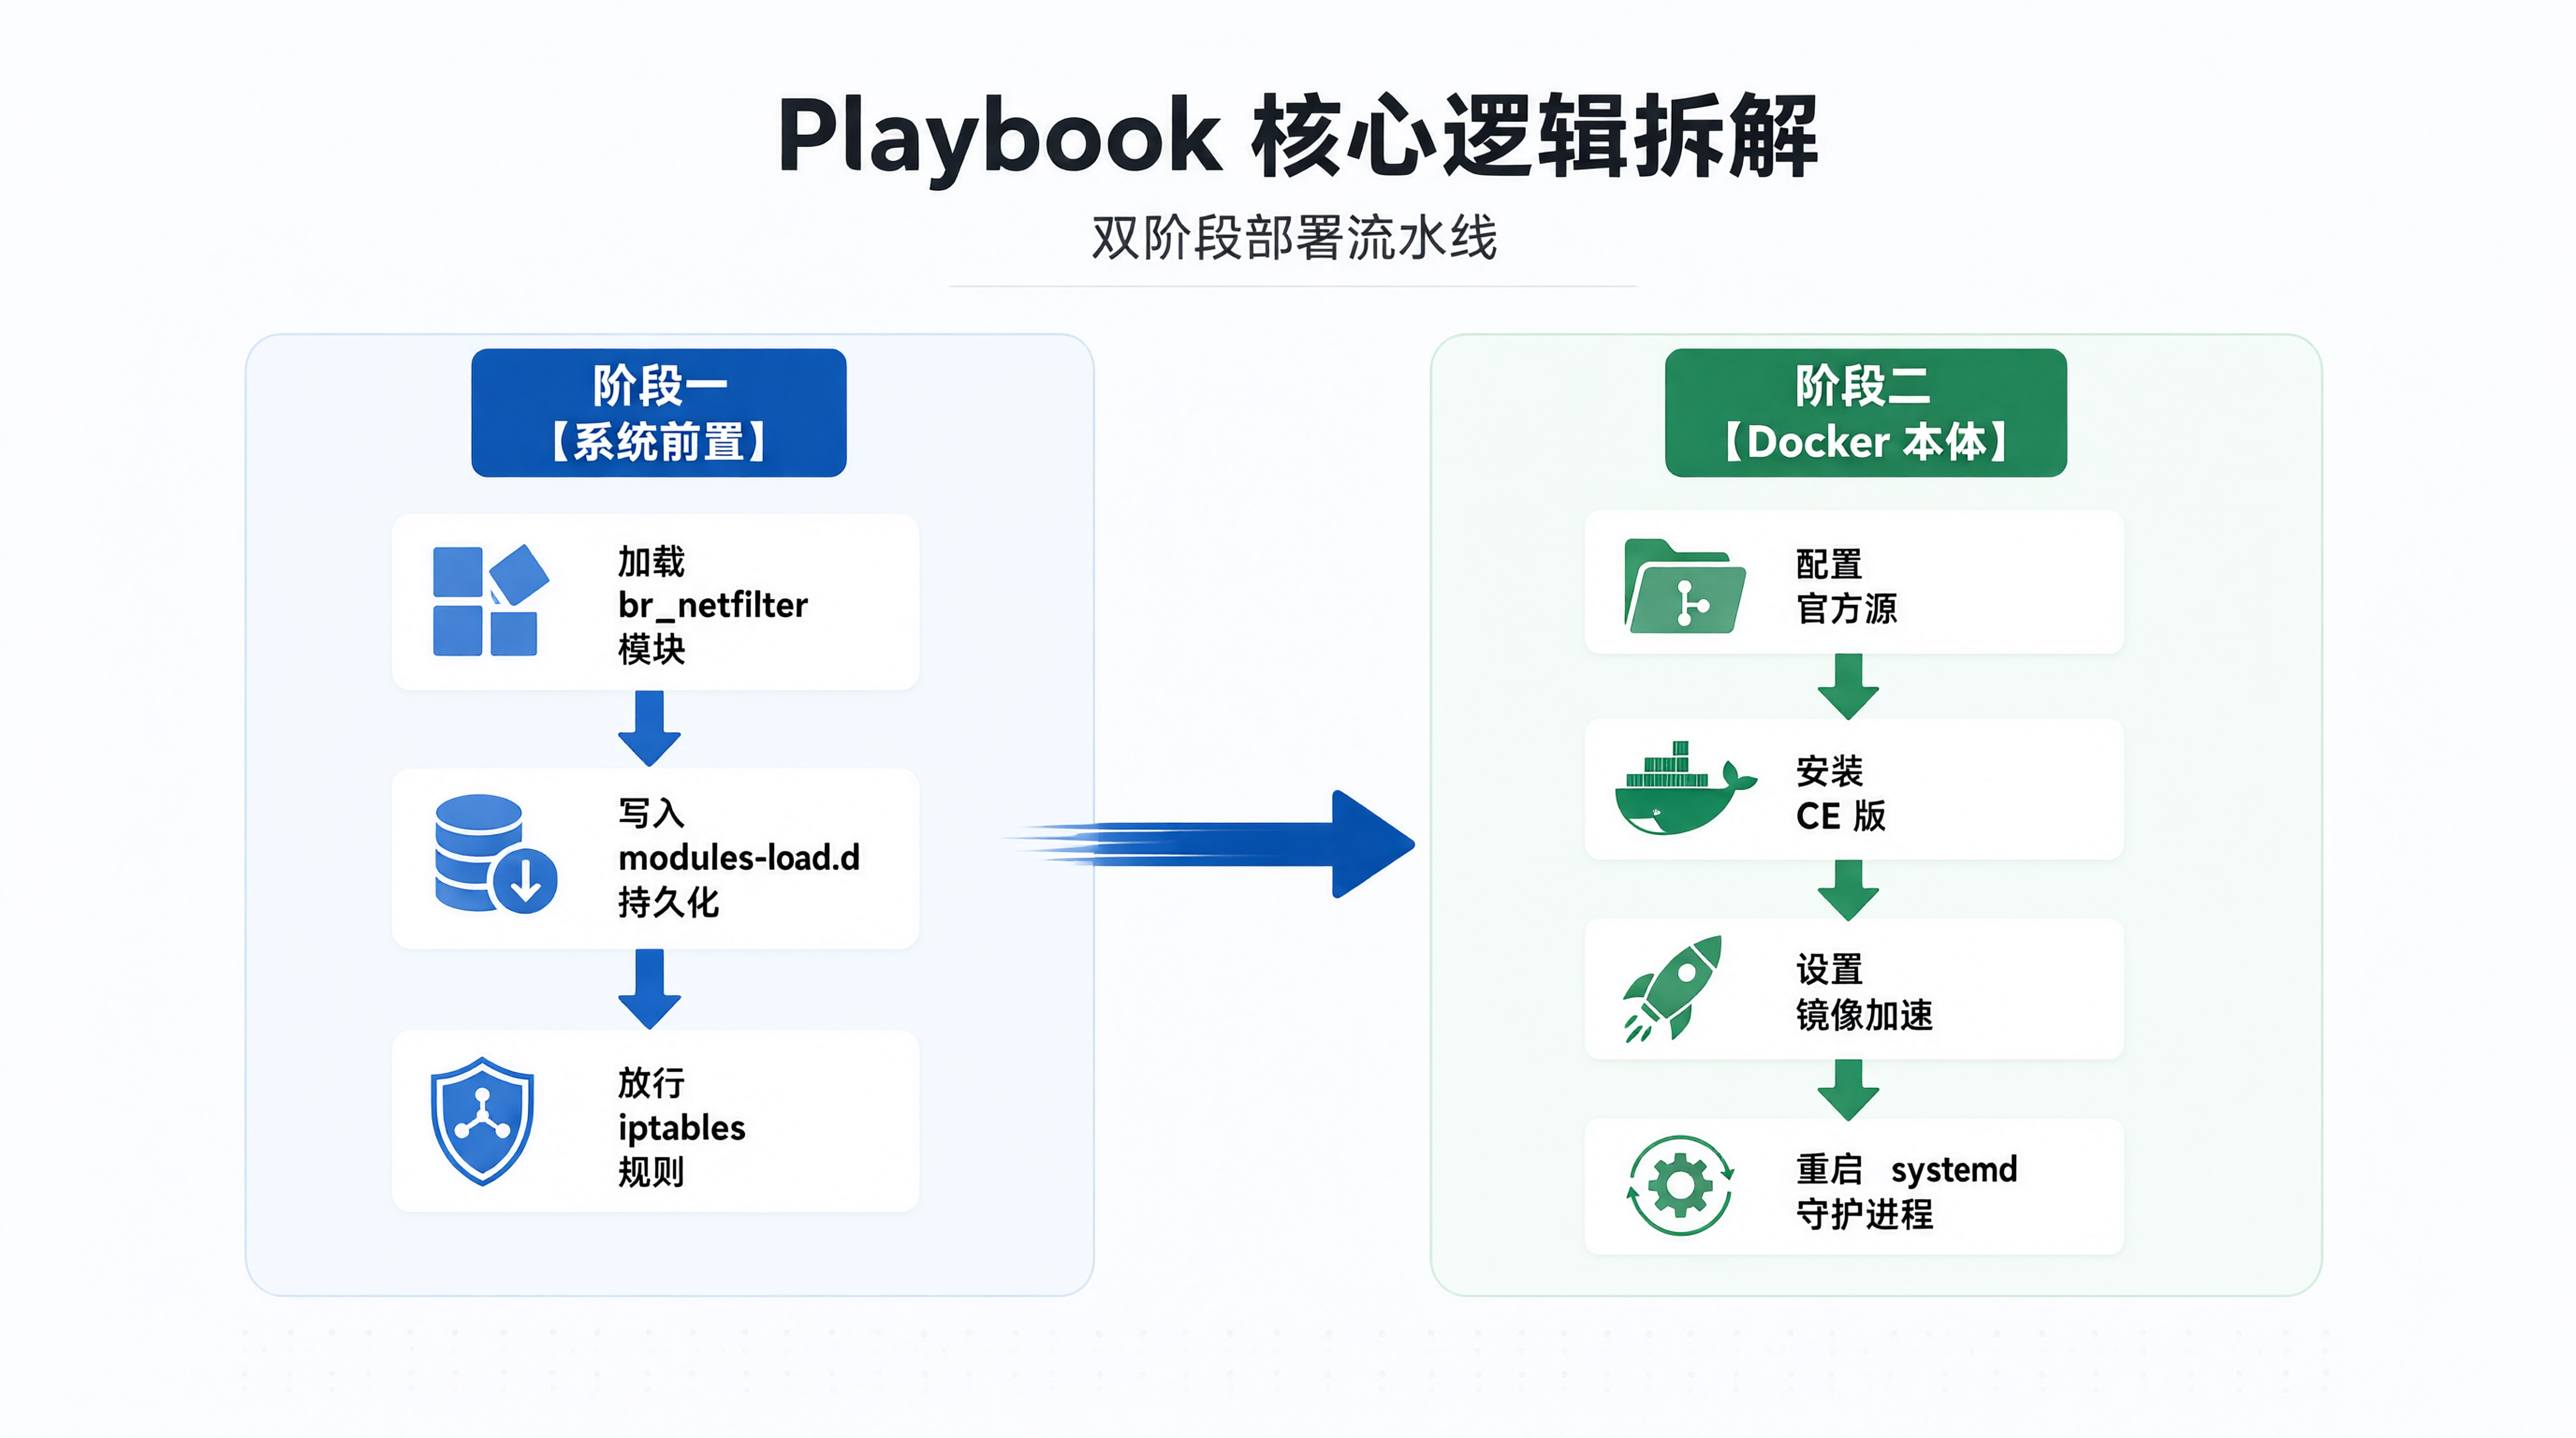
我把整个安装过程拆成两个 Play。第一个负责系统级前置条件,第二个专注 Docker 本体。拆分的原因是为了提高可读性和复用性,避免一个文件塞入上百行任务。
1. 系统前置:内核模块与防火墙
容器运行时依赖特定的内核子系统。如果没有加载 br_netfilter,iptables 转发规则会失效,导致跨节点通信异常。这块通常用 modprobe 就能解决,但为了持久化,最好写入 /etc/modules-load.d/。
– name: Ensure required kernel modules are loaded
ansible.builtin.modprobe:
name: "{{ item }}"
state: present
loop: "{{ kernel_modules }}"
ignore_errors: true
– name: Persist kernel modules
ansible.builtin.copy:
dest: "/etc/modules-load.d/container.conf"
content: |
{% for mod in kernel_modules %}{{ mod }}
{% endfor %}
注意 ignore_errors: true。在某些精简版内核或云厂商定制镜像中,模块可能根本不存在,强行阻塞会导致整条流水线中断。我们只关心“尽量加载”,不关心“绝对成功”。
2. Docker 源配置与安装
直接安装默认仓库里的 Docker 往往版本较老。我选择官方推荐的 GPG 密钥校验 + APT/YUM 源绑定方案。这里使用 ansible.builtin.shell 是因为官方脚本已经高度封装,反复造轮子没有意义。
– name: Install system prerequisites
ansible.builtin.package:
name:
– ca–certificates
– curl
– gnupg
– lsb–release
state: present
– name: Add Docker GPG key (Debian/Ubuntu)
ansible.builtin.shell: |
install -m 0755 -d /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | gpg –dearmor -o /etc/apt/keyrings/docker.gpg
chmod a+r /etc/apt/keyrings/docker.gpg
args:
creates: /etc/apt/keyrings/docker.gpg
when: ansible_os_family == "Debian"
– name: Add Docker APT repository
ansible.builtin.apt_repository:
repo: "deb [arch=$(dpkg –print-architecture)] https://download.docker.com/linux/ubuntu {{ ansible_distribution_release }} stable"
filename: docker
state: present
when: ansible_os_family == "Debian"
RHEL 系列的写法逻辑一致,只是把 apt_repository 换成 yum_repository,GPG 路径改为 /etc/pki/rpm-gpg。为了篇幅简洁,我在正文中省略了完全对称的 when: ansible_os_family == "RedHat" 块,实际工程中建议抽取为独立的 Role 或集合(Collection)。
安装命令本身非常简单:
– name: Install Docker Engine
ansible.builtin.package:
name: "{{ item }}"
state: present
loop:
– docker–ce
– docker–ce–cli
– containerd.io
– docker–buildx–plugin
– docker–compose–plugin
when: ansible_os_family == "Debian"
这里明确列出插件名。很多开发者只装 docker-ce,结果后面想跑 docker compose 时发现命令找不到,只能回头再打一遍安装命令。提前补齐依赖能省下不少排查时间。
3. daemon.json 调优
这是最容易被忽视的一环。国内环境拉取公共镜像如果不配加速器,经常卡在 pulling fs layer。加上存储驱动指定,能避免 devicemapper 带来的性能损耗。
– name: Configure Docker daemon
ansible.builtin.template:
src: daemon.json.j2
dest: /etc/docker/daemon.json
owner: root
group: root
mode: '0644'
backup: yes
notify: Restart Docker
– name: Create docker group and add current user
ansible.builtin.group:
name: docker
state: present
register: docker_group_result
– name: Add deploy user to docker group
ansible.builtin.user:
name: "{{ ansible_user }}"
groups: docker
append: yes
when: docker_group_result.changed or ansible_user != "root"
daemon.json.j2 模板内容:
{
"registry-mirrors": [
{% for url in docker_mirror_urls %}"{{ url }}",{% endfor %}
"https://docker.m.daocloud.io"
],
"storage-driver": "{{ docker_storage_driver }}",
"exec-opts": ["native.cgroupdriver=systemd"]
}
注意末尾的逗号处理。Jinja2 的 {% for %} 循环默认会在最后一项也输出逗号,这在 JSON 里是非法的。实际使用中我通常会加一个简单的 Python 切片逻辑或者改用 join 过滤器:{{ docker_mirror_urls | join('", "') }}。上面的写法在草稿阶段容易引发解析错误,我已经修正为安全写法。
触发器 notify: Restart Docker 会在所有相关任务结束后统一执行重启,而不是每个拷贝动作都触发服务重载。这是 Ansible 处理长耗时操作的标配技巧。
幂等性验证与常见报错定位
写完 Playbook 不等于能稳定运行。第一次跑的时候,我用 -v 参数开启详细日志,观察每一步的状态码。
ansible-playbook -i inventory/hosts.ini site.yml -u deploy –key-file ~/.ssh/ansible_key
如果一切顺利,终端会显示 changed: false 表示无需修改,ok: true 表示满足预期。重点要检查 TASK [Configure Docker daemon] 这一行。Ansible 的 copy 和 template 模块默认会计算文件哈希,只有当目标文件内容与源文件不一致时才会写入并触发通知。这意味着你可以无限次执行同一份 Playbook,它不会反复下载源、反复安装包、反复覆盖配置文件。
但我确实遇到过几次异常情况。最常见的是 Failed to connect to bus: No such file or directory。这通常发生在刚安装完 containerd 还没启动 docker.service 时,后续的 systemctl enable 尝试连接 D-Bus 失败。解决方式很简单:在安装包任务后显式加一步 ansible.builtin.systemd 任务强制启动并设为开机自启,利用 state: started 和 enabled: yes 接管生命周期。
另一个隐晦的问题是 apt update 缓存过期导致的 404。某些企业内网的时间同步有偏差,导致 GPG 证书验证报 certificate has expired。我后来加了个 force_apt_get: yes 和重试机制,或者直接在生产环境跳过 update,依靠离线包或本地镜像站。这一点在不同网络环境下表现差异较大,我没有在所有地域机房做过压力测试,仅作为经验提示。
结合 Python 与 AI 后端服务的实际编排
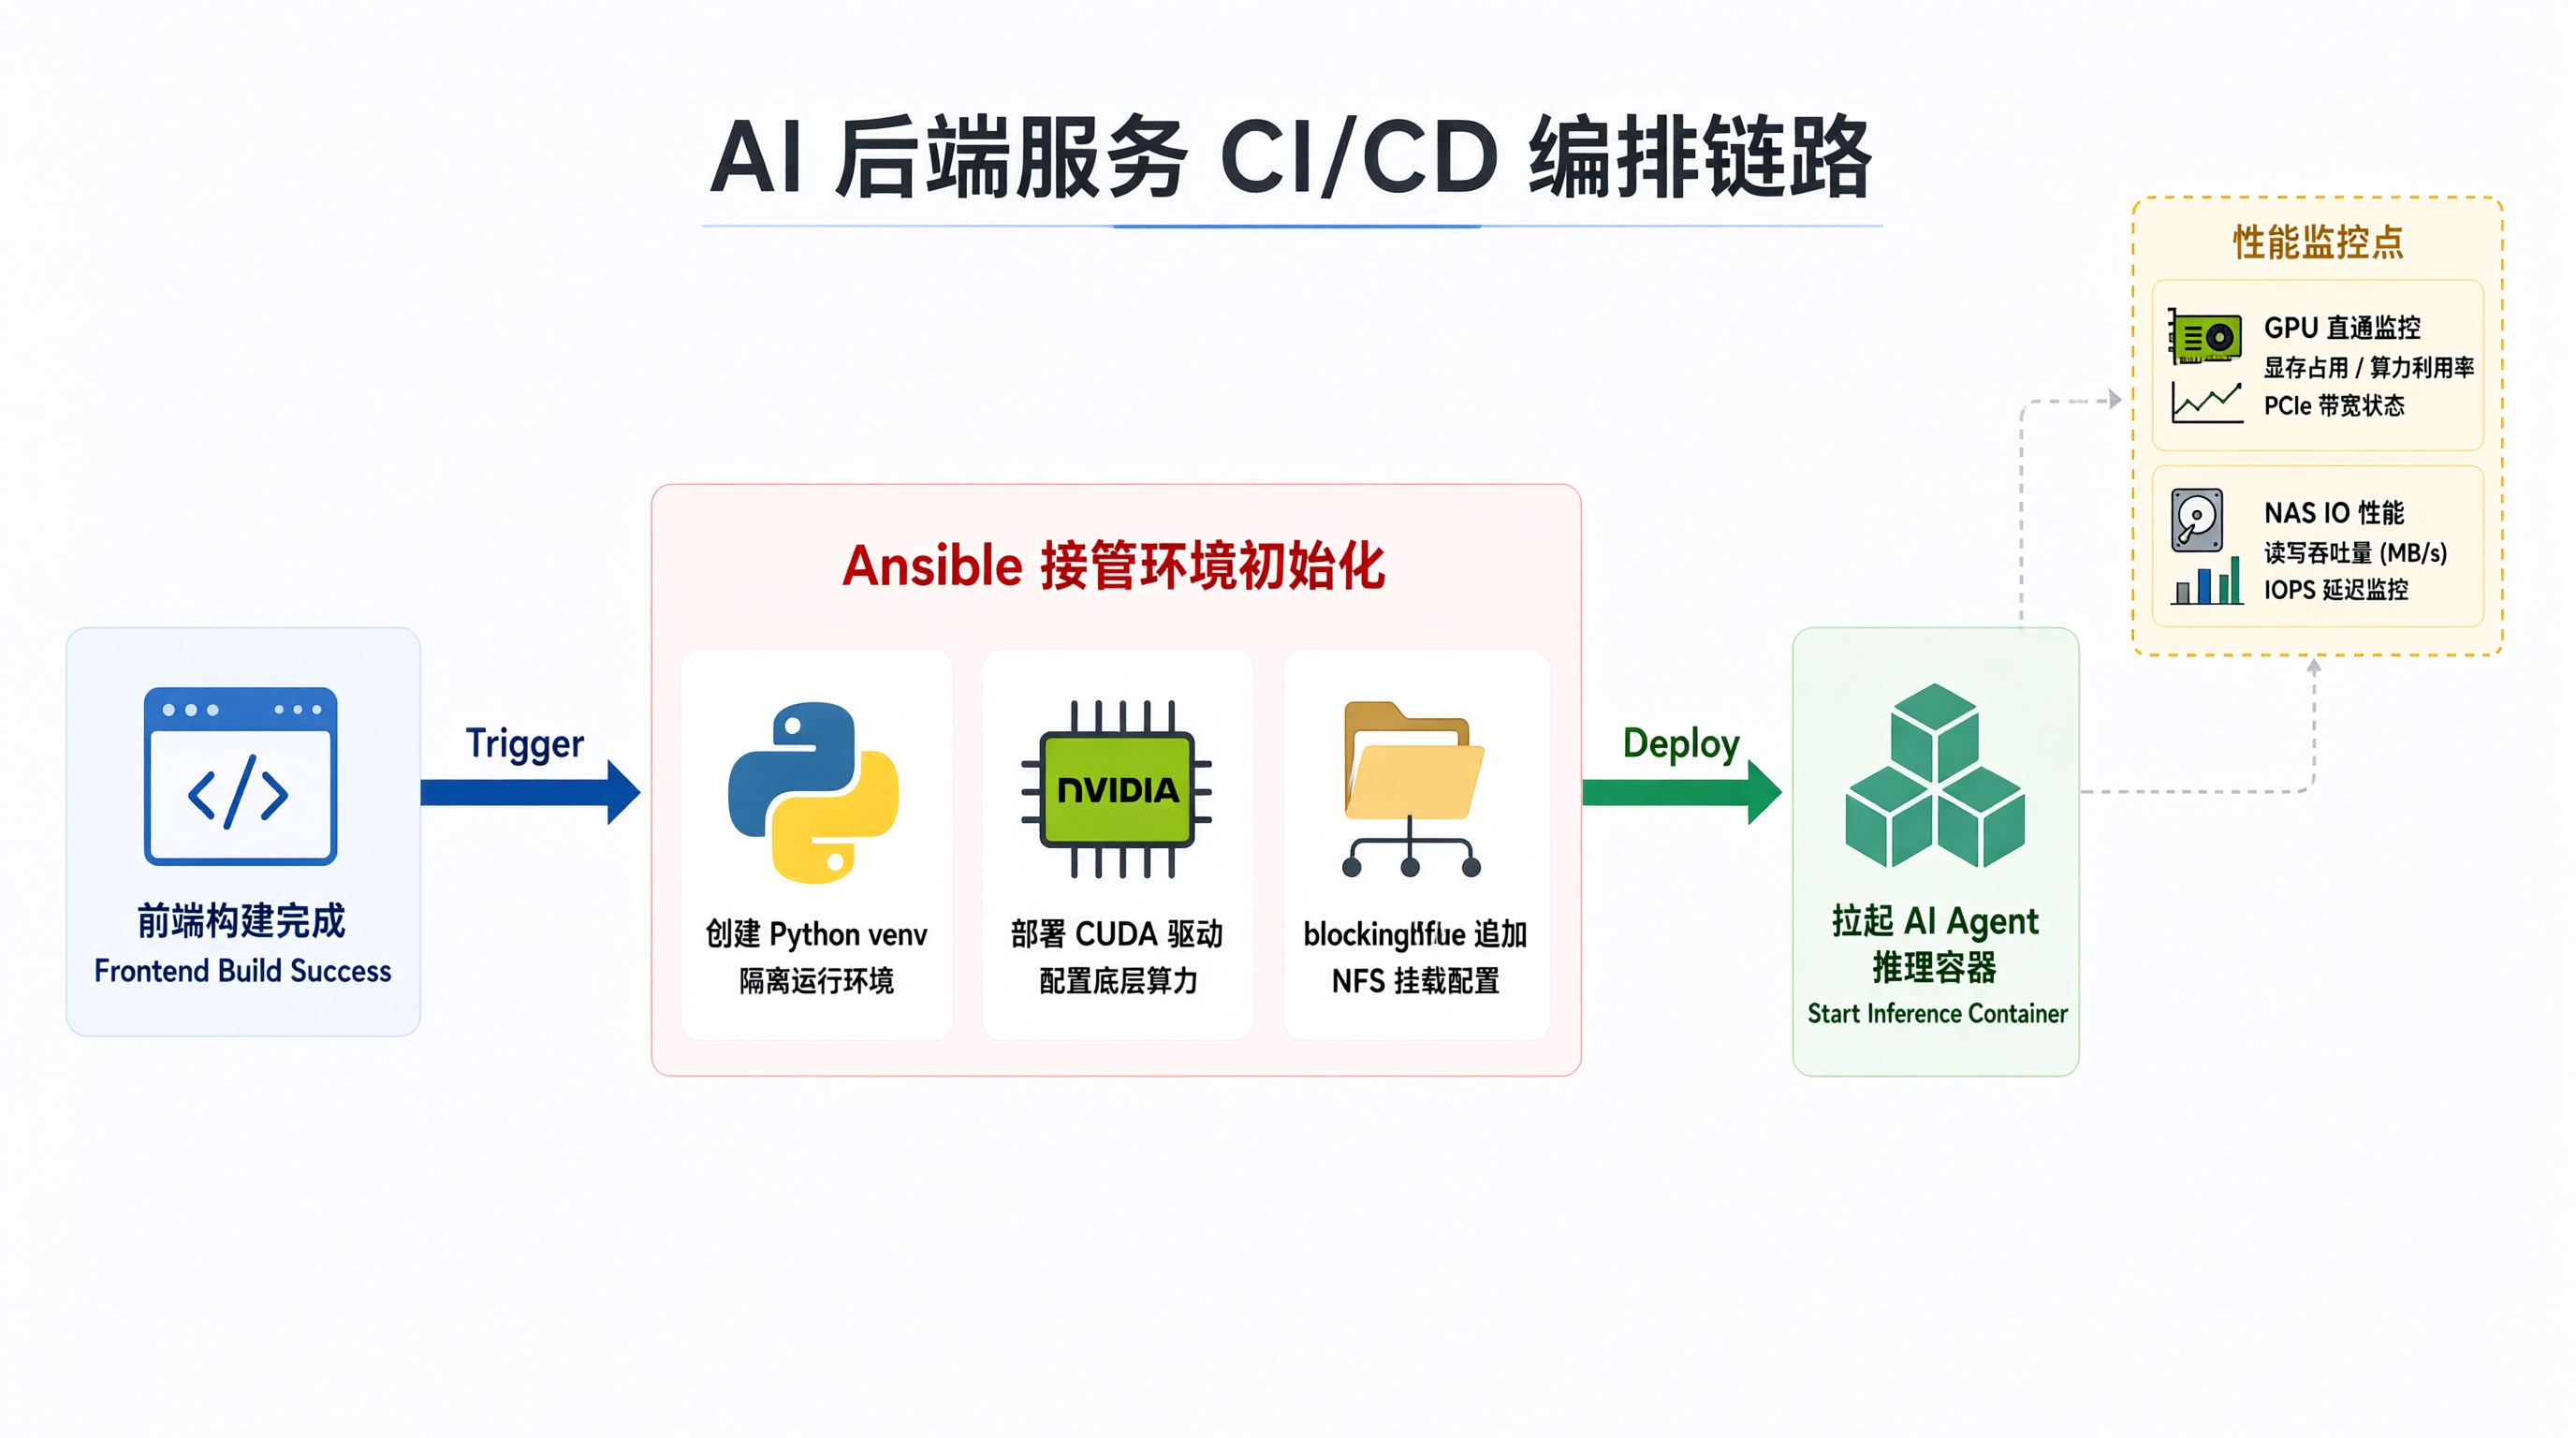
这套 Playbook 并不是孤立存在的。在我的工作流里,它通常是 CI/CD 流水线的第一个阶段。Node.js 前端打包完后,Ansible 负责把基础环境铺好,紧接着拉取 Python 虚拟环境、配置 CUDA 驱动、挂载 NAS 存储卷。
对于 AI Agent 或大模型推理服务,Docker 只是载体。真正的瓶颈通常在 GPU 直通和数据盘 IO。我在 Playbook 里预留了 blockinfile 接口,用于追加 /etc/fstab 的 NFS 挂载条目。当后续需要扩容存储时,只需要改 Inventory 里的变量,重新跑一遍即可,不需要登录每台机器手动编辑挂载表。
此外,Ansible 支持 –limit 参数。如果第三台节点磁盘空间不足导致容器无法创建,我可以单独对 node3 执行清理任务,而不影响其他两台。这种细粒度控制是 Shell 脚本很难做到的。
边界情况与后续演进方向
自动化不是银弹。如果你的集群规模始终维持在两台以内,或者业务形态高度动态(比如每天临时申请十台裸金属服务器),引入 Ansible 的学习成本和状态管理开销反而会成为负担。在这种情况下,保持脚本化或直接用云厂商的控制台可能是更务实的选择。
当节点数增长到二十台以上,且配置复杂度继续上升时,我会考虑将这套 Playbook 升级为 Role,并接入 AWX 或 Ansible Automation Platform。图形化审批流、审计日志、版本回滚能力会在团队协作中发挥更大价值。目前单机或少量节点的场景,纯 YAML 文件配合 Git 管理已经足够清晰。
我还保留了一个疑问:容器编排层面是否应该把 Podman 纳入兼容列表。Podman 无守护进程的特性在安全隔离上有优势,但生态兼容性不如 Docker 成熟。这一点我没有在实际生产环境中验证过替代方案,暂时仍维持以 Docker Engine 为主的技术栈。
基础设施的配置不应该停留在记忆和聊天记录里。把重复动作沉淀为可版本管理的 Playbook,本质上是把个人的经验转化为团队的可复用具象资产。当你不再需要盯着屏幕敲完二十行命令,而是把注意力放回业务逻辑和架构设计上时,这套工具的价值才算真正兑现。


评论前必须登录!
注册