 网硕互联帮助中心
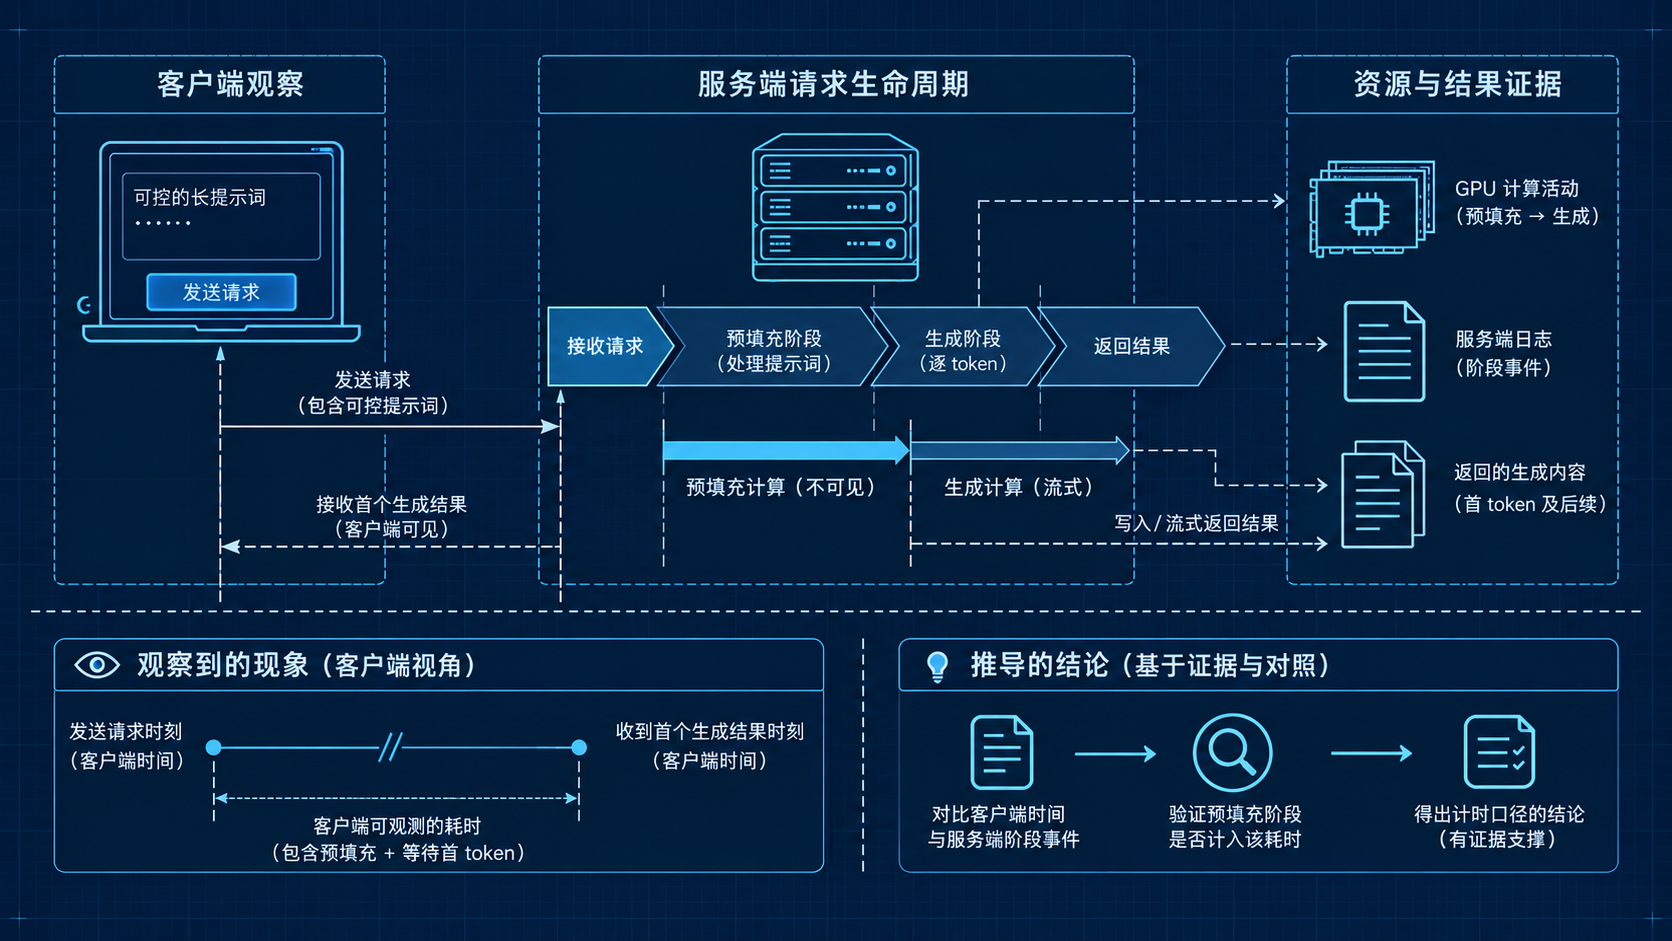
给指标起名叫“预填充时间”很容易,证明它真的测了预填充却需要实验。客户端首内容延迟包含多段等待,调度器的一个事件也未必覆盖全部输入处理。先验证口径,再拿数字比较优化效果。
从最容易解释的条件开始
选择固定模型、模板和输入,低并发逐条运行,保留服务端事件与客户端时间。记录缓存状态,避免逻辑输入很长却大量复用前缀。预热与正式采样分开,不能在看见慢结果之后才把它划为预热。
需要区分三种边界:第一次调度到最后一块输入完成的墙钟跨度、各输入计算片段之和,以及客户端等待首内容的跨度。前两种在分块或竞争场景下可以不同,第三种还包含输入处理之外的工作。
一次只改变输入长度
保持到达方式和输出条件不变,使用若干预先定义的输入长度。目的不是证明时间必须线性增加,而是检查事件是否随实际处理路径变化。若增加逻辑长度后指标不变,先查前缀复用、截断和计时边界,不直接宣称实现无限加速。
随后开启可控竞争,让同一请求的输入处理跨越多个调度轮次。若指标表示墙钟跨度,它应能够包含轮次之间的等待;若表示设备执行片段,它就不应被解释成用户经历的全部等待。
检查测量是否改变执行
设备异步执行时,主机提交结束不等于设备完成。为了计时在每个请求上强制同步,又可能破坏流水线。精细设备测量应在诊断环境中验证,再决定采用事件采样或已有低开销指标。
记录同一块的开始与结束,缺失事件标记缺失,不能填零。发生重算时区分首次处理与重复计算,否则输入工作量增加会被误认为单次计算变慢。
用结果约束指标解释
把每组输入的事件序列、实际 token 与缓存观测放在一起,逐条检查先后关系。若指标无法区分调度等待与执行,就在名称和说明中保留这一限制。
vLLM 的指标设计可作为核对观测层级的入口,参见 官方指标说明。实际事件定义仍以部署版本为准。一个可用的计时口径,应能解释隔离、分块与竞争三类请求,而不是只在一条理想请求上看起来合理。


评论前必须登录!
注册