 网硕互联帮助中心
标签:RocketMQ | 消息积压 | 排查 | 扩容 | 队列不均 | 消费并行度 | mqadmin | 面试
适合人群:线上被消息积压告警叫起来、第一反应是“加消费者”但发现没用的后端开发和 SRE
阅读收益:搞清楚积压排查的正确顺序(先止损、再定位、后扩容)、为什么“加消费者”在队列不均时完全无效、消费并行度的硬上限由什么决定,以及 mqadmin 里最该先敲的那几条命令
前言:加了 4 台消费者,积压一点没降
一个 canal 同步链路在业务高峰期积压了 30 多万条消息。值班同学的第一反应是扩容消费端,把消费者实例从 2 台加到 6 台。监控显示消费 TPS 纹丝不动,积压继续增长。
排查后发现:这个 Topic 虽然有 4 个队列,但生产者(canal)的默认分区逻辑把所有消息都写到了 0 号队列。RocketMQ 的并行度上限由队列数决定,一个队列同一时刻只能被一个消费线程消费。4 个队列里 3 个是空的,剩下的 1 个队列无论加多少消费者实例,都只有 1 个线程在真正干活。
“加消费者”是积压处理中最常见、也最容易被误用的动作。这篇按 先止损 → 再定位 → 后扩容 的顺序,把每一步该看什么、该动什么拆开。
一、先止损:积压正在影响业务时,扩容之前先做这三件事
积压排查的第一个原则是:如果积压已经影响到核心业务,不要先花 30 分钟查根因,先止损。
第一,降级非核心消费。 同一消费组里如果混跑了日志、统计、推送等非核心逻辑,先把这些消费停掉或降级,把消费线程、数据库连接和下游资源全部让给核心消息。积压状态下,消费端每一份资源都应该优先服务关键链路。
第二,检查死信和毒消息是否在阻塞队列。 一条处理永远失败的消息,如果消费逻辑没有正确返回状态,可能长期占据一个消费线程甚至卡住整个队列。mqadmin consumerProgress 看 DiffTotal 的分布,如果某个队列的积压量远远高于其他队列,先怀疑这个队列上有毒消息。
第三,评估是否需要跳过或转储。 积压量达到百万级以上时,直接“原地消费”可能把 Broker 和下游一起拖垮。一个应急方案是用独立的转发消费者把积压消息快速转存到 Redis/MySQL/OSS,先清空队列、恢复业务,高峰期过后再慢慢回放处理。这个动作会引入额外的数据管理成本,只在积压已经阻塞业务、常规扩容无法快速见效时使用。
二、定位:三条链路按顺序看,90% 的问题在消费端
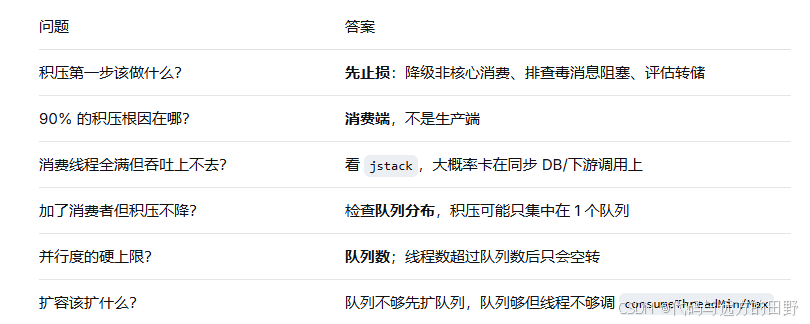
止损之后,进入根因定位。顺序比工具重要:先看消费端,再看 Broker,最后看生产端。搜索材料中反复出现的数据是,90% 以上的积压问题出在消费端。
第一步,消费端:消费线程在干什么。 用 jstack <consumer_pid> | grep ‘consumeExecutor’ 看消费线程的状态。如果所有 ConsumeMessageThread_* 都处于 RUNNABLE 但阻塞在同一个堆栈(比如 orderService.save() 的 JDBC 调用),问题就是下游同步写入太慢,不是线程不够。这时候加线程只会把更多请求压到已经饱和的数据库上。
一个真实案例的完整链路是:接口耗时从 200ms 涨到 5s,消费 lag 涨到 50 万,jstack 显示 20 个消费线程全部卡在同步 DB 写入。消费慢导致 max.poll.interval.ms 超时,触发 Rebalance,队列在实例间反复迁移,形成“消费慢 → Rebalance → 重复消费 → 更慢”的死亡螺旋。在这种情况下,正确的动作是优化下游写入(异步化、批量落库、连接池调优) ,而不是扩容。
第二步,队列分布:积压是不是“不均”。 用 mqadmin consumerProgress 看每个队列的 DiffTotal。如果积压集中在少数队列上,加消费者实例是无效的——没有消费者分到那个热点队列,新增的实例只会空转。队列不均的根因通常在生产端的分区逻辑:canal 默认只写 0 号队列、或者哈希键的选择导致严重倾斜。解法是修改生产端的队列选择规则,让消息均匀分布到所有可用队列。
第三步,Broker 端:PUT 请求是否在排队。 如果生产端的 send 调用耗时也从 50ms 涨到 1–2s,说明 Broker 收到了消息但处理变慢,PUT 请求在排队。这时候看 Broker 的磁盘 I/O、页缓存命中率和 CPU。Broker 瓶颈的典型信号是多个不相关的消费组同时出现积压,而消费端线程状态看起来正常。
三、扩容的正确姿势:先确认并行度上限,再决定扩什么
扩容的前提是并行度上限已经确定。RocketMQ 的消费并行度由两个维度共同决定,扩容必须同时匹配这两层:
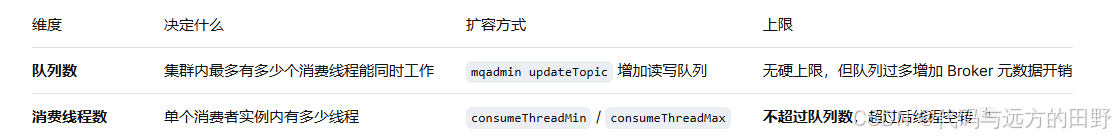
如果队列数足够但线程不够:调大 consumeThreadMin 和 consumeThreadMax。这两个值建议设为相等,因为消费端的线程池队列是无界的,设成不等时 consumeThreadMax 可能永远不会生效。默认是 20,对于 I/O 密集型消费可以适当上调,但线程数最终受限于下游连接池和数据库的并发承受能力。
如果队列数本身就不够:先扩队列,再扩消费者实例。一个 4 队列的 Topic,无论加多少实例,最多只有 4 个消费线程在工作。扩队列的命令是:
mqadmin updateTopic -n namesrv:9876 -t order-events \\
-c DefaultCluster -r 16 -w 16
如果积压量大且允许短暂不一致:可以临时新建一个队列数更多的 Topic,用轻量级转发消费者把积压消息快速搬到新 Topic,下游从新 Topic 多实例并行消费,实现数十倍速的积压出清,之后再切回原链路。这个方案的本质是用临时的架构复杂度换恢复速度,适合“业务已经不可用、需要分钟级恢复”的场景。
四、mqadmin 排查命令速查
积压排查中最高频的四条命令:
# 1. 看消费组整体积压(DiffTotal)和每个队列的分布
mqadmin consumerProgress -n namesrv:9876 -g order-consumer-group
# 2. 看 Topic 各队列的位移差,确认队列是否不均
mqadmin topicStatus -n namesrv:9876 -t order-events
# 3. 看死信队列的堆积量
mqadmin statsMessage -n namesrv:9876 -t %DLQ%order-consumer-group
# 4. 看消费者连接和线程配置是否生效
mqadmin consumerConnection -n namesrv:9876 -g order-consumer-group
consumerProgress 的输出里,DiffTotal 是总积压,每个队列的 Diff 列才是判断“不均”的依据。topicStatus 看的是队列级别的 max offset 和 consumer offset,如果某个队列的 consumer offset 长期停滞而其他队列正常推进,说明那个队列上有消费端的问题(毒消息、线程阻塞、或者根本没有消费者持有那个队列)。
本篇小结



评论前必须登录!
注册