 网硕互联帮助中心
摘要:上一篇进入存储层,看到请求最终调 Log.append 落盘。但 Broker 上成百上千个分区的 Log 对象是谁创建的?Broker 重启后怎么知道哪些数据可靠、哪些要恢复?日志段滚动、过期删除、日志压缩、周期刷盘又是谁在后台默默做的?答案都是 LogManager。这篇讲透这个"不露面但管着全部数据文件"的组件。
关键词:Kafka LogManager、日志加载恢复、recovery point、日志保留 retention、日志压缩 compaction、LogSegment 滚动、检查点
为什么需要 LogManager
先说一个我踩过的坑。有台 Broker 异常宕机(机器掉电),重启后卡了二十多分钟才对外提供服务,监控显示这期间 CPU 不高、但磁盘读很活跃。当时不理解:Kafka 重启不就是打开几个文件吗,为什么这么慢?
后来读了 LogManager 的启动逻辑才明白:宕机重启要对所有未刷盘确认的日志段逐条消息做恢复——校验 CRC、截断脏数据、重建索引。分区和段越多,恢复越慢。这件事就是 LogManager 干的。
上一篇的请求路径里,ReplicaManager → Partition → Log,看起来没有 LogManager 什么事。但每个 Log 对象本身、Log 背后的目录和段文件、以及 Log 写完之后的一切"善后工作",全归 LogManager 管。它是 Broker 上所有日志的工厂 + 管家 + 后台任务调度中心。
01 LogManager 在存储栈中的位置
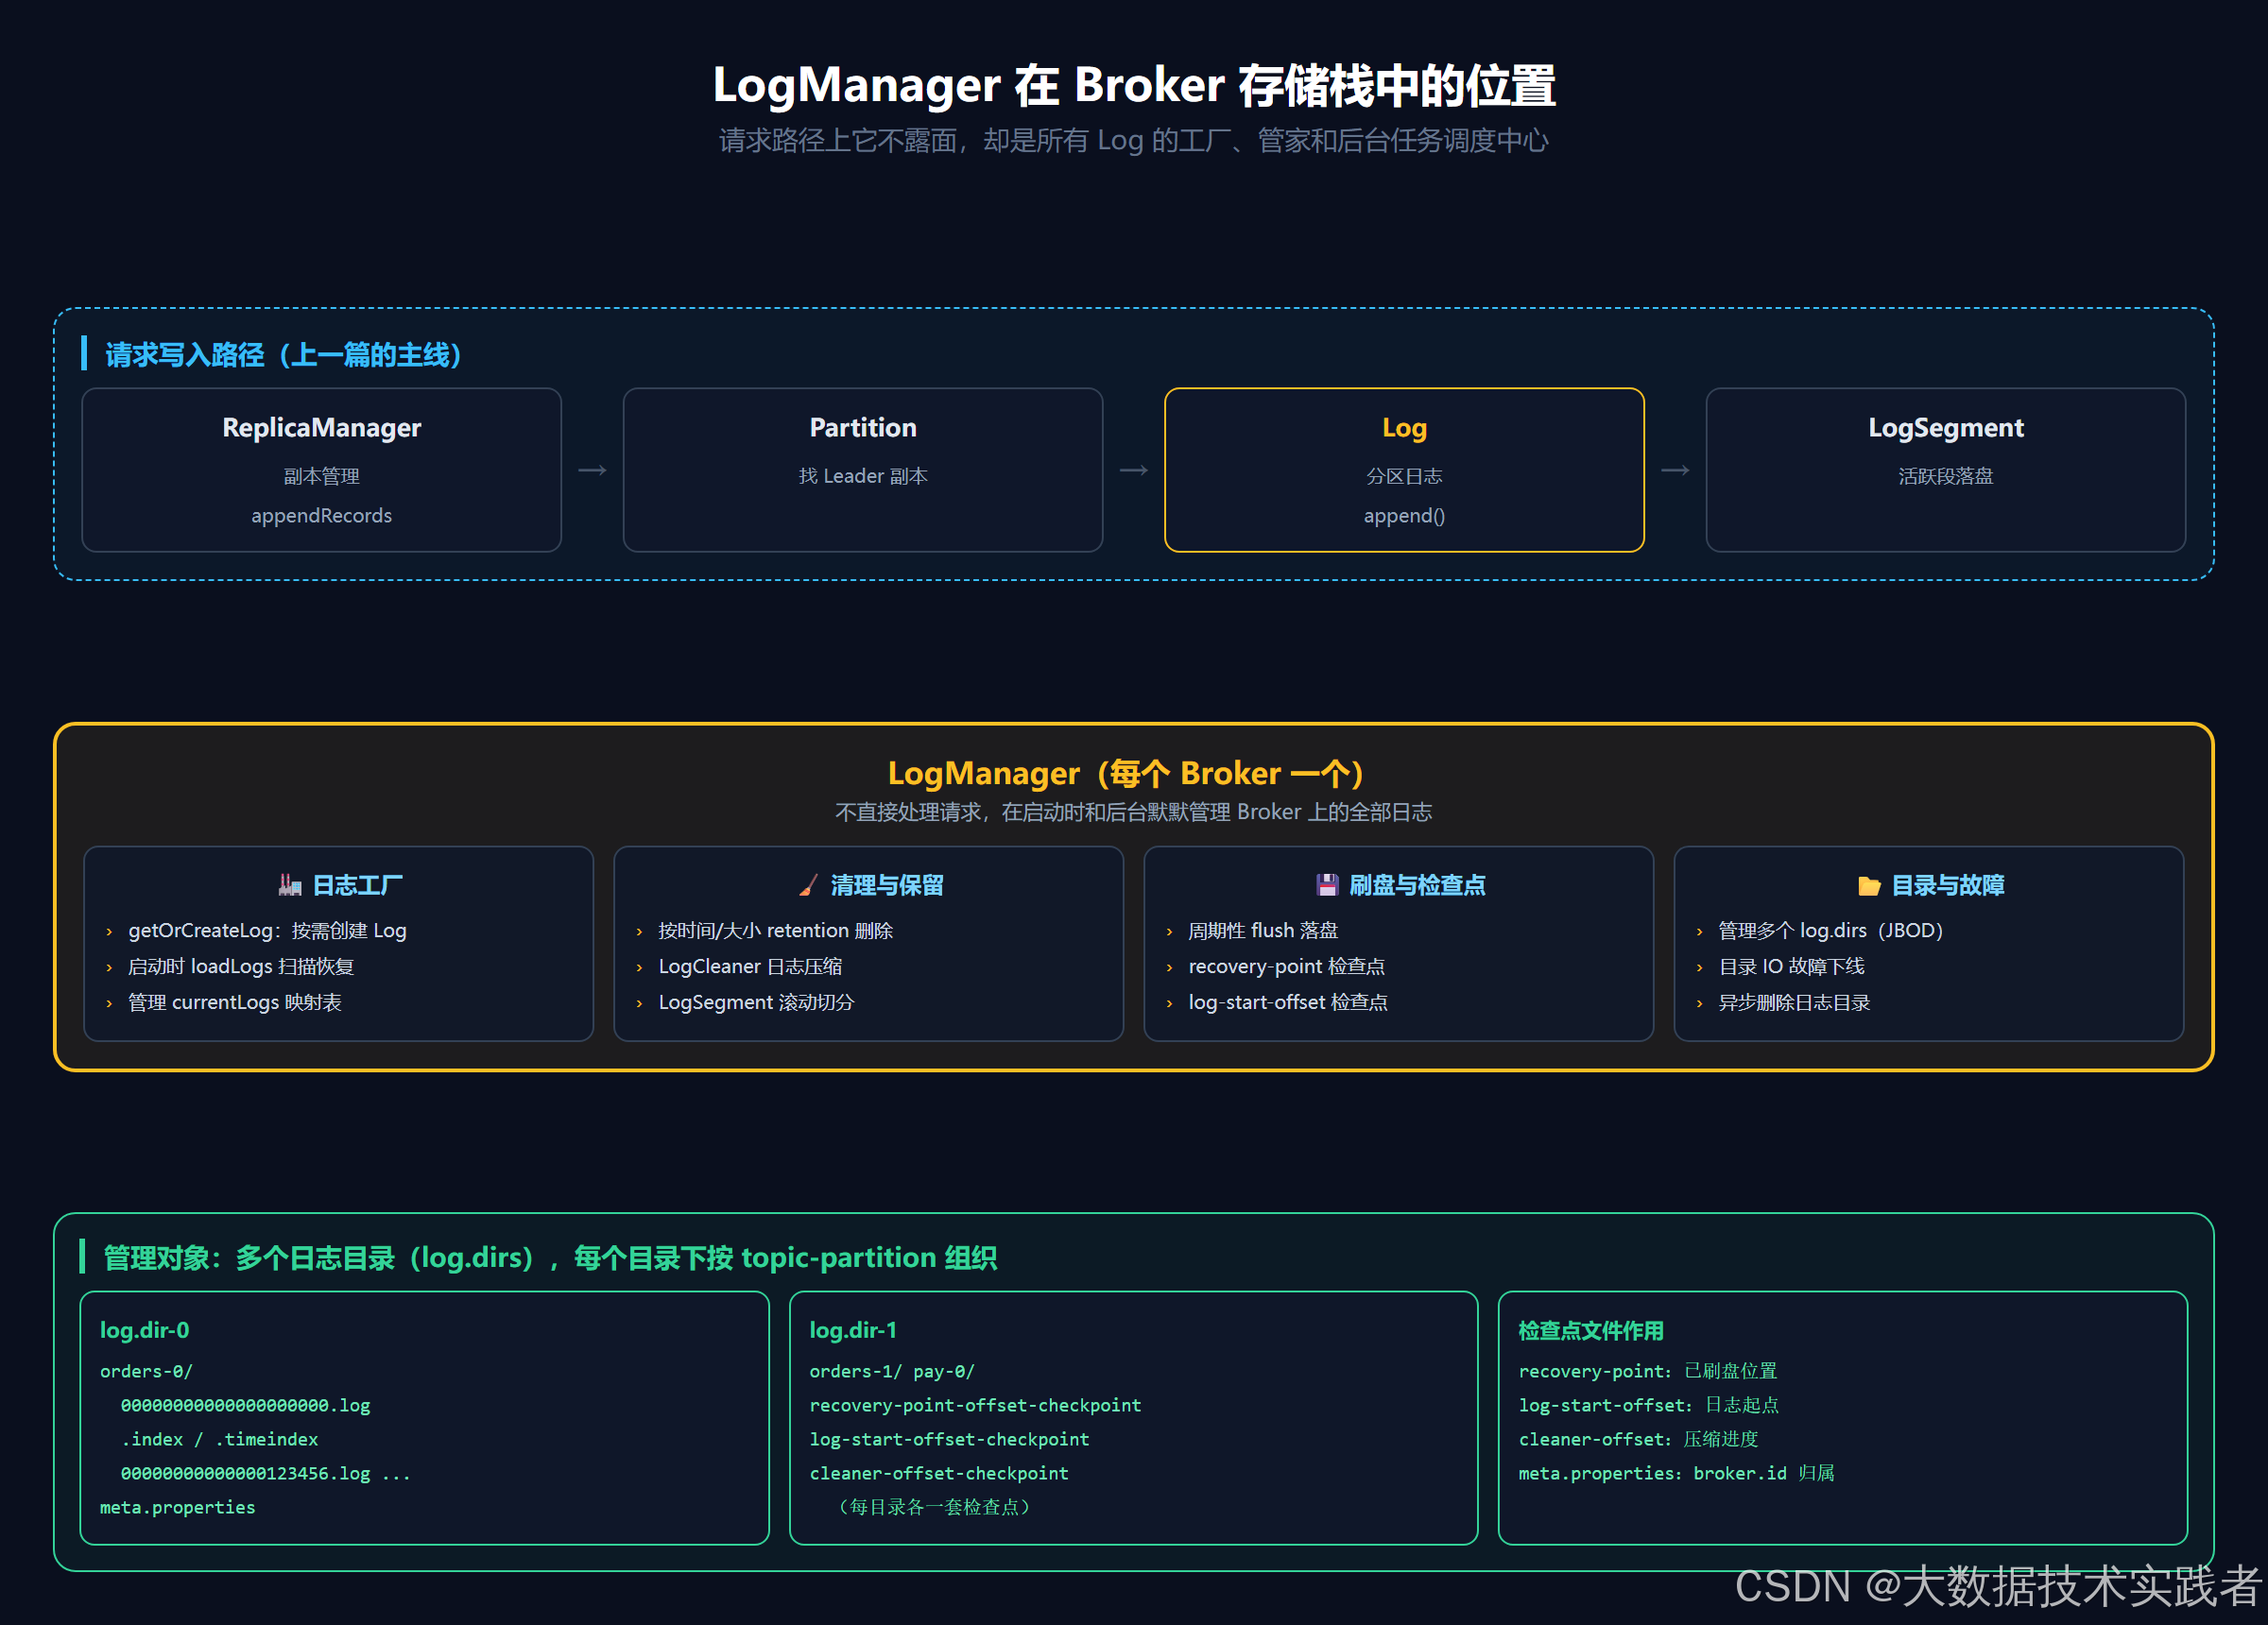
LogManager 每个 Broker 只有一个,在 Broker 启动时创建,主要持有三样东西:
class LogManager(
logDirs: Seq[File], // 日志目录列表(log.dirs,可配多个盘)
val initialTaskDelayMs: Long, // 后台任务初始延迟
scheduler: KafkaScheduler, // 周期任务调度器
...
val logCleaner: LogCleaner, // 日志压缩组件
...) {
// 核心:topic-partition -> Log 的映射
private val currentLogs = new Pool[TopicPartition, Log]()
}
它对上不直接处理请求,对下管理着磁盘上的实体文件。一个 Broker 配置多个 log.dirs(典型的 JBOD 用法,多块盘分担 IO),每个目录下按 topic名-分区号 组织子目录,里面是一个个以基准 offset 命名的 LogSegment 文件:
/kafka-data-0/orders-0/
00000000000000000000.log # 数据文件
00000000000000000000.index # 偏移量稀疏索引
00000000000000000000.timeindex # 时间戳索引
0000000000000000123456.log # 滚动后的新段
…
/kafka-data-0/
recovery-point-offset-checkpoint # 各分区已刷盘确认位置
log-start-offset-checkpoint # 各分区日志保留起点
cleaner-offset-checkpoint # 各分区压缩进度
meta.properties # 记录这台Broker的cluster.id/broker.id
这几个 checkpoint 文件是理解 LogManager 的钥匙,后面反复出现。
02 启动时:加载与恢复日志
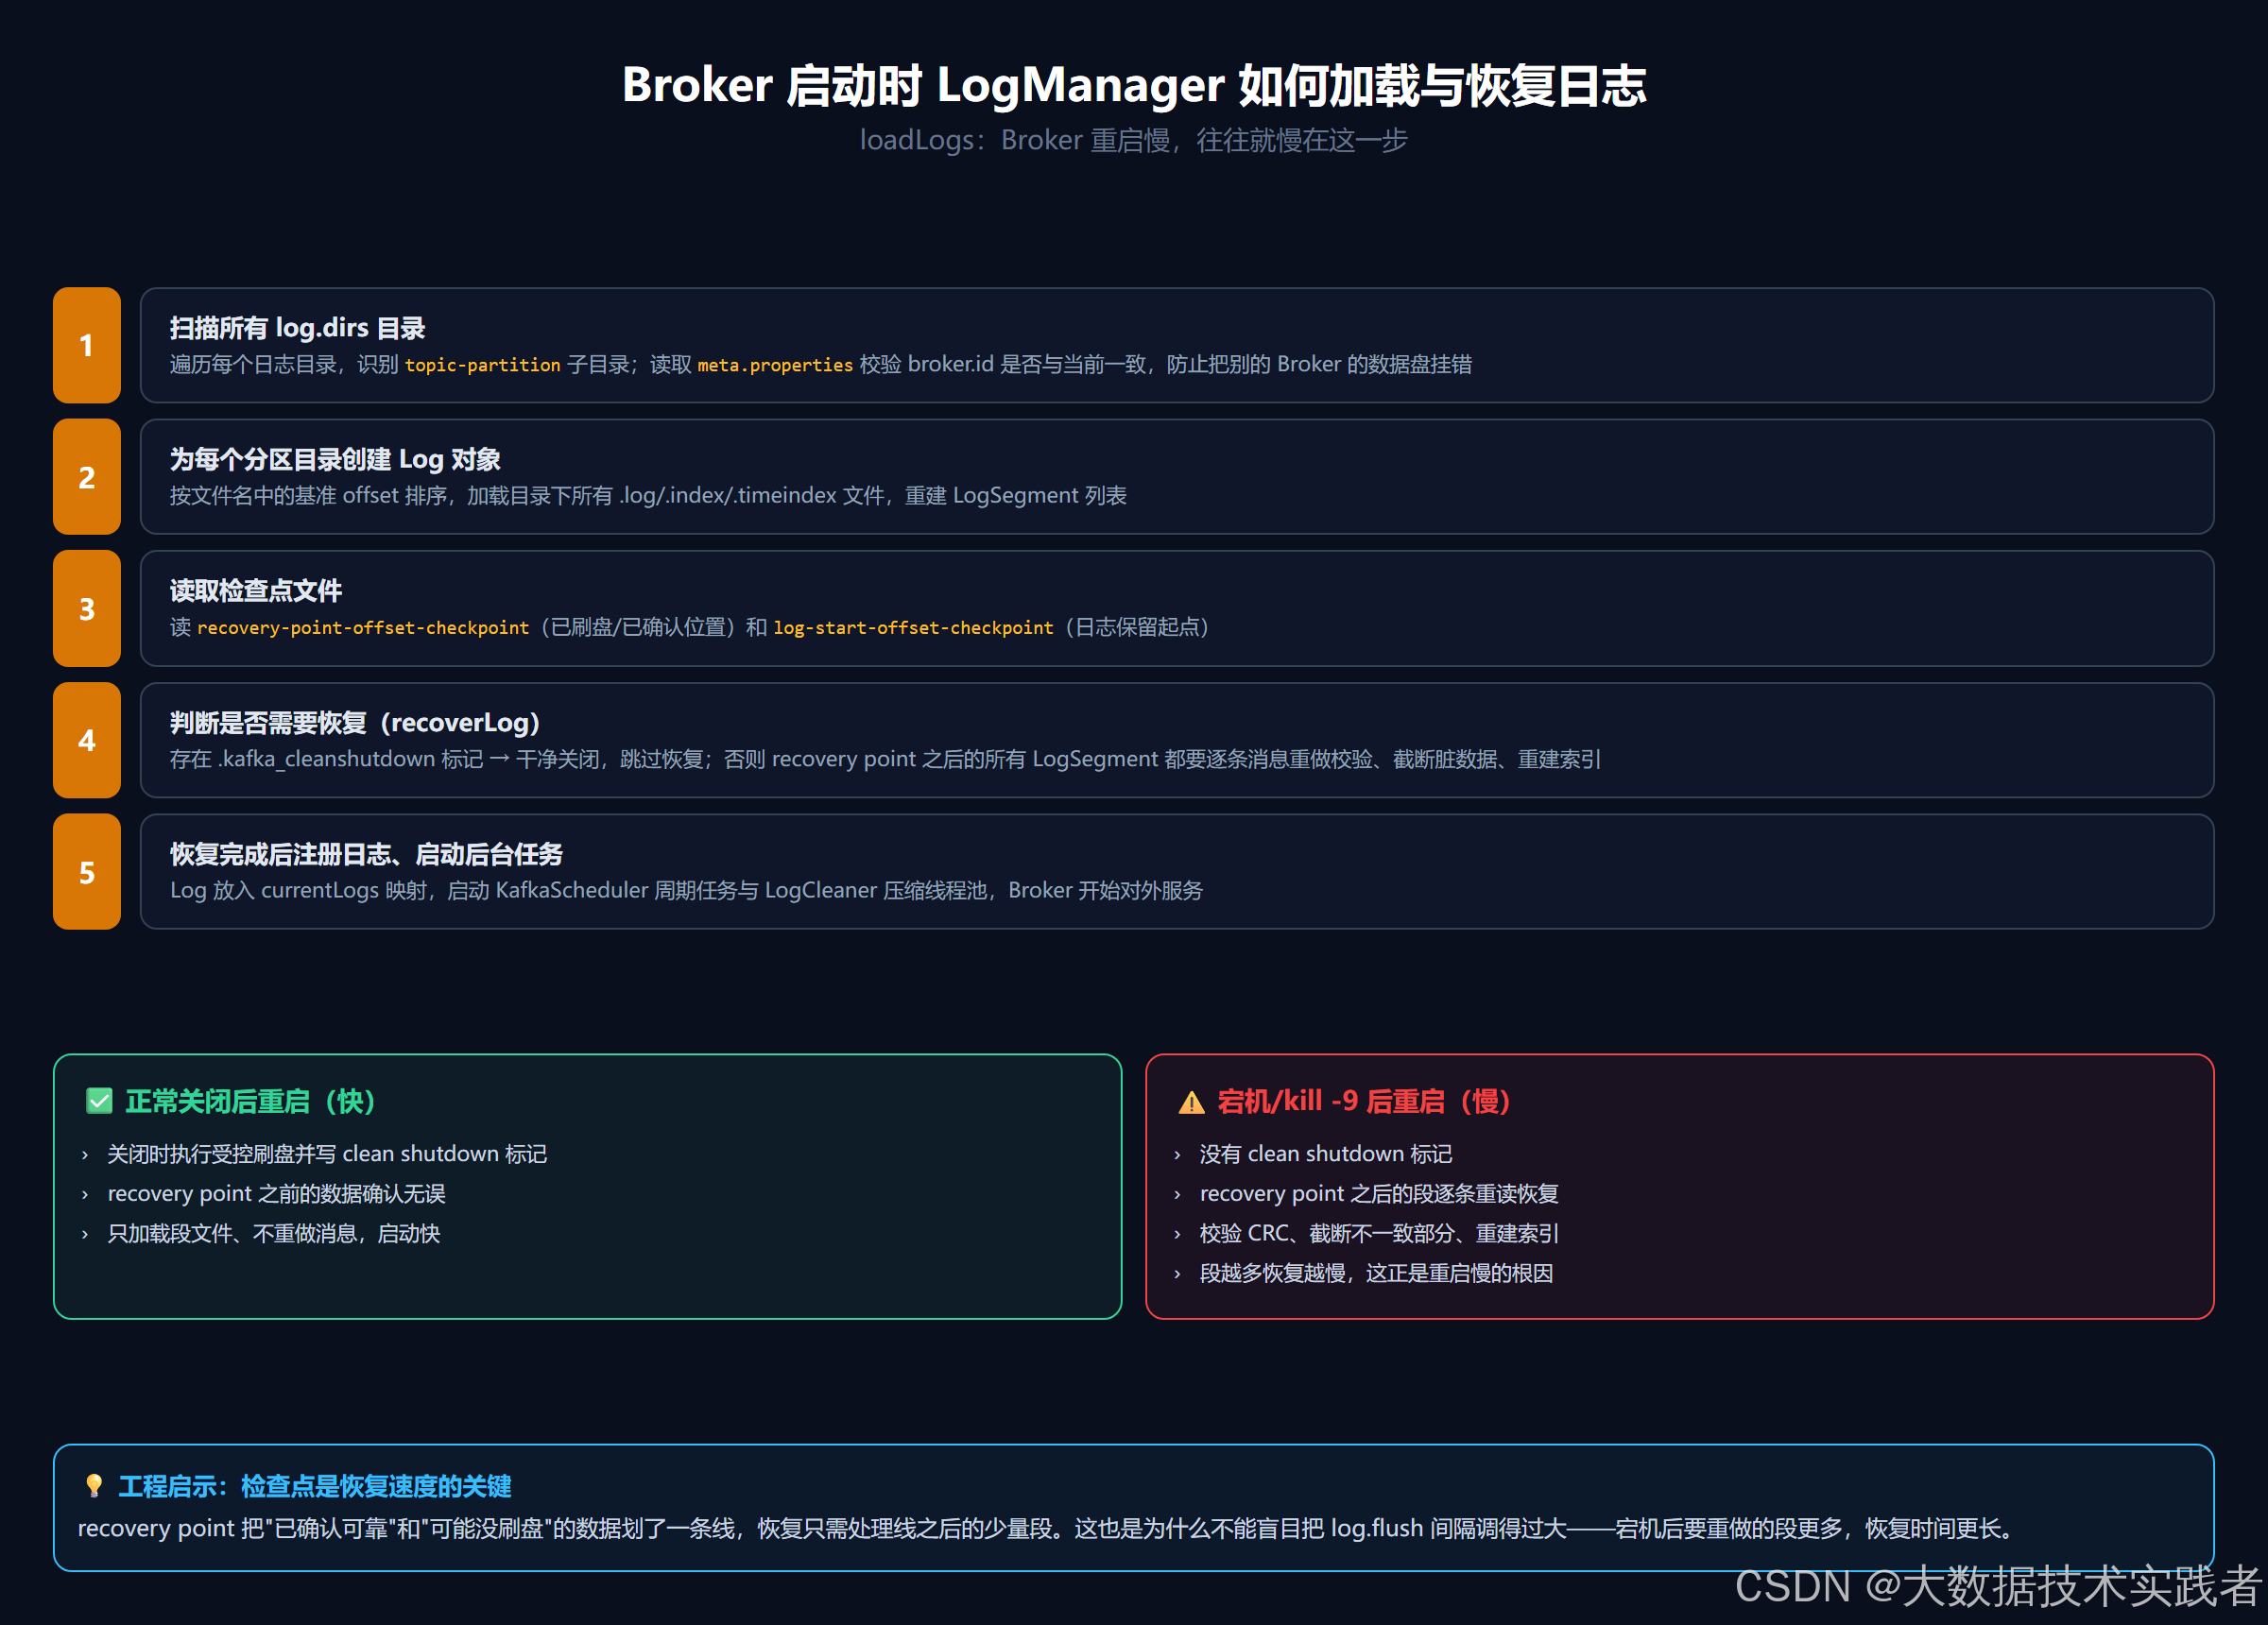
Broker 启动,LogManager.loadLogs 要把磁盘上的日志全部"读回内存",分五步:
第一步,扫描目录。 遍历每个 log.dirs,识别分区子目录,先读 meta.properties 校验 broker.id 和 cluster.id——这一步防止运维把别的 Broker 的数据盘误挂到本机,那会造成数据归属混乱。
第二步,为每个分区创建 Log 对象。 把目录下的 .log/.index/.timeindex 文件按文件名里的基准 offset 排序,重建出 LogSegment 列表。
第三步,读检查点。 重点是 recovery point(恢复点):它标记"这个 offset 之前的数据已经 fsync 落盘、确认可靠",之后的数据可能还只在页缓存里。
第四步,判断是否恢复。 这里就是开头那个坑的根源:
// 干净关闭会留下 .kafka_cleanshutdown 标记文件
if (hasCleanShutdownFile) {
// 正常关闭:所有段都可靠,跳过恢复,删除标记
} else {
// 异常宕机:recovery point 之后的段全部 recoverLog()
// 逐条消息读、校验CRC、重建索引
// 遇到损坏处截断(truncate),丢弃脏数据
}
第五步,注册并启动后台任务。 Log 放入 currentLogs 映射,随后启动 KafkaScheduler 和 LogCleaner,Broker 才真正开始对外服务。
这里有个实用结论:Broker 重启慢,先看是不是异常宕机导致的日志恢复。想缩短恢复时间,一方面保证正常关闭(让 controlled shutdown 走完刷盘),另一方面要理解段大小的影响——段切得越小,恢复时要扫描的段边界越多;段越大,单段恢复时间越长,需要权衡。
03 运行期:四类周期任务 + 压缩线程池
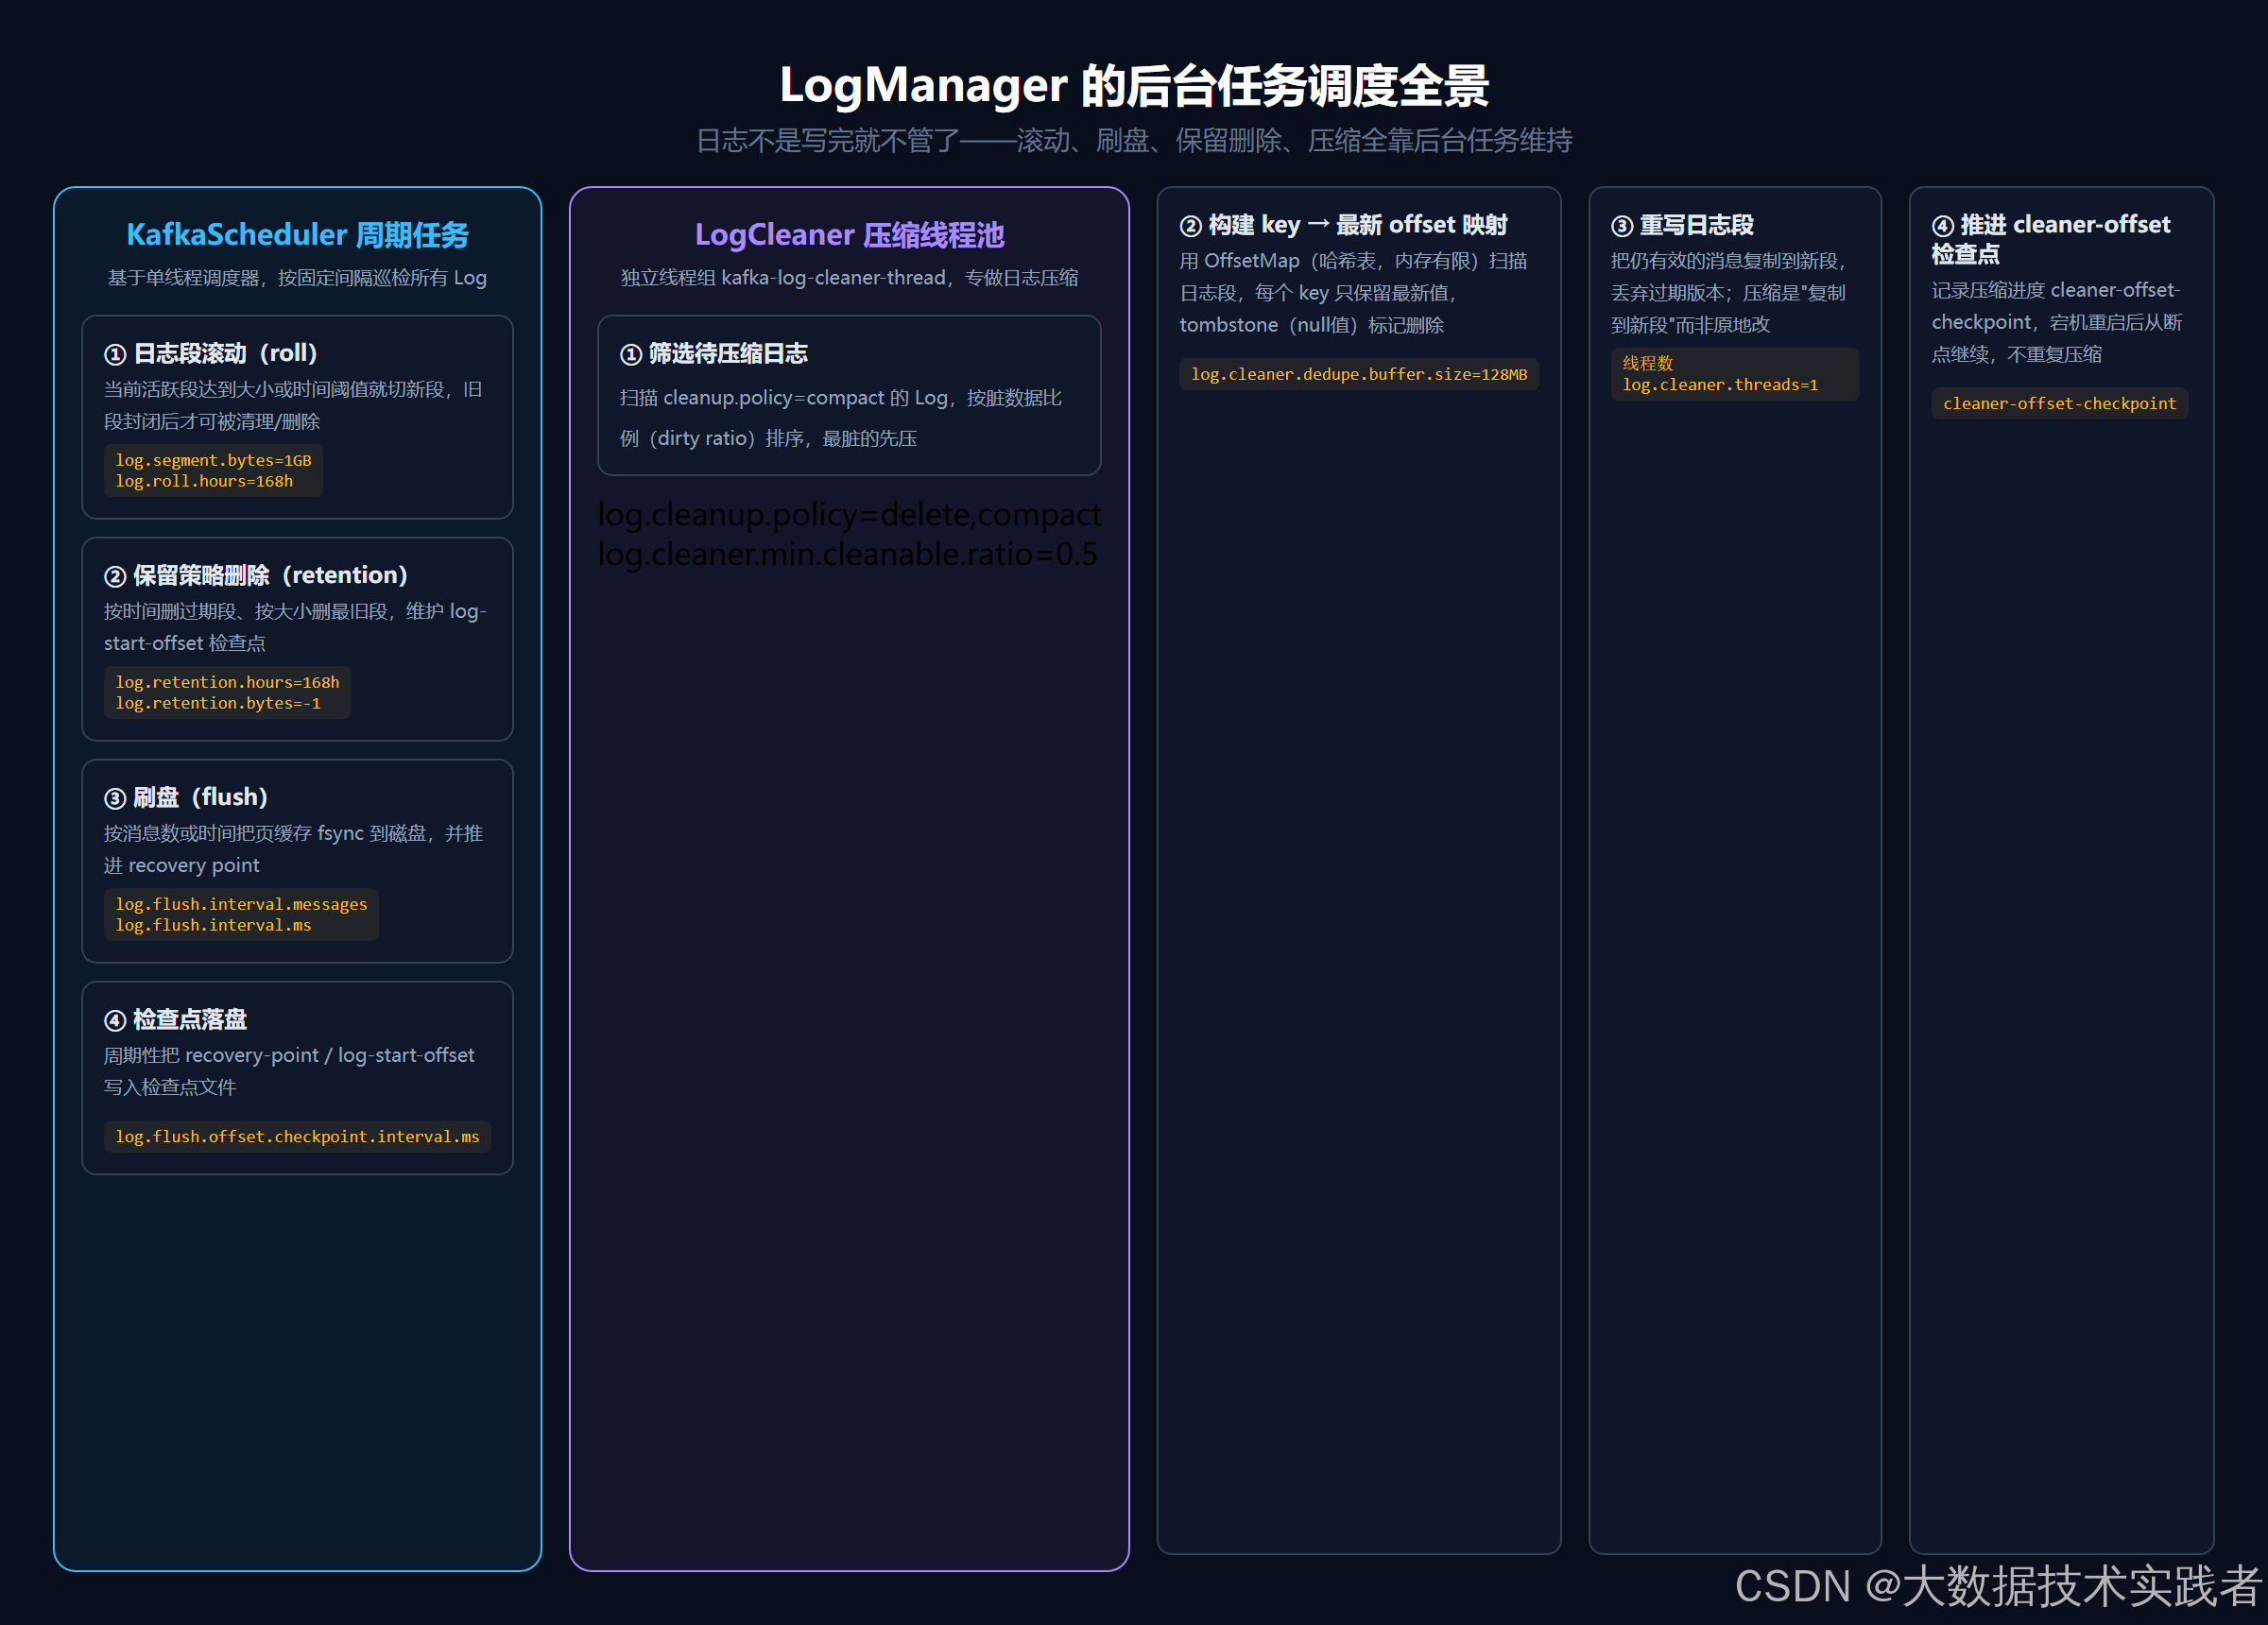
Broker 跑起来后,LogManager 靠两套后台机制维持日志的"健康"。
第一套:KafkaScheduler 周期巡检,负责四件事:
- 日志段滚动(roll):活跃段写满 log.segment.bytes(默认 1GB)或到达 log.roll.hours(默认 168 小时)就切新段。为什么要滚动?因为只有封闭的旧段才能被删除和压缩,活跃段永远在追加。
- 保留删除(retention):按时间删超过 log.retention.hours(默认 168 小时 / 7 天)的段,或按大小删到 log.retention.bytes 以内。删除时更新 log-start-offset 检查点。
- 刷盘(flush):Kafka 默认依赖操作系统页缓存延迟刷盘,也支持按 log.flush.interval.messages / log.flush.interval.ms 主动 fsync,刷完推进 recovery point。
- 检查点落盘:定期把 recovery point、log start offset 写回 checkpoint 文件。
第二套:LogCleaner 压缩线程池,专门处理 cleanup.policy=compact 的日志。它的思路是:对于按 key 记录状态的 topic(比如消费者位移主题 __consumer_offsets、配置变更主题),同一个 key 只保留最新值,旧版本物理清除:
压缩前(key=A 的多次更新): 压缩后:
A=1 B=x A=2 C=y A=3 B=x C=y A=3
^^^^^^^ A 的旧值全删 每个key只剩最新值
压缩流程是:按脏数据比例(dirty ratio,默认 0.5)挑最脏的 Log → 在内存哈希表(OffsetMap,去重缓冲默认 128MB)里建 key→最新offset 映射 → 把有效消息复制重写成新段(不是原地改)→ 推进 cleaner-offset-checkpoint。值为 null 的消息是 tombstone(墓碑),表示这个 key 被删除,压缩后也会在保留期后清掉。
几个值得记住的工程细节:
- 删除不是立刻做 IO:retention 命中的段先改名加 .deleted 后缀,由延迟任务异步真正删除,避免后台任务长时间持锁影响写入。
- 压缩慢不影响刷盘和滚动:两类任务用不同线程,log.cleaner.threads 默认只有 1 个,compact 主题多、写入量大时需要调大,否则会看到压缩跟不上、磁盘持续涨。
- 所有进度都有检查点:recovery-point、log-start-offset、cleaner-offset 三类检查点,保证任何时刻宕机,恢复都不会重复劳动或误删数据。
04 多目录(JBOD)的管理与故障处理
LogManager 对多个 log.dirs 还承担一个关键职责:新建分区时挑选剩余空间最多的目录(按可用磁盘空间轮询/优选),以及目录级故障隔离。
某块盘发生 IO 故障时,LogManager 会把这个目录标记为 offline,上面的分区进入失败状态并上报,Broker 进程不退出、其他盘继续工作。这也是用 JBOD 的代价:单盘故障只影响该盘上的分区,但这些分区会变成离线副本,依赖多副本把它们切到其他 Broker。生产上是否用多目录、是否上 RAID,要结合这种故障模型来选。
写在最后
LogManager 这个组件很容易被读源码的人跳过——它不在请求热路径上,没有精巧的网络模型,代码里大量是文件遍历和定时任务。但正是它决定了三件运维中最要命的事:Broker 重启要多久(日志恢复)、磁盘会不会被写满(保留与压缩)、宕机会不会丢数据(刷盘与检查点)。
读它的回报也很直接:理解了 recovery point,就懂了重启慢和刷盘参数的关系;理解了段滚动,就懂了为什么保留删除总是"滞后"的;理解了 compaction,就敢把 Kafka 当 key-value 状态存储用。下一篇我们回到热路径,深入 Log.append,看一条消息拿到 offset、写进活跃段的完整过程。


评论前必须登录!
注册