 网硕互联帮助中心
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于深度学习的鸟类物种图像分类研究介绍
- 基于深度学习的鸟类物种图像分类研究演示视频
- 基于深度学习的鸟类物种图像分类研究演示图片
- 基于深度学习的鸟类物种图像分类研究代码展示
- 基于深度学习的鸟类物种图像分类研究文档展示
基于深度学习的鸟类物种图像分类研究介绍
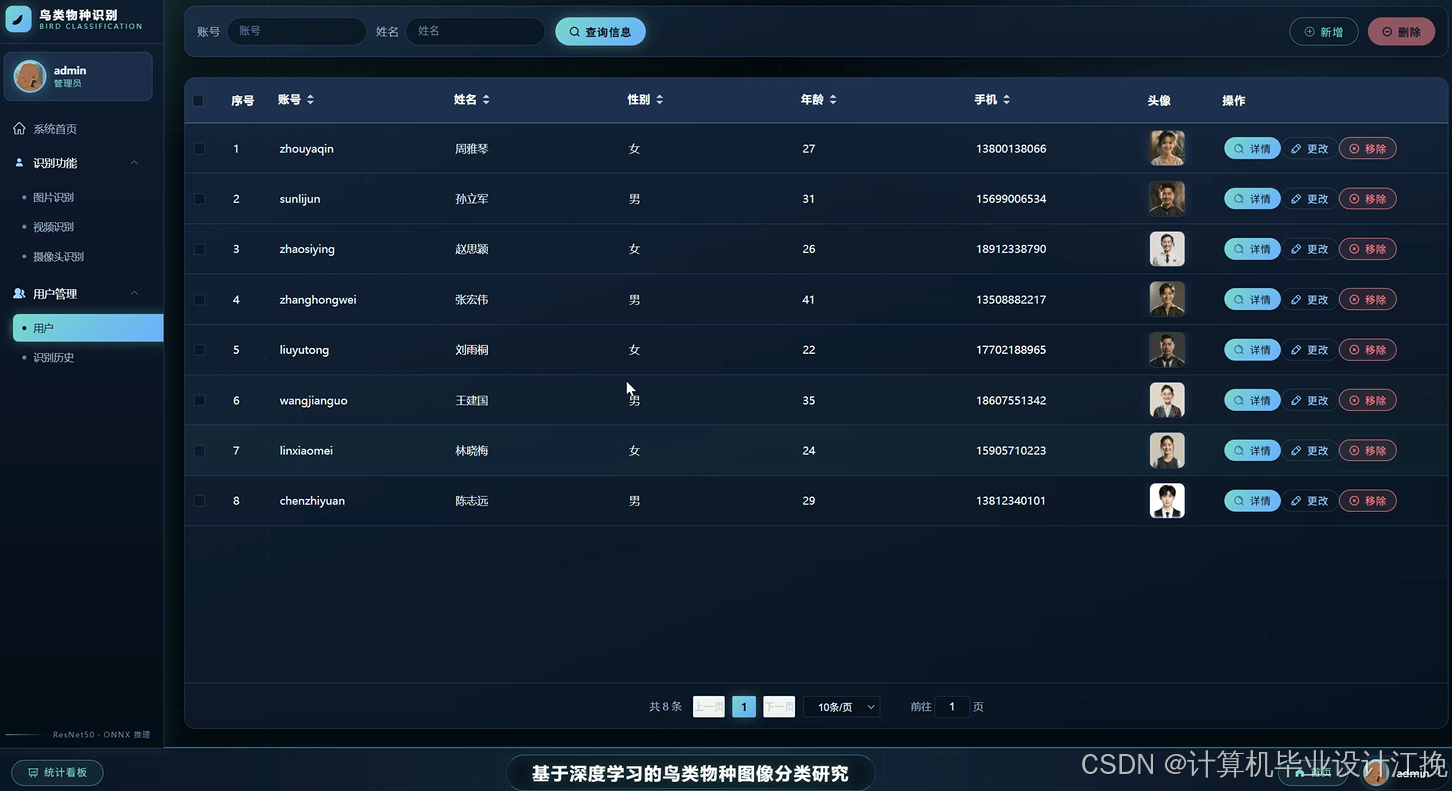
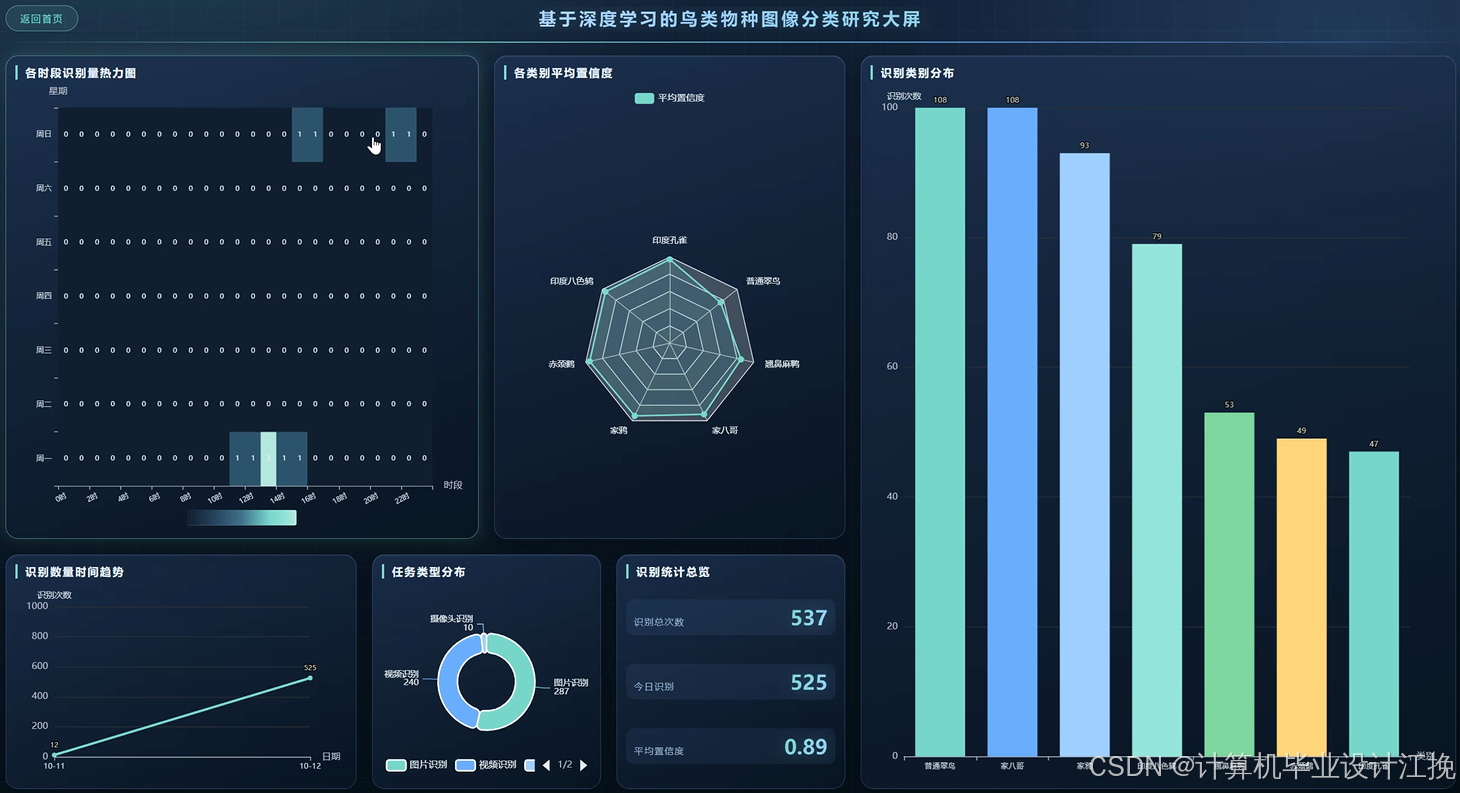
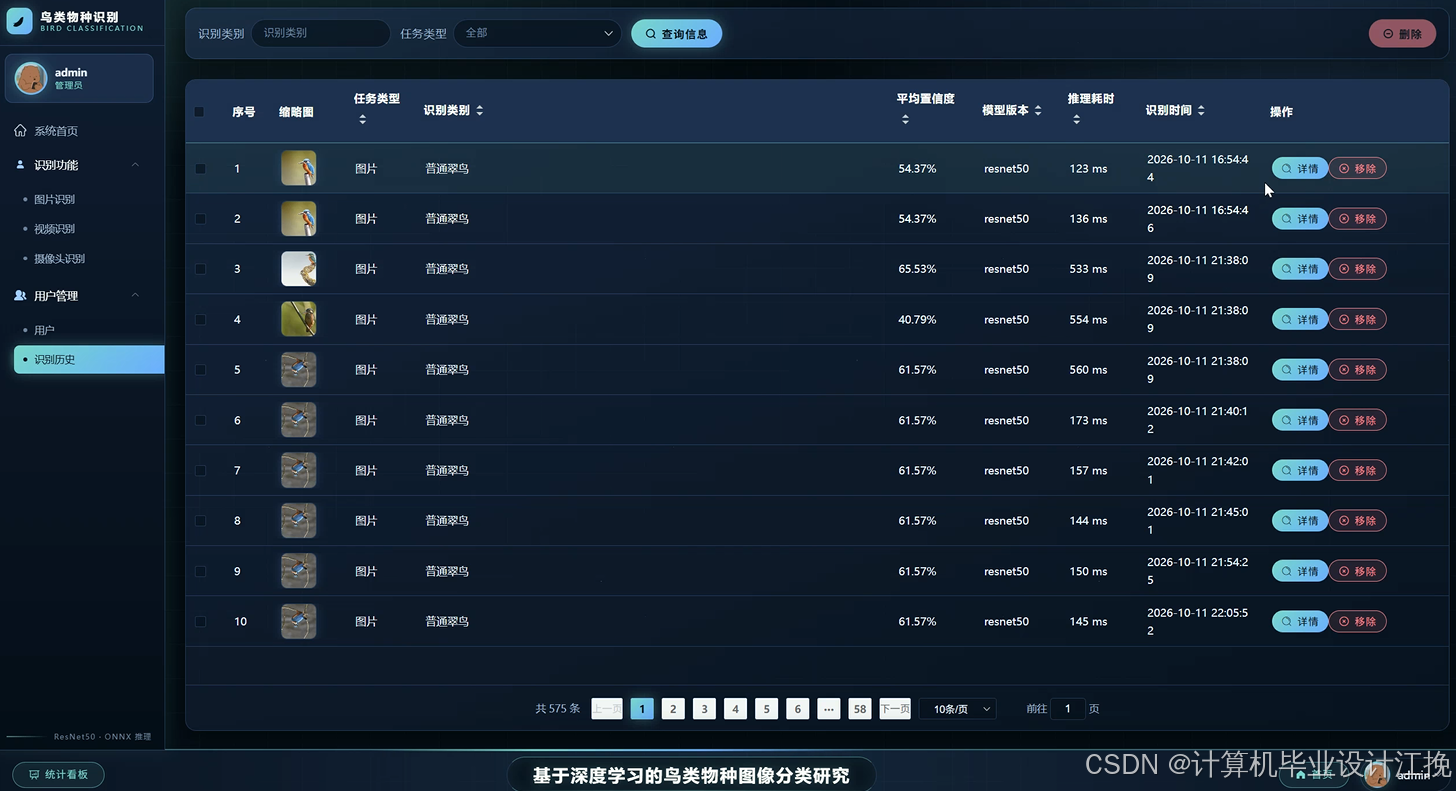
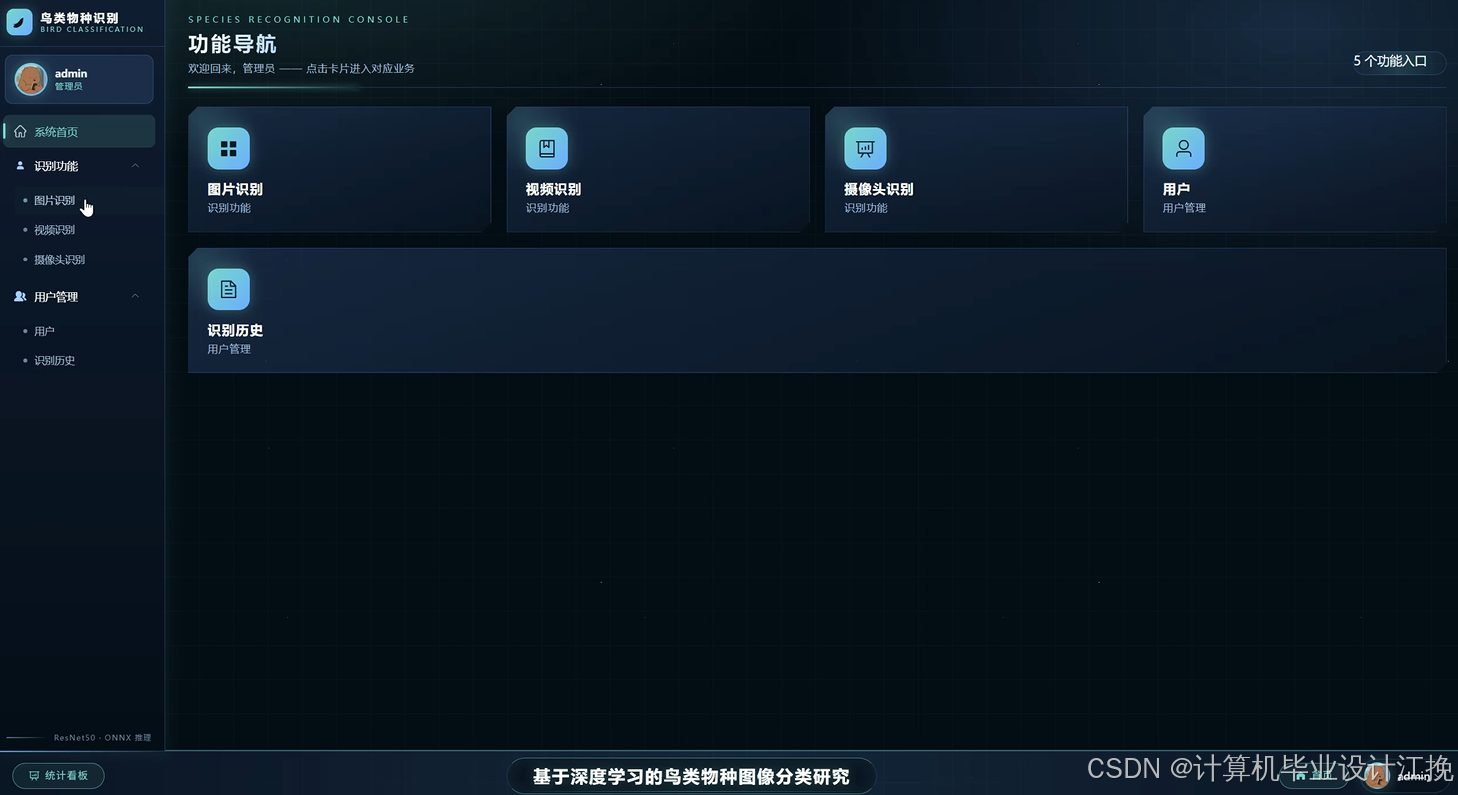
本系统名为《基于深度学习的鸟类物种图像分类研究》,采用Python语言与Django框架搭建后端服务,核心识别能力由深度学习图像分类模型提供,面向鸟类物种识别场景设计了图片识别、视频识别与摄像头识别三种输入方式。用户登录后可在系统首页进入识别功能,上传图片、视频或调用摄像头实时画面,后端将输入数据送入深度学习模型完成物种分类并返回识别结果,同时把每次识别记录写入识别历史,便于用户按时间回溯查看。系统还提供用户管理模块,支持用户信息维护与识别历史管理,整体功能围绕"输入—识别—记录—管理"这条主线展开,结构清晰、职责明确,适合作为计算机专业本科毕业设计的完整实现方案。
基于深度学习的鸟类物种图像分类研究演示视频
演示视频
基于深度学习的鸟类物种图像分类研究演示图片
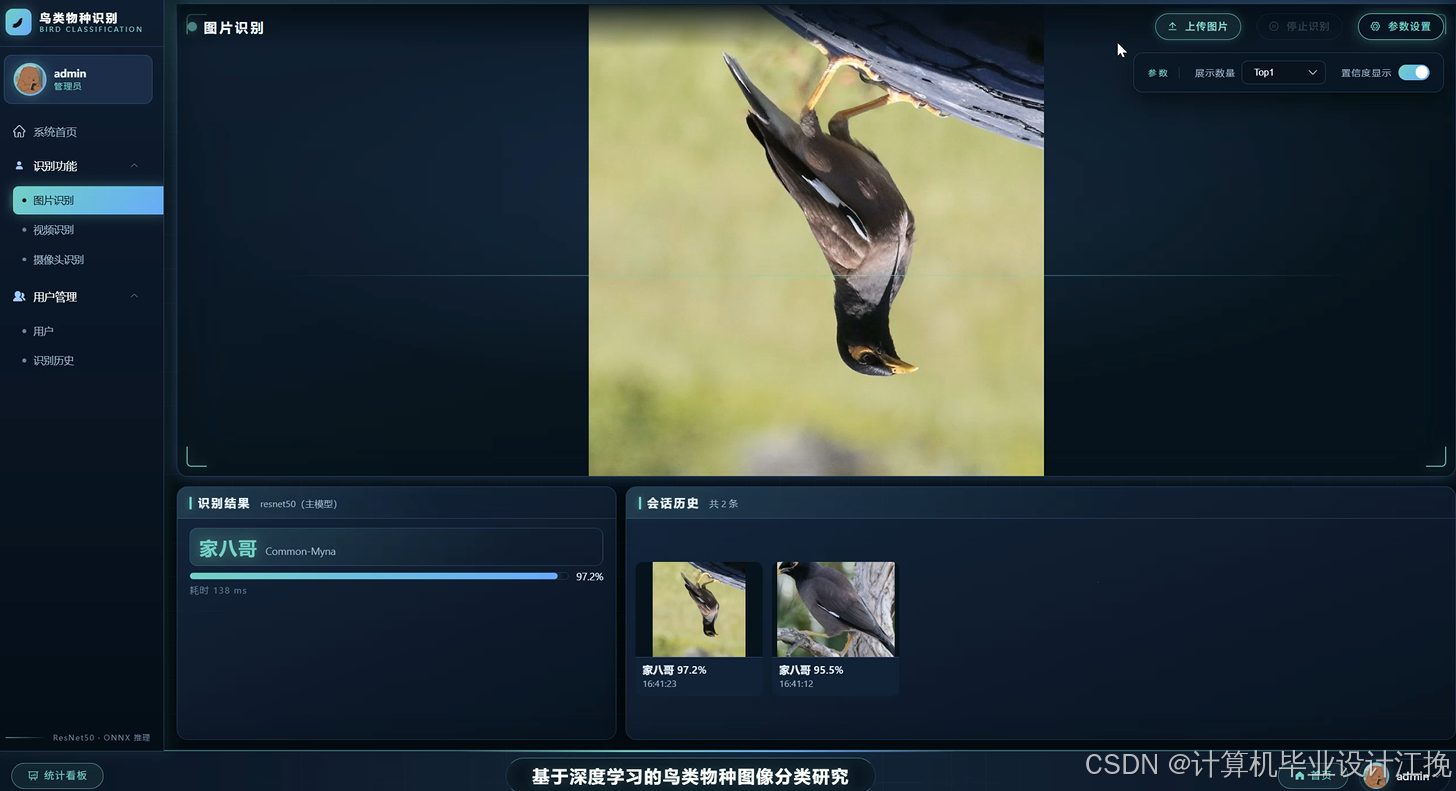
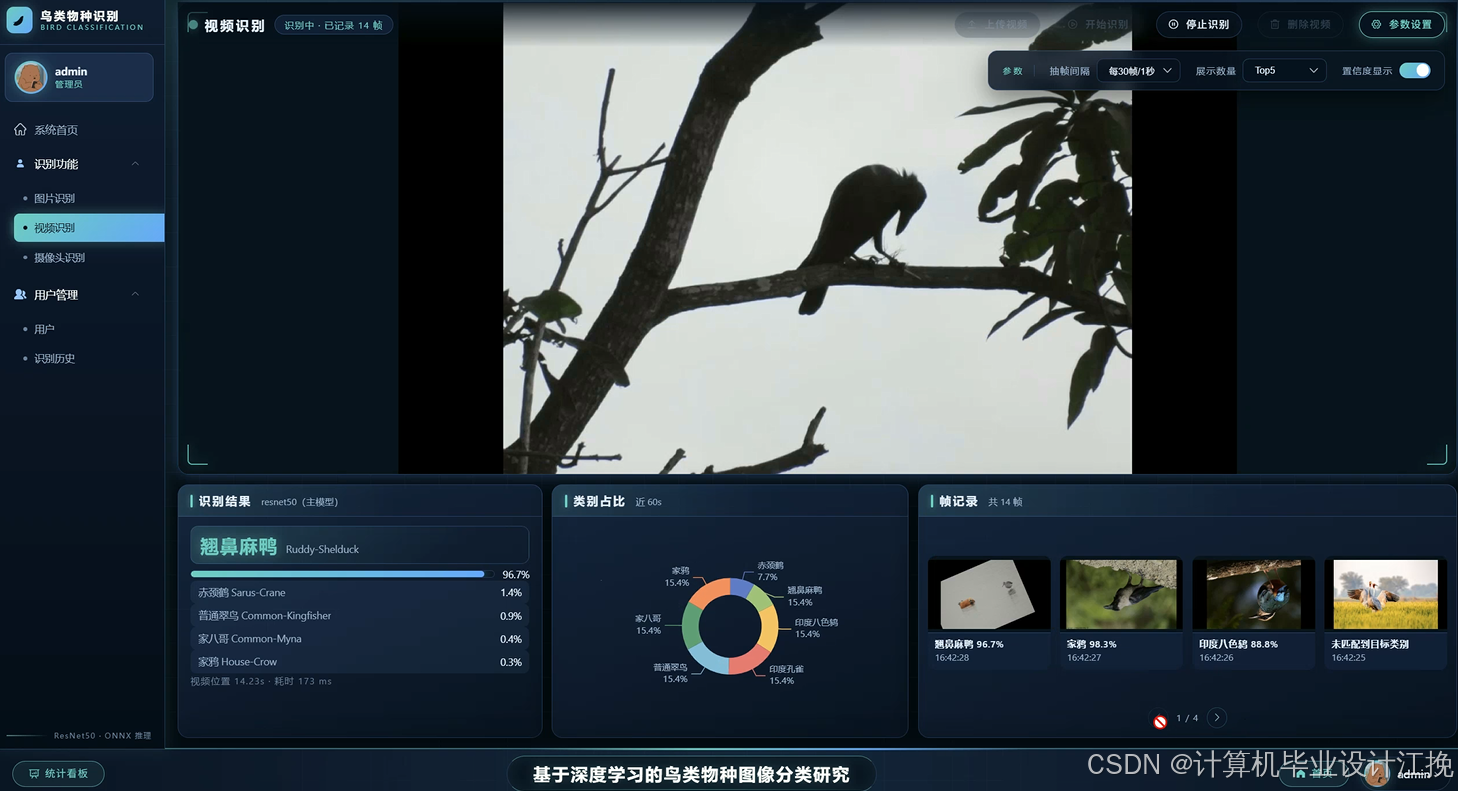
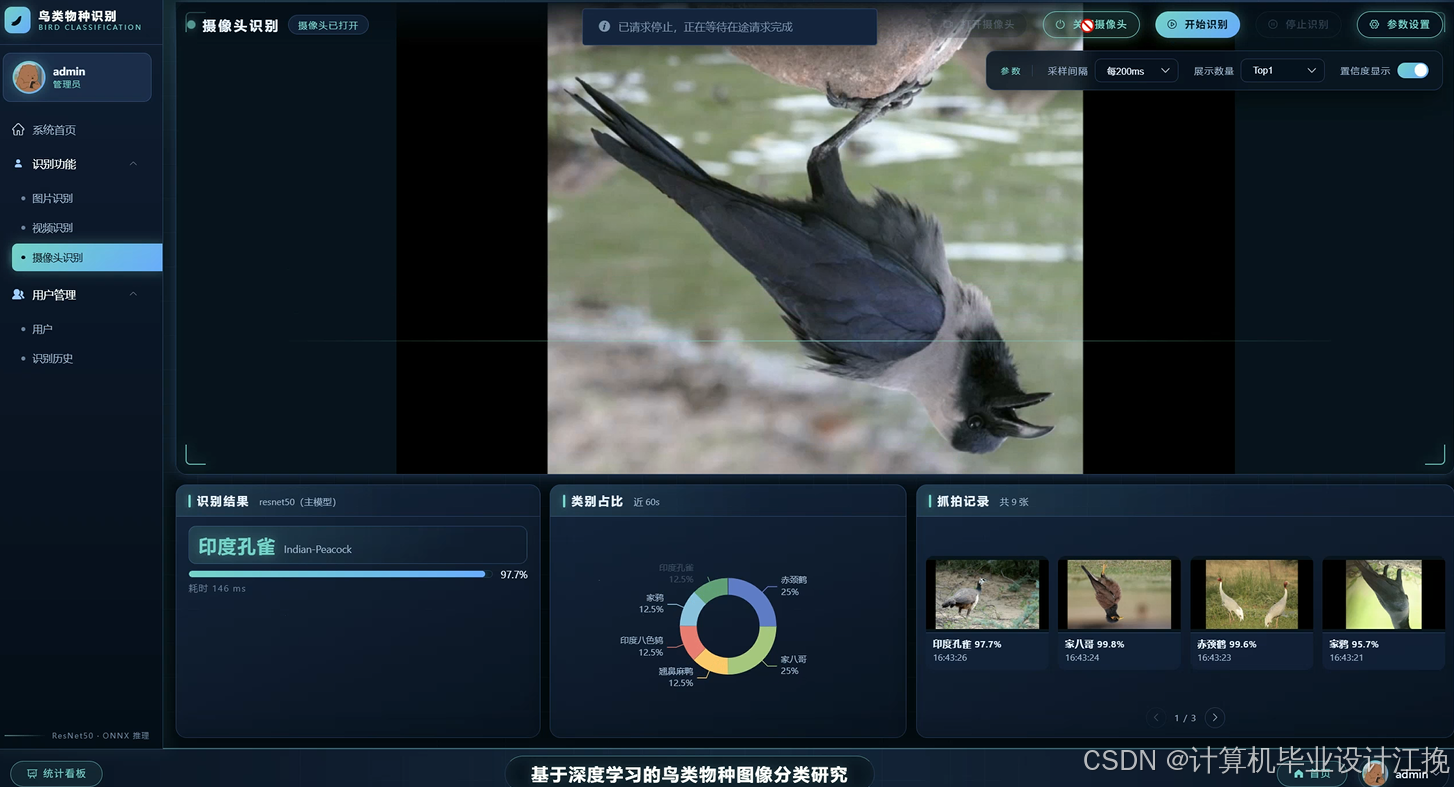
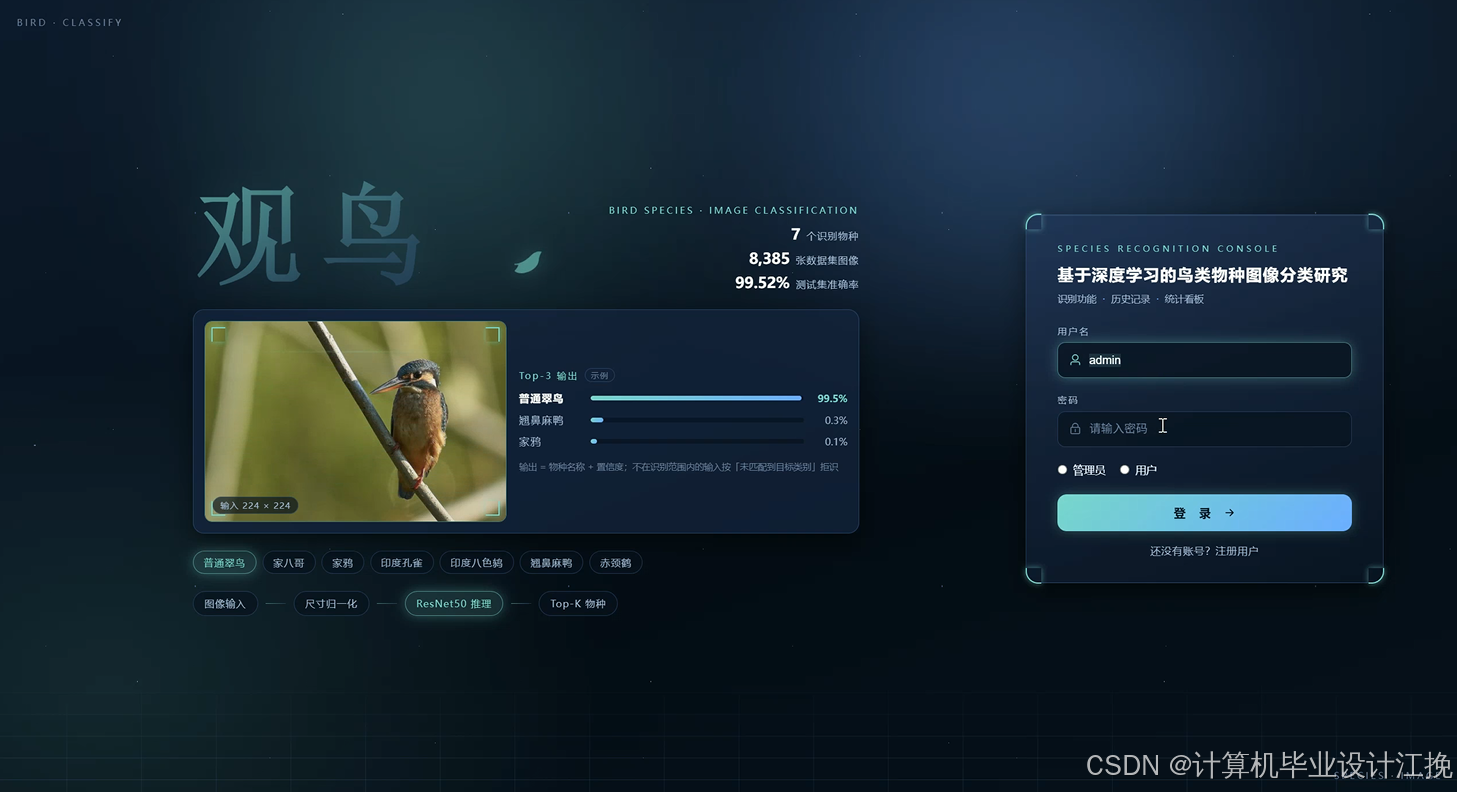
基于深度学习的鸟类物种图像分类研究代码展示
# ========== 核心功能1:图片识别 ==========
def handle_image_recognition(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请求方式不正确"})
user_id = request.session.get("user_id")
if not user_id:
return JsonResponse({"code": 401, "msg": "请先登录后再进行识别"})
image_file = request.FILES.get("image")
if not image_file:
return JsonResponse({"code": 402, "msg": "未接收到上传图片"})
if image_file.size > 10 * 1024 * 1024:
return JsonResponse({"code": 403, "msg": "图片大小超过限制"})
allow_ext = [".jpg", ".jpeg", ".png", ".bmp"]
file_ext = os.path.splitext(image_file.name)[1].lower()
if file_ext not in allow_ext:
return JsonResponse({"code": 404, "msg": "图片格式不支持"})
save_dir = os.path.join(settings.MEDIA_ROOT, "recognize", "image")
if not os.path.exists(save_dir):
os.makedirs(save_dir)
file_name = str(uuid.uuid4()) + file_ext
save_path = os.path.join(save_dir, file_name)
with open(save_path, "wb+") as f:
for chunk in image_file.chunks():
f.write(chunk)
try:
image = Image.open(save_path).convert("RGB")
except Exception:
return JsonResponse({"code": 405, "msg": "图片读取失败,请更换图片"})
input_tensor = preprocess_image(image)
with torch.no_grad():
output = bird_model(input_tensor)
prob = torch.softmax(output, dim=1)
top_prob, top_index = torch.topk(prob, 3)
result_list = []
for i in range(top_index.size(1)):
species_name = index_to_species[int(top_index[0][i])]
result_list.append({"species": species_name, "score": round(float(top_prob[0][i]), 4)})
record = RecognizeHistory()
record.user_id = user_id
record.recognize_type = "image"
record.file_path = "recognize/image/" + file_name
record.result_species = result_list[0]["species"]
record.result_score = result_list[0]["score"]
record.result_detail = json.dumps(result_list, ensure_ascii=False)
record.create_time = datetime.now()
record.save()
return JsonResponse({"code": 200, "msg": "识别成功", "data": {"top1": result_list[0], "top3": result_list}})
# ========== 核心功能2:视频识别 ==========
def handle_video_recognition(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请求方式不正确"})
user_id = request.session.get("user_id")
if not user_id:
return JsonResponse({"code": 401, "msg": "请先登录后再进行识别"})
video_file = request.FILES.get("video")
if not video_file:
return JsonResponse({"code": 402, "msg": "未接收到上传视频"})
if video_file.size > 200 * 1024 * 1024:
return JsonResponse({"code": 403, "msg": "视频大小超过限制"})
allow_ext = [".mp4", ".avi", ".mov", ".mkv"]
file_ext = os.path.splitext(video_file.name)[1].lower()
if file_ext not in allow_ext:
return JsonResponse({"code": 404, "msg": "视频格式不支持"})
save_dir = os.path.join(settings.MEDIA_ROOT, "recognize", "video")
if not os.path.exists(save_dir):
os.makedirs(save_dir)
file_name = str(uuid.uuid4()) + file_ext
save_path = os.path.join(save_dir, file_name)
with open(save_path, "wb+") as f:
for chunk in video_file.chunks():
f.write(chunk)
cap = cv2.VideoCapture(save_path)
if not cap.isOpened():
return JsonResponse({"code": 405, "msg": "视频无法打开,请更换视频"})
frame_count = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
sample_step = max(1, frame_count // 10) if frame_count > 0 else 1
frame_results = []
current_index = 0
while True:
ret, frame = cap.read()
if not ret:
break
if current_index % sample_step == 0:
rgb_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
image = Image.fromarray(rgb_frame)
input_tensor = preprocess_image(image)
with torch.no_grad():
output = bird_model(input_tensor)
prob = torch.softmax(output, dim=1)
top_prob, top_index = torch.topk(prob, 1)
species_name = index_to_species[int(top_index[0][0])]
frame_results.append({"frame": current_index, "species": species_name, "score": round(float(top_prob[0][0]), 4)})
current_index += 1
cap.release()
if not frame_results:
return JsonResponse({"code": 406, "msg": "视频中未提取到有效画面"})
species_counter = {}
for item in frame_results:
species_counter[item["species"]] = species_counter.get(item["species"], 0) + 1
main_species = max(species_counter, key=species_counter.get)
main_score = max([item["score"] for item in frame_results if item["species"] == main_species])
record = RecognizeHistory()
record.user_id = user_id
record.recognize_type = "video"
record.file_path = "recognize/video/" + file_name
record.result_species = main_species
record.result_score = main_score
record.result_detail = json.dumps(frame_results, ensure_ascii=False)
record.create_time = datetime.now()
record.save()
return JsonResponse({"code": 200, "msg": "识别成功", "data": {"main_species": main_species, "main_score": main_score, "frames": len(frame_results)}})
# ========== 核心功能3:摄像头识别 ==========
def handle_camera_recognition(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请求方式不正确"})
user_id = request.session.get("user_id")
if not user_id:
return JsonResponse({"code": 401, "msg": "请先登录后再进行识别"})
frame_data = request.POST.get("frame_data")
if not frame_data:
return JsonResponse({"code": 402, "msg": "未接收到摄像头画面"})
if frame_data.startswith("data:image"):
frame_data = frame_data.split(",")[1]
try:
image_bytes = base64.b64decode(frame_data)
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")
except Exception:
return JsonResponse({"code": 403, "msg": "画面解析失败,请重试"})
save_dir = os.path.join(settings.MEDIA_ROOT, "recognize", "camera")
if not os.path.exists(save_dir):
os.makedirs(save_dir)
file_name = str(uuid.uuid4()) + ".jpg"
save_path = os.path.join(save_dir, file_name)
image.save(save_path, "JPEG")
input_tensor = preprocess_image(image)
with torch.no_grad():
output = bird_model(input_tensor)
prob = torch.softmax(output, dim=1)
top_prob, top_index = torch.topk(prob, 3)
result_list = []
for i in range(top_index.size(1)):
species_name = index_to_species[int(top_index[0][i])]
result_list.append({"species": species_name, "score": round(float(top_prob[0][i]), 4)})
spark = SparkSession.builder.appName("BirdRecognizeStat").master("local[*]").getOrCreate()
stat_rdd = spark.sparkContext.parallelize([(item["species"], item["score"]) for item in result_list])
species_count = stat_rdd.map(lambda x: (x[0], 1)).reduceByKey(lambda a, b: a + b).collect()
spark.stop()
record = RecognizeHistory()
record.user_id = user_id
record.recognize_type = "camera"
record.file_path = "recognize/camera/" + file_name
record.result_species = result_list[0]["species"]
record.result_score = result_list[0]["score"]
record.result_detail = json.dumps(result_list, ensure_ascii=False)
record.create_time = datetime.now()
record.save()
return JsonResponse({"code": 200, "msg": "识别成功", "data": {"top1": result_list[0], "top3": result_list, "stat": species_count}})
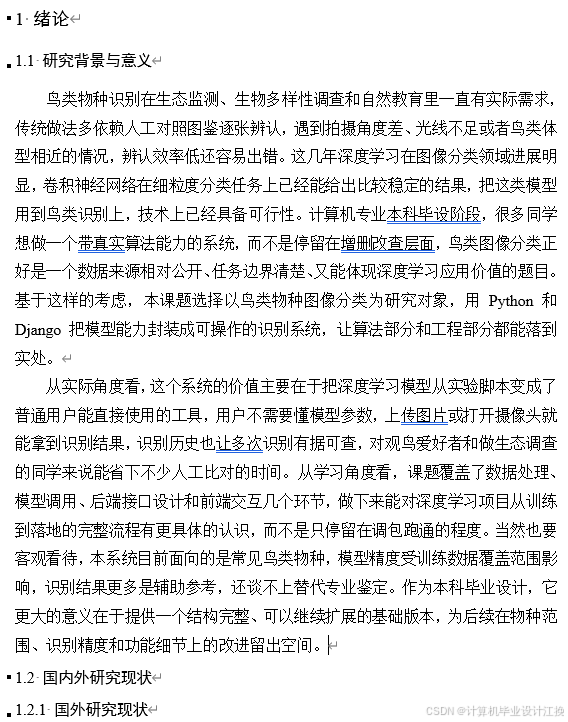
基于深度学习的鸟类物种图像分类研究文档展示
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册