 网硕互联帮助中心
💡 这个系列的最后一篇,讲完剩下四条工程落地路径。
前两篇里出现了一堆名词:RAG、微调、续训、Agent、Function Call、MCP。它们经常被放在一起宣传,但真实情况是——RAG 和微调解决的根本不是同一个问题,Function Call 和 MCP 也不是竞争关系,而"智能体"这三个字底下藏着的东西比其他四条加起来都多。
最常见的两个误判是:用微调去补领域知识(应该先续训),以及把 SFT 数据拿去做续训(会破坏语言建模能力)。这两个坑都是白花真金白银的。
这篇把四条路逐一说清:什么时候需要、前置条件是什么、代价多大、坑在哪,最后给一张决策表。
1. 模块 2:RAG——给模型外挂一个知识库
1.1 什么是 RAG
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种结合**信息检索(Retrieval)与文本生成(Generation)**的技术:
AI 应用接收到用户请求后,先从外部知识库检索相关资料,把这些资料与用户请求一并提供给大模型,模型在此基础上生成更准确、更有依据的回答。
对应到第一篇讲过的模型分工,就特别清楚了:
用户提问 –> 嵌入模型向量化 –> 向量库检索候选 –> 重排序模型精排
↓
最终回答 <– 生成式大模型 <– 把检索结果拼进上下文
1.2 工作流程
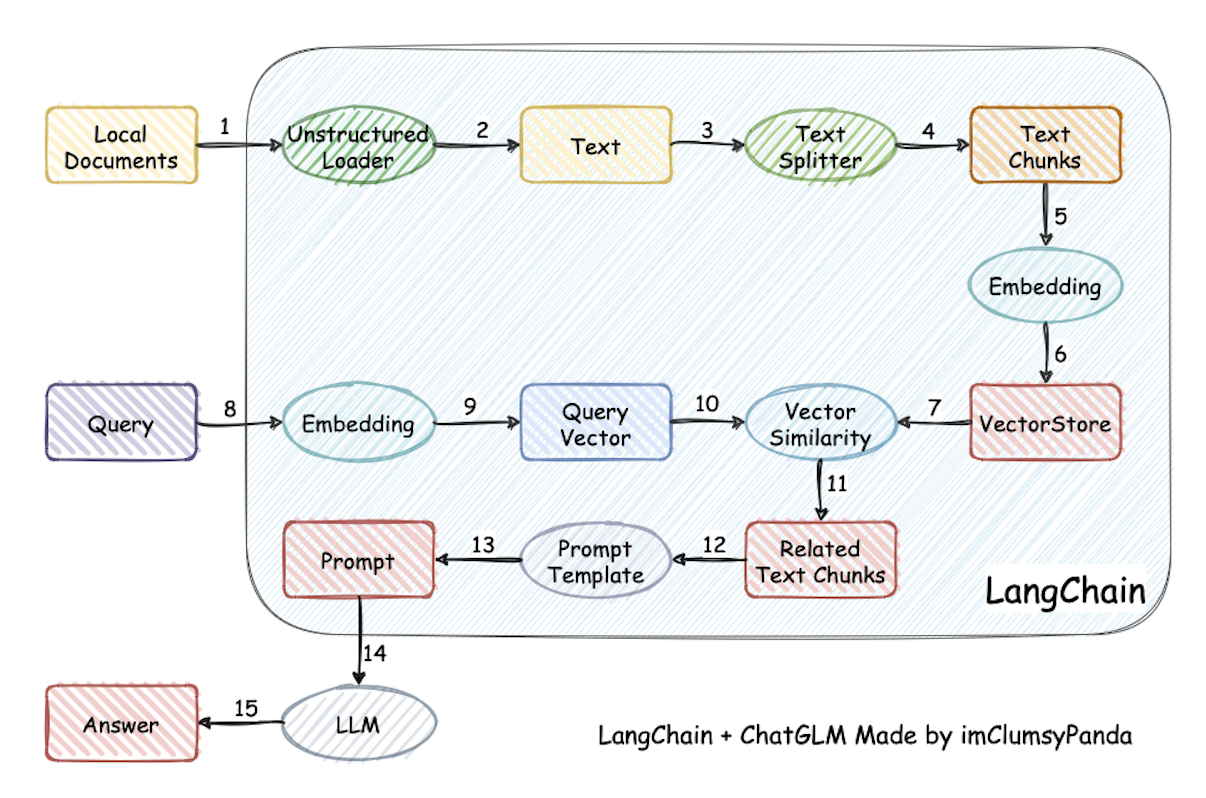
1.3 何时需要 RAG
当模型缺乏必要的参考信息时,RAG 用来补充外部知识与上下文。
典型场景:
- 需要获取最新信息(比如当月新闻)——模型的训练数据有截止时间,这块它天生看不到
- 需要查阅或引用公司内部资料——这些资料压根不在公开语料里
1.4 三种实现方式
| 在线平台 | 各大模型官网自带的知识库/文件问答功能,零代码 |
| 离线客户端 | 带知识库功能的本地客户端,比如上一篇提到的 Cherry-Studio |
| 框架 / 代码 | 借助 LangChain 等框架,或纯 Python 实现 |
2. 模块 3:微调——把知识焊进权重里
2.1 什么是微调
在已经训练好的模型上,按照 SFT 或 RLHF/RLAIF 的范式继续训练(通常采用 SFT 范式)。第二篇讲的那三阶段,到这里就是复用同一套方法。
| 训练目标 | 适应特定任务或领域,提升在具体场景下的性能 |
| 数据特点 | 小规模、高质量、任务相关的标注数据 |
| 参数更新 | 调整部分或全部参数(0.1% – 100%) |
2.2 何时需要微调
(1)模型能力不足:指令遵循能力不够、风格/话术不满足要求,反复调提示词效果欠佳。
(2)希望固化知识:如果提示词很长,每次调用都消耗大量 token,长期服务成本高昂且不好维护,甚至可能超出上下文窗口。此时可以通过微调把知识固化在模型权重中。
这一条经常被忽略:微调不一定为了"更强",也可以为了"更便宜"。 把固定的长提示词蒸进权重,是把运营成本换成一次性投入。
2.3 何时可以微调(前置条件)
- 数据充足:微调需要的数据规模通常比提示词示例和 RAG 知识库更大。收集不到足够数据,微调就没什么效果,还容易过拟合。
- 硬件资源充足:整体来说微调成本较低(仅需少量标注数据)。
2.4 技术方法:从全参到 QLoRA
随着模型规模越来越大,如何低成本微调成为核心问题。
(1)全参数微调(Full Fine-tuning)
更新模型所有参数,理论上限最高但资源消耗巨大。7B 模型全参微调需要约 80GB+ 显存,适合资源充足、追求极致性能的场景。
(2)参数高效微调(PEFT, Parameter-Efficient Fine-Tuning)
| LoRA(低秩适配) | 冻结原模型权重,在 attention 层插入低秩矩阵,只训练新增的低秩参数 | 7B 模型仅需训练 0.1%–1% 参数(约 4–20MB),显存占用减少 90% 以上 |
| QLoRA | 在 LoRA 基础上引入 4 位量化,进一步压显存 | 7B 模型可在单卡 24G 显存上微调,成本降至全参微调的 1/10 |
(3)其他高效方法
- Adapter Tuning:在模型层间插入小型适配器模块
- Prefix Tuning:在输入前添加可学习的虚拟前缀
- P-Tuning v2:在模型每一层添加可训练的提示向量
2.5 主要风险
灾难性遗忘(学习新任务时忘记旧任务)或过拟合。
灾难性遗忘这个坑很实在:你为了统一话术微调了一个客服模型,结果它写代码、做数学的能力明显退化了。所以微调后的评测集必须包含原始能力项,不能只测新功能。
2.6 RAG vs 微调
这两者的差异一直是热门话题。课件给的判断标准很干净:
RAG 特别适合融合新知识;微调则通过优化模型内部知识、输出格式以及提升复杂指令的执行能力,来增强模型的性能和效率。
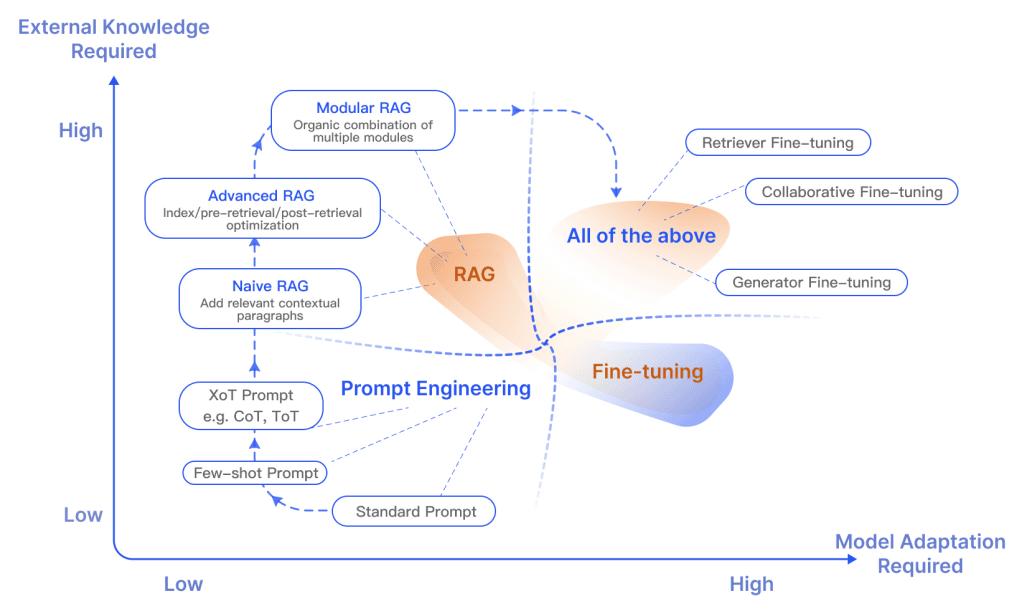
我按实操维度再拆一层:
| 改变权重 | 否 | 是 |
| 适合解决 | 知识更新、事实溯源、私域资料问答 | 说话方式、格式规范、指令遵循、固定流程 |
| 知识时效 | 实时(更新知识库即可) | 冻结在训练那一刻 |
| 可溯源 | 强(能给出引用出处) | 弱(说不清从哪学的) |
| 迭代成本 | 低,改文档就行 | 高,每次都要重训 + 重评测 |
| 需要硬件 | 向量库 + 检索服务 | 训练卡(LoRA 可单卡) |
一句话:知识会变、要溯源,选 RAG;要改的是"表达方式和行为习惯",选微调。
3. 模块 4:续训——微调之上还有一层
3.1 什么是续训
在模型已经完成预训练(以及可能的微调)之后,在大量语料上采用和预训练相同的范式继续训练,提升模型基础能力。
本质上,续训仍然属于 Pre-Training 阶段的延续。
3.2 何时需要续训
如果微调效果不理想,且问题来自模型对领域语言/知识分布的系统性缺失,可以考虑续训。
关键在"系统性缺失"这四个字。模型不是不知道几个事实,而是整个领域的语言模式和知识分布它就没见过——这种问题微调补不上,因为微调改不了模型对领域语言的底层表征。
3.3 前置条件
- 数据充足:需要大量原始文本(无标注),数据规模在 GB – TB 级。比如法律文档、医疗论文、企业日志、代码仓库。
- 硬件资源充足:续训要求的数据量和硬件资源远高于微调,成本相应更高。
3.4 三个高频误区(这部分最值钱)
| ① 用 SFT 数据去做"续训" | 续训的范式是自监督语言建模,喂指令-答案对会破坏语言建模能力 | 续训用无标注原始语料,SFT 数据留给微调阶段 |
| ② 想靠微调解决"领域知识缺失" | 微调改不动底层领域表征,效果必然不理想 | 先续训,再微调 |
| ③ 企业场景盲目续训 | 绝大多数企业场景根本用不上 | 多数场景 RAG + 微调已足够 |
Q:为什么"先续训再微调"这个顺序不能反?
因为两者改的东西不同。续训改的是模型对领域语言和知识分布的基础理解(无标注语料、自监督目标),微调改的是任务行为和输出格式(标注数据、有监督目标)。顺序反了,等于在一个还没"懂行"的模型上教它做事——它连术语都没建立起来,指令遵循训得再好也是空中楼阁。
4. 模块 5:智能体——复杂度最高的那条路
4.1 什么是智能体
经典智能体框架中:智能体(Agent)一般指能够在环境中感知信息、基于策略做出决策并采取行动,以最大化回报或满足目标约束的系统。
大模型应用开发中:智能体通常指一种以大语言模型为推理与决策核心,结合记忆、工具调用与环境交互能力,能够进行规划决策并执行动作以达成目标的软件系统。
OpenAI 前安全系统团队负责人在 2023 年 6 月于个人博客系统化总结了当时流行的 LLM Agent 典型架构:
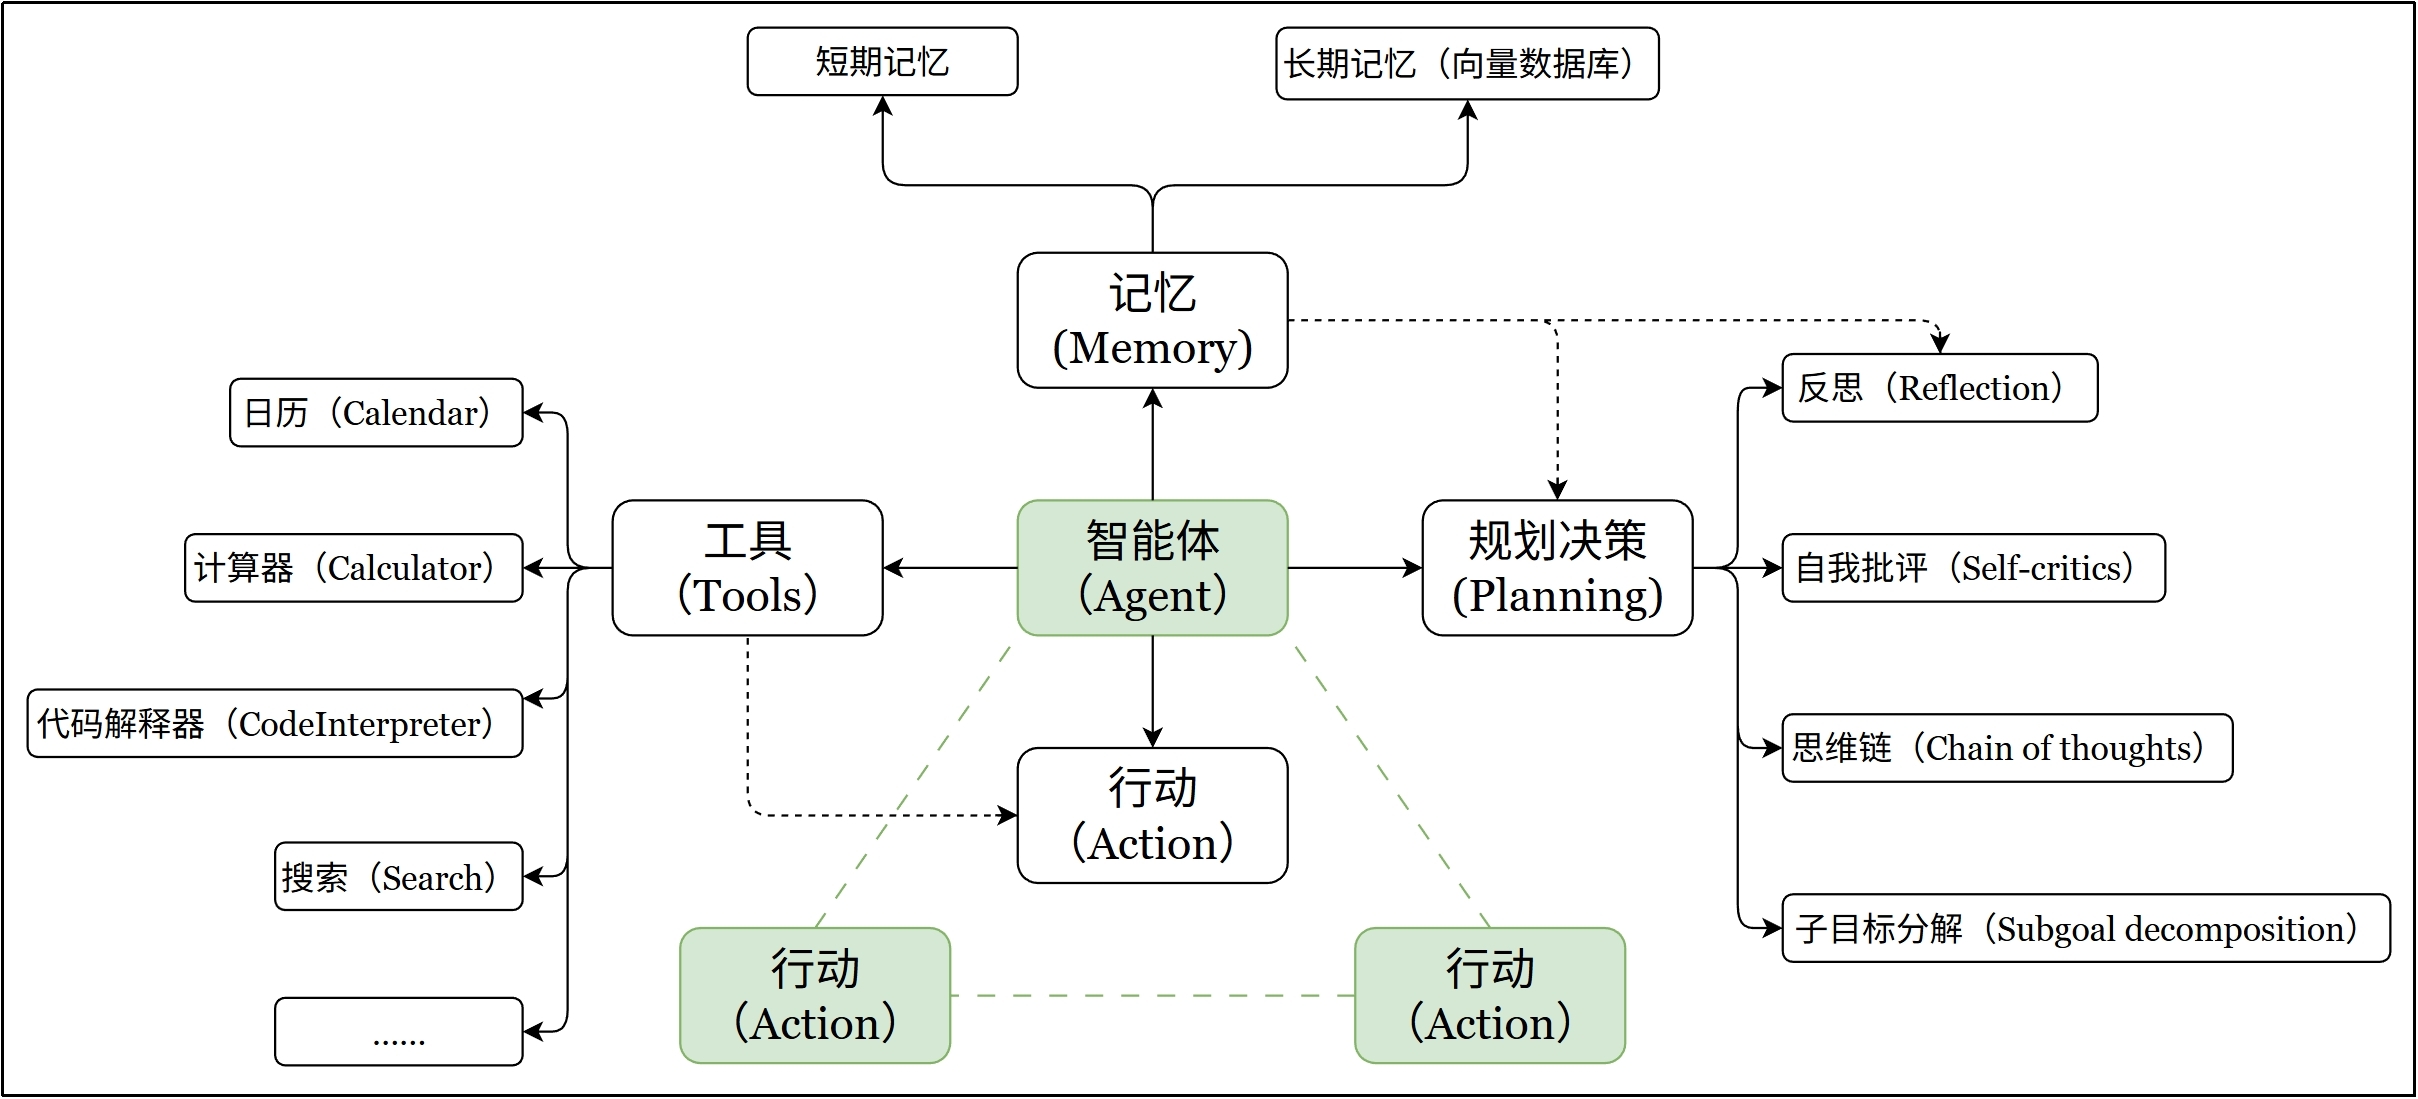
4.2 何时需要智能体
当提示词优化、RAG 难以满足要求时,可以考虑引入智能体,尤其适用于多步骤、依赖外部工具或需要持续状态管理的任务。
此外,微调或续训效果不理想时,也可以结合 Agent(如引入规则校验、结构化约束、事实核对等机制)提升生成质量。
智能体通常是大模型工程实现中复杂度最高的方案——涉及工具调用、记忆、规划、反思与多组件协作。
这也呼应了第四篇的判断:智能体和前四个模块是正交的,可以和任意一层叠加,而不是替代关系。
4.3 工具调用的实现方式之一:Function Call
定义:Function Call(函数调用 / Tools call / 工具调用)为模型提供了一种强大而灵活的方式,使其能够与外部系统交互并访问其训练数据之外的数据,拓展了模型的能力边界。
流程:
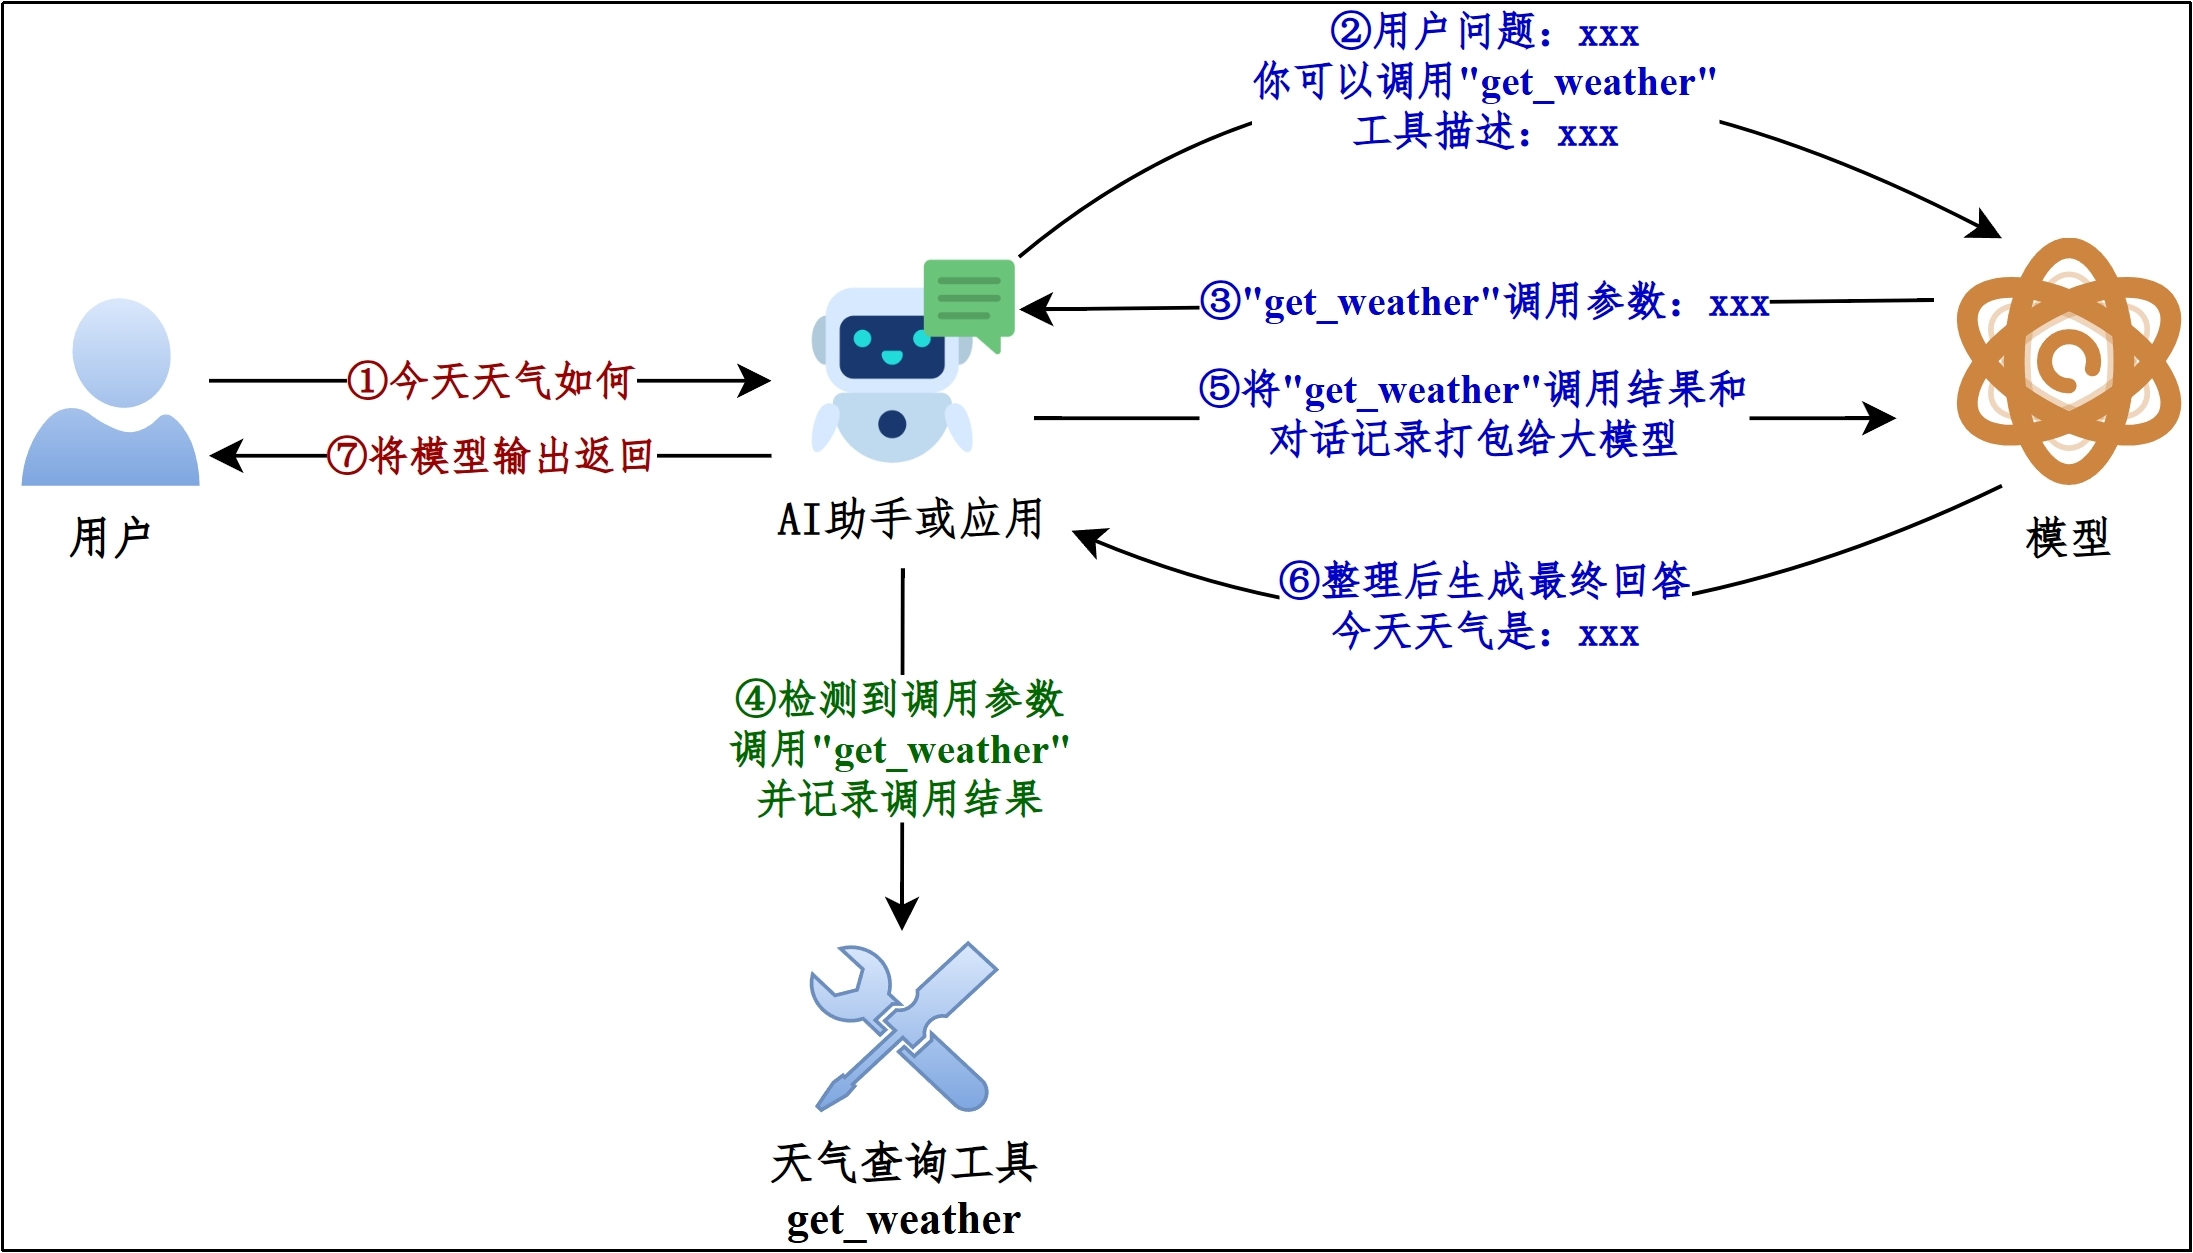
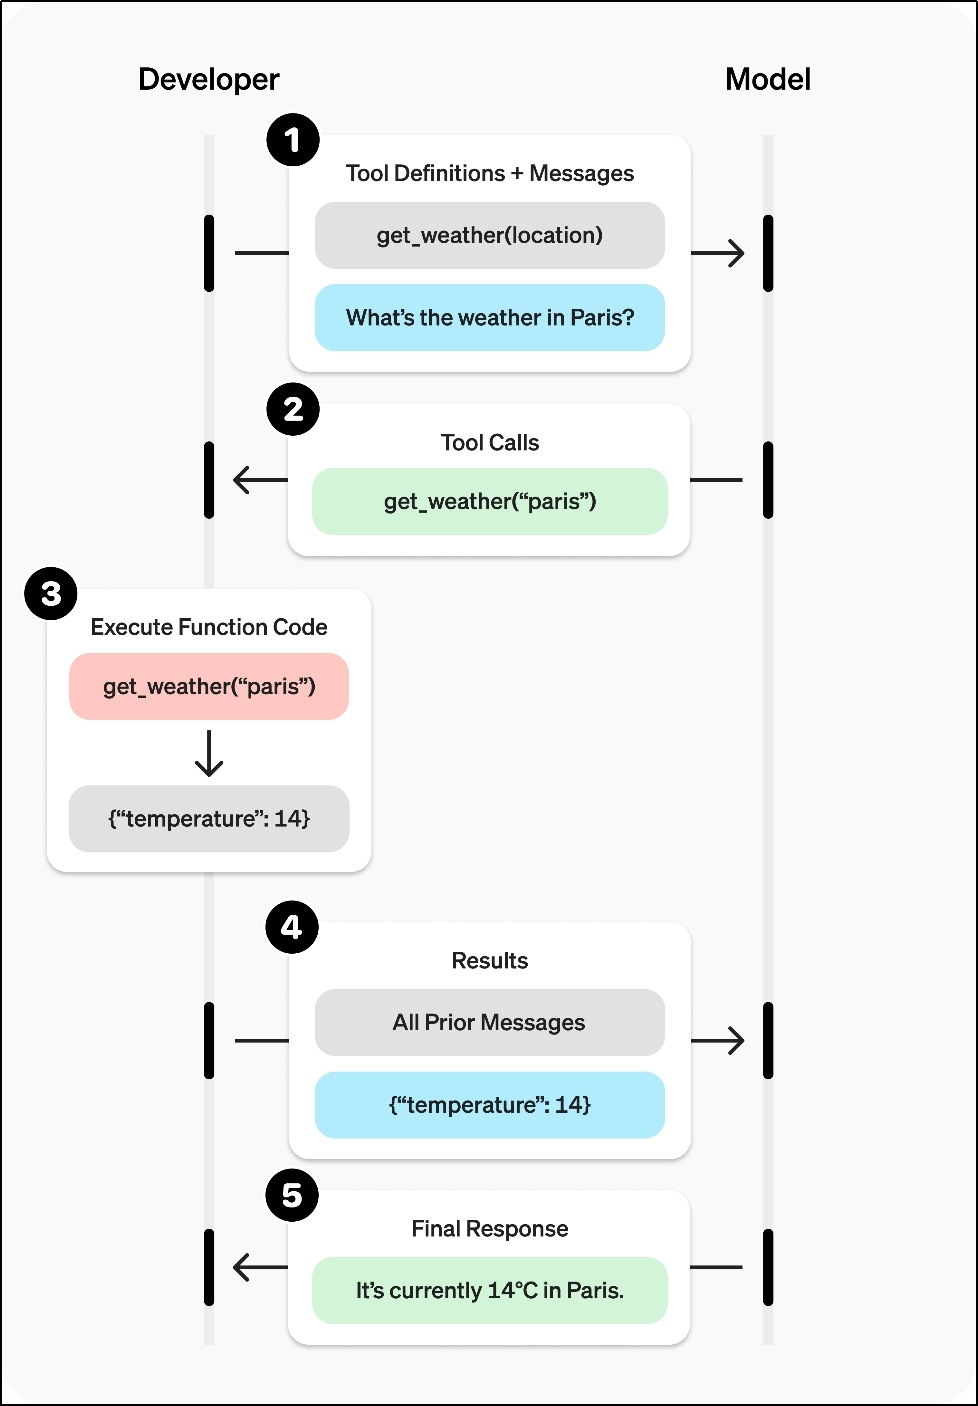
模型为了支持 Function Call,在特定数据集上做了后训练,以支持 API 调用中工具相关字段。目前顶尖大模型基本都支持。
用 DeepSeek 官方 API 走一遍完整四步,逻辑非常清楚:
步骤一:定义工具 + 发问
{
"model": "deepseek-chat",
"messages": [
{"role": "system", "content": "你是个智能天气查询助手,根据用户的提问自主调用工具"},
{"role": "user", "content": "北京市天气如何?"}
],
"tools": [{
"type": "function",
"function": {
"name": "get_weather",
"description": "根据用户输入的城市信息,获取该城市的天气",
"parameters": {
"type": "object",
"properties": {
"city": {"type": "string", "description": "城市名称,只保留最细粒度的地区名称"}
},
"required": ["city"]
}
}
}]
}
步骤二:模型不直接回答,而是返回"我要调哪个函数、参数是什么"
{
"message": {
"role": "assistant",
"content": "我来帮您查询北京市的天气情况。",
"tool_calls": [{
"id": "call_00_Kpq3g6mPl9BYlZIe1NSNm3Cs",
"type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\": \\"北京\\"}"}
}]
},
"finish_reason": "tool_calls"
}
finish_reason: "tool_calls" 是判断"模型想调工具"的可靠信号,比解析 content 稳得多。
步骤三:你的代码真正去执行这个函数
这一步在业务代码里完成(curl 无法模拟)。假设返回:
{"temp": "2℃", "text": "晴", "wind": "西北风3级"}
步骤四:把结果连同历史消息回传给模型,由它生成最终回答
"messages": [
{"role": "system", "content": "你是个智能天气查询助手…"},
{"role": "user", "content": "北京市天气如何?"},
{"role": "assistant", "content": "我来帮您查询北京市的天气情况。",
"tool_calls": [{"id": "call_00_…", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\": \\"北京\\"}"}}]},
{"role": "tool", "tool_call_id": "call_00_…",
"content": "{\\"temp\\":\\"2℃\\",\\"text\\":\\"晴\\",\\"wind\\":\\"西北风3级\\"}"}
]
模型最终输出:
根据查询结果,北京市当前的天气情况如下:
– 温度:2℃ – 天气状况:晴 – 风力:西北风3级
今天北京天气晴朗,温度在 2℃ 左右,风力不大……建议您外出时适当保暖。
注意 token 数:这一步 prompt_tokens 已经涨到 422(其中 384 命中缓存)。一次简单的工具调用,就是两次完整的大模型请求 + 全量历史上下文。这就是第四篇说智能体"token 开销较大"的具体含义。
4.4 Function Call 的三个不足
| ① 工具实现与复用成本高,协作困难 | 开发者需要自己实现工具并编写可被调用的描述信息,通常与业务、环境绑定,复用难、共享难、生态扩展慢 |
| ② 规范碎片化,跨模型适配负担重 | 不同厂商定义的 Function Call规范不同,同一个工具要写多份描述信息,维护成本和一致性风险高 |
| ③ 可靠性不足 | 工具可能没经过足够调试,描述信息不完善时,模型在某些场景下不能正确调用工具 |
4.5 工具调用的实现方式之二:MCP
定义:MCP(Model Context Protocol,模型上下文协议) 是一套标准化的通讯协议,旨在规范 AI 模型和外部工具、数据源的连接方式,由 Anthropic(Claude 母公司)于 2024 年 11 月提出。
MCP 就像 AI 时代的 USB-C 通用接口:开发者只需按标准开发一次 MCP Server,任何支持该协议的 AI 应用都能即插即用。
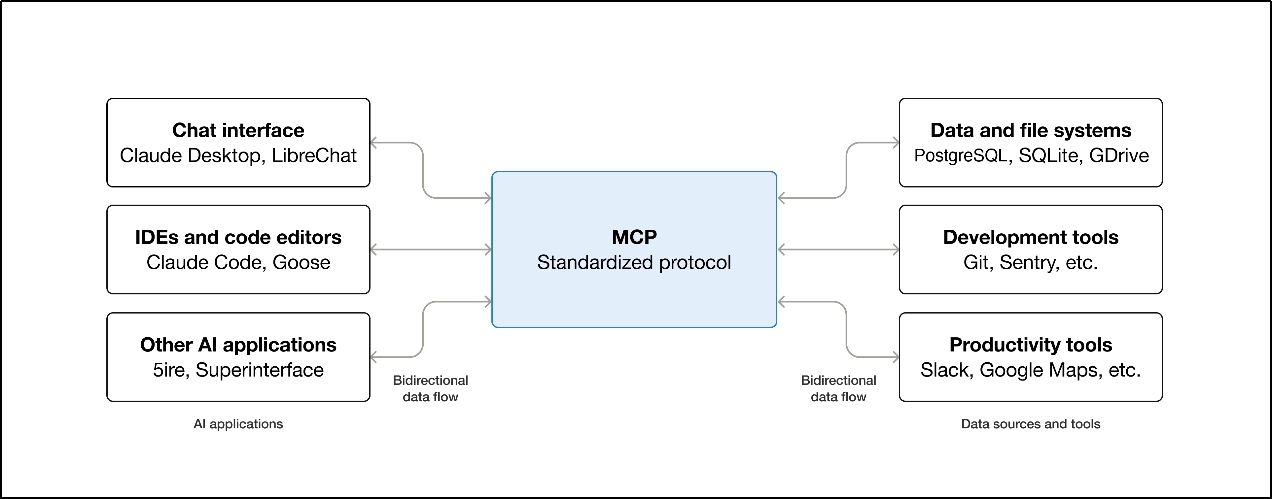
通过 MCP 协议,AI 应用和 MCP Server 可以建立多对多的双向数据流。
流程:
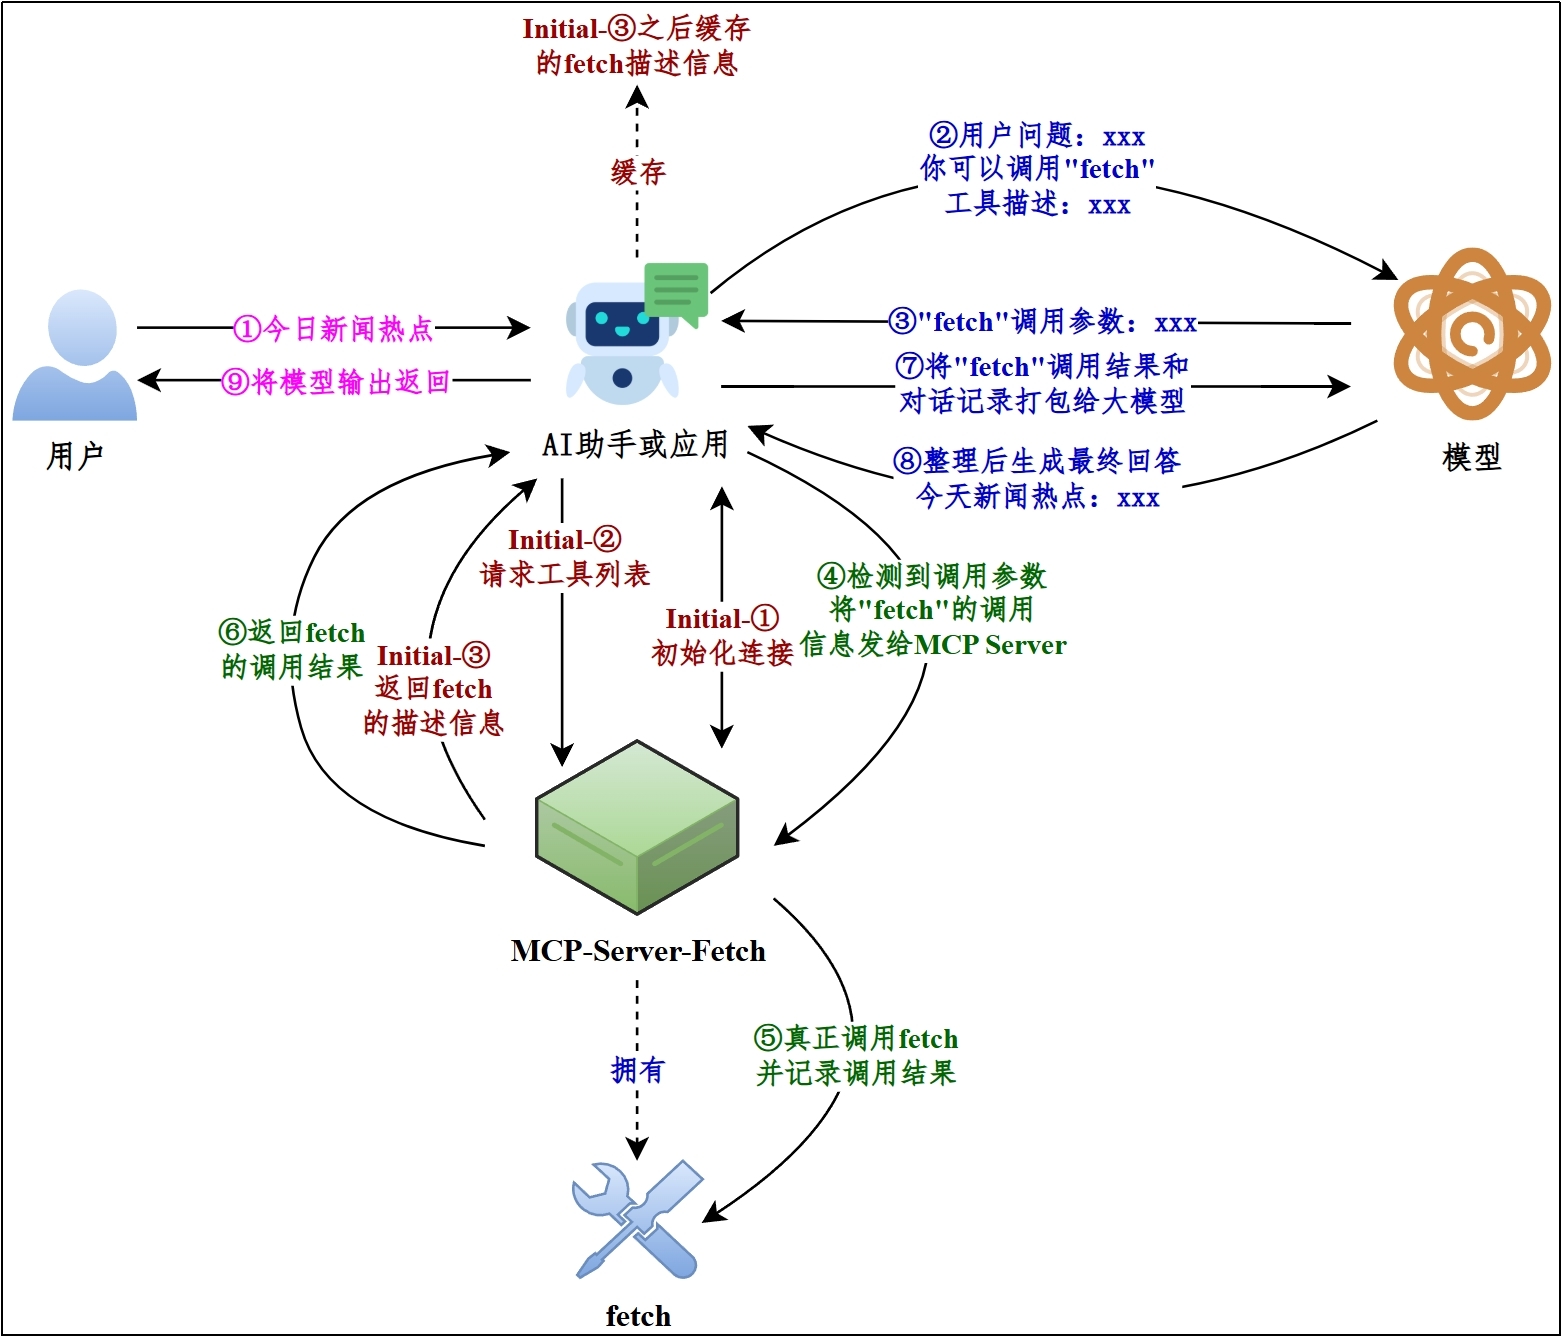
MCP 可以理解为对 Function Call 的进一步封装和拓展,最核心的变化是:工具的定义和调用者由 AI 应用变为 MCP 服务器。
除了工具调用,MCP 还支持管理资源(Resources)和提示词(Prompts),但最常用的是**工具(Tools)**模块。
相较 Function Call 的优势(正好补上那三个不足):
| 协作困难 | 允许开发者把工具暴露为 MCP Server,可被多个 AI 应用复用 |
| 适配负担重 | AI 应用只要把模型的 Function Call 格式映射为 MCP 的工具调用格式即可调用 MCP Server 的工具。切换模型时只需切换映射规则,不必为每个模型维护一份描述信息,一致性和维护成本大大降低 |
| 可靠性不足 | 公开的 MCP Server 经过社区和很多开发者共同检验,工具定义和元数据信息更规范,通常可靠性更高 |
常用 MCP 资源站:
| MCP.so(热度最高) | https://mcp.so/ | 国内开发者打造的资源航母平台,已收录 8,000+ 个 MCP 服务器,支持 STDIO(本地通信)与 SSE(云端托管)两种模式,提供 API Key 与命令行参数配置方式;特色功能包括实时接口调试、企业级数据安全接入,以及 Firecrawl 爬虫服务的无缝集成 |
| Smithery(新手友好) | https://smithery.ai/servers | 工具库,已收录 4,500+ 优质资源,支持一键生成并复制 Cursor 配置命令;集成 GitHub 快捷跳转,便于快速获取代码示例;支持按 Star 数量和更新频率筛选高质量服务 |
| 阿里云百炼 MCP 市场 | https://bailian.console.aliyun.com/?tab=mcp#/mcp-market | 连接智能,即点即用,阿里云百炼全周期 MCP 服务 |
4.6 智能体的两种开发方式
| 在线平台开发智能体 | Dify、Coze |
| 基于框架开发智能体 | LangChain / LangGraph 等 |
4.7 工作流 Workflow:确定性与自主性的取舍
定义:工作流(Workflow)可以看作是一种智能体的设计模式,用于将复杂任务拆解为一系列有序、可控的步骤,并按照预先定义的流程逐步执行。
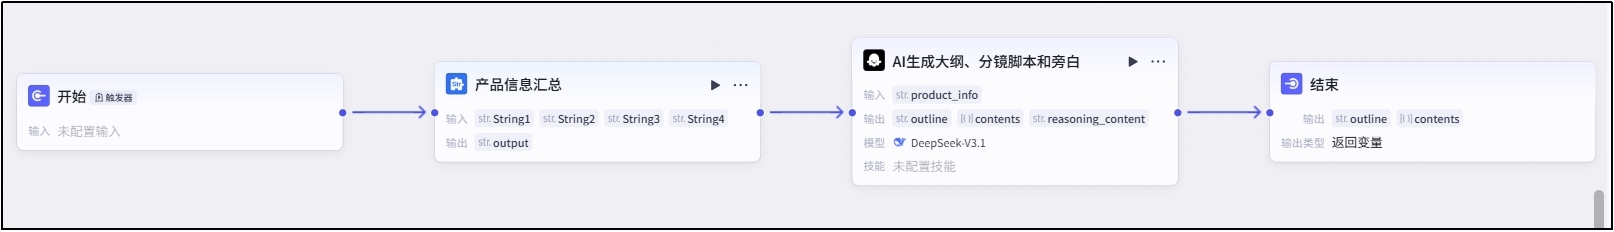
在实际应用中,不同任务对确定性的要求不同:当任务流程相对固定、规则明确时,可以把流程清晰建模为工作流,由系统或模型按既定步骤执行。这种方式可提升稳定性、可复用性和可解释性。
比如讯飞星辰 Agent 平台 https://agent.xfyun.cn/home :
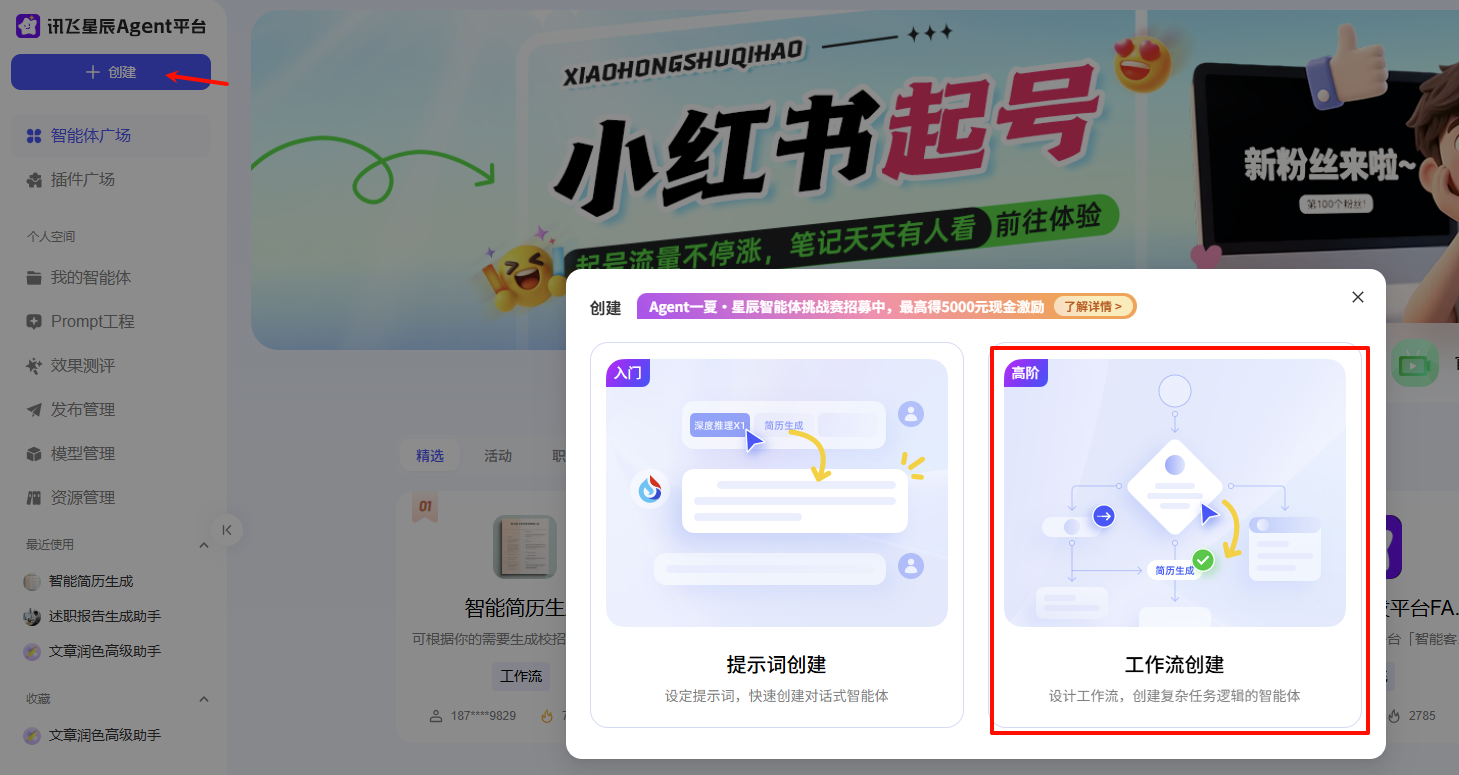
相较于 Agent,工作流的执行流程固定、结果可控,所以很多开发平台把工作流作为独立于 Agent 的另一种应用。
工作流的两种开发方式:Dify、Coze 等在线平台;或基于 LangChain 等框架。
Q:Agent 和工作流到底选哪个?
| 流程是否固定可枚举 | ✅ | |
| 是否需要模型自己决定下一步 | ✅ | |
| 出错能否接受 | 不能(要确定性) | 可以容忍 |
| 是否需要审计、回放 | ✅ | 较难 |
| 步骤数量 | 有限 | 开放 |
我的做法是:能画成流程图的,一律先画成工作流;只有当某个节点确实需要模型自主判断时,才在那个局部引入 Agent。全自主的 Agent 在业务系统里很难交付——你没法向产品解释"它这次为什么走了三步上次走了八步"。
5. 五条路的最终决策表
把四、五、六篇三篇的内容收成一张表:
| 需求没说清、格式乱、风格飘 | 提示词工程 | 无 | 几乎为零 |
| 缺最新信息 / 缺私域资料 / 要溯源 | RAG | 知识库 + 检索链路 | 每次调用的 token |
| 模型不听指令、话术不统一 | 微调 | 标注数据 + 训练卡 | 一次性投入 |
| 长提示词太贵,想固化下来 | 微调 | 同上 | 一次性投入,省长期 token |
| 对整个领域语言/知识系统性不懂 | 先续训再微调 | GB–TB 无标注语料 + 大量卡 | 很高的资本开支 |
| 多步骤 / 要调外部工具 / 要管状态 | 智能体 或 工作流 | 工具生态 + 编排 | 每次调用多次模型请求,长期成本 |
最后总结
- 四条路改的东西不一样:RAG 和智能体完全不动权重(只改上下文和调用方式);微调动一部分权重(0.1%–100%);续训动得最深(继续预训练)。
- RAG 管知识,微调管行为——这句能解决八成的选型争论。
- 微调 ≠ 一定更准:它同样可以是"为了省 token 把长提示词固化进权重",是一个成本手段而不是质量手段。
- 两个昂贵的误区:用 SFT 数据做续训(破坏语言建模能力)、想靠微调补领域知识(应该先续训再微调)。而多数企业场景,RAG + 微调已经够了。
- MCP 不是 Function Call 的替代品,是它的标准化封装:工具的定义和调用者从 AI 应用变成 MCP Server,一次开发多处复用。
- 工作流是智能体的一种设计模式,牺牲自主性换确定性、可复用性和可解释性。业务系统里我更倾向于先穷尽工作流。
- 笔者(后端 & 架构)的落地策略:提示词打底 → RAG 补知识 → 工作流跑固定流程 → 局部节点引入 Agent → 只有出现明确的行为/成本问题时才考虑微调 → 续训基本不参与。真需要续训时,说明这已经是个模型训练项目,不是应用项目了。
系列回顾
| 第一篇 | 认识大模型 | 数据 + 算力 + Transformer 可扩展性,才换来"规模出能力" |
| 第二篇 | 训练范式 | 预训练让它会说话,SFT 让它听指挥,RLHF 让它懂分寸 |
| 第三篇 | 算力与硬件 | 训练卡在显存和通信,推理卡在带宽,FLOPS 最不重要 |
| 第四篇 | 访问方式与幻觉 | 幻觉是系统性问题,只能控制、缓解、检测 |
| 第五篇 | 提示词工程 | 重心已从"设计技巧"转向"需求表达" |
| 第六篇 | RAG / 微调 / 续训 / 智能体 | RAG 管知识,微调管行为,MCP 是工具调用的标准化封装 |
参考资料 & 致谢
[1] 大模型技术之大模型概述 [2] LoRA 论文-arXiv [3] QLoRA 论文-arXiv [4] DeepSeek API 开放平台-官方文档 [5] Model Context Protocol 规范-官网 [6] MCP.so 服务器目录-官网 [7] Smithery MCP 服务-官网 [8] 阿里云百炼 MCP 市场-官网 [9] LangChain / LangGraph 官网 [10] Dify


评论前必须登录!
注册