 网硕互联帮助中心
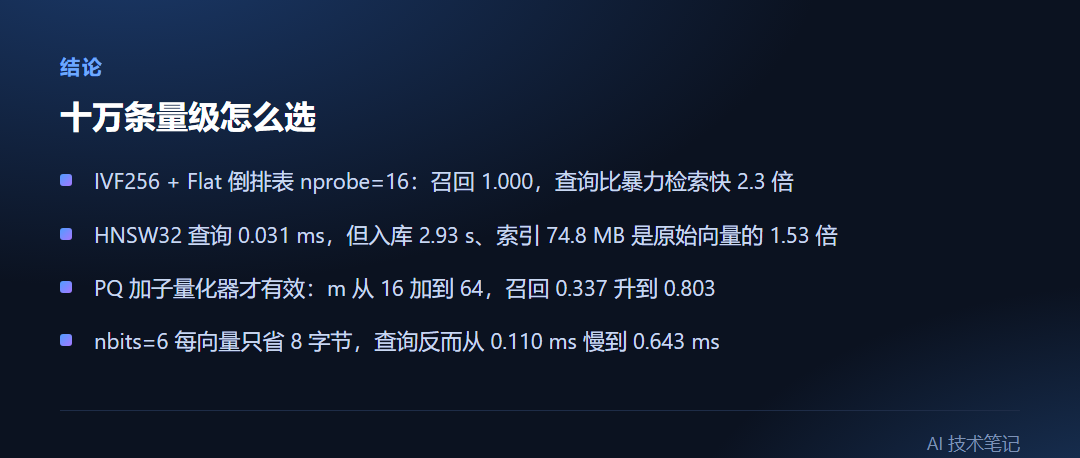
手里有 10 万条 128 维向量、机器只有 2 核的时候,Faiss 里最先该试的不是 HNSW,而是倒排表不加压缩的 IVF:nprobe=16 就能把召回做到和暴力检索一样(1.000),单条查询从 0.452 ms 掉到 0.195 ms。HNSW 更快,0.031 ms 拿到 0.998 的召回,代价是索引体积变成原始向量的 1.53 倍、入库 2.93 秒(IVF 只要 0.10 秒)。PQ 压缩能把索引压到 1/20,但召回只剩 0.337,而且调 nprobe 完全救不回来——瓶颈在压缩码本,不在扫多少个倒排桶。
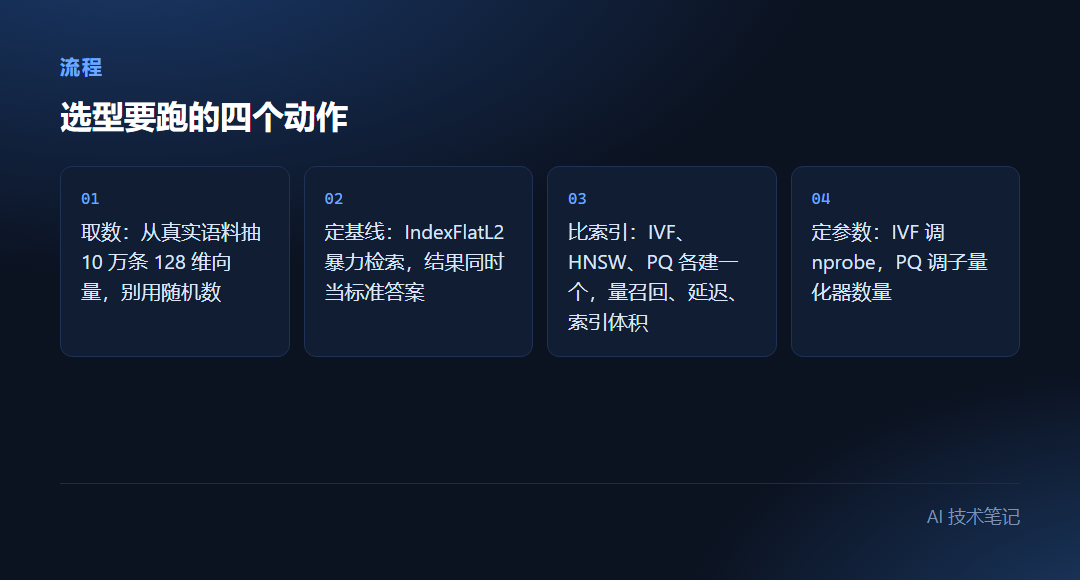
下面这组数全部在一台 2 核机器上跑出来:faiss-cpu 1.15.1、numpy 2.5.3,10 万条 128 维 float32 向量,1000 条查询,top-10。
实验怎么搭的
数据用 2000 个簇心加高斯噪声合成,模拟真实 embedding 的簇结构:512 字节一条的向量,总共 48.8 MB。评测口径是召回@10——用暴力检索(IndexFlatL2)的结果当标准答案,看近似索引的前 10 条里命中了几条。
import faiss, numpy as np, time
np.random.seed(7)
d, nb, nq, k, nc = 128, 100_000, 1000, 10, 2000
centers = np.random.rand(nc, d).astype("float32")
xb = (centers[np.random.randint(0, nc, nb)] + 0.08 * np.random.randn(nb, d)).astype("float32")
xq = (centers[np.random.randint(0, nc, nq)] + 0.08 * np.random.randn(nq, d)).astype("float32")
# 暴力检索既当基线,也当标准答案
flat = faiss.IndexFlatL2(d)
flat.add(xb)
_, gt = flat.search(xq, k) # gt: (1000, 10) 的邻居 id
def recall(I):
return float(np.mean([len(set(I[i]) & set(gt[i])) / k for i in range(len(I))]))
def bench(name, index, need_train=True):
t0 = time.perf_counter()
if need_train:
index.train(xb) # IVF/PQ 必须先训练
t_train = time.perf_counter() – t0
t0 = time.perf_counter(); index.add(xb); t_add = time.perf_counter() – t0
t0 = time.perf_counter(); _, I = index.search(xq, k); t_q = time.perf_counter() – t0
print(f"{name}: 训练 {t_train:.2f}s 入库 {t_add:.2f}s "
f"查询 {t_q / nq * 1000:.3f} ms/条 召回@10 {recall(I):.3f}")
return I
ivf = faiss.IndexIVFFlat(faiss.IndexFlatL2(d), d, 256) # 256 个倒排桶
ivf.nprobe = 16 # 每次扫 16 个桶
bench("IVF256,Flat nprobe=16", ivf)
pq = faiss.IndexIVFPQ(faiss.IndexFlatL2(d), d, 256, 16, 8) # 16 个子量化器 x 8 bit
pq.nprobe = 32
bench("IVF256,PQ16x8 nprobe=32", pq)
hnsw = faiss.IndexHNSWFlat(d, 32) # 图索引不需要训练
hnsw.hnsw.efSearch = 64
bench("HNSW32 efSearch=64", hnsw, need_train=False)
四种索引的实测结果
| Flat(暴力,基线) | 不需要 | 0.02 s | 0.452 | 1.000 | 48.8 MB | 1.00 |
| IVF256,Flat nprobe=16 | 0.70 s | 0.10 s | 0.195 | 1.000 | 49.7 MB | 1.02 |
| HNSW32 efSearch=64 | 不需要 | 2.93 s | 0.031 | 0.998 | 74.8 MB | 1.53 |
| IVF1024,PQ32x8 nprobe=32 | 5.37 s | 0.51 s | 0.063 | 0.573 | 4.4 MB | 0.09 |
| IVF256,PQ16x8 nprobe=32 | 1.99 s | 0.24 s | 0.072 | 0.337 | 2.5 MB | 0.05 |
口径说明:召回@10 以暴力检索结果为标准答案;体积倍率 = 索引文件 ÷ 原始向量 48.8 MB;查询耗时为 1000 条查询连续执行后的平均值,未做预热剔除。
Flat(基线): 入库 0.02s 查询 0.452 ms/条 召回 1.000
IVF256,Flat nprobe=16: 训练 0.70s 入库 0.10s 查询 0.195 ms/条 召回 1.000
IVF256,PQ16x8 nprobe=32: 训练 1.99s 入库 0.24s 查询 0.072 ms/条 召回 0.337
IVF1024,PQ32x8 nprobe=32: 训练 5.37s 入库 0.51s 查询 0.063 ms/条 召回 0.573
HNSW32 efSearch=64: 入库 2.93s 查询 0.031 ms/条 召回 0.998
这组数据里最能说明问题的是 IVF 和 HNSW 的差别:两者召回都在 0.998 以上,但 HNSW 的查询快 6 倍,入库慢 29 倍,索引大 50%。查询量大的在线服务,这点差异值得;离线批处理每天跑一次的场景,就没必要为 HNSW 付这份入库代价。
调 nprobe 救不回 PQ
PQ 版本的召回 0.337 看着难受,第一反应是加大 nprobe。结果是白费功夫:
nprobe= 1 查询 0.005 ms/条 召回@10 0.336
nprobe= 4 查询 0.012 ms/条 召回@10 0.337
nprobe= 8 查询 0.021 ms/条 召回@10 0.337
nprobe= 16 查询 0.040 ms/条 召回@10 0.337
nprobe= 32 查询 0.076 ms/条 召回@10 0.337
nprobe= 64 查询 0.132 ms/条 召回@10 0.337
nprobe=128 查询 0.229 ms/条 召回@10 0.337
nprobe 从 1 涨到 128,扫描的桶数量翻了 128 倍,查询耗时涨了 46 倍,召回一位小数都没动。原因不难理解:正确的那条邻居早就被倒排桶圈进来了,问题出在距离是用 16 字节的压缩码算的,算出来的排序和真实距离不一致,前 10 名被挤出去了。扫更多桶只会带进更多同样被压缩码扭曲的候选。
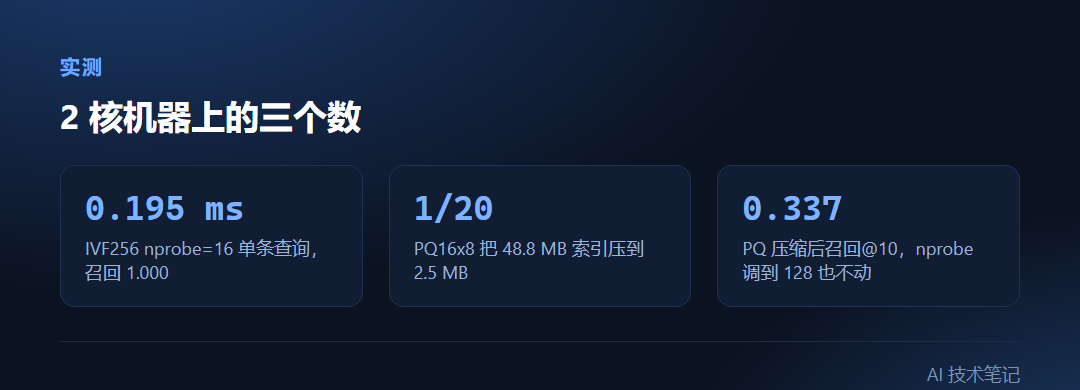
真正管用的旋钮是每个向量的字节数。把子量化器数量从 16 加到 64,召回从 0.337 升到 0.803,索引也从 2.5 MB 涨到 7.1 MB:
| 8 | 8 | 8 | 1.63 s | 0.048 | 0.244 | 1.8 MB |
| 16 | 8 | 16 | 1.94 s | 0.075 | 0.337 | 2.5 MB |
| 32 | 8 | 32 | 2.86 s | 0.110 | 0.509 | 4.1 MB |
| 64 | 8 | 64 | 4.97 s | 0.229 | 0.803 | 7.1 MB |
| 32 | 6 | 24 | 1.62 s | 0.643 | 0.425 | 3.2 MB |
口径说明:全部为 IVF256 + nprobe=32,同样的 10 万条数据和 1000 条查询;字节/向量 = m × nbits ÷ 8,与索引文件大小互相印证(16 字节 × 10 万条 = 1.6 MB,加码本和倒排表后是 2.5 MB)。
表里最后一行是个意外的坑:nbits=6 每向量只要 24 字节,比 m=32/nbits=8 省 8 字节,但查询从 0.110 ms 变成 0.643 ms,慢了近 6 倍。faiss 的 PQ 距离计算只对 nbits=8 和 4 有 SIMD 快路径,6 bit 走通用路径,省下的那点体积全被算力吃回去了。
我踩到的两个坑
第一个跟数据有关。同一套代码,我把向量换成均匀随机数(没有簇结构)再跑一遍,IVF256 nprobe=8 的召回只有 0.175,PQ 是 0.165。128 维空间里均匀随机的点彼此距离都差不多,倒排桶分不出谁该进哪个桶,压缩码也分不出差距。所以在自己的语料上做选型前,先确认数据是不是真的有簇结构——用真实 embedding 跑,别照搬别人的召回数字。
第二个是流程上的。IVF 和 PQ 必须先训练再入库,顺序反了会直接报错:
RuntimeError: Error in virtual void faiss::IndexIVFFlat::add_core(…)
at /project/faiss/IndexIVFFlat.cpp:66: Error: 'is_trained' failed
另外 faiss 对训练样本量有自己的判断,训练集给 2000 条时会打印 please provide at least 9984 training points,这个 9984 约等于 39 × nlist。我试了 2000 / 13000 / 26000 / 100000 四种训练规模,召回分别是 0.346 / 0.337 / 0.333 / 0.337,在这个数据集上没有区别,但训练样本少于建议值时该给的警告还是会给。
我怎么用它
十万条这个量级,我的默认选择是 IVF256 加 Flat 倒排表、nprobe=16:召回和暴力检索一样,查询快 2.3 倍,索引只大 1.8%,训练 0.7 秒。上线前只在真实语料上跑一遍召回,对得上就收工。
HNSW 我会留给两种情况:查询延迟有硬指标(比如要压到 0.05 ms 以内),或者数据是流式增量、没法停机重训。它的代价是入库 2.93 秒和 74.8 MB 索引,增量插入还会让图结构慢慢变差,需要定期重建。
PQ 我暂时不用在这个量级。十万条压缩到 2.5 MB 省下来的内存,换 0.337 的召回不划算。PQ 真正的用武之地是千万级以上、内存装不下原始向量的场景,那时候连 Flat 倒排表都放不下,压缩是唯一选项,代价就是召回。真要上,我会先把 m 调到 32 或 64,而不是去动 nprobe。
三条可以马上做的:


评论前必须登录!
注册