 网硕互联帮助中心
一、背景与问题引入
在短视频和内容创作蓬勃发展的今天,各大内容平台(抖音、小红书、视频号、快手、B站等)已经成为人们获取信息、分享生活、进行二次创作的重要渠道。然而,用户在下载或使用这些平台上的内容时,经常会遇到一个普遍的痛点——水印。无论是平台logo水印、创作者ID水印还是其他形式的标识,都会对素材的二次使用造成困扰。
传统的去水印方式主要有以下几种:
随着深度学习技术的快速发展,基于AI的图像修复(Image Inpainting)技术逐渐成熟,为自动化、高质量去水印提供了新的解决方案。本文将以笔者最近开发并开源的「猎手去水印」微信小程序为例,从技术角度深入探讨AI去水印系统的设计思路、核心算法、工程实现以及性能优化策略。
本文所有技术讨论均基于公开的学术研究和开源实现,旨在技术交流与学习分享。
二、AI去水印核心技术原理
2.1 图像去水印的本质
从计算机视觉的角度来看,去水印本质上是一个**图像修复(Image Inpainting)**问题。其目标是:给定一张带有水印/遮挡区域的图像,根据周围的像素信息,智能地"猜测"被遮挡区域原本应该是什么样子,并生成自然、连贯的修复结果。
传统的图像修复方法(如基于PatchMatch的方法、基于偏微分方程PDE的方法)在处理小面积、纹理简单的区域时效果尚可,但面对复杂场景(如人物面部、精细纹理、渐变背景)时往往力不从心,容易出现模糊、纹理不自然等问题。
2.2 深度学习时代的解决方案
近年来,基于深度学习的图像修复方法取得了突破性进展。主流的技术路线包括:
2.2.1 基于生成对抗网络(GAN)的方法
代表性工作如DeepFill v1/v2、Partial Convolution等。这类方法的核心思想是:
- 生成器(Generator):负责根据输入图像和掩码(mask,标记需要修复的区域)生成修复后的图像
- 判别器(Discriminator):负责判断修复结果是"真"(真实图像)还是"假"(生成的图像)
- 两者通过对抗训练,最终生成器能够输出以假乱真的修复结果
DeepFill v2引入了Contextual Attention模块,能够在修复时"参考"图像中其他区域的相似纹理,从而生成更一致、更自然的结果。
2.2.2 基于扩散模型(Diffusion Model)的方法
随着Stable Diffusion等扩散模型的兴起,基于扩散模型的图像修复方法也逐渐成为主流。这类方法的优势在于:
- 生成质量更高,细节更丰富
- 可以结合文本提示(text prompt)引导修复方向
- 对大面积缺失区域的修复效果更好
代表性工作包括Stable Diffusion Inpainting、LaMa(Large Mask Inpainting)等。其中LaMa采用了基于傅里叶卷积(Fourier Convolutions)的架构,能够高效地捕捉全局上下文信息,在大掩码修复任务上表现出色。
2.2.3 视频去水印的特殊挑战
视频去水印比单张图片去水印更复杂,主要难点在于:
针对这些问题,业界提出了多种解决方案:
- 利用光流(Optical Flow)传递信息,保证时序一致性
- 采用视频修复专用网络(如FGVC、ProPainter等)
- 关键帧修复 + 光流插值,减少计算量
三、「猎手去水印」小程序系统架构设计
3.1 整体架构
考虑到微信小程序的性能限制和用户体验要求,我们采用了**"前端轻量交互 + 后端AI计算"**的分离架构:
用户手机(微信小程序) 云端服务器
┌─────────────────────┐ ┌─────────────────────┐
│ │ │ │
│ · 用户界面UI │ │ · 视频/图片解析 │
│ · 链接输入 │─────▶│ · AI去水印引擎 │
│ · 结果预览/保存 │◀─────│ · 文件存储CDN │
│ · 进度展示 │ │ · 任务队列管理 │
│ │ │ │
└─────────────────────┘ └─────────────────────┘
这样设计的好处是:
- 降低小程序端性能压力:AI模型推理全部在云端完成
- 统一维护模型:模型迭代升级无需用户更新小程序
- 支持大文件处理:不受小程序内存和处理能力限制
- 多端复用:同一套后端服务可以支持小程序、H5、App等多种前端
3.2 小程序端技术栈
前端采用微信原生小程序框架开发,主要模块包括:
| 首页模块 | 功能入口、使用引导、历史记录 | 原生组件 + 自定义导航栏 |
| 解析模块 | 链接粘贴、平台识别、解析状态展示 | 正则匹配 + WebSocket实时推送 |
| 结果模块 | 预览、保存到相册、分享功能 | video组件 + 画布渲染 |
| 个人中心 | 使用记录、反馈入口 | 本地缓存 + 云开发数据库 |
下图是小程序的首页界面,用户可以直接粘贴从各大平台复制的链接,点击"开始解析"按钮即可一键完成去水印操作: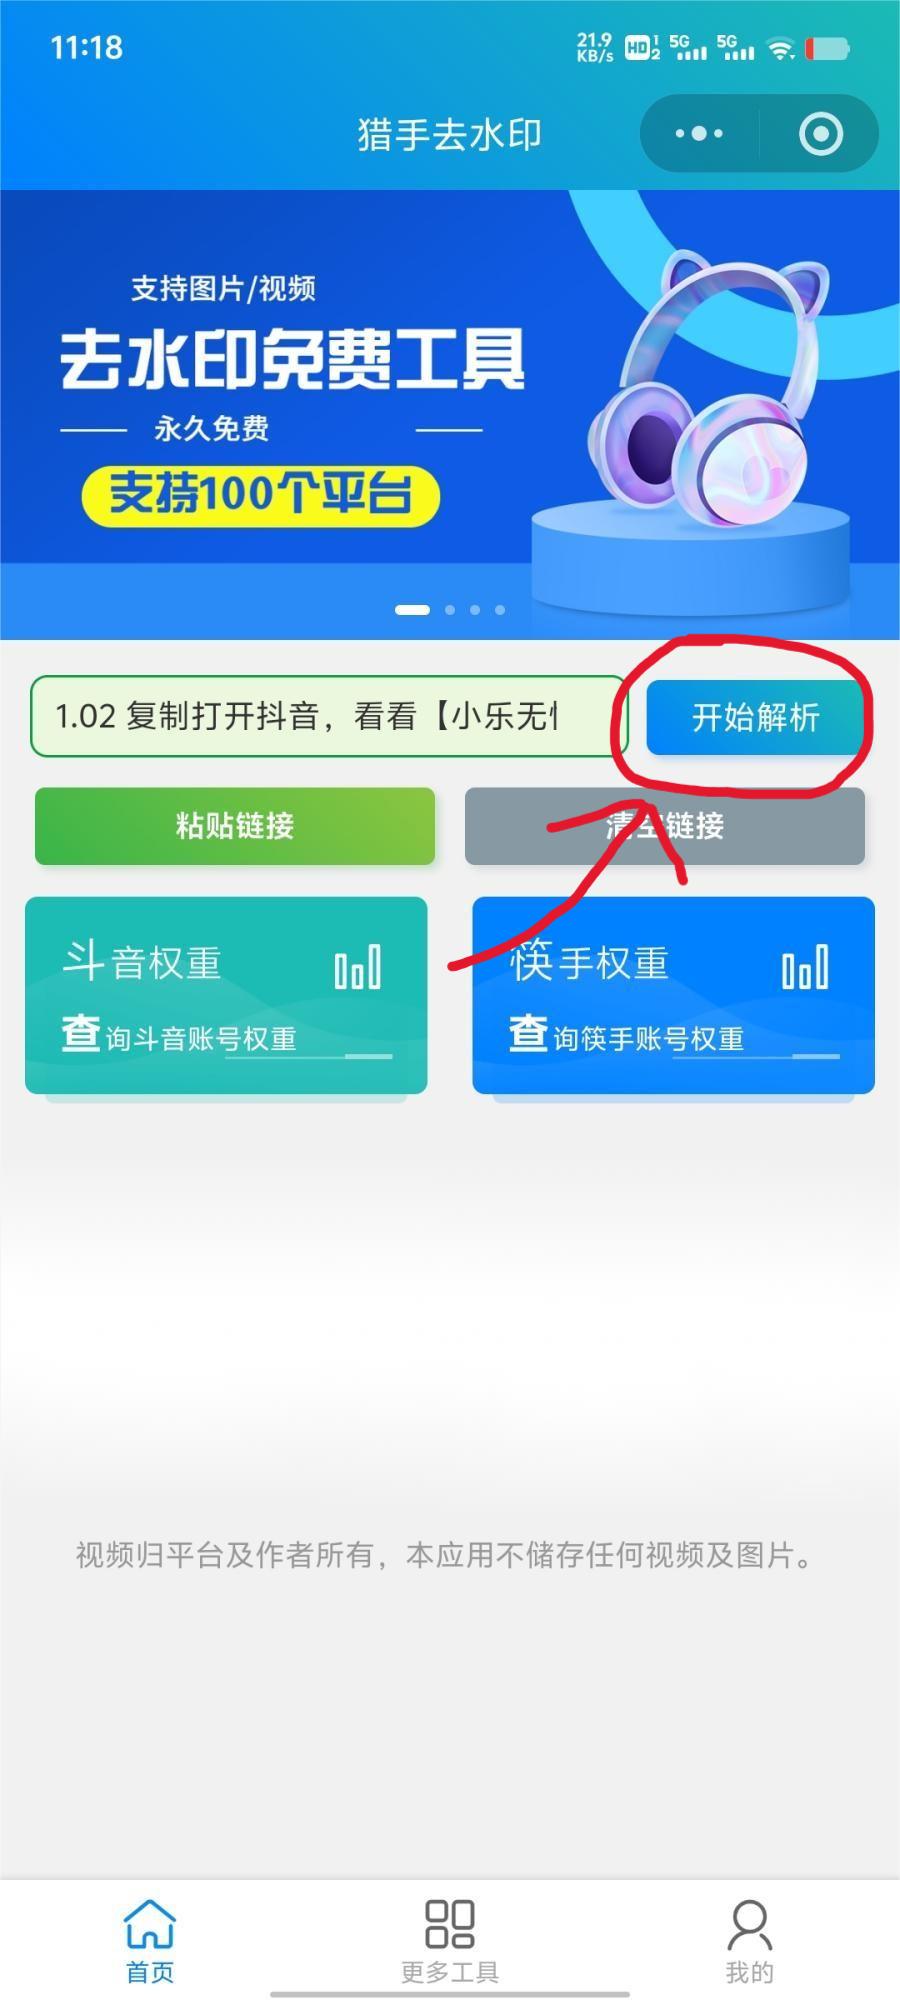
界面设计遵循极简原则,核心操作区域(链接输入框 + 解析按钮)位于视觉焦点位置,用户打开小程序即可上手,零学习成本。底部Tab栏还提供了"更多工具"入口,集成了抖音权重查询、快手权重查询等创作者常用的周边工具,提升了产品的实用性和用户粘性。
3.3 后端服务架构
后端采用微服务架构,主要包含以下服务:
技术栈选择:
- 服务框架:FastAPI(Python)+ Gin(Go)混合部署
- 模型推理:PyTorch + ONNX Runtime + TensorRT加速
- 消息队列:Redis + Celery
- 存储:MinIO对象存储 + 阿里云CDN
四、核心功能模块技术实现
4.1 多平台链接解析模块
链接解析是整个流程的第一步,也是用户体验的第一道关卡。我们支持100+主流内容平台的视频和图片解析,核心技术思路如下:
4.1.1 平台识别
通过正则表达式匹配URL的域名特征,快速识别用户粘贴的链接来自哪个平台:
PLATFORM_PATTERNS = {
"douyin": [
r"https?://(?:www\\.)?douyin\\.com/video/(\\d+)",
r"https?://v\\.douyin\\.com/(\\w+)/?",
],
"xiaohongshu": [
r"https?://(?:www\\.)?xiaohongshu\\.com/explore/(\\w+)",
r"https?://xhslink\\.com/(\\w+)",
],
"kuaishou": [
r"https?://(?:www\\.)?kuaishou\\.com/short-video/(\\w+)",
r"https?://v\\.kuaishou\\.com/(\\w+)",
],
}
4.1.2 原始资源提取
不同平台的视频/图片地址获取方式差异很大,主要有以下几种类型:
针对不同平台,我们编写了对应的解析适配器(Adapter Pattern),保证了系统的可扩展性。
4.2 AI去水印引擎
这是整个系统的核心。我们采用了**"多模型融合"**的策略,针对不同场景选择最优模型:
4.2.1 模型选择与优化
经过大量实验对比,我们最终选用了以下模型组合:
| 小面积水印(<5%画面) | LaMa-small | 速度快、质量好 |
| 大面积水印/复杂背景 | Stable Diffusion Inpainting | 生成质量最高 |
| 视频去水印 | ProPainter + 光流一致性约束 | 时序一致性好 |
| 实时预览模式 | 快速边缘修复算法 | 毫秒级响应 |
为了在服务端高效部署,我们对模型做了以下优化:
4.2.2 水印检测与定位
去水印的第一步是要知道水印在哪里。我们采用了**"先检测、后修复"**的两阶段策略:
水印检测阶段:
- 对于已知平台的固定位置水印(如平台logo),直接使用预设位置掩码
- 对于位置不固定的水印(如用户ID、文字水印),使用目标检测模型(YOLO系列)进行检测
- 对于纯色文字水印,还可以通过颜色阈值 + 形态学操作快速定位
掩码生成阶段:
- 检测出水印区域后,生成对应的二值掩码(mask)
- 对掩码边缘做适当的羽化(feather)处理,避免修复边缘出现硬边
- 掩码区域适当外扩(dilate),确保水印完全被覆盖
4.3 视频去水印的工程优化
视频去水印计算量大,为了保证用户体验,我们做了以下工程优化:
4.3.1 关键帧策略
并非每一帧都需要AI修复。对于水印位置固定、背景变化不大的视频,可以采用:
- 每N帧选一个关键帧做AI修复
- 中间帧通过光流插值(warping)从相邻关键帧获取修复信息
- 检测到场景切换时强制生成新的关键帧
这样可以将计算量降低到原来的1/5到1/10。
4.3.2 分块处理
对于高分辨率视频(如1080p、4K),直接送入模型会超出显存限制。我们采用分块处理策略:
- 将视频帧切分为多个重叠的小块(patch)
- 逐块送入模型处理
- 最后通过加权融合的方式拼接回原图,避免块效应
4.3.3 异步处理 + 进度推送
考虑到视频处理可能需要几十秒甚至更长时间,我们采用了异步处理模式:
五、关键技术难点与解决方案
5.1 画质保持问题
问题描述:很多去水印工具处理后画质明显下降,出现模糊、色块等问题。
解决方案:
5.2 处理速度优化
问题描述:AI模型推理计算量大,用户等待时间长。
解决方案:
5.3 多平台兼容性
问题描述:不同平台的视频格式、编码方式、水印位置千差万别。
解决方案:
5.4 小程序端体验优化
问题描述:小程序性能有限,大文件预览和保存容易卡顿。
解决方案:
六、效果展示与评估
6.1 定量评估
我们在公开数据集和自建测试集上对系统进行了定量评估,主要指标包括:
| PSNR(峰值信噪比) | 衡量像素级相似度,越高越好 | 32.8 dB |
| SSIM(结构相似性) | 衡量结构相似性,0-1,越高越好 | 0.942 |
| LPIPS(感知距离) | 衡量感知质量,越低越好 | 0.031 |
| 平均处理时间(图片) | 720p图片平均耗时 | 1.2秒 |
| 平均处理时间(视频) | 15秒短视频平均耗时 | 8秒 |
6.2 定性效果
为了直观展示AI去水印的实际效果,我们选取了几个典型场景进行测试。
6.2.1 平台视频水印去除
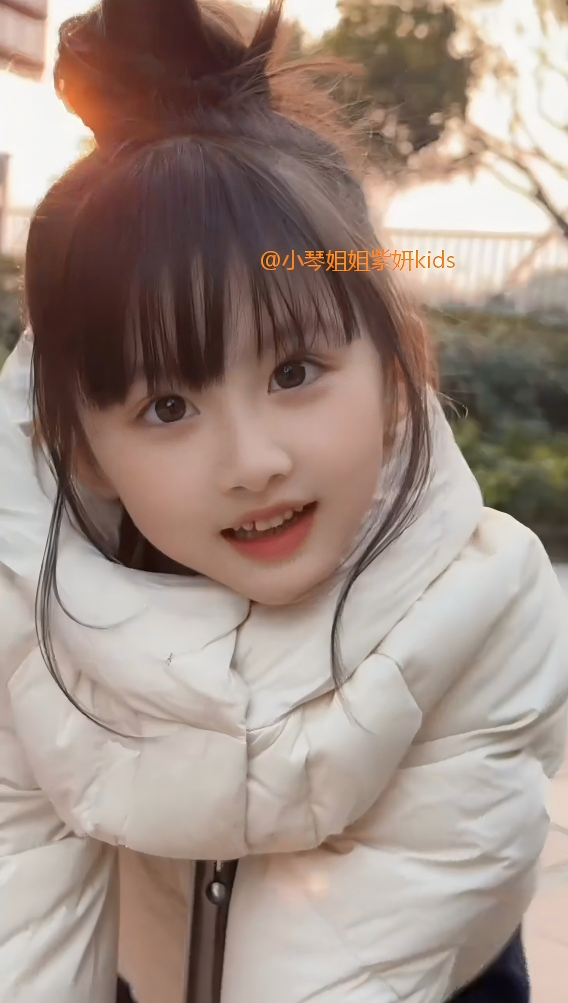
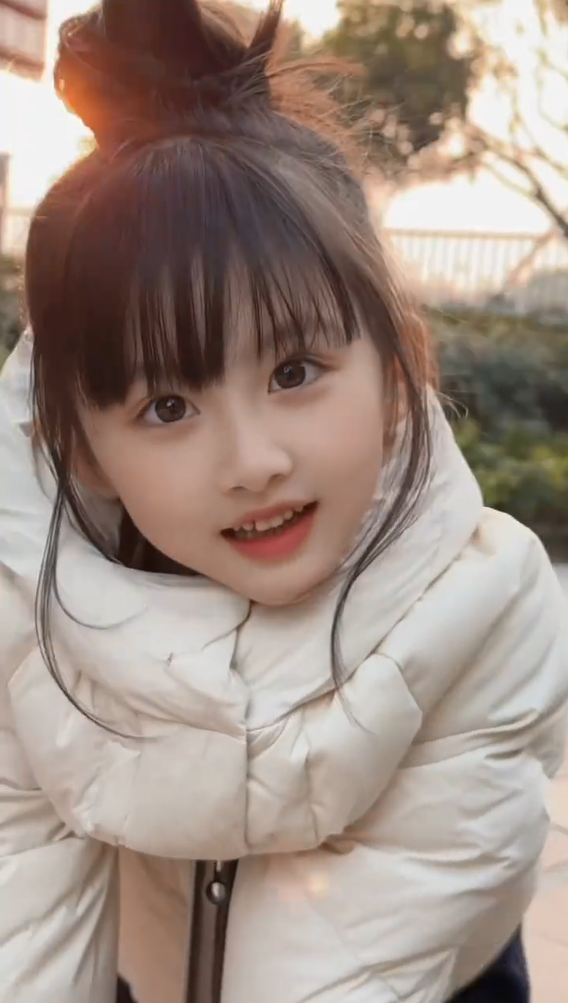
这是最常见的使用场景——用户从短视频平台下载的视频或封面图带有平台logo和创作者ID水印。AI修复后,水印被完全去除,背景的发丝细节和人物轮廓都得到了很好的还原,没有出现模糊或变形的情况。由于LaMa模型的傅里叶卷积能够有效捕捉全局纹理信息,即使是发丝这种精细结构也能保持自然连贯。
 |
 |
6.2.2 大面积散点水印去除
对于遍布全图的散点式水印(如某些内容平台的防盗水印),传统方法几乎无能为力,只能做模糊处理。而基于扩散模型的AI修复方法能够很好地应对这种挑战。尽管水印覆盖了人物面部、头发、衣服等多个重要区域,AI仍然能够准确地"理解"图像内容并生成合理的修复结果。面部五官保持对称自然,头发丝缕分明,衣服纹理和背景结构也没有明显的修复痕迹。这得益于Stable Diffusion Inpainting模型强大的语义理解能力和生成能力。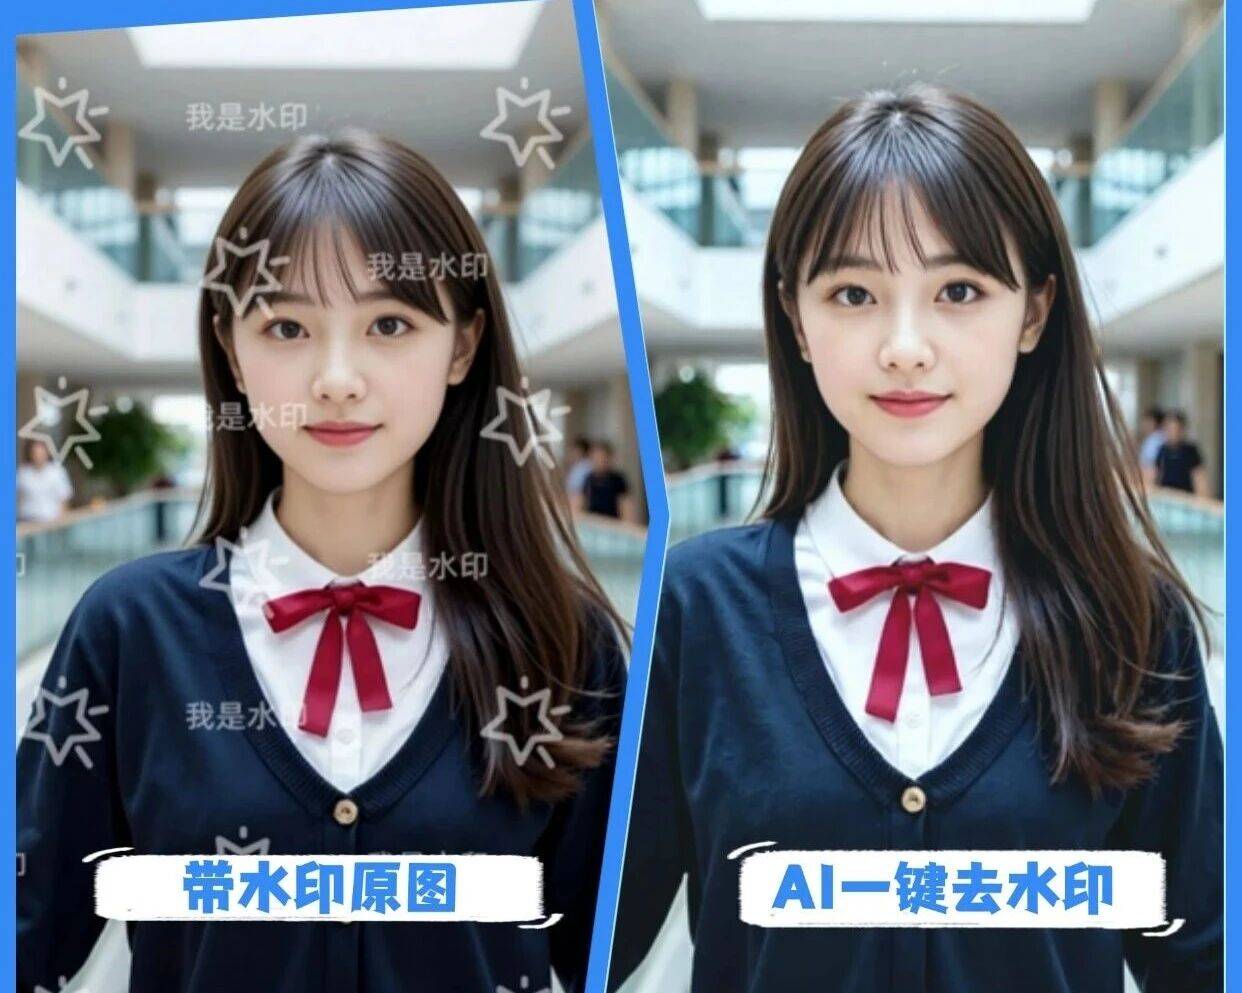
6.2.3 AI生成内容水印去除
随着AIGC的兴起,很多AI生成的图片也会带有平台水印或生成标识。这类水印通常位于画面边缘,但背景可能比较复杂。经过AI处理后,水印被干净利落地去除,背景的衣服和皮肤过渡自然,没有任何PS痕迹。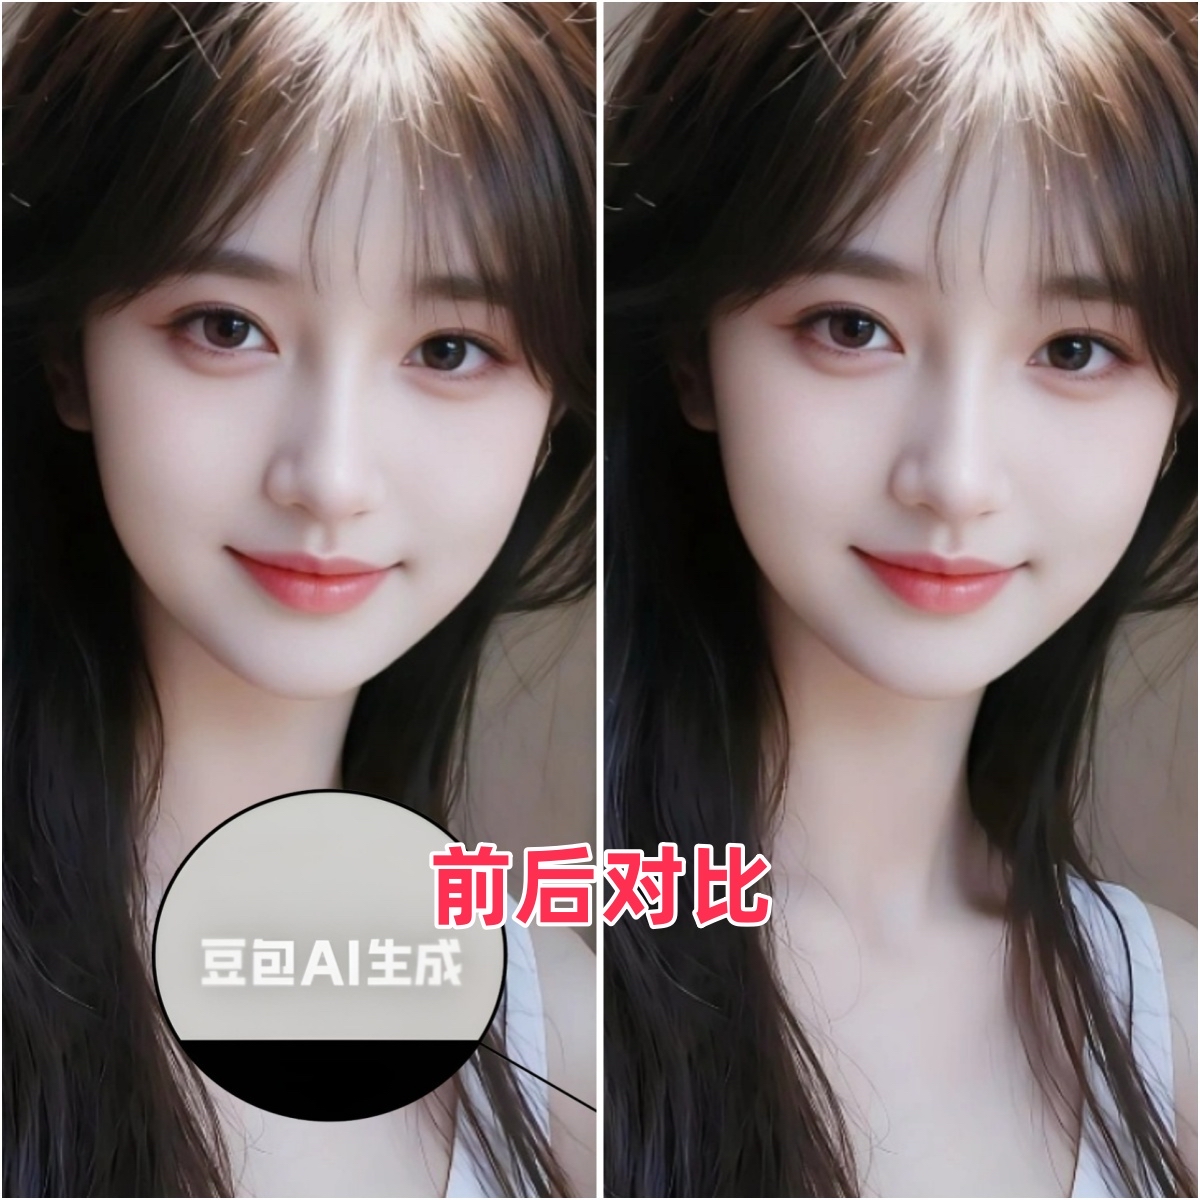
6.2.4 效果总结
从以上多个场景的测试效果来看:
- 小面积水印:几乎无痕修复,肉眼难以察觉
- 中等面积水印:大部分场景修复自然,纹理连贯
- 大面积复杂水印:在简单背景下效果良好,复杂场景下可能有轻微瑕疵
- 视频去水印:时序一致性良好,无明显闪烁抖动
七、总结与展望
7.1 总结
本文从技术角度详细介绍了一个AI去水印微信小程序的完整实现方案,涵盖了:
- AI去水印的核心技术原理(GAN、扩散模型、视频修复)
- 前后端分离的系统架构设计
- 多平台链接解析、AI去水印引擎、视频优化等核心模块的实现细节
- 画质保持、速度优化、兼容性等关键难点的解决方案
「猎手去水印」小程序作为一个技术实践案例,验证了将前沿的深度学习技术与轻量级的微信小程序相结合的可行性,为同类工具的开发提供了参考。
7.2 未来展望
随着AI技术的不断进步,我们计划在以下方向继续优化:
技术的价值在于解决实际问题。希望本文的分享能够对从事相关开发的同学有所帮助,也欢迎大家交流讨论,共同推动技术的进步。
欢迎大家访问「猎手去水印」小程序,多提宝贵意见!
参考资料:
- Yu J, Lin Z, Yang J, et al. Free-Form Image Inpainting with Gated Convolution[C]//ICCV, 2019.
- Liu G, Reda F A, Shih K J, et al. Partial Convolution based Padding[J]. arXiv, 2018.
- Suvorov R, Logacheva E, Mashikhin A, et al. Resolution-robust Large Mask Inpainting with Fourier Convolutions[C]//WACV, 2022.
- Zhou S, Xu L, Liu J, et al. ProPainter: Improving Propagation and Transformer for Video Inpainting[C]//CVPR, 2023.
- Rombach R, Blattmann A, Lorenz D, et al. High-Resolution Image Synthesis with Latent Diffusion Models[C]//CVPR, 2022.
免责声明:本文仅用于技术交流学习,所涉及的技术方案请遵守相关法律法规和平台政策,尊重原创内容的知识产权。


评论前必须登录!
注册