 网硕互联帮助中心
26年9月来自伯克利分校、圣何塞州立大学、Meta公司和Apple公司等的论文“Do World Models Make Better Robots?”。
这篇论文最有价值的观点是:世界模型的评估应当落实到“预测未来能否帮助机器人更好地行动”,并测出这种帮助发生在哪些任务、哪些能力上。 但论文的若干关键分类存在明显问题,因此,它提出的研究方向值得重视,“11/160”等统计结论则需要谨慎引用。
论文首先提出了一个明确的问题:预测能力与行动能力之间,缺少什么证据?
如图 1 所示预测还是行动?这是该综述基于实际基准提出的核心问题。闭环(左侧):策略类和具身智能类基准通过在环境中运行策略来评估任务成功率。开环(右侧):世界模型和视频生成类基准在不涉及实际行动的情况下,评估预测或生成的质量。处于中间轴位置的问题是上述两端均未直接回答的:预测是否能带来闭环优势?而在160个基准中,仅有11个明确构建了这种优势(见表10)。
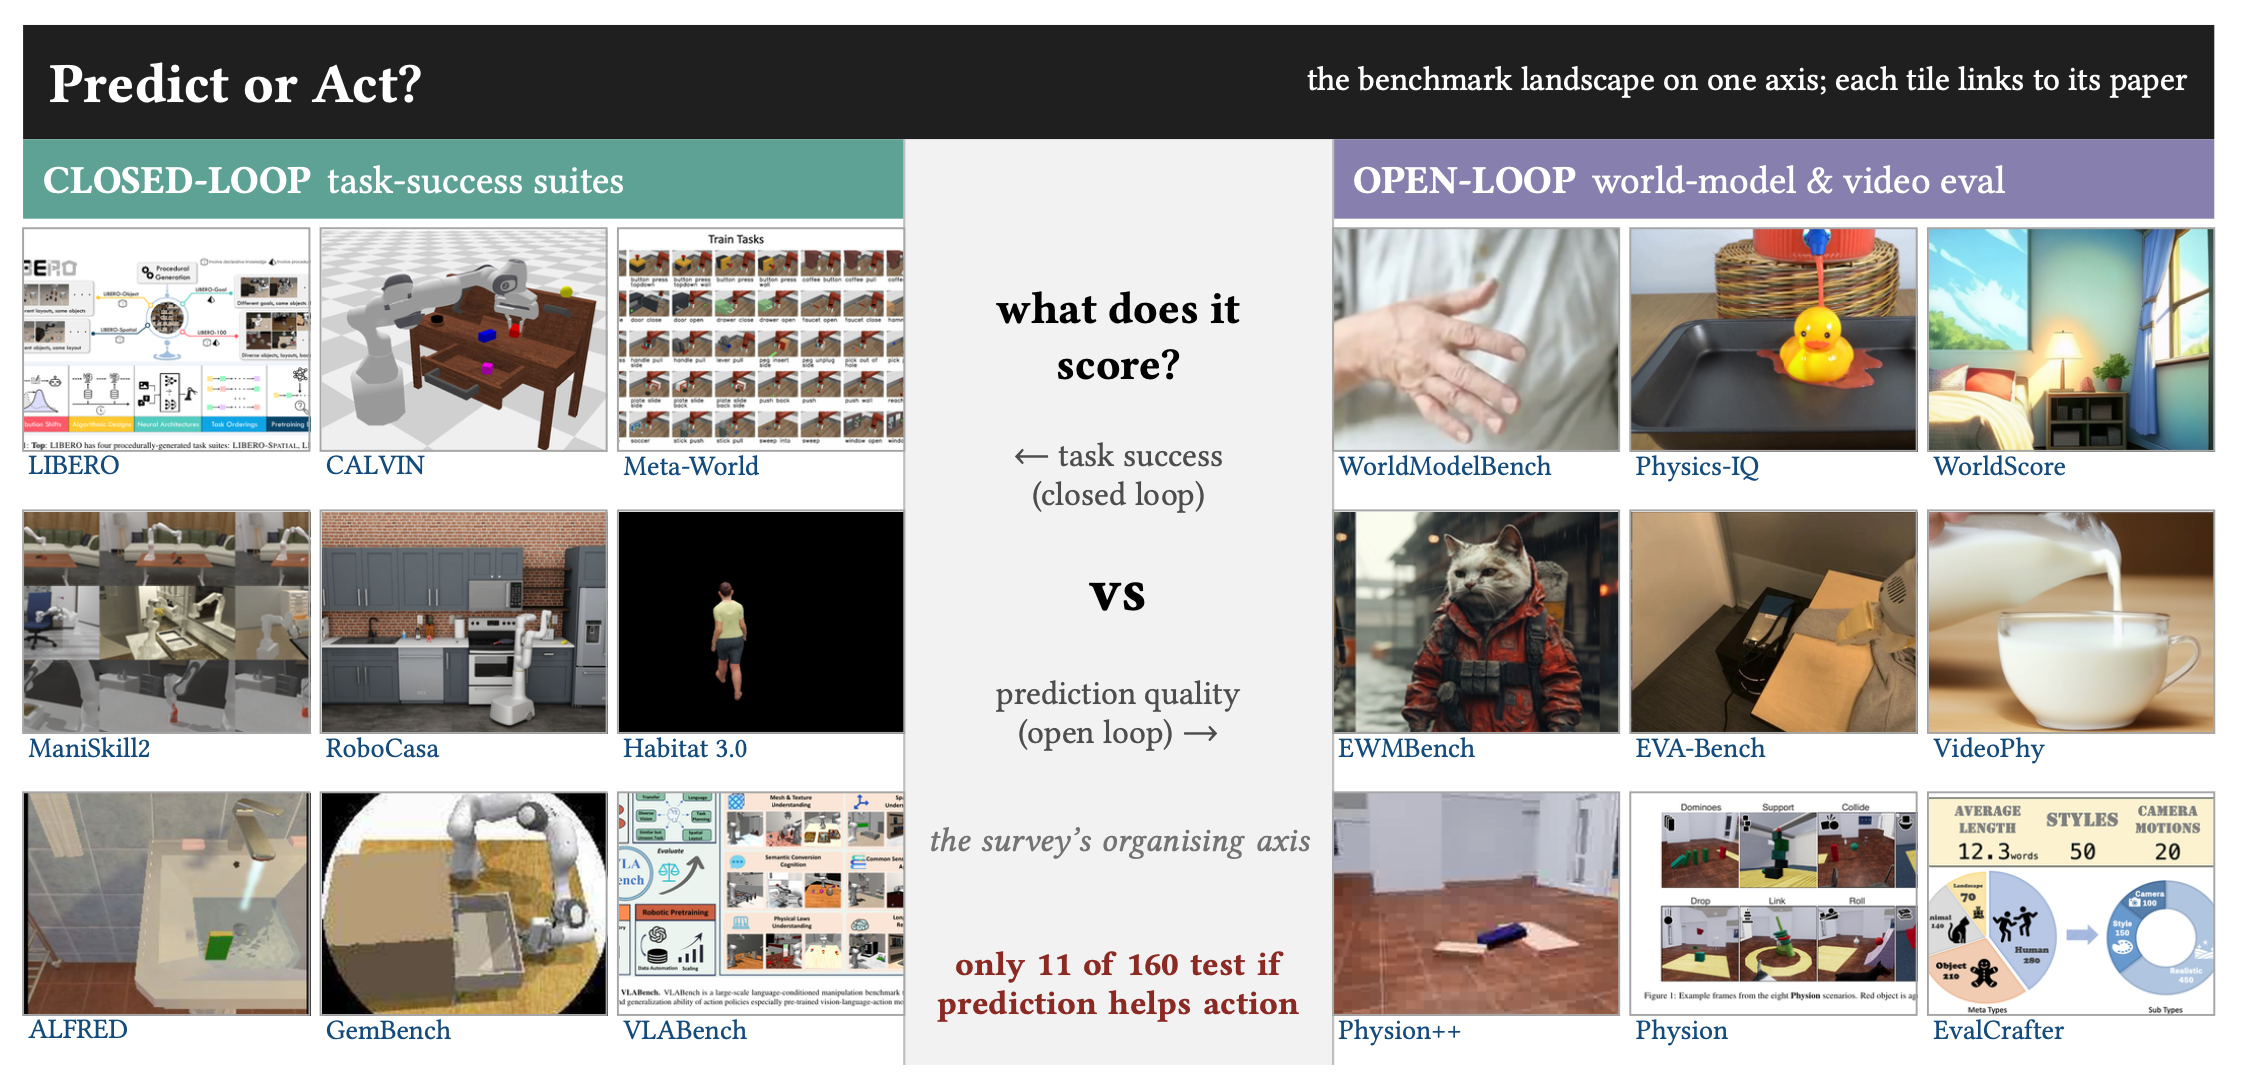
作者观察到,机器人研究中有两套相对分离的评测方式:
直接策略,包括视觉—语言—动作模型(VLA):根据观察和指令产生动作,通常通过机器人在环境中的任务成功率来评价。
预测式世界模型:预测未来状态、图像或视频,很多评测关注预测是否准确、画面是否逼真、运动是否符合物理规律。
两套评测分别回答了“任务完成得怎样”和“未来预测得怎样”,却不一定回答:加入世界模型以后,相比条件匹配的直接策略,机器人究竟提高了多少?
例如,一个模型能生成“机械臂成功拿起杯子”的逼真视频,并不能保证视频对应的抓取位置、接触过程和运动轨迹可以执行。反过来,一个机器人任务成功率很高,也不能单凭这一结果认定收益来自世界模型。
作者希望建立的证据链是:
世界模型提供预测 → 预测影响决策 → 动作在环境中执行 → 获得反馈 → 与直接策略比较实际收益。
这里的“执行”可以发生在仿真环境中,并不意味着一定经过真实机器人验证。
论文的调查对象是评测基准,范围相当广。(第 2 节,第 4—7 页)
作者汇集了 2017—2026 年的 160 个基准,并选出 86 个作为核心分类中的代表,涉及 12 个能力领域,同时与 8 篇相关综述或立场论文比较。
如图 2 所示按时间顺序排列的最相关基准测试/评估综述如下。其中两项发表于近期热潮之前:一篇是关于具身智能(Embodied AI)仿真器与任务的 IEEE TETCI 综述 [42],另一篇是关于真实机器人强化学习(RL)可复现性的 CoRL 综述 [95](琥珀色标记表示经同行评审的会议/期刊);其余均为 2026 年发布的预印本,涵盖具身评估、VLA 数据及世界模型等领域。
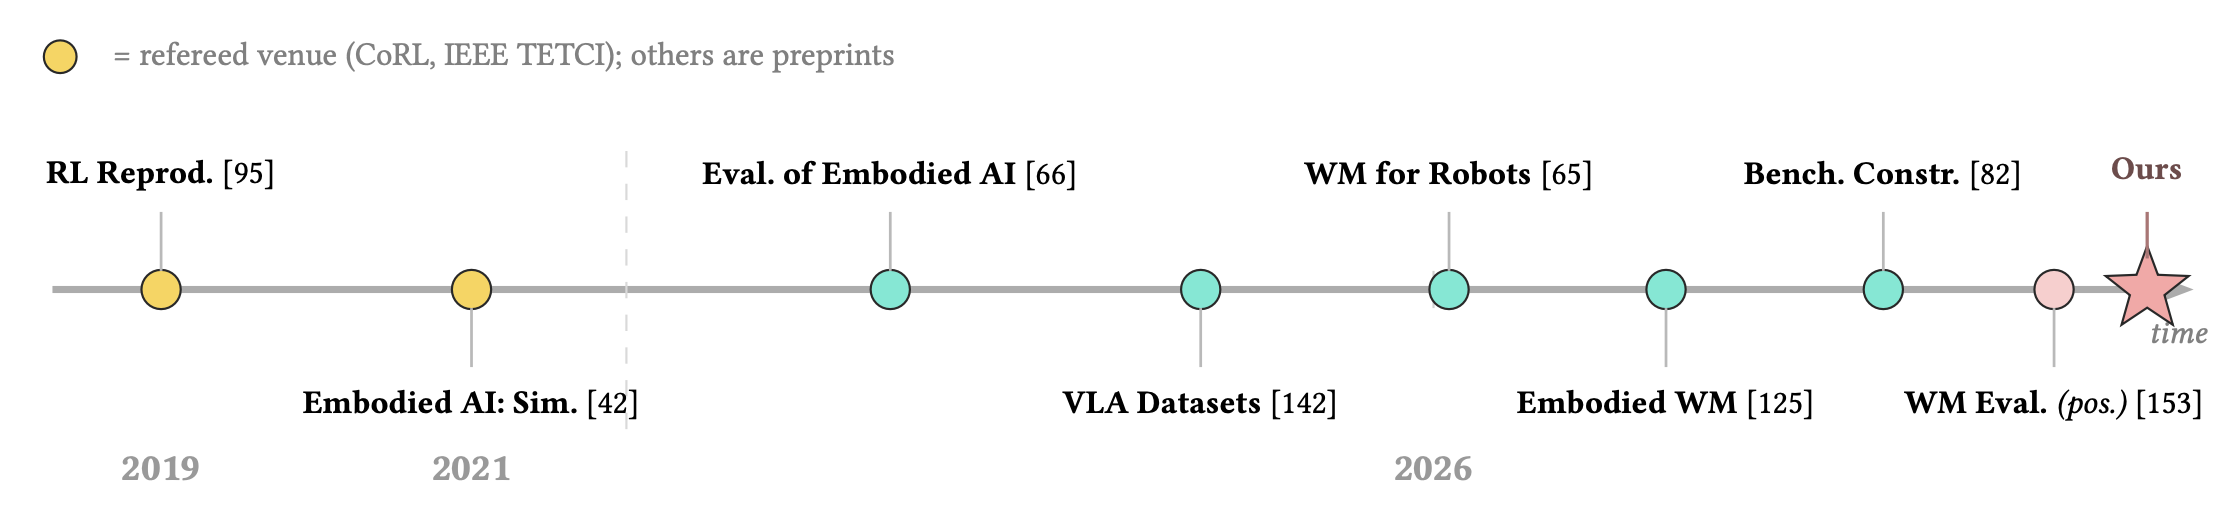
其收集过程包括网络检索、去重、筛选,以及对标题、作者、年份和论文编号的核验。原则上,作者排除没有评分协议的原始数据集、没有任务分布的纯仿真器,以及单独的模型论文。
需要区分:论文所说的“经过网络核验”,主要指文献信息真实可查,不等于其中每一项能力和评测方式的分类都已得到正确验证。 后面的问题分析与此直接相关。
如图 8 所示涵盖所调研语料库的各项基准测试。图中展示目录中的代表性示例,按评估类别(而非具体实现形式)进行分组:闭环任务成功率评估、开环世界模型与视频生成评估,以及“预测-到-动作”的衔接机制。
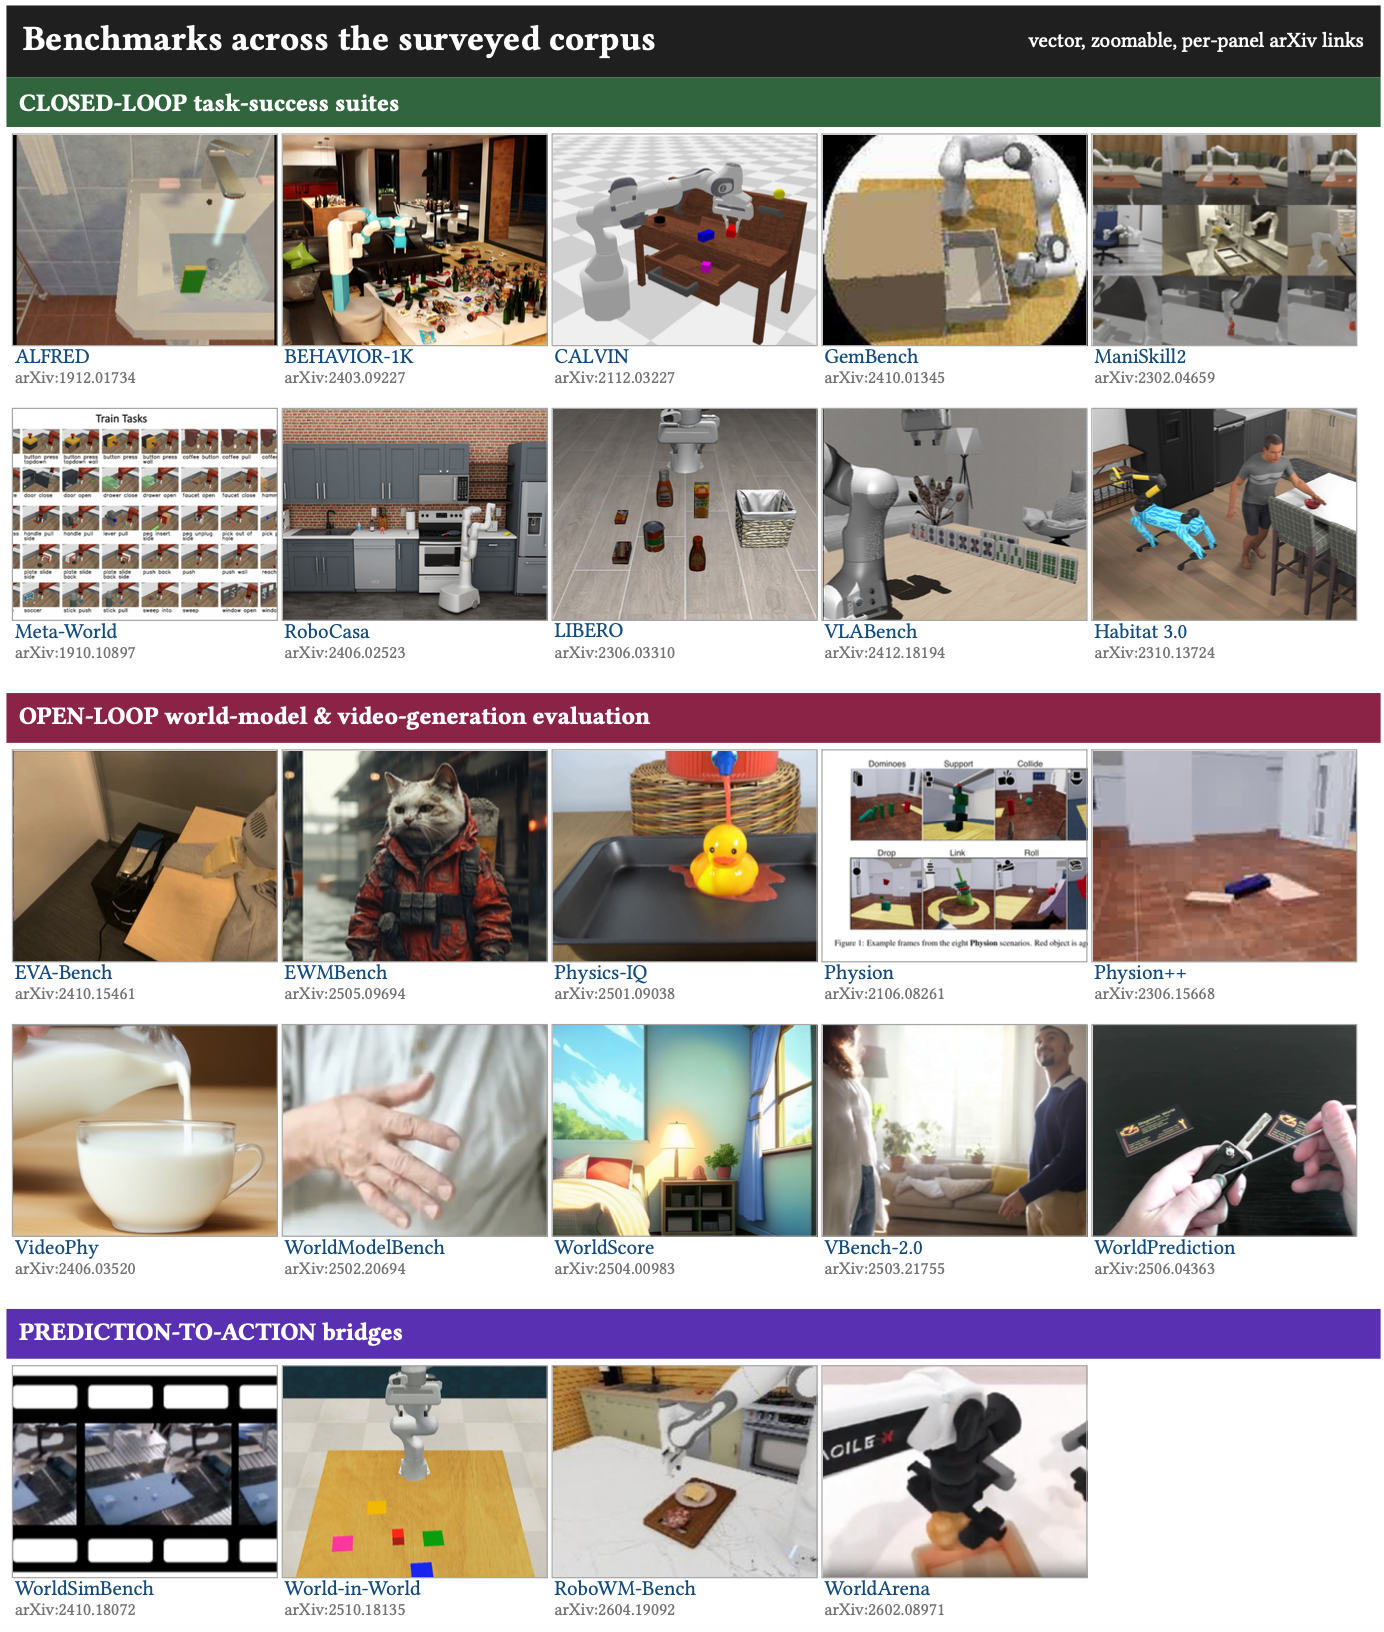
全文的主体,是把评测划分为四条路线。(第 3 节,表 3—6、表 10)
以下数量及归类均按论文原文呈现。
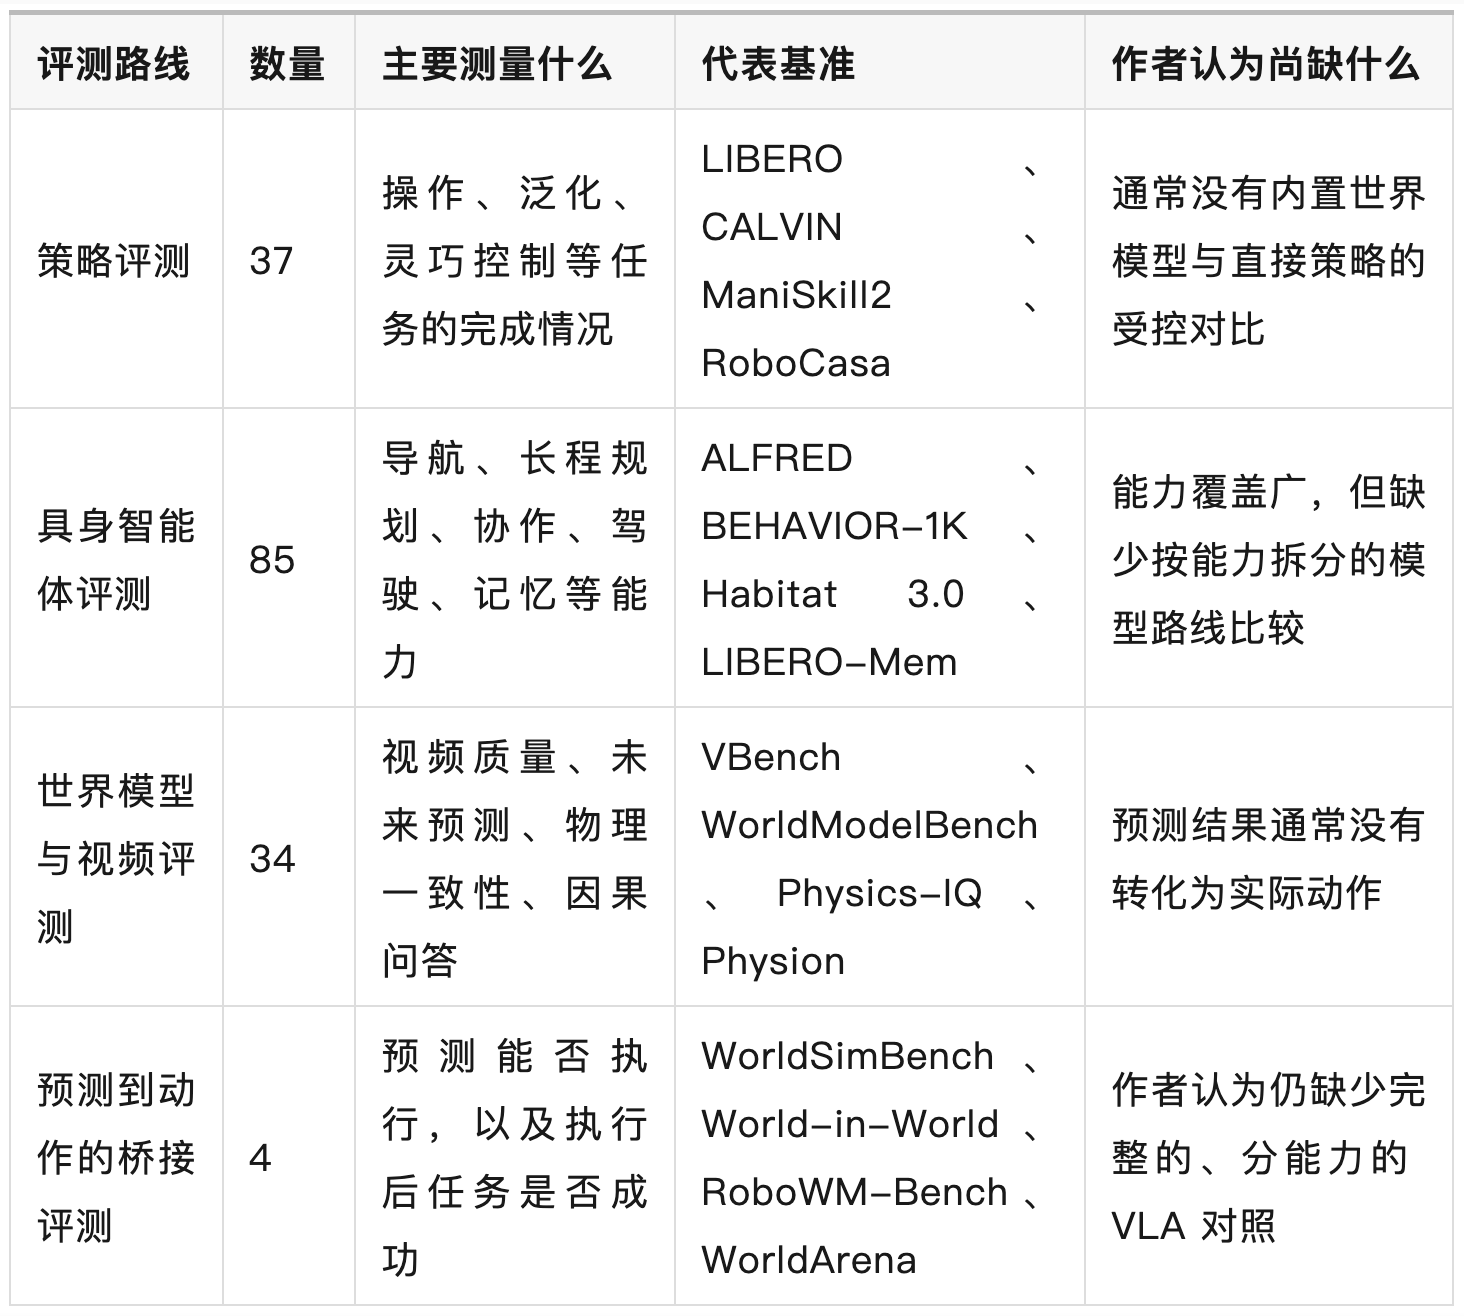
这四类中,最值得关注的是最后一类:它开始检查世界模型的实际用途。
例如,RoboWM-Bench 把生成的操作视频转换成动作序列,再在具有物理约束的仿真中检查可执行性;World-in-World 则通过统一的在线规划和动作接口,评价世界模型在闭环任务中的表现。这些工作已经说明,视觉质量与实际任务表现之间可能存在显著落差。
作者特别强调:谈论“世界模型”时,必须说明它预测什么、又被用来做什么。(第 4.1 节,表 7)
论文在“模型表示”层面区分三类:
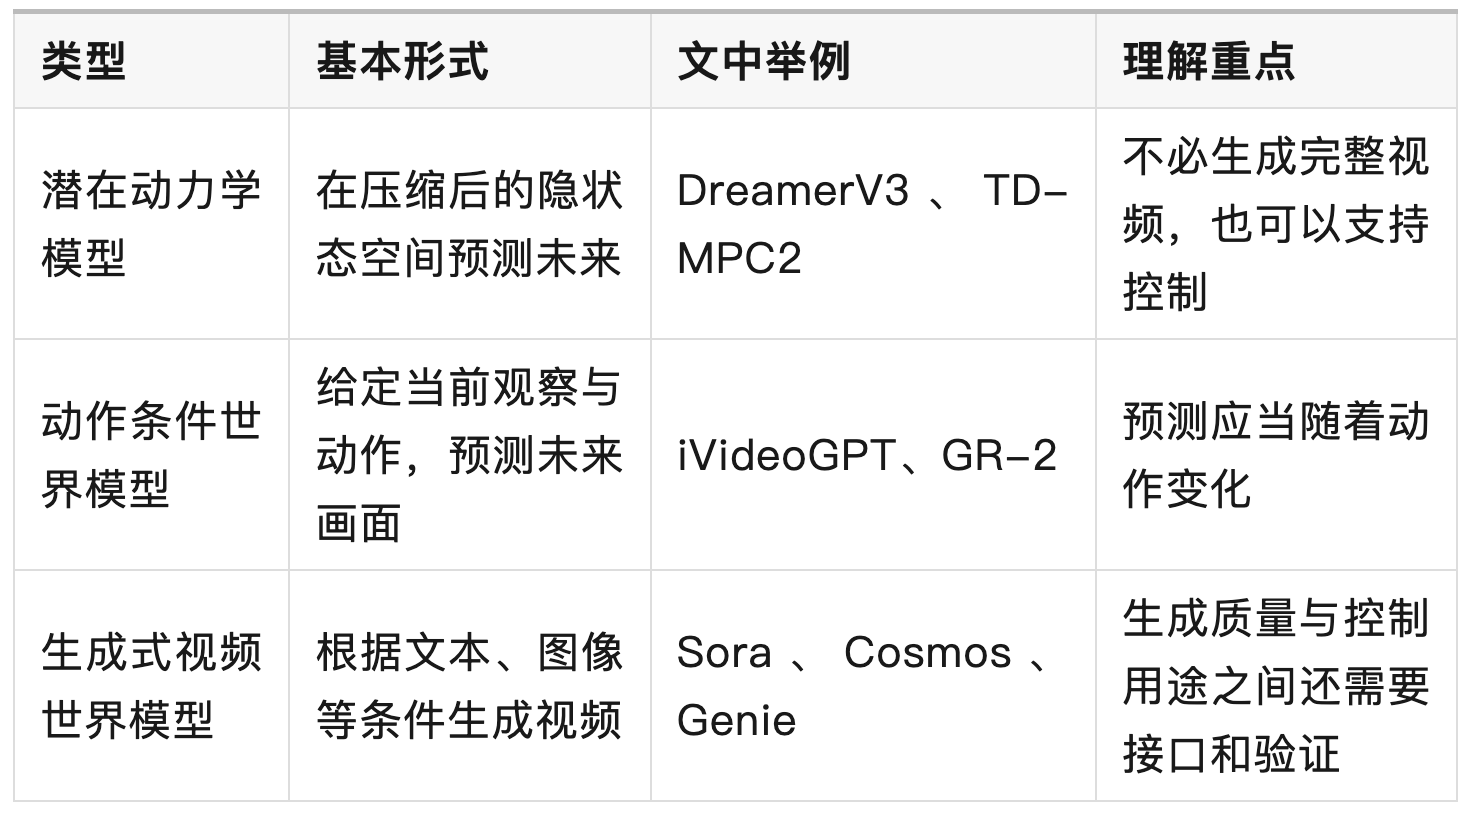
作者也承认这些类别存在交叉,尤其是动作条件生成模型。
在“使用角色”层面,世界模型又可能是:
用于训练或评估策略的神经仿真环境;
用于辅助决策的预测模块;
被基准直接评分的对象。
这一划分的意义是:“视频生成得好”“能模拟动作后果”“有助于训练策略”“能提升在线控制”是不同层次的能力,证据不能直接互相替代。
论文希望把平均成功率拆解成具体能力上的收益。(表 5,第 12—13 页)
作者尤其关注以下几类能力,因为它们可能更需要记忆、预测和推理:
隐藏状态与记忆:目标被遮挡后,是否还记得它的位置和状态;是否知道某个步骤已经完成。
反事实与因果推理:如果改变动作、物体属性或初始条件,后果会怎样。
长程与组合任务:当前动作对后续多个步骤是否有利,局部成功能否累积成整体成功。
社会与多智能体交互:是否能推断他人的目标,预测对方行为并调整自己的动作。
其合理之处在于:世界模型可能只在部分情境中带来明显收益。把简单抓取、遮挡记忆、长程规划混合成一个总分,容易掩盖这种差异。
但这里也埋下了论文的一个问题:记忆、状态估计、因果推断和未来预测彼此相关,却不能直接当作同一种能力。
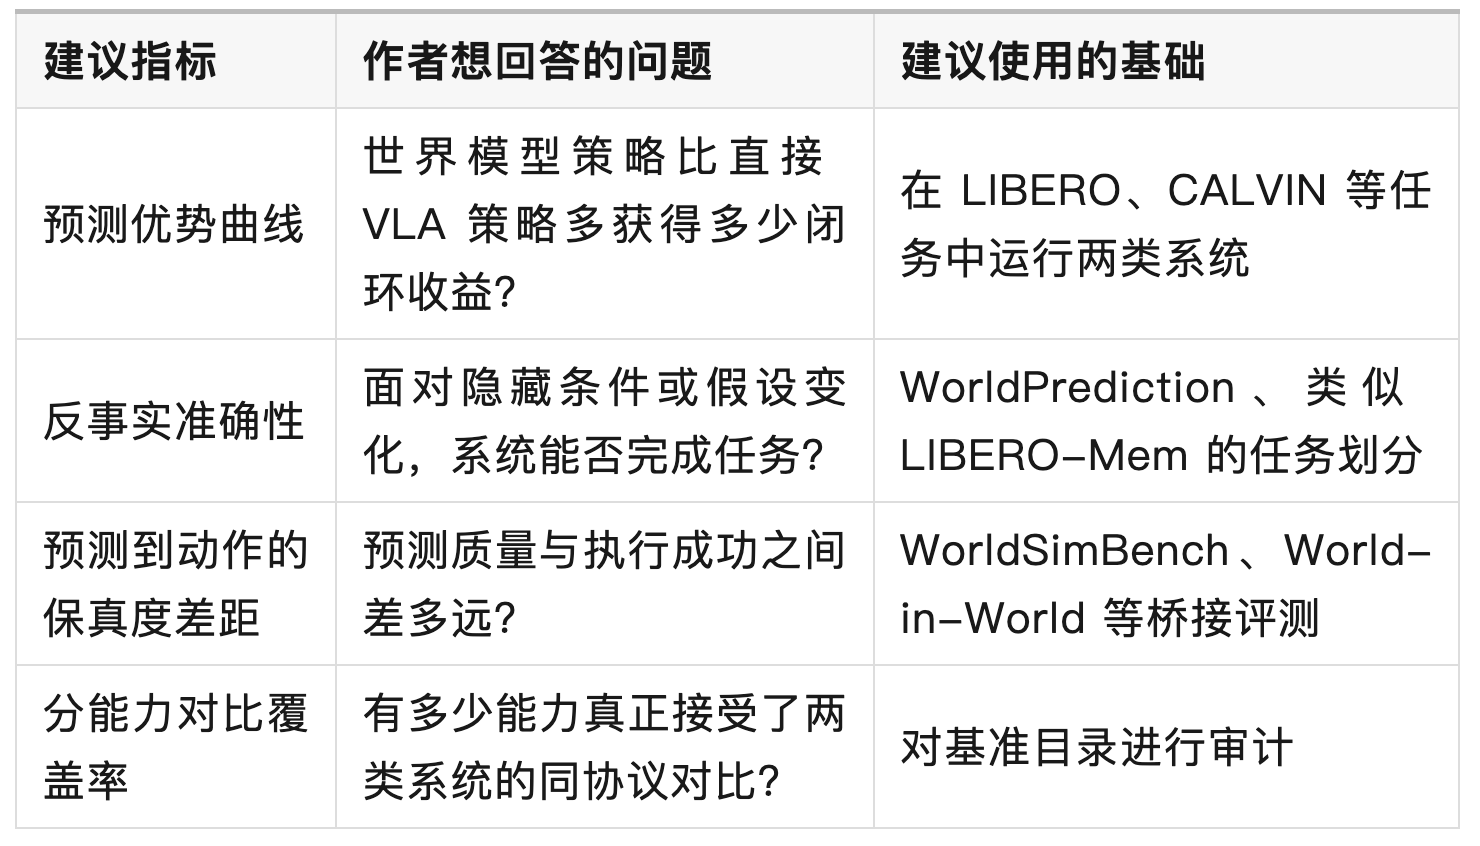
论文最终提出了四项评测量,但这些仍属于协议建议。(第 5 节,表 9、图 11)
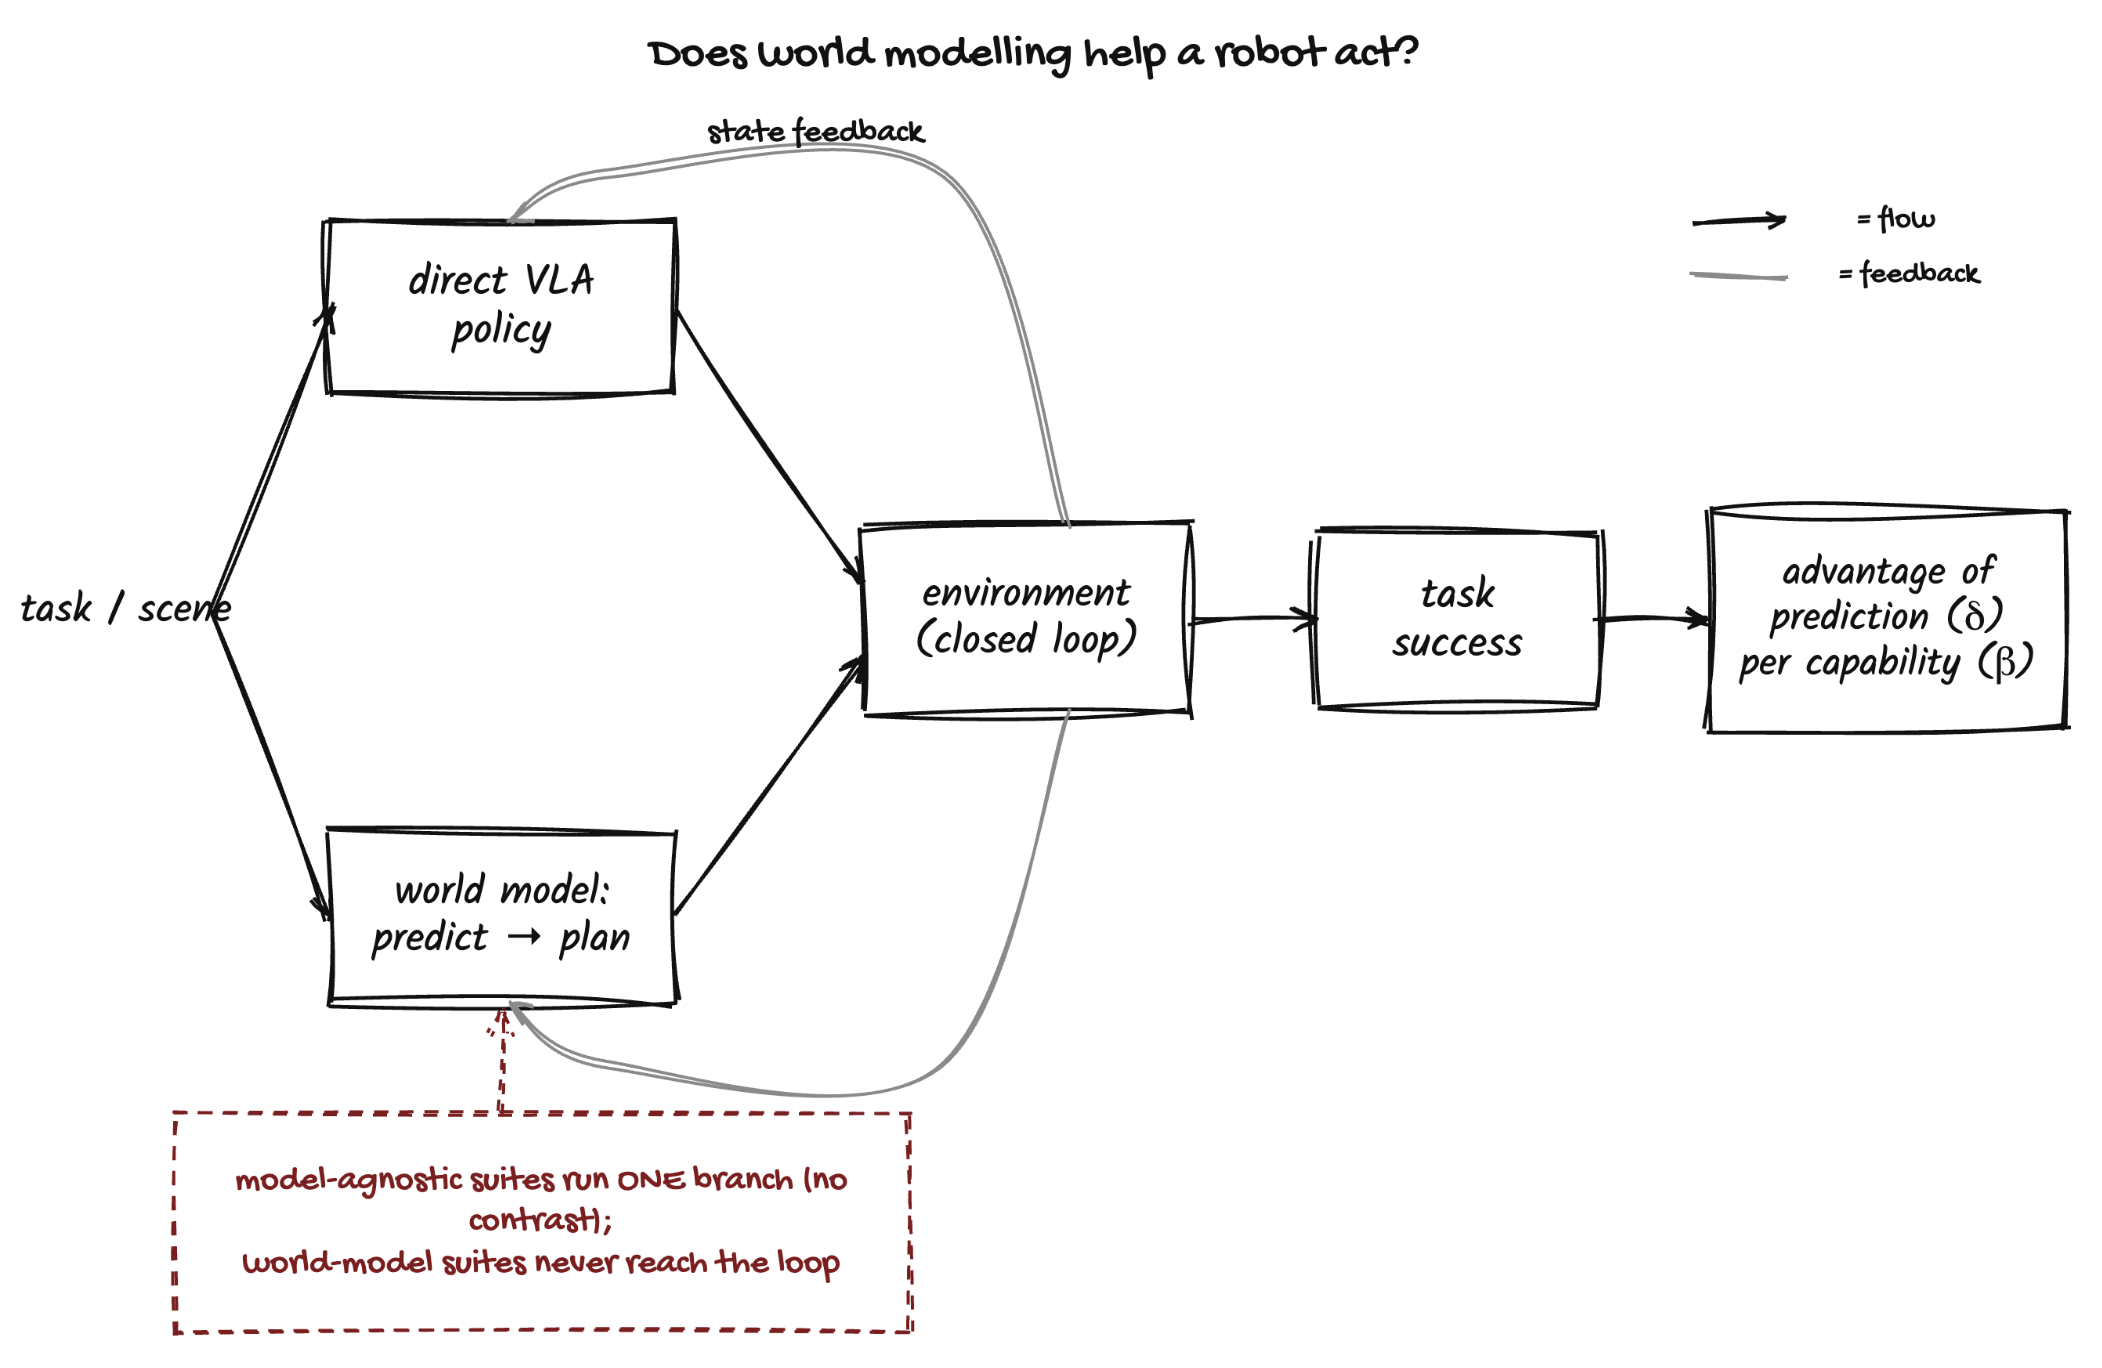
如图 10 所示一个旨在分离预测所带来优势的评估闭环。若要构建一个能够回答“世界模型是否有助于机器人行动”这一问题的基准测试,就必须在同一个闭环内运行“视觉-语言-动作(VLA)策略”与“世界模型策略(先预测后规划)”,并报告按能力维度(𝛽)细分的闭环增益(𝛿)。现有的评估套件通常会通过以下两种方式之一打破这一闭环:与模型无关的策略套件仅包含单一策略,无法进行对比;而世界模型套件则仅在开环状态下评估预测效果,而不实际执行动作。
第一项可以用一个简单表达式理解——这是对作者思想的形式化说明:
Delta_c = SuccessRate(世界模型策略, c) – SuccessRate(直接策略, c)
其中 c 代表某项能力或任务子集。
真正有价值的结果应当是“在遮挡任务上提高多少,在短程任务上是否没有收益,在某些情况下是否反而下降”,并附带波动和不确定性。
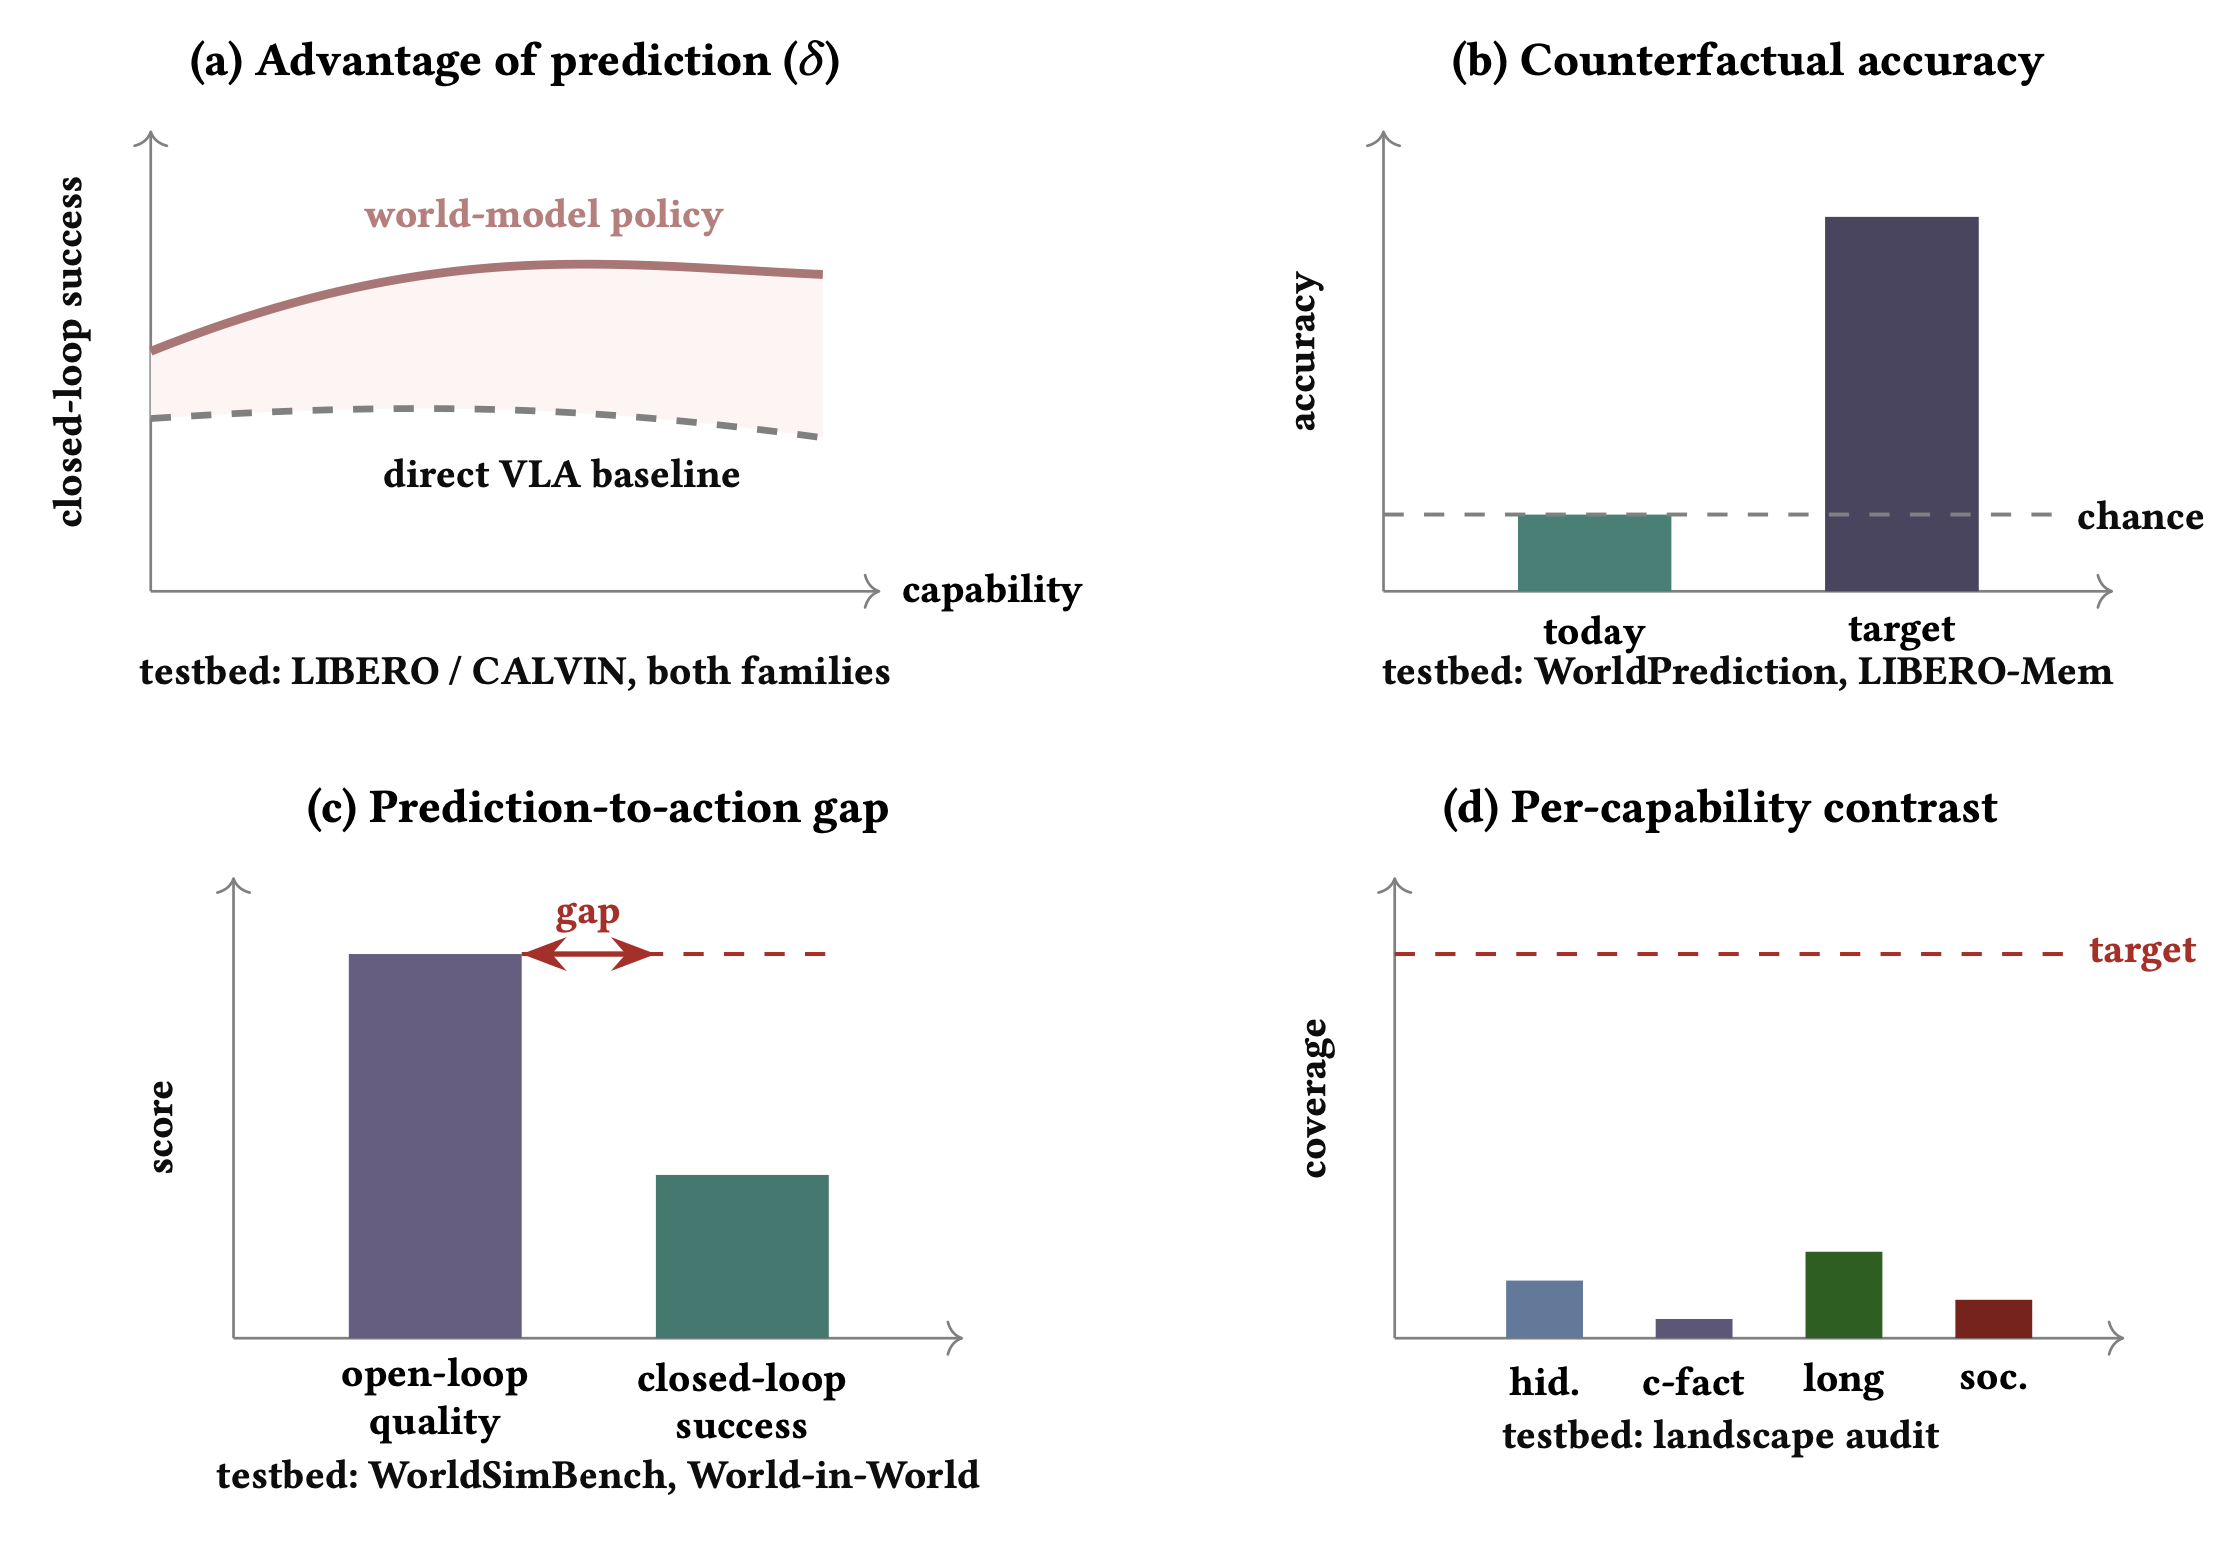
图 11 的评估协议是示意图,不是实验结果。 因而不能把图中世界模型高于 VLA 的曲线,或反事实准确率接近随机水平的柱状图,当作本文已经测得的事实。
这篇综述最值得记住的要点,可以归纳为五条。
逼真的预测不能替代行动效果验证。 物理合理性、动作可控性、可执行性和任务收益需要分别测量。
闭环成功率还需要一个合适的对照。 单独报告世界模型系统表现良好,无法说明预测模块贡献了多少。
世界模型的优势应按能力、任务难度和使用条件报告。 一个平均分不足以支持“世界模型普遍更好”。
桥接评测是值得发展的方向。 它把预测结果与环境反馈连接起来,使实际效用成为可测对象。
本文主要贡献是提出评测框架和研究议程。 它没有通过统一实验回答“哪类世界模型在什么条件下优于哪类 VLA”。
论文自身的问题如下。
作者承认的局限主要是覆盖与研究范围。(第 6 节,第 20 页)
作者明确表示:本文不提供模型排名;“明确对比”的判定依赖其操作性定义;文献覆盖偏向通过网络检索可获取的近期、英文、arXiv 工作;检索流程部分计数没有记录;提出的预测优势指标尚未得到充分验证。
这些说明是必要的,但不足以解释以下更实质的问题。
问题一:核心统计中的“明确 VLA—世界模型对比”存在分类错误。
摘要反复强调:160 个基准中,只有 11 个、约 7%,进行了明确对比。
我重新统计附录表 10 后发现:这 11 项中,8 项同时被论文标为开环评测,只有 3 项标为闭环。 开环项包括 ACRE、CoPhy、ComPhy、AGENT、BIB 等。
进一步核对原始论文:
CoPhy 比较的是反事实物理动力学预测及视频预测基线,主要评价改变初始条件后的预测结果。
ACRE 测试视觉系统的因果归纳能力,采用直接、间接、筛除和逆向阻断等问题,并非机器人策略的闭环对比。
LIBERO-Mem 的核心比较涉及对象记忆及不同 VLA 设计,其提出的方法本身被描述为具有结构化记忆的 VLA。记忆增强的策略不能未经论证就等同于本文定义的“预测后规划”的世界模型策略。
因此,问题不在于“11”加错了,而在于计数所依据的标签没有一致地落实作者自己的定义。目前不能把“11/160”理解成已经确认存在的 11 个严格闭环对照基准,也不能简单删掉 8 项就把剩下 3 项视为正确答案;剩余项仍需逐一审计。
问题二:开环与闭环的分类也有明确反例。
附录把 EgoPlan-Bench 标为闭环。但其原始协议是:给定历史视频、当前观察和任务目标,从候选动作计划中选择答案,按答题准确率评分。它不执行所选动作,再把环境变化反馈给模型。
按照本综述第 6 页的定义,这应属于离线评测,不能算闭环任务执行。
这意味着“113 个闭环、43 个开环、4 个桥接”的数量虽然与表格能对上,分类本身仍需要修正。由于这是全文的主要分类轴,影响比一般书目错误更大。
问题三:作者把“基准没有内置对比”推得过远。
论文多次将“模型无关”与“不能回答世界模型是否有用”联系起来,但二者之间没有必然关系。
一个架构中立的基准完全可以让研究者运行:
直接策略;
使用世界模型的策略;
去掉预测模块的消融版本。
只要协议与条件受到控制,就可以产生有价值的证据。基准最初的论文有没有运行这个对比,与后续研究能不能在该基准上运行,是两件事。
因此,统计基准原始论文中的对比缺失,不能充分支持“整个领域目前无法判断世界模型是否有益”这一结论。 要支持后者,还需要系统审查模型论文中的受控实验、消融实验和复用基准的结果。
问题四:“世界模型对直接策略”的二分法过于粗糙。
世界模型可以用于在线规划,也可以在训练阶段生成想象轨迹、改善策略学习;一个最终直接输出动作的系统,也可能在训练中受益于世界模型。
例如,DreamerV3 利用学习到的环境模型,通过想象未来情境来改善行为,本身就是世界模型支持策略学习的例子。
因此,应当至少区分:
训练时是否使用世界模型、执行时是否进行预测或规划、是否具有记忆,以及是否采用混合结构。
否则,对比很容易变成“两个完整系统谁更强”,却无法隔离世界模型的具体作用。
问题五:“匹配的基线”没有被落实为可执行的控制要求。
论文反复要求 matched baseline,但没有充分规定如何匹配:
训练数据与环境交互次数;
预训练资源和模型容量;
推理时间与规划计算量;
历史观察长度;
动作空间、控制频率与任务信息。
这些条件都会影响成功率。若世界模型系统获得更多历史信息或更多搜索计算,其提升不能全部归因于预测能力。
更有说服力的设计应同时提供:同等资源下的比较,以及尽可能保持其他组件一致的模块消融。 对机器人还应报告延迟、真实交互样本效率、失败恢复和安全相关表现,而不仅是最终成功率。
问题六:四项指标尚不够严谨,尤其是“保真度差距”。
作者把“开环生成质量与闭环成功率的差”作为一个指标,但二者通常不在同一尺度上。有的视频指标越低越好,成功率则越高越好;即便都归一化到相同范围,也不意味着可以直接相减并获得稳定含义。
更合理的做法是研究:
开环指标与闭环成功率之间的相关关系;
两种评测下模型排序是否一致;
哪些预测错误会导致任务失败;
在控制器固定时,预测质量变化带来多少行动收益。
另外,“反事实准确性”的定义混入了遮挡和记忆。记住被遮挡物体的位置,并不自动证明模型能回答“改变某个原因后会发生什么”。反事实评测需要更明确的干预变量、对照条件和结果判定。
问题七:检索可复现性不足,无法证明目录完整。
论文采用了类似 PRISMA 的流程图,但没有提供足够完整的检索截止日期、逐条检索记录、候选数量、全部排除原因,以及分类者之间的一致性和争议处理过程。
因此,160 是作者收集到的目录规模,不能直接当作领域的完整总体。“只有 4 个桥接基准”等结论,也应限定为作者当前目录与分类口径中的数量。
文中还声称,放宽对比判定阈值不会改变总体图景,但没有展示相应的敏感性分析。这个判断目前缺少验证。
问题八:示意图和表述有时超出了证据。
图 11 一方面明确标为示意图,另一方面又呈现世界模型应当优于直接策略、当前反事实准确率接近随机水平等方向性描述。这样的画法容易把研究假设呈现成已知结果。
一个中立的评测协议应当允许三种结果:世界模型有益、没有显著收益,或者在某些条件下造成退化。作者关于“反事实能力几乎未被测量”的表述也需要收窄,因为其目录本身已经列出多项反事实评测;更准确的说法是,反事实能力对闭环行动收益的贡献,缺少严格、统一的验证。
这些问题使本文更适合用于理解评测思路和寻找相关基准。若要把它作为研究立项或论文论证中的定量依据,最先需要补上的工作是:重新审计分类标签、检查已有模型论文的对照证据,并把“公平比较”落实为可复现的实验协议。


评论前必须登录!
注册