 网硕互联帮助中心
为什么要把本体和 LLM 放在一起
先说我遇到的实际问题。之前做一个设备运维知识库,让模型回答"XX型号泵的密封件更换周期是多少"。模型给出的答案里,把"密封件"和"轴承"的更换周期混在一起,还把两个不同型号的参数拼接成了一个。答案读起来很通顺,但事实是错的。
这类问题的根源不是模型不够大,而是模型没有"领域概念的边界"。它知道"密封件"这个词,但不知道在这个业务里,密封件属于哪个部件、和哪些型号关联、有哪些属性是必须的。
本体(Ontology)解决的正是这个问题。它用形式化的方式描述一个领域里的概念、属性和关系。W3C 体系下的 OWL(Web Ontology Language)和 RDF(Resource Description Framework)是目前最通用的标准。把本体引入 LLM 流程,本质上是给模型一套"词汇表和规则表"。
需要提前说明一点:本体不是万能药。它擅长的是结构化的概念约束和关系推理,不擅长处理模糊语义和自然语言理解。所以实践中的做法通常是"本体管骨架,LLM 管血肉"。
本体到底长什么样
如果用一句话概括:本体就是"类(Class)+ 属性(Property)+ 个体(Individual)+ 公理(Axiom)"。
举个设备运维的例子。用 Turtle 语法写一段最小的本体:
@prefix ex: <http://example.org/equipment#> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .
ex:Equipment a owl:Class .
ex:Pump a owl:Class ; rdfs:subClassOf ex:Equipment .
ex:Component a owl:Class .
ex:Seal a owl:Class ; rdfs:subClassOf ex:Component .
ex:Bearing a owl:Class ; rdfs:subClassOf ex:Component .
ex:hasComponent a owl:ObjectProperty ;
rdfs:domain ex:Equipment ;
rdfs:range ex:Component .
ex:replacementCycle a owl:DatatypeProperty ;
rdfs:domain ex:Component ;
rdfs:range xsd:integer .
ex:PumpA a ex:Pump .
ex:SealA a ex:Seal ;
ex:replacementCycle 180 .
这段本体表达了几件模型自己学不到的事:
- Seal 和 Bearing 都是 Component 的子类
- hasComponent 只能连接 Equipment 和 Component
- replacementCycle 的值必须是整数
当模型想输出"泵A的轴承更换周期是180天"时,如果本体里根本没有 PumpA hasComponent BearingA 这个三元组,那这个结论在推理上就是站不住的。这就是本体能给 LLM 提供的第一层价值:事实的可验证性。
三种把本体接进 LLM 的方式
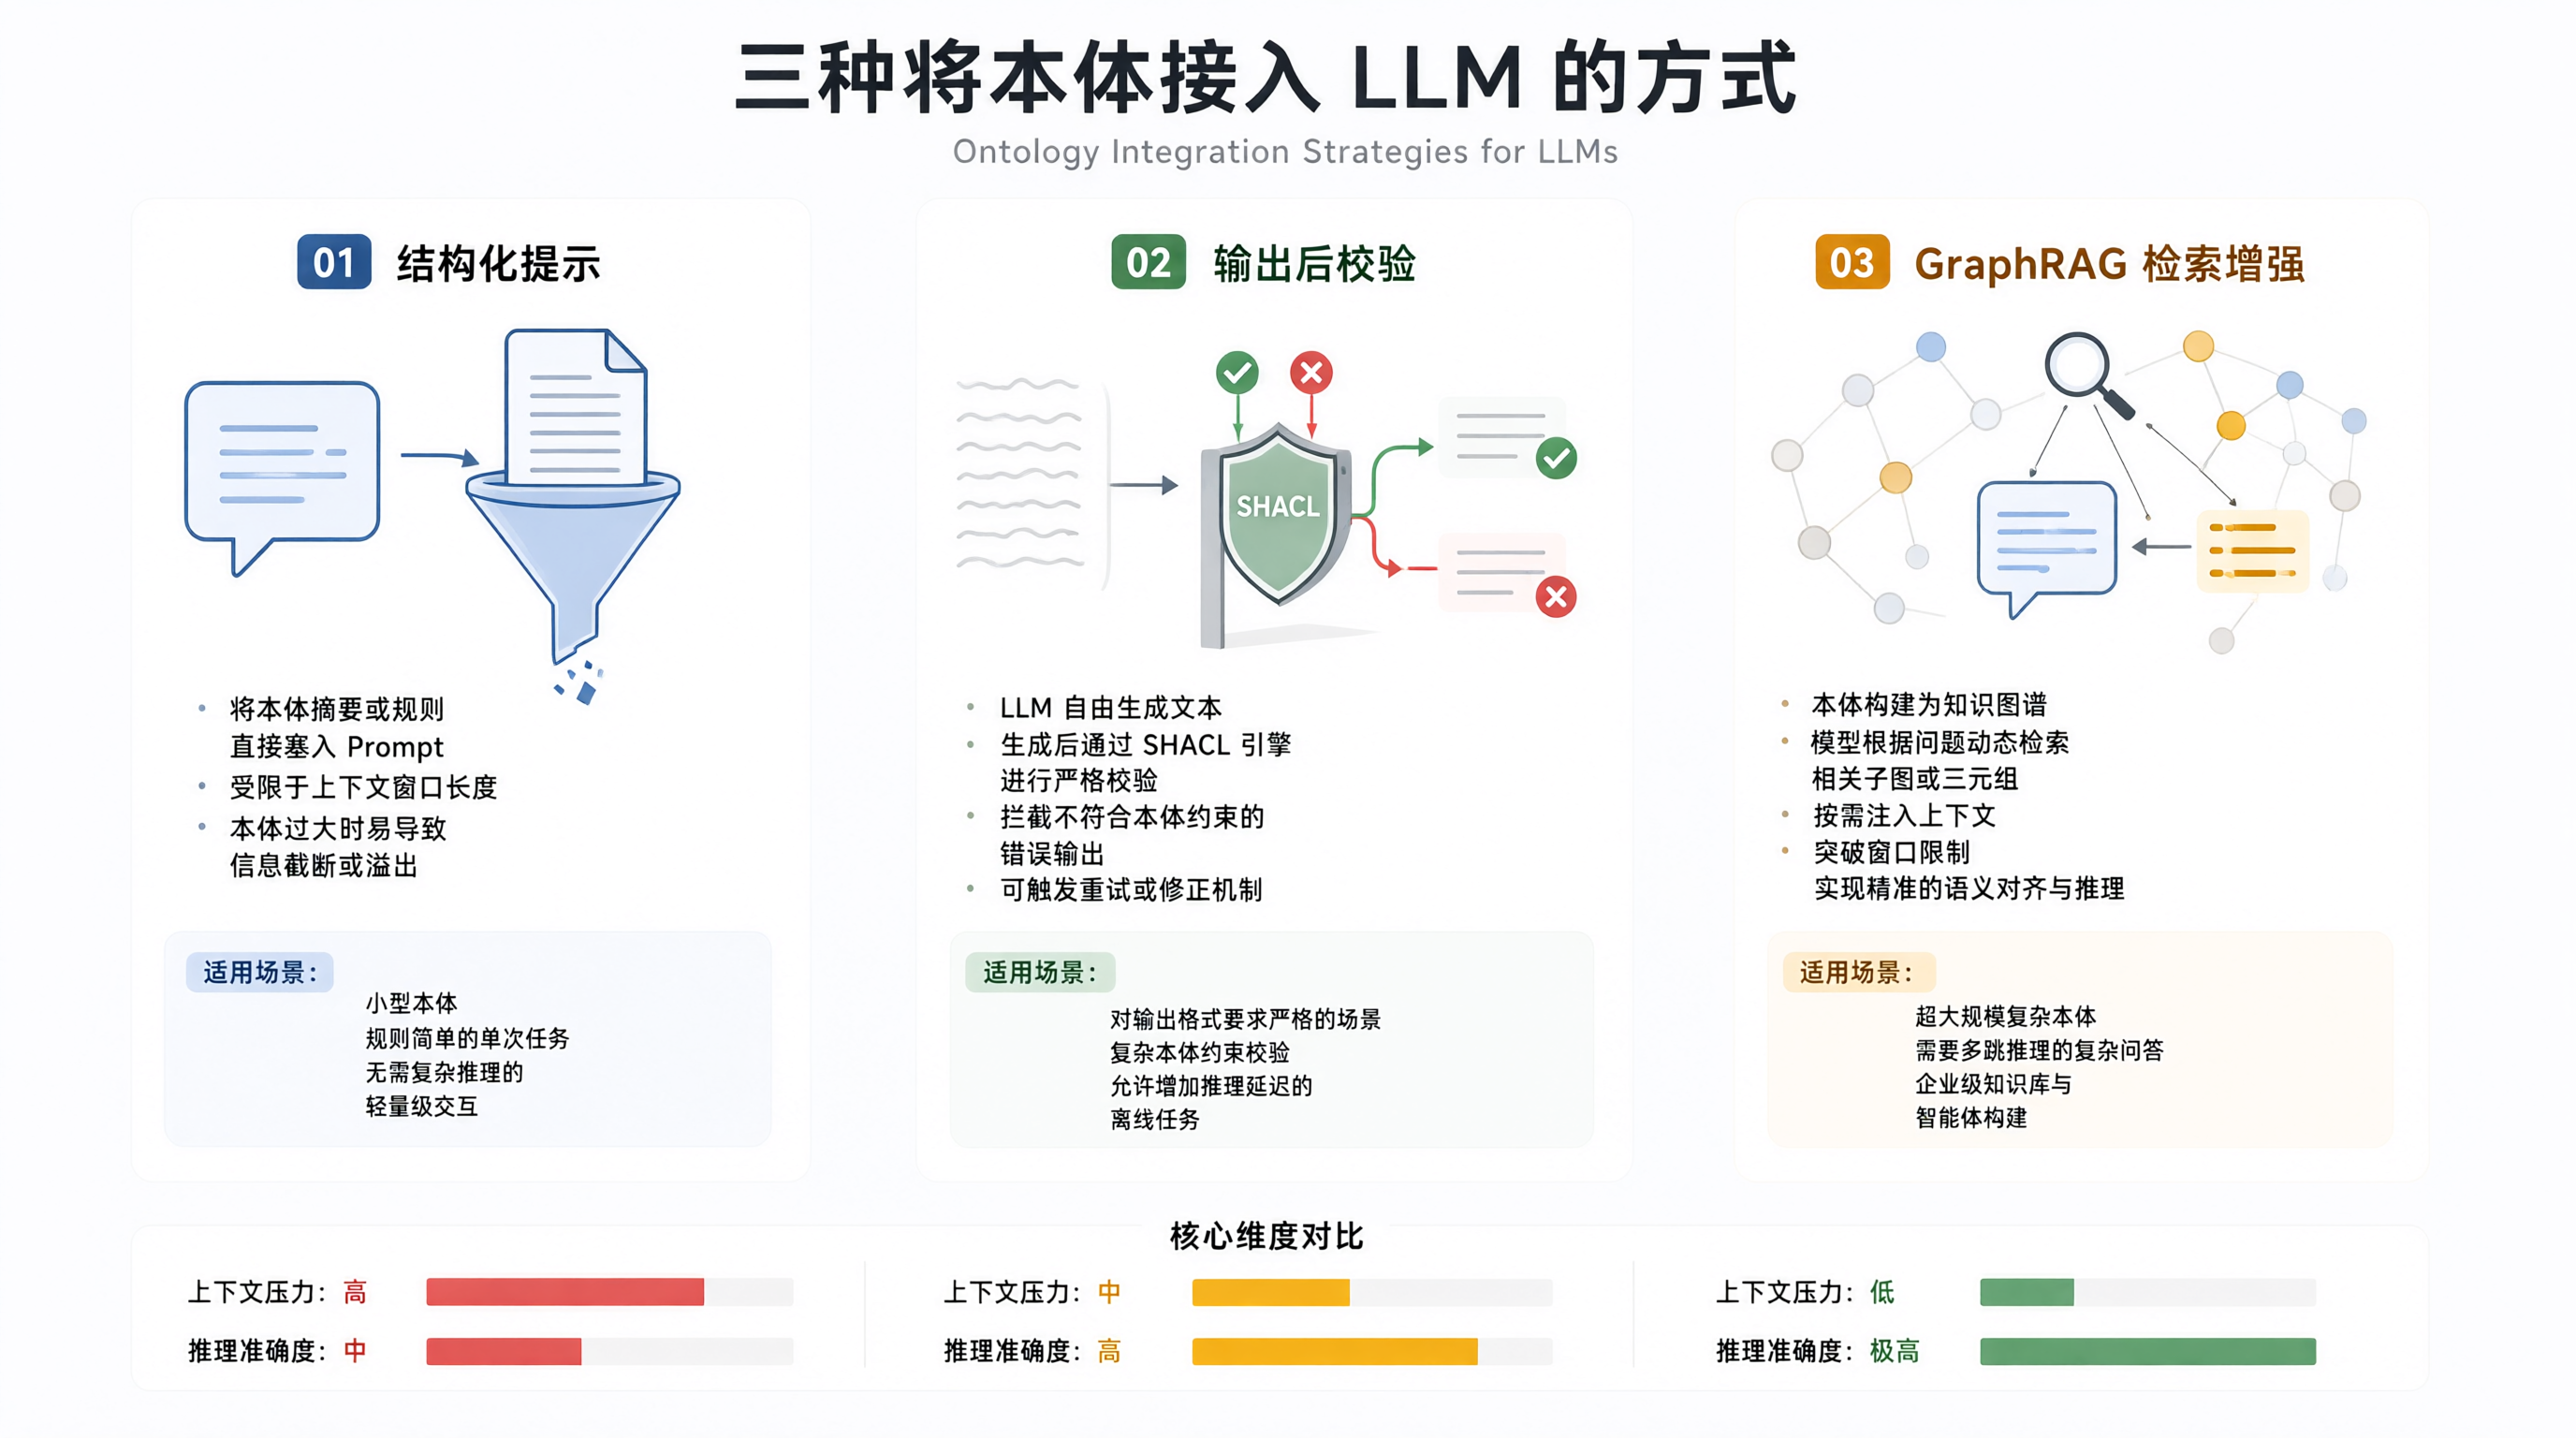
我在实际项目里试过三种做法,复杂度和效果差别很大。
| 结构化提示(Prompt 注入本体摘要) | 实现简单,无需额外服务 | 本体一大就塞不进上下文,模型仍可能违反约束 | 本体规模小(<200 个概念)、原型验证 |
| 输出后校验(生成后跑 SHACL/推理机) | 能拦截错误,可作为兜底 | 只做事后检查,不改善生成质量 | 与结构化提示组合使用 |
| GraphRAG(本体作为检索图谱) | 检索阶段就用本体约束,效果稳定 | 需要图数据库和额外工程 | 本体规模大、关系复杂的生产环境 |
下面分别说一下。
方式一:结构化提示
最直接的做法是把本体里相关的部分序列化成文本,塞进 system prompt。比如查询"泵A的密封件更换周期",先把 PumpA 相关的三元组提取出来:
from rdflib import Graph, Namespace
EX = Namespace("http://example.org/equipment#")
g = Graph()
g.parse("equipment.ttl", format="turtle")
def get_context(entity_uri: str, max_triples: int = 30) –> str:
query = f"""
SELECT ?p ?o WHERE {{
<{entity_uri}> ?p ?o .
}} LIMIT {max_triples}
"""
rows = []
for p, o in g.query(query):
rows.append(f"<{entity_uri}> {p.n3(g.namespace_manager)} {o.n3(g.namespace_manager)} .")
return "\\n".join(rows)
context = get_context(str(EX.PumpA))
print(context)
然后拼进提示词:
prompt = f"""你是一个设备运维助手。请严格依据下面的事实回答问题,
不要引入事实之外的任何参数或关系。如果事实不足以回答,直接说"信息不足"。
【已知事实】
{context}
【问题】泵A的密封件更换周期是多少?
"""
这个做法的关键在最后一句约束。不写"不要引入事实之外的内容",模型几乎一定会补充。我测试下来的经验是:约束越具体,效果越明显。写"不要编造"没用,写"如果事实不足以回答,直接说信息不足"就有用,因为后者给了模型一个明确的替代动作。
【踩坑提醒】把整个本体丢进 prompt 是很常见的误区。本体一旦超过几百个三元组,模型会开始忽略其中一部分。所以这里的 get_context 只取和当前实体直接相关的三元组,而不是全图。
方式二:输出后校验
结构化提示不能保证 100% 合规,所以需要一层事后校验。SHACL(Shapes Constraint Language)是 W3C 推荐的校验语言,Python 里用 pyshacl 库。
先定义约束形状:
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix ex: <http://example.org/equipment#> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .
ex:ComponentShape a sh:NodeShape ;
sh:targetClass ex:Component ;
sh:property [
sh:path ex:replacementCycle ;
sh:datatype xsd:integer ;
sh:minCount 1 ;
] .
然后校验模型输出的 RDF:
from pyshacl import validate
from rdflib import Graph
data_graph = Graph()
data_graph.parse(data=model_output_ttl, format="turtle")
shapes_graph = Graph()
shapes_graph.parse("shapes.ttl", format="turtle")
conforms, results_graph, results_text = validate(
data_graph,
shacl_graph=shapes_graph,
inference="rdfs",
)
print(conforms)
print(results_text)
inference="rdfs" 这个参数会让校验器先做一次 RDFS 推理再校验,这在本体有子类关系时很重要。比如 SealA 被声明为 Seal,而 Seal 是 Component 的子类,只有开启推理,ComponentShape 才能正确作用到 SealA 上。
【注意】pyshacl 的 inference 支持 "none"、"rdfs"、"owlrl" 三个值。owlrl 推理能力更强但速度明显更慢,本体规模大时慎用。这一点我建议你根据自己本体里用到的 OWL 构造子来选,我没有做过完整的性能基准测试。
方式三:GraphRAG
前两种方式本质上是把本体当"参考资料"。真正让本体发挥作用的做法,是把它做成检索层——也就是常说的 GraphRAG。
思路是:用户提问 → 先从问题中抽取实体 → 在图谱里做子图检索 → 把子图作为上下文喂给 LLM。这样检索阶段就已经被本体约束住了,模型拿到的永远是"本体里真实存在的关系"。
实体抽取这一步可以用 LLM 完成,也可以用 spaCy 之类的 NER 模型。用 LLM 的话大致是这样:
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
extract_prompt = ChatPromptTemplate.from_messages([
("system", "从用户问题中抽取设备实体,只输出实体名称,用逗号分隔。"
"可识别的实体类型:Pump、Seal、Bearing。无法识别时输出空字符串。"),
("human", "{question}"),
])
chain = extract_prompt | llm
result = chain.invoke({"question": "泵A的密封件更换周期是多少"})
print(result.content) # 期望得到类似 "泵A, 密封件"
拿到实体名称后,映射到本体的 URI,再做子图查询:
def subgraph_query(entity_uris: list[str], depth: int = 2) –> str:
values = " ".join(f"<{u}>" for u in entity_uris)
sparql = f"""
CONSTRUCT {{
?s ?p ?o .
}}
WHERE {{
VALUES ?start {{ {values} }}
?start (!<http://example.org/equipment#hasComponent>)* ?s .
?s ?p ?o .
}}
"""
result_graph = g.query(sparql)
return result_graph.serialize(format="turtle")
这段 SPARQL 里的 (!<…hasComponent>)* 是属性路径语法,表示"沿 hasComponent 走 0 到 N 步"。用 ! 是因为 Turtle 里直接写 IRI 在属性路径中需要装饰,具体语法建议你对照 SPARQL 1.1 规范确认,不同实现(rdflib、Jena、Virtuoso)在这个细节上表现不完全一致。
我不建议在 Python 里用 rdflib 做生产级的图查询。rdflib 是纯内存实现,几万三元组还行,上百万就吃力了。生产环境一般换成 Neo4j、NebulaGraph 或 Oxigraph 这类专门的图存储,SPARQL 或 Cypher 走它们的原生引擎。
本体从哪来
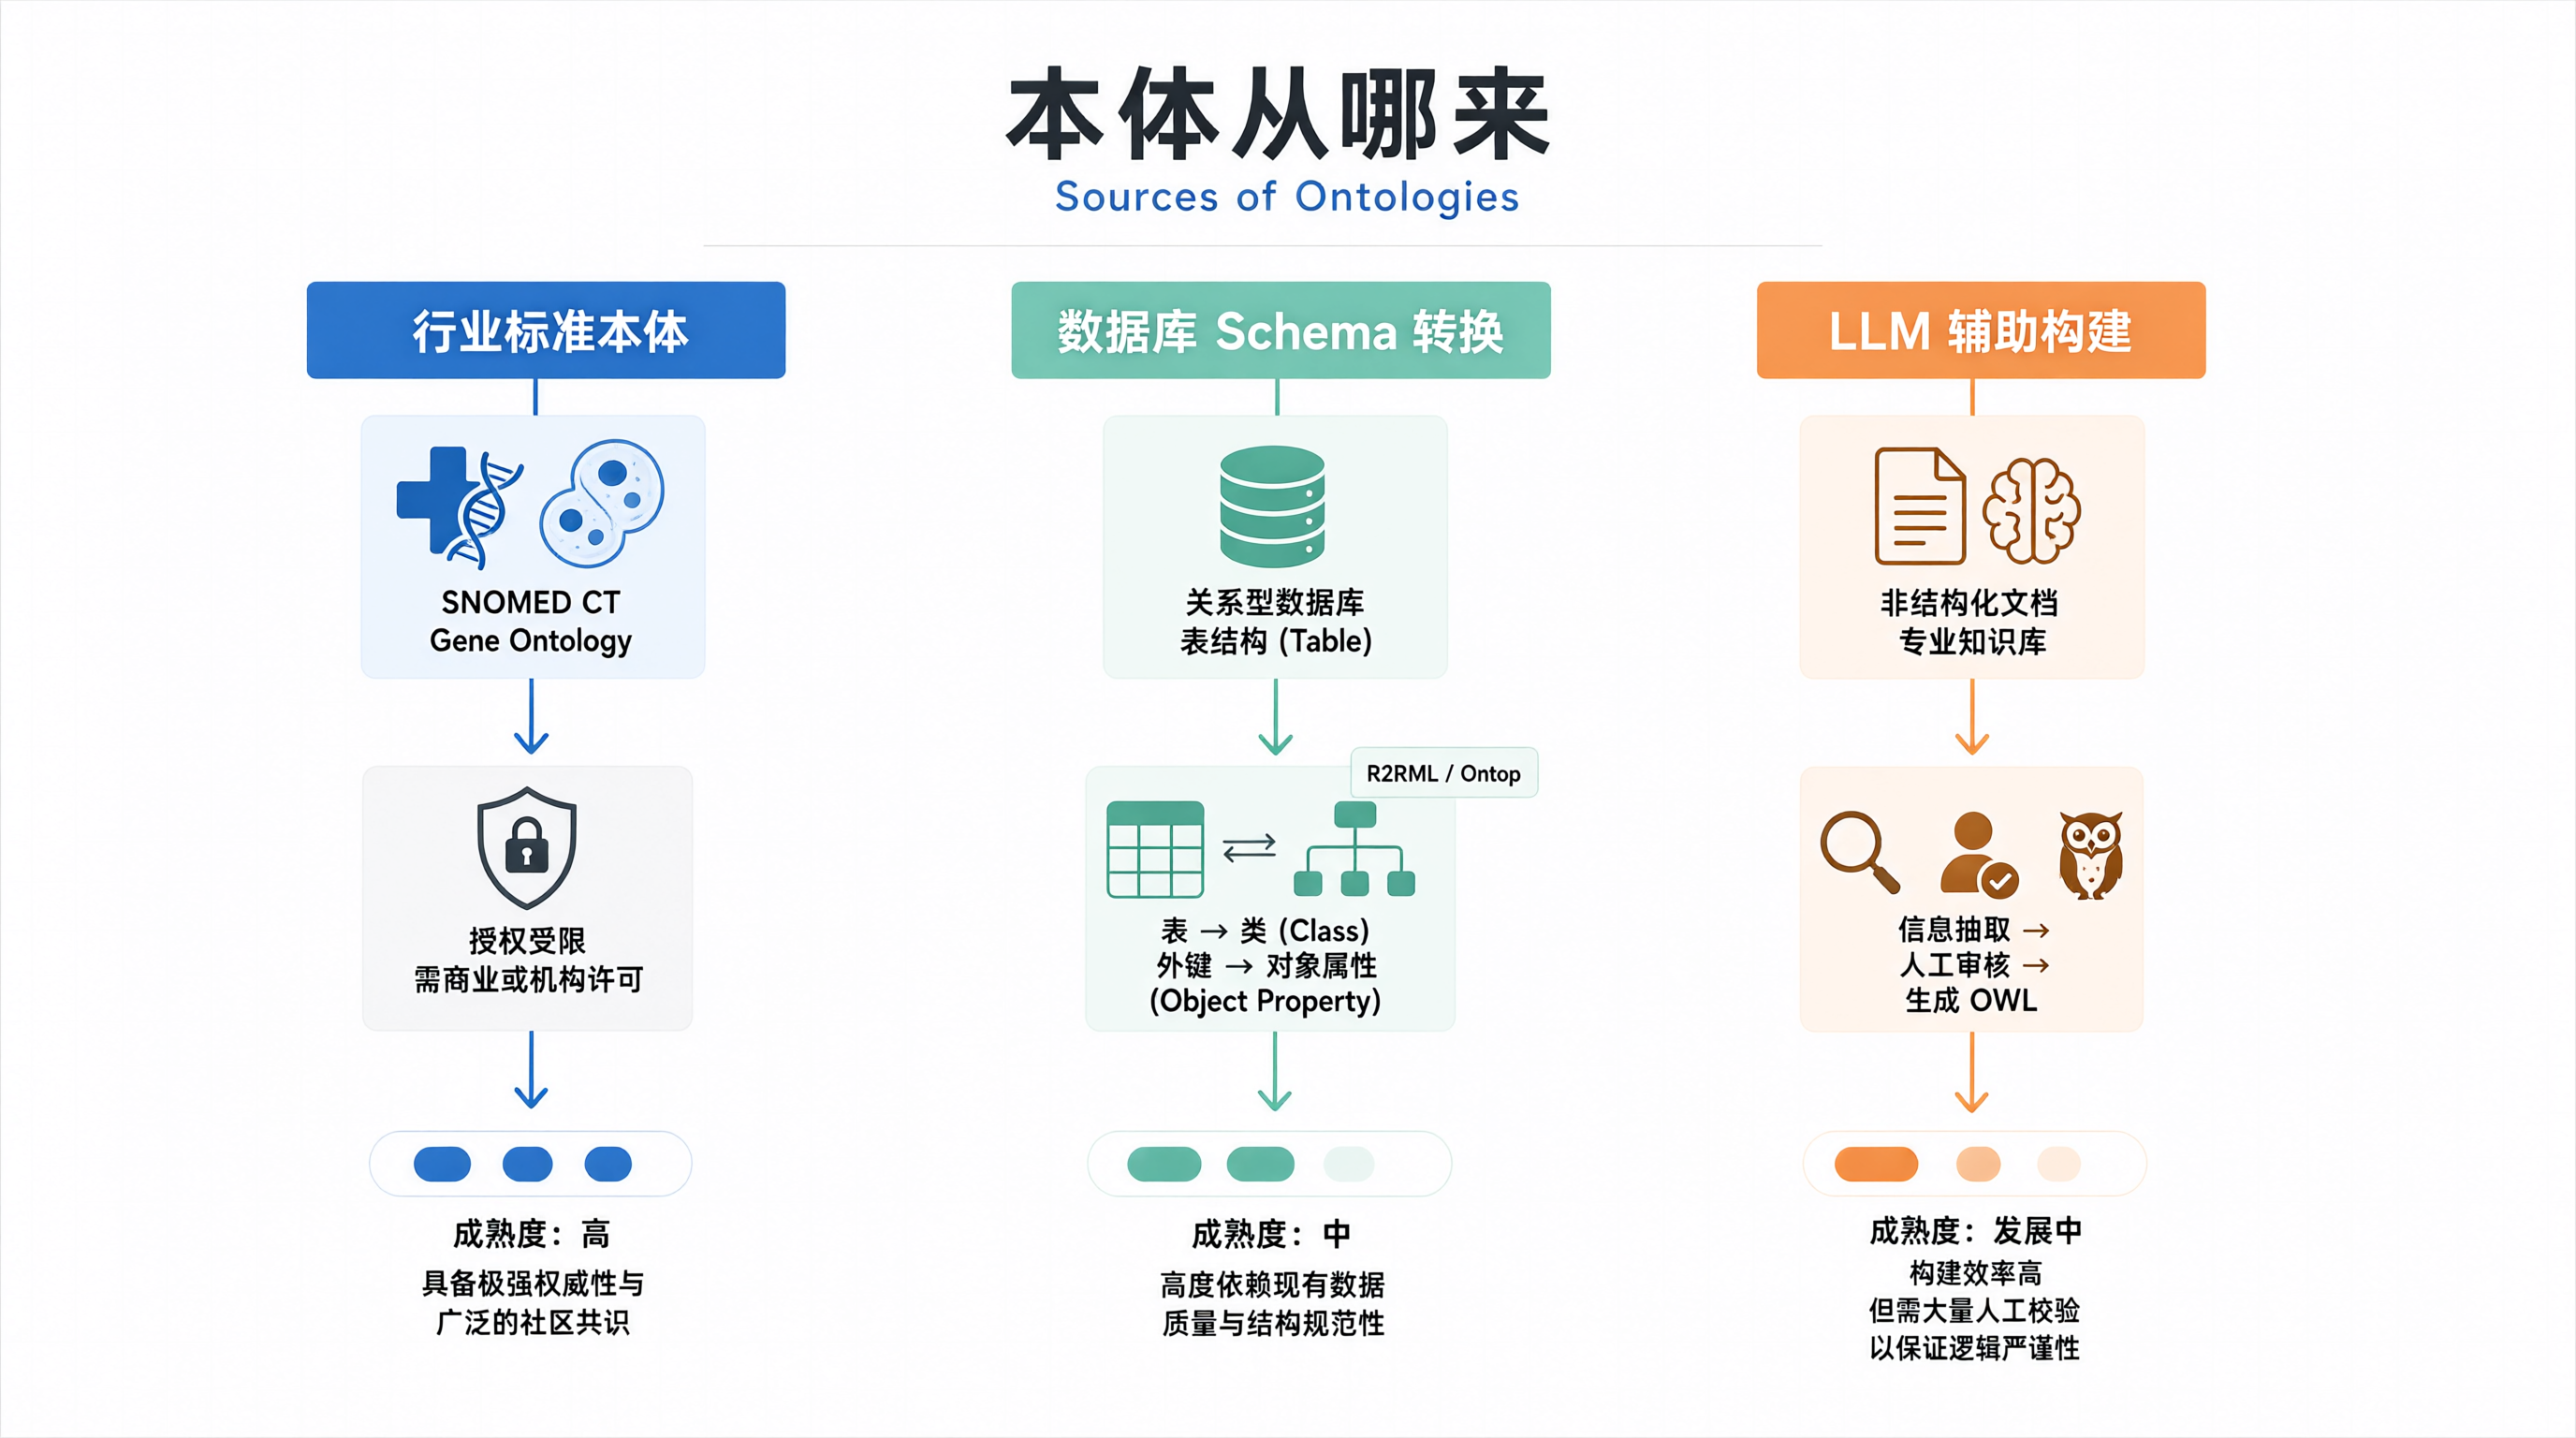
前面讲的都是"有了本体怎么用"。更现实的问题是:本体从哪来?
三个来源:
对我个人来说,最务实的起点是第二条:从现有数据库 Schema 出发,先建一个"够用"的本体,随着业务问题暴露再逐步补充。不要一上来就想着建一个"完备的领域本体",那是个无底洞。
一个容易忽视的取舍:本体规模
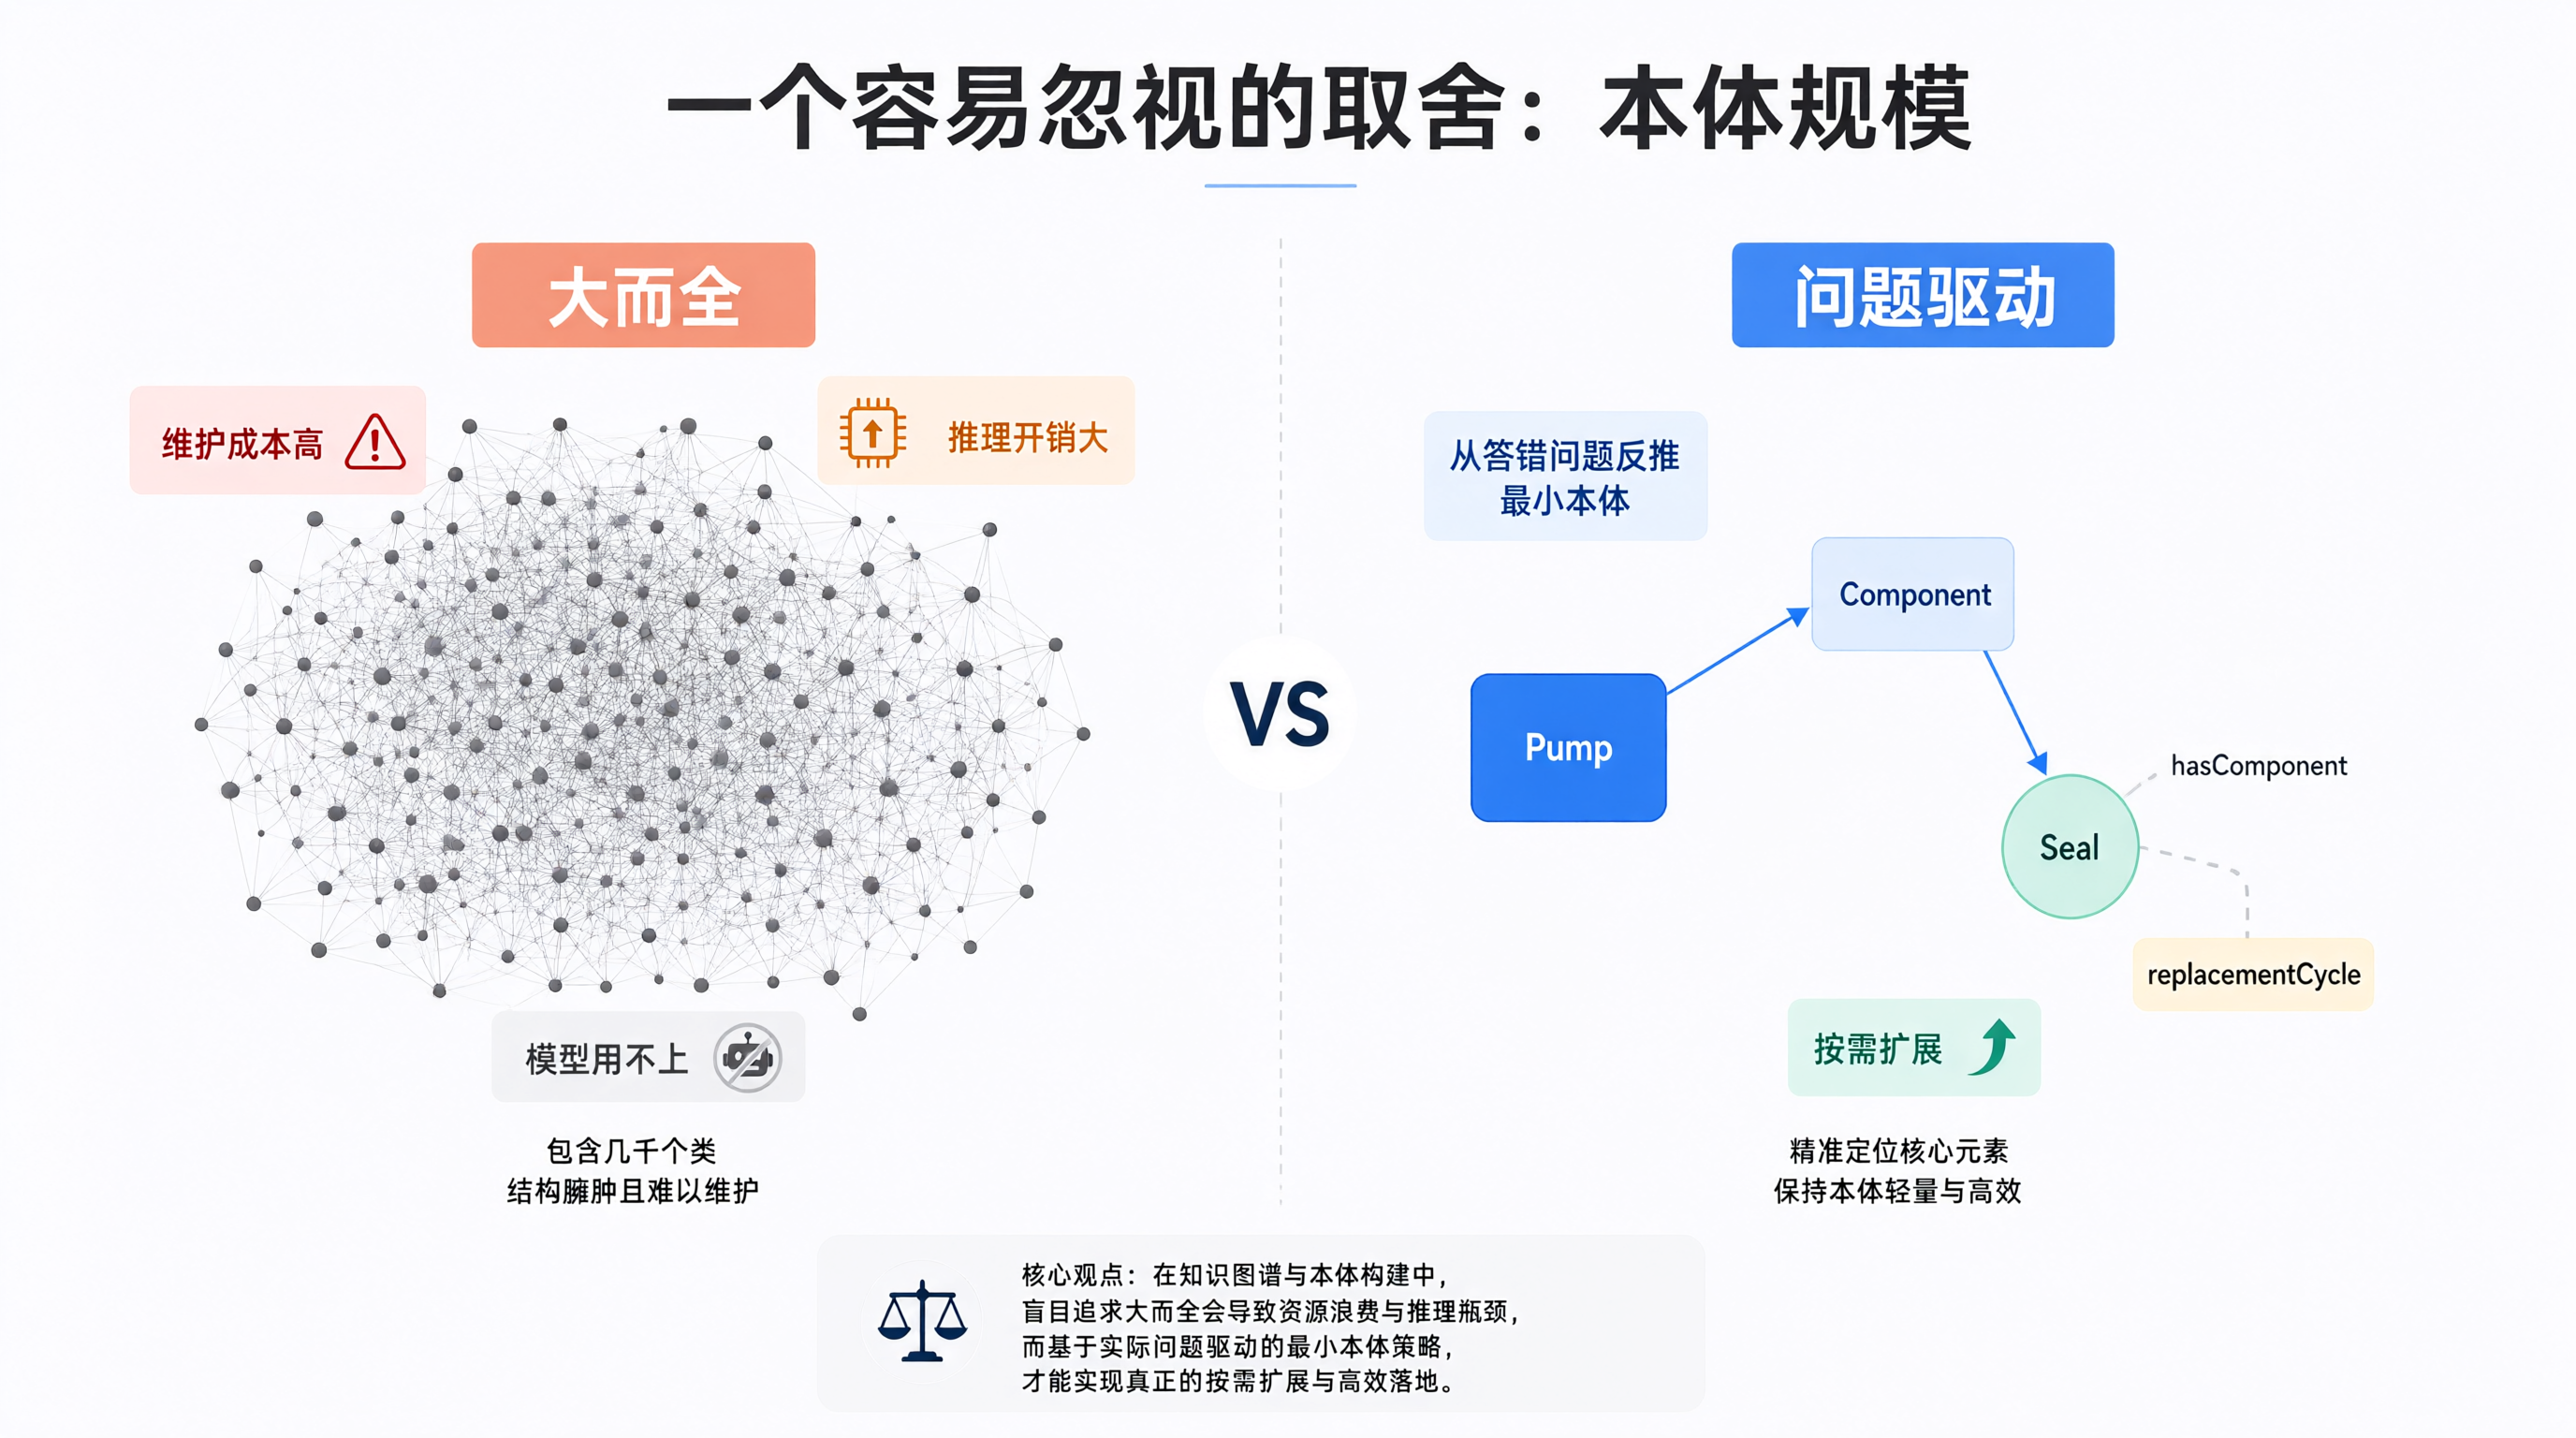
本体越细,约束越强,但维护成本和推理开销也越大。我见过一些团队花几个月建了几千个类的本体,结果模型用不上,业务也没受益。
我的建议是按问题驱动建本体。先列出模型答错的典型问题,反推需要哪些概念和关系来约束,只建这些。比如前面那个"泵A的密封件更换周期"的问题,需要的最小本体就是 Pump、Component、Seal、hasComponent、replacementCycle 这五个元素。等新问题出现再扩。
这样做的另一个好处是:本体规模小的时候,方式一(结构化提示)就能解决大部分问题,不需要一上来就上 GraphRAG 这套重工程。
效果怎么衡量
引入本体之后,怎么知道真的有效?
我一般看三个指标:
- 事实准确率:答案中的每个三元组能否在本体中查到。这个可以直接用 SPARQL 验证,是硬指标。
- 约束违反率:SHACL 校验失败的输出占比。这个指标反映的是生成阶段的质量。
- 拒答率:模型回答"信息不足"的比例。这个指标不是越低越好——太低说明模型在编,太高说明本体覆盖不够。
这三个指标要一起看。只看准确率容易鼓励模型少回答,只看拒答率容易鼓励模型多编造。
一点个人判断
本体 + LLM 这条路,我的看法是:它解决的是"可信度"问题,不是"能力"问题。
模型本身的知识和推理能力,本体替代不了。但模型在垂直领域最让人不放心的恰恰是可信度——它会自信地给出错误答案。本体提供的是一套外部的事实锚点和约束规则,让错误答案有机会被拦下来。
如果业务场景对事实准确性要求不高(比如写作辅助、创意生成),那本体的投入产出比很低。如果场景是医疗、金融、工业运维这类错一个字都麻烦的领域,那这套东西值得认真做。
还有一个方向我没深入验证,但觉得有意思:用本体做 Agent 的"行动空间约束"。也就是 Agent 在规划步骤时,每一步操作都必须对应本体里定义的一个合法 Action,非法操作在规划阶段就被排除。这个思路在理论上很干净,但实际落地会遇到"Action 粒度怎么定"的问题,我目前还没有可分享的实践结果。
如果你正在做类似的落地,欢迎交流具体场景,特别是本体构建那一段——那是最花时间也最没有标准答案的部分。


评论前必须登录!
注册