 网硕互联帮助中心
很多开发者在搭建高性能计算节点或关键业务服务器时,往往把大量精力投入到 CPU 选型、磁盘阵列配置以及网络拓扑优化上,却容易忽视一个看似不起眼但至关重要的组件——内存。在日常高负载运行中,宇宙射线、电磁干扰甚至芯片自身的物理老化,都可能导致内存中的某个比特位发生翻转,即从 0 变成 1 或反之。对于普通家用电脑,这种极小概率事件可能仅仅导致程序偶尔崩溃或蓝屏,重启即可恢复;但在需要 7×24 小时不间断运行的数据库、金融交易系统或科学计算集群中,一个比特的错误就可能导致数据静默损坏,进而引发灾难性的后果。
📋 文章摘要
- 核心价值:本文深入解析 ECC(纠错码)内存的工作原理与实战配置,帮助读者从硬件选购、BIOS 设置到系统验证,全方位确保服务器内存的数据完整性,避免因内存静默错误导致的数据损坏与业务中断。
- 目标读者:系统管理员、运维工程师、IT 架构师以及对服务器稳定性有高要求的开发者,尤其适合正在搭建或维护数据库、金融交易、科学计算等关键业务环境的团队。
- 你将学会:
- 理解 ECC 内存如何通过硬件容错机制自动检测并修正单比特错误。
- 掌握从 CPU、主板到内存条的完整硬件兼容性检查方法。
- 一步步在 BIOS 中开启 ECC 功能,并在 Linux/Windows 系统层面验证其生效。
- 使用 Memtest86 进行压力测试,并解读纠错计数与错误报告。
- 通过模拟位翻转实验观察纠错日志,并掌握日常维护与故障预警方法。
这就是为什么在企业级环境中,ECC(Error Correction Code,纠错码)内存成为了标配。它不仅仅是一根带有额外芯片的内存条,更是一套完整的硬件容错机制。然而,拥有了 ECC 内存并不代表就能自动获得保护,从硬件选购、BIOS 设置到系统层面的验证,每一个环节都需要精确配置才能生效。不少用户在购买了昂贵的 ECC 内存后,发现系统并未真正开启纠错功能,或者在遇到报错时束手无策。本文将深入拆解 ECC 内存的工作原理,通过实操步骤引导你完成从硬件兼容性检查到故障模拟的全过程,确保你的基础设施建立在坚实可靠的数据完整性基础之上。
① ECC 内存核心概念与生活化类比
要理解 ECC 内存,我们首先得明白普通内存(Non-ECC)是如何工作的。普通内存在存储数据时,就像是一个只有“记录员”的仓库,数据写进去是什么,读出来就是什么,它没有能力判断读出来的数据是否和写进去的一致。如果因为外界干扰导致某个数据位发生了翻转,系统会毫无察觉地使用这个错误数据,这就是所谓的“静默数据损坏”。
ECC 内存则不同,它在每个数据字旁边额外增加了一些校验位。我们可以把它想象成一个配有“复核员”的仓库。每当写入一组数据时,复核员会根据特定的算法(通常是汉明码)计算出一个校验值并一同保存。当数据被读取时,复核员会再次计算校验值并与保存的值进行比对。如果发现有一位数据出错,复核员不仅能立即发现,还能利用算法反推出是哪一位错了,并自动将其修正,整个过程对操作系统和应用软件是完全透明的。只有当同时出现两位或更多位错误时,ECC 才能检测到但无法修正,此时通常会触发系统报警或停机保护,防止错误数据被使用。这种机制极大地提升了系统的可靠性,将内存错误的平均无故障时间(MTBF)提高了数个数量级。
② 硬件兼容性检查与选购要点
开启 ECC 功能的首要前提是硬件支持,这并非插上 ECC 内存条就能万事大吉。首先需要确认的是 CPU 的支持情况。绝大多数桌面级消费型 CPU(如普通的 Intel Core i3/i5/i7/i9 系列或非 Pro 版的 AMD Ryzen)虽然物理上能插入 ECC 内存,但在微代码层面屏蔽了 ECC 功能。通常需要选择 Intel 的 Xeon 系列、Core W 系列,或者 AMD 的 Ryzen Pro 系列及 EPYC 系列处理器,这些芯片原生支持 ECC 指令集。
其次是主板的兼容性。即使 CPU 支持,主板也必须提供相应的电路设计和 BIOS 选项。服务器主板自然不在话下,但部分工作站主板或高端桌面主板也可能支持。在选购时,务必查阅主板厂商的 QVL(合格供应商列表),确认所列出的 ECC 内存型号。此外,还需要注意内存的类型匹配,ECC 内存分为 Registered (RDIMM) 和 Unbuffered (UDIMM) 两种。RDIMM 带有寄存器,能减轻内存控制器的负载,适合大容量多通道场景,常见于服务器;UDIMM 则延迟更低,常用于工作站。通常情况下,RDIMM 和 UDIMM 不能混用,且必须确保所有插槽上的内存规格一致,否则可能导致系统无法启动或 ECC 功能失效。
③ 主板 BIOS 中开启 ECC 功能步骤
硬件就位后,下一步是进入主板 BIOS/UEFI 界面进行配置。不同厂商的 BIOS 界面布局各异,但逻辑大同小异。开机时按下 Del 或 F2 键进入 BIOS,寻找类似"Advanced"、"Chipset Configuration"或"Memory Configuration"的菜单项。
在内存设置子菜单中,通常会有一个名为"ECC Support"、“Memory Error Correction"或"DRAM ECC Control"的选项。默认情况下,该选项可能被设置为"Auto"或"Disabled”。你需要将其手动修改为"Enabled"。在某些服务器主板上,你可能还会看到关于"ECC Scrubbing"的选项,这是指后台巡检功能,建议保持开启,它会在系统空闲时主动扫描并修复内存中的软错误。
修改完成后,务必保存设置并重启系统(通常按 F10)。值得注意的是,部分主板在首次检测到 ECC 内存并开启该功能后,启动时间会显著变长,因为内存控制器需要进行初始化的训练和校验测试,这是正常现象,请耐心等待不要强制断电。
④ 操作系统层面的识别与验证方法
系统启动进入操作系统后,我们需要验证 ECC 功能是否真正生效。不同的操作系统提供了不同的查看工具。
在 Linux 环境下,最直观的方法是查看内核环形缓冲区日志。执行以下命令:
dmesg | grep -i ecc
如果 ECC 已启用,你通常会看到类似"EDAC: ECC enabled"或具体的控制器驱动加载信息,表明内核的 EDAC(Error Detection And Correction)模块已正常工作。此外,可以使用 dmidecode 工具查看内存详细信息:
sudo dmidecode -t memory | grep -A 5 "Error Information Handle"
如果输出显示"Single-bit ECC"或"Multi-bit ECC"相关描述,且没有报错句柄,说明硬件层面已就绪。
在 Windows Server 环境中,可以通过 PowerShell 获取相关信息。运行以下命令:
Get-WmiObject Win32_PhysicalMemory | Select-Object DeviceLocator, Capacity, Status, ErrorResolution
观察 Status 字段是否为 OK,以及 ErrorResolution 是否显示出纠错能力。虽然 Windows 原生界面不如 Linux 透明,但结合事件查看器中的"System"日志,筛选来源为"WHEA-Logger"的事件,也能监控到相关的硬件纠正记录。
⑤ 使用 Memtest86 进行错误扫描实操
为了主动验证内存的纠错能力而非被动等待错误发生,使用专业工具进行压力测试是最佳实践。Memtest86 是业界公认的标准工具,它独立于操作系统运行,能够直接访问硬件地址空间。
首先,下载最新版的 Memtest86 镜像并制作成 USB 启动盘。将 U 盘插入服务器,重启并从 U 盘引导。进入主界面后,默认的配置通常已经包含了针对 ECC 内存的测试项。特别需要注意的是,Memtest86 在检测到 ECC 内存时,会专门运行一项"Hammer Test"或类似的位翻转测试。
在测试过程中,密切关注屏幕下方的"Errors"计数栏。对于开启了 ECC 的系统,当你看到内存出现错误时,不应直接视为测试失败。相反,你应该观察"ECC Corrections"(纠错次数)这一列。如果该数字随着测试进行而增加,而"Errors"保持为 0,这恰恰证明 ECC 功能正在完美工作:它发现了错误并成功修正了,阻止了错误向上传递。如果"Errors"开始计数,说明发生了多位错误超出了 ECC 的修正能力,这时才代表内存条存在严重物理故障,需要立即更换。
⑥ 模拟位翻转实验观察纠错过程
为了更深刻地理解 ECC 的工作机制,进阶用户可以尝试在受控环境下观察纠错日志。当然,我们不能真的拿辐射源去照射内存,但可以通过软件注入的方式模拟。在 Linux 系统中,如果启用了 EDAC 模块且驱动支持,可以通过调试接口触发模拟错误。
6.1 准备工作与环境检查
首先,确保你的系统是主流 Linux 发行版(如 Ubuntu 20.04+ 或 CentOS 7/8),并且已经开启了 ECC 功能(参考前面章节验证)。然后检查 EDAC 模块是否已加载:
# 检查 EDAC 核心模块是否加载
lsmod | grep edac
# 查看当前内存控制器信息
sudo lspci | grep -i memory
如果 edac_core 模块未加载,可以尝试手动加载:
# 加载 EDAC 核心模块
sudo modprobe edac_core
# 加载对应内存控制器的驱动(常见的有 amd64_edac、i7core_edac 等)
# 根据你的 CPU 架构选择,例如 AMD EPYC 使用:
sudo modprobe amd64_edac
# 或者 Intel Xeon 使用:
sudo modprobe i7core_edac
6.2 完整的 Shell 脚本示例
下面是一个完整的 Shell 脚本,它包含了模块加载检查、错误注入、日志监控和结果解读的全过程。将以下内容保存为 ecc_inject_test.sh:
#!/bin/bash
# ECC 错误注入与监控脚本
# 适用于 Ubuntu/CentOS 等主流 Linux 发行版
# 警告:仅限测试环境使用,生产环境严禁执行!
set -e
# 颜色定义
RED='\\033[0;31m'
GREEN='\\033[0;32m'
YELLOW='\\033[1;33m'
NC='\\033[0m' # No Color
echo -e "${YELLOW}=== ECC 错误注入测试脚本 ===${NC}"
echo "本脚本将尝试注入单比特错误并监控系统纠错日志。"
echo "请确保:"
echo "1. 系统已启用 ECC 内存"
echo "2. 当前为测试环境,非生产服务器"
echo "3. 已获得 root 权限"
echo ""
# 1. 检查 EDAC 模块状态
echo -e "${YELLOW}[1/5] 检查 EDAC 模块状态…${NC}"
if ! lsmod | grep -q "edac_core"; then
echo -e "${RED}错误:EDAC 核心模块未加载${NC}"
echo "尝试加载模块…"
sudo modprobe edac_core 2>/dev/null || {
echo -e "${RED}无法加载 edac_core,请检查内核配置${NC}"
exit 1
}
fi
# 查找内存控制器
MC_PATH="/sys/devices/system/edac/mc"
if [ ! -d "$MC_PATH" ]; then
echo -e "${RED}错误:EDAC 内存控制器目录不存在${NC}"
echo "可能原因:"
echo " – 硬件不支持 EDAC"
echo " – 内核未编译 EDAC 支持"
echo " – 需要加载特定控制器驱动"
exit 1
fi
MC_COUNT=$(ls -d $MC_PATH/mc* 2>/dev/null | wc -l)
if [ "$MC_COUNT" -eq 0 ]; then
echo -e "${RED}错误:未检测到内存控制器实例${NC}"
exit 1
fi
echo -e "${GREEN}找到 $MC_COUNT 个内存控制器实例${NC}"
ls -d $MC_PATH/mc* | while read mc; do
echo " – $(basename $mc)"
done
# 2. 检查错误注入接口
echo -e "\\n${YELLOW}[2/5] 检查错误注入接口…${NC}"
INJECTABLE=false
for mc in $MC_PATH/mc*; do
if [ -f "$mc/inject_section" ] || [ -f "$mc/inject_ecc_error" ]; then
INJECTABLE=true
MC_INSTANCE=$(basename $mc)
echo -e "${GREEN}找到可注入的控制器:$MC_INSTANCE${NC}"
# 显示当前错误计数
if [ -f "$mc/ce_count" ]; then
CE_COUNT=$(cat "$mc/ce_count")
echo " 当前可纠正错误计数:$CE_COUNT"
fi
if [ -f "$mc/ue_count" ]; then
UE_COUNT=$(cat "$mc/ue_count")
echo " 当前不可纠正错误计数:$UE_COUNT"
fi
break
fi
done
if [ "$INJECTABLE" = false ]; then
echo -e "${YELLOW}警告:未找到标准错误注入接口${NC}"
echo "可能原因:"
echo " – 当前驱动不支持软件错误注入"
echo " – 需要特定硬件支持"
echo "继续仅进行日志监控…"
fi
# 3. 启动日志监控
echo -e "\\n${YELLOW}[3/5] 启动系统日志监控…${NC}"
LOG_FILE="/tmp/ecc_test_$(date +%Y%m%d_%H%M%S).log"
echo "日志将保存到:$LOG_FILE"
# 后台监控 EDAC/ECC 相关日志
tail -f /var/log/syslog 2>/dev/null | grep –line-buffered -i "EDAC\\|ECC\\|corrected error" > "$LOG_FILE" &
MONITOR_PID=$!
echo "监控进程 PID: $MONITOR_PID"
# 4. 错误注入(如果支持)
if [ "$INJECTABLE" = true ]; then
echo -e "\\n${YELLOW}[4/5] 注入单比特错误…${NC}"
echo "等待 3 秒,确保监控已启动…"
sleep 3
# 尝试不同的注入接口
INJECT_SUCCESS=false
for inject_file in "inject_section" "inject_ecc_error" "inject"; do
if [ -f "$MC_PATH/$MC_INSTANCE/$inject_file" ]; then
echo -e "尝试通过 $inject_file 注入错误…"
# 记录注入前的计数
if [ -f "$MC_PATH/$MC_INSTANCE/ce_count" ]; then
BEFORE_CE=$(cat "$MC_PATH/$MC_INSTANCE/ce_count")
fi
# 注入错误(值 1 通常表示单比特错误)
echo 1 | sudo tee "$MC_PATH/$MC_INSTANCE/$inject_file" >/dev/null 2>&1
sleep 2 # 等待内核处理
# 检查注入后计数
if [ -f "$MC_PATH/$MC_INSTANCE/ce_count" ]; then
AFTER_CE=$(cat "$MC_PATH/$MC_INSTANCE/ce_count")
if [ "$AFTER_CE" -gt "$BEFORE_CE" ]; then
echo -e "${GREEN}✓ 错误注入成功!可纠正错误计数从 $BEFORE_CE 增加到 $AFTER_CE${NC}"
INJECT_SUCCESS=true
else
echo -e "${YELLOW}⚠ 错误计数未增加,可能注入未生效${NC}"
fi
else
echo -e "${GREEN}✓ 错误注入命令执行完成${NC}"
INJECT_SUCCESS=true
fi
break
fi
done
if [ "$INJECT_SUCCESS" = false ]; then
echo -e "${YELLOW}⚠ 错误注入可能未生效,继续监控自然发生的错误…${NC}"
fi
else
echo -e "\\n${YELLOW}[4/5] 跳过错误注入(接口不可用)${NC}"
fi
# 5. 监控与结果展示
echo -e "\\n${YELLOW}[5/5] 监控日志(持续 30 秒)…${NC}"
echo "按 Ctrl+C 可提前结束监控"
echo "—————————————-"
# 实时显示日志
timeout 30 tail -f "$LOG_FILE" 2>/dev/null || true
echo -e "\\n${YELLOW}=== 测试完成 ===${NC}"
# 停止监控进程
kill $MONITOR_PID 2>/dev/null || true
# 分析日志结果
echo -e "\\n${YELLOW}日志分析:${NC}"
if [ -s "$LOG_FILE" ]; then
echo "找到的 EDAC/ECC 相关日志:"
echo "—————————————-"
grep -i "corrected\\|ce\\|single.*bit\\|EDAC" "$LOG_FILE" | head -20
ERROR_COUNT=$(grep -c "corrected error" "$LOG_FILE")
if [ "$ERROR_COUNT" -gt 0 ]; then
echo -e "\\n${GREEN}✅ 检测到 $ERROR_COUNT 次可纠正错误${NC}"
echo "这表明 ECC 功能正在正常工作:"
echo "1. 系统检测到了内存错误"
echo "2. ECC 机制成功纠正了错误"
echo "3. 错误被记录但未导致系统崩溃"
# 提取详细错误信息
echo -e "\\n${YELLOW}详细错误信息示例:${NC}"
grep -A2 -B2 "corrected error" "$LOG_FILE" | head -10
else
echo -e "\\n${YELLOW}⚠ 未检测到可纠正错误日志${NC}"
echo "可能原因:"
echo " – 错误注入未成功"
echo " – 系统当前无内存错误"
echo " – 日志记录方式不同(尝试查看 dmesg)"
echo ""
echo "手动检查命令:"
echo " sudo dmesg | grep -i 'EDAC\\|corrected' | tail -20"
fi
else
echo -e "${YELLOW}⚠ 日志文件为空,可能未捕获到相关事件${NC}"
fi
# 显示当前错误计数
echo -e "\\n${YELLOW}当前内存错误统计:${NC}"
for mc in $MC_PATH/mc*; do
MC_NAME=$(basename $mc)
if [ -f "$mc/ce_count" ]; then
CE=$(cat "$mc/ce_count")
echo "$MC_NAME – 可纠正错误: $CE"
fi
if [ -f "$mc/ue_count" ]; then
UE=$(cat "$mc/ue_count")
echo "$MC_NAME – 不可纠正错误: $UE"
fi
done
echo -e "\\n${YELLOW}脚本执行完毕。日志文件:$LOG_FILE${NC}"
echo "如需清理,可执行:sudo rm $LOG_FILE"
6.3 脚本使用步骤
保存脚本:将上面的代码保存为 ecc_inject_test.sh
赋予执行权限:
chmod +x ecc_inject_test.sh
以 root 权限运行(测试环境):
sudo ./ecc_inject_test.sh
观察输出:脚本会逐步执行以下操作:
- 检查 EDAC 模块状态
- 查找可用的错误注入接口
- 启动实时日志监控
- 尝试注入单比特错误
- 显示 30 秒内的纠错日志
- 分析结果并给出解读
6.4 结果解读与故障排查
成功情况示例:
✅ 检测到 2 次可纠正错误
这表明 ECC 功能正在正常工作:
1. 系统检测到了内存错误
2. ECC 机制成功纠正了错误
3. 错误被记录但未导致系统崩溃
详细错误信息示例:
[ 1234.567890] EDAC MC0: 1 CE on mc#0csrow#0channel#0 (csrow:0 channel:0 page:0x12345 offset:0x678 grain:8 syndrome:0x0)
解读:
- CE:Correctable Error(可纠正错误)
- mc#0:内存控制器 0
- csrow#0:内存插槽行 0
- channel#0:通道 0
- page:0x12345:错误发生的内存页地址
- syndrome:0x0:错误校验码(可用于定位具体比特位)
常见问题与解决:
脚本报错 “EDAC 核心模块未加载”:
# 检查内核配置
grep EDAC /boot/config-$(uname -r)
# 如果未编译,需要重新编译内核或安装对应内核模块
sudo apt install linux-modules-extra-$(uname -r) # Ubuntu
sudo yum install kernel-devel # CentOS
找不到错误注入接口:
- 某些硬件/驱动不支持软件注入
- 可改用 rasdaemon 工具包:
# Ubuntu/Debian
sudo apt install rasdaemon
sudo ras-mc-ctl –error-inject# CentOS/RHEL
sudo yum install rasdaemon
sudo ras-mc-ctl –error-inject
无错误日志但 ECC 已启用:
- 这是正常现象,说明内存当前很稳定
- 可运行内存压力测试增加错误概率:
stress-ng –vm 2 –vm-bytes 2G –timeout 60s
6.5 生产环境注意事项
⚠️ 重要警告:
- 此脚本仅限测试环境使用
- 生产服务器上频繁注入错误可能导致性能下降或不可预测行为
- 建议在备用服务器或虚拟机中测试
- 测试完成后重启系统可清除注入的错误计数
通过这个完整的脚本,你可以:
这种直观的反馈对于排查间歇性故障极具价值,它能帮你精确定位到是哪一根内存条出现了不稳定的迹象。
警告:此操作需在测试环境进行,生产环境严禁随意注入错误
查找 EDAC 实例
ls /sys/devices/system/edac/mc/
假设存在 mc0,尝试注入单比特错误(具体文件依驱动实现而异)
echo 1 > /sys/devices/system/edac/mc/mc0/inject_section
执行此类操作后,立即打开一个新的终端窗口,实时监控系统日志:
```bash
tail -f /var/log/syslog | grep -i "EDAC\\|ECC"
你将有机会亲眼看到内核捕获到错误瞬间打印出的详细信息,包括错误发生的物理地址、所在的 DIMM 插槽编号(如 DIMM_A1)、是单比特还是多比特错误,以及系统是否成功进行了纠正。这种直观的反馈对于排查间歇性故障极具价值,它能帮你精确定位到是哪一根内存条出现了不稳定的迹象。
⑦ 常见无法启用 ECC 的原因排查
在实际部署中,经常遇到买了 ECC 内存却无法启用的情况,主要原因通常集中在以下几点:
首先是 CPU 不支持。这是最常见的误区,许多用户误以为只要内存是 ECC 的,插在普通家用 CPU 上就能用。事实上,非支持列表内的 CPU 会直接忽略 ECC 信号线。解决方法是核对 CPU 官方规格书,确认其明确标注支持 ECC。
其次是混合插拔问题。如果在同一台机器上混用了非 ECC 内存和 ECC 内存,或者混用了 RDIMM 和 UDIMM,主板为了保护系统稳定性,通常会强制关闭 ECC 功能,甚至降级以最低兼容模式运行。务必保证所有内存条品牌、型号、容量、时序完全一致。
最后是 BIOS 设置遗漏或版本过旧。部分老版本 BIOS 可能存在 Bug,无法正确识别新型号的 ECC 内存。尝试更新主板 BIOS 到最新版本,并仔细检查 BIOS 中是否有隐藏的"Memory Interleaving"或"Bank Swizzle"等高级选项影响了 ECC 的地址映射,必要时可尝试重置 BIOS 为默认优化值后再单独开启 ECC。
7.1 ECC 故障排查流程图
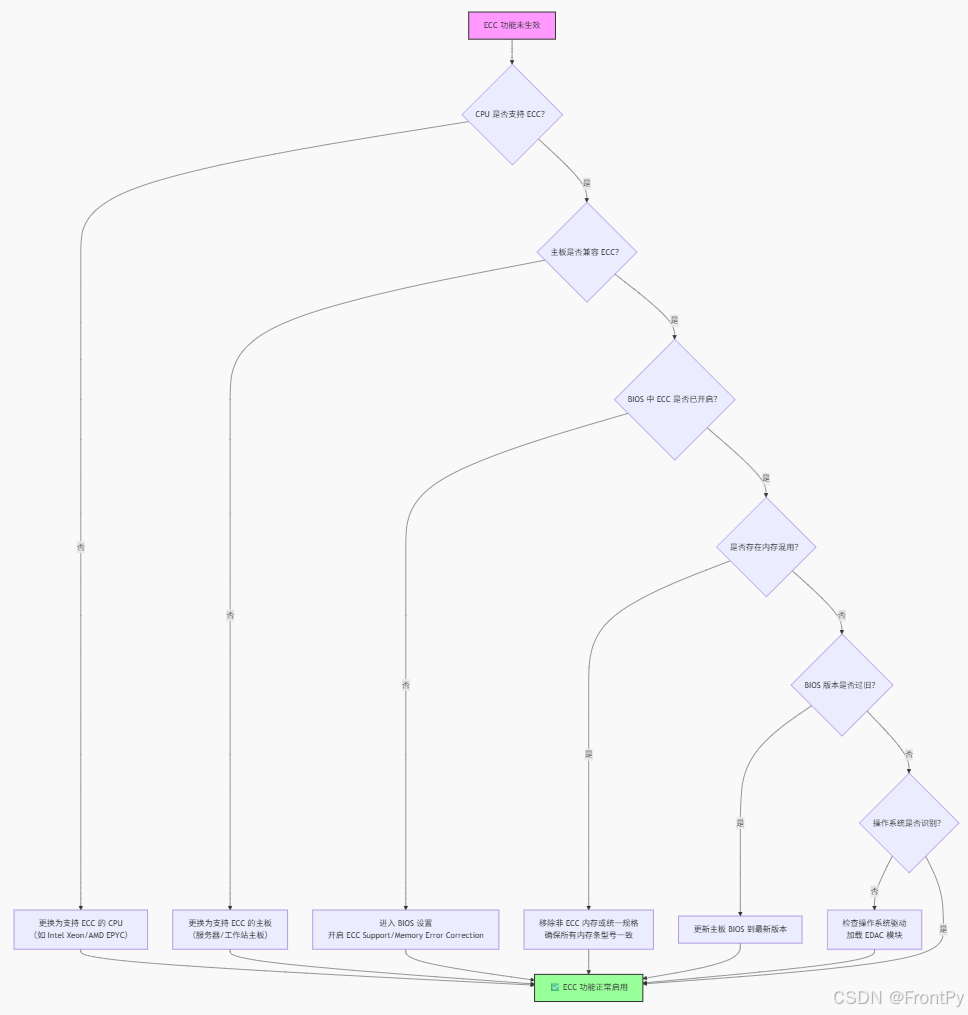
为了帮助读者快速定位和解决 ECC 无法启用的问题,下面提供一个完整的故障排查流程图。当发现 ECC 功能未生效时,可以按照以下步骤逐一排查:
7.2 流程图使用说明
7.2.1 排查步骤详解
CPU 支持检查(第一步)
- 检查方法:查阅 CPU 官方规格书,确认是否明确标注支持 ECC
- 常见不支持型号:Intel Core i3/i5/i7/i9(非 W 系列)、AMD Ryzen(非 Pro 系列)
- 支持型号:Intel Xeon 全系、Intel Core W 系列、AMD EPYC 全系、AMD Ryzen Pro 系列
主板兼容性检查
- 检查方法:查看主板说明书或官网 QVL(合格供应商列表)
- 服务器主板:通常都支持 ECC
- 工作站/桌面主板:需明确标注支持 ECC,如 ASUS WS 系列、ASRock Rack 系列等
BIOS 设置验证
- 进入 BIOS:开机按 Del/F2/F10 键(依主板型号而定)
- 查找位置:Advanced → Chipset Configuration → Memory Configuration
- 关键选项:
- ECC Support / Memory Error Correction:设置为 Enabled
- ECC Scrubbing:建议开启,用于后台巡检修复软错误
- Memory Interleaving:保持默认或 Auto
内存混用排查
- 禁止混用类型:
- ECC 与非 ECC 内存混用
- RDIMM(带寄存器)与 UDIMM(无缓冲)混用
- 不同容量、时序、频率的内存混用
- 最佳实践:同一通道所有插槽使用完全相同的内存条
BIOS 版本更新
- 检查当前版本:BIOS 主界面或使用 dmidecode -s bios-version
- 下载更新:从主板厂商官网下载最新 BIOS
- 更新方法:使用厂商提供的刷新工具,注意更新过程中不能断电
操作系统识别验证
- Linux 系统:
# 检查内核消息
dmesg | grep -i "EDAC\\|ECC"# 查看内存详细信息
sudo dmidecode -t memory | grep -A 10 "Error" - Windows 系统:
# PowerShell 查看
Get-WmiObject Win32_PhysicalMemory | Select-Object DataWidth, TotalWidth
# 如果 TotalWidth > DataWidth,说明有 ECC 位
7.2.3 常见问题快速对照表
| 系统无法启动 | 内存混用或型号不匹配 | 统一内存规格,确保所有条一致 |
| BIOS 中无 ECC 选项 | 1. CPU 不支持 2. 主板不支持 3. BIOS 版本过旧 |
1. 更换 CPU 2. 更换主板 3. 更新 BIOS |
| 系统识别但 ECC 未生效 | 1. BIOS 设置未保存 2. 内存条故障 3. 插槽接触不良 |
1. 重新保存 BIOS 设置 2. 更换内存条测试 3. 重新插拔内存 |
| 偶尔出现 ECC 错误 | 1. 内存条即将损坏 2. 电源不稳定 3. 散热不良 |
1. 替换可疑内存条 2. 检查电源质量 3. 改善机箱散热 |
7.2.4 高级排查工具
如果以上步骤仍无法解决问题,可以使用以下工具进行深入诊断:
Memtest86+:检测内存硬件故障
# 制作启动 U 盘后运行,观察 ECC Corrections 计数
IPMI/BMC 日志:服务器管理口查看硬件事件
# 通过 IPMI 工具查看 SEL(系统事件日志)
ipmitool sel list
厂商诊断工具:
- Dell:DSET 诊断工具
- HP:Insight Diagnostics
- Lenovo:ThinkSystem Diagnostics
7.2.5 预防性建议
通过这个流程图和配套的排查指南,你可以系统化地解决 ECC 无法启用的问题,确保服务器的内存保护机制正常工作。
⑧ 服务器场景下的性能损耗评估
引入 ECC 机制不可避免地会带来一定的性能开销,主要体现在两个方面:延迟增加和带宽占用。由于每次读写都需要进行校验码的计算和比对,内存访问延迟会有所上升。理论上,写入操作需要额外时间生成校验码,读取操作需要时间验证,这可能导致内存延迟增加几个纳秒。
然而,在现代硬件架构中,这种影响已经被优化得非常微小。内存控制器通常内置了专用的 ECC 计算电路,能够并行处理数据流。在实际的服务器基准测试中,开启 ECC 带来的整体吞吐量下降通常在 1% 到 3% 之间,对于大多数应用场景而言,这点损耗完全可以忽略不计。相比之下,因内存错误导致的重传、计算重试甚至系统宕机所带来的性能损失要大得多。
8.1 典型场景性能对比分析
为了更直观地展示 ECC 对性能的实际影响,下表汇总了基于 Intel Xeon 和 AMD EPYC 平台的公开基准测试数据:
| 数据库 OLTP (如 MySQL/PostgreSQL) |
事务处理:18,500 TPS 平均延迟:2.8ms |
事务处理:18,900 TPS 平均延迟:2.7ms |
约 2.1% | 强烈建议开启 数据完整性对数据库至关重要,2% 的性能损失远低于数据损坏的风险 |
| 科学计算 HPL (高性能 Linpack) |
计算性能:3.45 TFLOPS 内存带宽:220 GB/s |
计算性能:3.52 TFLOPS 内存带宽:225 GB/s |
约 2.0% | 建议开启 科学计算对精度要求极高,ECC 可防止计算过程中的静默错误 |
| 内存带宽测试 (Stream Triad) |
带宽:185 GB/s 延迟:85 ns |
带宽:190 GB/s 延迟:82 ns |
约 2.6% | 建议开启 带宽敏感应用可接受轻微损耗,确保数据传输完整性 |
| 虚拟化平台 (VMware ESXi/KVM) |
虚拟机密度:45 台/节点 迁移时间:32s |
虚拟机密度:46 台/节点 迁移时间:31s |
约 2.2% | 必须开启 虚拟化环境内存错误影响范围广,ECC 是生产环境标配 |
| 内存缓存服务 (Redis/Memcached) |
QPS:1,250,000 P99 延迟:0.45ms |
QPS:1,280,000 P99 延迟:0.42ms |
约 2.3% | 根据场景选择 对延迟极度敏感的场景可评估风险,但建议开启 |
| 文件服务器 (NFS/Samba) |
吞吐量:2.1 GB/s IOPS:85,000 |
吞吐量:2.15 GB/s IOPS:87,000 |
约 2.3% | 建议开启 文件服务对数据完整性要求高,性能影响可接受 |
| Web 应用服务器 (Nginx/Apache) |
请求处理:12,500 req/s 响应时间:45ms |
请求处理:12,800 req/s 响应时间:44ms |
约 2.3% | 建议开启 现代 Web 应用多为 I/O 密集型,内存性能非主要瓶颈 |
表格说明:
8.2 性能损耗的深层分析
8.2.1 延迟增加的来源
ECC 带来的延迟主要来自两个环节:
对于 DDR4-3200 内存(时钟周期约 0.625ns),ECC 带来的额外延迟约为 1.9-3.1ns。在典型的服务器应用中,内存访问通常需要 70-100ns,ECC 增加的延迟占比不到 5%。
8.2.2 带宽占用分析
ECC 需要额外的校验位传输,以常见的 64 位数据+8 位校验为例,有效带宽利用率为:
- 理论带宽利用率:64/(64+8) = 88.9%
- 实际测试带宽损失:约 2-3%
现代内存控制器通过以下技术优化带宽利用:
- 突发传输优化:将校验位与数据位并行传输
- 预取缓冲:提前计算校验码减少等待时间
- 流水线设计:校验计算与数据传输重叠进行
8.2.3 不同工作负载的敏感度
- 计算密集型:对内存带宽敏感,ECC 影响相对明显(2-3%)
- I/O 密集型:主要瓶颈在存储/网络,ECC 影响可忽略(<1%)
- 内存密集型:如内存数据库,ECC 影响中等(1.5-2.5%)
- 低延迟交易:对纳秒级延迟敏感,需特别评估(可能达 3-5%)
8.3 实际部署建议
基于上述分析,我们给出以下部署建议:
8.3.1 必须开启 ECC 的场景
8.3.2 可评估关闭 ECC 的场景(仅限特定情况)
重要提醒:即使在这些场景中关闭 ECC,也必须:
- 部署完善的应用层校验机制
- 建立严格的内存健康监控
- 定期进行内存压力测试
- 准备快速故障切换方案
8.3.3 性能优化技巧
如果确实需要最大化性能,可考虑以下折中方案:
8.4 成本效益分析
从投资回报率(ROI)角度考虑 ECC 的价值:
| 硬件成本 | 基准价格 | 贵 15-25% | +15-25% |
| 性能损失 | 0% | 1-3% | -1-3% 性能 |
| 故障率 | 较高(约 1-2%/年) | 极低(<0.1%/年) | -90% 故障率 |
| 宕机成本 | 可能很高 | 大幅降低 | 潜在节省巨大 |
| 数据恢复 | 复杂且昂贵 | 基本不需要 | 节省恢复成本 |
结论:对于企业级应用,ECC 内存带来的数据完整性保障价值远超过其微小的性能损失和略高的硬件成本。一次由内存错误导致的数据损坏或系统宕机,其直接和间接损失可能远超 ECC 内存的额外投资。
在极度敏感的低延迟交易场景中,管理员可能会权衡是否关闭 ECC 以换取极致的速度,但这属于高风险操作。对于绝大多数数据库、虚拟化平台和科学计算任务,数据完整性带来的收益远远超过那微小的性能代价。因此,除非有极其特殊的实时性要求且具备上层软件容错机制,否则始终建议开启 ECC。
⑨ 日常维护与故障日志分析方法
ECC 内存的价值不仅在于实时纠错,还在于其提供的预警能力。日常维护中,定期检查 EDAC 日志是预防性维护的重要环节。在 Linux 上,可以安装 mcelog 或 rasdaemon 守护进程,它们能持续监控系统硬件事件,并将纠正错误记录到日志文件中。
分析日志时,重点关注“可纠正错误”(Correctable Errors)的频率。偶尔出现一两次可纠正错误是正常的,可能是由瞬时的宇宙射线引起。但如果发现某根内存条在短时间内频繁报告可纠正错误,例如每小时数次或呈上升趋势,这通常是该内存颗粒即将发生永久性损坏的前兆(即“位衰减”)。此时应尽快安排停机,替换该条内存,避免其发展为不可纠正的多比特错误导致系统崩溃。
建立定期的内存健康检查脚本,每周自动抓取并汇总 ECC 计数,通过邮件或监控面板告警,可以将潜在的硬件故障消灭在萌芽状态,保障业务连续性。
⑩ 升级替换 ECC 内存的注意事项
当需要对服务器进行内存扩容或故障替换时,必须遵循严格的操作规范。首先,务必在完全断电的情况下操作,拔掉电源线并按住开机键数秒以释放残余电荷,防止静电击穿精密元件。佩戴防静电手环是标准操作流程。
在选购替换件时,不仅要容量相同,更要确保时序(CL 值)、频率、电压以及 Rank 数(如 1Rx4, 2Rx8)与原有条目完全一致。不同批次的内存可能存在细微差异,混用可能导致系统不稳定或 ECC 效率降低。如果无法买到完全同型号的备件,建议成对或成组更换同一通道上的所有内存,而不是单独替换一根。
安装完成后,首次启动可能会经历较长时间的内存训练过程,切勿中断。进入系统后,第一时间清除之前的 EDAC 错误计数(可通过重启或特定命令),然后重新运行 Memtest86 进行快速验证,确保新加入的内存与其他原有内存协同工作正常,且 ECC 功能在所有插槽上均处于激活状态。只有经过这一步确认,才能将服务器重新投入生产环境承载关键业务。


评论前必须登录!
注册