 网硕互联帮助中心
GEO 品牌监测系统实战:基于 Node.js + Playwright 实现多平台采集与报告导出
当用户开始通过 DeepSeek、豆包等 AI 产品了解品牌、比较产品、寻找服务商时,企业会遇到一个新的问题:
用户提问时,AI 的回答中有没有出现我们的品牌?
单次手动提问可以看到一个结果,但要持续观察多个问题、多个平台以及不同时间的变化,就需要一套能够重复执行、保存证据和汇总数据的监测系统。
最近,我基于开源项目 geo-monitoring 完成了本地部署与二次开发,围绕多轮采样、采集引擎接入、历史趋势和报告导出做了一轮完善。
本文分享这套系统的实现思路,以及开发过程中几个值得关注的细节。
试用地址
一、系统解决什么问题?
这套系统的核心,是观察品牌在 AI 回答中的出现情况。
例如,为一个品牌配置以下问题:
企业搭建官网,应该如何选择服务商?
某个行业有哪些值得了解的品牌?
品牌 A 的产品适合哪些用户?
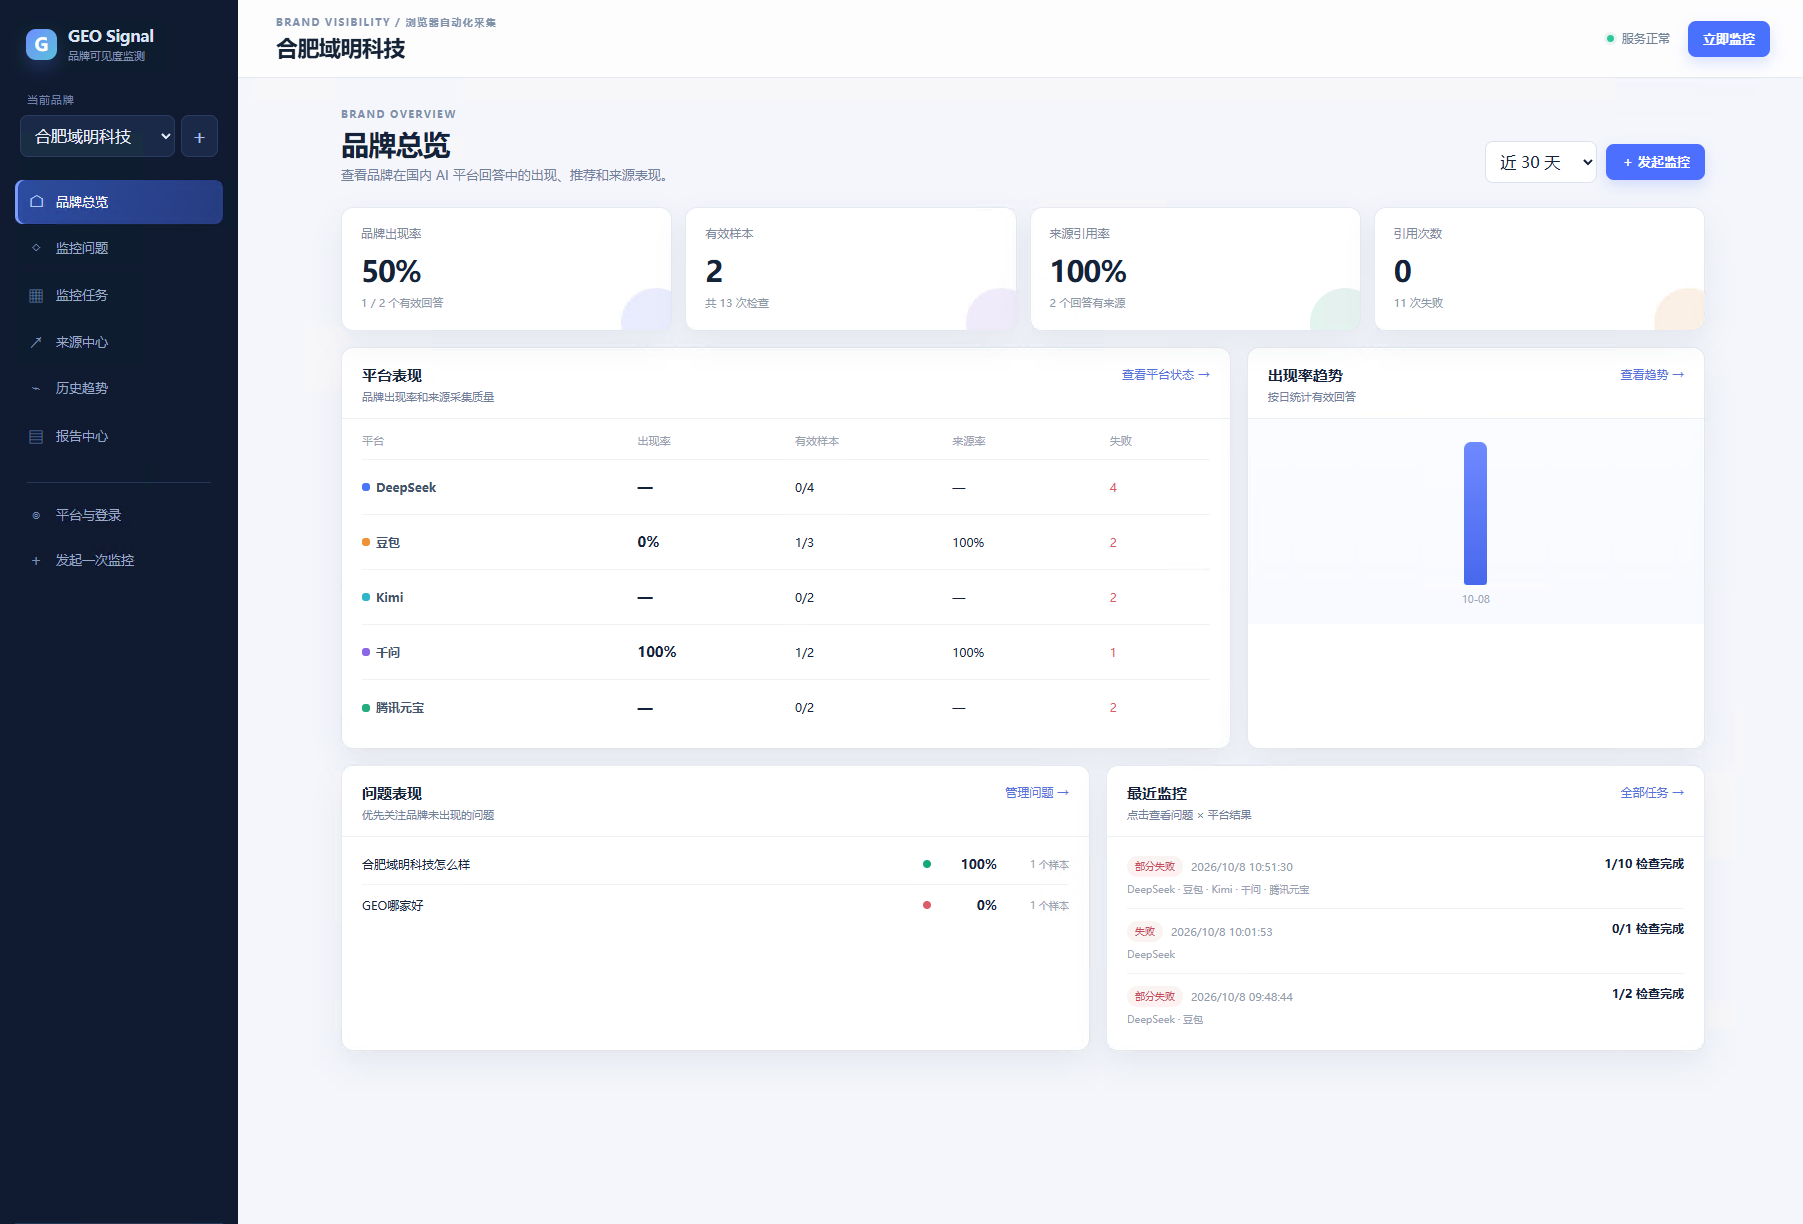
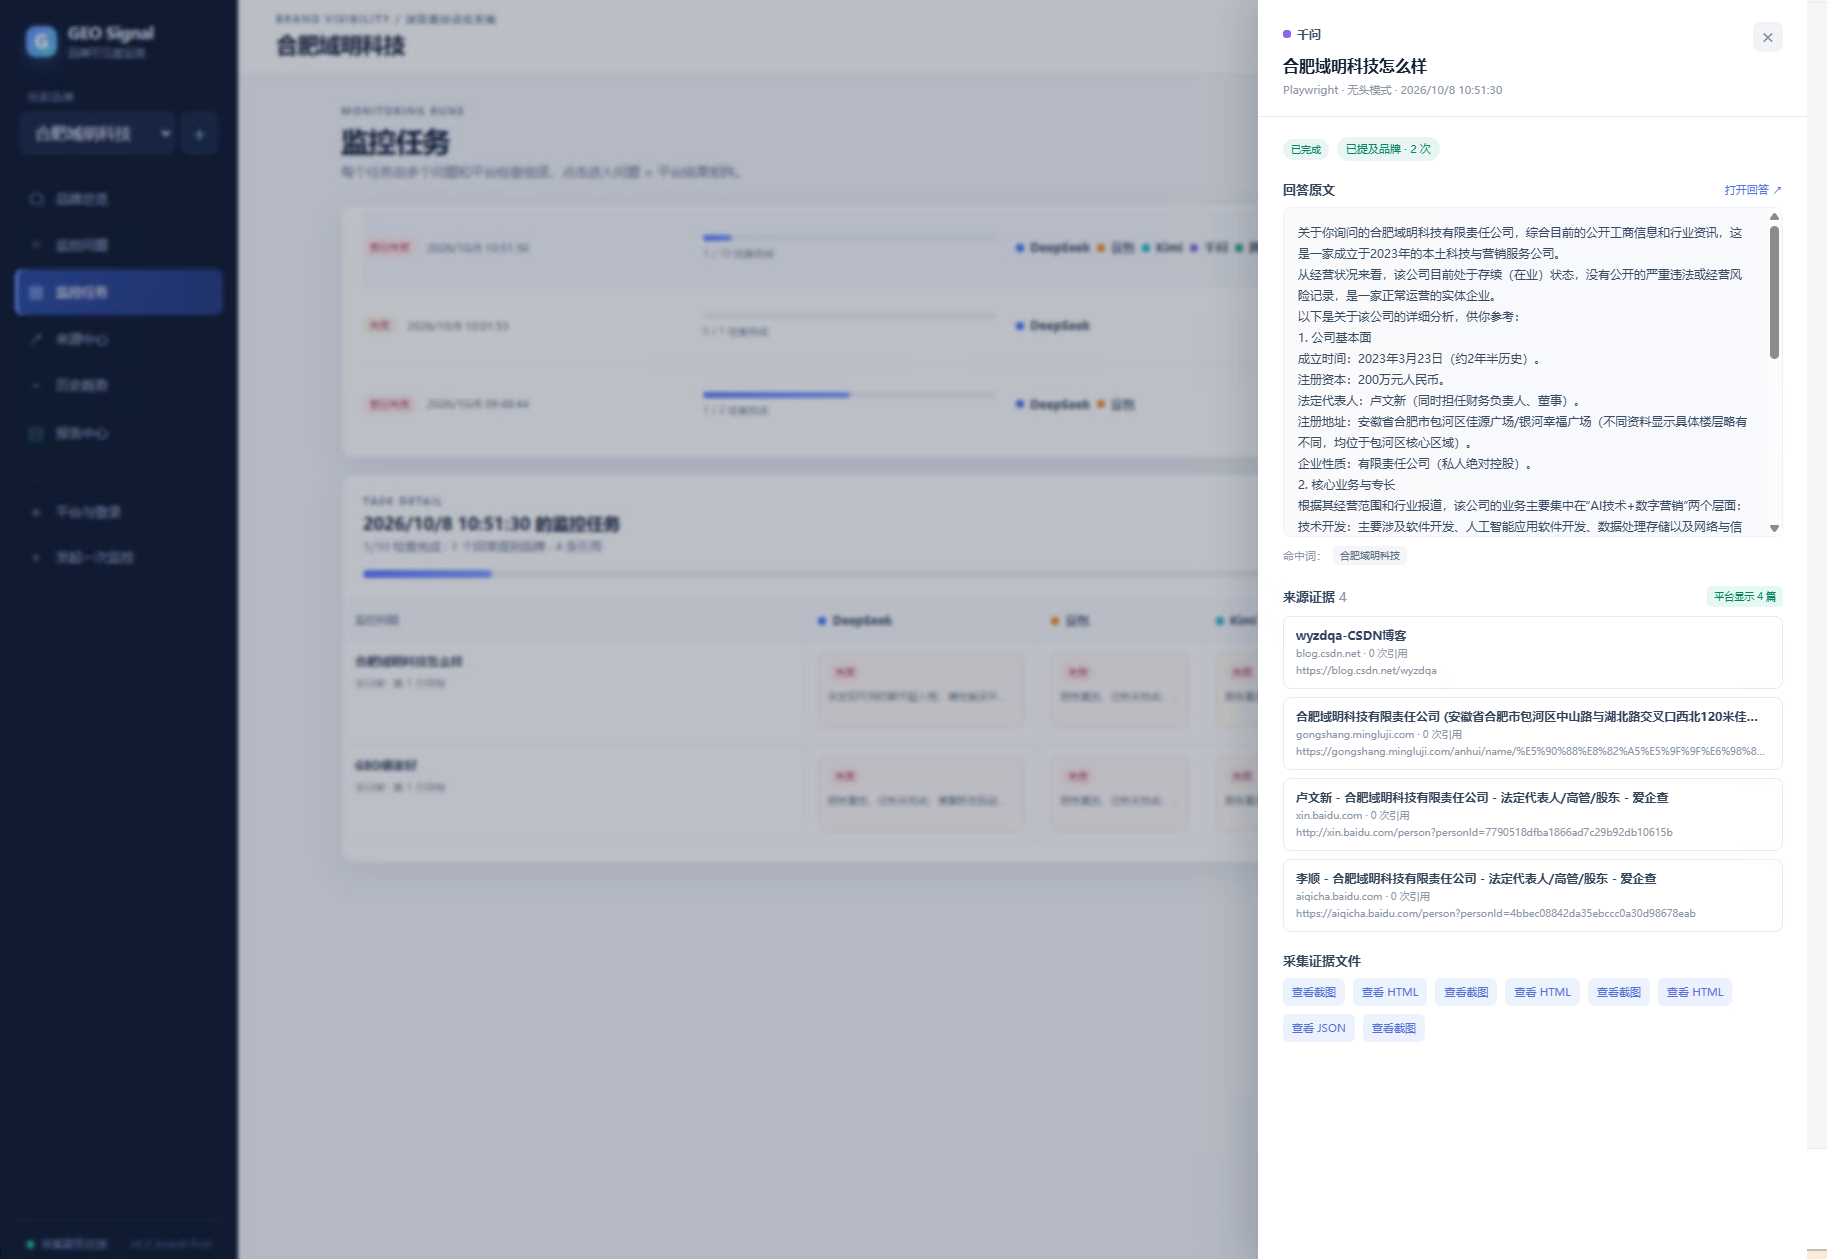
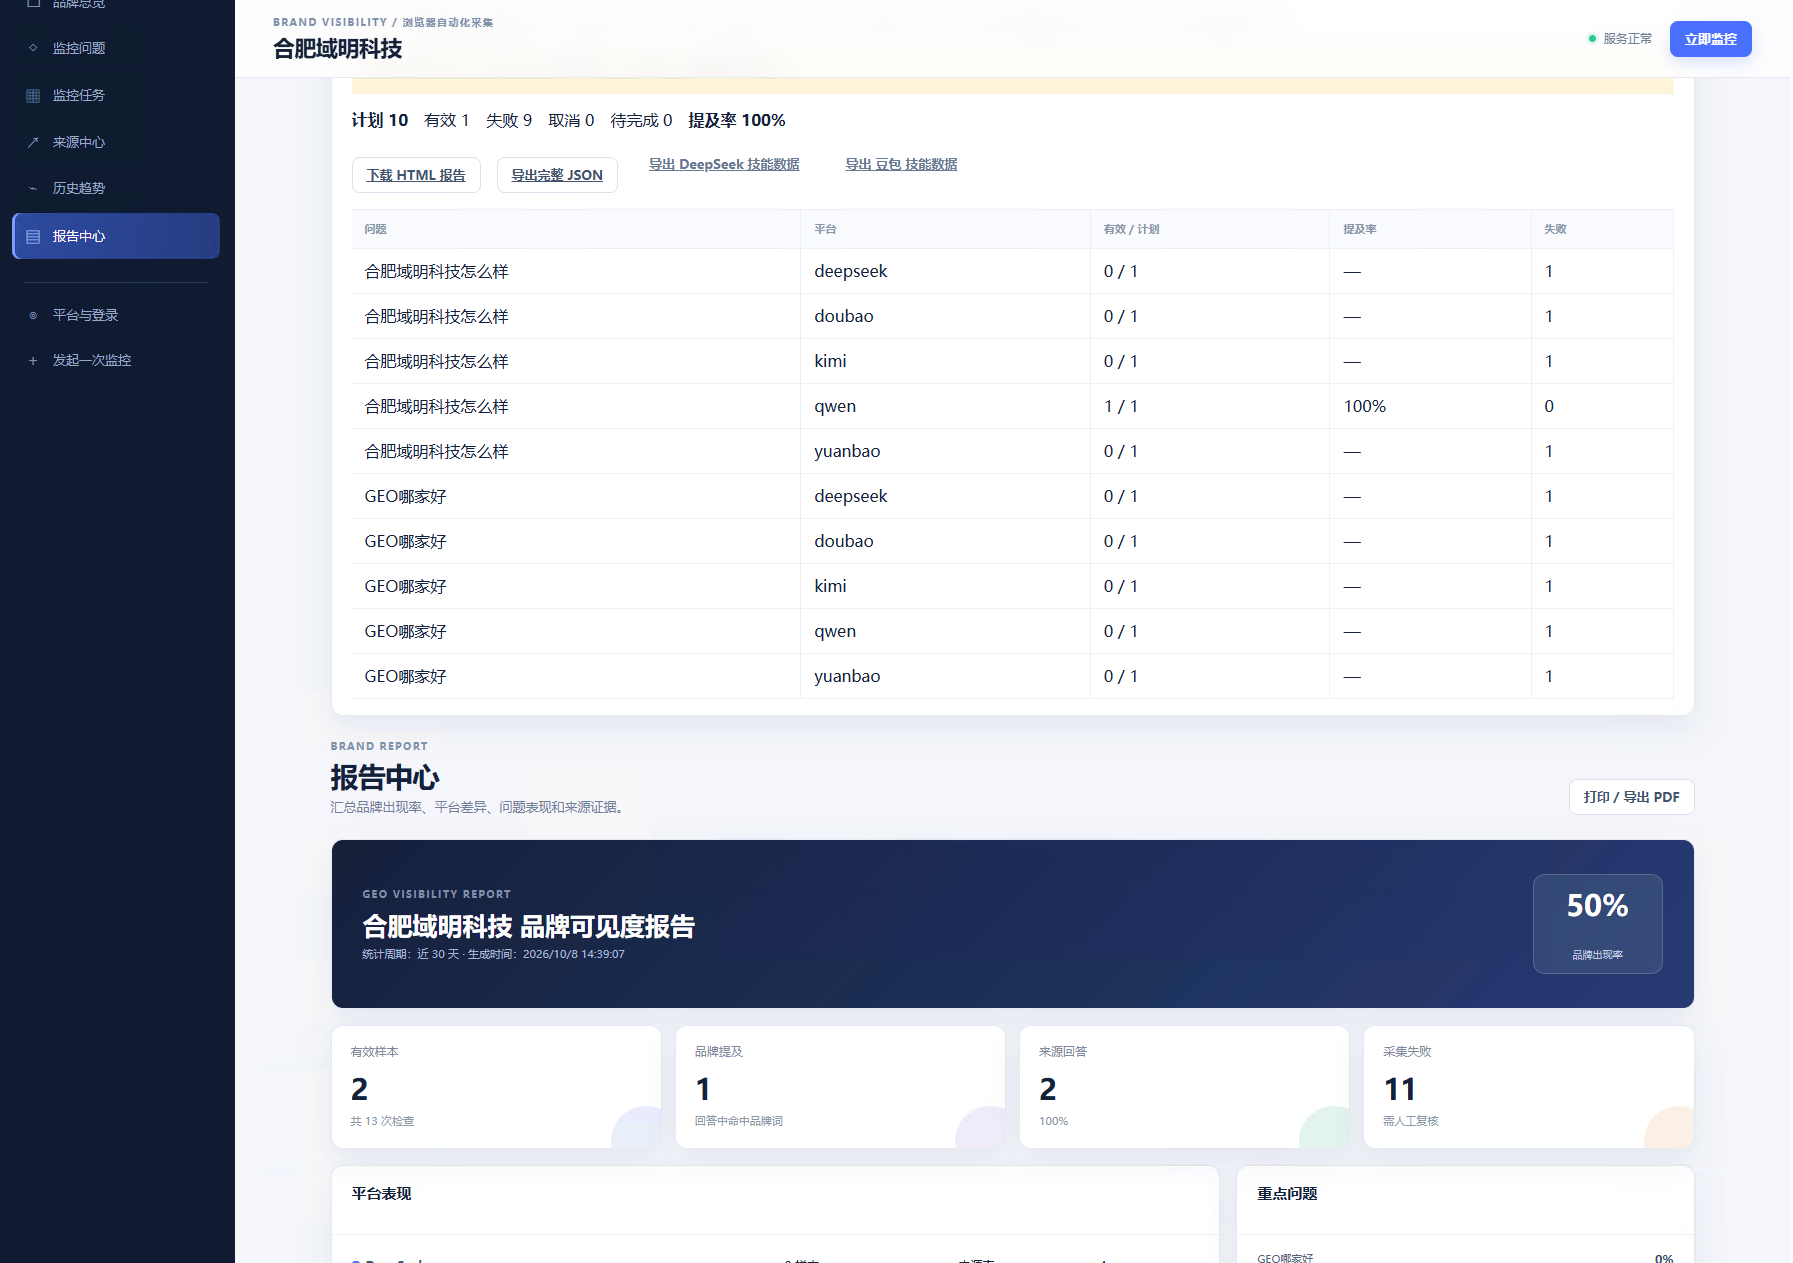
系统按照配置的平台和采样次数执行提问,然后保存:
- 本次执行的问题、平台和采样轮次;
- AI 回答正文;
- 品牌及别名的出现情况;
- 能够获取到的引用来源;
- 任务状态、错误信息和采集证据。
再通过品牌概览、历史趋势和报告中心查看结果。
这里需要明确:品牌被提及,不等于品牌被推荐。 当前的出现率主要依据回答文本中的品牌及别名匹配,用于衡量可见度,不能直接等同于推荐强度或市场份额。
二、技术架构
系统采用前后端分离开发、构建后统一提供服务的方式。
| 前端 | React + Vite | 品牌管理、任务配置、趋势与报告 |
| 后端 | Node.js + Fastify | API、任务调度和静态页面服务 |
| 数据存储 | SQLite + better-sqlite3 | 保存品牌、问题、任务与回答 |
| 浏览器采集 | Playwright | 执行页面操作、提取回答与证据 |
| 扩展采集 | OpenCLI | 接入 DeepSeek、豆包浏览器采集 |
| 数据分析 | JavaScript | 汇总样本、计算指标、生成报告 |
整体处理流程如下:
品牌与问题配置
↓
创建监测任务
↓
展开:问题 × 平台 × 采样轮次
↓
任务队列与采集引擎
↓
回答与来源标准化
↓
品牌匹配、样本统计
↓
品牌概览 / 历史趋势 / 报告导出
对于本地部署场景,SQLite 减少了数据库服务的维护成本,采集证据则以文件形式保存。
三、为什么需要重复采样?
AI 回答具有一定波动。同一个问题,在不同会话、不同时间或不同搜索模式下,可能得到不同结果。
因此,只提问一次,很容易把偶然结果当成稳定结论。
这次改造加入了重复采样次数和执行间隔。例如:
监测问题:5 个
监测平台:2 个
每组采样:3 次
总采集单元 = 5 × 2 × 3 = 30
每一轮采样都有独立记录,避免后一次回答覆盖前一次结果。
任务展开逻辑可以简化为:
for (const prompt of prompts) {
for (let sampleIndex = 1; sampleIndex <= repeatCount; sampleIndex++) {
for (const platformId of platforms) {
createPlatformRun({
runId,
promptId: prompt.id,
platformId,
sampleIndex,
// 保存创建任务时的问题内容
promptTextSnapshot: prompt.text,
promptCategorySnapshot: prompt.category ?? '',
// 保存本次任务选用的采集方式
collector: collectorByPlatform[platformId].collector,
bridgeProfile: collectorByPlatform[platformId].bridgeProfile,
});
}
}
}
数据库同时对以下字段组合建立唯一约束:
UNIQUE (
run_id,
prompt_id,
platform_id,
sample_index
)
这样可以明确区分“同一个问题在同一个平台上的第几次采样”。
执行间隔也很重要。当前实现按同一平台上一次执行结束的时间计算等待时间,避免短时间内连续触发大量页面操作。
四、历史任务为什么要保存快照?
问题库中的文本是可以修改的。
假设今天创建任务时,问题是:
品牌 A 怎么样?
明天把问题改成:
品牌 A 和品牌 B 有什么区别?
如果历史报告只关联问题库中的当前文本,就可能出现“显示的是新问题,保存的却是旧回答”的情况。
因此,新任务会保存创建时的问题文本、分类、品牌配置以及采集方式。后续修改问题库,不会改变这些任务的分析依据。
对于改造前没有快照的旧记录,系统会提示数据限制,不会把当前问题文本冒充成当时的原始问题。
这个设计看起来很小,却直接影响报告是否可追溯。
五、如何接入两种采集引擎?
原有系统主要通过 Playwright 执行浏览器采集。
在扩展 DeepSeek、豆包采集能力时,我参考并接入了 yao-geo-skills 中对应的浏览器采集脚本,通过 OpenCLI 调用。
这里的接入不是简单复制技能说明文件,而是把采集脚本纳入系统现有的任务调度、数据标准化和证据保存流程。
上层任务统一通过一个入口执行:
import { executePlatformRun } from './platform-runner.js';
import { executeOpenCliRun } from './opencli-runner.js';
export function executeCollectorRun(options) {
return options.platformRun.collector === 'opencli'
? executeOpenCliRun(options)
: executePlatformRun(options);
}
这种设计让任务调度与具体采集方式分离:
监测任务
├── Playwright 执行器
└── OpenCLI 执行器
↓
统一回答数据结构
↓
统计与报告模块
当前 OpenCLI 接入范围是 DeepSeek 和豆包,其他平台继续使用原有采集方式。
采集方式会随任务一起保存,因此修改平台默认设置,不会改变已经创建的任务。
另外,多个 OpenCLI 任务会串行访问浏览器桥接,连接检查也使用同一把锁,避免检查操作与采集操作互相干扰页面。
Windows 下的调用细节
在 Windows 环境中,直接通过命令字符串拼接调用 CLI,容易受到路径、引号和特殊字符影响。
项目使用本地安装的 CLI,并通过当前 Node.js 进程执行入口文件。核心调用方式如下:
import { execFile } from 'node:child_process';
// cliEntry 为项目本地安装的 OpenCLI 入口文件
execFile(
process.execPath,
[cliEntry, …args],
{ windowsHide: true },
(error, stdout, stderr) => {
if (error) {
// 交给任务层记录失败原因和执行日志
return;
}
// 继续解析采集结果
},
);
参数以数组传入,不需要把用户问题拼成 Shell 命令。
实际任务执行器还处理了超时、取消和子进程清理,确保取消任务后不会遗留持续运行的采集进程。
六、出现率与采样覆盖率要分开计算
统计时,一个容易忽略的问题是:采集失败应该如何处理?
假设计划采集 20 次,其中:
成功获得有效回答:16 次
有效回答中出现品牌:8 次
采集失败:4 次
此时:
品牌出现率 = 8 ÷ 16 = 50%
采样覆盖率 = 16 ÷ 20 = 80%
采集失败意味着没有拿到有效样本,不能直接判定为“AI 没有提及品牌”。
核心统计逻辑如下:
const rate = (numerator, denominator) =>
denominator
? Math.round((numerator / denominator) * 1000) / 10
: null;
function summarize(samples) {
const valid = samples.filter(
sample =>
sample.status === 'completed' &&
sample.answer?.content?.trim()
);
const mentioned = valid.filter(
sample => sample.answer.brandMentioned
).length;
return {
planned: samples.length,
valid: valid.length,
mentioned,
failed: samples.filter(s => s.status === 'failed').length,
cancelled: samples.filter(s => s.status === 'cancelled').length,
pending: samples.filter(
s => ['queued', 'running'].includes(s.status)
).length,
mentionRate: rate(mentioned, valid.length),
coverageRate: rate(valid.length, samples.length),
citationRate: rate(
valid.filter(s => s.answer.citations.length > 0).length,
valid.length
),
};
}
没有有效样本时返回 null,页面显示“—”,避免把“暂无数据”误显示为“0%”。
引用率也需要结合采集能力理解:没有提取到链接,不一定意味着平台没有使用外部来源。不同采集路径能够获取的来源信息并不完全一致。
七、一次浏览器关闭引发的异常处理改造
浏览器自动化不能只考虑成功路径。
实际运行时,用户可能关闭浏览器,页面可能失效,任务也可能超时。此时,连“保存错误截图”这个动作本身都可能失败。
之前的一个问题出现在截图与 HTML 保存逻辑中:
await Promise.all([
page.screenshot({ path: screenshotPath }),
writeFile(htmlPath, await page.content(), 'utf8'),
]);
第一项截图操作已经启动,但第二项在构造数组时执行了 await。
如果读取页面内容失败,代码可能还没进入 Promise.all,已经启动的截图操作就失去了统一的异常处理入口。
改造后的写法是:
export async function capturePage(page, directory, name) {
const screenshotPath = path.join(directory, `${name}.png`);
const htmlPath = path.join(directory, `${name}.html`);
await Promise.all([
page.screenshot({
path: screenshotPath,
fullPage: true,
}),
page.content().then(html =>
writeFile(htmlPath, html, 'utf8')
),
]);
return { screenshotPath, htmlPath };
}
同时,调用方单独处理证据保存失败,保留原始采集错误。
这样,即使浏览器已经关闭,也能将对应任务记录为失败,避免辅助取证逻辑进一步影响服务运行。
八、报告中心与历史趋势
当前报告中心支持:
- 查看任务级统计结果;
- 按问题和平台汇总采样数据;
- 下载 HTML 报告;
- 下载完整 JSON 数据;
- 导出与 Yao DeepSeek、豆包分析脚本兼容的数据结构。
对应接口示例:
GET /api/runs/:runId/report
GET /api/runs/:runId/report?format=html
GET /api/runs/:runId/report?download=1
GET /api/runs/:runId/report?format=yao&platform=deepseek
GET /api/runs/:runId/report?format=yao&platform=doubao
HTML 适合阅读和汇报,JSON 适合继续分析或接入其他工具。
历史趋势页面则按日期展示品牌出现率、有效样本和来源情况。进度条的轨道与数值使用独立布局,避免 100% 时覆盖相邻列。
需要区分的是:兼容数据导出已经接入,但排名分析、竞品分析和 Excel 报告尚未成为系统内置功能。
九、部署与验证
上游基础项目可以通过以下命令部署:
npm ci
npm run build:web
npm start
默认本地访问地址:
http://127.0.0.1:3030
以上命令获取的是上游基础版。本文介绍的二次开发内容,需要合入相应改造代码后才能使用。
当前开发环境使用 Node.js 24。此次改造完成后,前端构建通过,36 项自动化测试通过,覆盖任务配置、采样统计、采集结果标准化、进程取消和异常处理等逻辑。
OpenCLI 路径还需要在本机 Chrome 或 Edge 中安装浏览器扩展、完成平台登录并通过连接检查。当前已完成程序接入和相关自动化验证,真实采集仍需在浏览器桥接连接完成后进行端到端验证。
十、后续可以继续做什么?
下一阶段可以沿着三个方向完善:
对于 GEO 监测系统,采集到一次回答只是起点。更有价值的是把问题、采样条件、回答和证据完整保存,让每个统计数字都有可追溯的依据。


评论前必须登录!
注册