 网硕互联帮助中心
玩转大模型 第四篇:从官网到 API——先搞懂幻觉,再看清工程落地的 5 条路
💡 前三篇讲的都是模型侧:它是什么、怎么训出来、跑在什么硬件上。从这篇开始换视角——一个开发者到底怎么把大模型用起来。
最省事的路径显然是打开官网对话框,DeepSeek、千问这些国内顶尖模型基本都能免费用。但只要你试着做点真实需求,比如接进自己的系统、挂个私有知识库、跑一条多步骤流程,马上就会撞到一堵墙:官网没提供这些能力,你得去调 API。
然后第二个问题立刻出现:模型开始一本正经地胡说八道——编出不存在的论文、不存在的接口参数,语气还特别肯定。这就是幻觉。
这篇把工程落地的入场券讲清楚:AIGC 和 AGI 的区别、访问大模型的三种方式、幻觉到底是什么毛病,以及业界公认的 5 个落地模块分别解决什么问题。最后给一张选型路线。
1. 先校准两个词:AIGC 和 AGI
这两个缩写经常同屏出现,但它们完全不在一个维度上——一个是在做的事,一个是目标。
| 全称 | Artificial Intelligence Generated Content | Artificial General Intelligence |
| 中文 | 人工智能生成内容 | 通用人工智能 |
| 是什么 | 技术与应用体系 | 一种人工智能形态 |
| 一句话 | 用 AI 生成内容 | 能自主学习并解决大多数人类能解决的问题 |
| 现状 | 已经在大规模落地 | 尚未实现 |
AIGC 的完整定义:以大规模预训练模型(尤其是生成式基础模型)为核心,通过学习海量数据中的统计规律和语义结构,在人类输入提示或条件约束下,自动生成文本、图像、音频、视频、代码等多模态内容的技术与应用体系。
AGI 的完整定义:具备跨领域、跨任务的通用认知能力的人工智能形态,能在不同环境和目标下进行理解、学习、推理、规划与知识迁移,并在缺乏明确任务定义或规则约束的情况下,自主发现问题并制定解决策略,整体智能水平接近或超越人类。
1.1 通向 AGI 的两条路径
主流研究普遍认为有两条:
路径一 提升 基础模型 的通用能力
路径二 通过 Agent 设计 对模型能力进行组织与调度
→ 让模型具备 目标分解 / 长期规划 / 工具使用 / 环境交互 能力
→ 在复杂任务中表现出更接近通用智能的行为
这条判断其实直接解释了这个系列为什么最后要讲智能体:Agent 不只是"更好用的 ChatBot",它被认为是通向 AGI 的两条主干路之一。
2. 访问大模型的三种方式
2.1 在线平台:门槛最低
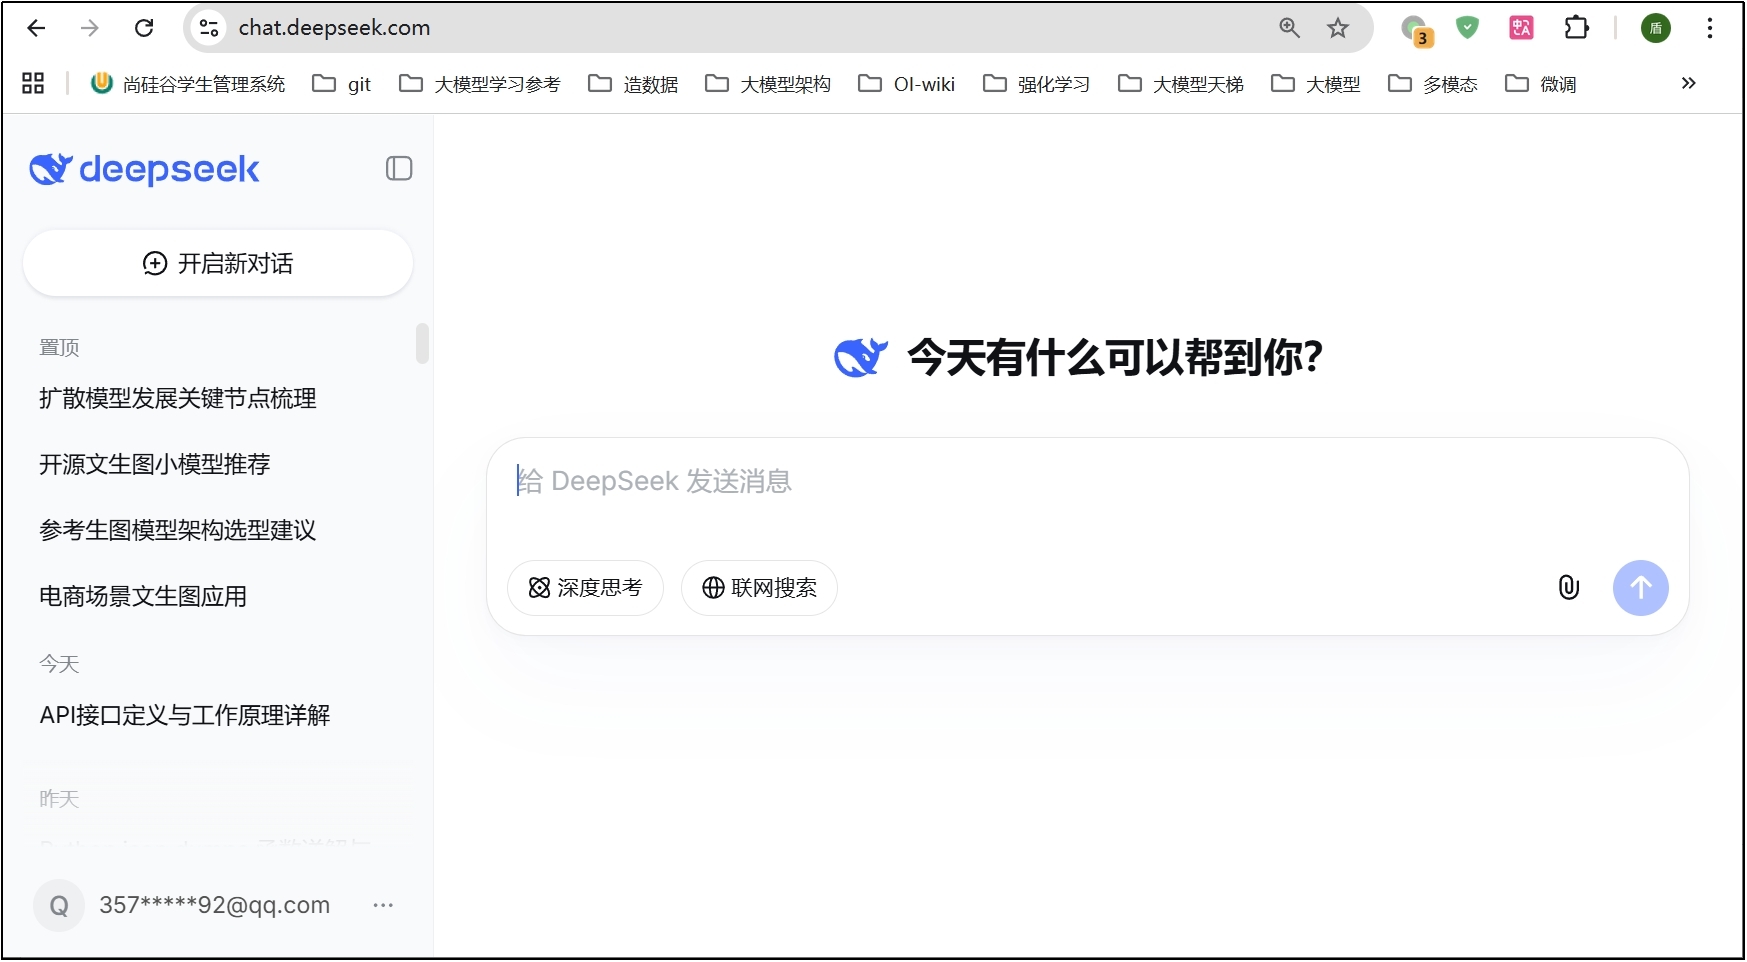
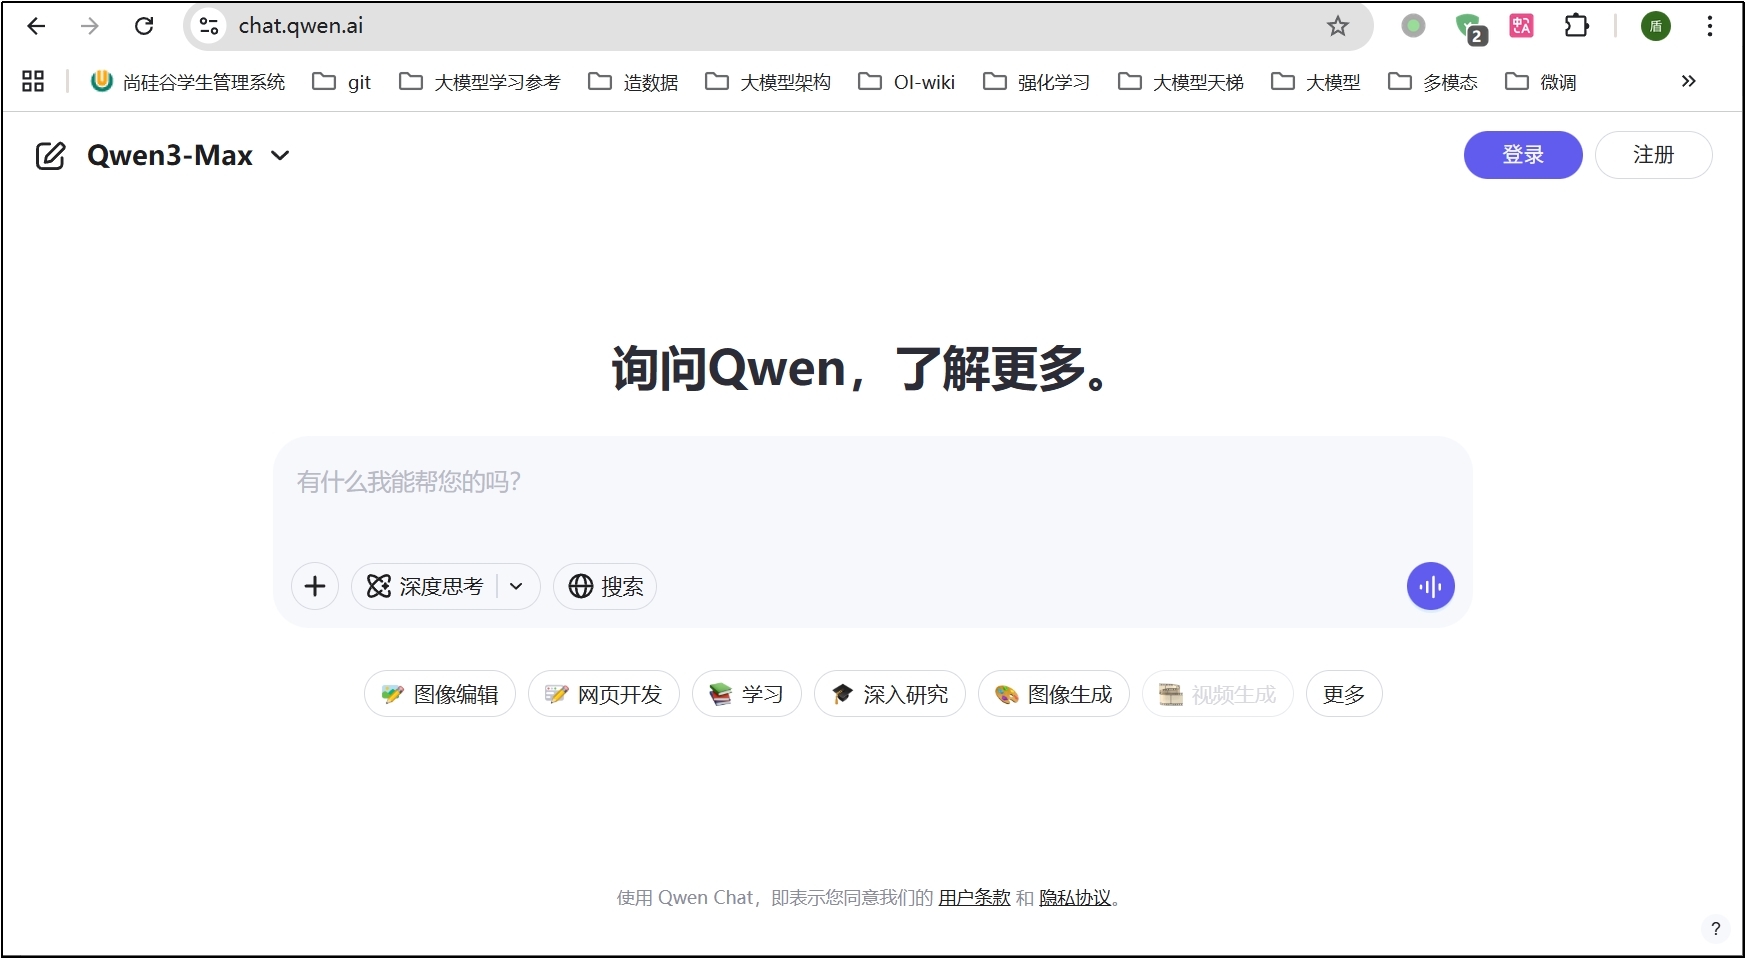
访问大模型厂商官网即可,国内的顶尖模型基本都能在官网免费使用。
| DeepSeek | https://chat.deepseek.com/ |
| Qwen | https://chat.qwen.ai/ |
2.2 为什么不直接用官网?
这个问题值得单独拎出来,因为很多人的技术路线是从这里开始分叉的。
如果只是和大模型对话,用官网是最合理的方式。但如果我们想用大模型做一些复杂任务,比如个人知识库、复杂的 Agent,而这类功能官网没有提供——此时就只能调用 API。
简单理解:
只想聊天问答 –> 官网,免费,零成本
要挂自己的知识库 –> 本地客户端(自带知识库功能)或自己写代码
要做复杂 Agent –> API + 框架(LangChain / LangGraph 等)
2.3 API 调用
大模型厂商基本都提供了 API 接口(基于 HTTP/HTTPS 协议的 REST API),访问接口即可调用大模型。API 接口通常是付费的,调用需要提供密钥。
以 DeepSeek 为例,开放平台在 https://platform.deepseek.com/ 。
方式一:命令行 curl
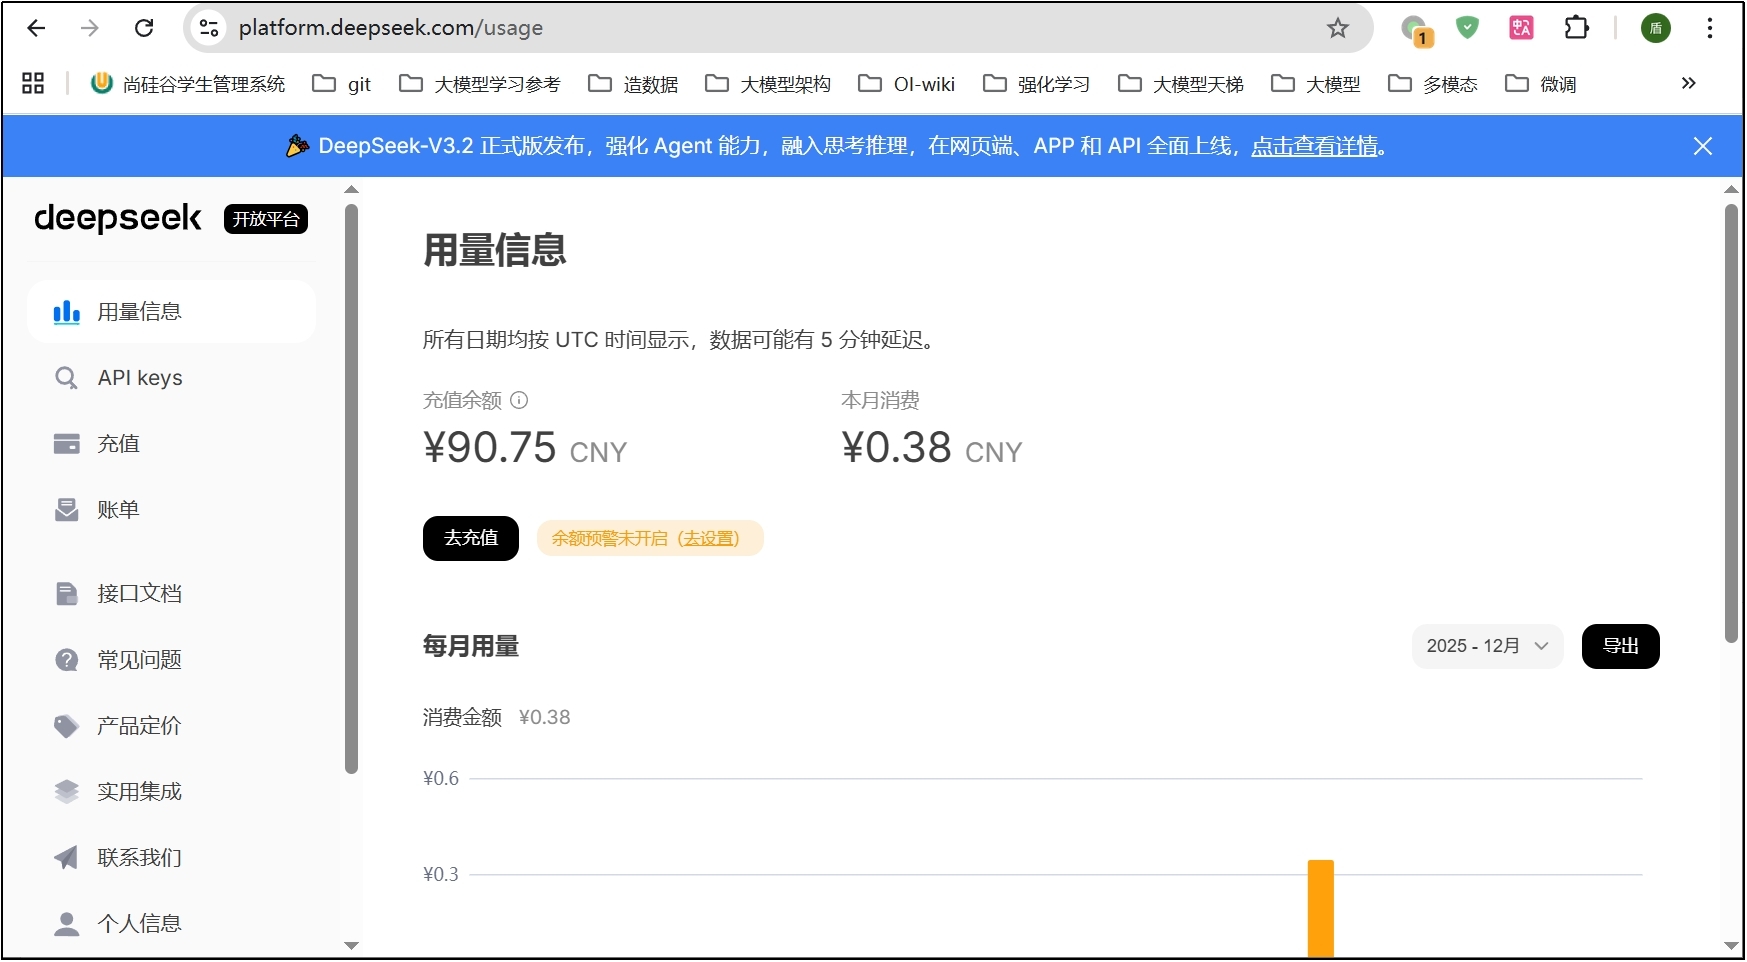
流程是:在官网获取 API 密钥和接口地址,把命令里的 ${DEEPSEEK_API_KEY} 替换成自己的 Key,然后在 Linux 命令行执行。
curl https://api.deepseek.com/chat/completions \\
-H "Content-Type: application/json" \\
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \\
-d '{
"model": "deepseek-chat",
"messages": [
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "你好"}
]
}'
返回日志:
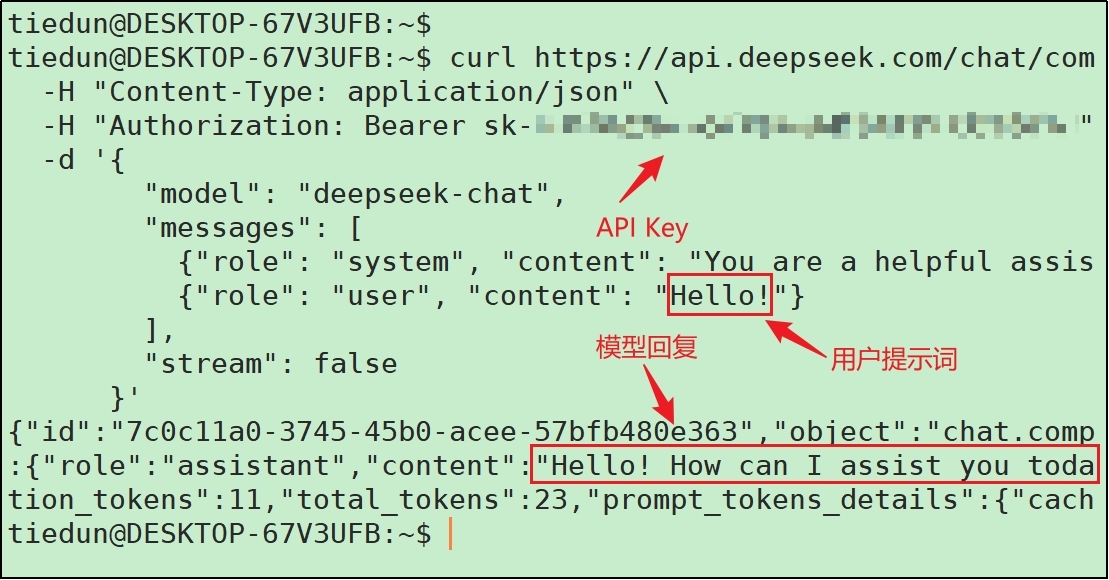
这里有个认知上很省心的一点:任何能调用 HTTP 接口的方式,都可以用来调用大模型接口。 除了 curl,还可以用 Python 代码、接口调试工具(如 Postman)等。大模型 API 没有任何特殊性,它就是普通的 REST 接口。
方式二:本地客户端(以 Cherry-Studio 为例)
命令行调用接口可读性差、交互成本高。市面上有很多本地大模型客户端,配置好接口服务就能像在线平台那样调用大模型,Cherry-Studio 是其中一种。
这时也可以选择自带知识库搭建功能的本地客户端——用 Cherry-Studio 既能自己配 API,也能直接用官方提供的模型。
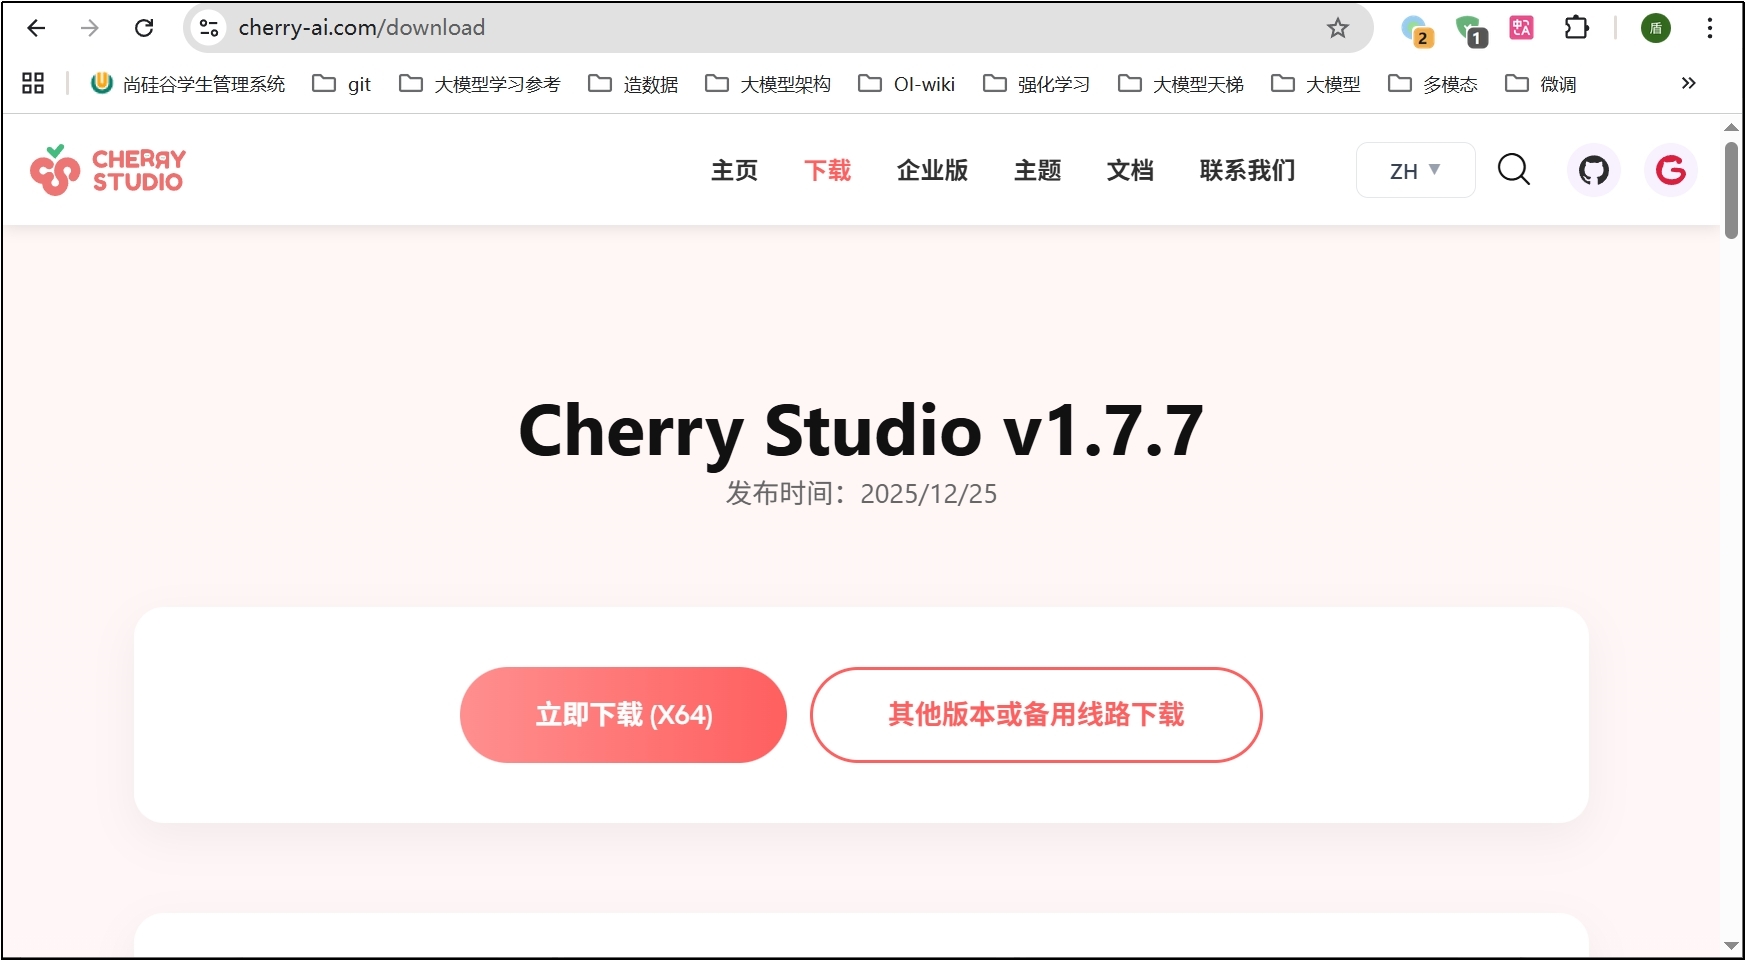
配置流程大致是:打开 API 配置界面 → 填密钥和地址 → 按官网的模型 ID 添加模型 → 检测连接 → 添加助手并配置默认模型 → 开始聊天。
一个实操细节:API 地址不需要填写 .com 后面的部分,Cherry-Studio 会自动补全,可以在输入框下方的"预览"里确认最终拼出来的地址。
方式三:代码调用
写代码发 API 请求,这是工程上真正的主路径(基于 LangChain、LangGraph 等框架,或纯 Python)。这部分内容在后续章节展开。
3. 幻觉:所有工程手段存在的理由
3.1 什么是幻觉
大模型的幻觉(Hallucination) 是指模型在生成内容时,给出看似合理、语言流畅,但实际上不正确、无法验证或与事实不符的信息。
这种输出往往具有较强迷惑性,因为它符合语法、风格和上下文预期,但在事实性、可追溯性或逻辑一致性上存在问题。
3.2 为什么会产生
模型之所以会"编",是因为在以下条件叠加时,它会给出一个概率上最合理的答案:
- 训练语料中缺乏相关信息
- 提示词存在歧义或不完整
- 模型被要求"必须回答"
- 超出模型知识边界或时间边界
注意第三条——"被要求必须回答"本身就是幻觉的成因。这条后面在提示词工程里会有对应的解法:允许模型说"我不知道"。
3.3 五种常见幻觉类型
| 事实性幻觉 | 编造不存在的事实 | 虚构论文、法律条文、接口 |
| 源引用幻觉 | 编造参考来源 | 不存在的 DOI / 文献 |
| 逻辑幻觉 | 推理链条自洽但前提错误 | 错误因果关系 |
| 过度自信幻觉 | 错误但语气极其肯定 | "100% 确定"式回答 |
| 工具/代码幻觉 | 调用不存在的 API / 参数 | 编造 SDK 方法 |
做后端的同学对最后一行应该最有共鸣:让模型写它不熟的 SDK 调用,方法名拼得漂漂亮亮,参数列表看着完全合理,一跑编译报错——这就是工具/代码幻觉。
3.4 为什么幻觉无法彻底消除
从系统设计角度看,幻觉是不可完全消除的系统性问题:
因此行业共识是:幻觉只能被"控制、缓解、检测",不能被彻底消灭。
Q:为什么第 3 点说 RLHF 反而加重了幻觉?
因为偏好数据里,"给出一个具体答案"通常比"我不知道"得分更高。模型被训练成倾向于回答,而不是承认边界。这不是训练做错了,而是**"有用"和"诚实"在偏好数据里天然冲突**。所以工程上要靠外部机制补:引用溯源、允许拒答、事实核对——这也正是后面 RAG 和 Agent 要干的事。
4. 工程落地的 5 大模块
既然大模型能力强大但不能直接用,就要做工程化加工。从工程实现角度看,大模型应用主要分为五个模块:提示词工程、RAG、微调、续训、智能体开发。
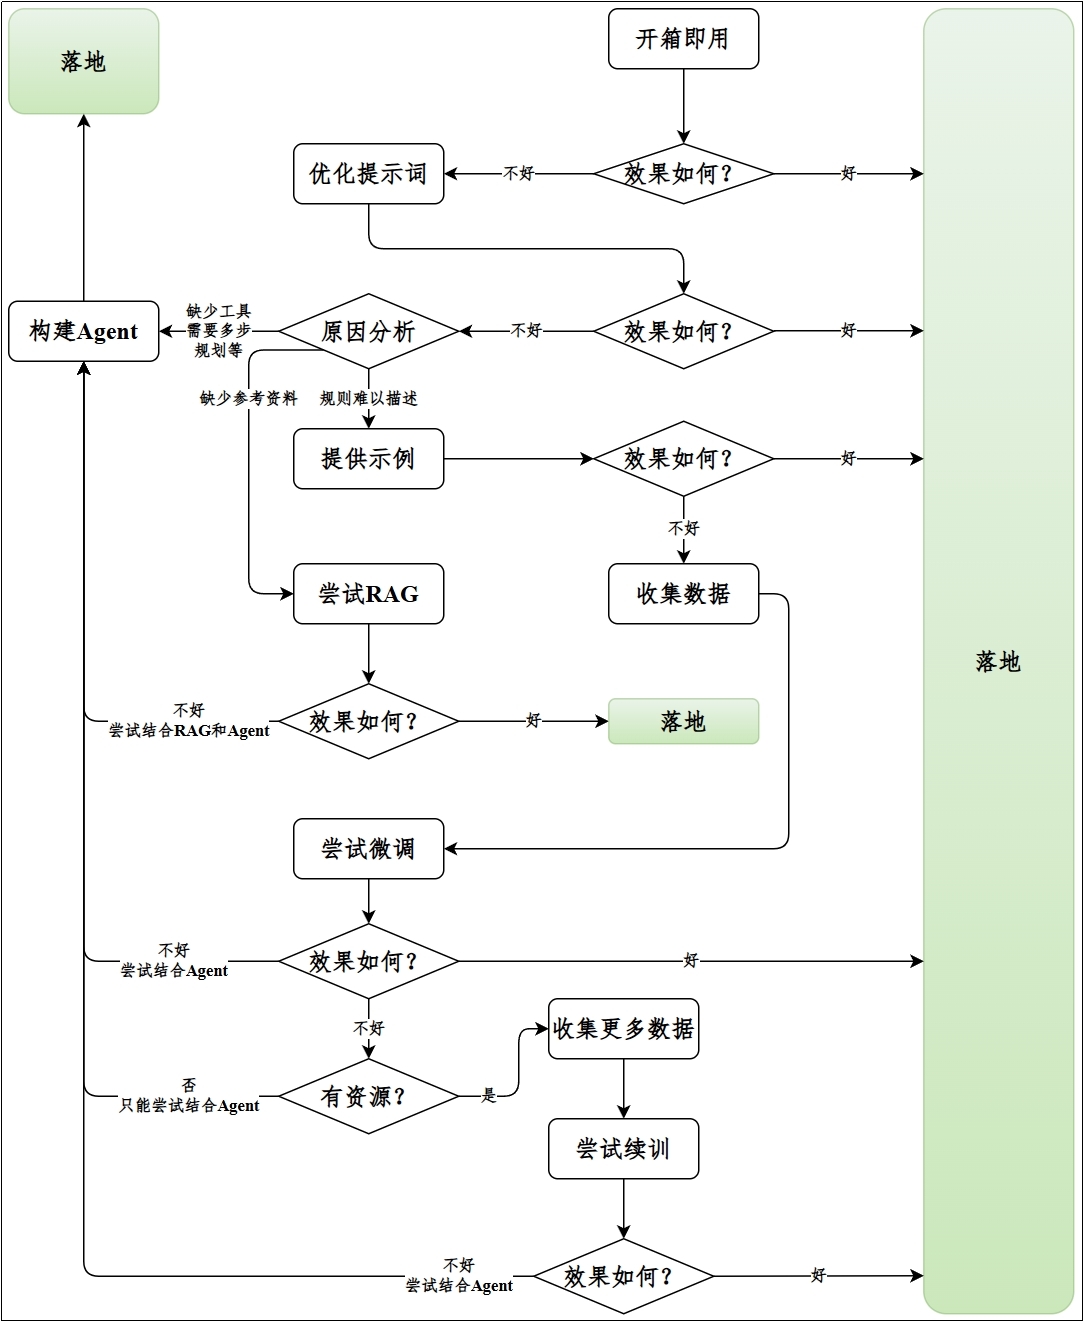
(1)提示词工程
最廉价的方式,开箱即用,直接调用模型。通过提示词优化和提供示例来优化输出效果。
(2)RAG
当提示词工程达不到预期,且原因是缺少参考知识时,尝试 RAG,调用外部知识库。token 消耗往往比开箱即用略高,开发略微复杂。
(3)微调
如果提示词工程效果不好,且原因是指令遵循能力较差、风格/话术不一致,可以尝试微调。需要收集数据,并且要有硬件资源。
(4)续训
如果微调效果仍不理想,且问题来自模型对领域语言/知识分布的系统性缺失,可以考虑收集更多数据做续训(预训练),前提是有充足的硬件资源。续训的硬件开销通常远高于微调。
(5)智能体开发
当其它方式都无法解决问题时,都可以尝试和智能体开发结合。智能体会涉及大模型的多次调用,token 开销较大,开发难度较高。
但经济账有意思的地方在这:智能体单次开销不及微调和续训,长期成本却可能更高——因为微调和续训是一次性投入,智能体是每次调用都要付费。
4.1 五个模块横向对比
| 提示词工程 | 需求没表达清楚 | 否 | 最低 | ⭐ | 无 |
| RAG | 缺外部/最新知识 | 否 | 低-中 | ⭐⭐ | 知识库 |
| 微调 | 指令遵循差、风格不稳 | 是(部分) | 中(一次性) | ⭐⭐⭐ | 标注数据 + 硬件 |
| 续训 | 领域知识系统性缺失 | 是 | 高(一次性) | ⭐⭐⭐⭐ | 海量语料 + 大量硬件 |
| 智能体 | 多步骤、需工具、需状态管理 | 否 | 长期累积高 | ⭐⭐⭐⭐⭐ | 工具生态 + 编排 |
4.2 决策路线:如果是我,按这个顺序试
课件给的是分类,落到实操上其实是一条成本递增的排查链:
效果不满意
↓
先改提示词(最便宜) → 还不行 ↓
是不是缺资料/最新信息? ── 是 ─→ 上 RAG → 还不行 ↓
是模型本身不听指令、风格漂移?── 是 ─→ 微调 → 还不行 ↓
是模型对整个领域语言/知识系统性不懂?─ 是 ─→ 续训
↓
任务本身是多步骤 / 要调工具 / 要管状态 ─────→ 智能体(可与上面任意一层组合)
注意最后一条不是"兜底"而是"正交":智能体可以和前面任何一层叠加使用。微调效果不理想时,同样可以靠 Agent 引入规则校验、结构化约束、事实核对来提升质量。
最后总结
- AIGC 是当下,AGI 是方向;而 Agent 被认为是通往 AGI 的两条主干路之一,这是它值得单独花一篇讲的原因。
- 访问方式三选一,按需求定:聊天用官网;要复杂能力(知识库、Agent)就得调 API;本地客户端是低成本的中间态。
- API 没有任何特殊性,它就是普通 REST 接口,任何能发 HTTP 请求的工具都能调。
- 幻觉是系统性问题,不是 bug:LLM 是生成模型而非知识库,加上 RLHF 奖励"有用"、生成任务追求完整,决定了它只能被控制、缓解、检测。
- 五个模块是一条成本递增的排查链:提示词 → RAG → 微调 → 续训,智能体则可以正交叠加在任意一层上。
- 笔者(后端 & 架构)的策略是:除非有明确的合规或数据隔离要求,前两步(提示词 + RAG)能覆盖 80% 的业务需求;一上来就想微调的团队,大多数是在为一个还没定义清楚的需求买单。
第五篇就沿着这条链往下走,把最便宜也最容易被低估的那一层讲透:提示词工程。
参考资料 & 致谢
[1] 尚硅谷大模型技术之大模型概述 V1.0.3-课件 [2] DeepSeek 开放平台 [3] Cherry-Studio 下载-官网 [4] LangChain 官网 [5] OpenAI API 参考文档


评论前必须登录!
注册