 网硕互联帮助中心
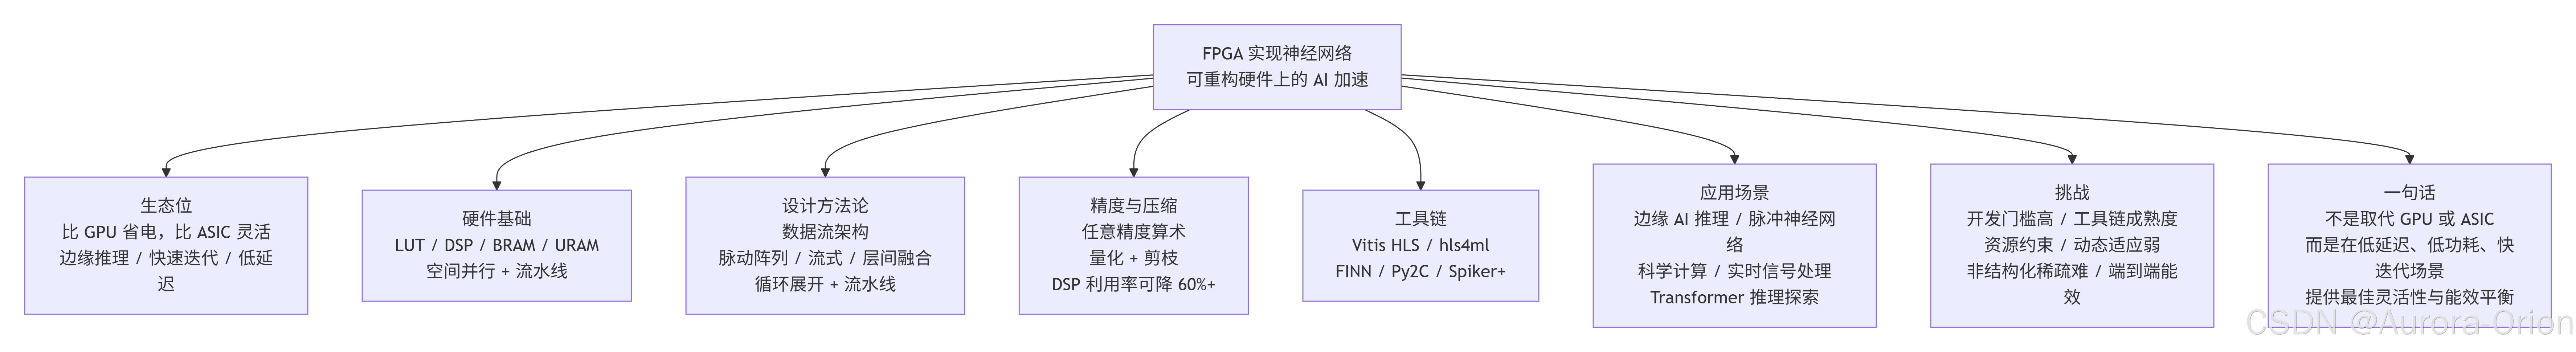
FPGA 实现神经网络,本质上是把神经网络的“计算图”映射到一块可重构的硬件画布上——你可以在上面“画”出任意形状的计算单元、任意精度的数据通路、任意深度的流水线。它不是 GPU 的通用并行,也不是 ASIC 的固定电路,而是在两者之间占据了一个独特生态位:比 GPU 更省电、比 ASIC 更灵活,尤其适合边缘推理、低延迟、模型快速迭代的场景。
一、为什么是 FPGA?
1.1 三种硬件的三角关系
理解 FPGA 的价值,需要把它放在 GPU 和 ASIC 的对比中看:
| 灵活性 | 高,编程即可 | 极高,电路可重构 | 低,流片后固定 |
| 能效 | 中 | 高 | 极高 |
| 延迟 | 中 | 低且确定 | 极低 |
| 开发成本 | 低 | 中 | 极高 |
| 适合阶段 | 训练/大吞吐推理 | 边缘推理/快速迭代 | 大规模量产 |
FPGA 占据的是“中间地带”:它不像 GPU 那样为通用并行牺牲能效,也不像 ASIC 那样一旦流片就无法修改。对于模型快速迭代、小批量部署、或者需要定制数据通路的场景,FPGA 的可重构性本身就是核心价值。
1.2 与 GPU 的能效对比
在推理场景中,FPGA 的能效通常优于 GPU。一项基于 PYNQ-Z2 的 CNN 加速器研究显示,其能效达到 114 GOP/s/W,相比同一平台上 ARM 核心的软件实现提升了 3.5 倍。另一项工作在 ZYNQ XC7Z045 上达到了 102 Gops/W 的能效,功耗效率相比其他方案提升了超过 38.7%。
1.3 与 ASIC 的定位差异
ASIC 的能效最高,但它的非经常性工程成本极高,且流片后无法修改。FPGA 虽然单芯片成本和能效不如 ASIC,但它允许在部署后重新配置,这对模型频繁更新、或者需要支持多种网络架构的场景至关重要。
二、FPGA 的硬件基础
2.1 可重构的逻辑画布
FPGA 的核心是一大片可配置逻辑块和可编程互连。你可以把它们想象成乐高积木:每个逻辑块可以实现简单的组合逻辑或时序逻辑,互连决定了这些块之间如何连接。通过配置比特流,你可以定义任意数字电路。
2.2 关键硬件资源
| LUT | 查找表,实现任意逻辑函数 | 激活函数、控制逻辑、小规模乘法 |
| DSP | 数字信号处理单元,硬件乘法器 | 卷积、矩阵乘法 |
| BRAM | 块状存储器,片上存储 | 权重缓存、特征图缓存 |
| URAM | 超大容量片上存储(部分型号) | 大模型权重存储 |
| DSP48 | 增强型 DSP,支持乘累加 | 卷积核心 |
FPGA 的并行性来自这些资源的空间分布:你可以在同一时刻让数百个 DSP 同时做乘法,让数十个 BRAM 同时提供数据,让流水线各级同时工作。
三、核心设计方法论
3.1 数据流架构
FPGA 神经网络加速器最核心的设计模式是数据流。与 CPU 的指令流不同,数据流架构中,数据像水流一样穿过一系列计算单元,每个单元在数据到达时立即处理,无需等待指令。
典型的数据流模式包括:
-
脉动阵列:计算单元按网格排列,数据从边缘流入、对角流出,每个单元做乘累加后传给邻居。这种结构在 CNN 卷积中非常高效。
-
流式数据流:层与层之间直接流式连接,中间结果不写回外部存储。
-
层间融合:把相邻的计算密集层紧密耦合,在一个流水线中顺序执行,减少片外访存。
3.2 并行策略
FPGA 可以在多个维度上并行:
-
输出通道并行:同时计算多个输出通道。
-
输入通道并行:同时处理多个输入通道。
-
空间并行:同时计算多个输出像素。
-
流水线并行:不同层或同一层的不同阶段重叠执行。
并行度的选择需要在资源占用、吞吐量、功耗之间权衡。
3.3 循环展开与流水线
在 HLS(高层次综合)中,循环展开和流水线是最基本的优化手段。展开让多个迭代并行执行,流水线让不同迭代的阶段重叠。二者的组合可以显著提升吞吐量。
3.4 精度定制
FPGA 最独特的优势之一是任意精度算术。你可以为每一层、甚至每一个张量单独定义位宽:整数部分几位、小数部分几位、是否有符号。8 位定点加法器的能耗仅为 32 位版本的 33%,8 位乘法器更是仅用 6.45% 的能量。这种细粒度的精度控制是 GPU 和 ASIC 都难以做到的。
四、模型压缩与硬件协同
4.1 量化
量化是把浮点权重和激活值转换为低位宽定点数的过程。常见的量化策略包括:
-
训练后量化:模型训练完成后直接转换。
-
量化感知训练:在训练中模拟量化误差,精度损失更小。
量化不仅减少存储和带宽,还让计算单元更小、更快、更省电。
4.2 剪枝
剪枝去除不重要的权重或神经元,减少计算量。但剪枝产生的非结构化稀疏(零值不规则分布)给 FPGA 硬件带来挑战:不规则的数据访问模式难以高效利用并行资源。
解决方案包括结构化剪枝(按通道或块剪枝)和硬件感知的剪枝策略,让稀疏模式与硬件数据流匹配。
4.3 量化+剪枝的联合效果
一项基于 hls4ml 的 CNN 研究显示,量化+剪枝的组合使 DSP 资源利用率降低了 63%,而分类精度损失极小。未压缩模型在 MNIST 上达到 99.24% 的测试准确率。另一项研究实现了 8 位量化、50% 剪枝的 CNN 直接部署到 Artix-7 FPGA 上。
4.4 算法-硬件协同设计
最有效的优化不是先设计模型再想硬件,而是模型和硬件一起设计。CoDAC 框架把剪枝、量化和硬件优化统一在一个 AutoML 闭环中,让硬件反馈驱动模型压缩策略的调整。
五、工具链与框架
5.1 HLS:从 C/C++ 到硬件
高层次综合让软件开发者用 C/C++ 描述算法,工具自动生成 RTL。Vitis HLS 是 Xilinx(AMD)的主流 HLS 工具,支持 C/C++ 到 HDL 的转换。
5.2 hls4ml:科学计算中的标准工具
hls4ml 是粒子物理和科学计算领域最流行的 FPGA 神经网络部署工具。它从 Keras/TensorFlow/PyTorch 模型直接生成 HLS 代码,支持定点量化,并自动处理流水线和并行化。大量边缘 AI 研究都基于 hls4ml 构建。
5.3 FINN:二值神经网络专用
FINN 是 Xilinx 开发的二值神经网络框架,专门针对 1 位权重和激活的网络。它的数据流架构充分利用了二值网络的极低计算复杂度,在极低功耗下实现高速推理。
5.4 Py2C / Py2RTL:从 Python 到 RTL
Py2C 是一个自动化框架,把 AI 模型从 Python 转换为 C,再与 Vitis HLS 集成形成 Py2RTL 流程,支持 VGG、ResNet、InceptionNet、YOLO 等多种架构,并允许用户灵活调整精度参数。
5.5 Spiker+:脉冲神经网络
Spiker+ 是一个开源框架,用于生成优化的 SNN 加速器。它支持网络拓扑、神经元模型和量化的高层描述,自动生成可部署的 HDL。
六、典型应用场景
6.1 边缘 AI 推理
这是 FPGA 最核心的应用场景。边缘设备面临功耗、延迟、隐私三重约束,FPGA 在这三点上都有优势。
-
图像识别:MNIST 上的 CNN 加速器在 PYNQ-Z2 上达到 96% 准确率,峰值功耗仅 1.82W。
-
脑肿瘤诊断:AlexNet 在 ZCU102 上部署,训练准确率 97.8%,时序延迟仅 7.215 ns。
-
船舶识别:Zynq-7020 上的 VHDL CNN 加速器用于嵌入式海事船舶识别。
-
心脏超声:8 位量化、50% 剪枝的 CNN 部署在 Artix-7 上,用于急诊和资源有限诊所的床旁心衰筛查。
6.2 脉冲神经网络
SNN 的事件驱动和稀疏激活特性与 FPGA 的可重构性天然匹配。FPGA 被认为是 SNN 加速的理想候选平台,在能效上优于 CPU 和 GPU。
-
多核神经形态架构:在 FPGA 上部署,支持深度 SNN 训练,在交通标志识别上达到 94.75% 准确率,持续学习使混合新旧数据的推理准确率提升了 17.97%。
-
XOR-Spikformer:脉冲 Transformer 的 FPGA 加速器,峰值吞吐 288 GSOP/s,能效 57.67 GSOP/W,仅使用 47.2K LUT 和 63 BRAM,零 DSP。
-
无乘法器 SNN:在 ZCU104 上验证的可训练 SNN,通过敏感噪声阈值机制保持了噪声鲁棒性。
6.3 科学计算与实时信号处理
-
SAR 图像识别:全流水线 SNN 加速器,吞吐 2069 GOPS,仅用 185K LUT 和 78 DSP。
-
ECG 信号分类:FPGA 上的 DNN 用于心电图分类,是医疗边缘设备的典型应用。
-
直流串联电弧故障检测:hls4ml 工具流部署深度学习模型,用于实时故障检测。
6.4 生成式 AI 与 Transformer
FPGA 也在向 Transformer 推理延伸。一项研究显示,FPGA 在 Transformer 推理上的能效通常优于 GPU 基线。
七、挑战与局限
7.1 开发门槛高
FPGA 开发传统上需要硬件设计专业知识,学习曲线陡峭。虽然 HLS 工具降低了门槛,但要实现接近手写 RTL 的效率,仍然需要理解流水线、数据流、资源约束等硬件概念。
7.2 工具链成熟度
HLS 工具在灵活性上仍有局限:许多工具只支持标准架构(VGG、ResNet),对自定义层的支持不足。调试和验证周期也比软件长得多。
7.3 资源约束
FPGA 的片上资源有限。大规模模型需要分块处理或权重流式加载,这增加了设计复杂度。量化虽然能大幅减少资源需求,但过度的量化会损害精度。
7.4 动态适应能力
FPGA 在运行时重新配置需要时间和功耗。对于动态变化的工作负载,FPGA 的适应速度不如 GPU 的软件调度灵活。
7.5 非结构化稀疏的难题
剪枝产生的非结构化稀疏对 FPGA 不友好。规则的数据流被打乱,并行效率下降。结构化剪枝或硬件感知剪枝是必要的缓解手段。
7.6 能效的“真实”与“理论”
虽然 FPGA 的计算能效很高,但端到端能效受限于光电/电光转换、外部存储访问、以及配置功耗。在实际系统中,能效优势可能被这些开销部分抵消。
八、口述总结
“FPGA 实现神经网络,核心思路是把计算图映射到可重构硬件上。FPGA 的独特价值在于它的生态位:比 GPU 省电,比 ASIC 灵活。在能效上,FPGA 推理通常优于 GPU,实测能效可达 100 GOP/s/W 以上;在灵活性上,ASIC 流片后无法修改,FPGA 可以重新配置,适合模型快速迭代和边缘部署。设计方法论的核心是数据流架构,包括脉动阵列、流式数据流和层间融合。FPGA 最独特的优势是任意精度算术,8 位乘法器的能耗只有 32 位的 6.45%。模型压缩方面,量化+剪枝的组合可以把 DSP 资源利用率降低 60% 以上,而精度损失极小。工具链方面,hls4ml 是科学计算领域的标准工具,FINN 适合二值网络,Vitis HLS 是通用 HLS 平台。应用场景集中在边缘 AI 推理、脉冲神经网络、科学信号处理。挑战主要是开发门槛高、工具链成熟度不足、非结构化稀疏难以高效处理、以及动态适应能力有限。面试里如果被追问,我会强调:FPGA 的价值不是在所有场景替代 GPU 或 ASIC,而是在低延迟、低功耗、模型快速迭代的边缘场景中提供最佳的灵活性与能效平衡;量化剪枝和 HLS 工具是降低门槛的关键,但硬件思维仍然是做好 FPGA 神经网络设计的核心能力。”
九、一句话收束
FPGA 实现神经网络的本质,是在一块可重构的硬件画布上,为每一个模型“量身定做”一套计算电路。 它牺牲了 GPU 的编程便利性,换来了精度、数据流和并行度的完全自由;牺牲了 ASIC 的极致能效,换来了随时可以重新配置的灵活性。在边缘 AI 从“能跑”走向“跑得好、跑得省”的过程中,FPGA 正在从备选方案变成核心选项之一。


评论前必须登录!
注册