 网硕互联帮助中心
🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》 👉 《YOLOv9实战》 👉 《YOLOv10实战》 👉 《YOLOv11实战》 👉 《YOLOv12实战》 👉 以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv10 核心模块改进与涨点篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐⭐☆(高级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
全文目录:
- 写在前面
- 一、承上启下:从验收报告到改进决策
-
- 1.1 上一节留下的"悬案"
- 1.2 先想清楚你的"硬约束"是什么
- 二、涨点方向:让模型"看得更准"的系统性方法
-
- 2.1 为什么精度上不去——从根因分析开始
- 2.2 注意力机制:性价比最高的涨点手段
-
- 2.2.1 通道注意力(Channel Attention)
- 2.2.2 双重注意力:CBAM
- 2.2.3 轻量级注意力:ECA-Net 与 SimAM
- 2.2.4 位置感知注意力:Coordinate Attention
- 2.3 Neck 改进:特征融合的"精装修"
-
- 2.3.1 为什么默认的 PAN 不够?
- 2.3.2 BiFPN:可学习的加权特征金字塔
- 2.3.3 P2 小目标检测层:直接扩大小目标的"战场"
- 2.4 损失函数改进:改"打分规则"而非"选手"
-
- 2.4.1 从 IoU 到 CIoU:回归损失的演进
- 2.4.2 针对小目标的 NWD 损失
- 三、提速方向:让模型"跑得更快"的工程化路径
-
- 3.1 速度的本质:FLOPs 不等于延迟
- 3.2 轻量卷积模块替换:最"温和"的提速方式
-
- 3.2.1 GhostConv:用"廉价操作"生成特征
- 3.2.2 FasterBlock:部分卷积(PConv)的工程化实现
- 3.2.3 深度可分离卷积:轻量化的"老祖宗"
- 3.3 重参数化:训练时"养精蓄锐",推理时"一招制敌"
- 四、轻量化方向:让模型"装得下"的骨干替换策略
-
- 4.1 轻量化与提速的本质区别
- 4.2 MobileNetV3:移动端的集大成者
- 4.3 ShuffleNetV2:为实际速度而生
- 4.4 EfficientNet:复合缩放的优雅与局限
- 五、三大方向的协同与权衡:打破"不可能三角"的边界
-
- 5.1 精度-速度-体积的"帕累托前沿"
- 5.2 组合改进的"1+1>2"效应与"1+1<1"陷阱
- 六、四步决策框架:从场景需求到改进方案的完整推导
-
- 6.1 第一步:明确部署硬件与计算预算
- 6.2 第二步:评估实时性要求
- 6.3 第三步:定位精度短板类型
- 6.4 第四步:按优先级制定改进路线
- 七、量化评估体系:用数字说话
-
- 7.1 五个核心评估指标
- 7.2 基线画像代码(完整版)
- 7.3 实验记录与对比框架
- 八、三项工程基本原则
-
- 8.1 单变量原则(Single Variable Principle)
- 8.2 基线对比原则(Baseline Reference Principle)
- 8.3 可复现性原则(Reproducibility Principle)
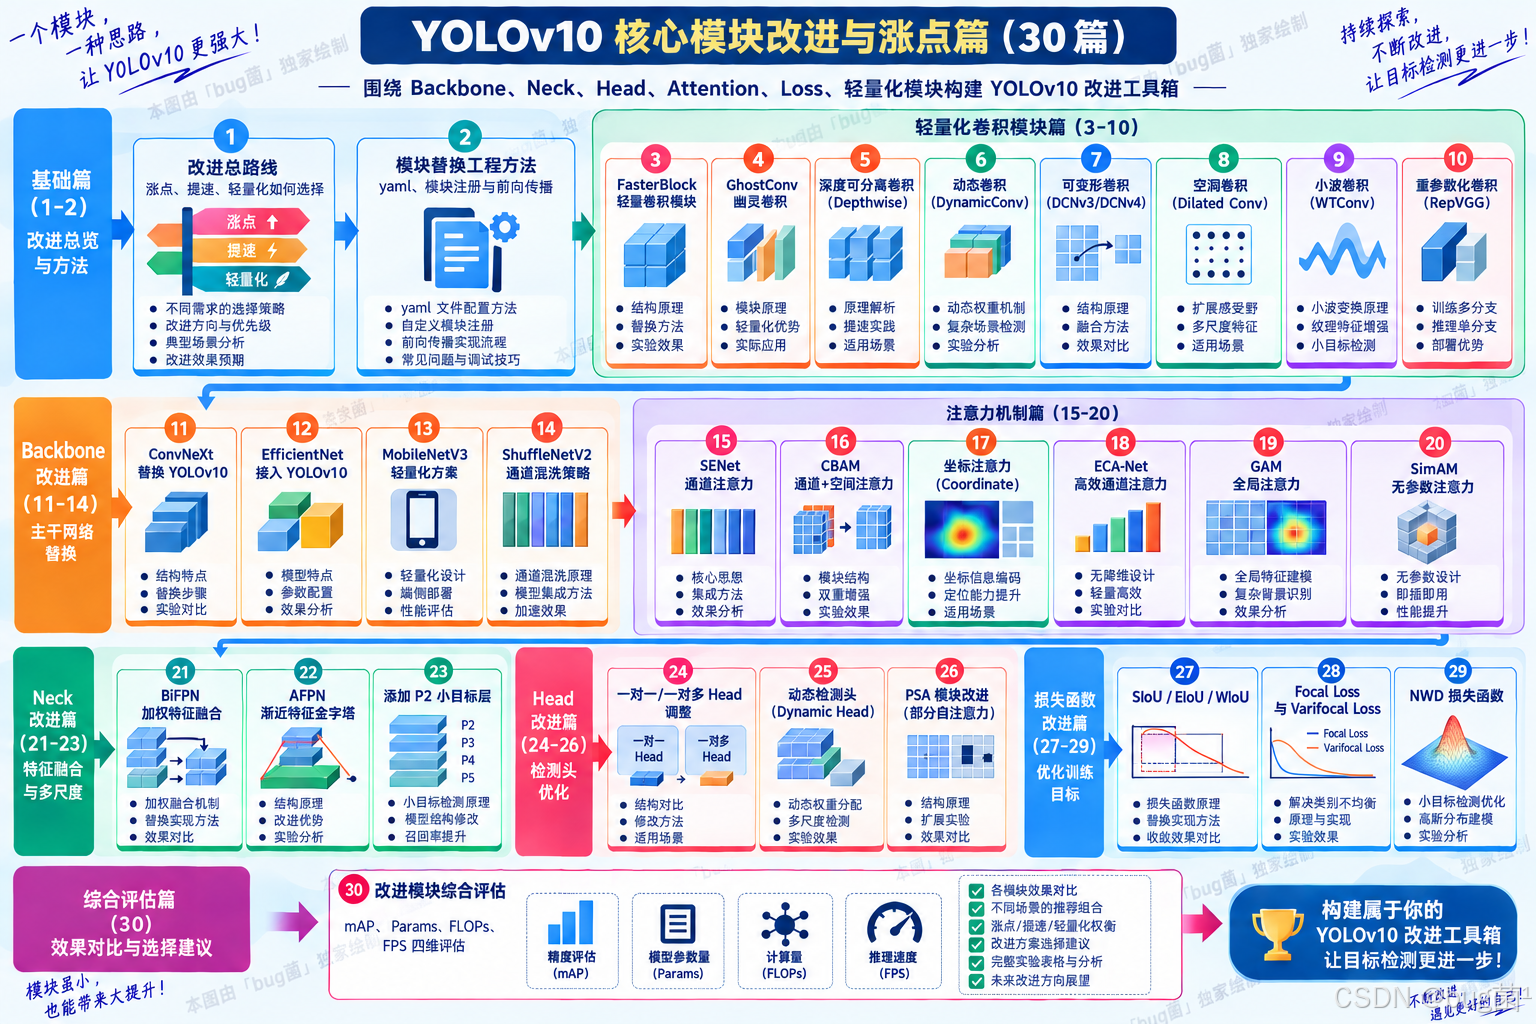
- 九、第六章全景地图:29 节改进工具箱的整体布局
- 十、真实场景的改进决策演练
-
- 案例一:工业 PCB 缺陷检测(精度优先)
- 案例二:智慧城市多路摄像头并发推理(提速优先)
- 案例三:无人机航拍目标检测(轻量化优先)
- 十一、常见误区与避坑指南
- 本节小结
- 📌 附录
-
- 👨💻 About Me · 关于作者
写在前面
经过第五章整整 15 节的系统训练,我们把 YOLOv10 从数据准备、模型训练,一路折腾到推理部署和性能分析,最终拿出了一份"模型验收报告"。那份报告里的数字,我相信不少同学看完之后跟我当时的感受一样——有几个指标让人比较满意,但有几个数字像鱼刺一样卡在喉咙里,不上不下,让人忍不住想深究:这里是不是还差点什么?这几个地方是不是还有改进空间?
这种"不甘心",其实是做工程最宝贵的驱动力。
但问题是,从"我想改进"到"我知道该怎么改进",中间隔着一道不小的鸿沟。很多同学的第一反应是:赶紧去搜论文、翻博客,看谁的模块涨点最多,二话不说就往自己的代码里塞。今天加一个 CBAM,明天换一个 BiFPN,后天再把 Loss 改成 WIoU——训练跑完,mAP 反而掉了,FPS 也掉了,还搞不清楚到底是哪一步"帮了倒忙"。这种"撒网式"的改进,是工程实践里最常见,也最低效的一种反模式。
我自己带过不少人,也见过太多这样的情况。说实话,这不是能力问题,而是方法论问题——在动手之前,没有想清楚"我要解决什么问题"、“这个改进适不适合我的场景”、“我怎么衡量它有没有效”。
这也正是今天这一节要干的事情:在正式进入第六章的"硬核手术"之前,先把改进的底层逻辑、决策框架、评估体系梳理清楚,把"地图"画出来,再谈进山探险。这一节没有复杂的网络结构代码,但我个人觉得,它可能是整个第六章里最值得反复来看的一节。
好,废话到此。咱们正式开始。
一、承上启下:从验收报告到改进决策
1.1 上一节留下的"悬案"
在上期《YOLOv10【第五章:推理、验证与性能分析篇·第15节】YOLOv10 模型验收报告——精度、速度、稳定性三维评估!》内容中,我们给基线模型 YOLOv10n 出了一份三维评估报告,精度、速度、稳定性三个维度都有了量化数据。核心结论浓缩如下:
| 精度(mAP50-95) | 0.385 | 小目标类别 AP 偏低,最差类别只有 0.25 |
| 速度(FPS) | ≈168(RTX 3060,FP16,640×640) | 后处理耗时已极低,主干是计算瓶颈 |
| 稳定性 | 标准差 < 2%,显存无泄漏 | 整体健康,无明显异常 |
这三个结论,对应的是三个不同的"改进动机":
- 小目标精度偏低 → 我想涨点
- 主干是计算瓶颈 → 我想提速
- 若要部署到算力受限的边缘设备 → 我想轻量化
这三个动机,对应三条改进路线,它们的技术手段、评估指标、甚至优化方向,都有显著差异,有时候还互相冲突。
这就是今天这一节要解决的核心问题:面对这三条路线,你该怎么选?
1.2 先想清楚你的"硬约束"是什么
在讲技术之前,有一个更重要的前置问题需要回答:你的模型最终要跑在什么地方?
这个问题决定了你的改进方向的"优先级排序"。我把常见的部署场景分成三类:
第一类:云端服务器/高性能工作站。GPU 算力充足(比如 A100、V100、RTX 3090),显存至少 16GB,模型体积基本不是问题。这类场景的改进逻辑是:精度优先,在精度达标的前提下考虑吞吐量。这里的"吞吐量"主要是为了节省推理成本(降低云端 GPU 时间费用)或者支持更多并发请求,但不是"能不能跑起来"的生死问题。
第二类:边缘计算盒子/工控机/Jetson 系列。算力中等,比如 Jetson AGX Xavier(32TOPS)、Jetson Orin Nano(40TOPS),显存通常 8-16GB,有时候跟主内存共享。这类场景需要在精度和速度之间做一个比较审慎的权衡:精度要够用,速度要达标(比如满足视频流的帧率要求),模型体积可以适当宽松但不能太离谱。
第三类:嵌入式芯片/移动端/MCU。这才是真正的"硬约束"场景——算力以 TOPS 甚至 GOPS 计,显存/内存以 MB 计,功耗以毫瓦计。这类场景的改进逻辑完全不同:首先保证模型能跑起来(参数量和计算量不超过芯片上限),其次才谈精度。轻量化在这里不是"锦上添花",而是"生死存亡"。
把这个"部署场景分类"和"三大改进方向"对应起来,大概是这样一个关系:
云端服务器 → 涨点优先(精度驱动)
边缘盒子 → 涨点 + 提速协同(精度–速度双目标)
嵌入式芯片 → 轻量化优先,再辅以低成本涨点
当然,现实项目远不会这么整齐。大多数真实场景都是"混合型约束"——比如你的部署目标是 Jetson Orin NX(16TOPS),既有算力上限,又对小目标精度有强要求。这时候就需要用到我们后面要讲的"决策框架",在多个约束之间找到一个最合理的优先级排序。
二、涨点方向:让模型"看得更准"的系统性方法
2.1 为什么精度上不去——从根因分析开始
很多同学在讨论"涨点"的时候,直接上来就问"加哪个注意力模块好"。这个问题没有通用答案,因为它忽略了一个更根本的前置问题:你的精度为什么上不去?
精度瓶颈可以来自以下几个不同的层面,不同的根因,对应的改进手段完全不同:
根因一:特征表达能力不足。模型对目标的局部纹理、全局语义、几何形态等维度的特征提取能力有限,导致不同类别的目标在特征空间里"没分开"。这类问题,靠注意力机制、更深/更宽的骨干、或者引入多尺度感受野来解决。
根因二:多尺度特征融合质量差。检测任务天然是多尺度问题——大目标在深层特征图上有强语义,小目标在浅层特征图上有精细位置信息,Neck 模块的质量决定了这两种信息能不能被高质量地融合起来。这类问题,靠改进 Neck 结构(BiFPN、AFPN)或者增加高分辨率检测层(P2 层)来解决。
根因三:标签分配与训练监督不够精准。损失函数的设计,直接决定了模型被"引导"去优化什么方向。传统的 IoU Loss 对小目标非常不友好——两个几乎重合的小目标,稍微一挪位,IoU 可能从 0.7 掉到 0.1,梯度非常不稳定。这类问题,靠改进损失函数来解决。
根因四:样本分布不均衡。有些类别训练样本特别多(比如"汽车"),有些类别极少(比如"消防栓"),模型在优化过程中自然会"偏心"高频类别,低频类别会被系统性地忽视。这类问题,靠类别权重调整、Focal Loss、或者数据增强来解决。
在开始改进之前,先通过混淆矩阵和各类别 AP 分布,把你的精度瓶颈归到这四类根因里去,才能做到"对症下药"。 这是我在做实际项目时养成的一个习惯,看似多了一步,实则省了很多弯路。
2.2 注意力机制:性价比最高的涨点手段
注意力机制(Attention Mechanism)是目前"涨点"工具箱里性价比最高的一类技术,原因是:用很小的参数量增加(有时候几乎为零),就能让模型学会"看哪里、怎么看",提升特征图的质量。
从机制层面,主流的注意力模块可以沿着"关注维度"这个轴线来理解:
2.2.1 通道注意力(Channel Attention)
代表作是 SENet(Squeeze-and-Excitation Network),发表于 CVPR 2018,是注意力机制在目标检测领域应用最广泛的起点之一。
SE 模块的核心思路是:对特征图的每个通道,先用全局平均池化"压缩"成一个标量(Squeeze),再通过一个小型 MLP 生成每个通道的"重要性权重"(Excitation),最后把这个权重乘回原始特征图,实现"通道加权"。
数学表述:
设输入特征图为
X
∈
R
C
×
H
×
W
\\mathbf{X} \\in \\mathbb{R}^{C \\times H \\times W}
X∈RC×H×W,SE 模块的计算过程如下:
z
c
=
1
H
×
W
∑
i
=
1
H
∑
j
=
1
W
x
c
(
i
,
j
)
,
c
=
1
,
2
,
…
,
C
z_c = \\frac{1}{H \\times W} \\sum_{i=1}^{H} \\sum_{j=1}^{W} x_c(i, j), \\quad c = 1, 2, \\ldots, C
zc=H×W1i=1∑Hj=1∑Wxc(i,j),c=1,2,…,C
这一步是 Squeeze(全局平均池化),把每个通道压成一个标量
z
c
z_c
zc,得到通道描述向量
z
∈
R
C
\\mathbf{z} \\in \\mathbb{R}^{C}
z∈RC。
接下来是 Excitation:
s
=
σ
!
(
W
2
⋅
δ
!
(
W
1
⋅
z
)
)
\\mathbf{s} = \\sigma!\\left( \\mathbf{W}_2 \\cdot \\delta!\\left( \\mathbf{W}_1 \\cdot \\mathbf{z} \\right) \\right)
s=σ!(W2⋅δ!(W1⋅z))
其中
W
1
∈
R
C
/
r
×
C
\\mathbf{W}_1 \\in \\mathbb{R}^{C/r \\times C}
W1∈RC/r×C,
W
2
∈
R
C
×
C
/
r
\\mathbf{W}_2 \\in \\mathbb{R}^{C \\times C/r}
W2∈RC×C/r,
r
r
r 是压缩比(通常取 16),
δ
\\delta
δ 是 ReLU,
σ
\\sigma
σ 是 Sigmoid。
s
∈
R
C
\\mathbf{s} \\in \\mathbb{R}^{C}
s∈RC 是每个通道的重要性权重。
最后是 Scale(通道加权):
x
^
c
=
s
c
⋅
x
c
\\hat{x}_c = s_c \\cdot x_c
x^c=sc⋅xc
SE 模块引入的参数量为
2
C
2
r
\\frac{2C^2}{r}
r2C2(忽略偏置),以
C
=
256
,
r
=
16
C=256, r=16
C=256,r=16 为例,仅新增约 8192 个参数,代价极低。
2.2.2 双重注意力:CBAM
CBAM(Convolutional Block Attention Module)在 SE 的通道注意力基础上,叠加了一层空间注意力,让模型不仅知道"哪些通道重要",还知道"图像里哪些位置重要"。
通道注意力部分,CBAM 同时使用了全局平均池化和全局最大池化,两路描述向量经过共享权重的 MLP 后相加,再过 Sigmoid:
M
c
(
X
)
=
σ
!
(
M
L
P
(
A
v
g
P
o
o
l
(
X
)
)
+
M
L
P
(
M
a
x
P
o
o
l
(
X
)
)
)
\\mathbf{M}_c(\\mathbf{X}) = \\sigma!\\left( \\mathrm{MLP}(\\mathrm{AvgPool}(\\mathbf{X})) + \\mathrm{MLP}(\\mathrm{MaxPool}(\\mathbf{X})) \\right)
Mc(X)=σ!(MLP(AvgPool(X))+MLP(MaxPool(X)))
空间注意力部分,对通道加权后的特征图
X
′
=
M
c
⊗
X
\\mathbf{X}' = \\mathbf{M}_c \\otimes \\mathbf{X}
X′=Mc⊗X,沿通道维度分别做平均池化和最大池化,得到两个
1
×
H
×
W
1 \\times H \\times W
1×H×W 的特征图,拼接后经过一个
7
×
7
7 \\times 7
7×7 卷积和 Sigmoid,生成空间注意力图:
M
s
(
X
′
)
=
σ
!
(
f
7
×
7
!
(
[
A
v
g
P
o
o
l
(
X
′
)
;
M
a
x
P
o
o
l
(
X
′
)
]
)
)
\\mathbf{M}_s(\\mathbf{X}') = \\sigma!\\left( f^{7 \\times 7}!\\left([\\mathrm{AvgPool}(\\mathbf{X}'); \\mathrm{MaxPool}(\\mathbf{X}')]\\right) \\right)
Ms(X′)=σ!(f7×7!([AvgPool(X′);MaxPool(X′)]))
最终输出为:
X
′
′
=
M
s
⊗
X
′
=
M
s
⊗
(
M
c
⊗
X
)
\\mathbf{X}'' = \\mathbf{M}_s \\otimes \\mathbf{X}' = \\mathbf{M}_s \\otimes \\left( \\mathbf{M}_c \\otimes \\mathbf{X} \\right)
X′′=Ms⊗X′=Ms⊗(Mc⊗X)
从工程经验来看,CBAM 在密集目标检测和部分遮挡场景下的效果通常优于纯通道注意力,但会比 SE 多一点点计算开销(空间注意力那个
7
×
7
7 \\times 7
7×7 卷积)。
2.2.3 轻量级注意力:ECA-Net 与 SimAM
**ECA-Net(Efficient Channel Attention)**解决了 SE 模块的一个痛点——SE 的两层全连接(MLP)打破了特征通道之间的局部性,而且
C
→
C
/
r
→
C
C \\to C/r \\to C
C→C/r→C 的降维-升维操作会损失一些通道间的精细依赖关系。ECA-Net 用一个一维卷积(kernel size 通过通道数
C
C
C 自适应确定)直接对通道描述向量做局部交叉,避免了降维损失,参数量进一步压缩:
kernel size
=
∣
log
2
C
+
1
2
∣
odd
\\text{kernel size} = \\left|\\frac{\\log_2 C + 1}{2}\\right|_{\\text{odd}}
kernel size=
2log2C+1
odd
其中
∣
⋅
∣
odd
|\\cdot|_{\\text{odd}}
∣⋅∣odd 表示取最近的奇数,保证卷积可以做 padding=same 的对称操作。ECA-Net 的参数量只有
k
k
k 个(
k
k
k 通常为 3 或 5),是 SE 的百分之一不到,但实验表明在 ImageNet 等基准上精度甚至略优于 SE。
SimAM(Simple Attention Module) 更极端——它甚至不新增任何参数,而是通过一个基于神经科学"神经元的抑制机制"推导出的能量函数,直接计算每个神经元(即每个特征点)的重要性:
e
t
∗
=
4
(
σ
^
2
+
λ
)
(
t
−
μ
^
)
2
+
2
σ
^
2
+
2
λ
e_t^* = \\frac{4(\\hat{\\sigma}^2 + \\lambda)}{(t – \\hat{\\mu})^2 + 2\\hat{\\sigma}^2 + 2\\lambda}
et∗=(t−μ^)2+2σ^2+2λ4(σ^2+λ)
其中
t
t
t 是目标神经元的激活值,
μ
^
\\hat{\\mu}
μ^ 和
σ
^
2
\\hat{\\sigma}^2
σ^2 是同一特征图上(包括空间和通道维度)所有神经元激活值的均值和方差,
λ
\\lambda
λ 是正则化项。通过最小化这个能量函数,可以得到每个神经元的重要性权重,进而对特征图加权。整个过程无需反向传播训练,是一种"即插即用"的计算模块。
对于工程师来说,这几个注意力模块的选择建议是:
- 计算资源宽裕、追求精度最大化 → CBAM 或 Coordinate Attention
- 计算资源中等、想要性价比 → ECA-Net 或 SE
- 几乎不想增加任何额外开销 → SimAM(零参数,真的是"白嫖")
2.2.4 位置感知注意力:Coordinate Attention
Coordinate Attention 是专门为下游检测/分割任务优化的注意力机制,核心创新是:把空间位置信息(水平方向和垂直方向)显式编码进注意力权重里,而不是像 SE/ECA 那样完全丢弃空间位置信息,也不像 CBAM 那样用
7
×
7
7\\times7
7×7 卷积隐式建模位置。
具体做法是用两个方向的 1D 全局平均池化分别生成水平和垂直的通道描述向量:
z
c
h
(
h
)
=
1
W
∑
0
≤
j
<
W
x
c
(
h
,
j
)
z_c^h(h) = \\frac{1}{W} \\sum_{0 \\le j < W} x_c(h, j)
zch(h)=W10≤j<W∑xc(h,j)
z
c
w
(
w
)
=
1
H
∑
0
≤
i
<
H
x
c
(
i
,
w
)
z_c^w(w) = \\frac{1}{H} \\sum_{0 \\le i < H} x_c(i, w)
zcw(w)=H10≤i<H∑xc(i,w)
然后把这两个方向的描述向量拼接后共同送入一个轻量的变换模块,生成带有位置信息的通道注意力,最终对原始特征图做加权。这使得模型在关注"哪些通道重要"的同时,还能感知到目标的大致位置(水平/垂直坐标),对需要精确定位的检测任务特别有用。
2.3 Neck 改进:特征融合的"精装修"
如果注意力机制是对单个特征图做"精细化处理",那 Neck 的改进就是对"跨尺度特征融合过程"做优化。这两者解决的是不同层次的问题,不能互相替代。
2.3.1 为什么默认的 PAN 不够?
YOLOv10 默认的 Neck 是 PAN(Path Aggregation Network),结构是:先自顶向下(Top-Down,深层高语义特征融合到浅层高分辨率特征),再自底向上(Bottom-Up,浅层高分辨率特征融合到深层)。这是目前检测模型 Neck 设计的主流选择,已经相当成熟。
但 PAN 有一个不太明显的问题:它在融合不同尺度的特征时,用的是"等权重"的拼接或相加,也就是说,P3 层的特征和 P5 层的特征,在最终的融合结果里占的比重是由网络自行学习的,没有显式的"哪个尺度更重要"的机制。在目标尺度分布比较均匀的场景下,这个"平等主义"的策略没什么问题;但在大小目标差异悬殊的场景下(比如同时存在行人远景小目标和近处大货车的交通监控场景),这种等权融合可能会导致某一尺度的特征被"稀释"。
2.3.2 BiFPN:可学习的加权特征金字塔
BiFPN(Bi-directional Feature Pyramid Network) 的核心改进是引入了可学习的权重,让每个融合节点自己决定各输入特征的比重:
O
=
∑
i
w
i
ϵ
+
∑
j
w
j
⋅
I
i
O = \\sum_{i} \\frac{w_i}{\\epsilon + \\sum_j w_j} \\cdot I_i
O=i∑ϵ+∑jwjwi⋅Ii
其中
w
i
w_i
wi 是可学习的标量权重(经过 ReLU 保证非负),
ϵ
=
0.0001
\\epsilon = 0.0001
ϵ=0.0001 防止除零,
I
i
I_i
Ii 是各输入特征图(经过 resize 对齐分辨率后)。
这个权重归一化(Fast Normalized Fusion)比 Softmax 归一化计算效率高,同时保证了所有权重之和为 1(便于训练稳定)。
此外,BiFPN 还做了一个结构上的改进:在 Top-Down 和 Bottom-Up 之间,对每个中间节点额外引入了一条来自原始(未经过融合的)同分辨率特征的"直连"边,形成真正的双向融合。这条直连边在反向传播时相当于一个"梯度高速公路",缓解了深层特征融合中的梯度消失问题。
在工程实践中,BiFPN 在多尺度目标混合场景下相对于 PAN 通常有 1%-2% 的 mAP 提升,但代价是计算量略有增加(主要是多了几次 resize 操作和额外的权重乘法)。如果你的场景是大小目标混杂、各尺度目标的频率差异较大,BiFPN 是一个值得优先考虑的 Neck 替换方案。
2.3.3 P2 小目标检测层:直接扩大小目标的"战场"
PAN 默认输出三个尺度:P3(stride=8)、P4(stride=16)、P5(stride=32)。对于一个 640×640 的输入,三个尺度的特征图分辨率分别是 80×80、40×40、20×20。
小目标的直接问题是:目标本身在原始图像里就很小(比如 10×10 像素),经过 stride=8 的下采样之后,在 P3 特征图上只有 1.25×1.25 个特征点,已经接近"特征稀疏化"的临界。强行用 P3 的特征来检测这么小的目标,召回率上不去是必然的。
增加 P2 检测层,意味着在 stride=4(分辨率 160×160)上额外布置一套检测头,这个分辨率下,原始 10×10 的小目标有 2.5×2.5 个特征点,虽然还是不多,但已经有了质的改变。大量实验证明,P2 层对于检测边长小于 32 像素的目标,召回率提升通常在 3%-8%,对整体 mAP(small)的提升可能超过 5%。
当然,代价也很明显:160×160 的特征图上做卷积,计算量是 80×80 的 4 倍。所以 P2 层不是"随手一加"的,只有当你的场景确实有大量小目标,且硬件算力有余量时,P2 才是合理的选择。
2.4 损失函数改进:改"打分规则"而非"选手"
损失函数的改进是涨点工具箱里一个特别"划算"的方向——它不改变网络结构,对推理速度没有任何影响,纯粹是训练阶段的"游戏规则"调整。调好了,精度直接提升;调不好,最多就是训练不稳定,不会破坏已有的工程基础。
2.4.1 从 IoU 到 CIoU:回归损失的演进
早期的检测模型用 MSE Loss 来优化边界框的坐标,问题很明显:MSE 独立地优化
(
x
,
y
,
w
,
h
)
(x, y, w, h)
(x,y,w,h) 四个值,没有考虑预测框和真实框之间的"整体形状重叠"关系。
IoU Loss 解决了这个问题,它直接优化两个框的重叠比例:
L
I
o
U
=
1
−
∣
B
∩
B
g
t
∣
∣
B
∪
B
g
t
∣
\\mathcal{L}_{IoU} = 1 – \\frac{|\\mathbf{B} \\cap \\mathbf{B}^{gt}|}{|\\mathbf{B} \\cup \\mathbf{B}^{gt}|}
LIoU=1−∣B∪Bgt∣∣B∩Bgt∣
但 IoU Loss 有一个严重的缺陷:当预测框和真实框完全不重叠时,IoU=0,梯度为零,训练停滞。GIoU、DIoU、CIoU 依次解决了这个问题:
GIoU 引入了最小外接矩形,通过惩罚外接矩形中非重叠区域的比例来提供非重叠时的梯度:
L
G
I
o
U
=
1
−
I
o
U
+
∣
C
∖
(
B
∪
B
g
t
)
∣
∣
C
∣
\\mathcal{L}_{GIoU} = 1 – IoU + \\frac{|\\mathbf{C} \\setminus (\\mathbf{B} \\cup \\mathbf{B}^{gt})|}{|\\mathbf{C}|}
LGIoU=1−IoU+∣C∣∣C∖(B∪Bgt)∣
其中
C
\\mathbf{C}
C 是
B
\\mathbf{B}
B 和
B
g
t
\\mathbf{B}^{gt}
Bgt 的最小外接矩形。
DIoU 在 IoU 基础上引入了中心点距离惩罚:
L
D
I
o
U
=
1
−
I
o
U
+
ρ
2
(
b
,
b
g
t
)
c
2
\\mathcal{L}_{DIoU} = 1 – IoU + \\frac{\\rho^2(\\mathbf{b}, \\mathbf{b}^{gt})}{c^2}
LDIoU=1−IoU+c2ρ2(b,bgt)
其中
ρ
(
⋅
)
\\rho(\\cdot)
ρ(⋅) 是欧氏距离,
b
\\mathbf{b}
b 和
b
g
t
\\mathbf{b}^{gt}
bgt 是预测框和真实框的中心点,
c
c
c 是最小外接矩形的对角线长度。
CIoU 在 DIoU 基础上再加了宽高比一致性惩罚:
L
C
I
o
U
=
1
−
I
o
U
+
ρ
2
(
b
,
b
g
t
)
c
2
+
α
v
\\mathcal{L}_{CIoU} = 1 – IoU + \\frac{\\rho^2(\\mathbf{b}, \\mathbf{b}^{gt})}{c^2} + \\alpha v
LCIoU=1−IoU+c2ρ2(b,bgt)+αv
v
=
4
π
2
(
arctan
w
g
t
h
g
t
−
arctan
w
h
)
2
,
α
=
v
(
1
−
I
o
U
)
+
v
v = \\frac{4}{\\pi^2}\\left(\\arctan\\frac{w^{gt}}{h^{gt}} – \\arctan\\frac{w}{h}\\right)^2, \\quad \\alpha = \\frac{v}{(1 – IoU) + v}
v=π24(arctanhgtwgt−arctanhw)2,α=(1−IoU)+vv
CIoU 是 YOLOv10 默认使用的 IoU 损失,已经相当成熟。但在此基础上,近年来还出现了几个有意思的改进:
**SIoU(Shape-IoU)**认为 CIoU 的宽高比惩罚在目标形状差异较大时会引入不稳定梯度,改为直接对预测框和真实框的角度差异建模:
L
S
I
o
U
=
1
−
I
o
U
+
Δ
+
Ω
2
\\mathcal{L}_{SIoU} = 1 – IoU + \\frac{\\Delta + \\Omega}{2}
LSIoU=1−IoU+2Δ+Ω
其中
Δ
\\Delta
Δ 是距离代价(基于向量角度),
Ω
\\Omega
Ω 是形状代价(基于宽高差异)。实验表明 SIoU 在一些旋转目标或形状不规则目标的场景下,收敛更快。
**WIoU(Wise-IoU)**的创新点是引入了一个动态聚焦机制——不同质量的样本(以"离群程度"来衡量),给予不同的损失权重,高质量的普通样本权重较低,模型更关注那些"边界框质量不稳定"的样本:
L
∗
W
I
o
U
=
r
⋅
L
∗
I
o
U
∗
,
r
=
e
(
x
−
x
m
)
2
+
(
y
−
y
m
)
2
W
f
2
\\mathcal{L}*{WIoU} = r \\cdot \\mathcal{L}*{IoU}^*, \\quad r = \\frac{e^{(x – x_m)^2 + (y – y_m)^2}}{\\mathcal{W}_f^2}
L∗WIoU=r⋅L∗IoU∗,r=Wf2e(x−xm)2+(y−ym)2
其中
W
f
\\mathcal{W}_f
Wf 是聚焦系数,
r
r
r 是基于中心点位置的动态权重。WIoU v3(最新版本)被证明在多个 COCO benchmark 上能有 0.5%-1.5% 的 mAP 提升,且对边界框质量差的样本鲁棒性更好。
2.4.2 针对小目标的 NWD 损失
小目标的 IoU 计算存在一个本质性的不稳定问题:对于小目标,预测框的微小偏移会导致 IoU 数值的剧烈变化。假设真实框是一个
10
×
10
10 \\times 10
10×10 的小目标,预测框偏移了 2 个像素,IoU 可能从 0.64 骤降到 0.16,产生非常大的梯度,反而不利于稳定训练。
NWD(Normalized Wasserstein Distance)的思路是:把边界框建模为二维高斯分布(均值为框的中心点,协方差为框的宽高),然后用 Wasserstein 距离来衡量两个分布之间的相似度,而不是用面积重叠比例来衡量两个矩形的相似度。
具体地,把边界框
B
=
(
c
x
,
c
y
,
w
,
h
)
\\mathcal{B} = (c_x, c_y, w, h)
B=(cx,cy,w,h) 建模为高斯分布:
N
(
μ
,
Σ
)
,
μ
=
(
c
x
,
c
y
)
⊤
,
Σ
=
d
i
a
g
(
w
2
,
h
2
)
2
\\mathcal{N}(\\boldsymbol{\\mu}, \\boldsymbol{\\Sigma}), \\quad \\boldsymbol{\\mu} = (c_x, c_y)^\\top, \\quad \\boldsymbol{\\Sigma} = \\mathrm{diag}\\left(\\frac{w}{2}, \\frac{h}{2}\\right)^2
N(μ,Σ),μ=(cx,cy)⊤,Σ=diag(2w,2h)2
两个高斯分布之间的 2-Wasserstein 距离有闭合解:
W
2
2
(
N
1
,
N
2
)
=
∣
μ
1
−
μ
2
∣
2
+
∣
Σ
1
1
/
2
−
Σ
2
1
/
2
∣
F
2
W_2^2(\\mathcal{N}_1, \\mathcal{N}_2) = |\\boldsymbol{\\mu}_1 – \\boldsymbol{\\mu}_2|^2 + \\left|\\boldsymbol{\\Sigma}_1^{1/2} – \\boldsymbol{\\Sigma}_2^{1/2}\\right|_F^2
W22(N1,N2)=∣μ1−μ2∣2+
Σ11/2−Σ21/2
F2
对于对角协方差矩阵,上式化简为:
W
2
2
=
(
c
x
−
c
x
g
t
)
2
+
(
c
y
−
c
y
g
t
)
2
+
(
w
2
−
w
g
t
2
)
2
+
(
h
2
−
h
g
t
2
)
2
W_2^2 = (c_x – c_x^{gt})^2 + (c_y – c_y^{gt})^2 + \\left(\\frac{w}{2} – \\frac{w^{gt}}{2}\\right)^2 + \\left(\\frac{h}{2} – \\frac{h^{gt}}{2}\\right)^2
W22=(cx−cxgt)2+(cy−cygt)2+(2w−2wgt)2+(2h−2hgt)2
然后归一化得到 NWD:
N
W
D
(
N
1
,
N
2
)
=
exp
!
(
−
W
2
2
C
)
\\mathrm{NWD}(\\mathcal{N}_1, \\mathcal{N}_2) = \\exp!\\left(-\\frac{\\sqrt{W_2^2}}{C}\\right)
NWD(N1,N2)=exp!(−CW22
)
其中
C
C
C 是一个与数据集目标平均尺寸相关的常数。NWD 损失定义为:
L
N
W
D
=
1
−
N
W
D
(
N
,
N
g
t
)
\\mathcal{L}_{NWD} = 1 – \\mathrm{NWD}(\\mathcal{N}, \\mathcal{N}^{gt})
LNWD=1−NWD(N,Ngt)
相比 IoU 类损失,NWD 对小目标的位置微小偏移不敏感(因为用分布相似度替代了面积重叠),梯度更平稳,对小目标的训练更友好。在遥感、医疗影像等小目标检测场景,NWD 通常能带来 2%-4% 的小目标 AP 提升。
三、提速方向:让模型"跑得更快"的工程化路径
3.1 速度的本质:FLOPs 不等于延迟
在讲提速技术之前,有一个观念必须先纠正:FLOPs(浮点运算量)和实际推理延迟(Latency)不是线性关系,有时候甚至完全不相关。
这是很多同学(包括写论文的时候)踩过的坑。一个模块的 FLOPs 减少了 30%,上机实测 FPS 却只涨了 5%,甚至有时候还降了——这种情况完全可能发生,原因在于:
影响实际延迟的,除了 FLOPs,还有:
内存访问开销(Memory Access Cost,MAC):深度可分离卷积 FLOPs 很低,但它把一个标准卷积拆分成了两个 kernel,增加了内存访问次数,在内存带宽受限的硬件(比如 Jetson 系列)上,这个额外的 MAC 可能抵消 FLOPs 减少的收益。
算子并行效率:GPU 的并行计算能力依赖于大量的"相同计算"被批量调度(CUDA kernel 的并行粒度)。某些轻量算子(比如很小的 1×1 卷积)在 GPU 上的并行效率很低,相当于把 GPU 的大部分并行核心都"闲置"了。
算子切换与调度开销:每次切换一个新的 CUDA kernel,都有一定的调度启动开销。如果一个轻量模块把一个卷积拆成了三四个小算子,每个算子单独启动的调度开销叠加起来,可能比原来的单个大卷积还慢。
硬件特定加速:很多推理硬件(如 TensorRT、NPU、NNAPI)对标准卷积(3×3 Conv、1×1 Conv)有高度优化的硬件实现,而对不规则的算子(如可变形卷积、动态卷积)支持有限,甚至需要 fallback 到通用算子,速度差异可能达到数倍。
这意味着:"提速"的目标,必须在目标硬件上通过实际测量来确认,而不能仅凭理论 FLOPs 来判断。 在接下来的代码部分,我们会专门建立一套"目标硬件速度基准测试"的流程,确保每一次改进的速度收益是真实的。
3.2 轻量卷积模块替换:最"温和"的提速方式
3.2.1 GhostConv:用"廉价操作"生成特征
GhostConv(Ghost Convolution) 来自 CVPR 2020 的 GhostNet,核心思想是对标准卷积特征图的"冗余性"的利用。
观察:深度神经网络中间层的特征图里,存在大量"相似的"特征图对——它们可能是某个特征图的简单线性变换。既然有这种冗余,为什么要花费昂贵的计算去"重复生成"这些相似特征?
GhostConv 的做法是:
m
/
2
m/2
m/2 个"本征特征图"(Intrinsic Feature Maps)
m
/
2
m/2
m/2 个本征特征图分别做 cheap linear transformation,生成另外
m
/
2
m/2
m/2 个"幽灵特征图"(Ghost Feature Maps)
m
m
m 个输出特征图
这样一来,原本需要
n
×
C
i
n
×
k
2
×
H
×
W
n \\times C_{in} \\times k^2 \\times H \\times W
n×Cin×k2×H×W 次乘加运算的标准卷积,被替换成了约
n
/
2
×
C
i
n
×
k
2
×
H
×
W
+
n
/
2
×
k
′
2
×
H
×
W
n
×
C
i
n
×
k
2
×
H
×
W
≈
1
2
+
k
′
2
2
C
i
n
k
2
\\frac{n/2 \\times C_{in} \\times k^2 \\times H \\times W + n/2 \\times k'^2 \\times H \\times W}{n \\times C_{in} \\times k^2 \\times H \\times W} \\approx \\frac{1}{2} + \\frac{k'^2}{2C_{in}k^2}
n×Cin×k2×H×Wn/2×Cin×k2×H×W+n/2×k′2×H×W≈21+2Cink2k′2 的计算量比例,当
C
i
n
C_{in}
Cin 较大时,这个比例接近
1
/
2
1/2
1/2,理论上节省约 50% 的 FLOPs。
更正式地,GhostConv 的计算量比例(与标准卷积相比)为:
r
c
=
n
⋅
s
⋅
h
′
⋅
w
′
n
/
(
2
s
)
⋅
C
i
n
⋅
k
2
⋅
h
′
⋅
w
′
+
(
n
⋅
(
s
−
1
)
/
2
)
⋅
k
′
2
⋅
h
′
⋅
w
′
≈
2
s
s
+
1
⋅
1
C
i
n
k
2
/
k
′
2
r_c = \\frac{n \\cdot s \\cdot h' \\cdot w'}{n/(2s) \\cdot C_{in} \\cdot k^2 \\cdot h' \\cdot w' + (n \\cdot (s-1)/2) \\cdot k'^2 \\cdot h' \\cdot w'} \\approx \\frac{2s}{s + 1} \\cdot \\frac{1}{C_{in} k^2 / k'^2}
rc=n/(2s)⋅Cin⋅k2⋅h′⋅w′+(n⋅(s−1)/2)⋅k′2⋅h′⋅w′n⋅s⋅h′⋅w′≈s+12s⋅Cink2/k′21
其中
s
s
s 是"幽灵比"(通常取 2),
k
k
k 是主卷积 kernel size,
k
′
k'
k′ 是 cheap operation 的 kernel size(通常取 3 或 5)。
在 YOLOv10 中,GhostConv 通常用来替换 Backbone 和 Neck 中计算量较大的 C2f 模块里的标准卷积,能够在精度损失 1% 以内的前提下,把 FLOPs 降低 20%-40%。
3.2.2 FasterBlock:部分卷积(PConv)的工程化实现
FasterBlock 来自 CVPR 2023 的 FasterNet,核心操作是 PConv(Partial Convolution,部分卷积)。
PConv 的出发点是对"内存访问效率"的分析,而不仅仅是 FLOPs:
对于深度可分离卷积,虽然 FLOPs 少,但它把
C
i
n
C_{in}
Cin 个通道分别卷积,内存访问次数(读取和写入特征图的次数)和标准卷积相当甚至更多,导致内存访问利用率很低。
PConv 的解法是:只对前
C
p
C_p
Cp 个通道(其中
C
p
=
C
i
n
/
4
C_p = C_{in}/4
Cp=Cin/4)做标准卷积,其余
C
i
n
−
C
p
C_{in} – C_p
Cin−Cp 个通道直接 identity(不做卷积,直接传递)。
计算量比(与标准卷积相比):
FLOPs比
=
C
p
⋅
C
p
⋅
k
2
⋅
h
⋅
w
C
i
n
⋅
C
i
n
⋅
k
2
⋅
h
⋅
w
=
(
C
p
C
i
n
)
2
=
1
16
\\text{FLOPs比} = \\frac{C_p \\cdot C_p \\cdot k^2 \\cdot h \\cdot w}{C_{in} \\cdot C_{in} \\cdot k^2 \\cdot h \\cdot w} = \\left(\\frac{C_p}{C_{in}}\\right)^2 = \\frac{1}{16}
FLOPs比=Cin⋅Cin⋅k2⋅h⋅wCp⋅Cp⋅k2⋅h⋅w=(CinCp)2=161
理论上 FLOPs 下降到 1/16,但更重要的是内存访问效率:由于只读写
C
p
C_p
Cp 个通道的特征图,内存访问量减少到原来的
C
p
C
i
n
=
1
4
\\frac{C_p}{C_{in}} = \\frac{1}{4}
CinCp=41,同时这
C
p
C_p
Cp 个通道的数据在内存里是连续的(内存局部性好),CUDA 的内存访问效率大幅提升。
实验表明,在 ImageNet 上,FasterNet-T0 在精度与 MobileNetV2 相当的情况下,在 CPU 上的推理速度快了约 2.8 倍,在 GPU 上快了约 1.5 倍。对于 CPU 推理或内存带宽受限的边缘设备,FasterBlock 的实际提速效果往往优于 GhostConv。
3.2.3 深度可分离卷积:轻量化的"老祖宗"
深度可分离卷积(Depthwise Separable Convolution)是 MobileNet 系列的基础组件,理解它的原理对后续所有轻量化方法都有帮助。
标准卷积的计算量:
FLOPs
∗
s
t
d
=
C
∗
o
u
t
×
C
i
n
×
k
2
×
H
o
u
t
×
W
o
u
t
\\text{FLOPs}*{std} = C*{out} \\times C_{in} \\times k^2 \\times H_{out} \\times W_{out}
FLOPs∗std=C∗out×Cin×k2×Hout×Wout
深度可分离卷积把这个操作拆成两步:
步骤一:深度卷积(Depthwise Conv)——对每个输入通道独立做卷积:
FLOPs
∗
d
w
=
C
∗
i
n
×
k
2
×
H
o
u
t
×
W
o
u
t
\\text{FLOPs}*{dw} = C*{in} \\times k^2 \\times H_{out} \\times W_{out}
FLOPs∗dw=C∗in×k2×Hout×Wout
步骤二:逐点卷积(Pointwise Conv,即 1×1 Conv)——跨通道的线性组合:
FLOPs
∗
p
w
=
C
∗
o
u
t
×
C
i
n
×
H
o
u
t
×
W
o
u
t
\\text{FLOPs}*{pw} = C*{out} \\times C_{in} \\times H_{out} \\times W_{out}
FLOPs∗pw=C∗out×Cin×Hout×Wout
总计算量:
FLOPs
∗
d
w
+
p
w
=
C
∗
i
n
×
H
o
u
t
×
W
o
u
t
×
(
k
2
+
C
o
u
t
)
\\text{FLOPs}*{dw+pw} = C*{in} \\times H_{out} \\times W_{out} \\times (k^2 + C_{out})
FLOPs∗dw+pw=C∗in×Hout×Wout×(k2+Cout)
与标准卷积的比值:
FLOPs
∗
d
w
+
p
w
FLOPs
∗
s
t
d
=
1
C
o
u
t
+
1
k
2
\\frac{\\text{FLOPs}*{dw+pw}}{\\text{FLOPs}*{std}} = \\frac{1}{C_{out}} + \\frac{1}{k^2}
FLOPs∗stdFLOPs∗dw+pw=Cout1+k21
以
k
=
3
,
C
o
u
t
=
64
k=3, C_{out}=64
k=3,Cout=64 为例,比值约为
1
/
64
+
1
/
9
≈
0.127
1/64 + 1/9 \\approx 0.127
1/64+1/9≈0.127,理论 FLOPs 减少约 87%。这个计算量节省是惊人的,但正如前面所说,在 GPU 上的实际加速比通常远达不到这个理论值,因为逐点卷积(大量 1×1 小卷积)的 GPU 利用率偏低。深度可分离卷积在 CPU 和部分 NPU 上的实际加速效果,通常优于 GPU。
3.3 重参数化:训练时"养精蓄锐",推理时"一招制敌"
重参数化(Re-parameterization) 是近年来提速方向里最优雅的一个技术,代表作是 RepVGG(CVPR 2021),其核心思想可以概括为:训练用复杂结构,推理用简单结构,通过数学等价变换无损地完成这个转换。
训练阶段,RepVGG 的每个 Block 有三个并联的分支:
-
3
×
3
3 \\times 3
3×3 卷积分支(提取局部特征) -
1
×
1
1 \\times 1
1×1 卷积分支(通道混合,类似跳连接的作用) - Identity 分支(恒等映射,要求输入输出通道数相同)
训练阶段的前向传播:
y
=
BN
3
(
W
3
∗
x
)
+
BN
1
(
W
1
∗
x
)
+
BN
0
(
x
)
y = \\text{BN}_3(W_3 * x) + \\text{BN}_1(W_1 * x) + \\text{BN}_0(x)
y=BN3(W3∗x)+BN1(W1∗x)+BN0(x)
其中
∗
*
∗ 是卷积操作,
W
3
∈
R
C
o
u
t
×
C
i
n
×
3
×
3
W_3 \\in \\mathbb{R}^{C_{out} \\times C_{in} \\times 3 \\times 3}
W3∈RCout×Cin×3×3,
W
1
∈
R
C
o
u
t
×
C
i
n
×
1
×
1
W_1 \\in \\mathbb{R}^{C_{out} \\times C_{in} \\times 1 \\times 1}
W1∈RCout×Cin×1×1。
推理阶段,通过以下等价变换,把三个分支"融合"成一个单一的
3
×
3
3 \\times 3
3×3 卷积:
等价变换步骤:
(
γ
,
β
,
μ
,
σ
2
)
(\\gamma, \\beta, \\mu, \\sigma^2)
(γ,β,μ,σ2) 可以等价地合并到卷积核里:
W
^
=
γ
σ
2
+
ϵ
W
,
b
^
=
β
−
γ
μ
σ
2
+
ϵ
\\hat{W} = \\frac{\\gamma}{\\sqrt{\\sigma^2 + \\epsilon}} W, \\quad \\hat{b} = \\beta – \\frac{\\gamma \\mu}{\\sqrt{\\sigma^2 + \\epsilon}}
W^=σ2+ϵ
γW,b^=β−σ2+ϵ
γμ
将
1
×
1
1 \\times 1
1×1 卷积等价转换为
3
×
3
3 \\times 3
3×3 卷积(在
1
×
1
1 \\times 1
1×1 卷积核外围零填充,扩展为
3
×
3
3 \\times 3
3×3)。
将 Identity 分支等价转换为
3
×
3
3 \\times 3
3×3 卷积(当
C
i
n
=
C
o
u
t
C_{in} = C_{out}
Cin=Cout 时,Identity 等价于权重为单位矩阵的
1
×
1
1 \\times 1
1×1 卷积,再零填充为
3
×
3
3 \\times 3
3×3)。
把三个
3
×
3
3 \\times 3
3×3 卷积的权重直接相加,得到一个等价的单
3
×
3
3 \\times 3
3×3 卷积。
整个过程是精确的数学等价,不是近似,不损失任何精度。推理时只有一个
3
×
3
3 \\times 3
3×3 卷积,结构极简,推理速度快,对 GPU 的利用率高。
这种"训练复杂、推理简单"的设计哲学,是重参数化技术最迷人的地方——你在训练时可以充分利用多分支结构提供的丰富梯度路径来"喂饱"模型,但推理时完全不用为这种复杂付出速度代价。这几乎是"免费的涨点"加"免费的提速",性价比在所有提速技术里排名第一。
在 YOLOv10 中,可以把 Backbone 中的部分 Conv-BN-SiLU 结构替换为 RepVGG 风格的多分支训练结构(即 RepConv),训练结束后融合参数,推理时恢复为单路结构。
四、轻量化方向:让模型"装得下"的骨干替换策略
4.1 轻量化与提速的本质区别
很多人把轻量化和提速混为一谈,但这两个目标有本质区别:
轻量化关注的是"模型的静态属性"——参数量(Params)、模型文件体积(MB)、运行时内存/显存占用(MB)。这些指标决定了模型能不能"装进"目标设备,以及运行时对内存的压力。
提速关注的是"模型的动态属性"——单次推理延迟(ms)、吞吐量(FPS)。这些指标决定了模型的实时处理能力。
一个极端的例子:把模型所有权重量化为 INT4(参数量减少 8 倍),模型体积大幅下降,但如果硬件不支持 INT4 的高效矩阵运算,反而每次推理要先做反量化再计算,实际延迟可能比 FP32 还高。这就是典型的"轻量了但没提速"。
理解了这个区别,就能理解为什么轻量化方向的核心武器是整体骨干替换——因为对于参数量的大幅压缩,靠在原有骨干里替换个别卷积模块收效有限(从 2.3M 降到 2.0M,差距不大),真正大幅压缩参数量,往往需要换一个"生来就轻量"的骨干网络。
4.2 MobileNetV3:移动端的集大成者
MobileNetV3 是 Google 基于 NAS(神经架构搜索)+手工设计混合方法得到的移动端骨干,在 MobileNetV1(深度可分离卷积)和 MobileNetV2(倒置残差块)基础上做了三个重要改进:
改进一:引入 SE 通道注意力。在每个 Bottleneck 的末尾插入一个 SE 模块,以非常小的参数代价提升特征表达质量。
改进二:h-swish 激活函数。Swish 激活函数
f
(
x
)
=
x
⋅
σ
(
x
)
f(x) = x \\cdot \\sigma(x)
f(x)=x⋅σ(x) 性能好但计算 Sigmoid 有开销,MobileNetV3 用硬近似版本替代:
h-swish
(
x
)
=
x
⋅
ReLU6
(
x
+
3
)
6
\\text{h-swish}(x) = x \\cdot \\frac{\\text{ReLU6}(x+3)}{6}
h-swish(x)=x⋅6ReLU6(x+3)
其中
ReLU6
(
x
)
=
min
(
max
(
0
,
x
)
,
6
)
\\text{ReLU6}(x) = \\min(\\max(0, x), 6)
ReLU6(x)=min(max(0,x),6),用线性函数近似 Sigmoid,在保持 Swish 性能的同时大幅降低计算量,且更容易在嵌入式硬件上定点化。
改进三:重新设计第一层和最后层。通过 NAS 搜索发现,第一个卷积层的 stride=2 的大卷积核(通常是 3×3 或 5×5)是计算瓶颈,可以适当精简;同时最后的全局平均池化层可以移到 1×1 卷积之前(SE 层之后),减少昂贵的特征图计算。
MobileNetV3-Small 在 ImageNet 上 Top-1 精度约 67.4%,参数量仅 2.9M,Pixel 4 手机上推理延迟约 5.2ms。替换 YOLOv10 的 Backbone 后,整体模型参数量通常可以压缩到基线的 40%-60%,精度损失通常在 3%-5%。
4.3 ShuffleNetV2:为实际速度而生
ShuffleNetV2 针对的是一个精妙的问题:为什么 ShuffleNetV1 在理论 FLOPs 很低的情况下,实际速度提升并不显著?
作者通过大量实验,总结出了四条高效网络设计准则(这四条准则本身就值得单独深入学习):
- G1(Equal channel width minimizes memory access cost):内存访问量
MAC
≥
2
h
w
B
C
i
n
C
o
u
t
≥
2
h
w
B
C
i
n
C
o
u
t
\\text{MAC} \\ge 2\\sqrt{hwBC_{in}C_{out}} \\ge 2hwB\\sqrt{C_{in}C_{out}}
MAC≥2hwBCinCout≥2hwBCinCout,当C
i
n
=
C
o
u
t
C_{in} = C_{out}
Cin=Cout 时 MAC 最小(固定 FLOPs 下)。 - G2(Excessive group convolution increases MAC):分组卷积分组数越多,MAC 越大,应适度使用。
- G3(Network fragmentation reduces degree of parallelism):网络分支越多(如 Inception 里的多路并联),GPU 并行效率越低。
- G4(Element-wise operations are non-negligible):逐元素操作(如 ReLU、Add、BN)虽然 FLOPs 很少,但 MAC 不低,应尽量减少。
基于这四条准则,ShuffleNetV2 做了两个关键设计决策:
ShuffleNetV2 在 ARM CPU 上的实际速度提升,相比同 FLOPs 的其他轻量骨干(如 ShuffleV1、MobileNetV2)通常有 20%-60% 的提升。对于需要在 ARM CPU 上跑的嵌入式 AI 设备,ShuffleNetV2 是目前最值得考虑的轻量骨干之一。
4.4 EfficientNet:复合缩放的优雅与局限
EfficientNet 的核心贡献不是一个具体的网络结构,而是一个系统性的网络缩放方法(Compound Scaling)。
传统的网络缩放,要么只扩大深度(加更多层),要么只扩大宽度(加更多通道),要么只提高输入分辨率。EfficientNet 的作者通过 NAS 找到了一个基础网络(EfficientNet-B0),然后推导出:在给定的计算量约束
ϕ
\\phi
ϕ 下,同时按照固定的比例缩放深度、宽度、分辨率,能够达到最优的精度-计算量权衡:
d
=
α
ϕ
,
w
=
β
ϕ
,
r
=
γ
ϕ
d = \\alpha^\\phi, \\quad w = \\beta^\\phi, \\quad r = \\gamma^\\phi
d=αϕ,w=βϕ,r=γϕ
约束条件:
α
⋅
β
2
⋅
γ
2
≈
2
\\alpha \\cdot \\beta^2 \\cdot \\gamma^2 \\approx 2
α⋅β2⋅γ2≈2,其中
α
,
β
,
γ
\\alpha, \\beta, \\gamma
α,β,γ 通过在 B0 上做 grid search 得到(
α
=
1.2
,
β
=
1.1
,
γ
=
1.15
\\alpha=1.2, \\beta=1.1, \\gamma=1.15
α=1.2,β=1.1,γ=1.15)。
这个方法的优雅之处在于:给定任意目标计算量,只需调整
ϕ
\\phi
ϕ,就能自动得到对应的最优网络规格(EfficientNet-B0 到 B7),不需要重新搜索架构。
在 YOLOv10 中,通常选择 EfficientNet-B0 或 EfficientNet-B1 作为骨干替换方案——它们在精度和参数量之间的平衡非常好,特别适合"希望在一定的轻量化程度下尽可能保住精度"的场景。
EfficientNet 的一个实际局限:它的设计是基于 GPU/CPU 的浮点计算,在某些 NPU 上(尤其是对深度可分离卷积支持不完善的 NPU),实际推理速度可能不如参数量相近的 ShuffleNetV2。选型时需要在目标硬件上实测。
五、三大方向的协同与权衡:打破"不可能三角"的边界
5.1 精度-速度-体积的"帕累托前沿"
在学术界,这三个目标之间的关系通常用 **Pareto 前沿(Pareto Frontier)**来描述——在某个可行解集合里,一组解被称为"帕累托最优解",当且仅当不存在另一个解,在不牺牲任何目标的情况下,在至少一个目标上更优。
直白地说:给定一个固定的数据集和训练策略,存在一条"最优曲线"——在这条曲线上,精度和速度(或精度和参数量)处于最优的权衡关系,任何偏离这条曲线的设计都是"次优的"。我们的改进目标,本质上是把模型从次优位置推向帕累托前沿,或者在帕累托前沿上沿着我们的目标方向移动。
而重参数化技术之所以"特别",是因为它在不改变推理侧帕累托前沿位置的情况下,通过训练侧的结构复杂化,找到了一个更好的局部最优解——相当于用训练时的额外开销,换来了精度的提升,而推理速度完全不受影响。这种技术,等于是"改变了训练优化的景观",让模型能收敛到更好的位置。
5.2 组合改进的"1+1>2"效应与"1+1<1"陷阱
改进不是孤立的,不同方向的改进组合在一起,有时候会产生超预期的协同效应(1+1>2),有时候会产生负向的干扰(1+1<1)。
典型的协同效应案例:
-
P2 小目标层 + NWD 损失:P2 层提供了高分辨率的特征图,使小目标有更多特征点可以用于检测;NWD 损失则针对小目标边界框的不稳定性提供了更好的梯度信号。两者结合,对小目标 AP 的提升通常显著优于单独使用任意一个。
-
SimAM + WIoU 损失:SimAM 提升了特征图质量(让模型关注更重要的空间区域),WIoU 改善了边界框回归的样本权重策略(聚焦于质量不稳定的样本)。两者都是"几乎零代价"的改进,组合使用在多个数据集上被验证是有效的。
典型的负干扰案例:
-
轻量骨干替换 + 多层注意力叠加:用 MobileNetV3 替换了骨干(大幅削减了特征表达能力),又在每个 Block 后面叠加 CBAM(增加少量参数)——结果是 MobileNetV3 本身已经是在参数效率极限附近工作,CBAM 带来的参数增量虽然不多,但对最终精度的提升往往聊胜于无,因为特征表达能力的瓶颈不在于"关注哪里",而在于"骨干网络的容量不足以提取足够丰富的特征"。
-
P2 层 + 轻量骨干:在 MobileNetV3 骨干基础上加 P2 检测层,由于 MobileNetV3 浅层的特征质量(尤其是语义信息的丰富程度)不如 YOLOv10 原版骨干,P2 层能利用的高质量特征很有限,效果通常不如在原版骨干上加 P2 层显著,有时候甚至因为增加了计算量但精度没有对应提升而"得不偿失"。
这些经验告诉我们:改进方向的选择,不仅要看单个技术的理论效果,还要考虑它在当前模型配置下的"适配性"——好的技术放在不合适的位置,可能是浪费,甚至是干扰。
六、四步决策框架:从场景需求到改进方案的完整推导
6.1 第一步:明确部署硬件与计算预算
在做任何改进决策之前,先回答这个问题:我的模型要跑在什么硬件上,这个硬件的"算力天花板"是多少?
| 数据中心 GPU(A100/V100) | >100 TFLOPS | 无严格上限(>100G) | 无严格上限 |
| 工作站 GPU(RTX 3090/4090) | 30-80 TFLOPS | 建议 <50G(保留并发余量) | <100M |
| Jetson AGX Xavier | 32 TOPS(INT8) | <20G(FP32等效) | <50M |
| Jetson Orin Nano | 40 TOPS(INT8) | <15G | <30M |
| ARM CPU(Cortex-A72 级别) | ~0.1-0.5 TFLOPS | <5G | <10M |
| 嵌入式 NPU(低功耗场景) | <1 TOPS | <2G | <5M |
把你的基线模型的 FLOPs 和 Params 对照这张表,看看它是否在目标硬件的"舒适区"内。如果已经超出了舒适区,那轻量化是第一优先级,精度暂时退居其次。
6.2 第二步:评估实时性要求
确认硬件约束之后,评估场景对延迟的要求:
强实时场景:视频流每帧都要处理,要求延迟低于一帧的时间间隔。如 25fps 视频要求延迟 <40ms,60fps 要求 <16ms。这类场景中,即便模型精度略低,也需要确保延迟达标,否则"积压帧"会导致系统崩溃。
弱实时场景:处理有一定延迟可接受,比如每隔几秒拍一张图检测、或者批量离线分析,对单帧延迟不敏感。这类场景下,精度往往比速度更重要。
异步场景:检测结果不需要同步返回,可以异步处理(比如安防系统里的事后回溯分析)。这类场景最宽松,可以跑更大的模型追求更高精度。
6.3 第三步:定位精度短板类型
如果硬件约束和实时性约束都能满足,那精度短板的分析就成了改进的核心驱动力。
通过以下几个诊断步骤来定位精度短板:
诊断一:各类别 AP 分布分析。找出 AP 最低的三到五个类别,分析这些类别的共同特征——它们是不是普遍比较小?是不是有严重的类别不均衡(训练样本极少)?还是经常被遮挡?
诊断二:按目标尺寸分析 AP。把验证集上的目标按面积分成三档:small(面积 <32² 像素)、medium(32²-96²)、large(>96²),分别统计 AP。如果 small AP 远低于 medium 和 large,那小目标检测是主要短板;如果三档都差不多,说明问题是全局性的,不是尺度特异性的。
诊断三:召回率 vs 精度分析。如果 Recall 很低但 Precision 较高,说明模型的问题是"漏检"——该检出的没检出,这通常和小目标、密集目标、遮挡目标有关;如果 Recall 不错但 Precision 偏低,说明模型的问题是"误检"——不该检出的检出了,这通常和类别相似度高、背景噪声强有关。
6.4 第四步:按优先级制定改进路线
综合前三步的结论,制定改进路线时遵循这个优先级规则:
1. 先满足硬件约束(轻量化,如果需要的话)
2. 再满足实时性要求(提速,如果需要的话)
3. 在满足上述两个约束的前提下,选择性价比最高的涨点手段
4. 精度达标后,考虑额外的速度优化(进一步提升吞吐量)
最重要的原则:不要在精度约束不明确的情况下谈提速,也不要在硬件约束不明确的情况下谈轻量化。约束驱动改进,而不是技术驱动改进。
七、量化评估体系:用数字说话
7.1 五个核心评估指标
| mAP50-95 | COCO 标准检测精度,IoU 阈值从 0.5 到 0.95 步长 0.05 的平均 | 涨点评估的金标准 | model.val() 返回 |
| Params(M) | 可训练参数量,单位百万 | 轻量化评估 | model.info() 返回 |
| FLOPs(G) | 单次前向传播浮点运算量,以 640×640 为基准 | 计算复杂度参考 | model.info() 返回 |
| FPS | 目标硬件上每秒处理帧数 | 速度评估的唯一可信指标 | 目标硬件实测 |
| 显存峰值(MB) | 推理过程中的最高显存占用 | 部署可行性评估 | torch.cuda.max_memory_allocated() |
有几点需要特别说明:
关于 mAP50 vs mAP50-95 的选择:mAP50(仅在 IoU=0.5 阈值下计算)更"宽容",对边界框定位不够精准的模型会给出虚高的分数;mAP50-95 对定位精度有更高要求,是 COCO 竞赛的标准指标,也是在工程上应该重点关注的指标。两个都记录,但以 mAP50-95 为主。
关于 FLOPs 和 FPS 的关系:如前所述,FLOPs 只是计算量的参考值,不能代替实测 FPS。建议做一个"FLOPs-FPS 散点图"——把多次改进的 FLOPs 和对应的 FPS 画在同一个坐标系里,观察它们的相关性。如果某个改进 FLOPs 下降了但 FPS 没涨,说明这个模块在目标硬件上存在效率问题。
7.2 基线画像代码(完整版)
下面这段代码把所有五个核心指标的测量集成在一起,是第六章所有改进实验的"度量仪器"。读懂这段代码,比读懂很多具体的改进模块更重要——因为它是你判断"改进到底有没有用"的底层工具。
# ===================================================================
# baseline_profile.py
#
# 功能:对 YOLOv10 基线模型进行精度、参数量、计算量、
# 推理速度、显存占用的全面画像
#
# 用法:在每次模块改进前后各跑一次,对比输出即可判断改进效果
#
# 依赖:ultralytics >= 8.1.0, torch >= 2.0.0, pandas
# ===================================================================
import torch
import time
import json
import warnings
from pathlib import Path
from ultralytics import YOLO
warnings.filterwarnings('ignore')
# ——————————————————————
# 工具函数:测量单次推理的延迟和显存占用
# ——————————————————————
def profile_speed(
model: YOLO,
imgsz: int = 640,
device: str = 'cuda',
n_warmup: int = 50,
n_iters: int = 300,
batch_size: int = 1
) –> dict:
"""
测量模型的推理速度和显存占用。
Args:
model: Ultralytics YOLO 模型对象
imgsz: 输入分辨率(正方形边长)
device: 'cuda' 或 'cpu'
n_warmup: 预热迭代次数(排除 CUDA 冷启动开销)
n_iters: 正式测速迭代次数(建议 >=200,统计意义更强)
batch_size: 测速时的 batch 大小(模拟真实推理场景)
Returns:
包含 latency_ms、fps、peak_mem_mb 的字典
"""
# 提取底层 PyTorch 模型,避免 Ultralytics 封装的预/后处理开销
net = model.model.to(device).eval()
# 构造 dummy 输入:batch_size 张随机图,模拟推理输入
dummy = torch.randn(batch_size, 3, imgsz, imgsz).to(device)
# 清空显存统计计数器,确保峰值显存测量的准确性
if device == 'cuda':
torch.cuda.empty_cache()
torch.cuda.reset_peak_memory_stats(device)
# —— 预热阶段 ——
# CUDA kernel 首次启动有 JIT 编译/内存分配的冷启动开销
# 预热 50 次可以让这部分开销在测量之前充分"消散"
with torch.no_grad():
for _ in range(n_warmup):
net(dummy)
# 确保预热期间的所有 CUDA 异步操作已完成
if device == 'cuda':
torch.cuda.synchronize(device)
# —— 正式测速阶段 ——
# 记录开始时间(必须在 synchronize 之后,否则计时不准)
t_start = time.perf_counter()
with torch.no_grad():
for _ in range(n_iters):
net(dummy)
# 等待所有异步 CUDA 操作完成后再计时结束
# 不加这一行,计时只反映 CPU 发起调用的时间,非常不准
if device == 'cuda':
torch.cuda.synchronize(device)
t_end = time.perf_counter()
# —— 计算统计量 ——
total_time = t_end – t_start
latency_per_sample_ms = (total_time / n_iters / batch_size) * 1000
fps = (n_iters * batch_size) / total_time
peak_mem_mb = 0.0
if device == 'cuda':
peak_mem_mb = (
torch.cuda.max_memory_allocated(device) / (1024 ** 2)
)
return {
'latency_ms': round(latency_per_sample_ms, 3),
'fps': round(fps, 2),
'peak_mem_mb': round(peak_mem_mb, 2),
'device': device,
'imgsz': imgsz,
'batch_size': batch_size,
}
# ——————————————————————
# 工具函数:获取模型的参数量和 FLOPs
# ——————————————————————
def profile_params_flops(model: YOLO, imgsz: int = 640) –> dict:
"""
获取模型的参数量(M)和计算量(GFLOPs)。
直接调用 Ultralytics 的 model.info() 解析输出。
Returns:
包含 params_M、flops_G 的字典
"""
# model.info() 返回 (layers, params, gradients, flops)
info = model.model.info(verbose=False, imgsz=imgsz)
# Ultralytics >= 8.1 版本 info 返回 tuple,兼容处理
if isinstance(info, (list, tuple)) and len(info) >= 4:
_, params, _, flops = info[0], info[1], info[2], info[3]
else:
# 部分版本直接打印,需要从 model.info 源码获取
# 这里做一个 fallback:手动计算参数量
params = sum(p.numel() for p in model.model.parameters()
if p.requires_grad)
flops = None # 需要 thop 库,此处省略
return {
'params_M': round(params / 1e6, 3) if params else None,
'flops_G': round(flops, 3) if flops else None,
}
# ——————————————————————
# 主流程
# ——————————————————————
def run_baseline_profile(
model_path: str = 'yolov10n.pt',
data_yaml: str = 'coco128.yaml',
imgsz: int = 640,
output_json: str = 'baseline_profile.json'
) –> dict:
"""
对指定模型做完整的基线画像,输出所有核心指标。
Args:
model_path: 模型权重路径(.pt 文件)
data_yaml: 验证集配置文件(Ultralytics 格式 yaml)
imgsz: 输入分辨率
output_json: 结果保存路径(JSON 格式,便于后续对比)
Returns:
包含所有基线指标的字典
"""
print(f"\\n{'='*65}")
print(f" 基线画像 | 模型:{model_path}")
print(f"{'='*65}")
# 1. 加载模型
model = YOLO(model_path)
device = 'cuda' if torch.cuda.is_available() else 'cpu'
print(f" 运行设备:{device.upper()}")
# 2. 精度评估(在 val 集上跑推理)
print("\\n[1/3] 精度评估(mAP)…")
metrics = model.val(
data=data_yaml,
imgsz=imgsz,
verbose=False,
save=False,
plots=False
)
accuracy = {
'mAP50': round(float(metrics.box.map50), 4),
'mAP50_95': round(float(metrics.box.map), 4),
'Precision': round(float(metrics.box.mp), 4),
'Recall': round(float(metrics.box.mr), 4),
}
print(f" mAP50-95 : {accuracy['mAP50_95']}")
print(f" mAP50 : {accuracy['mAP50']}")
print(f" Precision: {accuracy['Precision']}")
print(f" Recall : {accuracy['Recall']}")
# 3. 参数量和计算量
print("\\n[2/3] 参数量 & FLOPs…")
arch_info = profile_params_flops(model, imgsz=imgsz)
print(f" Params : {arch_info['params_M']} M")
print(f" FLOPs : {arch_info['flops_G']} G")
# 4. 推理速度和显存
print("\\n[3/3] 推理速度 & 显存…")
speed_info = profile_speed(model, imgsz=imgsz, device=device)
print(f" 延迟 : {speed_info['latency_ms']} ms/帧")
print(f" 吞吐量 : {speed_info['fps']} FPS")
if device == 'cuda':
print(f" 峰值显存 : {speed_info['peak_mem_mb']} MB")
# 5. 汇总并保存
result = {
'model': model_path,
'imgsz': imgsz,
'device': device,
**accuracy,
**arch_info,
**speed_info,
}
with open(output_json, 'w', encoding='utf-8') as f:
json.dump(result, f, ensure_ascii=False, indent=2)
print(f"\\n结果已保存至 {output_json}")
print(f"{'='*65}\\n")
return result
if __name__ == '__main__':
run_baseline_profile(
model_path='yolov10n.pt',
data_yaml='coco128.yaml',
imgsz=640,
output_json='exp_baseline.json'
)
7.3 实验记录与对比框架
有了基线画像之后,每次做改进实验,都需要用相同的流程跑一次 run_baseline_profile(),然后和基线做对比。下面这段代码实现了一个简单但够用的"改进实验追踪器":
# ===================================================================
# experiment_tracker.py
#
# 功能:管理第六章所有改进实验的记录,自动计算相对基线的变化率,
# 并生成对比报告
# ===================================================================
import json
import pandas as pd
from pathlib import Path
from typing import Optional
class ExperimentTracker:
"""
第六章改进实验的轻量级追踪器。
使用方式:
tracker = ExperimentTracker('baseline_exp.json')
tracker.add('EXP-003', 'FasterBlock替换C2f', '提速', 'exp003.json')
tracker.summary()
"""
# 对比时关注的核心指标列
METRIC_COLS = ['mAP50_95', 'params_M', 'flops_G', 'fps', 'peak_mem_mb']
# 指标越高越好 or 越低越好(用于绘制趋势箭头)
HIGHER_IS_BETTER = {
'mAP50_95': True,
'params_M': False, # 越小越好(轻量化)
'flops_G': False, # 越小越好(提速)
'fps': True,
'peak_mem_mb': False # 越小越好
}
def __init__(self, baseline_json: str):
"""
Args:
baseline_json: 由 run_baseline_profile() 生成的基线 JSON 文件路径
"""
with open(baseline_json, 'r', encoding='utf-8') as f:
baseline_data = json.load(f)
self.baseline = baseline_data
self.records = []
# 把基线作为第 0 条记录
self._add_record(
exp_id='EXP-000',
module_name=f"{baseline_data['model']}(基线)",
direction='基线',
data=baseline_data
)
def add(
self,
exp_id: str,
module_name: str,
direction: str,
result_json: str
):
"""
添加一条改进实验记录。
Args:
exp_id: 实验编号,如 'EXP-003'
module_name: 改进模块名称,如 'FasterBlock替换C2f'
direction: 改进方向,'涨点' / '提速' / '轻量化' 之一
result_json: 改进后模型的 profile JSON 文件路径
"""
with open(result_json, 'r', encoding='utf-8') as f:
data = json.load(f)
self._add_record(exp_id, module_name, direction, data)
print(f"已添加实验 {exp_id}: {module_name}")
def _add_record(self, exp_id, module_name, direction, data):
record = {
'exp_id': exp_id,
'module': module_name,
'direction': direction,
}
for col in self.METRIC_COLS:
record[col] = data.get(col)
self.records.append(record)
def summary(self, show_delta: bool = True) –> pd.DataFrame:
"""
生成实验对比汇总表。
Args:
show_delta: 是否显示相对基线的变化率列(百分比)
Returns:
pandas DataFrame,可直接打印或导出 CSV
"""
df = pd.DataFrame(self.records)
if show_delta:
baseline_vals = {
col: self.baseline.get(col)
for col in self.METRIC_COLS
if self.baseline.get(col) is not None
}
for col in self.METRIC_COLS:
bval = baseline_vals.get(col)
if bval and bval != 0:
delta_col = f'Δ{col}(%)'
df[delta_col] = (
(df[col] – bval) / abs(bval) * 100
).round(2)
# 根据指标方向添加趋势符号
better = self.HIGHER_IS_BETTER.get(col, True)
df[delta_col] = df[delta_col].apply(
lambda v: (
f"▲{abs(v):.2f}%"
if (v > 0) == better and v != 0
else (f"▼{abs(v):.2f}%" if v != 0 else "—")
) if v is not None else "N/A"
)
print("\\n" + "=" * 80)
print(" 改进实验汇总报告")
print("=" * 80)
display_cols = (
['exp_id', 'module', 'direction']
+ self.METRIC_COLS
+ ([f'Δ{c}(%)' for c in self.METRIC_COLS] if show_delta else [])
)
display_cols = [c for c in display_cols if c in df.columns]
print(df[display_cols].to_string(index=False))
print("=" * 80)
print(" ▲ 表示该指标向好的方向变化 ▼ 表示向坏的方向变化")
print("=" * 80 + "\\n")
return df
def save_csv(self, path: str = 'experiments.csv'):
"""导出完整对比表到 CSV"""
df = self.summary(show_delta=True)
df.to_csv(path, index=False, encoding='utf-8-sig')
print(f"实验记录已导出至 {path}")
这套追踪器的设计思路是:每次做改进,跑一次 profile,生成 JSON,加到 tracker 里,一行 tracker.summary() 就能出汇总报告。不需要手动维护 Excel,不需要记忆之前的数字,整个实验历史全部有据可查。
八、三项工程基本原则
在正式进入第六章接下来每一节的"手术"之前,有三条原则我必须再强调一遍,因为它们被忽视的概率比任何具体技术都高,而忽视它们造成的损失也比任何具体技术失效都大。
8.1 单变量原则(Single Variable Principle)
每一次实验,只改动一个变量。
这条原则说起来简单,但在实际操作中非常容易被破坏:你想测试 GhostConv 的效果,结果顺手把训练 epoch 从 100 改成了 150;或者你换了一个 Neck 结构,同时也调整了学习率。这样一来,最终精度的变化,你根本说不清是哪个因素造成的。
消融实验(Ablation Study)的基础就是单变量原则。没有扎实的消融实验,你的改进报告就只是"运气的结果",而不是"方法论的产物"。
8.2 基线对比原则(Baseline Reference Principle)
永远保留一份未改动的基线模型和基线实验数据,作为所有改进的"锚点"。
这条原则看似废话,但我见过太多同学在做了七八次改进之后,已经找不到当初的"原始基线"了——因为他们每次都把上一次的改动当做"新的基线"继续改,最终完全失去了和"什么都没改"的模型的可比较性。
正确的做法是:基线模型永远不改,每一次实验都是"在基线的副本上做单一改动",改完之后 profile,记录到 tracker,然后回到干净的基线准备下一次实验。
8.3 可复现性原则(Reproducibility Principle)
固定随机种子,记录完整的实验配置(包括环境版本),所有实验结果配合代码一起归档。
为什么这条很重要?有两个典型场景:
场景一:你做了一次改进,mAP 涨了 0.8%,但因为没有固定随机种子,下次重跑结果变成涨了 0.2%,完全不稳定。这时候你就不知道这 0.8% 是真实的改进效益,还是随机种子带来的"运气"。
场景二:三个月后你想复现某次实验,结果发现 Ultralytics 版本已经更新了,模型加载方式变了,之前的代码直接报错。没有完整记录环境配置,复现成本极高。
最简单的可复现性保障,就是在每次实验开始时加上这几行:
import random
import numpy as np
import torch
SEED = 42
def set_seed(seed: int = SEED):
"""固定所有可能影响结果的随机种子"""
random.seed(seed)
np.random.seed(seed)
torch.manual_seed(seed)
torch.cuda.manual_seed_all(seed)
# 关闭 CUDNN 的随机优化(会牺牲少量速度,但确保结果可复现)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
set_seed()
并把实验配置(包括 Ultralytics 版本、CUDA 版本、Python 版本、关键超参数)一起存到 JSON 里:
import platform
import subprocess
def get_env_info() –> dict:
"""收集当前环境信息,用于实验归档"""
try:
torch_version = torch.__version__
cuda_version = torch.version.cuda or 'N/A'
# 获取 ultralytics 版本
result = subprocess.run(
['pip', 'show', 'ultralytics'],
capture_output=True, text=True
)
ul_version = 'unknown'
for line in result.stdout.split('\\n'):
if line.startswith('Version:'):
ul_version = line.split(':')[1].strip()
break
except Exception:
torch_version = cuda_version = ul_version = 'unknown'
return {
'python': platform.python_version(),
'os': platform.system(),
'torch': torch_version,
'cuda': cuda_version,
'ultralytics': ul_version,
'seed': SEED,
}
九、第六章全景地图:29 节改进工具箱的整体布局
把三大改进方向和 YOLOv10 网络结构的四个层次(Backbone、Neck、Head、Loss)对应起来,第六章接下来的 29 节大致的分布是这样的:
| 第2节 | yaml 配置与模块注册工程方法 | 基础工具 | 全局 |
| 第3-6节 | FasterBlock、GhostConv、DWConv、DynamicConv | 提速 / 轻量化 | Backbone |
| 第7-9节 | DCNv3/v4、空洞卷积、WTConv小波卷积 | 涨点(感受野) | Backbone |
| 第10节 | RepVGG 重参数化 | 提速 + 涨点 | Backbone |
| 第11-14节 | ConvNeXt、EfficientNet、MobileNetV3、ShuffleNetV2 | 轻量化 | 骨干整体替换 |
| 第15-20节 | SENet、CBAM、Coordinate Attention、ECA-Net、GAM、SimAM | 涨点(注意力) | 全局可嵌入 |
| 第21-23节 | BiFPN、AFPN、P2 小目标层 | 涨点(特征融合) | Neck |
| 第24-26节 | 一对一/一对多 Head、Dynamic Head、PSA 局部自注意力 | 涨点(检测头) | Head |
| 第27-29节 | SIoU/EIoU/WIoU、Focal/Varifocal Loss、NWD 损失 | 涨点(损失) | Loss |
| 第30节 | 综合评估与最优组合推荐 | 综合 | 全局 |
这张地图有两个建议的"使用方式":
方式一:按需查阅。如果你的场景是"小目标精度不足",优先精读第 15-17 节(注意力机制)、第 21-23 节(Neck 改进)、第 27-29 节(损失函数),其他节次可以先了解结论、推迟精读。
方式二:顺序学习。如果你希望系统性地掌握 YOLOv10 改进的全貌,建议按节次顺序学习。第 2 节的工程基础非常重要,是后续所有节次的"脚手架",不能跳过。
十、真实场景的改进决策演练
案例一:工业 PCB 缺陷检测(精度优先)
场景:电子制造产线,检测 PCB 板上的微小焊点缺陷(目标边长通常 8-20 像素),部署在产线旁的工控机(GTX 1660 SUPER),节拍 2 秒/张,FPS > 10 即可,客户的核心诉求是"不漏检"(Recall 要高)。
决策过程:
- 硬件约束:GTX 1660 SUPER,显存 6GB,FLOPs < 30G 均可接受 ✓
- 实时性:FPS > 10,当前基线 168FPS,远超要求 ✓
- 精度短板:小目标(8-20 像素)严重漏检,Recall 偏低
选择路线:涨点优先,重点解决小目标召回率
改进方案(按优先级):
预期收益:小目标 AP 提升 5%-10%,整体 mAP50-95 提升 2%-4%,FPS 从 168 降至约 120(因为 P2 层的计算量),但仍远超 FPS > 10 的要求。
案例二:智慧城市多路摄像头并发推理(提速优先)
场景:城市路口安防,单服务器挂载 32 路摄像头(720P,25fps),要求所有路的视频都能实时处理,单路延迟 < 35ms(25fps 的帧间隔是 40ms,留 5ms 余量),部署在 RTX 3080(显存 10GB)。
决策过程:
- 硬件:RTX 3080,算力充足,但 32 路并发对单模型的吞吐量要求极高
- 实时性:35ms/帧,32 路 = 800 帧/秒的整体吞吐量需求 ← 这是核心约束
- 精度:客户要求行人检测 AP > 0.6,当前基线满足
选择路线:提速优先,同时控制精度不要明显下降
改进方案:
预期收益:FPS 从 168 提升至 220-250,FLOPs 下降 20%-30%,mAP 精度损失 < 1%,满足 32 路并发需求。
案例三:无人机航拍目标检测(轻量化优先)
场景:电力巡检无人机,机载算力模块为某低功耗 AI 芯片(峰值算力 2 TOPS INT8),要求模型 INT8 FLOPs(等效 FP32 FLOPs)< 3G,参数量 < 5M,检测输电线塔上的异物。
决策过程:
- 硬件:2 TOPS AI 芯片,FLOPs < 3G(极严苛约束)← 轻量化是生死线
- 当前基线(YOLOv10n):FLOPs ≈ 6.7G,超出约束 1 倍,必须先解决这个问题
- 精度:异物检测对精度有要求,但首先得"跑起来"
选择路线:轻量化优先,在满足约束后尽可能保住精度
改进方案:
这套方案估计能把整体 FLOPs 压到 2.0-2.5G,Params 降至 2-3M,满足硬件约束,mAP 预计下降 4%-7%,但这是在硬约束下的"最优解",而不是"理想解"。
十一、常见误区与避坑指南
做了这么多改进实验,也见过很多同学踩坑,在这里集中梳理几个最常见的误区:
误区一:“论文里涨了 2%,我的数据集上应该也能涨 2%”
这是最大的认知偏差。论文里的结果通常是在 COCO、ImageNet 等标准数据集上,用特定的训练策略、特定的硬件、特定的数据增强组合跑出来的。你的自定义数据集,样本分布、类别特性、标注质量都不同,直接套用论文里的数字是不靠谱的。唯一可信的,是你在自己的数据集上实测出来的数字。
误区二:“参数量少了,模型应该更快”
如前所述,FLOPs 和参数量都不等于实际延迟。必须在目标硬件上实测。
误区三:“加更多注意力模块,精度一定更高”
注意力模块是有"边际递减"效应的——第一个 SE 模块可能带来 0.5% 的涨点,叠加第二个 SE 可能只有 0.1%,叠加第三个 SE 可能反而因为过拟合或梯度干扰而掉点。不是越多越好,而是"够用就好"。
误区四:“改进前后对比时,没有控制训练超参数一致”
如果基线用了 100 epoch,改进模型用了 200 epoch,那精度的提升可能大部分来自训练时间的增加,而不是结构改进。对比必须公平:相同 epoch 数、相同学习率策略、相同数据增强、相同随机种子。
误区五:“只看 mAP,不看 Recall”
对于很多工业检测场景,漏检的代价远大于误检。一个 mAP 很高但 Recall 很低的模型,在"不漏检"的业务场景里是不合格的。评估时一定要同时看 Precision 和 Recall,根据业务场景决定哪个更重要。
本节小结
这一节我们从三个层次建立了第六章的"改进框架":
第一个层次是"认知框架"——把改进目标明确划分为涨点、提速、轻量化三个方向,每个方向有各自的核心评估指标和技术武器库。理解了这三个方向的本质差异和相互关系,就不会再做"撒网式"的盲目改进。
第二个层次是"决策框架"——四步法(明确硬件约束 → 评估实时性 → 定位精度短板 → 按优先级选方案),加上三个真实场景的完整演练,把抽象的方法论变成了可操作的工程决策流程。
第三个层次是"工具框架"——baseline_profile.py 和 ExperimentTracker 两段代码,构建了贯穿第六章所有实验的"度量仪器"和"记录系统",确保所有改进结果都可量化、可对比、可复现。
还有三条工程原则——单变量、基线对比、可复现性——这是所有工程实践的元原则,不只是本章适用,任何涉及实验对比的工作都适用。
接下来第2节,我们就要解决"工程基础"的问题——怎么往 YOLOv10 里"装进"一个新的 PyTorch 模块,yaml 配置文件的语法、Ultralytics 的模块注册机制、前向传播的调试方法。这是后续 27 节"手术"的"手术室准备工作",同样不能跳过。
最后说一句:改进模型这件事,没有捷径,也没有银弹。你在这一节里建立的"方法论",远比你直接复制一段 CBAM 代码塞进模型更有价值。方法论对了,每一次"失败的实验"都是信息,而不是浪费;方法论不对,就算偶然涨了几个点,也不知道下次该怎么重复这个"成功"。咱们下节见 🚀
📌 附录
相关参考资料
- YOLOv10 官方论文:YOLOv10: Real-Time End-to-End Object Detection,Wang et al., 2024,arXiv: 2405.14458
- YOLOv10 核心机制:Consistent Dual Assignments(一致性双重标签分配)
- YOLOv10 端到端检测机制:One-to-Many + One-to-One Dual Assignments
- YOLOv10 高效模型设计:Holistic Efficiency-Accuracy Driven Model Design
- YOLOv10 NMS-Free 推理:End-to-End Object Detection without NMS
- DFL 相关:Generalized Focal Loss: Learning Qualified and Distributed Bounding Boxes for Dense Object Detection
- COCO 数据集基准:https://cocodataset.org
- YOLOv10 官方仓库:https://github.com/THU-MIG/yolov10
- PyTorch 官方安装指南:https://pytorch.org/get-started/locally/
- NVIDIA CUDA Toolkit 归档:https://developer.nvidia.com/cuda-toolkit-archive
- Miniconda 下载:https://docs.conda.io/en/latest/miniconda.html
- 本节所有脚本代码:见文章各代码块,可直接复制使用
COCO:
| YOLOv10-N | 640 | 38.5% | 2.3M | 6.7G | 1.84 ms |
| YOLOv10-S | 640 | 46.3% | 7.2M | 21.6G | 2.49 ms |
| YOLOv10-M | 640 | 51.1% | 15.4M | 59.1G | 4.74 ms |
| YOLOv10-B | 640 | 52.5% | 19.1M | 92.0G | 5.74 ms |
| YOLOv10-L | 640 | 53.2% | 24.4M | 120.3G | 7.28 ms |
| YOLOv10-X | 640 | 54.4% | 29.5M | 160.4G | 10.70 ms |
希望本文围绕 YOLOv10 的实战讲解,能够在以下几个维度上切实帮助到你:
- 🎯 模型精度提升:结合 YOLOv10 的一致性双重标签分配、端到端检测机制与整体效率-精度设计思想,从网络结构、特征融合、检测头、标签分配、损失函数和数据增强等方向展开优化,通过工程实验进一步提升目标检测精度;
- 🚀 推理速度优化:结合 YOLOv10 的 NMS-Free 推理机制,以及模型轻量化、结构重参数化、剪枝、量化、知识蒸馏与部署加速策略,帮助模型在真实业务场景中运行得更快、更稳定;
- 🧩 工程落地实践:覆盖数据准备、环境配置、模型训练、效果评估、问题排查、模型导出与部署推理等完整链路,提供可直接复用或稍加修改即可迁移的工程级方案;
- 🧠 核心机制理解:深入分析 YOLOv10 中 One-to-Many 与 One-to-One 双标签分配机制、一致性匹配度量、端到端检测以及高效网络设计 的设计逻辑,帮助你理解模型性能提升背后的原因,而不是停留在简单调用层面;
- 🔬 改进方案验证:通过消融实验、指标对比与可视化分析,评估不同改进模块对 Precision、Recall、mAP、FPS、Latency、参数量和 FLOPs 的实际影响。
PS:如果你按照文中步骤对 YOLOv10 进行优化后仍然遇到问题,请不必焦虑或灰心。
YOLOv10 是一个涉及网络结构、特征提取、标签分配、梯度优化、端到端预测与部署环境的复杂目标检测框架,最终表现会受到 硬件环境、数据集质量、任务定义、类别分布、训练配置、代码版本与部署平台 等多重因素的共同影响。
这是目标检测项目中十分常见的客观现象,并不意味着某个改进模块一定无效。
如果你在实践过程中遇到以下问题:
- 🐛 模块替换后出现新的报错或 Bug;
- 📉 Precision、Recall 或 mAP 难以继续提升;
- 📈 训练损失异常、梯度不稳定或模型难以收敛;
- 🎯 One-to-One / One-to-Many 分支训练效果异常;
- ⏱️ 推理速度、Latency、显存占用或部署性能不达预期;
- 🔄 修改网络结构后出现维度、通道数或特征层不匹配;
- ⚙️ 修改检测头后端到端预测分支出现兼容性问题;
- 📦 模型导出 ONNX、TensorRT、OpenVINO 等格式时失败;
欢迎将 完整报错信息 + 环境版本 + 关键配置截图 + 网络配置文件 + 核心代码片段 粘贴至评论区,我们可以一起分析问题根因,并探讨更加可行的解决方案。
如果你已经摸索出更优的训练参数、网络结构、标签分配策略、模块组合或部署优化思路,也非常欢迎在评论区分享。
你的每一条实战经验,都可能成为其他开发者解决问题、减少试错成本的关键线索。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对 YOLOv10 的主流改进方案进行重构与再设计,使内容更加贴近工业检测、智慧交通、游戏分析、行为识别、遥感影像、无人机视觉与边缘设备部署等真实应用场景。
# 🧧🧧 文末福利,等你来拿!🧧🧧
📌 文中所涉及的技术内容,大多来源于本人在 YOLOv10 项目中的一线实践积累,部分案例参考了开源项目、公开论文、技术社区资料与读者反馈。
如有版权相关问题,欢迎第一时间联系,我将尽快核实并进行修改或下线处理。
部分问题分析思路与排查路径参考了技术社区及 AI 问答平台,在此一并致谢 🙏
最后想说的是:
YOLOv10 的优化本质上是一个高度依赖任务、数据和部署环境的系统工程问题,不存在“一招通杀”的银弹方案。
一致性双重标签分配、One-to-Many / One-to-One 检测策略、注意力机制、轻量化卷积、改进检测头、IoU 损失函数、特征融合模块和数据增强策略,都有其适用条件。
某个模块在公开数据集上取得提升,并不意味着它能够在所有自定义数据集、硬件平台和业务场景中获得同样收益。
尤其对于 YOLOv10 而言,在进行结构改进时还需要额外关注 端到端检测分支、标签分配一致性以及 NMS-Free 推理链路。某些直接从 YOLOv8、YOLOv9、YOLOv11 等模型迁移过来的模块,如果没有处理好检测头与训练分支之间的适配关系,也可能出现精度下降、训练不稳定或推理逻辑异常等问题。
真正有效的优化路径,永远源于:
- 对业务目标与评价指标的准确理解;
- 对数据质量和类别分布的持续分析;
- 对模型瓶颈的定位与针对性改进;
- 对 One-to-Many 与 One-to-One 分支机制的正确理解;
- 对实验变量的严格控制;
- 对精度、速度、Latency、参数量和部署成本的综合权衡;
- 以及一轮又一轮可复现的对比实验。
如果你已经在自己的项目中探索出了更加高效、稳定的 YOLOv10 优化路径,非常鼓励你:
- 💬 在评论区简要分享核心思路与实验结论;
- 📊 分享不同模块的消融实验结果;
- 📝 将完整过程整理成教程、博客或系列文章;
- 🔧 提交可复现的配置文件、代码或工程实践经验。
你的经验,或许正是别人卡关已久所缺少的最后一块拼图。
✅ 本期关于 YOLOv10 优化与实战应用 的内容就先聊到这里。
如果你想进一步深入:
- 🔍 系统理解 Consistent Dual Assignments 与 YOLOv10 的整体网络结构;
- 🎯 深入理解 One-to-Many 与 One-to-One 双标签分配机制;
- 🚀 掌握 YOLOv10 无 NMS 端到端目标检测的实现原理;
- 🧱 学习主干网络、颈部网络、检测头与特征融合模块的改进方法;
- 📉 掌握损失函数、匹配度量、样本分配与训练策略的优化技巧;
- ⚡ 对比不同场景下的模型轻量化与部署加速方案;
- 🧪 建立规范的消融实验、指标对比与模型评估流程;
- 🧠 系统构建一套属于自己的 YOLOv10 调优方法论;
欢迎继续关注专栏:《YOLOv10实战:从入门到深度优化》
期待这些内容能够在你的项目中真正落地见效,帮助你 少踩坑、多提效、快验证、稳部署,我们下期见。
✨ 当然,如果 YOLOv10 专栏已经无法满足你,也可以继续关注:
-
《YOLOv9实战:从入门到深度优化》
-
《YOLOv11实战:从入门到深度优化》
-
《YOLOv12实战:从入门到深度优化》
更多新版本、新模块与新论文的工程复现内容,也会持续更新。
✍️ 码字不易,如果这篇文章对你有所启发或帮助,欢迎给我来个 一键三连:关注 + 点赞 + 收藏。
你的支持,是我持续输出高质量 YOLOv10 技术内容与工程实战案例最直接的动力来源。
同时诚挚推荐关注我的技术号: 「猿圈奇妙屋」
在这里,你可以:
- 📡 第一时间获取 YOLOv10、目标检测、多目标追踪与多任务学习等方向的进阶内容;
- 🛠️ 获取视觉算法、深度学习与模型部署的最新优化方案和工程实战经验;
- 📚 学习 PyTorch、OpenCV、ONNX、TensorRT 等相关技术;
- 🎁 获取 BAT 大厂面经、技术书籍 PDF、工程模板与常用工具清单等实用资源。
期待在更多维度上与你一起进步、共同成长。
👨💻 About Me · 关于作者
我是专注于 计算机视觉、图像识别、目标检测与深度学习工程落地 的讲师和技术博主,笔名 bug菌:
- 活跃于 CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等多个技术社区;
- CSDN 博客之星 Top 30、华为云多年度十佳博主及卓越贡献奖获得者、掘金多年度人气作者 Top 40;
- CSDN、掘金、InfoQ、51CTO 等平台签约作者及优质创作者;
- 全网粉丝累计 30w+。
更多高质量技术内容与成长资料,可查看合集入口:
👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入,一起进阶、一起打怪升级。
– End –

评论前必须登录!
注册