 网硕互联帮助中心
目录
- 一、任务设定:为什么只生成数字 8
- 二、前向过程:200 步把一张图毁掉
- 三、制造训练样本:本集的核心
- 四、两个关键认知
- 五、U-Net:扩散模型的"大脑"
- U-Net 不是必选项,只是经典实现
- 核心设计:时间信号怎么进网络
- 六、训练与反向生成
- 七、路线选择:什么时候从零写,什么时候用现成库
- 八、常见问题 FAQ
- 结语
摘要:本文以「只生成数字 8」的极简设定,完整走通 DDPM 扩散模型的最小闭环:前向过程用 200 步把清晰图像逐步加噪成纯噪声,制造训练样本时随机采样噪声与时间步、按闭式公式一步到位构造带噪图;U-Net 作为噪声预测网络,通过「CNN + 时间图」注入步数信息,训练目标是预测噪声与真实噪声的 MSE;反向生成时从纯噪声出发,按 DDPM 反推公式逐步去噪,最终还原出手写风格的数字 8。全文覆盖任务设定、前向加噪、样本构造、U-Net 结构、训练与反向采样、路线选择及 12 个常见问题,帮助读者从零理解扩散模型的完整链路。
DDPM扩散模型代码实战:前向加噪造数据、U-Net噪声预测与反向生成手写数字
一句话概括:扩散模型代码实战第一课,只做一件事——不用任何条件引导,让模型从纯噪声里"无中生有"画出 MNIST 风格的手写数字 8;整条链路就三步:前向加噪造训练样本、U-Net 学预测噪声、反向采样逐步去噪生成。
DDPM(Denoising Diffusion Probabilistic Model,去噪扩散概率模型)由两个过程构成:前向过程对清晰图像逐步加入高斯噪声,T=200 步后图像退化为纯噪声;反向过程训练一个 U-Net,输入带噪图 x_t 和时间步 t,预测当初加入的噪声 ε,训练目标是预测噪声与真实噪声的 MSE。推理时从一张纯随机噪声出发,反复"预测噪声→按公式去噪",200 步后还原出清晰图像。本文以"只生成数字 8"的极简设定走通完整闭环。
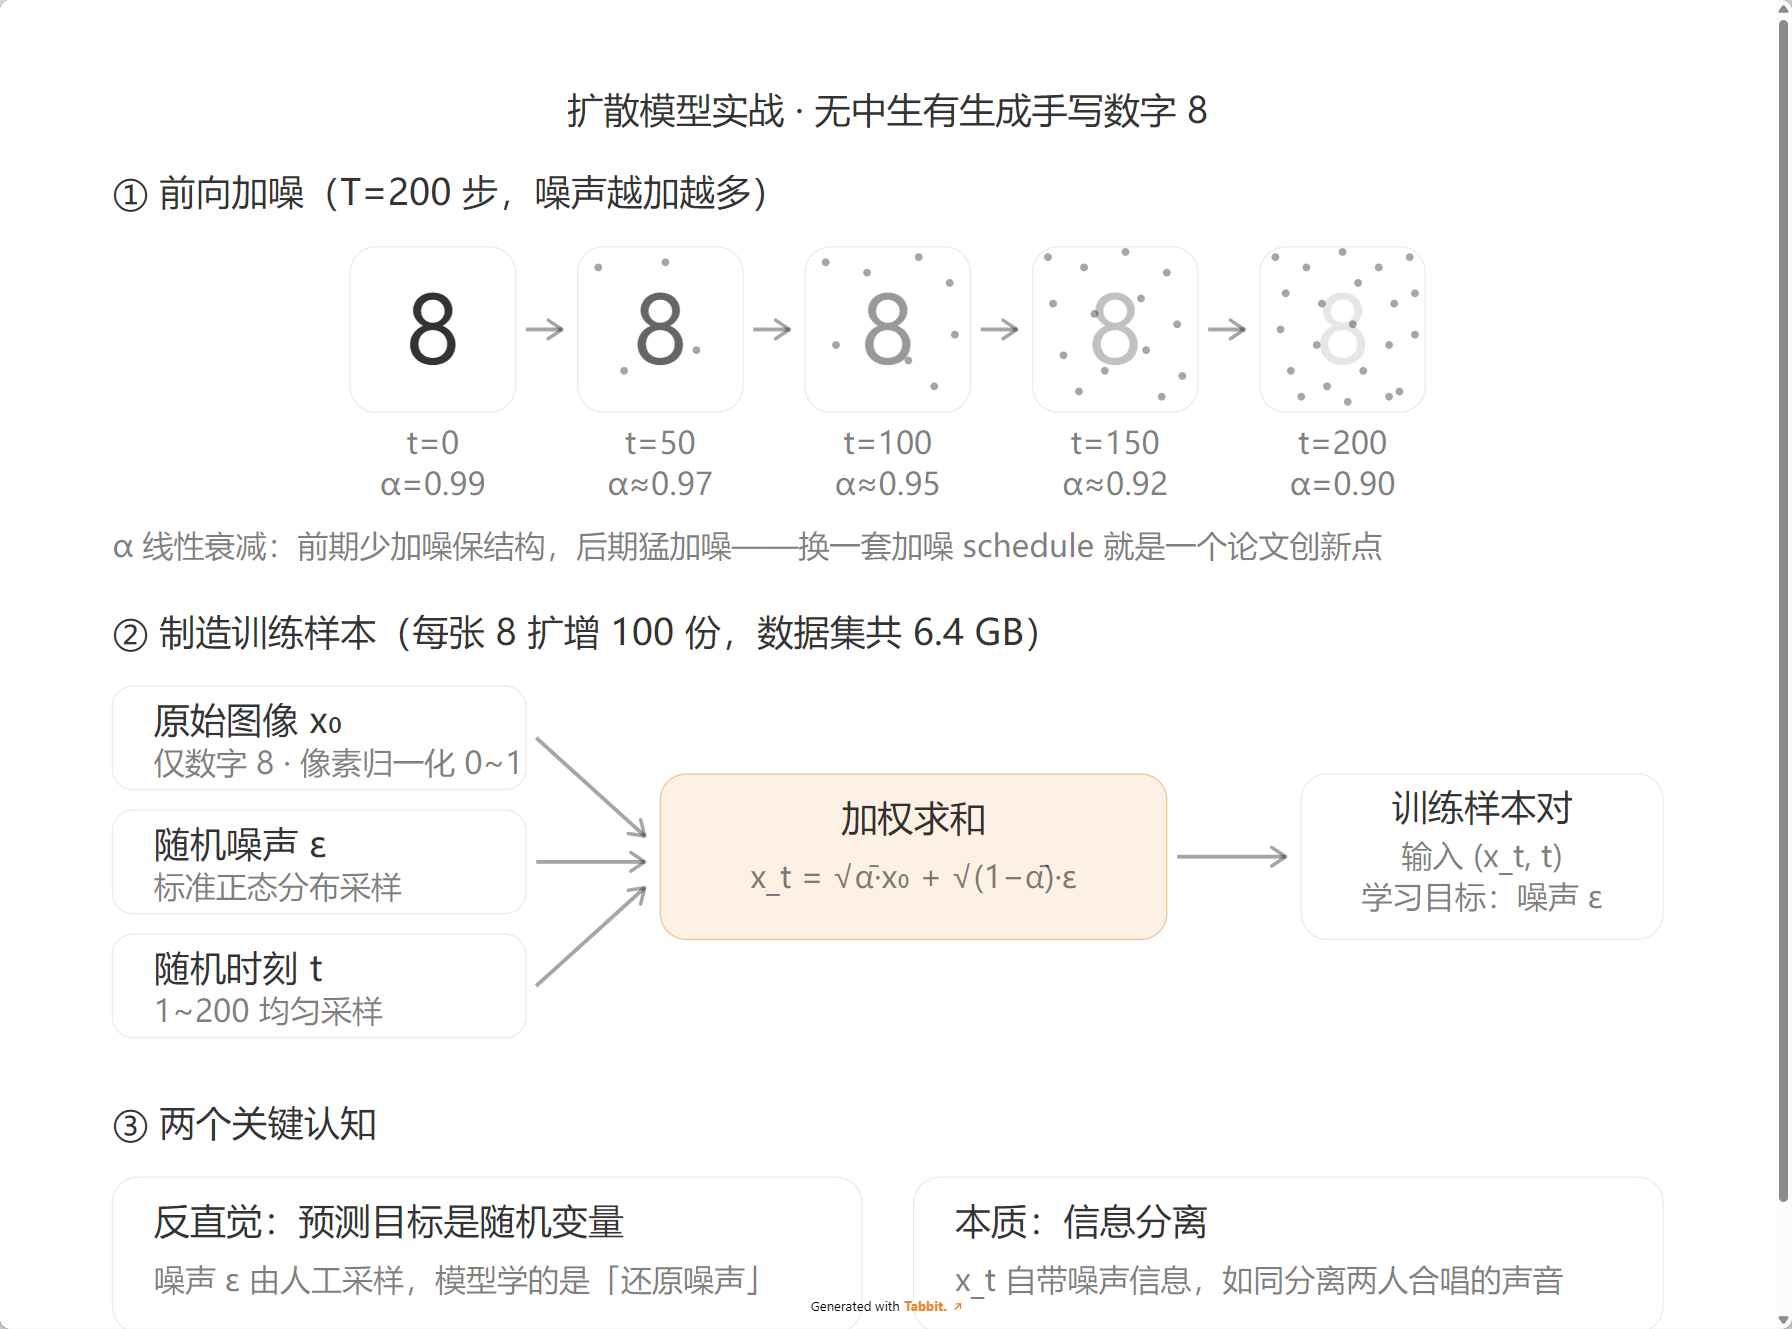
扩散模型实战图解:无中生有生成手写数字 8
U-Net 噪声预测网络与反向生成图解
一、任务设定:为什么只生成数字 8
为了把问题简化到能在 CPU 上跑通,本集做了三个取舍:只复原数字 8(其他数字全部跳过)、28×28 灰度图(像素 0–255 归一化到 0–1)、无条件生成(不喂类别标签,模型自己学会"数字 8 长什么样")。任务虽简单,但前向加噪、样本构造、网络结构、反向采样四个环节一个不少——这是理解扩散模型全貌的最小闭环。
二、前向过程:200 步把一张图毁掉
扩散模型的起点不是"生成",而是"破坏"。从清晰图 x₀ 出发,每一步按比例保留原图像素、混入新噪声。
关键符号辨析(新手最容易混):
- α_t(单步保留率):每一步保留上一步图像的比例。本集 CONFIG 设 α 从 0.99 线性衰减到 0.9——前期少加噪保结构,后期猛加噪彻底侵蚀;
- ᾱ_t(代码里的 alpha_M,累积保留率):从 α₁ 连乘到 α_t 的结果,越乘越小,代表 t 步后原图整体还占多少比例。
任意一步的加噪公式(DDPM 闭式解,不必真做 200 步迭代):
xt=αˉt⋅x0+1−αˉt⋅ε,ε∼N(0,I)xt=αˉt⋅x0+1−αˉt⋅ε,ε∼N(0,I)
t=0 时 ᾱ≈1,x_t≈原图;t=200 时 ᾱ≈0,x_t≈纯噪声。这就是训练样本可以"一步到位"现场构造的原因。
讲师题外话:这套线性 schedule 只是论文原始做法,换成更好的加权 schedule(如余弦 schedule)并调优,本身就是论文级创新点——这是新手切入扩散模型研究的现实缝隙。
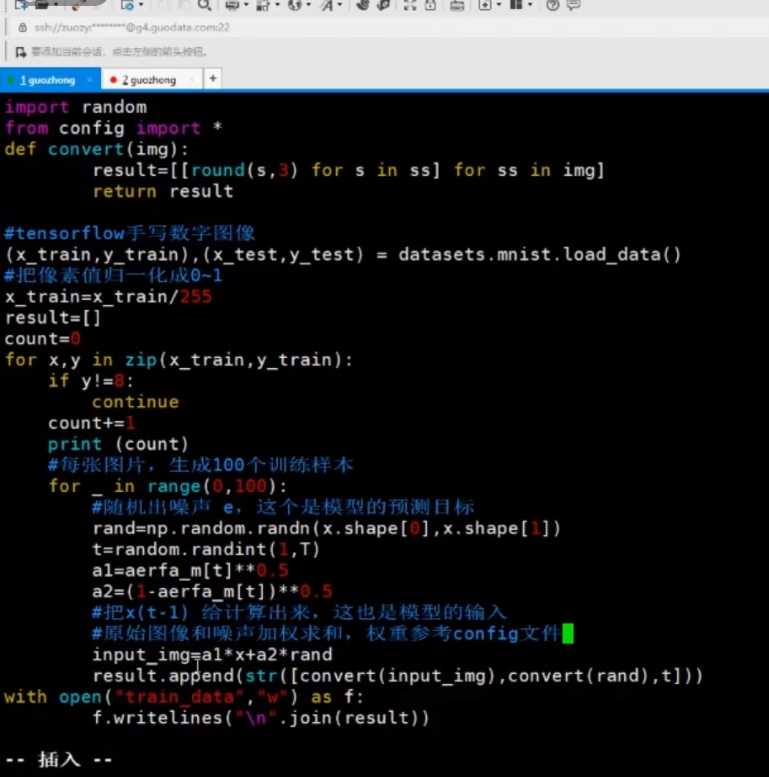
三、制造训练样本:本集的核心
数据流程:
反直觉点就在这里:模型要预测的目标,是一个人工随机采出来的变量。但这恰恰是训练能收敛的原因——每张真实图都对应无数个"它加了噪长什么样"的样本,数据被凭空放大上百倍。
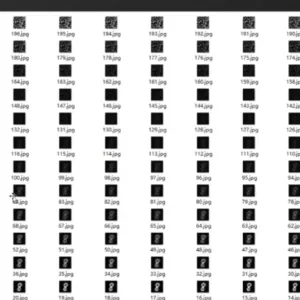
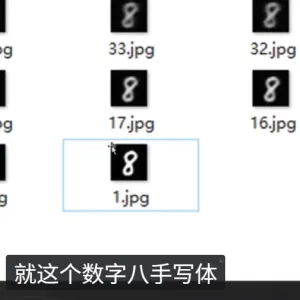
最终输出由电脑「手写」 的数字八!
四、两个关键认知
认知一:学的是"还原当初加进去的噪声",而噪声本身是随机的。扩散模型不直接学"数字 8 长什么样",它学的是任何时刻 x_t 里"哪部分是噪声、该怎么扣掉"。
认知二:模型干的其实是信息分离。x_t 里混着图像信号和噪声两份信息,模型本质是把它们拆开——就像把两人合唱的录音分离成两条独立音轨。这也解释了为什么输出必须和输入同尺寸:只有同尺寸才能逐元素减除噪声。
五、U-Net:扩散模型的"大脑"
U-Net 不是必选项,只是经典实现
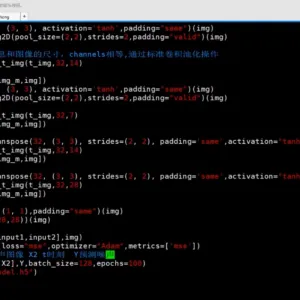
论文里只有数学公式占位符,没规定网络结构。U-Net 最早为图像分割设计:先卷积池化越压越小(提语义),再反卷积越放越大(恢复分辨率),天然满足"输入加噪图、输出同尺寸噪声图"。它的**跳跃连接(skip connection)**把编码器同层特征直接加到解码器对应层,让去噪复用细节。想换结构完全可以。
核心设计:时间信号怎么进网络
模型要从 x_t 恢复 x_{t-1},就必须知道"现在是第几步 t"。本集做法:
一句话:这个模型就是"CNN + 时间"。
六、训练与反向生成
训练:输入 (x_t, t),输出预测噪声 ε̂,MSE 反向传播。GPU 约 1 小时训完,纯 CPU 约五六个小时。
生成(把过程倒着放):
xt−1=1αt(xt−1−αt1−αˉtε^θ(xt,t))+σtz,z∼N(0,I)xt−1=αt1(xt−1−αˉt1−αtε^θ(xt,t))+σtz,z∼N(0,I)
(最后一步 t=1→0 不加随机噪声 z;σ_t 为由 schedule 决定的固定方差项。)
整条链路落到代码上就三段:造训练数据 → 搭 U-Net → 反向采样生成,核心代码几十行。论文数学符号唬人,实现本身不难。
七、路线选择:什么时候从零写,什么时候用现成库
| 学习原理、课程作业、复现最小闭环 | 从零手写(只生成8、T=200、CPU可训) |
| 要生成全部 10 类数字、清晰效果 | 扩大数据集 + 加深加宽 U-Net + 更多 epoch |
| 生产级海报级图像 | 直接用 Hugging Face diffusers 加载预训练模型,不要从零训 |
| 想做研究发论文 | 从换加噪 schedule(linear→cosine)切入,公认易出成果 |
八、常见问题 FAQ
Q1:为什么预测噪声而不是直接预测清晰图? 数学上可证明:高斯加噪设定下,预测"该减去多少噪声"比直接回归 x₀ 更容易学,且每步都能用同一网络、同一 MSE 训练;预测噪声是 DDPM 的核心训练目标。
Q2:α_t 和 ᾱ_t 有什么区别? α_t 是单步保留率(本集 0.99→0.9 线性衰减);ᾱ_t 是 α₁ 到 α_t 的连乘累积保留率,越乘越小。加噪公式里用的是 ᾱ_t——代码里最常见的下标写错点。
Q3:时间 t 为什么必须输入?不传会怎样? 不同噪声浓度需要不同去噪量,模型不知道步数就无法判断该去多少噪,训练无法收敛。本集做法是把 t 变成 28×28 时间图逐像素相加。
Q4:U-Net 是必备结构吗? 不是。任何输入输出同尺寸、能逐像素预测的网络都可以;U-Net 因先压缩再放大的结构和跳跃连接成为最常用实现。
Q5:为什么每张图扩增 100 个样本? t 和 ε 都是随机采样的,同一原图加不同噪声、在不同步数上构成无穷多样本;扩增 100 倍让模型见到"同一内容在各种噪声浓度下"的样子。
Q6:反向生成公式是什么? x_{t-1} = (1/√α_t)(x_t − (1−α_t)/√(1−ᾱ_t)·ε̂) + σ_t·z;每步用 U-Net 预测噪声并扣掉,除最后一步外加回小随机噪声 z 维持多样性。
Q7:为什么从纯噪声开始? 训练时见过最大 t 处 x_t≈纯噪声,从 N(0,I) 采样正好落在训练分布边界上,反向走一遍就是完整去噪路径。
Q8:没有 GPU 能跑吗? 能。本设定纯 CPU 约 5–6 小时;生产级大模型才必须 GPU。
Q9:生成的数字模糊不像,通常什么原因? 训练轮数不够、schedule 不合理、U-Net 容量太小或时间信号没正确注入;先看训练损失曲线和中间去噪过程可视化定位。
Q10:扩散模型和 GAN 有什么区别? GAN 一次出图、靠判别器博弈,训练不稳定易模式崩塌;扩散模型多步去噪、训练稳定、样本覆盖全,代价是推理慢(200 步串行)。
Q11:为什么只生成数字 8? 教学简化:单类别能把整条链路跑通,而不必先解决多类别条件控制这个更复杂的问题。
Q12:换加噪 schedule 为什么能发论文? 加噪节奏决定训练信号分布和采样效率,线性 schedule 只是众多方案之一;更优 schedule 能在更少步数下得到更好效果,是扩散研究的经典切入点。
九、常见问题排查指南
前面 FAQ 回答了原理层面的疑问,这一节聚焦实战中最容易卡住的三类问题:训练不收敛、生成图像模糊、显存不足。下面按「现象 → 原因 → 解决步骤」给出可操作的排查路径。
问题一:训练不收敛(损失不下降或震荡)
典型现象:训练多轮后 MSE 损失曲线几乎水平,或上下剧烈震荡不下降;反向生成时输出仍是纯噪声或大片灰块。
可能原因与解决步骤:
问题二:生成图像模糊、不像数字 8
典型现象:反向生成 200 步后,输出能看出轮廓但边缘模糊,或形状不像数字 8。
可能原因与解决步骤:
问题三:显存不足(OOM)
典型现象:训练或采样时报 CUDA out of memory,或 batch size 稍大就崩溃。
可能原因与解决步骤:
通用排查顺序建议:先看损失曲线判断收敛状态,再可视化中间去噪过程定位模糊来源,最后用 nvidia-smi 确认显存占用。三步走完,绝大多数问题都能定位到具体环节。
结语
这两集只做了一件事:把"从噪声生成数字 8"这条最小闭环走通——前向加噪是为了造数据,U-Net 是为了学噪声,反向采样是把训练好的能力"倒放"成生成。论文符号看着唬人,落到代码上就是造数据、搭模型、生成三段。
本文基于 2026 年 10 月课程内容整理;超参(T=200、α=0.99→0.9、每图扩增100份)以原课程代码为准。
参考延伸:DDPM 原论文 Denoising Diffusion Probabilistic Models(Ho et al., 2020)|Hugging Face Diffusers MNIST 教程|浙大《计算摄影学》Lab6-Unet&DDPM 讲义


评论前必须登录!
注册