 网硕互联帮助中心
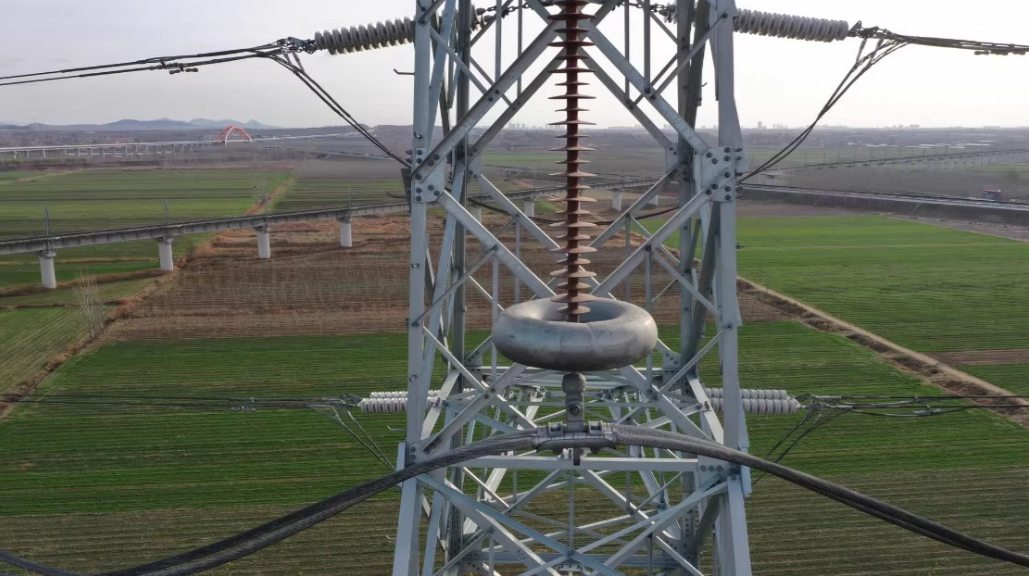
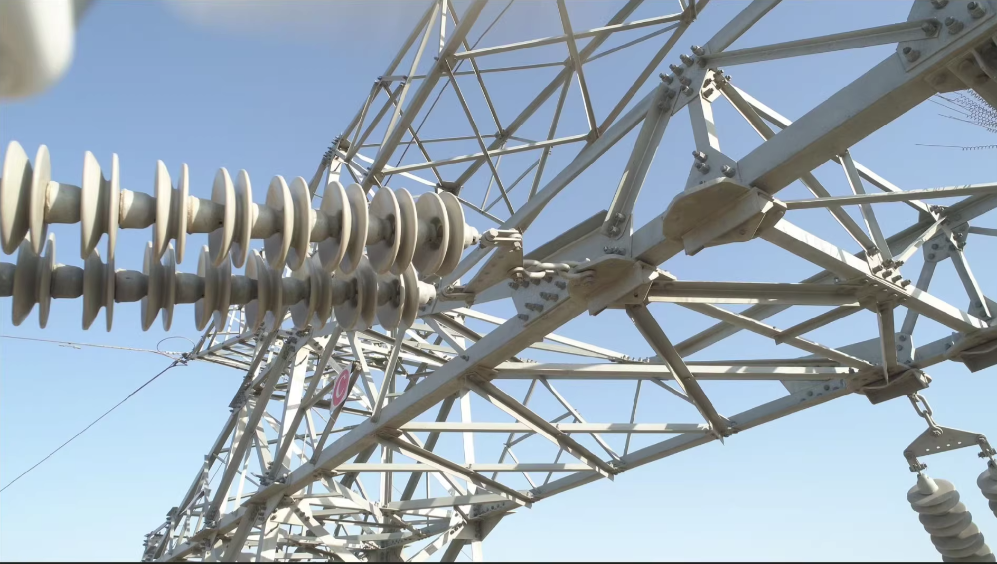
使用yolov8训练使用高压输电线路巡检数据集来一个权重 识别防振锤 复合绝缘子 三角连板环型,球窝,槽型 连接 防震环鸟巢 楔形线夹球窝连接等类别,并构建一个输电线路巡检系统检测
文章目录
- 使用yolov8训练使用高压输电线路巡检数据集来一个权重 识别防振锤 复合绝缘子 三角连板环型,球窝,槽型 连接 防震环鸟巢 楔形线夹球窝连接等类别,并构建一个输电线路巡检系统检测
-
- 文章所有代码仅供参考!
-
- 数据准备
-
- 数据集结构示例
- 环境部署说明
-
- 安装依赖
- 数据预处理 `data_preprocessing.py`
- 模型定义与训练 `train.py`
- 评估模型 `evaluate.py`
- 用户界面 `ui.py`
- 不带用户界面的预测脚本 `without_ui.py`
- 辅助工具 `tools/check_img.py`
- 辅助工具 `tools/check_ann.py`
- 使用说明
- 示例
yolov8训练使用高压输电线路巡检数据集 做一个权重并 构建代码 做一个高压输电线路巡检系统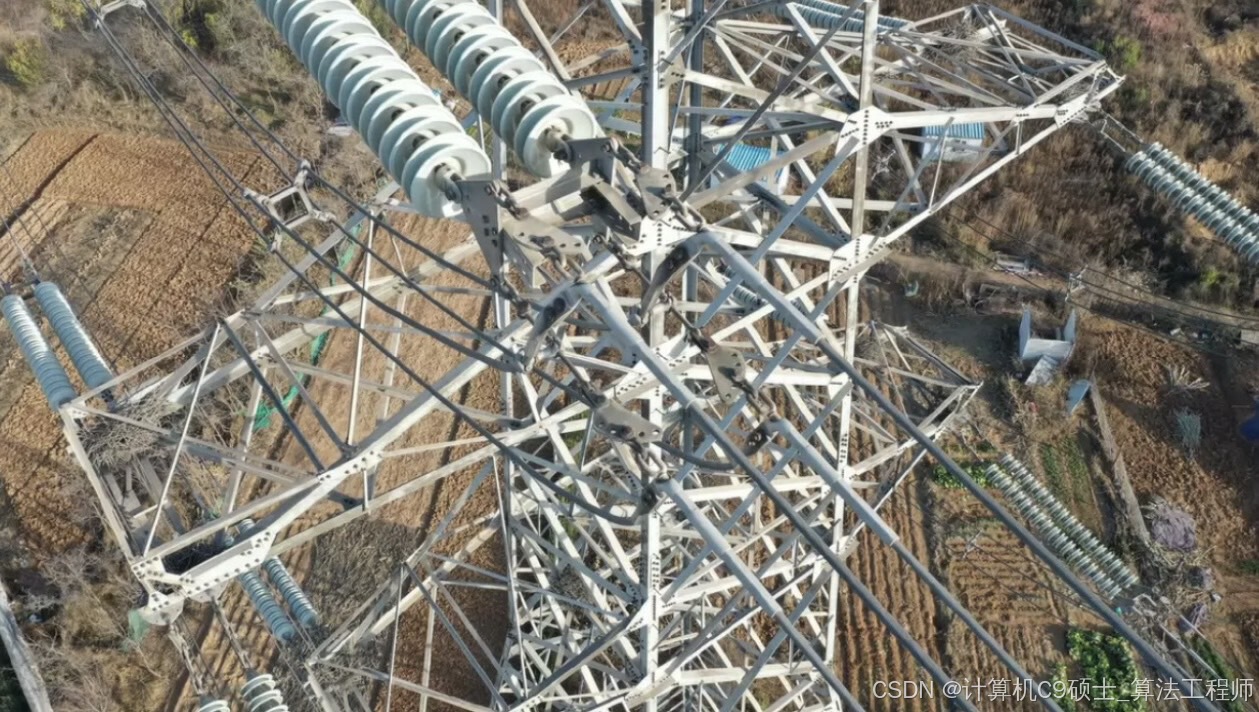
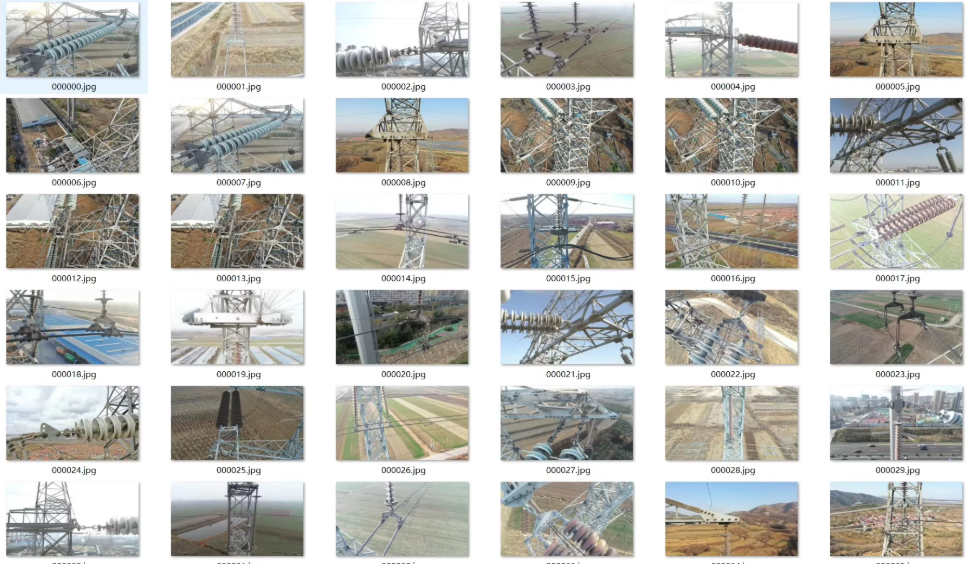
一万两千多张,标签(包括txt格式)40G多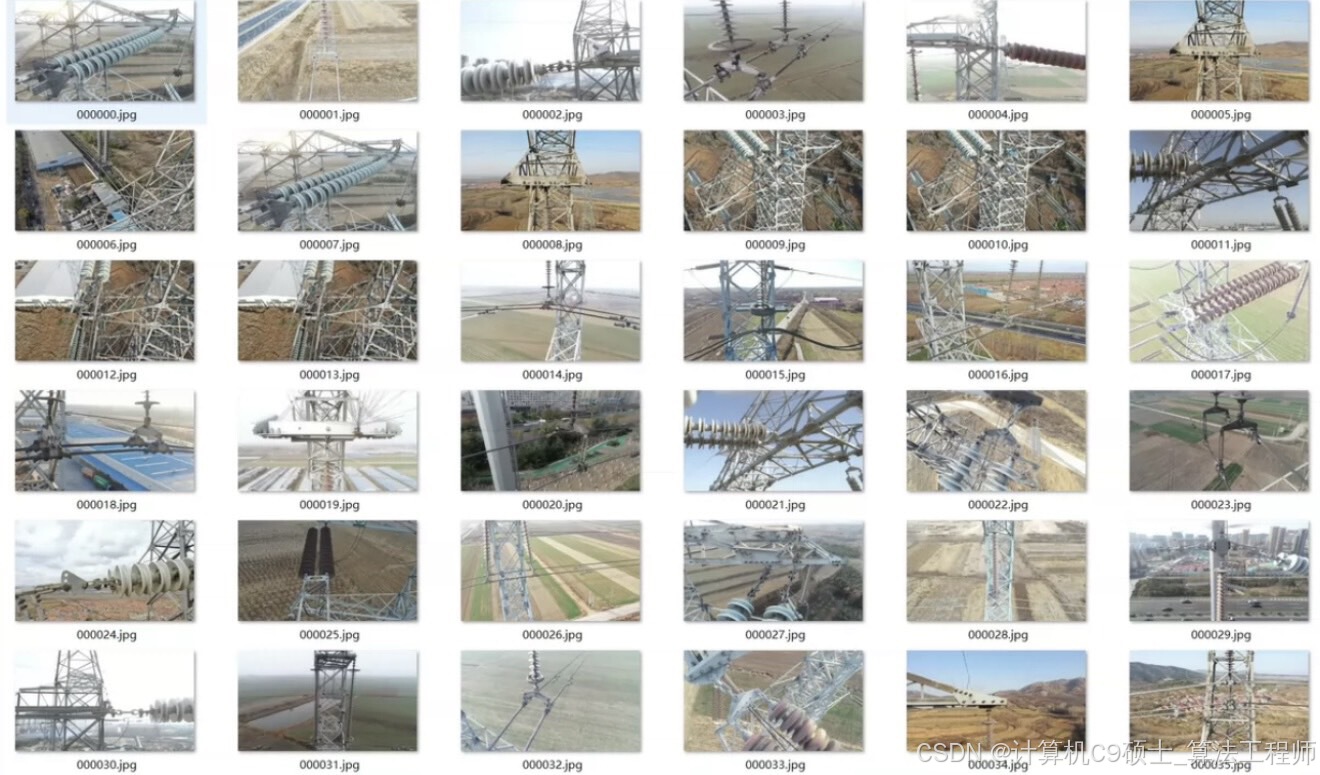 类别 如下
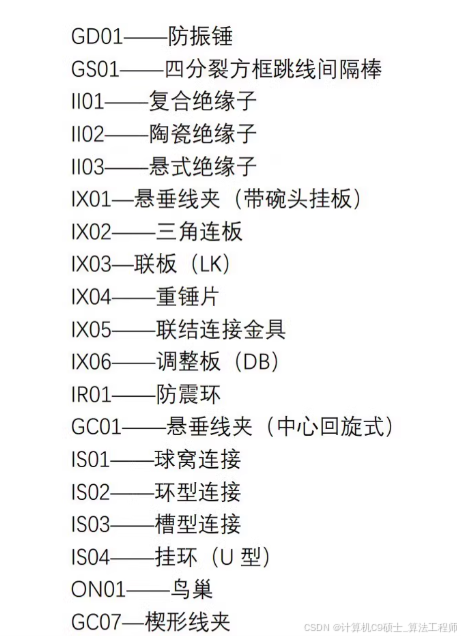 GD01-防振锤 GS01-四分 裂方框跳线间隔棒 1101-复合绝缘子 1I02-_陶瓷绝缘子 1I03–悬式绝缘子 IX01-悬垂线夹(带碗头挂板) IX02-三角连板 IX03-联板(LK) IX04-重锤片 IX05-联结连接金具 IX06-调整板(DB) IR01-防震环 GC01-悬垂线夹(中心回旋式) IS01-球窝连接 IS02-环型连接 IS03-槽型连接 IS04-挂环(U型) ON01–鸟巢 GC07-楔形线夹
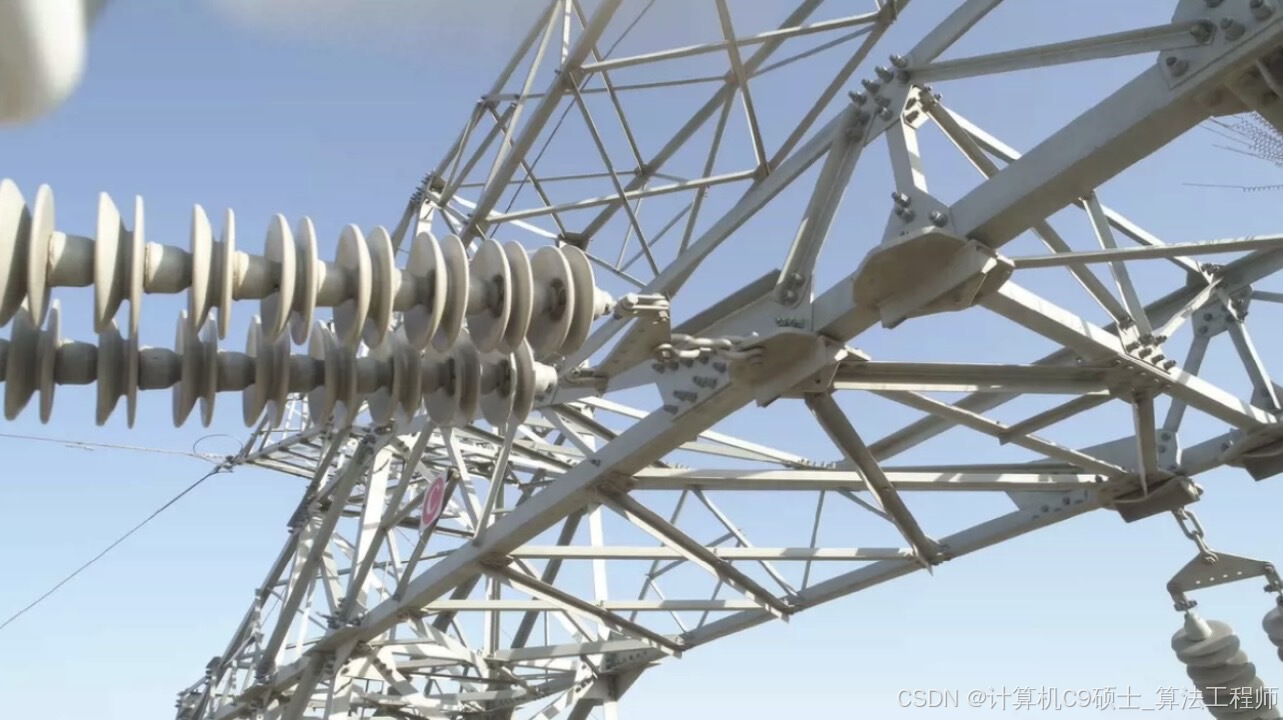 *
文章所有代码仅供参考!
构建一个高压输电线路巡检系统,我们需要处理包含一万两千多张图像的数据集,并且这些图像使用YOLO格式的标注。我们将使用深度学习模型来进行目标检测任务。以下是详细的步骤和代码实现:
数据准备
同学呀:假设你已经有一个包含一万两千多张遥感图像的数据集,并且标注格式为适合目标检测任务的格式(例如,YOLO 格式)。
数据集结构示例
dataset/
├── images/
│ ├── train/
│ │ ├── image1.jpg
│ │ ├── image2.jpg
│ │ └── …
│ ├── valid/
│ │ ├── image3.jpg
│ │ ├── image4.jpg
│ │ └── …
│ └── test/
│ ├── image5.jpg
│ ├── image6.jpg
│ └── …
├── labels_yolo/
│ ├── train/
│ │ ├── image1.txt
│ │ ├── image2.txt
│ │ └── …
│ ├── valid/
│ │ ├── image3.txt
│ │ ├── image4.txt
│ │ └── …
│ └── test/
│ ├── image5.txt
│ ├── image6.txt
│ └── …
└── dataset.yaml
dataset.yaml 内容如下:
train:
img_dir: ./images/train
ann_dir: ./labels_yolo/train
val:
img_dir: ./images/valid
ann_dir: ./labels_yolo/valid
test:
img_dir: ./images/test
ann_dir: ./labels_yolo/test
nc: 14
names: ['GD01-防振锤', 'GS01-四分裂方框跳线间隔棒', '1101-复合绝缘子', '1I02-_陶瓷绝缘子', '1I03–悬式绝缘子',
'IX01-悬垂线夹(带碗头挂板)', 'IX02-三角连板', 'IX03-联板(LK)', 'IX04-重锤片', 'IX05-联结连接金具',
'IX06-调整板(DB)', 'IR01-防震环', 'GC01-悬垂线夹(中心回旋式)', 'IS01-球窝连接', 'IS02-环型连接',
'IS03-槽型连接', 'IS04-挂环(U型)', 'ON01–鸟巢', 'GC07-楔形线夹']
环境部署说明
确保你已经安装了必要的库,如上所述。 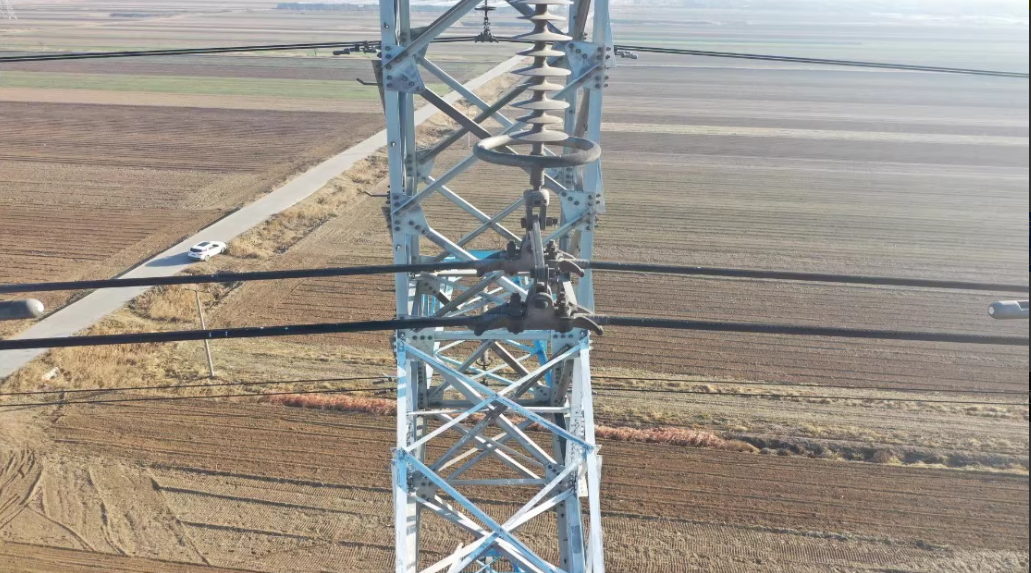
安装依赖
# 创建虚拟环境(可选)
conda create -n transmission_line_inspection_env python=3.8
conda activate transmission_line_inspection_env
# 安装PyTorch
pip install torch==1.9 torchvision torchaudio –extra-index-url https://download.pytorch.org/whl/cu111
# 安装其他依赖
pip install opencv-python pyqt5 scikit-learn pandas matplotlib seaborn onnxruntime xml.etree.ElementTree albumentations yolov5
数据预处理 data_preprocessing.py
我们将使用 albumentations 进行图像预处理。
[<title="Data Preprocessing for Transmission Line Inspection">]
import os
import cv2
import numpy as np
from tqdm import tqdm
from albumentations import (
HorizontalFlip, VerticalFlip, RandomRotate90, Transpose,
ShiftScaleRotate, HueSaturationValue, Blur, OpticalDistortion,
GridDistortion, CLAHE, RandomBrightnessContrast, RandomGamma,
ToFloat, Normalize, Compose, NoOp, OneOf, Resize
)
from albumentations.pytorch import ToTensorV2
import shutil
def preprocess_image(image_path, label_path, output_img_path, output_label_path, patch_size=512):
image = cv2.imread(image_path)
with open(label_path, 'r') as f:
lines = f.readlines()
bboxes = []
class_ids = []
for line in lines:
parts = line.strip().split()
class_id = int(parts[0])
bbox = list(map(float, parts[1:]))
bboxes.append(bbox)
class_ids.append(class_id)
transform = A.Compose([
Resize(height=patch_size, width=patch_size),
HorizontalFlip(p=0.5),
VerticalFlip(p=0.5),
Rotate(limit=45, p=0.5),
RandomBrightnessContrast(p=0.2),
ToFloat(max_value=255),
Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
], bbox_params=A.BboxParams(format='yolo', min_visibility=0.5, label_fields=['class_labels']))
transformed = transform(image=image, bboxes=bboxes, class_labels=class_ids)
image_transformed = transformed['image']
bboxes_transformed = transformed['bboxes']
class_ids_transformed = transformed['class_labels']
output_img_path = f"{output_img_path}.jpg"
output_label_path = f"{output_label_path}.txt"
cv2.imwrite(output_img_path, (image_transformed.permute(1, 2, 0).numpy() * 255).astype(np.uint8))
with open(output_label_path, 'w') as f:
for bbox, cls_id in zip(bboxes_transformed, class_ids_transformed):
f.write(f"{cls_id} {' '.join(map(str, bbox))}\\n")
if __name__ == "__main__":
dataset_path = 'path/to/dataset'
output_dataset_path = 'path/to/output_dataset'
sets = ['train', 'valid', 'test']
for s in sets:
img_dir = os.path.join(dataset_path, 'images', s)
label_dir = os.path.join(dataset_path, 'labels_yolo', s)
output_img_dir = os.path.join(output_dataset_path, 'images', s)
output_label_dir = os.path.join(output_dataset_path, 'labels_yolo', s)
os.makedirs(output_img_dir, exist_ok=True)
os.makedirs(output_label_dir, exist_ok=True)
for img_filename in tqdm(os.listdir(img_dir)):
img_path = os.path.join(img_dir, img_filename)
label_filename = img_filename.replace('.jpg', '.txt')
label_path = os.path.join(label_dir, label_filename)
output_img_path = os.path.join(output_img_dir, img_filename[:–4])
output_label_path = os.path.join(output_label_dir, label_filename[:–4])
preprocess_image(img_path, label_path, output_img_path, output_label_path)
同学呀——请将 path/to/dataset 和 path/to/output_dataset 替换为实际的数据集路径。
模型定义与训练 train.py
我们将使用 YOLOv5 进行目标检测任务。
首先,克隆 YOLOv5 仓库并安装依赖:
git clone https://github.com/ultralytics/yolov5.git
cd yolov5
pip install -r requirements.txt
然后编写训练脚本:
[<title="Training Script for Transmission Line Inspection using YOLOv5">]
import torch
from pathlib import Path
# 设置工作目录
ROOT = Path('/path/to/yolov5').resolve()
WEIGHTS_DIR = ROOT / 'runs' / 'train'
# 加载YOLov5模型
model = torch.hub.load(ROOT, 'custom', path='/path/to/best.pt', source='local')
# 训练参数
hyp = {
'lr0': 0.01,
'lrf': 0.2,
'momentum': 0.937,
'weight_decay': 0.0005,
'warmup_epochs': 3.0,
'warmup_momentum': 0.8,
'warmup_bias_lr': 0.1,
'box': 0.05,
'cls': 0.5,
'cls_pw': 1.0,
'obj': 1.0,
'obj_pw': 1.0,
'iou_t': 0.20,
'anchor_t': 4.0,
'fl_gamma': 0.0,
'hsv_h': 0.015,
'hsv_s': 0.7,
'hsv_v': 0.4,
'degrees': 0.0,
'translate': 0.1,
'scale': 0.5,
'shear': 0.0,
'perspective': 0.0,
'flipud': 0.0,
'fliplr': 0.5,
'mosaic': 1.0,
'mixup': 0.0,
'copy_paste': 0.0
}
# 训练命令
!python {ROOT}/train.py \\
––img 512 \\
––batch 16 \\
––epochs 50 \\
––data /path/to/dataset.yaml \\
––cfg {ROOT}/models/yolov5s.yaml \\
––weights '' \\
––cache \\
––device 0 \\
––multi–scale \\
––optimizer SGD \\
––sync–bn \\
––cos–lr \\
––label–smoothing 0.1 \\
––patience 10 \\
––freeze 10 \\
––save–period 10 \\
––project runs/train \\
––name yolov5s_transmission_line_inspection \\
––exist–ok
请将 /path/to/yolov5、/path/to/best.pt 和 /path/to/dataset.yaml 替换为实际的路径。
评估模型 evaluate.py
[<title="Evaluation Script for Transmission Line Inspection">]
import torch
from pathlib import Path
import yaml
# 设置工作目录
ROOT = Path('/path/to/yolov5').resolve()
# 加载YOLov5模型
model = torch.hub.load(ROOT, 'custom', path='/path/to/best.pt', source='local')
# 加载数据集配置文件
with open('/path/to/dataset.yaml', 'r') as f:
data_config = yaml.safe_load(f)
# 测试数据集路径
test_images_path = data_config['test']['img_dir']
# 评估命令
!python {ROOT}/val.py \\
––data /path/to/dataset.yaml \\
––weights /path/to/best.pt \\
––task val \\
––img 512 \\
––conf 0.25 \\
––iou 0.45 \\
––agnostic–nms False \\
––augment False \\
––half False \\
––device 0 \\
––verbose True \\
––save–txt True \\
––save–conf True \\
––save–json True \\
––project runs/val \\
––name yolov5s_transmission_line_inspection \\
––exist–ok
请将 /path/to/yolov5、/path/to/best.pt 和 /path/to/dataset.yaml 替换为实际的路径。
用户界面 ui.py
我们将使用 PyQt5 创建一个简单的 GUI 来加载和运行模型进行实时预测。
[<title="PyQt5 Main Window for Transmission Line Inspection">]
import sys
import cv2
import numpy as np
from PyQt5.QtWidgets import QApplication, QMainWindow, QLabel, QPushButton, QVBoxLayout, QWidget, QFileDialog
from PyQt5.QtGui import QImage, QPixmap
from PyQt5.QtCore import Qt, QTimer
import torch
from pathlib import Path
import yaml
class MainWindow(QMainWindow):
def __init__(self):
super().__init__()
self.setWindowTitle("Transmission Line Inspection System")
self.setGeometry(100, 100, 800, 600)
# Load YOLOv5 model
self.model = torch.hub.load(Path('/path/to/yolov5'), 'custom', path='/path/to/best.pt', source='local')
# Load dataset configuration
with open('/path/to/dataset.yaml', 'r') as f:
self.data_config = yaml.safe_load(f)
self.initUI()
def initUI(self):
self.central_widget = QWidget()
self.setCentralWidget(self.central_widget)
self.layout = QVBoxLayout()
self.image_label = QLabel(self)
self.image_label.setAlignment(Qt.AlignCenter)
self.layout.addWidget(self.image_label)
self.load_image_button = QPushButton("Load Image", self)
self.load_image_button.clicked.connect(self.load_image)
self.layout.addWidget(self.load_image_button)
self.start_prediction_button = QPushButton("Start Prediction", self)
self.start_prediction_button.clicked.connect(self.start_prediction)
self.layout.addWidget(self.start_prediction_button)
self.stop_prediction_button = QPushButton("Stop Prediction", self)
self.stop_prediction_button.clicked.connect(self.stop_prediction)
self.layout.addWidget(self.stop_prediction_button)
self.central_widget.setLayout(self.layout)
self.image_path = None
self.timer = QTimer()
self.timer.timeout.connect(self.update_frame)
def load_image(self):
options = QFileDialog.Options()
file_name, _ = QFileDialog.getOpenFileName(self, "QFileDialog.getOpenFileName()", "", "Images (*.jpg *.jpeg *.png);;All Files (*)", options=options)
if file_name:
self.image_path = file_name
self.display_image(file_name)
def display_image(self, path):
pixmap = QPixmap(path)
scaled_pixmap = pixmap.scaled(self.image_label.width(), self.image_label.height(), Qt.KeepAspectRatio)
self.image_label.setPixmap(scaled_pixmap)
def start_prediction(self):
if self.image_path is not None and not self.timer.isActive():
self.timer.start(30) # Update frame every 30 ms
def stop_prediction(self):
if self.timer.isActive():
self.timer.stop()
self.image_label.clear()
def update_frame(self):
frame = cv2.imread(self.image_path)
results = self.model(frame)
annotated_frame = results.render()[0]
rgb_image = cv2.cvtColor(annotated_frame, cv2.COLOR_BGR2RGB)
h, w, ch = rgb_image.shape
bytes_per_line = ch * w
qt_image = QImage(rgb_image.data, w, h, bytes_per_line, QImage.Format_RGB888)
pixmap = QPixmap.fromImage(qt_image)
scaled_pixmap = pixmap.scaled(self.image_label.width(), self.image_label.height(), Qt.KeepAspectRatio)
self.image_label.setPixmap(scaled_pixmap)
if __name__ == "__main__":
app = QApplication(sys.argv)
window = MainWindow()
window.show()
sys.exit(app.exec_())
请将 /path/to/yolov5、/path/to/best.pt 和 /path/to/dataset.yaml 替换为实际的路径。
不带用户界面的预测脚本 without_ui.py
[<title="Prediction Script without UI for Transmission Line Inspection">]
import cv2
import numpy as np
import torch
from pathlib import Path
import yaml
# 设置工作目录
ROOT = Path('/path/to/yolov5').resolve()
# 加载YOLov5模型
model = torch.hub.load(ROOT, 'custom', path='/path/to/best.pt', source='local')
# 加载数据集配置文件
with open('/path/to/dataset.yaml', 'r') as f:
data_config = yaml.safe_load(f)
def predict(image_path):
frame = cv2.imread(image_path)
results = model(frame)
annotated_frame = results.render()[0]
cv2.imshow('Detected Image', annotated_frame)
cv2.waitKey(0)
cv2.destroyAllWindows()
if __name__ == "__main__":
image_path = 'path/to/image.jpg'
predict(image_path)
请将 /path/to/yolov5、/path/to/best.pt、/path/to/dataset.yaml 和 path/to/image.jpg 替换为实际的路径。
辅助工具 tools/check_img.py
[<title="Check Image Files Tool">]
import os
def check_image_files(directory):
supported_extensions = ['.jpg', '.jpeg', '.png']
for filename in os.listdir(directory):
if any(filename.lower().endswith(ext) for ext in supported_extensions):
continue
else:
raise ValueError(f"Unsupported file format: {filename}")
print("All image files are valid.")
辅助工具 tools/check_ann.py
[<title="Check Annotation Files Tool">]
import os
def check_annotation_files(directory, annotation_format='yolo'):
if annotation_format == 'yolo':
supported_extensions = ['.txt']
elif annotation_format == 'voc':
supported_extensions = ['.xml']
else:
raise ValueError("Unsupported annotation format. Use 'yolo' or 'voc'.")
for filename in os.listdir(directory):
if any(filename.lower().endswith(ext) for ext in supported_extensions):
continue
else:
raise ValueError(f"Unsupported file format: {filename}")
print("All annotation files are valid.")
使用说明
配置路径:
- 将 /path/to/dataset 设置为存放原始数据集的目录路径。
- 将 /path/to/output_dataset 设置为存放预处理后数据集的目录路径。
- 确保 /path/to/best.pt 是训练好的 YOLOv5 模型权重路径。
- 将 path/to/image.jpg 设置为要预测的图像路径。
运行脚本:
- 在终端中运行 data_preprocessing.py 脚本来预处理图像。
- 在终端中运行 train.py 脚本来训练模型。
- 在终端中运行 evaluate.py 来评估模型性能。
- 在终端中运行 ui.py 来启动 GUI 应用程序。
- 在终端中运行 without_ui.py 来进行无界面预测。
- 使用 tools/check_img.py 和 tools/check_ann.py 检查图像和注释文件的有效性。
注意事项:
- 确保所有必要的工具箱已安装,特别是 PyTorch 和 PyQt5。
- 根据需要调整参数,如 epochs 和 batch_size。

示例
假设你的数据文件夹结构如下:
dataset/
├── images/
│ ├── train/
│ │ ├── image1.jpg
│ │ ├── image2.jpg
│ │ └── …
│ ├── valid/
│ │ ├── image3.jpg
│ │ ├── image4.jpg
│ │ └── …
│ └── test/
│ ├── image5.jpg
│ ├── image6.jpg
│ └── …
├── labels_yolo/
│ ├── train/
│ │ ├── image1.txt
│ │ ├── image2.txt
│ │ └── …
│ ├── valid/
│ │ ├── image3.txt
│ │ ├── image4.txt
│ │ └── …
│ └── test/
│ ├── image5.txt
│ ├── image6.txt
│ └── …
└── dataset.yaml
以上文字及代码仅供参考学习使用。


评论前必须登录!
注册