 网硕互联帮助中心
目录:
- 一、模块定位:从"分割一切"到"检测一切"
- 二、第 16 集:YOLOS 与 DETR——检测的 Transformer 化
- 三、第 17 集:GLIP 原理——检测即短语定位
- 四、第 18 集:GLIP 损失函数
- 五、第 19 集:GLIP vs YOLOv / DETR / YOLOS 对比
- 六、课程脉络衔接
- 七、学习要点回顾
- 八、学习路线图
- 九、总结与参考资料
摘要:本文系统梳理卢菁博士《多模态大模型教程》第五模块《GLIP 模型详解》(第 16–19 集)的核心内容。GLIP 通过三大创新实现开放词汇检测:一是架构三件套(DyHead + BERT + 语言感知深度融合),把目标检测重构为短语定位(phrase grounding);二是联合损失函数(跨模态对齐损失 + 定位损失),让分类从固定类别表变为在提示文本中找词;三是 27M 预训练数据配方(3M 人工标注 + 24M 图文对自训练伪框)。文章从 DETR、YOLOS 的检测 Transformer 化讲起,并与 YOLOv / DETR / YOLOS 对比,揭示从封闭类别到开放词汇的范式跃迁,最后介绍 GLIP 与 Grounded-SAM 组合的落地流程,帮助读者掌握 DETR 原理并快速上手零样本检测实战。
✅ 第五模块《GLIP 模型详解》(第 16–19 集)
李沐深度学习191集课程全解析:模块拆解、学习路径-CSDN博客
吴恩达《面向开发者的提示词工程》-CSDN博客
吴恩达 MCP 教程(Model Context Protocol)(一)-CSDN博客
多模态大模型教程学习笔记 — ViT · CLIP · SAM · GLIP · Stable Diffusion
GLIP 开放词汇检测:从 YOLOS/DETR 到短语定位
从 YOLOS / DETR 到 GLIP——把目标检测重构为短语定位(检测即 grounding),用语言开放检测器的词汇表。
可视化页面
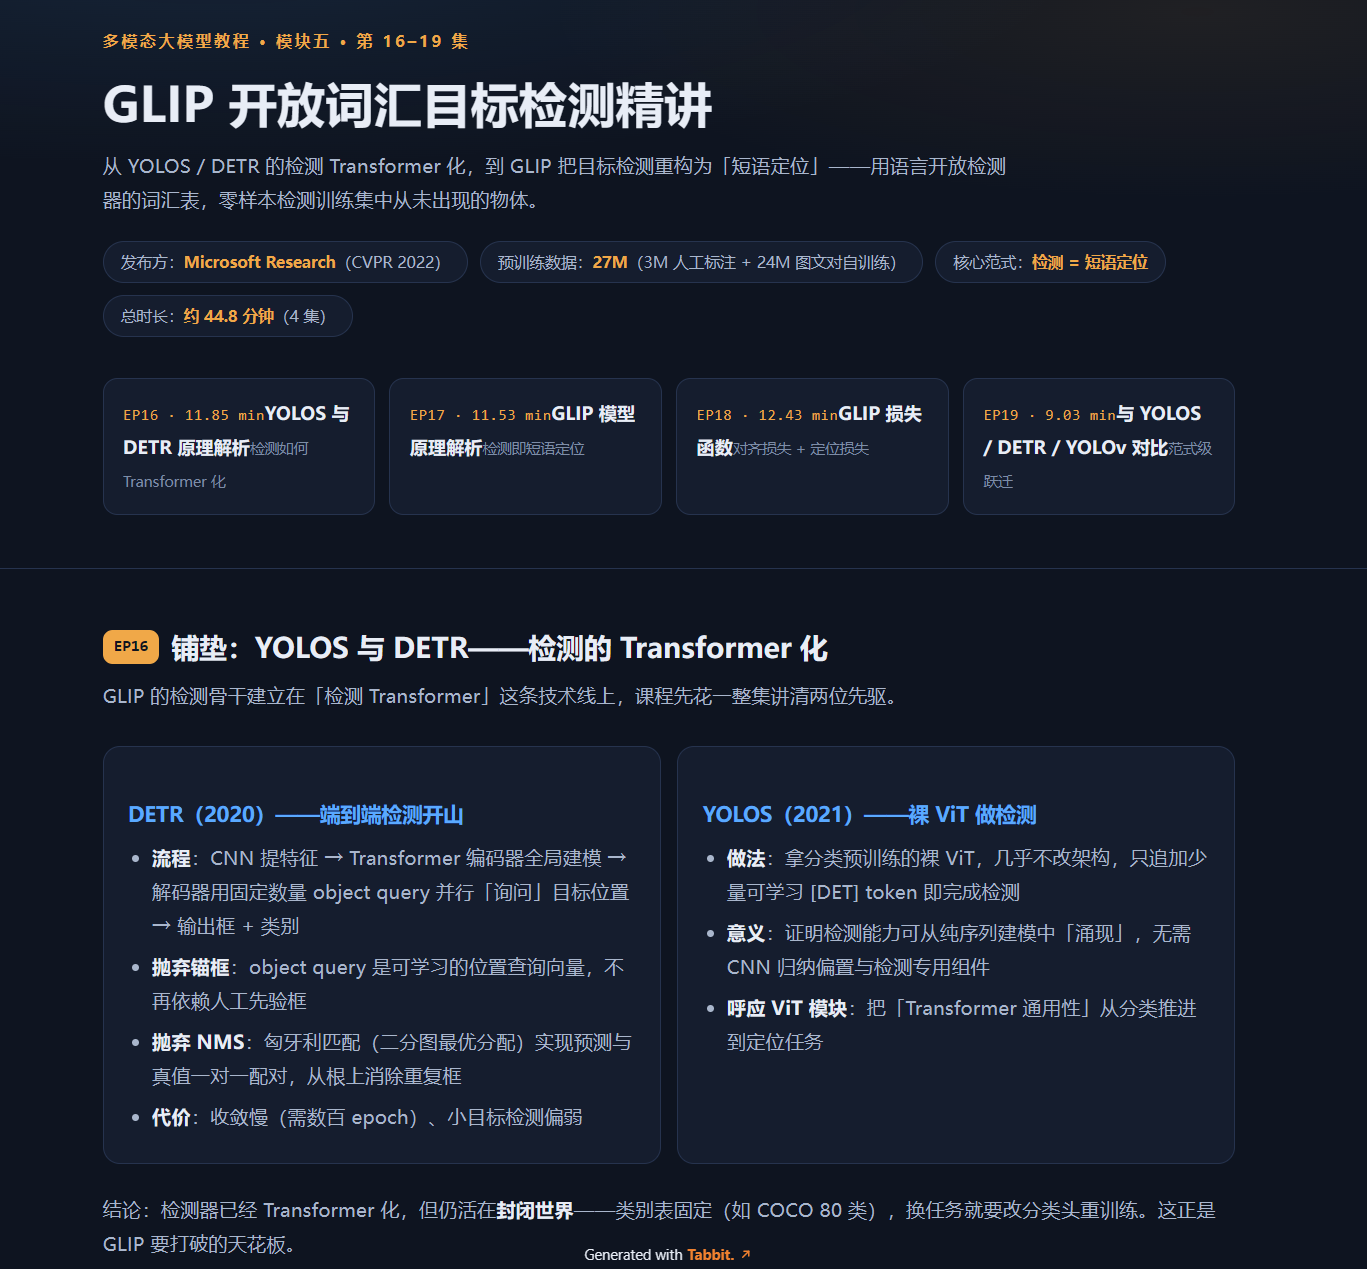 GLIP 开放词汇目标检测精讲(含 YOLOS/DETR 原理) | 多模态大模型教程 第 16–19 集
- 文件:artifacts/glip-model-guide.html(暗色设计,含分集导航、GLIP 架构流程图、语言感知深度融合示意、损失函数公式块、四模型对比表、课程脉络时间线,代码级质检 PASS)
分集结构实证(来源:课程选集 链接):
| 第 16 集 | GLIP 模型详解(1) YOLOS 和 DETR 模型原理解析 | 11.85 分钟 |
| 第 17 集 | GLIP 模型详解(2) GLIP 模型原理解析 | 11.53 分钟 |
| 第 18 集 | GLIP 模型详解(3) GLIP 损失函数 | 12.43 分钟 |
| 第 19 集 | GLIP 模型详解(4) GLIP 与 YOLOS/DETR/YOLOv 对比 | 9.03 分钟 |
详细总结(约 5200 字)
一、模块定位:从"分割一切"到"检测一切"
本模块为卢菁博士《多模态大模型教程》第五模块,共 4 集,总时长约 44.8 分钟。上一模块 SAM 解决了"类别无关的分割",但留下一个明确缺口:SAM 只画轮廓、不认类别。本模块讲解的 GLIP(Grounded Language-Image Pre-training,微软研究院,CVPR 2022)恰好补上这块拼图——用自然语言定义"要检测什么",把开放词汇能力带到对象级定位任务。
课程编排颇具匠心:第 16 集并不直接讲 GLIP,而是先铺垫两代检测 Transformer(DETR、YOLOS),因为 GLIP 的检测骨干正是建立在这条技术线上。理解了"检测如何 Transformer 化",才能理解 GLIP 在其上做的范式革新。
二、第 16 集:YOLOS 与 DETR——检测的 Transformer 化
DETR(2020,Facebook AI):首个端到端目标检测 Transformer。流程为:CNN 骨干提取图像特征 → Transformer 编码器做全局建模 → 解码器用一组固定数量(如 100 个)的 object query 并行"询问"图像中每个目标的位置 → 输出边界框与类别。它有两大革命性设计:
代价也很明显:收敛慢(需数百个 epoch)、小目标检测偏弱。这些问题催生了后续大量改进工作(Deformable DETR 等),但"端到端 + 集合预测"的范式由此确立。
YOLOS(2021):一个"极简实验"——拿为分类预训练的裸 ViT,几乎不改架构,只追加少量可学习的 [DET] token,就直接做目标检测,且性能可观。它的意义不在刷榜,而在证明:检测能力可以从纯粹的序列到序列建模中"涌现",不需要 CNN 的归纳偏置,也不需要检测专用架构。这与课程第一模块 ViT"Transformer 可完全替代 CNN 做视觉"的结论一脉相承,把"Transformer 通用性"从分类推进到了定位任务。
这一集合起来回答的问题是:检测器已经 Transformer 化了,但它仍是"封闭世界"的——类别表固定(如 COCO 80 类),换任务就要改分类头、重新训练。这就是 GLIP 要解决的根本问题。
三、第 17 集:GLIP 原理——检测即短语定位
GLIP 的核心思想用一句话概括:把目标检测重构为短语定位(phrase grounding)任务。
- 输入:图像 + 一段文本提示,如 cat . dog . person .(各类别用句号分隔的提示句)
- 输出:图中每个与提示中短语语义对应的目标框
在 GLIP 框架下,“检测"被统一进 grounding 的语义:传统检测器输出"这是类别编号 #15”,GLIP 输出"这个区域与提示中的词 ‘cat’ 对齐"。分类头被替换为视觉区域特征与文本词特征的相似度计算——检测的"类别表"从此变成任意自然语言,词汇表彻底开放:面对训练集中从未出现的新类别(如"戴太阳镜的柴犬"),只需改提示词,零样本即可检测。
架构三件套:
预训练数据配方(27M):
- 3M 人工标注:Flickr30K Entities、Objects365 等检测/定位数据,框与短语天然对应,质量高但规模有限;
- 24M 网络图文对:没有框标注。GLIP 用**自训练(self-training)**方式——先训出的模型给图文对 Caption 中的名词短语"打伪框",过滤低置信度结果后回炉训练。这与 CLIP 利用 4 亿图文对的思路同源,但把对齐粒度从图像级下沉到了对象级。
效果:GLIP-L 在零样本 COCO 检测上达到 49.8 AP,超过有监督训练的强基线;在 13 个非常规目标数据集上平均超越有监督方法,证明了开放词汇路线的实用价值。
四、第 18 集:GLIP 损失函数
GLIP 的训练目标是"分类与定位统一"的联合损失,由两部分组成:
① 跨模态对齐损失(classification as grounding):先构建"区域 × 词"相似度矩阵 S = O·Pᵀ(区域特征 O 与词特征 P 的点积),用它替代传统的固定类别 softmax 分类头。匈牙利匹配确定预测框与真值短语的配对后,在矩阵上做 token 级对齐:正样本对(框与对应短语的词)相似度推高,负样本对推低——本质是一个对象级的对比分类损失(焦点加权以处理正负样本极度不均衡)。
② 定位损失(localization):L1 损失 + GIoU 损失的组合框回归,约束预测框与真值框的几何贴合度。
总损失 = 对齐损失 + λ × 定位损失,端到端联合优化。这个设计的精妙之处在于:分类损失不再是"从固定类别表里挑一个",而是"在提示文本里找对词"——同一个损失函数既适用于人工标注的检测数据(框-短语自然对应),也适用于图文对数据(Caption 中的名词短语即"免费"的类别词),这正是 GLIP 能同时吃下两类异构数据、实现 27M 规模预训练的根本原因。
五、第 19 集:GLIP vs YOLOv / DETR / YOLOS 对比
| 骨干 | CNN | CNN + Transformer | 裸 ViT | DyHead + BERT 跨模态 |
| 类别系统 | 固定 | 固定 | 固定 | 开放词汇 |
| 输入 | 仅图像 | 仅图像 | 仅图像 | 图像 + 文本提示 |
| 后处理 | NMS | 无(匈牙利匹配) | 无 | 无 |
| 新类别迁移 | 需重训 | 需重训 | 需重训 | 改提示词即可,零样本 |
| 代表意义 | CNN 实时检测巅峰 | 端到端检测开山 | 架构通用性证明 | 检测范式革新 |
结论:从 YOLOv 到 DETR / YOLOS 是架构层的演进(CNN → Transformer、手工组件 → 端到端),从它们到 GLIP 是范式层的跃迁(封闭类别 → 开放词汇、视觉独奏 → 语言引导)。四个模型构成一条完整的技术谱系,也是理解后续开放词汇工作的钥匙。
六、课程脉络衔接
至此五个模块的主线清晰可循:ViT(视觉 Token 化)→ CLIP(图像级图文对齐)→ BLIP/BLIP-2/LLaVA(视觉进 LLM 统一推理)→ SAM(类别无关分割)→ GLIP(对象级开放词汇检测)。GLIP 与 SAM 的组合即 Grounded-SAM(GLIP 用语言指定目标并出框 → SAM 沿框精细分割),是当前最流行的开源开放词汇分割流水线之一,也为后续 Stable Diffusion 生成模块(局部重绘需先定位/分割)埋下伏笔。
七、学习要点回顾
- 检测 Transformer 化两支柱:DETR 的 object query + 匈牙利匹配;YOLOS 的裸 ViT 通用性证明;
- GLIP 一句话:检测 = "图像区域 × 提示短语"的对齐问题,词汇表由文本开放;
- 关键架构:DyHead + BERT + 多层语言感知深度融合(区别于 CLIP 的 late fusion);
- 损失 = 区域-词 token 级对齐对比损失 + (L1 + GIoU) 定位损失,匈牙利匹配配对后联合优化;
- 数据配方:3M 人工标注 + 24M 图文对自训练伪框;
- 动手建议:Hugging Face 直接加载 GLIP 系 checkpoint,改一行提示词即可体验零样本检测,再进阶组合 Grounded-SAM 流水线。
八、GLIP 零样本检测实战
前面几节从原理上理解了 GLIP 如何把目标检测重构为短语定位,本节给出可直接运行的实战代码,帮助读者在 Hugging Face 上快速体验零样本检测,并进阶组合 Grounded-SAM 完成从出框到分割的完整落地。
1. 使用 Hugging Face transformers 加载 GLIP 模型
transformers 库提供了 AutoModelForZeroShotObjectDetection 接口,可统一加载 GLIP 与 Grounding DINO 等开放词汇检测模型。下面以 GLIP 为例给出完整推理流程:
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
from PIL import Image
import torch
import matplotlib.pyplot as plt
import matplotlib.patches as patches
1. 加载模型与处理器(首次运行会自动下载 checkpoint)
model_id = "microsoft/grounding-dino-base" # 也可换成 GLIP 系 checkpoint
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id)
model.eval()
2. 读取图像并构造文本提示(各类别用句号分隔)
image = Image.open("demo.jpg").convert("RGB")
text = "cat . dog . person ."
3. 输入预处理:图像缩放 + 文本 token 化,统一送入模型
inputs = processor(images=image, text=text, return_tensors="pt")
4. 前向推理,得到预测框、类别与置信度
with torch.no_grad():
outputs = model(**inputs)
5. 阈值过滤 + 框坐标转换(从模型坐标还原到原图像素坐标)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
box_threshold=0.35, # 框置信度阈值,低于此值丢弃
text_threshold=0.25, # 文本对齐阈值,控制类别匹配严格度
target_sizes=[image.size[::-1]] # 还原到原图尺寸
)[0]
6. 可视化:在原图上绘制检测框与标签
fig, ax = plt.subplots(1, 1, figsize=(12, 8))
ax.imshow(image)
for box, score, label in zip(results["boxes"], results["scores"], results["labels"]):
x1, y1, x2, y2 = box.tolist()
rect = patches.Rectangle((x1, y1), x2 – x1, y2 – y1,
linewidth=2, edgecolor="red", facecolor="none")
ax.add_patch(rect)
ax.text(x1, y1 – 5, f"{label} {score:.2f}",
color="red", fontsize=12, bbox=dict(facecolor="white", alpha=0.8))
plt.axis("off")
plt.show()
关键步骤说明:第 3 步的 processor 负责把图像缩放到模型输入尺寸、把文本提示编码为 token 序列;第 5 步的 box_threshold 与 text_threshold 分别控制框置信度与文本对齐的过滤强度,值越低召回越多、误检也越多;target_sizes 用于把模型输出的归一化坐标还原为原图像素坐标,便于直接绘制。
2. 组合 Grounded-SAM:GLIP 出框 + SAM 分割
GLIP 负责用语言指定目标并输出边界框,SAM 再沿框内区域做精细分割,二者组合即 Grounded-SAM 流水线。简化流程如下:
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
from segment_anything import sam_model_registry, SamPredictor
from PIL import Image
import numpy as np
第一步:GLIP 出框(复用上一节的加载逻辑)
det_processor = AutoProcessor.from_pretrained("microsoft/grounding-dino-base")
det_model = AutoModelForZeroShotObjectDetection.from_pretrained("microsoft/grounding-dino-base")
image = Image.open("demo.jpg").convert("RGB")
text = "cat . dog . person ."
inputs = det_processor(images=image, text=text, return_tensors="pt")
outputs = det_model(**inputs)
boxes = det_processor.post_process_grounded_object_detection(
outputs, inputs.input_ids,
box_threshold=0.35, text_threshold=0.25,
target_sizes=[image.size[::-1]]
)[0]["boxes"].tolist()
第二步:SAM 沿框精细分割
sam = sam_model_registry"vit_h".to("cuda")
predictor = SamPredictor(sam)
predictor.set_image(np.array(image))
for box in boxes:
x1, y1, x2, y2 = [int(v) for v in box]
# 把检测框作为 SAM 的提示框,生成框内前景掩码
masks, scores, _ = predictor.predict(
box=np.array([x1, y1, x2, y2]),
multimask_output=True
)
best_mask = masks[scores.argmax()] # 取置信度最高的掩码
# 此处可将 best_mask 保存为 PNG 或叠加到原图用于后续编辑
这段流程把 GLIP 的开放词汇定位能力与 SAM 的类别无关分割能力串联起来:GLIP 先回答"图中哪里有 cat / dog / person",SAM 再回答"这些目标各自的精确轮廓是什么"。在开放词汇图像编辑场景中,这一组合非常实用——例如用户输入"把图中的柴犬换成柯基",即可先用 GLIP 定位"柴犬"区域,再用 SAM 分割出该区域掩码,最后交给 Stable Diffusion 做局部重绘,实现目标级、语义可控的图像编辑。
八、学习路线图
针对不同基础的学习者,建议按以下路径循序渐进地掌握 GLIP 及开放词汇检测技术:
- 入门路线(0–2 周):先掌握 Transformer 基础与 ViT 原理,再学习 DETR 的端到端检测范式,理解 object query 与匈牙利匹配机制;
- 进阶路线(2–4 周):深入 YOLOS 的裸 ViT 检测实验,理解检测能力的涌现机制;随后系统学习 GLIP 的架构三件套(DyHead + BERT + 语言感知深度融合),掌握短语定位的核心思想;
- 实战路线(4–6 周):在 Hugging Face 上加载 GLIP 系 checkpoint,动手实践零样本检测;进阶组合 Grounded-SAM 流水线,完成从语言指定目标到精细分割的完整落地;
- 研究路线(6 周以上):精读 GLIP 论文与源码,复现损失函数与自训练数据配方,尝试在自定义数据集上微调,探索开放词汇检测的边界与改进方向。
SEO 关键词:GLIP、开放词汇检测、多模态大模型、phrase grounding、YOLOS、DETR 原理、DyHead、零样本检测、GLIP 损失函数、Grounded-SAM 教程、目标检测 Transformer、语言感知深度融合。
九、总结与参考资料
本文系统梳理了卢菁博士《多模态大模型教程》第五模块《GLIP 模型详解》(第 16–19 集)的核心内容:从 DETR、YOLOS 的检测 Transformer 化讲起,深入剖析 GLIP 如何把目标检测重构为短语定位任务,实现开放词汇检测。GLIP 通过 DyHead + BERT + 语言感知深度融合的架构设计,配合 27M 预训练数据配方与联合损失函数,在零样本检测上取得了超越有监督基线的成绩,标志着检测范式从封闭类别到开放词汇的关键跃迁。
以下是官方文档与推荐阅读资料:
- GLIP 论文:Grounded Language-Image Pre-training(CVPR 2022,微软研究院)
- Microsoft Research 项目页:Object Detection in the Wild via Grounded Language-Image Pre-training
- Hugging Face 模型库:搜索 GLIP 即可找到官方 checkpoint 与使用示例,支持零样本检测快速体验
- Grounded-SAM 项目:IDEA-Research/Grounded-Segment-Anything,GLIP 与 SAM 组合的开放词汇分割流水线
- 课程选集:卢菁博士《多模态大模型教程》,第 16–19 集对应本模块内容
主要来源:GLIP 论文 链接、Microsoft Research 项目页 链接、GLIP 技术解读 链接、课程选集 链接



评论前必须登录!
注册