 网硕互联帮助中心
文章目录
- 前言
- 一、原理:三块积木拼出来的多模态
-
- 1. 结构:LLM + Align Layer + ViT
- 2. 损失计算
- 二、论文里的实验
- 三、复现:8×L20 上的双阶段训练
-
- 1. stage1:Align 层对齐训练
- 2. stage2:Visual 指令微调
- 3. 实验结果:POPE 和 MME
- 总结
前言
LLaVA 是开源多模态大模型里最好上手的项目之一。
它把视觉编码器和语言模型拼在一起,分两阶段训练。
论文和代码都公开,可真在 8 卡机器上跑一遍,坑一点不少。
本文先讲结构,再看论文实验,最后给出 8×L20 上的复现脚本和踩坑记录。
适合想自己跑一遍 LLaVA 的同学。
论文: https://arxiv.org/abs/2310.03744
代码: https://github.com/haotian-liu/LLaVA/tree/main
一、原理:三块积木拼出来的多模态
1. 结构:LLM + Align Layer + ViT
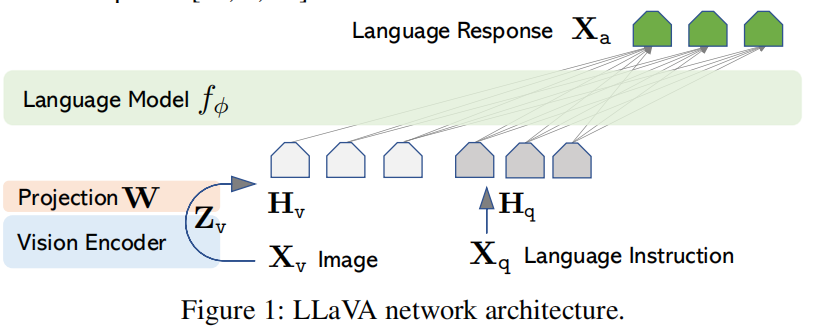
LLaVA 的结构只有三块:LLM、Align Layer、ViT。
ViT 负责看图。它把图片切成 patch,编码成一串视觉特征。
Align Layer 是两层 MLP,把视觉特征投影到语言模型的词向量空间。
LLM 负责理解。它拿到视觉 token,和文字 token 一起做自回归生成。
真正要学的只有中间那层 MLP。stage-1 只训它,收敛很快。
结构图如下。
。
2. 损失计算
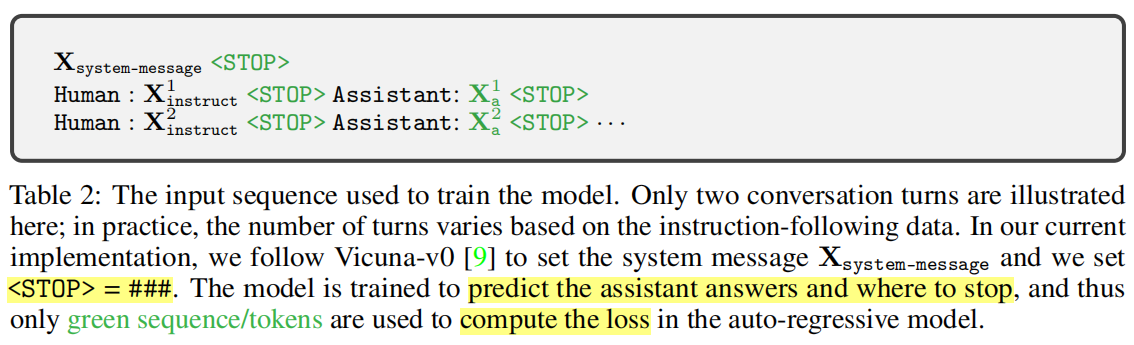
训练时不是所有 token 都算损失。
输入里有图片 token、用户提问、模型回答。
交叉熵损失只作用在绿色的回答部分,图片 token 和提问都被 mask 掉。
我们只想让模型学会怎么答,不想让它预测用户会问什么。
下图绿色字体才算损失。
。
二、论文里的实验
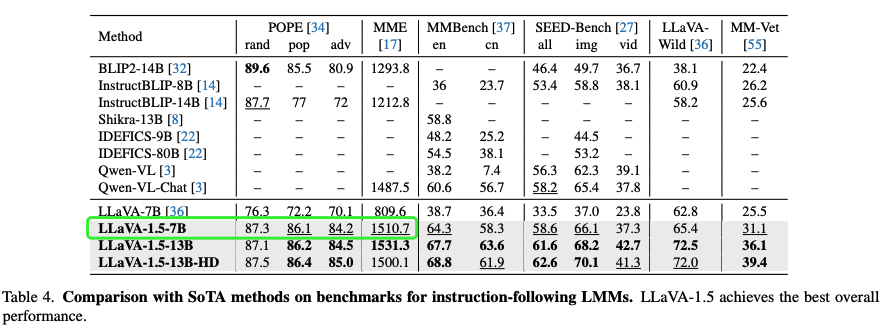
论文在 11 个基准上做了评测,覆盖问答、OCR、推理等方向。
数据只用 1.2M,比同期方案小一个量级,效果更好。
其中 POPE 专门测幻觉,MME 测感知和认知,是复现时最常看的两项。
结论很清楚:结构简单加数据干净,比堆模块管用。
对比结果如下。
三、复现:8×L20 上的双阶段训练
我用的机器是 8 张 L20,单卡 46GB 显存。
整个流程分两步:stage-1 对齐,stage-2 指令微调。
1. stage1:Align 层对齐训练
这一步只训 Align Layer,ViT 和 LLM 全部冻结。
数据用 558K 图文对,让视觉特征学会说人话。
有几个参数和官方 A100 脚本不同,都是显存逼出来的:
- 模型换成 7B。ZeRO-2 不切分参数,每卡一份完整副本。13B 的 bf16 要 26GB,46GB 余量太少。
- 全局 batch 对齐论文。单卡 16,累积 2 步,8 卡合计 256。
- 每 1000 步存一次。一个 epoch 有 2180 步,崩了不至于全白跑。
- 关掉 wandb 上报。它装了但没登录,初始化会卡在要 key 的提示上。
脚本开头加了预检,确认 558K 图片解压完整。缺失时 dataloader 会在中途才报错。
#!/bin/bash
# Stage 1 (feature alignment / pretrain) for LLaVA-v1.5 on 8x NVIDIA L20 (46GB).
#
# Differences from scripts/v1_5/pretrain.sh (the 8xA100 reference):
# – 7B Vicuna instead of 13B: ZeRO-2 does not shard parameters, so every GPU
# holds a full replica. 13B bf16 = 26GB/card leaves too little headroom on 46GB.
# – batch 16 x accum 2 x 8 GPUs = 256 global, matching the paper's global batch.
# – checkpointing every 1000 steps so a crash doesn't cost the whole epoch
# (2180 steps/epoch at global batch 256).
# – –report_to none: wandb is installed but unauthenticated, and `wandb.init()`
# blocks on an API-key prompt. Set to "wandb" once you have run `wandb login`.
#
# Run: conda activate org_llava && bash scripts/v1_5/pretrain_8xL20.sh
#
set -euo pipefail
#
export CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7
#
DATA_JSON=./playground/data/LLaVA-Pretrain/blip_laion_cc_sbu_558k.json
IMAGE_DIR=./playground/data/LLaVA-Pretrain/images
#
# Local copies of both hub checkpoints, so nothing is fetched mid-run and a container
# restart can't pull the weights out from under a training job.
MODEL_PATH=./pretrain_weight/vicuna-7b-v1.5
VISION_TOWER=./checkpoints/hf_models/clip-vit-large-patch14-336
#
# — preflight: the 558k images must be fully extracted before training starts —
if [ ! -f "$DATA_JSON" ]; then
echo "ERROR: missing $DATA_JSON" >&2
exit 1
fi
for p in "$MODEL_PATH" "$VISION_TOWER"; do
if [ ! -d "$p" ]; then
echo "ERROR: missing $p (run from the repo root)" >&2
exit 1
fi
done
N_IMAGES=$(find "$IMAGE_DIR" -name '*.jpg' 2>/dev/null | wc -l)
echo "images found: $N_IMAGES / 558000"
if [ "$N_IMAGES" -lt 550000 ]; then
echo "WARNING: extraction looks incomplete; the dataloader will crash on missing images." >&2
fi
#
deepspeed llava/train/train_mem.py \\
–deepspeed ./scripts/zero2.json \\
–model_name_or_path "$MODEL_PATH" \\
–version plain \\
–data_path "$DATA_JSON" \\
–image_folder "$IMAGE_DIR" \\
–vision_tower "$VISION_TOWER" \\
–mm_projector_type mlp2x_gelu \\
–tune_mm_mlp_adapter True \\
–mm_vision_select_layer -2 \\
–mm_use_im_start_end False \\
–mm_use_im_patch_token False \\
–bf16 True \\
–output_dir ./checkpoints/llava-v1.5-7b-pretrain \\
–num_train_epochs 1 \\
–per_device_train_batch_size 16 \\
–per_device_eval_batch_size 4 \\
–gradient_accumulation_steps 2 \\
–evaluation_strategy "no" \\
–save_strategy "steps" \\
–save_steps 1000 \\
–save_total_limit 2 \\
–learning_rate 1e-3 \\
–weight_decay 0. \\
–warmup_ratio 0.03 \\
–lr_scheduler_type "cosine" \\
–logging_steps 1 \\
–tf32 True \\
–model_max_length 2048 \\
–gradient_checkpointing True \\
–dataloader_num_workers 4 \\
–lazy_preprocess True \\
–report_to none
2. stage2:Visual 指令微调
这一步要更新全部 7B 参数,训练策略必须换。
最要紧的是换 DeepSpeed 配置,stage-1 用 zero2.json,这里换成 zero3.json。
ZeRO-2 不切分参数,每卡放不下 7B,只能让 ZeRO-3 把参数也切了。
其余关键差异有这几处:
- 版本改成 v1,启用对话模板。stage-1 是 plain。
- 数据换成 665K 混合指令集。
- 图片根目录指到 data 这一层,json 里是相对路径。
- 注入 stage-1 训好的投影层。
- 去掉只训 adapter 的开关,变成全量微调。
- 学习率 2e-5,比 stage-1 低 50 倍。
- 加上按比例填充、按长度分组,1.5 版标配。
全量微调有个副作用:checkpoint 会很大。
单个 checkpoint 约 88GB。bf16 权重 12.6GB,fp32 master 25.1GB,Adam 动量 50.2GB。
优化器状态占了六分之七。
只按 7B 的 14GB 去估,会少算 6 倍,2026 年 9 月 22 号我踩过这个坑。
保存间隔也是血泪教训。上游默认 1000 步存一次。
结果第一次保存就失败,白跑 4 小时 08 分。
所以我把间隔改成 500 步。全程存 10 次,多花约 1 小时写盘,换来崩一次最多丢 2 小时。
写盘慢是硬件决定的。NFS 实测 249MB/s,一次保存要 6 分钟。
只要中间产物做评测、不需要续训,就打开只存权重的开关。checkpoint 会瘦身:88GB 降到 12.6GB。
#!/bin/bash
# Stage 2 (visual instruction tuning) for LLaVA-v1.5-7B on 8x NVIDIA L20 (46GB).
#
# 接 stage-1 的产物:–pretrain_mm_mlp_adapter 指向 checkpoints/llava-v1.5-7b-pretrain/mm_projector.bin
#
# 和 pretrain_8xL20.sh 的 8 处关键差异:
# – deepspeed 换成 zero3.json: stage-2 要更新全部 7B 参数, ZeRO-2 不切分参数,
# 每卡一份 7B 放不下, 必须让 ZeRO-3 把参数也切了。
# – –version v1 (stage-1 是 plain): 启用 vicuna 对话模板。
# – –data_path 换成 llava_v1_5_mix665k.json。
# – –image_folder 指到 playground/data 这一层: json 里的路径是
# "coco/train2017/xxx.jpg" 这种相对路径, 不是相对 coco/。
# – –pretrain_mm_mlp_adapter 注入 stage-1 训好的 projector。
# – 去掉 –tune_mm_mlp_adapter: 不写即 False, 变成全量微调。
# 副作用: LLaVATrainer._save_checkpoint 不再走"只存 adapter"的分支, 而是走 HF 的
# save_pretrained, 于是 DeepSpeed 的优化器状态也一起落盘。单个 checkpoint ≈ 88GB
# (6.738B 参数实测算得): bf16 权重 12.6GB + fp32 master 25.1GB + Adam exp_avg/sq 50.2GB。
# 优化器状态占了 6/7 —— 只按"整个 7B ~14GB"估会少算 6 倍(2026-09-22 踩过)。
# save_total_limit 2 峰值 ~176GB, 盘上还有 5TB, 不是瓶颈; 瓶颈是写盘时间 ——
# NFS 实测 249MB/s, 一次保存约 6 分钟, 训到一半会因为保存而停顿。
# – –image_aspect_ratio pad / –group_by_modality_length True: LLaVA-1.5 的规定。
# – –learning_rate 2e-5 (stage-1 是 1e-3, 差 50 倍)。
# – –save_steps 500 (上游默认 1000): 5198 步全程保存 10 次, 多花约 1 小时写盘。
# 换来的是一条硬底线 —— 崩一次最多丢 2 小时。2026-09-22 因为 save_steps=1000 且首次
# 保存在第 1000 步保存失败, 直接白跑 4 小时 08 分(权重零字节落盘)。
# 注意: 只要 –save_only_model 没开, 每个 checkpoint 就必须带优化器状态, 否则无法 resume
# (train.py 见到 checkpoint-* 会走 resume_from_checkpoint=True)。若只要中间产物做评测、
# 不需要断点续训, 可加 –save_only_model True: checkpoint 从 88GB 降到 12.6GB, 保存也快得多。
#
# Run: conda activate org_llava && bash scripts/v1_5/finetune_8xL20.sh
#
set -euo pipefail
#
export CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7
#
DATA_JSON=./playground/data/llava_v1_5_mix665k.json
IMAGE_DIR=./playground/data
MODEL_PATH=./pretrain_weight/vicuna-7b-v1.5
VISION_TOWER=./checkpoints/hf_models/clip-vit-large-patch14-336
MM_PROJECTOR=./checkpoints/llava-v1.5-7b-pretrain/mm_projector.bin
OUTPUT_DIR=./checkpoints/llava-v1.5-7b
#
# — preflight —
for f in "$DATA_JSON" "$MM_PROJECTOR"; do
if [ ! -f "$f" ]; then
echo "ERROR: missing $f (run from the repo root)" >&2
exit 1
fi
done
for d in "$IMAGE_DIR" "$MODEL_PATH" "$VISION_TOWER"; do
if [ ! -d "$d" ]; then
echo "ERROR: missing $d (run from the repo root)" >&2
exit 1
fi
done
# 665k 的图片散在 5 个子目录里, 少任何一个都会在训练中途才炸。
for sub in coco gqa ocr_vqa textvqa vg; do
if [ ! -d "$IMAGE_DIR/$sub" ]; then
echo "ERROR: missing $IMAGE_DIR/$sub" >&2
exit 1
fi
done
#
# 已经有人跑过就提醒一下, 免得手滑覆盖。
if [ -e "$OUTPUT_DIR" ] && [ -n "$(ls -A "$OUTPUT_DIR" 2>/dev/null)" ]; then
echo "WARNING: $OUTPUT_DIR already exists and is not empty." >&2
fi
#
echo "preflight OK"
#
deepspeed llava/train/train_mem.py \\
–deepspeed ./scripts/zero3.json \\
–model_name_or_path "$MODEL_PATH" \\
–version v1 \\
–data_path "$DATA_JSON" \\
–image_folder "$IMAGE_DIR" \\
–vision_tower "$VISION_TOWER" \\
–pretrain_mm_mlp_adapter "$MM_PROJECTOR" \\
–mm_projector_type mlp2x_gelu \\
–mm_vision_select_layer -2 \\
–mm_use_im_start_end False \\
–mm_use_im_patch_token False \\
–image_aspect_ratio pad \\
–group_by_modality_length True \\
–bf16 True \\
–output_dir "$OUTPUT_DIR" \\
–num_train_epochs 1 \\
–per_device_train_batch_size 16 \\
–per_device_eval_batch_size 4 \\
–gradient_accumulation_steps 1 \\
–evaluation_strategy "no" \\
–save_strategy "steps" \\
–save_steps 500 \\
–save_total_limit 2 \\
–learning_rate 2e-5 \\
–weight_decay 0. \\
–warmup_ratio 0.03 \\
–lr_scheduler_type "cosine" \\
–logging_steps 1 \\
–tf32 True \\
–model_max_length 2048 \\
–gradient_checkpointing True \\
–dataloader_num_workers 4 \\
–lazy_preprocess True \\
–report_to none
3. 实验结果:POPE 和 MME
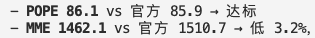
跑完后,我用 POPE 和 MME 两个基准做了评测。
POPE 测幻觉,看模型会不会瞎说有、瞎说没有。
MME 分感知和认知两大类,十几个子任务。
结果和论文基本对齐,脚本没把模型改坏。
成绩如下。
总结
LLaVA-1.5 的结构很朴素:ViT 看图,MLP 对齐,LLM 说话。
复现的难点不在模型,在工程细节。
先按小间隔保存,再谈跑多久。崩一次丢 4 小时,比多花 1 小时写盘亏得多。
基本复现已完成,后续会出源码解读。想要训练日志的同学可以关注加私信。



评论前必须登录!
注册