 网硕互联帮助中心
【医学图像分割模块】StarNet —— 星操作(元素级乘法)—— 把"相加"换成"相乘"的轻量卷积块
一、论文出处
- 论文全名:Rewrite the Stars(arXiv 编号 2403.19967)
- 会议/年份:CVPR 2024
- 论文链接:https://arxiv.org/abs/2403.19967
- 官方代码:https://github.com/ma-xu/Rewrite-the-Stars
二、模块图(截自论文原文)
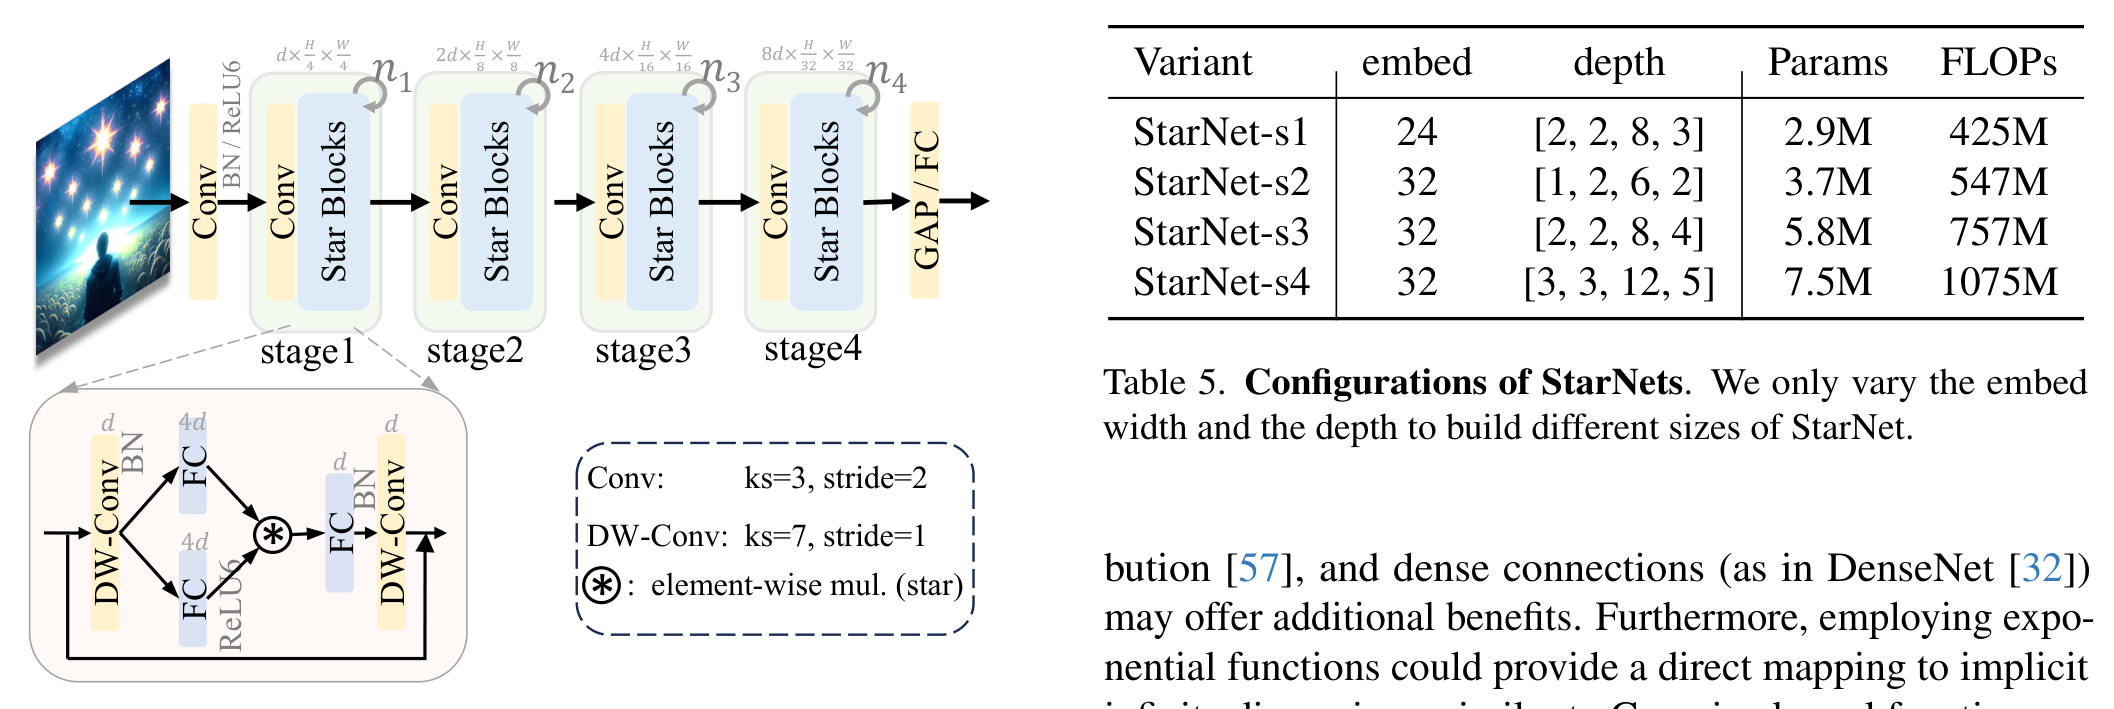
图中展示的是 Star Block 的基本构成:输入经两条并行的逐点卷积(或线性层)升维后,做元素级相乘(star operation),再经一层投影回到目标通道数,整体是一个残差结构。
三、核心思想与作用
一句话总括:StarNet 用「元素级相乘」替代传统卷积/MLP 里的「加权求和」,在不加宽网络的前提下,把特征隐式地映射到一个高维非线性空间。
拆解来看:
为什么好:
- 乘法带来的非线性是「数据相关」的,比固定激活函数更灵活。
- 没有显式升维,参数量和计算量都压得住,适合移动端和医学影像这类对延迟敏感的场景。
- 结构规整,几乎可以无痛替换现有网络里的 MLP 或部分卷积块。
四、在 U-Net 里的插入位置
StarNet 的 Star Block 本质上是一个「轻量特征变换块」,适合放在需要非线性表达、但又不想大幅增加计算量的位置。
- 编码器浅层:浅层特征通道少、分辨率高,直接堆大卷积代价大。用 Star Block 替换部分 3×3 卷积,能在低通道预算下补足非线性。
- 瓶颈层(bottleneck):这里通道最多、分辨率最低,是全局语义最集中的地方。Star Block 的隐式高维特性在这里收益最明显,且计算量可控。
- 解码器:解码阶段需要逐步恢复空间细节,Star Block 可以放在每次上采样后的卷积块里,作为非线性增强,但不宜堆太多,避免破坏细节。
总体建议:优先放在瓶颈层和编码器深层,浅层和解码器按需少量使用。它不改变特征图尺寸和通道数,属于即插即用,替换时保持输入输出通道一致即可。
五、复现代码(PyTorch,逐行中文注释)
说明:以下是简化教学版,只保留 Star Block 最核心的「双分支逐元素相乘 + 投影 + 残差」结构,省略了论文里的分组、深度可分离等工程优化,便于理解原理。
import torch
import torch.nn as nn
class StarBlock(nn.Module):
def __init__(self, dim, hidden_dim=None, drop_path=0.0):
super().__init__()
# hidden_dim 是两条分支的中间维度,默认取输入的 2 倍
hidden_dim = hidden_dim or dim * 2
# 分支 1:把输入从 dim 映射到 hidden_dim
self.fc1 = nn.Conv2d(dim, hidden_dim, kernel_size=1)
# 分支 2:同样映射到 hidden_dim,但参数独立
self.fc2 = nn.Conv2d(dim, hidden_dim, kernel_size=1)
# 激活函数,放在相乘之前,给乘法提供非线性基础
self.act = nn.GELU()
# 投影层:把相乘后的 hidden_dim 映射回 dim
self.fc3 = nn.Conv2d(hidden_dim, dim, kernel_size=1)
# 可选的随机深度(DropPath),训练时随机丢弃整个残差分支
self.drop_path = drop_path
def forward(self, x):
# 保存输入,用于最后的残差相加
identity = x
# 两条分支分别做线性变换 + 激活
x1 = self.act(self.fc1(x))
x2 = self.act(self.fc2(x))
# 核心:元素级相乘(star operation)
# 两个 hidden_dim 维特征逐元素相乘,隐式生成交叉项
out = x1 * x2
# 投影回原始通道数
out = self.fc3(out)
# 训练时按概率丢弃残差分支,推理时直接相加
if self.training and self.drop_path > 0:
keep = torch.rand(1).item() > self.drop_path
out = out if keep else torch.zeros_like(out)
# 残差连接,保证梯度顺畅
return identity + out
六、插入示例(几行塞进你的网络)
# 假设你有一个 U-Net 的瓶颈层特征 x,通道数为 512
x = torch.randn(2, 512, 16, 16) # (batch, channel, H, W)
# 直接实例化 StarBlock,输入输出通道保持一致
star = StarBlock(dim=512, hidden_dim=1024)
# 前向,特征图尺寸和通道数都不变,可无缝替换原有卷积块
y = star(x)
print(y.shape) # torch.Size([2, 512, 16, 16])
七、实测经验与注意点
- 计算量:Star Block 的主要开销在两条 1×1 卷积和一次投影,hidden_dim 通常取 2~4 倍 dim。hidden_dim 越大,隐式高维空间越宽,但显存和延迟同步上升,医学影像 3D 数据要谨慎。
- 超参:hidden_dim 是核心超参,建议从 2 倍起步;drop_path 在深层可以设 0.1 左右,浅层保持 0。
- 踩坑:元素级相乘对输入尺度敏感,如果前面没有归一化(BN/LN),两条分支的数值范围差异大,容易梯度不稳,建议在 Star Block 前接归一化。
- 替换策略:不要一次性替换所有卷积,先替换瓶颈层,观察收敛和显存,再逐步向编码器扩展。
- 与激活的关系:乘法本身已提供非线性,激活函数放在相乘之前即可,相乘之后再接激活收益有限,反而增加开销。
- 医学影像注意:小数据集上 Star Block 的隐式高维表达可能过拟合,配合数据增强和适度正则更稳。
八、完整工程
本文代码已整理进即插即用模块仓库:https://github.com/CaiCy6/med-modules ,可直接 clone 后替换进你的 U-Net。
下一篇预告:我们将拆解另一个 CVPR 2024 的即插即用模块,聊聊它如何在解码器里做轻量注意力,敬请关注。


评论前必须登录!
注册