 网硕互联帮助中心
AI视觉稿里的文字问题,通常不是单一的“字体不好看”,而是生成、排版和校对三个环节混在了一起。 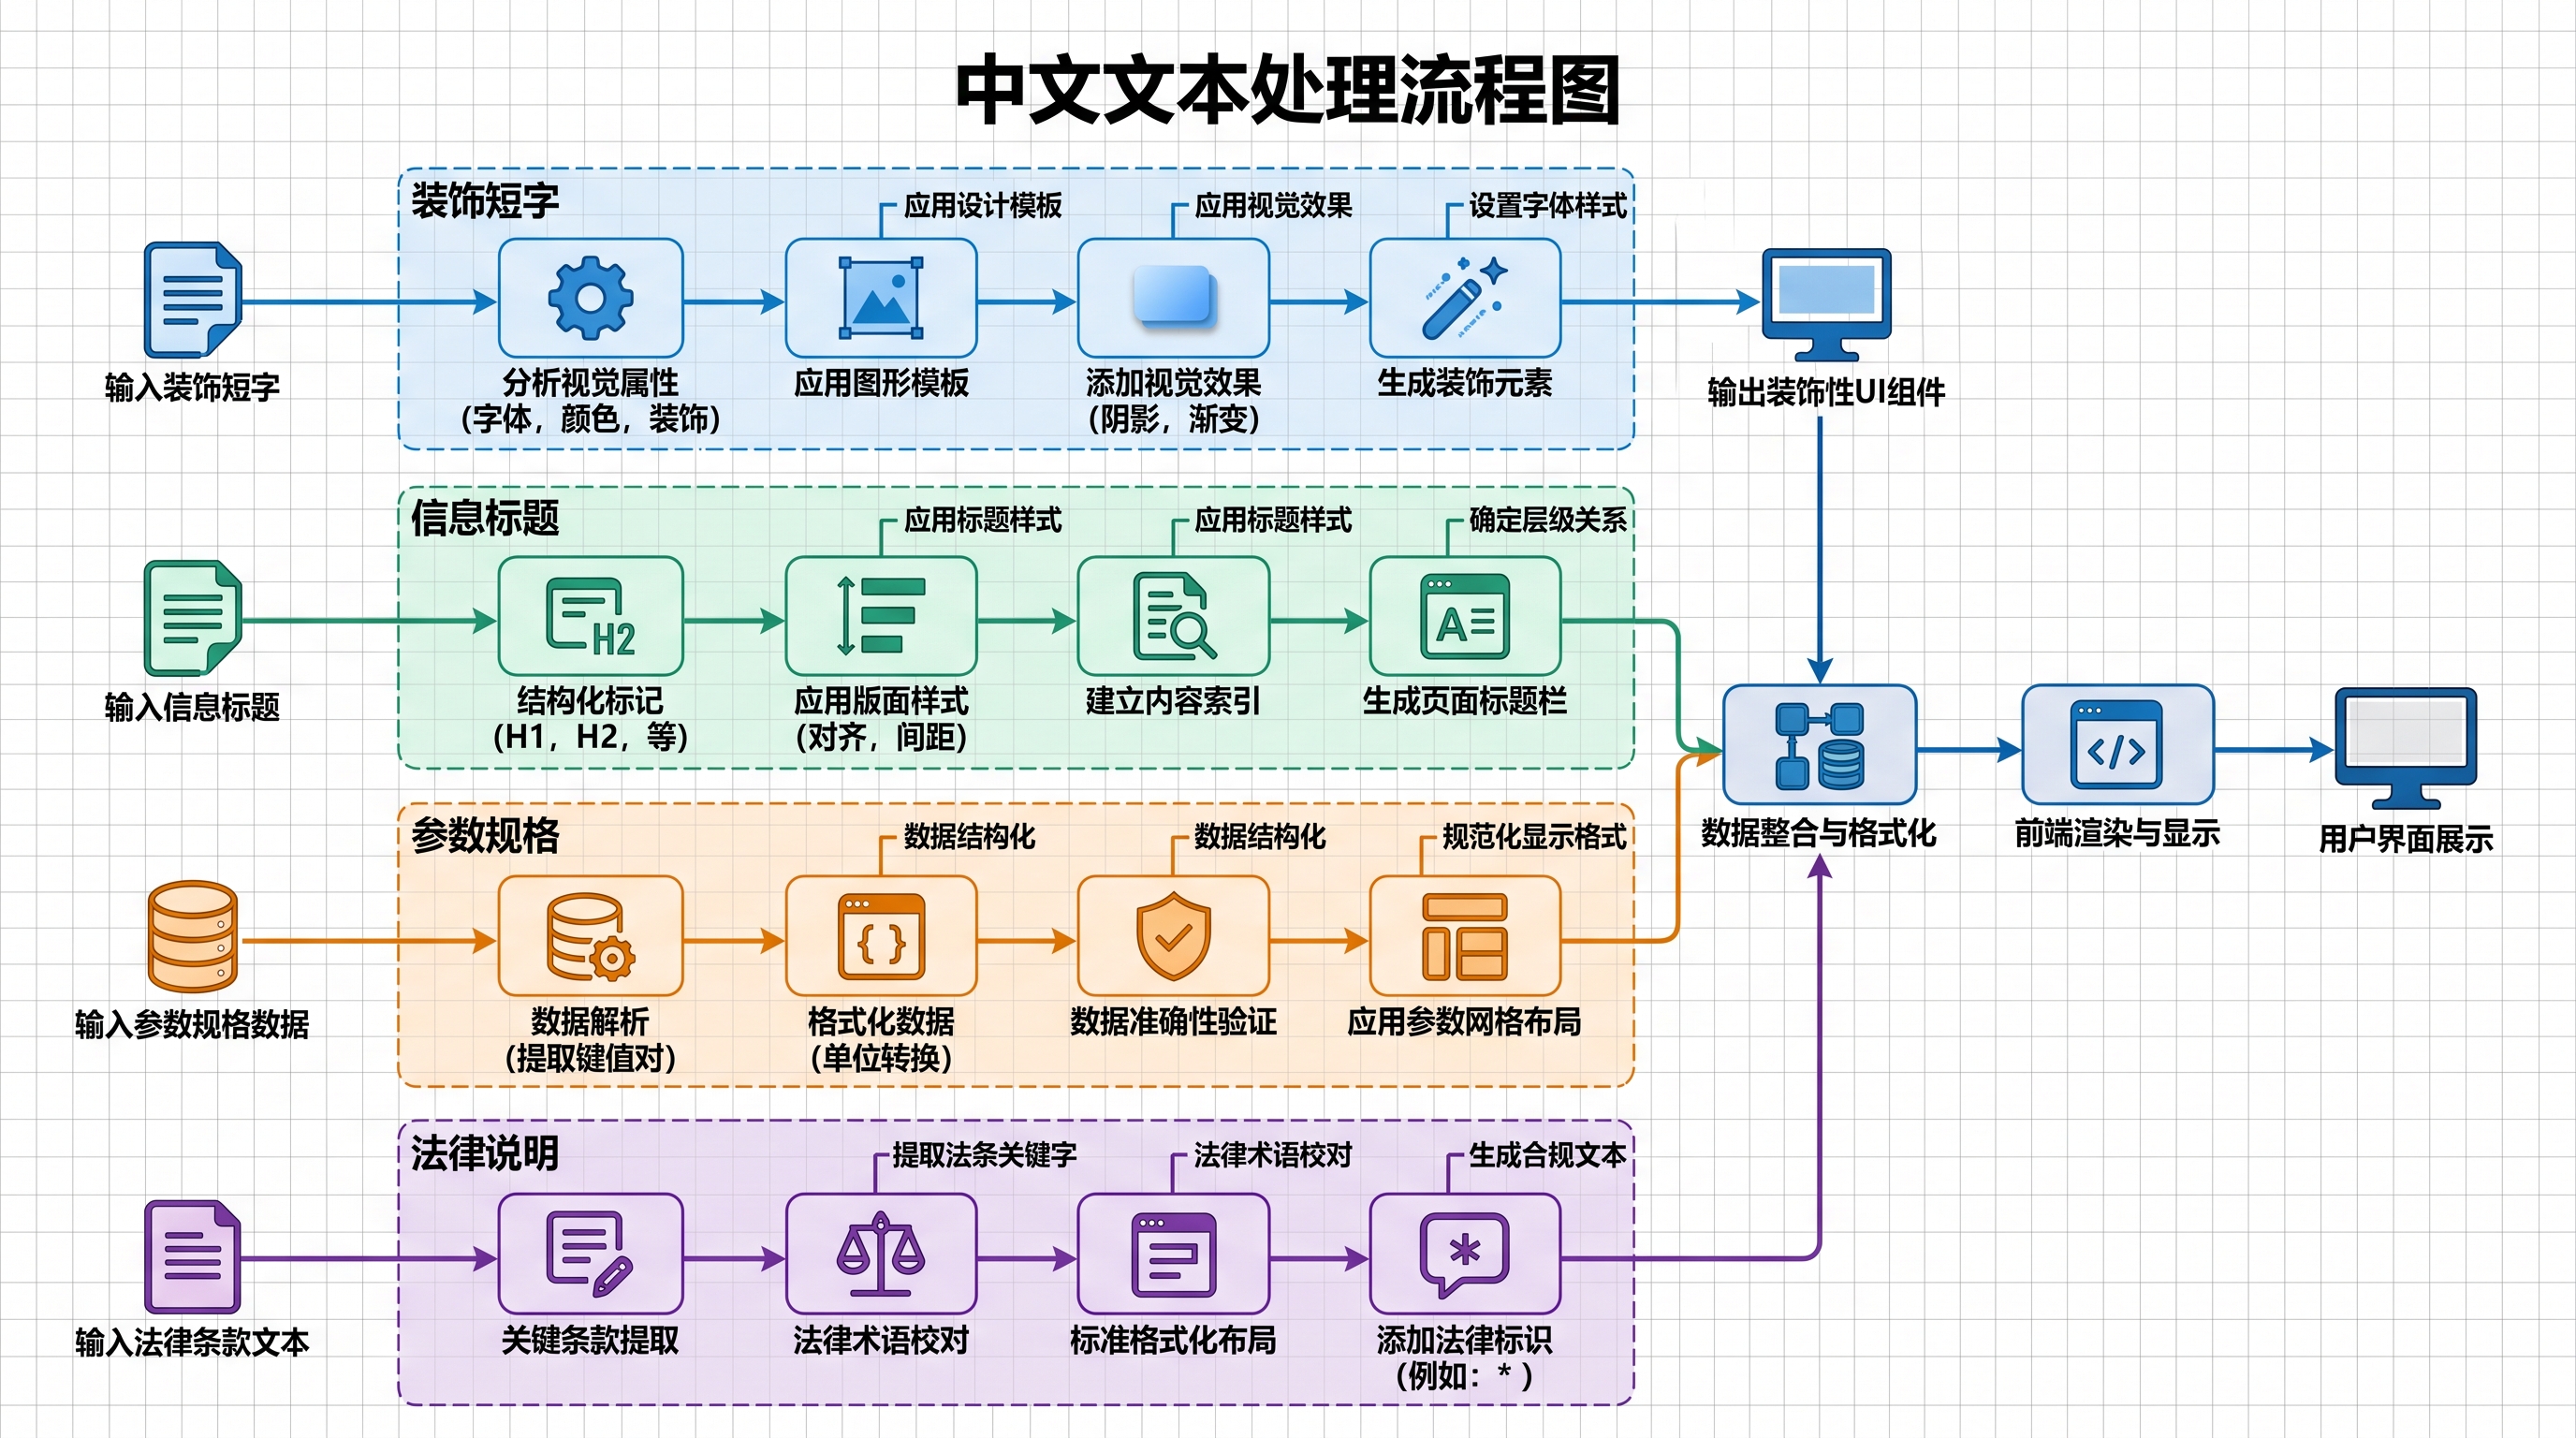
本文将画面生成与文字排版拆开,先为文字预留安全区,再用可复制文本源和发布前缩放检查,减少乱码、漏字和错位被带到最终交付物中。凡达Ai画布仅作为项目语境,不代表产品会自动生成准确文字或替代人工校对。
一、先判断文字属于哪一段处理
装饰性短字、信息性标题和需要精确复制的正文,验收标准不同。装饰字可以作为视觉草稿观察,精确信息则应保留独立文本源,不能只依赖图片里的像素结果。先给文字分级,才能决定是重生成、后期排版还是直接改写。
| 装饰短字 | 可作为视觉草稿 | 字形不稳定 | 看整体层级 |
| 信息标题 | 生成留区后排版 | 错字、断行 | 逐字核对 |
| 参数与规格 | 独立文本源排版 | 数字和单位错误 | 复制比对 |
| 法律或版权说明 | 人工录入并复核 | 漏字或误读 | 发布前二次确认 |
二、为文字预留安全区而不是事后硬塞
在输入阶段明确文字区域的位置、宽度、行数和不得覆盖的主体边缘。安全区不是让模型承诺“必然留白”,而是给人工排版留下可检查的空间;如果画面已经没有安全区,继续改形容词通常不能解决布局问题。
三、保留独立文本源并做复制比对
function compareText(source, extracted) {
const clean = value => value.replace(/\\s+/g, "").trim();
return clean(source) === clean(extracted);
}
// 图片中的文字仍需人工核对,代码不能替代视觉检查。
核验记录:以上代码是可复用示例,不等于本文已在你的项目中实测;使用前请替换字段并记录实际输出。
四、按三个缩放档位检查可读性
五、将文字问题归因后再返工
| 字符错误 | 文本源与输入内容 | 改为独立排版 |
| 位置错位 | 安全区和版式宽度 | 重新规划区域 |
| 对比度不足 | 背景与字色 | 加底板或换层级 |
| 缩小不可读 | 发布尺寸和字数 | 精简信息并复核 |
文字可靠性不是把字交给生成模型,而是让文字有独立来源、独立校对和独立的发布检查。
失败反例
失败反例:看到图片中的标题大致正确,就直接复制到发布平台;缩小后才发现数字漏写、字形混乱或关键信息被背景吞掉。
仍然失败怎么办
仍然出现文字错误时,停止继续生成整张图,先冻结视觉背景,再用独立文本源完成排版和逐字核对;如果原图承担了必须准确的文字,不应把它当作最终信息源。
结论与边界
本文是视觉文字的流程治理方法,不代表任何模型能准确识别、生成或校对所有中文文字,也不代表排版后的图像会自动通过目标平台检查。
参考资料
- MDN:CanvasRenderingContext2D.measureText()
- W3C:WCAG 2.2 Understanding Resize Text
#凡达Ai #凡达Ai画布 #凡达Ai工具 #凡达Ai导演台 #文字排版


评论前必须登录!
注册