 网硕互联帮助中心
每天都在用 flink run 提交作业,但你有没有想过,一条简单的提交命令背后,Flink 到底做了多少事情?从命令行参数解析,到用户 main 方法执行,再到 StreamGraph、JobGraph 的构建,最后通过 REST API 提交到集群,Dispatcher 启动 JobManager,JobMaster 调度 Task 到 TaskManager 执行——这是一条跨越客户端和服务端的完整链路。这篇从源码层面把 Flink 任务提交的每一步讲透,包括 CliFrontend、PackagedProgram、StreamGraphGenerator、JobGraphGenerator、ClusterDescriptor、RestClusterClient、Dispatcher、JobManagerRunner、JobMaster 等核心类的源码实现,并对比三种部署模式的差异。
一、Flink 任务提交流程整体架构
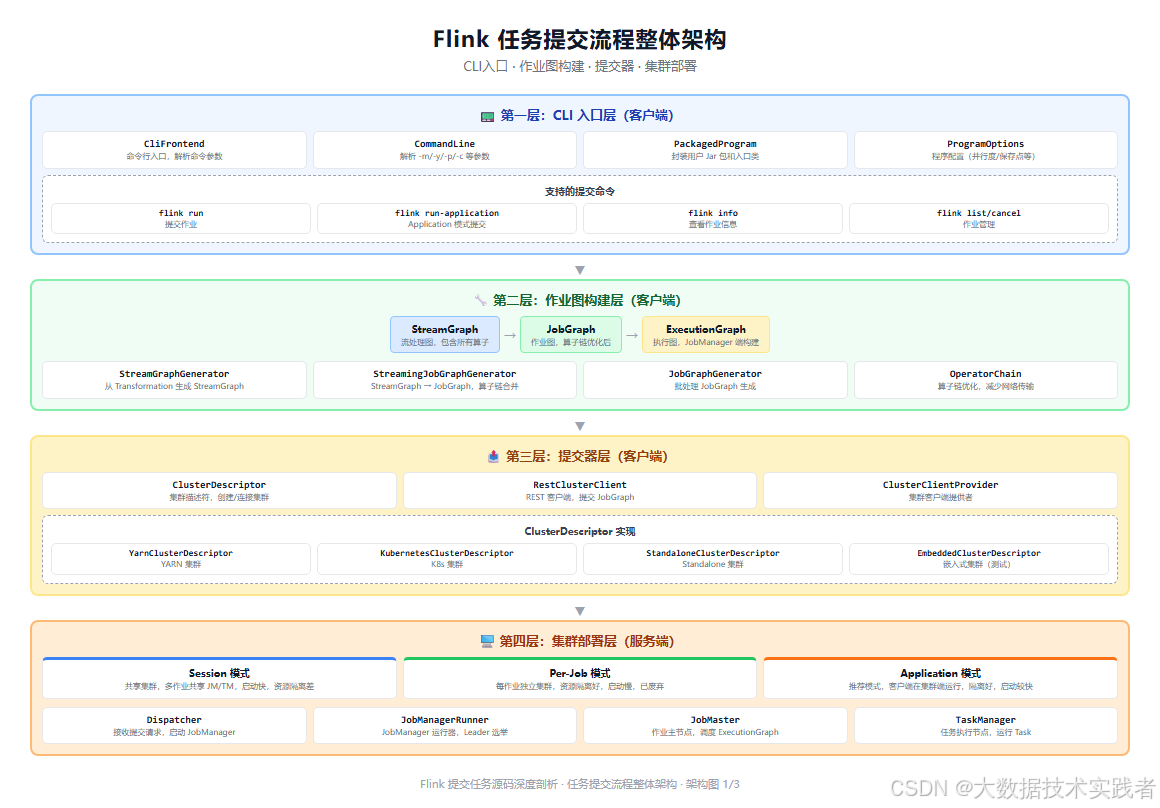
下面这张图是 Flink 任务提交流程整体架构,分为四层:CLI 入口层、作业图构建层、提交器层、集群部署层。
1.1 四层架构概览
Flink 任务提交可以分为四层,每层职责清晰:
第一层:CLI 入口层(客户端)
- CliFrontend:命令行入口,解析 flink run 等命令
- CommandLine:解析 -m/-y/-p/-c/-s 等参数
- PackagedProgram:封装用户 Jar 包和入口类
- ProgramOptions:程序配置(并行度/保存点等)
第二层:作业图构建层(客户端)
- StreamGraph:流处理图,包含所有算子和边
- JobGraph:作业图,算子链优化后
- ExecutionGraph:执行图,JobManager 端构建
- StreamGraphGenerator / JobGraphGenerator:图生成器
第三层:提交器层(客户端)
- ClusterDescriptor:集群描述符,创建/连接集群
- RestClusterClient:REST 客户端,提交 JobGraph
- ClusterClientProvider:集群客户端提供者
- YarnClusterDescriptor / KubernetesClusterDescriptor 等实现
第四层:集群部署层(服务端)
- Dispatcher:接收提交请求,启动 JobManager
- JobManagerRunner:JobManager 运行器,Leader 选举
- JobMaster:作业主节点,调度 ExecutionGraph
- TaskManager:任务执行节点,运行 Task
1.2 三种图的关系
Flink 任务提交涉及三种图,层层递进:
StreamGraph(客户端,逻辑图) → JobGraph(客户端,优化后) → ExecutionGraph(服务端,物理执行图)
StreamGraph:从用户代码的 Transformation 列表生成,包含所有算子、数据流边、分区策略,是逻辑执行计划。
JobGraph:StreamGraph 经过算子链合并(OperatorChain)优化后生成,多个可链接的算子合并为一个 JobVertex,减少网络传输和线程切换开销。JobGraph 是提交到集群的最终图。
ExecutionGraph:JobManager 端根据 JobGraph 构建,按并行度展开为 ExecutionVertex,每个 ExecutionVertex 对应一个具体的 Task,是物理执行计划。
二、CLI 入口源码剖析
2.1 CliFrontend 入口
CliFrontend 是 flink 命令行的入口类,main 方法是整个提交流程的起点:
public class CliFrontend {
private final CustomCommandLine activeCustomCommandLine;
public static void main(String[] args) {
// 1. 加载配置
Configuration configuration = GlobalConfiguration.loadConfiguration();
// 2. 创建 CliFrontend
CliFrontend cli = new CliFrontend(configuration);
// 3. 解析命令并执行
int retCode = cli.parseAndRun(args);
System.exit(retCode);
}
public int parseAndRun(String[] args) {
// 解析第一个参数作为命令(run/run-application/info/list/cancel…)
String command = args[0];
switch (command) {
case "run":
return run(args);
case "run-application":
return runApplication(args);
case "info":
return info(args);
case "list":
return list(args);
case "cancel":
return cancel(args);
default:
throw new IllegalArgumentException("Unknown command " + command);
}
}
}
关键逻辑:
- main 方法加载配置,创建 CliFrontend,调用 parseAndRun
- parseAndRun 根据第一个参数分发到不同命令处理方法
- 支持的命令:run、run-application、info、list、cancel、savepoint 等
2.2 run 方法源码
run 方法是提交作业的核心,完整流程:
protected int run(String[] args) throws Exception {
// 1. 解析命令行参数
final CommandLine commandLine = parser.parse(options, args);
// 2. 创建 ProgramOptions(程序配置)
final ProgramOptions programOptions = ProgramOptions.create(commandLine);
// 3. 创建 PackagedProgram(封装用户 Jar)
final PackagedProgram program = PackagedProgram.newBuilder()
.setJarFile(new File(programOptions.getJarFilePath()))
.setEntryPointClassName(programOptions.getEntryPointClassName())
.setArguments(programOptions.getProgramArgs())
.setSavepointRestoreSettings(programOptions.getSavepointRestoreSettings())
.build();
// 4. 获取活跃的 CustomCommandLine(YARN/K8s/Standalone)
final CustomCommandLine activeCommandLine =
findActiveCommandLine(commandLine);
// 5. 创建 ClusterDescriptor
final ClusterDescriptor<ClusterID> clusterDescriptor =
activeCommandLine.createClusterDescriptor(configuration);
// 6. 获取 ClusterClientProvider
final ClusterClientProvider<ClusterID> clusterClientProvider =
clusterDescriptor.retrieve(clusterId);
// 7. 获取 ClusterClient
final ClusterClient<ClusterID> clusterClient =
clusterClientProvider.getClusterClient();
// 8. 执行用户程序并提交
return executeProgram(program, clusterClient);
}
关键步骤:
2.3 PackagedProgram
PackagedProgram 封装用户 Jar 包,负责类加载和 main 方法调用:
public class PackagedProgram {
private final File jarFile;
private final String entryPointClassName;
private final String[] args;
private final SavepointRestoreSettings savepointSettings;
private final URLClassLoader userCodeClassLoader;
public static class Builder {
private File jarFile;
private String entryPointClassName;
private String[] args = new String[0];
public Builder setJarFile(File jarFile) {
this.jarFile = jarFile;
return this;
}
public Builder setEntryPointClassName(String className) {
this.entryPointClassName = className;
return this;
}
public PackagedProgram build() {
// 1. 从 Jar 包 MANIFEST.MF 读取入口类(如果未指定)
if (entryPointClassName == null) {
entryPointClassName = getEntryPointClassNameFromJar(jarFile);
}
// 2. 创建用户代码类加载器(ChildFirstClassLoader)
userCodeClassLoader = createUserCodeClassLoader(jarFile);
return new PackagedProgram(this);
}
}
// 调用用户 main 方法
public void invokeInteractiveModeForExecution() {
Class<?> mainClass = Class.forName(entryPointClassName, true, userCodeClassLoader);
Method mainMethod = mainClass.getMethod("main", String[].class);
mainMethod.invoke(null, (Object) args);
}
}
关键设计:
- Builder 模式构建,支持设置 Jar 路径、入口类、参数、保存点
- 入口类未指定时从 Jar 包 MANIFEST.MF 的 Main-Class 读取
- 创建 ChildFirstClassLoader,用户代码类优先加载,避免与 Flink 框架类冲突
- invokeInteractiveModeForExecution 通过反射调用用户 main 方法
三、作业图构建源码
3.1 StreamGraph 生成
用户 main 方法执行时,会创建 StreamExecutionEnvironment,添加各种 Transformation,最后调用 execute() 触发 StreamGraph 生成:
public class StreamExecutionEnvironment {
private final List<Transformation<?>> transformations = new ArrayList<>();
// 添加 Source
public <OUT> DataStreamSource<OUT> addSource(SourceFunction<OUT> function) {
SourceTransformation<OUT> transformation =
new SourceTransformation<>(function, parallelism);
transformations.add(transformation);
return new DataStreamSource<>(this, transformation);
}
// 执行作业
public JobExecutionResult execute(String jobName) throws Exception {
// 1. 生成 StreamGraph
StreamGraph streamGraph = getStreamGraph();
streamGraph.setJobName(jobName);
// 2. 生成 JobGraph
JobGraph jobGraph = StreamingJobGraphGenerator.createJobGraph(streamGraph);
// 3. 提交 JobGraph
return executeRemotely(jobGraph);
}
// 生成 StreamGraph
public StreamGraph getStreamGraph() {
StreamGraphGenerator generator =
new StreamGraphGenerator(transformations, config, checkpointCfg);
return generator.generate();
}
}
关键逻辑:
- 用户代码调用 env.addSource() / map() / keyBy() 等方法时,创建对应的 Transformation 并添加到列表
- execute() 触发 StreamGraph 生成
- StreamGraphGenerator 遍历 Transformation 列表,生成 StreamNode 和 StreamEdge
- StreamingJobGraphGenerator 将 StreamGraph 转为 JobGraph
3.2 StreamGraphGenerator
StreamGraphGenerator 从 Transformation 列表生成 StreamGraph:
public class StreamGraphGenerator {
private final StreamGraph streamGraph;
private final Map<Integer, Transformation<?>> transformations;
public StreamGraph generate() {
// 1. 遍历所有 Transformation
for (Transformation<?> transformation : transformations) {
transform(transformation);
}
return streamGraph;
}
private Collection<Integer> transform(Transformation<?> transform) {
if (transform instanceof SourceTransformation) {
return transformSource((SourceTransformation) transform);
} else if (transform instanceof OneInputTransformation) {
return transformOneInputTransform((OneInputTransformation) transform);
} else if (transform instanceof TwoInputTransformation) {
return transformTwoInputTransform((TwoInputTransformation) transform);
} else if (transform instanceof PartitionTransformation) {
return transformPartition((PartitionTransformation) transform);
} else if (transform instanceof UnionTransformation) {
return transformUnion((UnionTransformation) transform);
}
// … 其他类型
}
private Collection<Integer> transformOneInputTransform(OneInputTransformation transform) {
// 1. 递归转换上游 Transformation
Collection<Integer> inputIds = transform(transform.getInput());
// 2. 创建 StreamNode
streamGraph.addOperator(
transform.getId(),
transform.getParallelism(),
transform.getOperator(),
transform.getName());
// 3. 创建 StreamEdge(连接上游和当前算子)
for (Integer inputId : inputIds) {
streamGraph.addEdge(inputId, transform.getId(), 0);
}
return Collections.singleton(transform.getId());
}
}
关键逻辑:
- generate() 遍历所有 Transformation,调用 transform() 递归转换
- transform() 根据 Transformation 类型分发到不同处理方法
- transformOneInputTransform 递归转换上游,创建 StreamNode 和 StreamEdge
- 支持 Source、OneInput、TwoInput、Partition、Union 等多种 Transformation 类型
3.3 JobGraph 生成与算子链优化
StreamingJobGraphGenerator 将 StreamGraph 转为 JobGraph,核心是算子链合并优化:
public class StreamingJobGraphGenerator {
public static JobGraph createJobGraph(StreamGraph streamGraph) {
StreamingJobGraphGenerator generator =
new StreamingJobGraphGenerator(streamGraph);
JobGraph jobGraph = generator.createJobGraph();
return jobGraph;
}
private JobGraph createJobGraph() {
// 1. 确定算子链(哪些算子可以合并)
Map<Integer, JobVertex> jobVertices = new HashMap<>();
// 2. 遍历 StreamGraph 的所有节点
for (StreamNode node : streamGraph.getStreamNodes()) {
// 3. 判断是否可以与上游算子链接
if (isChainable(node, streamGraph)) {
// 4. 合并到上游 JobVertex 的 OperatorChain
addToChain(node);
} else {
// 5. 创建新的 JobVertex
JobVertex vertex = createJobVertex(node);
jobVertices.put(node.getId(), vertex);
}
}
// 6. 创建 JobGraph 并设置 JobVertex
JobGraph jobGraph = new JobGraph(jobName, jobVertices.values());
return jobGraph;
}
// 判断两个算子是否可以链接
private boolean isChainable(StreamNode upStreamVertex, StreamNode downStreamVertex) {
// 1. 下游算子的入边只有一个
// 2. 上游算子的出边只有一个
// 3. 分区策略是 ForwardPartitioner(数据不重分区)
// 4. 上下游并行度相同
// 5. 没有禁用算子链(disableChaining)
// 6. 上下游算子在同一个 SlotSharingGroup
return true; // 满足以上所有条件
}
}
关键逻辑:
- createJobGraph 遍历 StreamGraph 节点,判断是否可以与上游算子链接
- isChainable 判断算子链条件:单输入单输出、Forward 分区、相同并行度、未禁用链、同一 Slot 组
- 可链接的算子合并为一个 JobVertex(OperatorChain),减少网络传输和线程切换
- 不可链接的创建独立 JobVertex
- 最终生成 JobGraph,包含所有 JobVertex 和 JobEdge
算子链优化的好处:
- 减少线程切换(多个算子在同一个线程执行)
- 减少网络传输(Forward 数据不需要序列化/网络传输)
- 减少序列化/反序列化开销
- 提高整体吞吐量
四、提交器源码
4.1 ClusterDescriptor
ClusterDescriptor 是集群描述符,负责创建和连接集群:
public interface ClusterDescriptor<ClusterID> extends AutoCloseable {
// 部署会话集群(Session 模式)
ClusterClientProvider<ClusterID> deploySessionCluster(
ClusterSpecification clusterSpecification) throws ClusterDeploymentException;
// 部署 Per-Job 集群(已废弃)
ClusterClientProvider<ClusterID> deployJobCluster(
ClusterSpecification clusterSpecification,
JobGraph jobGraph,
boolean detached) throws ClusterDeploymentException;
// 部署 Application 集群
ClusterClientProvider<ClusterID> deployApplicationCluster(
ClusterSpecification clusterSpecification,
ApplicationConfiguration applicationConfiguration) throws ClusterDeploymentException;
// 连接已有集群(retrieve)
ClusterClientProvider<ClusterID> retrieve(ClusterID clusterId) throws ClusterRetrieveException;
// 关闭集群
void killCluster(ClusterID clusterId) throws FlinkException;
}
关键方法:
- deploySessionCluster:部署 Session 模式集群
- deployJobCluster:部署 Per-Job 模式集群(已废弃)
- deployApplicationCluster:部署 Application 模式集群
- retrieve:连接已有集群(Session 模式提交作业时使用)
- killCluster:关闭集群
YarnClusterDescriptor 是 YARN 环境的实现,KubernetesClusterDescriptor 是 K8s 环境的实现,StandaloneClusterDescriptor 是 Standalone 环境的实现。
4.2 RestClusterClient
RestClusterClient 是 ClusterClient 的 REST 实现,通过 REST API 与集群通信:
public class RestClusterClient<ClusterID> implements ClusterClient<ClusterID> {
private final RestClient restClient;
private final String webInterfaceURL;
// 提交作业
@Override
public CompletableFuture<JobSubmissionResult> submitJob(JobGraph jobGraph) {
// 1. 序列化 JobGraph
byte[] jobGraphBytes = serializeJobGraph(jobGraph);
// 2. 构建提交请求
JobSubmitRequestBody requestBody = new JobSubmitRequestBody(
jobGraphBytes,
jobGraph.getJobID(),
jobGraph.getName());
// 3. 调用 REST API POST /jobs
return restClient.sendRequest(
webInterfaceURL,
JobSubmitHeaders.getInstance(),
requestBody)
.thenApply(response -> new JobSubmissionResult(response.getJobID()));
}
// 取消作业
@Override
public CompletableFuture<Acknowledge> cancel(JobID jobId) {
return restClient.sendRequest(
webInterfaceURL,
JobCancellationHeaders.getInstance(),
jobId);
}
// 查询作业状态
@Override
public CompletableFuture<JobStatus> getJobStatus(JobID jobId) {
return restClient.sendRequest(
webInterfaceURL,
JobStatusHeaders.getInstance(),
jobId)
.thenApply(response -> response.getJobStatus());
}
}
关键逻辑:
- submitJob 序列化 JobGraph,调用 POST /jobs REST API 提交
- cancel 调用 PATCH /jobs/{id}?mode=cancel 取消作业
- getJobStatus 调用 GET /jobs/{id} 查询作业状态
- 所有操作都是异步的,返回 CompletableFuture
- REST API 基于 Netty HTTP 客户端实现
五、任务提交完整链路
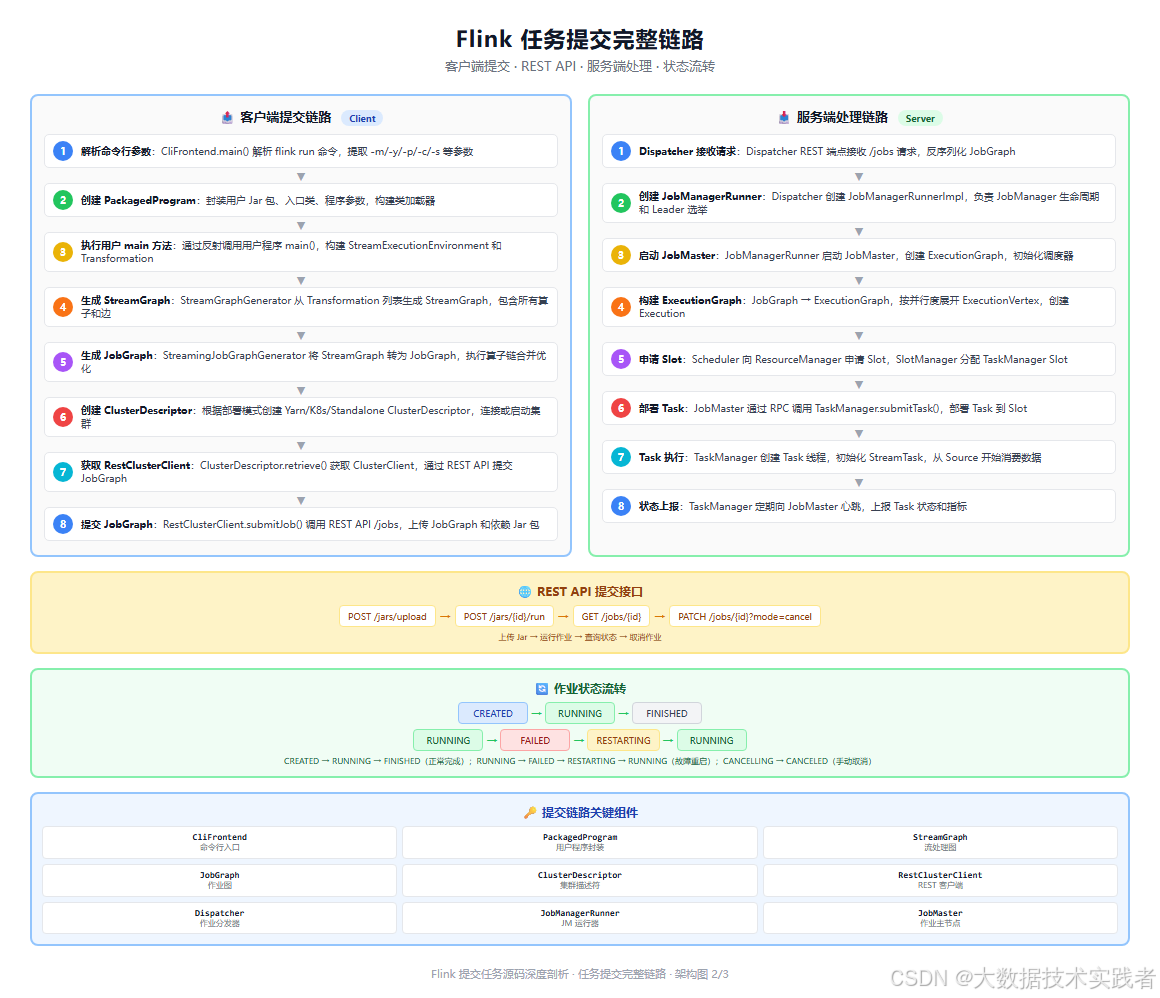
下面这张图是 Flink 任务提交完整链路,包括客户端提交8步、服务端处理8步、REST API、状态流转和关键组件。
5.1 客户端提交链路8步
以 flink run -m yarn-cluster -c com.example.MyJob ./my-job.jar 为例:
第1步:解析命令行参数
- CliFrontend.main() 入口
- parseAndRun 分发到 run 方法
- CommandLine 解析 -m(目标)、-y(YARN参数)、-p(并行度)、-c(入口类)、-s(保存点)等参数
第2步:创建 PackagedProgram
- 封装用户 Jar 包路径
- 确定入口类(-c 指定或从 MANIFEST.MF 读取)
- 构建 ChildFirstClassLoader 用户代码类加载器
第3步:执行用户 main 方法
- 通过反射调用用户程序 main(String[] args)
- 用户代码创建 StreamExecutionEnvironment
- 添加 Source、Transformation、Sink
- 调用 env.execute() 触发提交
第4步:生成 StreamGraph
- StreamGraphGenerator 遍历 Transformation 列表
- 递归转换每个 Transformation
- 生成 StreamNode(算子节点)和 StreamEdge(数据流边)
- StreamGraph 是逻辑执行计划
第5步:生成 JobGraph
- StreamingJobGraphGenerator 转换 StreamGraph
- 执行算子链合并优化(OperatorChain)
- 可链接的算子合并为一个 JobVertex
- JobGraph 是提交到集群的最终图
第6步:创建 ClusterDescriptor
- 根据部署模式(-m 参数)选择 CustomCommandLine
- YARN 模式创建 YarnClusterDescriptor
- K8s 模式创建 KubernetesClusterDescriptor
- Standalone 模式创建 StandaloneClusterDescriptor
第7步:获取 RestClusterClient
- Session 模式:retrieve 连接已有集群
- Per-Job/Application 模式:deploy 启动新集群
- 获取 ClusterClientProvider,再获取 RestClusterClient
第8步:提交 JobGraph
- RestClusterClient.submitJob(jobGraph)
- 序列化 JobGraph 为字节数组
- 调用 REST API POST /jobs 上传
- 返回 JobSubmissionResult(包含 JobID)
5.2 服务端处理链路8步
第1步:Dispatcher 接收请求
- Dispatcher 的 REST 端点接收 POST /jobs 请求
- 反序列化 JobGraph
- 验证作业配置
第2步:创建 JobManagerRunner
- Dispatcher 创建 JobManagerRunnerImpl
- JobManagerRunner 负责 JobManager 的生命周期
- 进行 Leader 选举(基于 ZooKeeper/K8s)
第3步:启动 JobMaster
- JobManagerRunner 启动 JobMaster
- JobMaster 是作业的主节点
- 初始化调度器、Checkpoint 协调器等
第4步:构建 ExecutionGraph
- JobMaster 将 JobGraph 转为 ExecutionGraph
- 按并行度展开为 ExecutionVertex
- 每个 ExecutionVertex 对应一个具体 Task
- 创建 Execution(任务执行实例)
第5步:申请 Slot
- Scheduler 向 ResourceManager 申请 Slot
- ResourceManager 的 SlotManager 分配 TaskManager Slot
- 建立 JobMaster 与 TaskManager 的连接
第6步:部署 Task
- JobMaster 通过 RPC 调用 TaskManager.submitTask()
- TaskManager 接收 Task 部署请求
- 在分配的 Slot 中创建 Task
第7步:Task 执行
- TaskManager 创建 Task 线程
- 初始化 StreamTask(SourceStreamTask/OneInputStreamTask等)
- 从 Source 开始消费数据
- 数据在算子链中流动处理
第8步:状态上报
- TaskManager 定期向 JobMaster 心跳
- 上报 Task 状态(RUNNING/FINISHED/CANCELED/FAILED)
- 上报指标(吞吐量、延迟、Checkpoint 状态)
- JobMaster 更新 ExecutionGraph 状态
5.3 REST API 接口
Flink 提供完整的 REST API 用于作业管理:
| /jars/upload | POST | 上传 Jar 包 |
| /jars/{id}/run | POST | 运行 Jar 包中的作业 |
| /jobs | GET | 列出所有作业 |
| /jobs/{id} | GET | 查询作业详情 |
| /jobs/{id} | PATCH | 取消作业(mode=cancel) |
| /jobs/{id}/savepoints | POST | 触发保存点 |
| /jobs/{id}/checkpoints | GET | 查询 Checkpoint 状态 |
| /jobs/{id}/metrics | GET | 查询作业指标 |
5.4 作业状态流转
Flink 作业有完整的状态机:
CREATED → RUNNING → FINISHED(正常完成)
RUNNING → FAILED → RESTARTING → RUNNING(故障重启)
RUNNING → CANCELLING → CANCELED(手动取消)
状态说明:
- CREATED:作业已创建,等待调度
- RUNNING:作业正在运行
- FINISHED:作业正常完成(批处理)
- FAILED:作业失败
- RESTARTING:作业重启中
- CANCELLING:作业取消中
- CANCELED:作业已取消
- SUSPENDED:作业挂起(JobManager 主备切换)
六、部署模式对比与配置参数
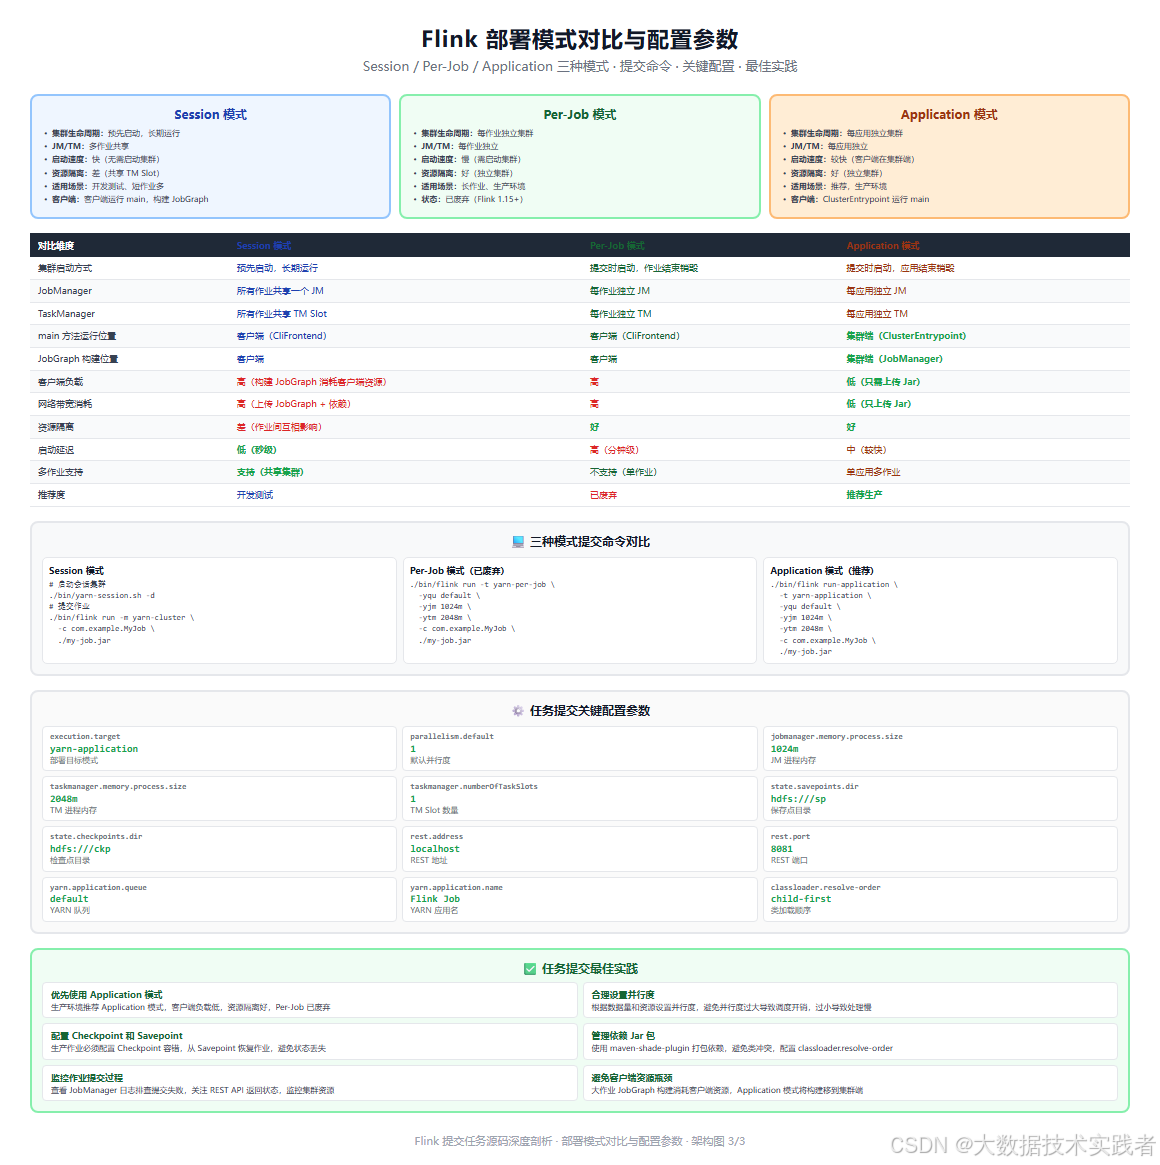
下面这张图是 Flink 部署模式对比与配置参数,包括三种模式对比、提交命令、关键配置和最佳实践。
6.1 三种部署模式对比
Flink 支持三种部署模式,各有适用场景:
| 集群生命周期 | 预先启动,长期运行 | 每作业独立集群 | 每应用独立集群 |
| JobManager | 所有作业共享 | 每作业独立 | 每应用独立 |
| TaskManager | 所有作业共享 Slot | 每作业独立 | 每应用独立 |
| main 方法运行位置 | 客户端 | 客户端 | 集群端(推荐) |
| JobGraph 构建位置 | 客户端 | 客户端 | 集群端 |
| 客户端负载 | 高 | 高 | 低 |
| 网络带宽消耗 | 高 | 高 | 低 |
| 资源隔离 | 差 | 好 | 好 |
| 启动延迟 | 低(秒级) | 高(分钟级) | 中(较快) |
| 多作业支持 | 支持 | 不支持 | 单应用多作业 |
| 推荐度 | 开发测试 | 已废弃 | 推荐生产 |
Session 模式:
- 预先启动一个长期运行的 Flink 集群
- 所有提交的作业共享这个集群的 JM 和 TM
- 优点:启动快(秒级),适合开发测试和大量短作业
- 缺点:资源隔离差,作业间互相影响,一个作业崩溃可能影响其他作业
- 客户端负载高:main 方法在客户端运行,构建 JobGraph 消耗客户端资源
Per-Job 模式:
- 每次提交作业都启动一个独立的 Flink 集群
- 作业结束后集群自动销毁
- 优点:资源隔离好,每个作业有独立的 JM 和 TM
- 缺点:启动慢(分钟级),需要等待集群启动
- 状态:Flink 1.15+ 已废弃,推荐使用 Application 模式
Application 模式:
- 每次提交应用启动一个独立的 Flink 集群
- main 方法在集群端(JobManager)运行,而不是客户端
- 优点:客户端负载低(只需上传 Jar),资源隔离好,网络带宽消耗少
- 缺点:启动需要一定时间(但比 Per-Job 快)
- 推荐:生产环境首选模式
6.2 三种模式提交命令
Session 模式:
# 启动会话集群(YARN)
./bin/yarn-session.sh -d -qu default -jm 1024m -tm 2048m
# 提交作业到已有会话集群
./bin/flink run \\
-m yarn-cluster \\
-p 4 \\
-c com.example.MyJob \\
./my-job.jar
Per-Job 模式(已废弃):
./bin/flink run \\
-t yarn-per-job \\
-yqu default \\
-yjm 1024m \\
-ytm 2048m \\
-p 4 \\
-c com.example.MyJob \\
./my-job.jar
Application 模式(推荐):
./bin/flink run-application \\
-t yarn-application \\
-yqu default \\
-yjm 1024m \\
-ytm 2048m \\
-p 4 \\
-c com.example.MyJob \\
./my-job.jar
关键参数:
- -t / -target:部署目标(yarn-session/yarn-per-job/yarn-application/kubernetes-session等)
- -p:并行度
- -c:入口类
- -s:从保存点恢复
- -yqu:YARN 队列
- -yjm:JobManager 内存
- -ytm:TaskManager 内存
- -ys:TaskManager Slot 数量
6.3 关键配置参数
flink-conf.yaml 中与任务提交相关的配置:
# 部署目标模式
execution.target: yarn–application
# 默认并行度
parallelism.default: 4
# JobManager 内存
jobmanager.memory.process.size: 1024m
# TaskManager 内存
taskmanager.memory.process.size: 2048m
# TaskManager Slot 数量
taskmanager.numberOfTaskSlots: 2
# 保存点目录
state.savepoints.dir: hdfs:///flink/savepoints
# 检查点目录
state.checkpoints.dir: hdfs:///flink/checkpoints
# REST 地址和端口
rest.address: localhost
rest.port: 8081
# YARN 队列
yarn.application.queue: default
# YARN 应用名
yarn.application.name: Flink Job
# 类加载顺序(child-first 避免类冲突)
classloader.resolve-order: child–first
# 类加载父级优先模式(排除某些类)
classloader.parent-first-patterns.default:
– "java."
– "scala."
– "org.apache.flink."
七、常见问题与最佳实践
7.1 常见问题
问题1:提交作业报 ClassNotFoundException
- 现象:提交作业后 JobManager 日志报 ClassNotFoundException
- 原因:用户依赖 Jar 未打包,或类加载顺序配置错误
- 解决:使用 maven-shade-plugin 打包所有依赖,或使用 -C 参数上传依赖 Jar,配置 classloader.resolve-order: child-first
问题2:提交作业报 JobGraph 构建失败
- 现象:客户端报错 “Could not build the JobGraph”
- 原因:用户代码有问题,Transformation 配置错误,算子链优化失败
- 解决:检查用户代码,查看完整异常栈,确认所有 Source/Sink 正确添加,检查并行度配置
问题3:Application 模式提交失败
- 现象:run-application 提交后集群启动失败
- 原因:Jar 包未上传到 HDFS,入口类配置错误,YARN 资源不足
- 解决:确认 Jar 包路径可访问,检查 -c 入口类是否正确,检查 YARN 队列资源是否充足
问题4:作业提交后一直处于 CREATED 状态
- 现象:作业提交后状态一直是 CREATED,不进入 RUNNING
- 原因:Slot 不足,TaskManager 未注册,资源申请失败
- 解决:检查 TaskManager 是否正常启动,检查 Slot 数量是否满足并行度需求,检查 ResourceManager 状态
问题5:从 Savepoint 恢复失败
- 现象:-s 参数指定保存点后恢复失败
- 原因:保存点路径错误,保存点与作业不兼容,状态后端配置不一致
- 解决:确认保存点路径正确可访问,检查作业算子 UID 是否与保存点一致,检查状态后端配置
7.2 最佳实践
推荐做法:
- 生产环境优先使用 Application 模式,客户端负载低,资源隔离好
- 合理设置并行度,根据数据量和资源调整,避免过大或过小
- 生产作业必须配置 Checkpoint 容错,配置 state.checkpoints.dir
- 重要作业配置 Savepoint,升级或迁移时从 Savepoint 恢复
- 使用 maven-shade-plugin 打包依赖,避免类冲突和 ClassNotFoundException
- 配置 classloader.resolve-order: child-first,用户代码类优先加载
- 为所有算子设置 UID(.uid(“source-kafka”)),确保 Savepoint 恢复时状态匹配
- 监控作业提交过程,查看 JobManager 日志排查问题
- 大作业使用 Application 模式,将 JobGraph 构建移到集群端,避免客户端资源瓶颈
避免的坑:
- 不要在客户端运行大作业的 main 方法(Session/Per-Job 模式),可能导致客户端 OOM
- 不要忘记设置算子 UID,否则 Savepoint 恢复时可能状态不匹配
- 不要混用不同版本的 Flink 客户端和集群,可能导致兼容性问题
- 不要在 main 方法中执行耗时操作(如读取大文件),应在算子中执行
- 不要忽略提交时的警告信息,可能预示潜在问题
- 不要在生产环境使用 Per-Job 模式(已废弃),改用 Application 模式
- 不要将大文件作为参数传递,应使用分布式缓存或文件系统
八、总结
Flink 提交任务源码级详解要点回顾:
第一,任务提交流程整体架构是理解提交过程的基础。分为四层:CLI 入口层(CliFrontend 解析命令、PackagedProgram 封装 Jar)、作业图构建层(StreamGraph → JobGraph → ExecutionGraph 三种图层层递进)、提交器层(ClusterDescriptor 连接集群、RestClusterClient 提交 JobGraph)、集群部署层(Dispatcher 接收请求、JobManagerRunner 启动、JobMaster 调度、TaskManager 执行)。
第二,CLI 入口源码揭示了提交的起点。CliFrontend.main() 是入口,parseAndRun 分发命令,run 方法完成8步核心流程:解析参数 → 创建 PackagedProgram → 执行用户 main → 生成 StreamGraph → 生成 JobGraph → 创建 ClusterDescriptor → 获取 RestClusterClient → 提交 JobGraph。PackagedProgram 用 Builder 模式构建,创建 ChildFirstClassLoader 避免类冲突,通过反射调用用户 main 方法。
第三,作业图构建源码是提交的核心。StreamExecutionEnvironment.execute() 触发图构建,StreamGraphGenerator 递归遍历 Transformation 列表生成 StreamNode 和 StreamEdge,StreamingJobGraphGenerator 执行算子链合并优化(isChainable 判断6个条件:单输入单输出、Forward分区、相同并行度、未禁用链、同一Slot组),可链接的算子合并为一个 JobVertex 减少网络传输。
第四,提交器源码连接客户端和集群。ClusterDescriptor 接口定义 deploySessionCluster/deployJobCluster/deployApplicationCluster/retrieve 方法,Yarn/K8s/Standalone 各有实现。RestClusterClient 通过 REST API 与集群通信,submitJob 序列化 JobGraph 调用 POST /jobs,cancel 调用 PATCH /jobs/{id},所有操作异步返回 CompletableFuture。
第五,任务提交完整链路是排查问题的关键。客户端8步:解析参数 → 创建PackagedProgram → 执行main → 生成StreamGraph → 生成JobGraph → 创建ClusterDescriptor → 获取RestClusterClient → 提交JobGraph。服务端8步:Dispatcher接收 → 创建JobManagerRunner → 启动JobMaster → 构建ExecutionGraph → 申请Slot → 部署Task → Task执行 → 状态上报。作业状态流转:CREATED→RUNNING→FINISHED,故障时FAILED→RESTARTING→RUNNING。
第六,部署模式对比是选型的依据。Session 模式共享集群启动快但隔离差,适合开发测试;Per-Job 模式每作业独立集群隔离好但启动慢,已废弃;Application 模式 main 在集群端运行,客户端负载低、隔离好、带宽消耗少,是生产推荐。关键配置包括 execution.target、parallelism.default、JM/TM 内存、Slot 数量、Checkpoint/Savepoint 目录、类加载顺序等。
第七,常见问题与最佳实践是生产经验的总结。常见问题包括 ClassNotFoundException(依赖打包)、JobGraph 构建失败(用户代码)、Application 模式失败(Jar/资源)、CREATED 状态不运行(Slot不足)、Savepoint 恢复失败(UID不匹配)。最佳实践:优先 Application 模式、合理并行度、配置 Checkpoint/Savepoint、maven-shade 打包、child-first 类加载、设置算子 UID、监控提交过程。
理解 Flink 任务提交源码,不仅能帮助排查线上提交失败问题,更能体会到分层架构、命令模式、访问者模式、动态代理等经典设计模式在分布式系统中的应用。从客户端到服务端的完整链路,每一层都有清晰的职责边界和扩展点,这也是 Flink 能够支持多种部署模式和资源管理器的架构基础。


评论前必须登录!
注册