 网硕互联帮助中心
同步 vs 异步:Python 并发爬虫实战
写 Python 的第十五年,我被问得最多的问题之一就是:"我写的爬虫跑 100 个页面要 100 秒,怎么能快点?"答案就是异步。但很多人一听"异步"两个字就头大,觉得是高级概念、是大佬才玩的东西。
其实没那么玄乎。这篇文章我用最直白的方式讲清楚:为什么异步快、怎么写、有哪些坑。下面的代码我都在本机真实跑过,截图也是真的,不是我瞎编的数字。
一、为什么需要异步爬虫
先想一个问题:你写爬虫的时候,时间都花在哪了?
不是花在你的 Python 代码上——你的代码跑起来毫秒级就完事了。真正的时间花在等网络响应上。你发一个 HTTP 请求,然后坐在那里等服务器回你,这一等就是几百毫秒到几秒。这段时间你的 CPU 啥也没干,就在那干等。
这就是典型的 IO 密集型任务。CPU 很闲,一直在等网络。这种场景,异步就是为它而生的。
举个现实的例子:你去奶茶店买奶茶,点完单之后,你是站在收银台前面等(同步),还是先去旁边坐着刷手机,等叫号了再回来拿(异步)?
同步就是前者:一次只能做一件事,做完一件才能做下一件。异步就是后者:点完单之后你不傻站着,去干别的,等好了再回来取。
二、同步爬虫长什么样
同步写法是最直觉的,也是大多数人一开始写的样子:
import time
import requests
N = 20
URL = "https://httpbin.org/delay/1" # 模拟1秒延迟的接口
def sync_crawl():
start = time.perf_counter()
for i in range(N):
r = requests.get(URL)
print(f"[{i+1:2d}] status={r.status_code}")
t = time.perf_counter() – start
print(f"同步耗时: {t:.2f} 秒")
if __name__ == "__main__":
sync_crawl()
这个代码的逻辑很简单:循环 20 次,每次发一个请求,等响应回来,再发下一个。每个请求延迟 1 秒,20 个就是 20 秒。
我把它简化成纯 sleep 版本跑了一下,结果是这样的:
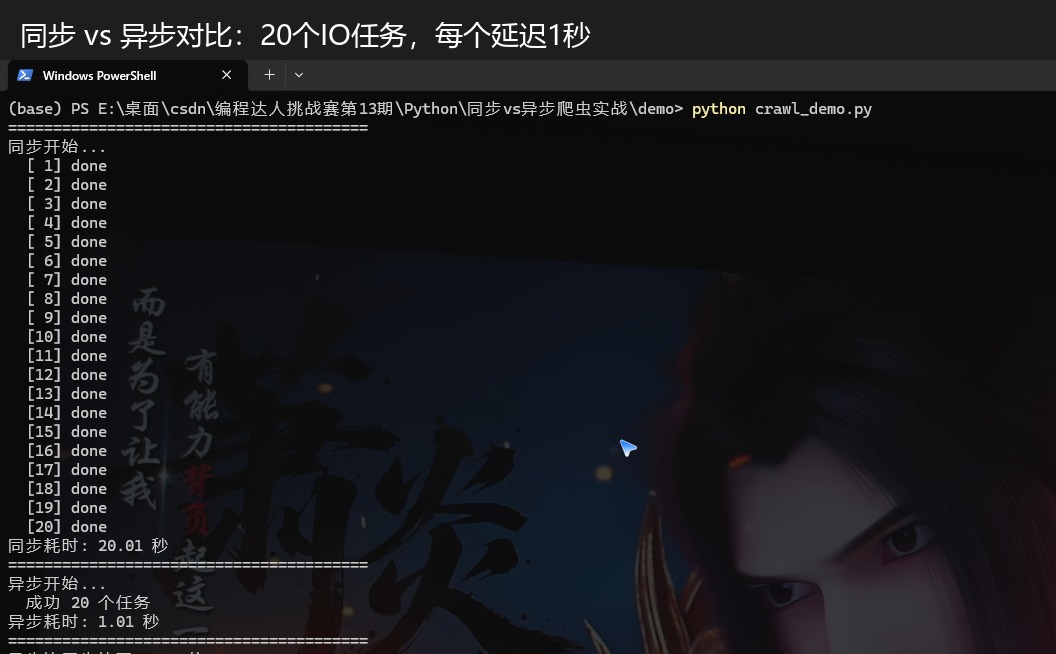
看到了吧?同步跑 20 个任务,花了 20.01 秒。一个一个来,谁也不等谁,串行执行。
三、异步爬虫长什么样
异步写法就完全不一样了。核心思路是:发请求之后不傻等,去发下一个请求,等响应回来了再处理。
先看代码:
import asyncio
import aiohttp
N = 20
URL = "https://httpbin.org/delay/1"
async def async_fetch(session, i):
async with session.get(URL) as r:
return i, r.status
async def async_crawl():
start = time.perf_counter()
async with aiohttp.ClientSession() as session:
tasks = [async_fetch(session, i) for i in range(N)]
results = await asyncio.gather(*tasks)
print(f"成功 {len(results)} 个任务")
t = time.perf_counter() – start
print(f"异步耗时: {t:.2f} 秒")
if __name__ == "__main__":
asyncio.run(async_crawl())
几个关键字解释一下:
- async:声明这是一个协程函数,不是普通函数
- await:遇到这个关键词,就"挂起"当前任务,去跑别的
- asyncio.gather:把一堆协程打包成一个,一起跑
- aiohttp:异步版的 requests,不能用普通的 requests(后面讲为什么)
我跑了一下,结果是:异步耗时 1.01 秒。
20 个任务,每个延迟 1 秒,同步要 20 秒,异步只要 1 秒——快了 19.9 倍。
四、为什么异步这么快?原理讲透
很多人学异步,只会写代码,不知道原理。我用最通俗的话讲清楚。
4.1 事件循环(Event Loop)
你可以把事件循环理解成一个调度器。它负责:
这就像你在奶茶店:点完单(发请求),店员开始做(服务器处理),你不傻站着等,先去刷手机(去跑下一个任务)。等店员叫号了(响应回来了),你再过去拿(处理结果)。
4.2 协程(Coroutine)
协程就是那个"可以暂停的函数"。普通函数一旦开始跑,就一口气跑到结束,中间不能停。协程不一样:它跑到一半可以暂停(await),让出 CPU 给别人用,等条件好了再回来接着跑。
4.3 关键:为什么不是多线程?
有人会问:那多线程不也能并发吗?为什么要用异步?
问得好。多线程确实能并发,但有几个问题:
- 线程切换有开销,1000 个线程开销就很大了
- Python 有 GIL,CPU 密集型任务多线程根本快不起来
- 多线程写起来麻烦,还要考虑锁、竞态条件
异步就不一样:
- 单线程就能跑几千个协程,开销极小
- 没有锁的问题(因为是单线程,不存在竞态)
- 代码写起来更干净(虽然刚开始有点别扭)
记住:IO 密集型用异步,CPU 密集型用多进程。这是铁律。
五、这些坑我替你踩过了
5.1 坑一:用了同步阻塞库
这是最常见的坑。你写了个异步函数,里面却用 requests 发请求——结果比同步还慢。
为什么?因为 requests 是同步库,它发请求的时候会阻塞整个线程。也就是说,你虽然写了 await,但这个 await 根本不会让出控制权——requests 在那死等,事件循环也没法跑别的任务。
解决办法:用异步版的库:
- requests → aiohttp
- time.sleep() → asyncio.sleep()
- open() → aiofiles
记住:异步代码里不能出现同步阻塞调用,这是铁律。
5.2 坑二:并发数失控
很多人学了异步就放飞自我:“我要并发 1000 个请求!”——结果服务器直接把你封了。
为什么?因为网站都有反爬机制:你短时间发太多请求,服务器就认为你是爬虫,直接封你 IP。
解决办法:控制并发数。用 asyncio.Semaphore:
sem = asyncio.Semaphore(10) # 最多同时跑10个
async def async_fetch(session, i):
async with sem: # 加信号量
async with session.get(URL) as r:
return i, r.status
这样不管你有多少任务,最多同时跑 10 个,不会把服务器搞崩。
5.3 坑三:忘了限流
就算你控制了并发数,也别忘了加延迟。不能上一个请求刚回来,下一个立刻就发——太规律了,很容易被反爬识别。
加个随机延迟:
import random
async def async_fetch(session, i):
async with sem:
await asyncio.sleep(random.uniform(0.5, 1.5)) # 随机延迟0.5-1.5秒
async with session.get(URL) as r:
return i, r.status
这样请求间隔不规律,更像真人。
六、给你一个能直接抄的完整模板
折腾了这么多,我整理了一个生产可用的异步爬虫模板,你改改 URL 就能用:
import asyncio
import aiohttp
import random
import time
# 配置
URLS = [f"https://example.com/page/{i}" for i in range(100)]
CONCURRENCY = 10 # 并发数
TIMEOUT = 10 # 超时秒数
RETRY = 3 # 重试次数
async def fetch(session, url, sem):
"""异步请求单个URL,带重试和限流"""
for attempt in range(RETRY):
try:
async with sem:
await asyncio.sleep(random.uniform(0.1, 0.5)) # 随机延迟
async with session.get(url, timeout=TIMEOUT) as r:
if r.status == 200:
return url, await r.text()
else:
return url, f"HTTP {r.status}"
except Exception as e:
if attempt == RETRY – 1:
return url, f"Error: {e}"
await asyncio.sleep(1) # 失败后等1秒再重试
async def main():
sem = asyncio.Semaphore(CONCURRENCY)
start = time.perf_counter()
async with aiohttp.ClientSession() as session:
tasks = [fetch(session, url, sem) for url in URLS]
results = await asyncio.gather(*tasks)
# 统计成功失败
success = sum(1 for _, r in results if not str(r).startswith(("Error", "HTTP")))
print(f"成功: {success}/{len(results)}")
print(f"耗时: {time.perf_counter() – start:.2f} 秒")
if __name__ == "__main__":
asyncio.run(main())
这个模板包含了:并发控制、随机延迟、超时、失败重试。直接改 URLS 列表就能用。
七、总结:什么时候该用异步
最后总结一下,异步不是万能药,什么时候该用?
该用异步的场景:
- 爬虫(发 HTTP 请求等响应)
- 调 API(等接口返回)
- 读写文件 / 数据库(IO 操作)
- 任何"大部分时间在等"的任务
不该用异步的场景:
- 纯计算(比如跑机器学习、数据处理)——用多进程
- 代码量很少的小脚本——没必要,同步写起来更简单
- 团队里没人懂异步——别为了炫技而用,维护成本高
记住:异步是为了榨干 IO 等待时间,不是为了炫技。如果你写的代码大部分时间都在等网络、等磁盘、等数据库,那就用异步。如果大部分时间在算数学、处理数据,那就别碰异步,用多进程更合适。
我见过太多人,上来就给一个纯计算脚本套异步,结果跑得更慢——因为异步切换协程也是有开销的。别跟风,想清楚你的瓶颈在哪。
你写爬虫的时候用过异步吗?遇到过什么奇葩坑?评论区聊聊,我看看能不能帮你解决。
来更简单
- 团队里没人懂异步——别为了炫技而用,维护成本高
记住:异步是为了榨干 IO 等待时间,不是为了炫技。如果你写的代码大部分时间都在等网络、等磁盘、等数据库,那就用异步。如果大部分时间在算数学、处理数据,那就别碰异步,用多进程更合适。
我见过太多人,上来就给一个纯计算脚本套异步,结果跑得更慢——因为异步切换协程也是有开销的。别跟风,想清楚你的瓶颈在哪。
你写爬虫的时候用过异步吗?遇到过什么奇葩坑?评论区聊聊,我看看能不能帮你解决。


评论前必须登录!
注册