 网硕互联帮助中心
✨作者主页:IT毕设梦工厂✨ 个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。 ☑文末获取源码☑ 精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目
文章目录
- 一、前言
- 二、开发环境
- 三、系统界面展示
- 四、部分代码设计
- 五、论文参考
- 六、系统视频
- 结语
一、前言
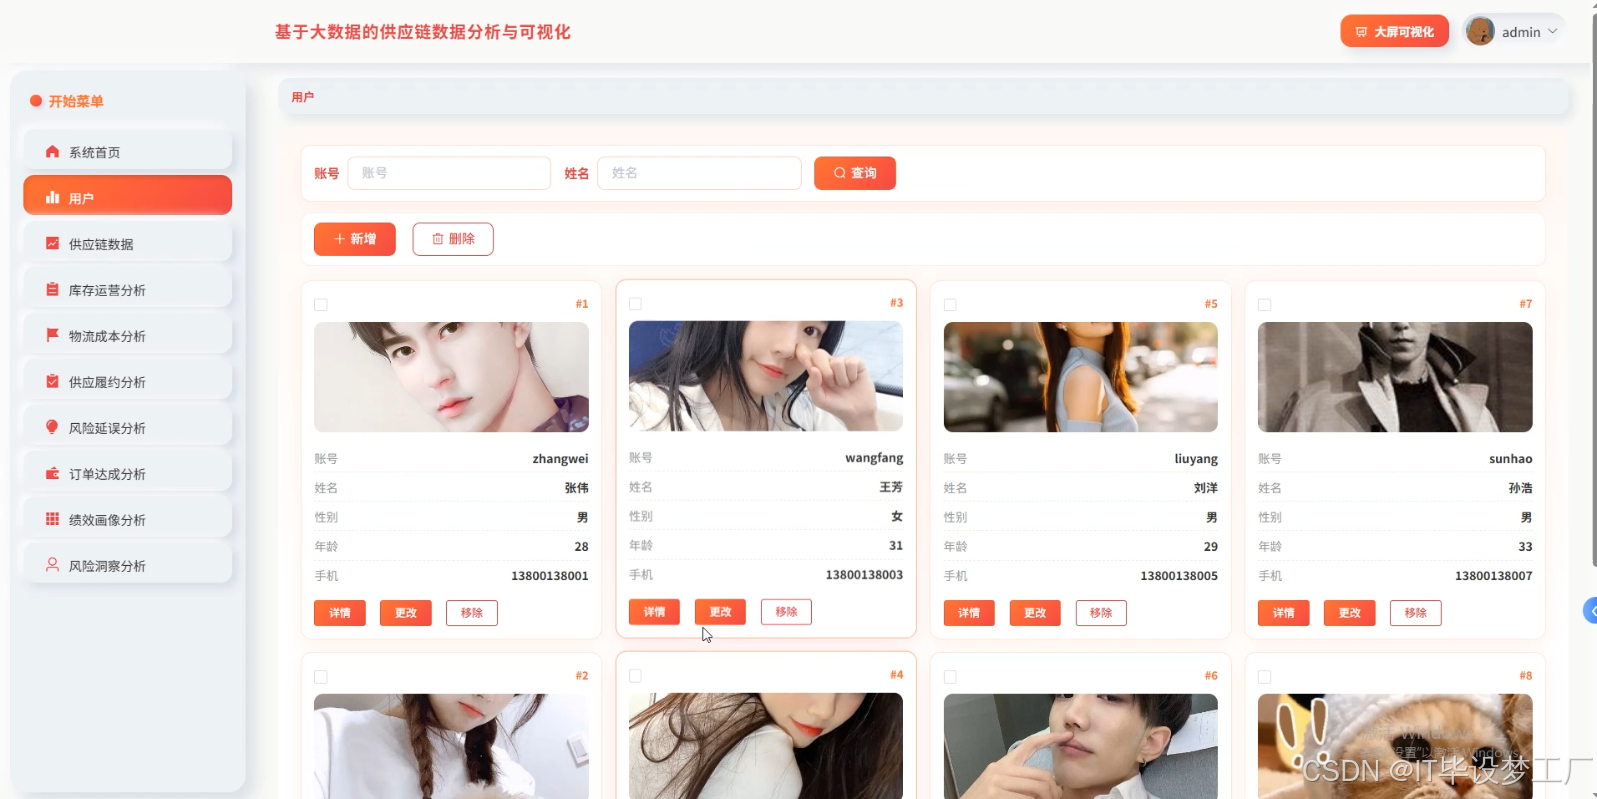
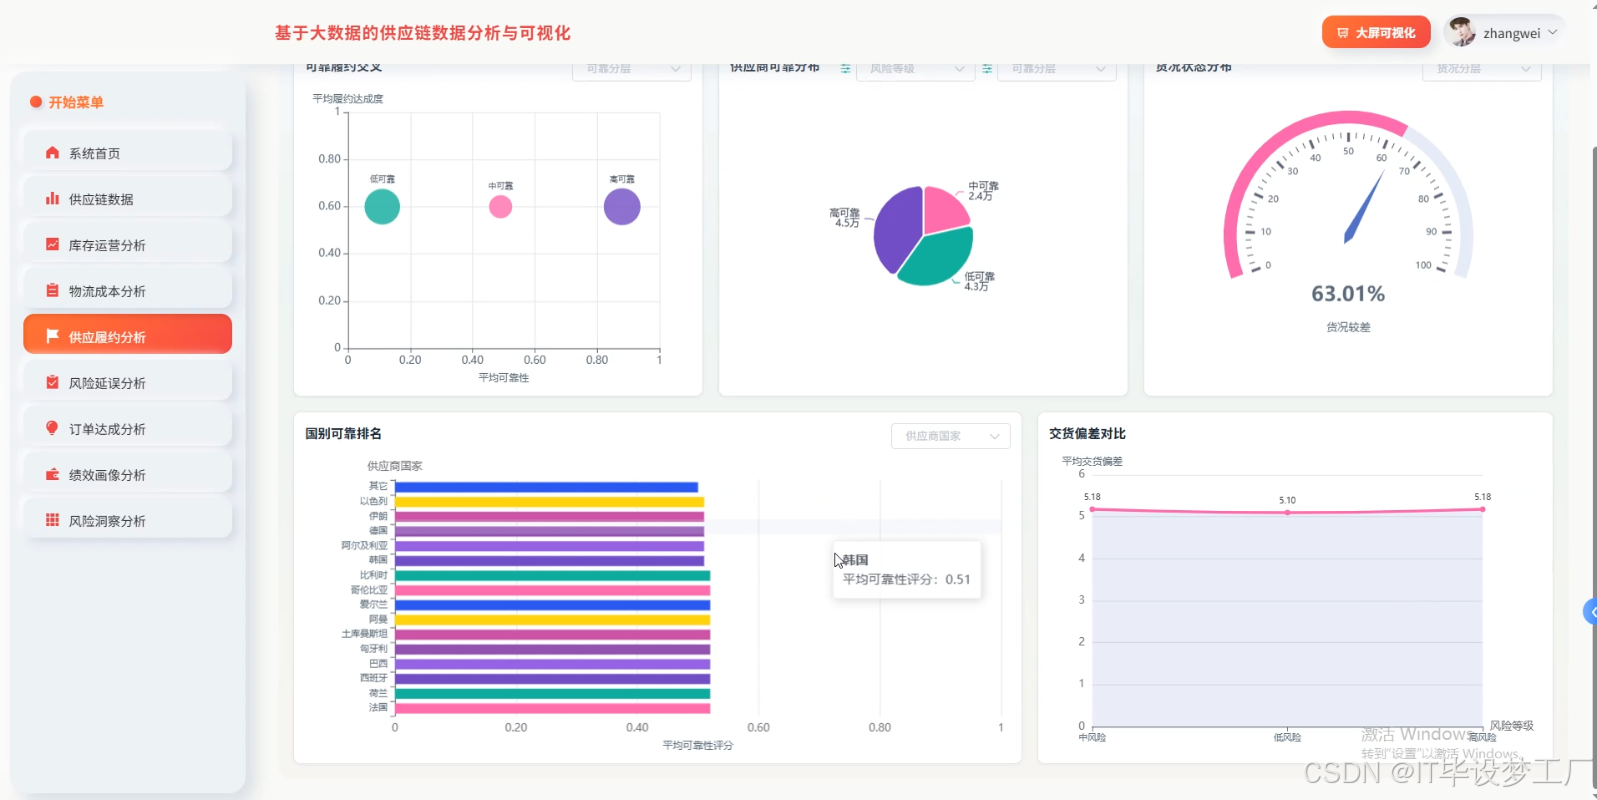
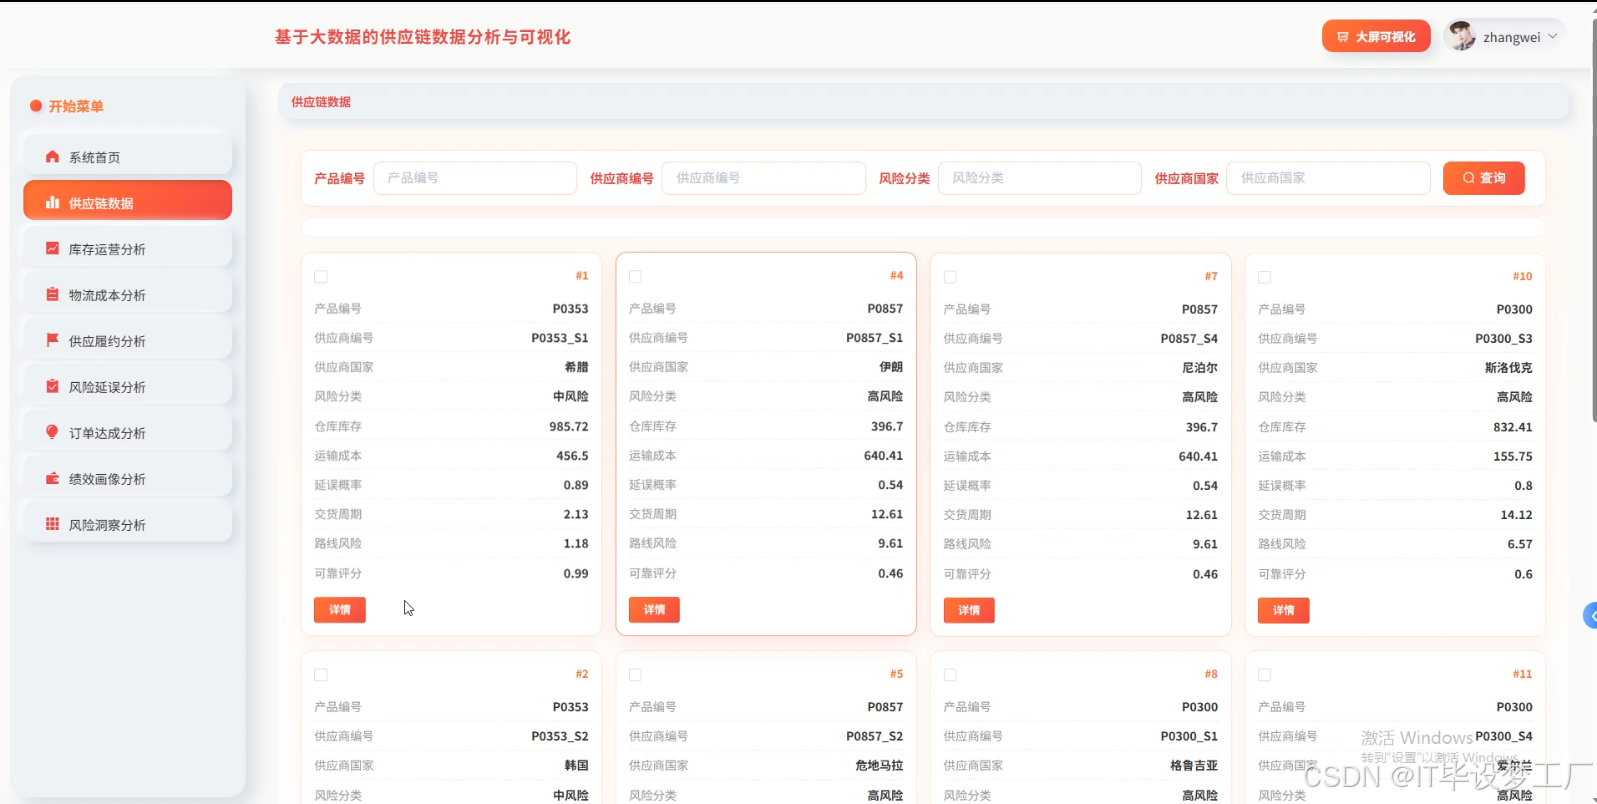
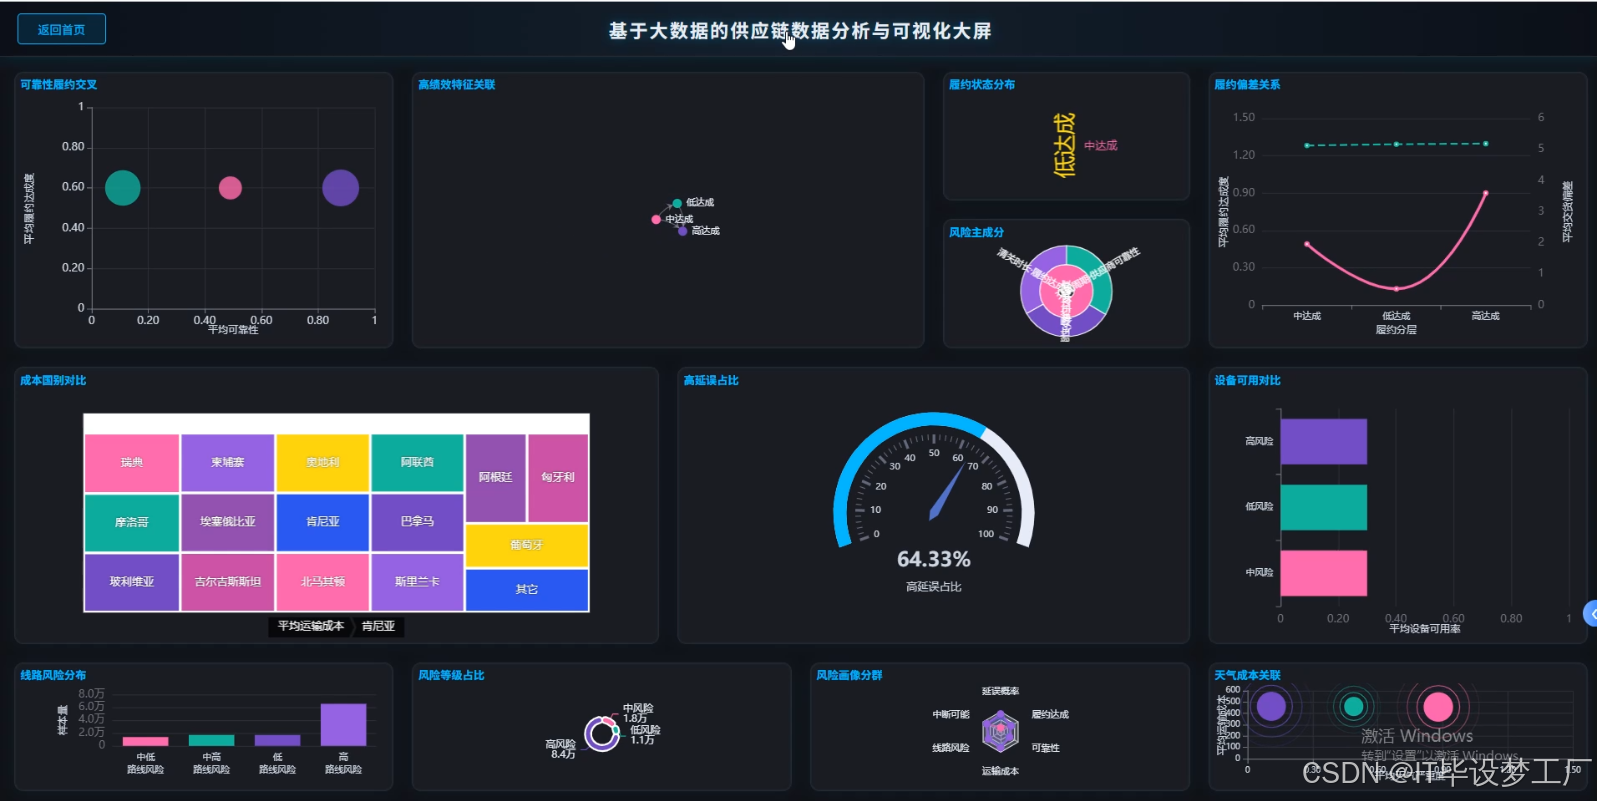
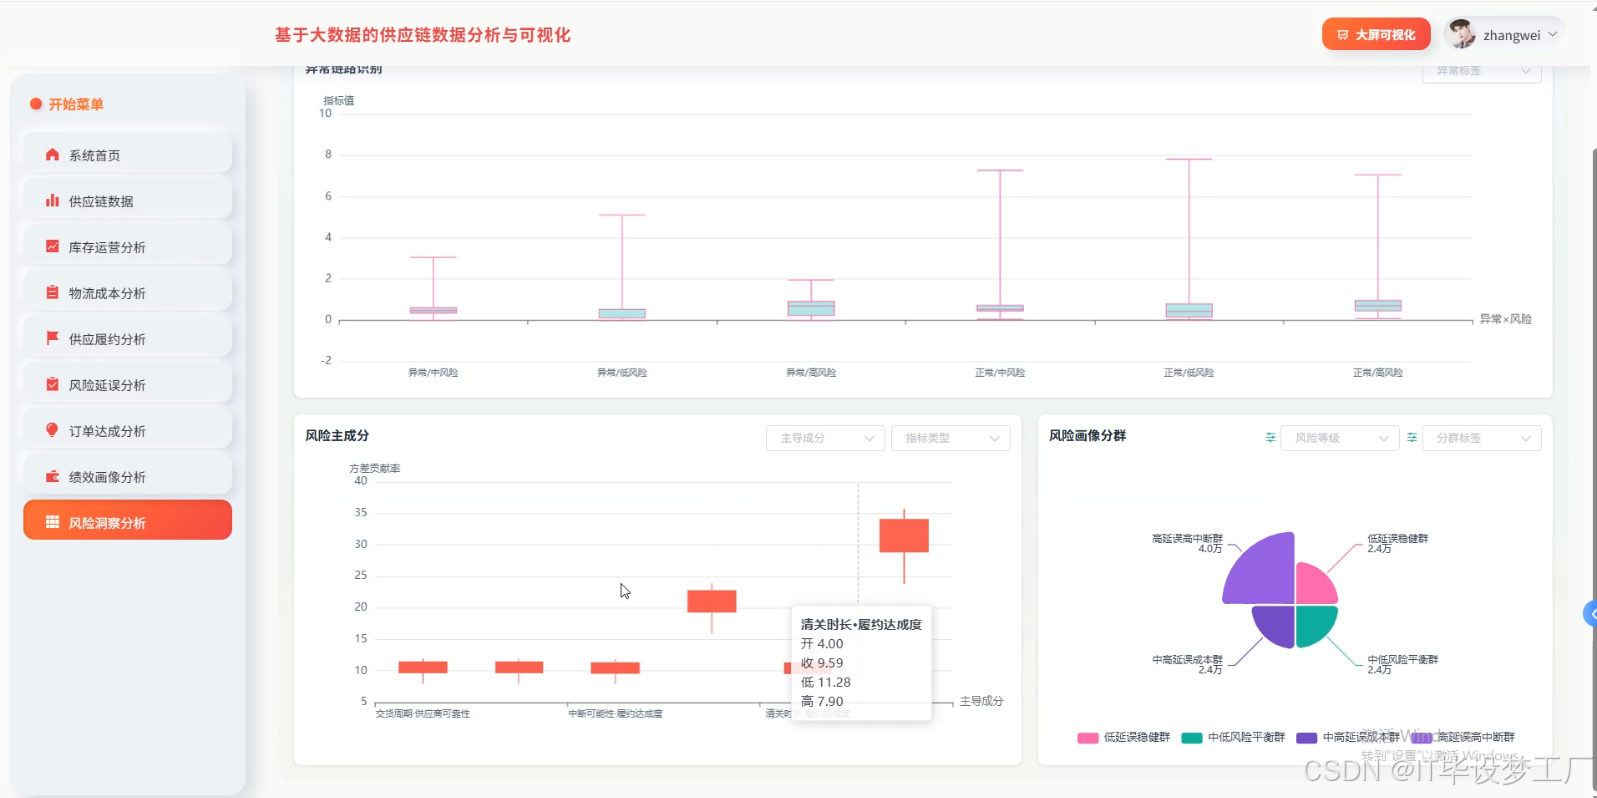
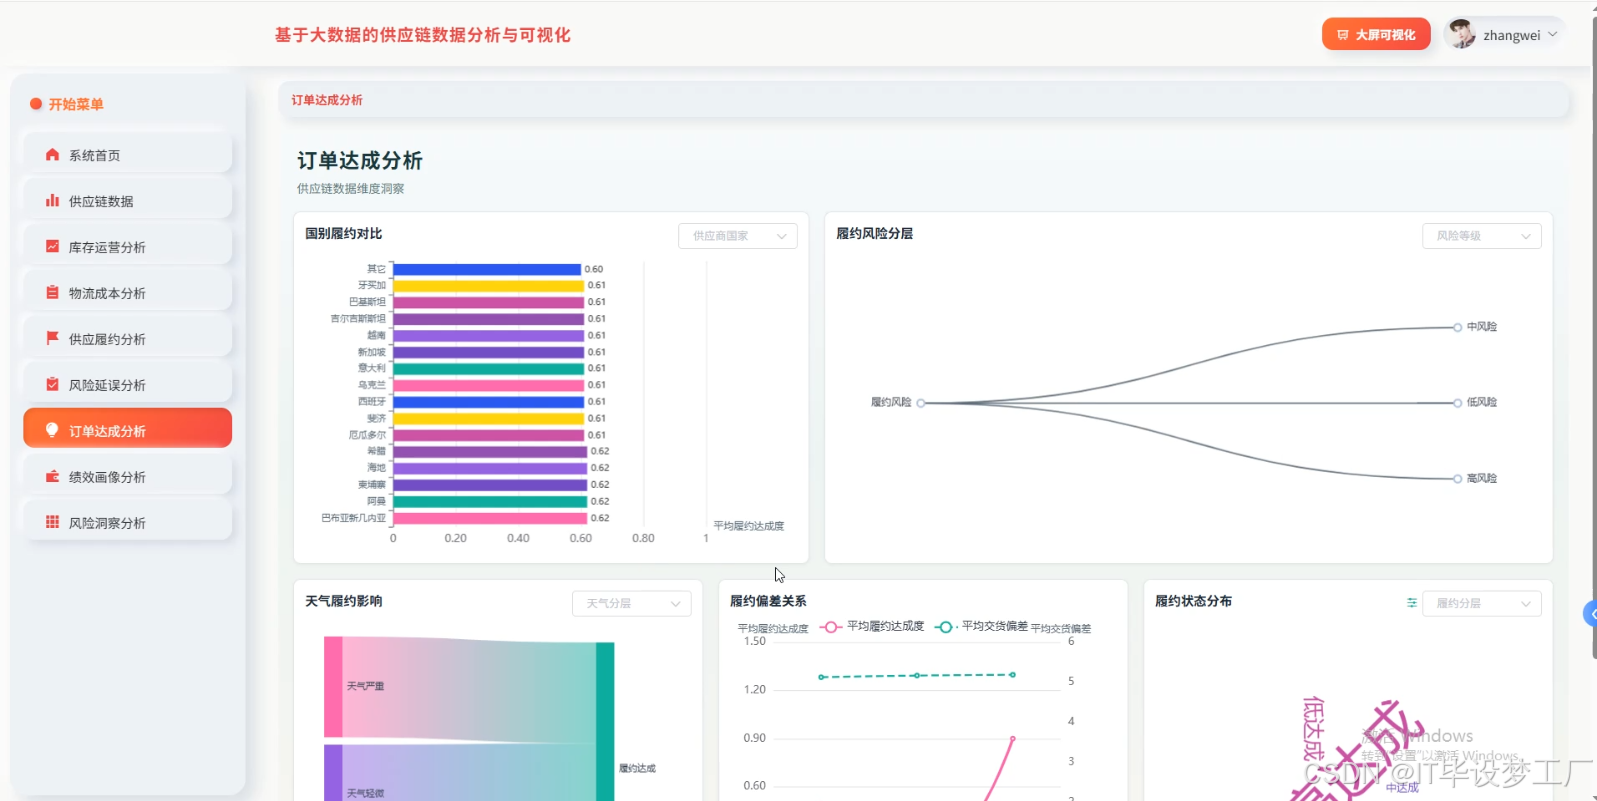
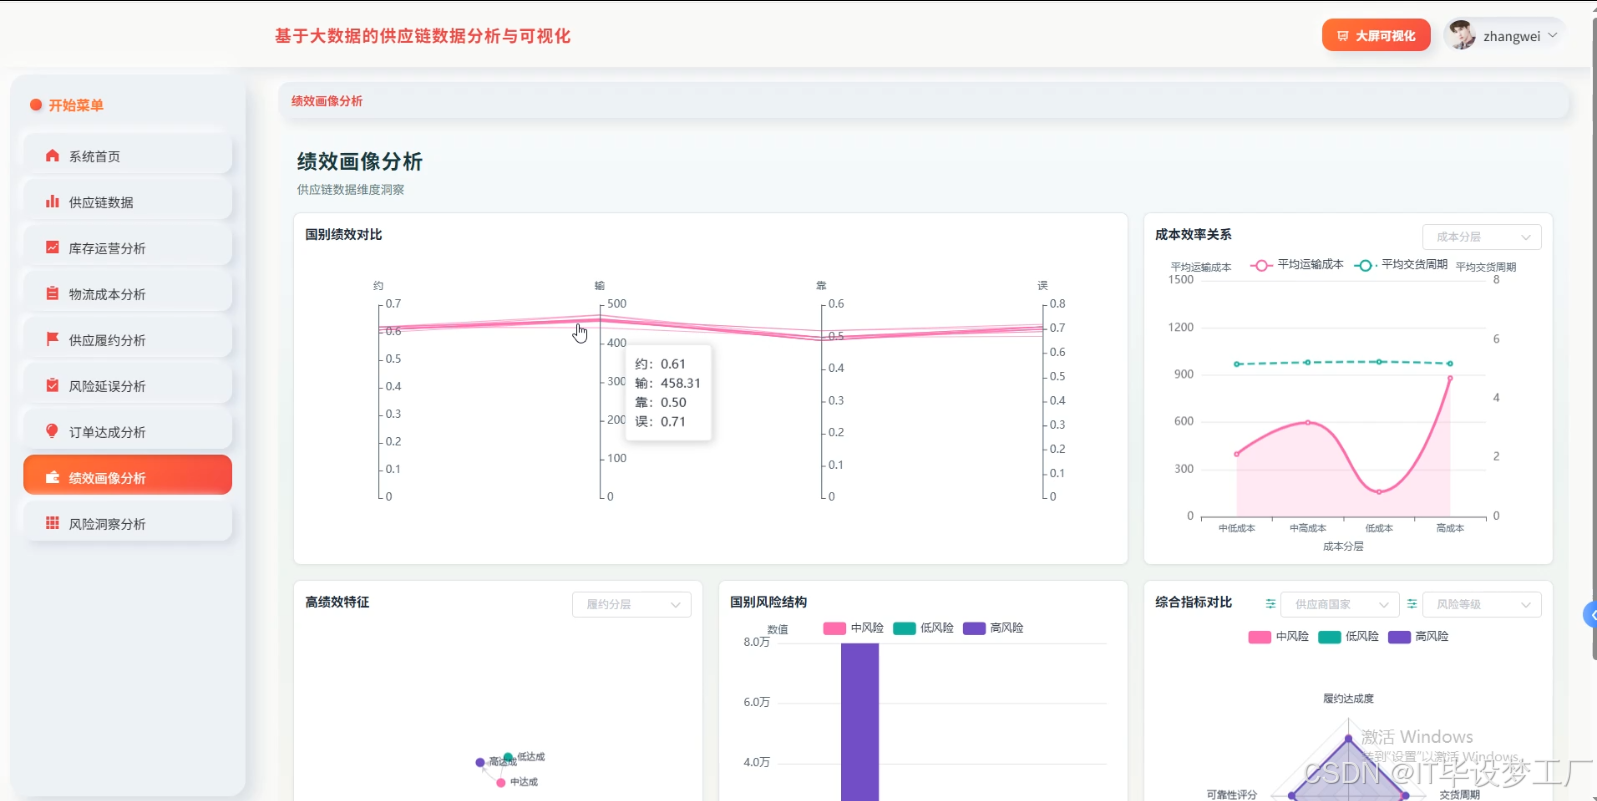
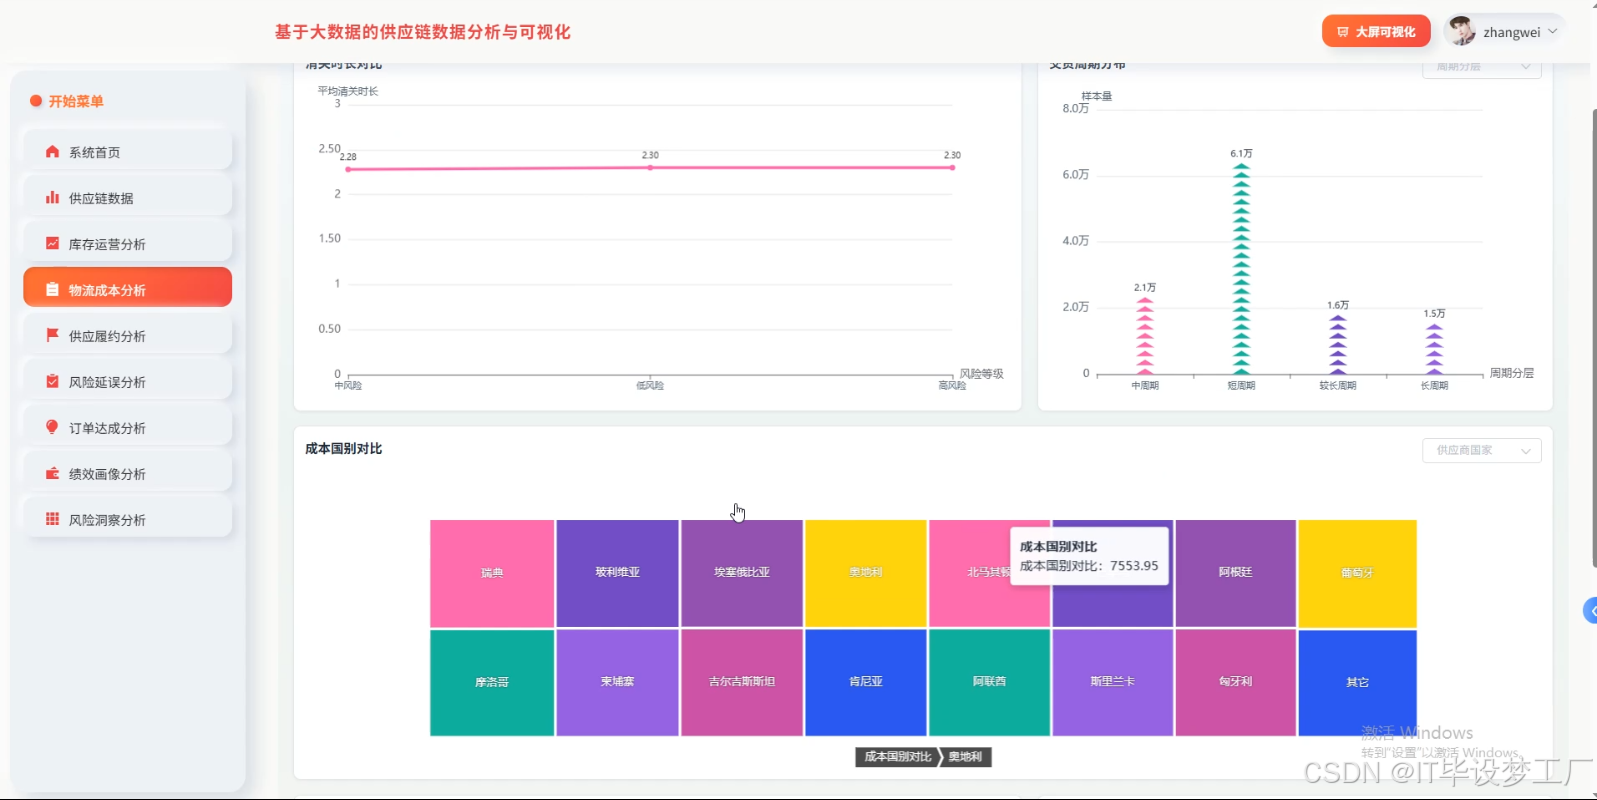
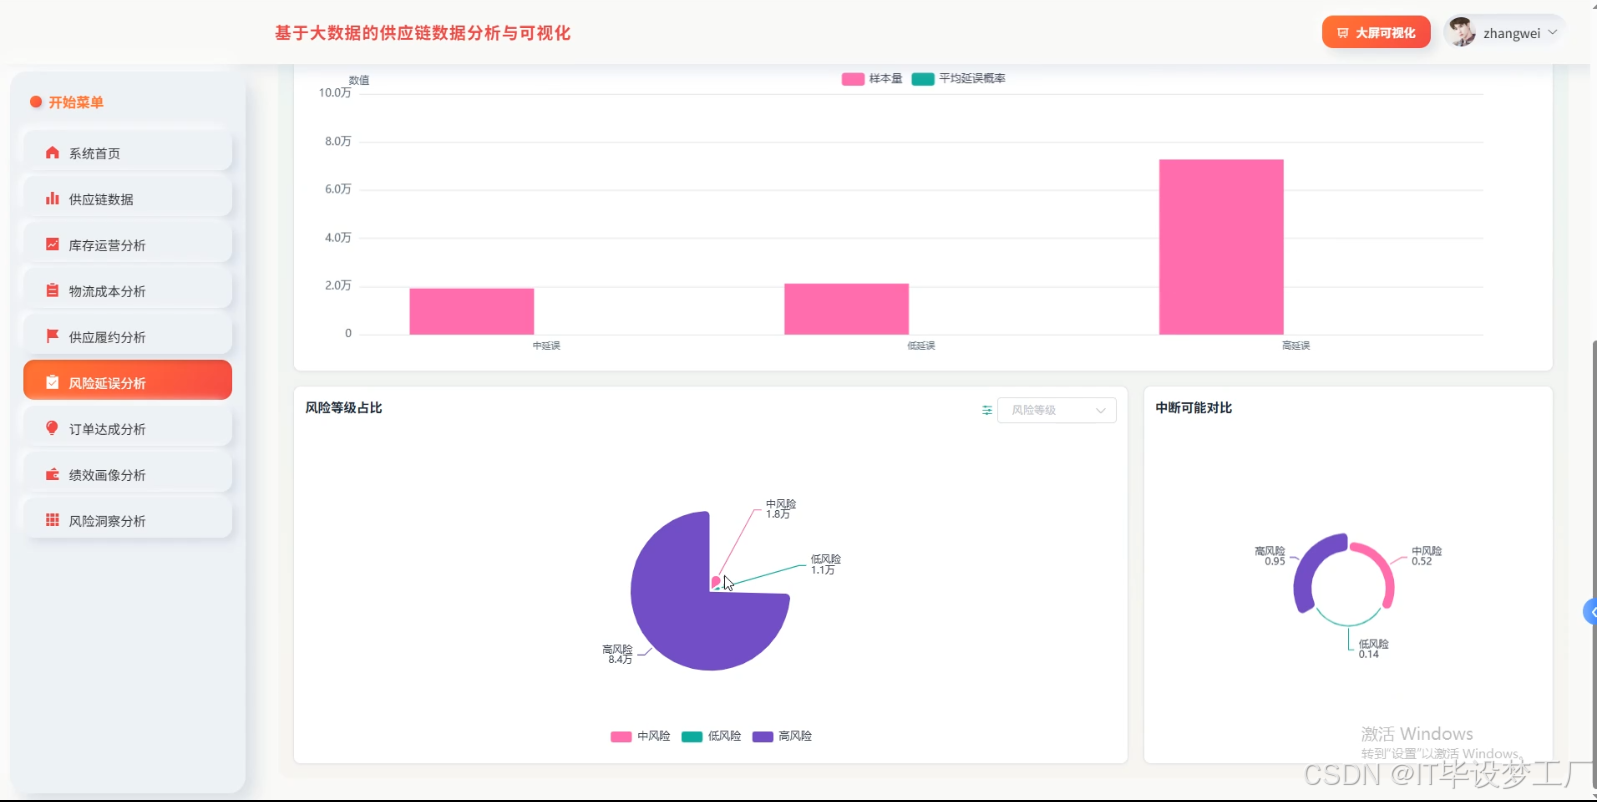
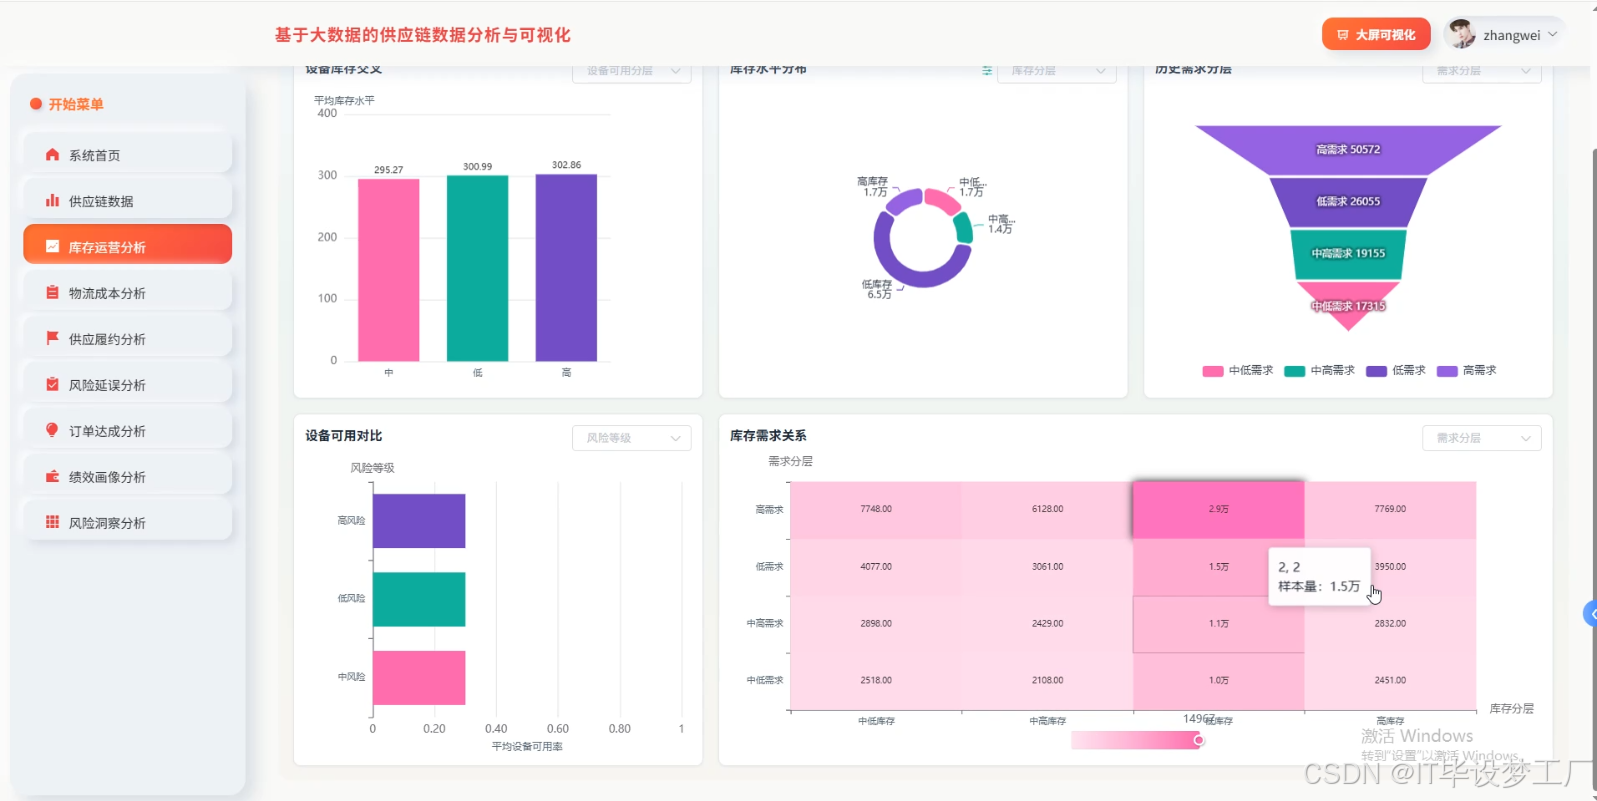
本系统名为《基于大数据的供应链数据分析与可视化》,主要面向供应链场景下的多源数据管理与分析需求,采用Hadoop与Spark作为大数据处理框架,结合HDFS进行数据存储,利用Spark SQL、Pandas与NumPy完成数据清洗、统计分析与指标计算,后端可选Python+Django或Java+Spring Boot实现业务接口与权限控制,前端使用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery完成页面交互与图表展示,数据库采用MySQL保存用户信息与业务数据。系统功能涵盖系统首页、大屏可视化、用户管理、供应链数据管理、库存运营分析、物流成本分析、供应履约分析、风险延误分析、订单达成分析、绩效画像分析、风险洞察分析、个人信息与修改密码等模块。通过对供应链数据的大数据处理与可视化呈现,系统能够把库存、物流、履约、订单、风险等环节的关键指标以图表和大屏形式直观展示,帮助使用者快速了解供应链运行状态,适合作为计算机专业毕业设计选题进行设计与实现。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制) 开发语言:Python+Java(两个版本都支持) 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持) 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy 数据库:MySQL
三、系统界面展示
- 基于大数据的供应链数据分析与可视化系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, avg, count, when, desc
spark = SparkSession.builder.appName("SupplyChainAnalysis").enableHiveSupport().getOrCreate()
def inventory_operation_analysis(request):
df = spark.read.format("csv").option("header", True).load("hdfs:///supplychain/inventory.csv")
df_clean = df.dropna().filter(col("stock_qty") >= 0)
result = df_clean.groupBy("warehouse_id").agg(sum("stock_qty").alias("total_stock"), avg("turnover_rate").alias("avg_turnover"), count("sku_id").alias("sku_count"))
result = result.withColumn("stock_status", when(col("avg_turnover") < 0.3, "滞销").when(col("avg_turnover") > 1.0, "畅销").otherwise("正常"))
data = result.orderBy(desc("total_stock")).limit(100).toPandas().to_dict("records")
return JsonResponse({"code": 200, "data": data})
def logistics_cost_analysis(request):
df = spark.read.format("csv").option("header", True).load("hdfs:///supplychain/logistics.csv")
df_clean = df.dropna().filter(col("cost") > 0)
result = df_clean.groupBy("route_id", "carrier_id").agg(sum("cost").alias("total_cost"), avg("cost").alias("avg_cost"), count("order_id").alias("order_count"))
result = result.withColumn("cost_level", when(col("avg_cost") > 500, "高成本").when(col("avg_cost") < 100, "低成本").otherwise("中等成本"))
data = result.orderBy(desc("total_cost")).limit(100).toPandas().to_dict("records")
return JsonResponse({"code": 200, "data": data})
def risk_delay_analysis(request):
df = spark.read.format("csv").option("header", True).load("hdfs:///supplychain/delivery.csv")
df_clean = df.dropna().filter(col("delay_days") >= 0)
result = df_clean.groupBy("supplier_id", "order_id").agg(avg("delay_days").alias("avg_delay"), sum("delay_days").alias("total_delay"), count("order_id").alias("delay_count"))
result = result.withColumn("risk_level", when(col("avg_delay") > 7, "高风险").when(col("avg_delay") > 3, "中风险").otherwise("低风险"))
data = result.orderBy(desc("avg_delay")).limit(100).toPandas().to_dict("records")
return JsonResponse({"code": 200, "data": data})
五、论文参考
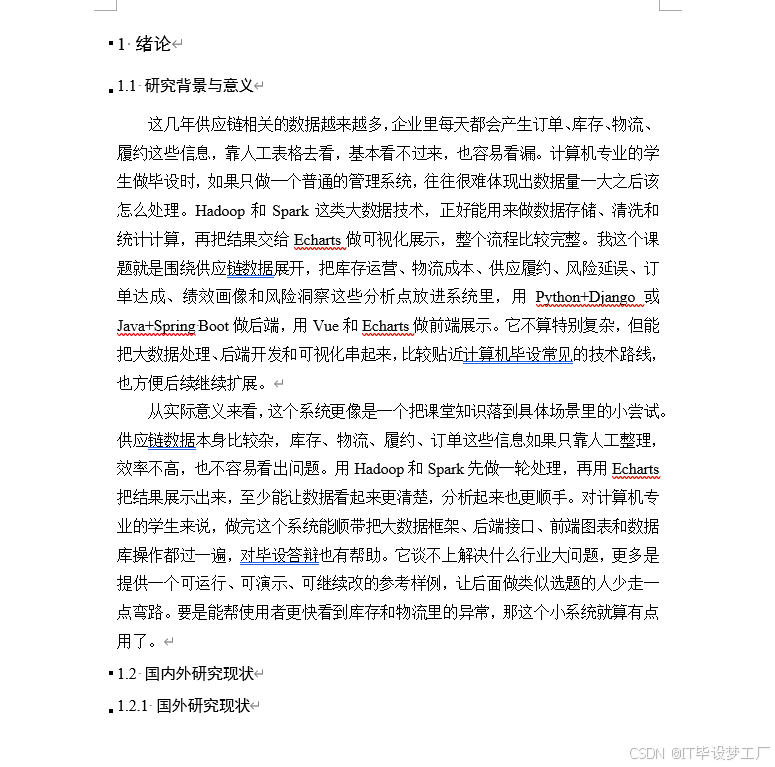
- 计算机毕业设计选题推荐-基于大数据的供应链数据分析与可视化系统-论文参考:
六、系统视频
- 基于大数据的供应链数据分析与可视化系统-项目视频: 项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的供应链数据分析与可视化|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目 大家可以帮忙点赞、收藏、关注、评论啦~ 源码获取:⬇⬇⬇
精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目


评论前必须登录!
注册