 网硕互联帮助中心
LeetCode 94. 二叉树的中序遍历
个人主页:
> 我不会起名字322 < (欢迎各位大佬莅临😊)
其他栏目:
> 技术栈学习笔记 <
其他栏目:
> 力扣Hot100题目解析 <
其他栏目:
> Go项目学习笔记 <
前言:
前面的回溯系列里,我们一直在强调"三要素"——路径、选择列表、结束条件。但算法题不是只有回溯一种套路。从今天开始,我们换一条线,专门聊二叉树。
二叉树题有个特点:代码极短,但递归逻辑极其密集。一道题可能只有五六行,但每一行都在做递归调用,如果对"递归到底在干什么"没有直觉,看代码就像看天书。所以这个系列的第一篇,我们不急着刷难题,先把遍历这个最基础、也最核心的骨架吃透。中序遍历是理解二叉树递归的入口——把它想清楚了,前序、后序只是换个位置的事,后面的层序遍历、路径求和、最近公共祖先也都是在这个骨架上长出来的。
首先我们说二叉树的递归到底是干了什么事:递归是一种"分而治之"的策略;当你把一棵树拆成"根 + 左子树 + 右子树",并且发现左子树和右子树又是同样结构的树时,递归就自然出现了。遍历题用递归访问每个节点,并在访问时收集答案。这道题稍微特殊一点——我们不是"在每个节点处都做同一件事",而是在左子树和右子树之间插入"访问根"的动作,这个插入位置的不同,直接决定了是前序、中序还是后序。
递归的终止条件,这是二叉树递归要看的第一个数据。这道题的终止条件就是当前节点为空。空节点不是"没有节点",而是递归的"地基"——没有它,递归就会无限往下走。所以每个递归函数的第一行,几乎都是 if node == nil { return }。
当前节点要做什么,这是二叉树递归要看的第二个数据。中序遍历里,当前节点要做的事就是把它的值追加到结果集。但注意,这个动作不是随便做的——它必须发生在"左子树递归回来之后、右子树递归开始之前"。这个位置就是中序的"序"。
递归的去向,这是二叉树递归要看的第三个数据。当前节点处理完之后,要往哪里递归?答案是左子树和右子树。但先去哪、后去哪,以及"访问根"夹在中间哪个位置,就是三种遍历的区别所在。
整体的一个模板还是这样的:
func traverse(node *TreeNode) {
if node == nil {
return
}
// 位置 A:前序在这里访问根
traverse(node.Left) // 递归左子树
// 位置 B:中序在这里访问根
traverse(node.Right) // 递归右子树
// 位置 C:后序在这里访问根
}
记住这三个位置 A、B、C——它们就是前序、中序、后序的全部秘密。
下面我们来看一道题目深入理解一下
给定一个二叉树的根节点 root ,返回 它的 中序 遍历 。
示例 1:
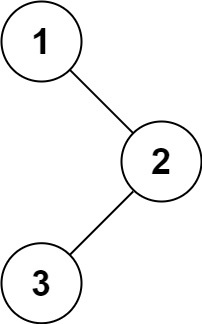
输入:root = [1,null,2,3]
输出:[1,3,2]
示例 2:
输入:root = []
输出:[]
示例 3:
输入:root = [1]
输出:[1]
提示:
- 树中节点数目在范围 [0, 100] 内
- -100 <= Node.val <= 100
遍历的规则
在动手写代码之前,先想清楚"一次合法的遍历"到底要满足什么。二叉树的递归定义决定了三件事:
第 2 条尤其关键。比如示例 1 的 [1,null,2,3],中序遍历之所以输出 [1,3,2],是因为:先递归到 1 的左子树(空),然后访问 1,再递归到 1 的右子树(节点 2);在 2 这里,先递归到它的左子树(节点 3),访问 3,再访问 2,最后递归 2 的右子树(空)。整个顺序就是 左 → 根 → 右。
-
首先,我们不需要排序,也不需要一维数组。这道题的输入是一棵二叉树,没有候选数组,所以组合总和里的 sort.Ints 和 startIndex 在这里都用不上。这正说明:二叉树题有自己的一套骨架,不必硬套回溯。
-
其次,我们要定义几个数据
-
一个是结果集,用来收集遍历到的节点值
res := []int{}
注意:这里不像单词搜索那样传一个 index,因为树的结构本身就在递归栈里,我们只需要一个地方把节点值存下来即可。
-
一个是递归函数本身,它的参数是当前节点
func traverse(node *TreeNode)
注意:这里不像括号生成那样传 open, close 两个计数器,因为树题要处理的是"节点",而不是"数量"。
-
上面两个是确定的,最后一个看题目不同来自己确定。这道题我们需要一个闭包来捕获结果集:
var traverse func(node *TreeNode)
traverse = func(node *TreeNode) {
if node == nil {
return
}
// 中序:左 → 根 → 右
traverse(node.Left)
res = append(res, node.Val)
traverse(node.Right)
} -
有了上面的数据,我们现在来套用模板来写这道题目
func traverse(node *TreeNode) {
首先是这个大框架,终止条件肯定要判 node == nil
这道题的"当前节点要做什么"不是数组,而是由 node 动态决定的:
– 访问根节点的值,插入到左子树和右子树之间
}if 满足终止条件 {
这里的终止条件就是 node == nil
直接返回,不做任何访问
}
//这里我们要想,如果还能往下走怎么办呢?显然,继续下面的递归即可
//那如果左右子树都为空呢?那就自然返回,让上一层去处理// 遍历三个动作(顺序由遍历方式决定)
traverse(node.Left) // 动作一:递归左子树
res = append(res, node.Val) // 动作二:访问根(中序)
traverse(node.Right) // 动作三:递归右子树注意一个细节:这道题和回溯题不一样——递归的入口不是"某个固定起点",而是"整棵树的根节点"。所以最外层只需要调用一次:
var res []int
traverse(root)
return res只要中途 node 变成了 nil,就直接返回,不用继续往下走了——这就是"遍历整棵树"和"搜索特定路径"的区别。
-
因此,我们最后改造的函数就是
/**
* Definition for a binary tree node.
* type TreeNode struct {
* Val int
* Left *TreeNode
* Right *TreeNode
* }
*/
func inorderTraversal(root *TreeNode) []int {
res := []int{}var traverse func(node *TreeNode)
traverse = func(node *TreeNode) {
// 终止条件:当前节点为空
if node == nil {
return
}// 中序:左 → 根 → 右
traverse(node.Left) // 递归左子树
res = append(res, node.Val) // 访问根节点
traverse(node.Right) // 递归右子树
}traverse(root)
return res
} -
进阶:能不能不用闭包,用显式的栈?
可以。递归的本质是编译器帮我们维护了一个调用栈,我们完全可以自己用 stack 来模拟这个过程。中序遍历的迭代版本稍微有点绕,因为"访问根"这个动作要延迟到左子树处理完之后。
func inorderTraversal(root *TreeNode) []int {
res := []int{}
stack := []*TreeNode{}
cur := rootfor cur != nil || len(stack) > 0 {
// 一路向左,把沿途节点压栈
for cur != nil {
stack = append(stack, cur)
cur = cur.Left
}
// 弹出栈顶,访问它
cur = stack[len(stack)–1]
stack = stack[:len(stack)–1]
res = append(res, cur.Val)
// 转向右子树
cur = cur.Right
}return res
}这份代码比递归版本更长,但把"递归栈"这个隐式结构显式化了——这就是递归和迭代的对应关系。尤其注意 stack = append(stack, cur) 和 stack = stack[:len(stack)-1] 这一对操作,它们分别对应递归里的"进入子树"和"从子树返回"。
拓展:前序、中序、后序遍历的逻辑
三种遍历共用同一套递归骨架,唯一的区别是**"访问根节点"这一动作放在位置 A、B 还是 C**。用一张表就能看清:
| 前序 | 根 → 左 → 右 | 位置 A(递归左子树之前) | [1,2,3] |
| 中序 | 左 → 根 → 右 | 位置 B(左右子树之间) | [1,3,2] |
| 后序 | 左 → 右 → 根 | 位置 C(递归右子树之后) | [3,2,1] |
对应的代码只需要调换三行:
// 前序:根 → 左 → 右
func preorderTraversal(root *TreeNode) []int {
res := []int{}
var traverse func(node *TreeNode)
traverse = func(node *TreeNode) {
if node == nil {
return
}
res = append(res, node.Val) // 位置 A:访问根
traverse(node.Left) // 递归左子树
traverse(node.Right) // 递归右子树
}
traverse(root)
return res
}
// 中序:左 → 根 → 右
func inorderTraversal(root *TreeNode) []int {
res := []int{}
var traverse func(node *TreeNode)
traverse = func(node *TreeNode) {
if node == nil {
return
}
traverse(node.Left) // 递归左子树
res = append(res, node.Val) // 位置 B:访问根
traverse(node.Right) // 递归右子树
}
traverse(root)
return res
}
// 后序:左 → 右 → 根
func postorderTraversal(root *TreeNode) []int {
res := []int{}
var traverse func(node *TreeNode)
traverse = func(node *TreeNode) {
if node == nil {
return
}
traverse(node.Left) // 递归左子树
traverse(node.Right) // 递归右子树
res = append(res, node.Val) // 位置 C:访问根
}
traverse(root)
return res
}
为什么顺序一换,结果就完全不同? 因为二叉树的递归定义是"根 + 左子树 + 右子树",而遍历的本质就是决定在递归的哪一步处理根。前序在进入子树之前处理根,中序在左子树回来之后处理根,后序在右子树回来之后处理根。
迭代版本的区别同样体现在"访问根"的时机上:
- 前序迭代:用栈,先压右再压左,弹出即访问
- 中序迭代:用栈,一路向左压栈,弹出时访问,再转向右
- 后序迭代:用栈,按"根 → 右 → 左"压栈,最后反转结果
复杂度分析
- 时间复杂度:O(n),其中 n 是节点数。每个节点恰好被访问一次。
- 空间复杂度:O(h),其中 h 是树的高度。递归栈深度等于树高,最坏情况下(链式树)为 O(n),平均情况下(平衡树)为 O(log n)。
总结
回过头看,这道题的核心就是三个位置 A、B、C:
| 前序 | 位置 A | res = append(res, node.Val) 放在两次 traverse 之前 |
| 中序 | 位置 B | res = append(res, node.Val) 放在两次 traverse 之间 |
| 后序 | 位置 C | res = append(res, node.Val) 放在两次 traverse 之后 |
和前面的回溯题对比一下,区别一目了然:
| 核心结构 | 一维数组 | 两个计数器 | 二维网格 | 递归树 |
| 终止条件 | curSum == target | len(path) == 2*n | index == len(word) | node == nil |
| 访问时机 | 收集所有解 | 收集所有解 | 找到一条就收手 | 位置 A/B/C 决定遍历方式 |
| 关键操作 | 做选择 / 撤销选择 | 做选择 / 撤销选择 | 做选择 / 撤销选择 | 递归左 / 访问根 / 递归右 |
遍历是二叉树的地基。把中序的递归逻辑想清楚,前序和后序只是把 append 换一行的事;把递归栈和显式栈的对应关系想清楚,迭代版本也就不再神秘。后面的层序遍历、路径求和、最近公共祖先,都会在这个骨架上继续长。
本文是 《算法题目解析系列》 的第 [39] 篇,本系列将持续更新,每篇都提供清晰的思路与编程语言实现。欢迎关注,第一时间获取更新。如果你有想看的题目,也可以在评论区留言告诉我。


评论前必须登录!
注册