 网硕互联帮助中心
文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题:为什么“做过”不等于“学会”
-
- 1. 真实生产力任务比短程网页任务难在哪里
- 2. 静态 Agent 的“失忆式执行”
- 3. MUSE 要解决的三个断点
- 二、相关工作:MUSE 与既有路线的差别
-
- 1. Self-evolving Agent
- 2. Agent Memory 与流程经验
- 3. Reflection 不是最终答案自评
- 三、方法总览:Plan—Execute—Reflect—Memorize
- 四、层次化 Memory Module
-
- 1. Strategic Memory:解决“遇到困境时遵循什么原则”
- 2. Procedural Memory:解决“这个任务具体怎么做”
- 3. Tool Memory:解决“某个工具用完以后下一步做什么”
- 4. 三层记忆为什么不能合并成一个向量库
- 五、Planning-Execution Agent
-
- 1. 子任务队列与动态重规划
- 2. 记忆增强的 ReAct 执行
- 3. 失败后的第二次探索
- 4. Minimal Usable Toolset
- 六、Reflect Agent:把“自我感觉完成”变成证据验收
-
- 1. 独立监督者
- 2. 两种核验方式
- 3. 任务结束后的全局升级
- 七、一个完整例子:从询问反馈到交付结论
- 八、实验设置
-
- 1. TAC 基准
- 2. 模型与运行设置
- 3. 指标
- 九、实验结果
-
- 1. 持续学习:三轮执行是否真的越做越好
- 2. 困难任务上的零样本迁移
- 3. TAC 全量结果
- 十、消融、模型迁移与效率
-
- 1. PE、Reflect 与 Memory 各自贡献多少
- 2. 记忆能否跨模型迁移
- 3. 上下文压缩的效率作用
- 十一、失败案例与反例
-
- 1. PDF 内嵌图片不可见
- 2. Excel 数字格式解析失败
- 十二、与 Agent Memory 系列方法的横向比较
- 十三、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
-
- 1. Coding Agent:把测试结果变成分层经验
- 2. Tool Agent:给工具调用增加后置条件
- 3. Multi-Agent:把 Reflect Agent 变成独立责任主体
- 4. 记忆系统应同时有“利用通道”和“反证通道”
- 十四、局限性
-
- 1. “自我进化”仍是外部自然语言记忆的进化
- 2. 长期记忆治理证据不足
- 3. 反思本身没有外部真值保证
- 4. 高层规划与多跳搜索仍然薄弱
- 5. 成本与延迟显著增加
- 6. 基准与真实部署仍有差距
- 十五、我的理解与启发
-
- 1. MUSE 真正把 Memory 从“内容系统”推进到“控制系统”
- 2. Reflect Agent 是记忆质量的写入门
- 3. 子任务是连接规划、验证和记忆的最小公共单元
- 4. 成功经验与失败经验不应该被同样处理
- 5. 经验迁移的核心可能不是任务相似,而是操作原语相似
- 十六、总结
- 参考资料
前言
在前面的 Agent Memory 系列里,我们讨论过很多“怎样把信息记住”的方案:有的方法重组记忆结构,有的方法改进检索,有的方法让记忆在使用中演化。但到了真实的办公 Agent,问题又向前推进了一步:Agent 缺的往往不只是一条关于用户或世界的事实,而是完成一件工作的方法。
例如,让 Agent 去聊天软件询问三位同事、汇总反馈、再把结论发给另一位员工。它必须跨多个页面执行几十步操作,并持续确认:消息是否真的发出、数据是否完整、文件是否保存到了正确位置。即使它今天偶然做成功,明天再遇到相似任务,冻结的模型仍可能重新踩一遍相同的坑。
这篇论文讨论的正是这种“会做一次,却不会越做越熟”的问题。
MUSE 的唯一核心增量可以概括为:
MUSE 把长流程任务中的“子任务执行—独立验收—失败重试—经验沉淀”做成测试时闭环,并把轨迹分别提炼为战略、流程和工具三种可复用记忆,使冻结的 Agent 能在真实跨应用环境中通过工作经验持续进化。
这里最重要的不是三种记忆的命名,而是记忆的生产时机与监督来源:系统不依赖人工标注的成功轨迹,而是在每个子任务结束后,由独立 Reflect Agent 依据环境证据验收结果;成功则立即形成 SOP,失败则生成诊断并触发重试或重规划。于是,记忆不再只是对话结束后的附属摘要,而成为下一轮行动的一部分。
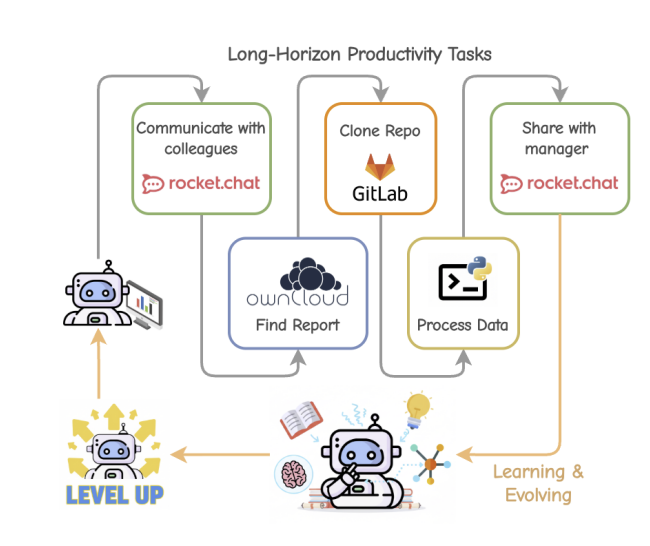
Figure 1:MUSE 的测试时学习与演化。 Agent 在跨应用长流程任务中不断交互,把经验写回记忆,并在后续任务中复用。
这也决定了本文在 Agent Memory 演进中的位置:它关心的不是“记忆库里能否找到一段相关文本”,而是“Agent 能否把操作成败转化为下一次更可靠的行为规则”。
零、论文基本信息
- 论文名称: Towards Self-Evolving Agents: Enabling Autonomy through Interactive Experience Refinement
- 发表平台: Findings of the Association for Computational Linguistics: ACL 2026
- 代码仓库: KnowledgeXLab/MUSE
- 作者: Cheng Yang, Xuemeng Yang, Licheng Wen, Daocheng Fu, Jianbiao Mei, Rong Wu, Pinlong Cai, Yufan Shen, Nianchen Deng, Jia Xu, Botian Shi, Yu Qiao, Haifeng Li
一、背景与问题:为什么“做过”不等于“学会”
1. 真实生产力任务比短程网页任务难在哪里
论文把目标场景称为 Productivity Tasks。它和普通问答或单页面网页操作至少有三点差异。
第一,轨迹长。TAC 中一个任务平均需要约 40 个动作,复杂任务可能超过百步。早期的小错误会沿后续步骤持续放大。
第二,跨应用。Agent 需要在 RocketChat、GitLab、OwnCloud、电子表格、浏览器与代码执行环境之间搬运信息。局部操作正确,并不意味着全局任务完成。
第三,成功信号稀疏。真实软件不会在每一步提供标准答案。按钮被点击不等于状态已经更新;模型说“任务完成”也不等于文件、消息或记录确实存在。
因此,单纯扩大上下文只能让模型看到更多历史,却不能自动回答三个关键问题:哪些步骤真的有效?失败发生在哪里?下一次应该保留什么?
2. 静态 Agent 的“失忆式执行”
冻结 LLM 在测试时参数不变。一次任务中的成功经验通常随着上下文结束而消失,下一次执行仍从近似空白状态开始。作者把这种模式描述为 amnesiac process:每次任务都像第一次做。
强化学习可以把经验写进参数,但需要训练资源、稳定奖励和可更新模型;对于闭源模型或已经部署的系统,这条路往往不可用。外部记忆因此成为更现实的测试时学习载体。
但“把日志存起来”仍不够。原始轨迹长、噪声大,而且混杂了试错、无效页面状态与偶然成功。真正需要保存的是跨粒度的可复用知识:
- 全局上,遇到某类困境应遵循什么原则;
- 流程上,完成某个应用操作应按什么 SOP;
- 单步上,某个工具调用后应立即检查什么。
3. MUSE 要解决的三个断点
MUSE 针对的是经验生命周期中的三个断点:
论文的整体设计,分别用独立反思、分层蒸馏和按层加载来连接这三个断点。
二、相关工作:MUSE 与既有路线的差别
1. Self-evolving Agent
一类工作通过优化 prompt、课程学习、技能库或工具集,让 Agent 在经验中获得新能力。Voyager 证明了技能积累的潜力,但 Minecraft 有明确状态变化、技术树和相对清晰的反馈;真实办公软件则更嘈杂,很多结果只能通过页面、文件或 DOM 主动核验。
MUSE 因此把重点放在“learning on the job”:没有预设课程,也没有每步 ground truth,而是让 Agent 自己拆任务、执行、检查和沉淀。
2. Agent Memory 与流程经验
Mem0 等方法强调长期记忆的写入、更新和检索;ExpeL 将轨迹总结为自然语言 insight;Agent Workflow Memory 和 Memp 更接近流程知识与可更新技能。
MUSE 与它们最接近的地方,是都不满足于保存原始历史,而要从历史中抽象可复用经验。区别在于,MUSE 把经验获取嵌入长流程交互现场:子任务结束后即时验收并写入 Procedural Memory,整项任务结束后再做全局去重、泛化和三层更新。它特别强调在缺少人工真值的环境里,主动操作环境来获得验证证据。
3. Reflection 不是最终答案自评
许多反思方法只让同一个模型检查最终答案。MUSE 的 Reflect Agent 更像独立质检员:它接收子任务目标与执行轨迹,可以追溯观测,也可以重新调用工具检查真实环境。反思的输出会改变后续控制流,而不只是生成一段建议。
三、方法总览:Plan—Execute—Reflect—Memorize
设生产力任务为
τ
∈
T
p
r
o
d
\\tau\\in\\mathcal{T}_{prod}
τ∈Tprod,交互环境为
E
\\mathcal{E}
E,基础工具集合为
A
t
o
o
l
\\mathcal{A}_{tool}
Atool。MUSE 由三部分组成:
- Memory Module:保存跨任务经验;
- Planning-Execution Agent,简称 PE Agent:拆解、执行与动态重规划;
- Reflect Agent:验收子任务、诊断失败并更新记忆。
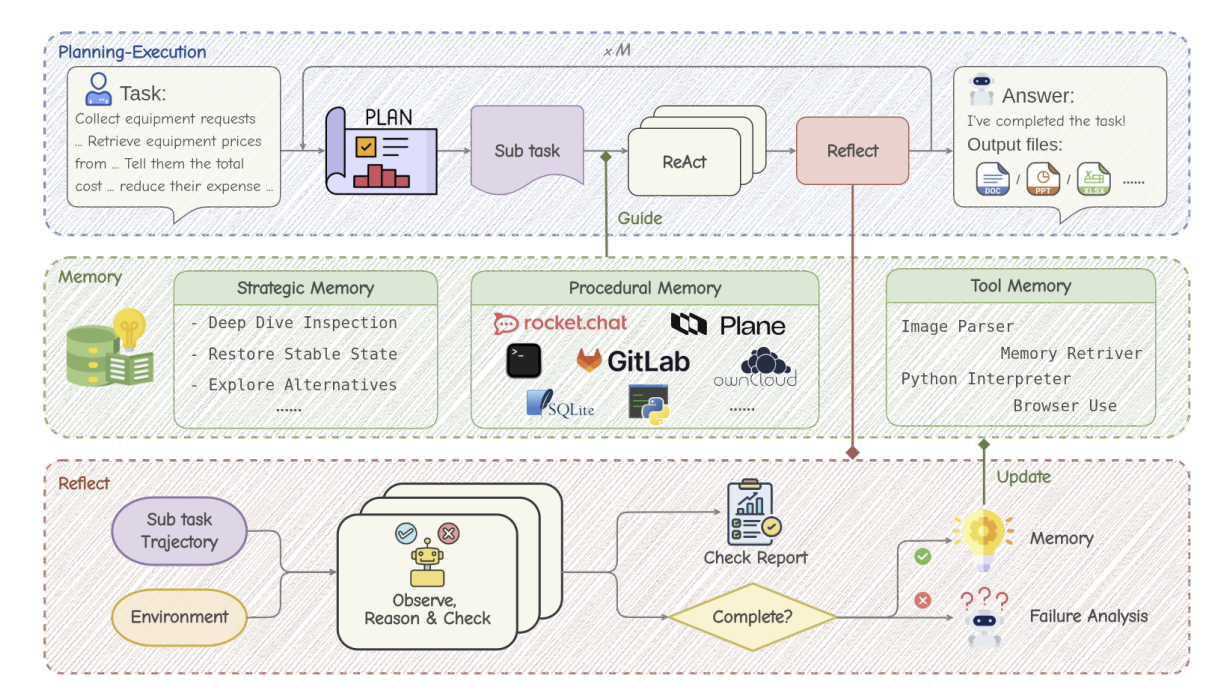
Figure 2:MUSE 框架。 PE Agent 负责规划与执行,Reflect Agent 验收轨迹;成功子任务形成流程记忆,任务结束后进一步更新战略记忆与工具记忆。
完整流程可以拆成三段。
这套闭环的关键是两个时间尺度:子任务级更新追求“马上能用”,任务级更新追求“长期可维护”。
四、层次化 Memory Module
MUSE 不微调基础模型,而是让性能
R
(
t
)
R(t)
R(t) 随任务经验积累而增长。记忆模块写成:
M
=
{
M
s
t
r
a
t
,
M
p
r
o
c
,
M
t
o
o
l
}
\\mathcal{M}=\\{\\mathcal{M}_{strat},\\mathcal{M}_{proc},\\mathcal{M}_{tool}\\}
M={Mstrat,Mproc,Mtool}
三者不是简单分类标签,而是分别进入 Agent 的不同决策位置。
1. Strategic Memory:解决“遇到困境时遵循什么原则”
M
s
t
r
a
t
\\mathcal{M}_{strat}
Mstrat 保存高层的 <Dilemma, Strategy> 对。它来自需要多次尝试才能解决的困境,例子包括:
- 不只修复表面症状,而要定位重复错误的系统性根因;
- 关键状态变更后逐项验证结果;
- 无法提取或核实时明确标注不可用,避免编造;
- 主路径受阻时启用备用方案并动态补齐前置条件。
这类记忆在初始化时整体加载进系统提示词,影响全局行为范式。为了避免提示词膨胀,任务结束后会合并、精炼并保持简洁。
它回答的不是“RocketChat 的登录按钮在哪里”,而是“面对不确定状态时应该怎样行动”。因此它的适用范围最广,但也最容易因抽象过度而变成正确却无用的口号。MUSE 用真实困境—解决模式来约束抽象来源。
2. Procedural Memory:解决“这个任务具体怎么做”
M
p
r
o
c
\\mathcal{M}_{proc}
Mproc 是按应用组织的 SOP 知识库。第一层索引是应用或平台,第二层索引是具体操作,例如 Login、Navigate to Folder、Create Channel。每条 SOP 包含前置条件、核心参数、操作步骤、注意事项和验证方式。
一条流程记忆表示为:
p
=
(
i
n
d
e
x
p
,
c
o
n
t
e
n
t
p
)
,
p
∈
M
p
r
o
c
p=(index_p, content_p),\\qquad p\\in\\mathcal{M}_{proc}
p=(indexp,contentp),p∈Mproc
系统启动时不加载全部正文,只加载轻量索引:
I
M
p
r
o
c
=
{
i
n
d
e
x
p
∣
p
∈
M
p
r
o
c
}
I_{\\mathcal{M}_{proc}}=\\{index_p\\mid p\\in\\mathcal{M}_{proc}\\}
IMproc={indexp∣p∈Mproc}
当 PE Agent 判断某条 SOP 相关时,再通过记忆工具
a
m
e
m
a_{mem}
amem 主动获取
c
o
n
t
e
n
t
p
content_p
contentp。
这个“索引常驻、正文按需取回”的设计比把所有经验塞进上下文更重要。它把记忆从被动相似度检索改成 Agent 的显式决策:Agent 知道有哪些经验可用,也能在真正需要时展开细节。
Procedural Memory 有两阶段更新:
- 子任务成功后,立刻加入新 SOP
p
n
e
w
p_{new}
pnew,后续子任务可直接复用; - 整项任务结束后,统一去重、合并和泛化,提高长期适用性。
3. Tool Memory:解决“某个工具用完以后下一步做什么”
Tool Memory 被作者比作“肌肉记忆”:
M
t
o
o
l
=
{
D
s
t
a
t
i
c
,
I
d
y
n
a
m
i
c
}
\\mathcal{M}_{tool}=\\{D_{static}, I_{dynamic}\\}
Mtool={Dstatic,Idynamic}
D
s
t
a
t
i
c
D_{static}
Dstatic 是工具的静态功能说明,在启动时加载;
I
d
y
n
a
m
i
c
I_{dynamic}
Idynamic 是动态操作指令,工具执行后随环境观察
o
t
o_t
ot 一起返回,直接指导下一动作
a
t
+
1
a_{t+1}
at+1。
例如,browser_click 的经验不是只写“点击元素”,而是要求点击后调用页面更新、验证导航或弹窗是否真的发生;如果失败,刷新元素后按语义属性重试。这样,验证动作被嵌入工具使用习惯,而不是完全依赖模型临场想起。
4. 三层记忆为什么不能合并成一个向量库
三层记忆对应三种不同的介入尺度:
- Strategic Memory 常驻全局上下文,改变决策原则;
- Procedural Memory 按需检索,提供跨工具的操作流程;
- Tool Memory 随工具反馈自动出现,约束下一步局部动作。
如果全部放入同一个相似度库,高层原则可能与具体步骤竞争,工具注意事项也可能在最需要时没有被召回。MUSE 的分层价值,本质上是让不同抽象层的经验在不同控制节点生效。
五、Planning-Execution Agent
1. 子任务队列与动态重规划
PE Agent 把任务拆成有序队列:
Q
=
[
s
t
1
,
s
t
2
,
…
,
s
t
M
]
Q=[st_1,st_2,\\ldots,st_M]
Q=[st1,st2,…,stM]
每个子任务定义为:
s
t
i
=
(
d
e
s
c
i
,
g
o
a
l
i
)
st_i=(desc_i,goal_i)
sti=(desci,goali)
d
e
s
c
i
desc_i
desci 描述执行范围,
g
o
a
l
i
goal_i
goali 给 Reflect Agent 提供验收依据。初始计划
Q
i
n
i
t
Q_{init}
Qinit 只由用户任务生成;后续重规划则融合实际执行结果与反思报告。
这意味着计划不是一次性清单。每完成一个子任务,系统都能根据新发现改变剩余队列;当
Q
Q
Q 为空时,还要检查环境全局状态,确认总目标是否真正满足。
2. 记忆增强的 ReAct 执行
每一步由 Thought、Action、Observation 三元组组成:
(
θ
t
,
a
t
,
o
t
)
(\\theta_t,a_t,o_t)
(θt,at,ot)
在历史
h
t
=
(
o
1
:
t
,
a
1
:
t
−
1
)
h_t=(o_{1:t},a_{1:t-1})
ht=(o1:t,a1:t−1) 下,Agent 按测试时策略选择动作:
a
t
∼
π
t
e
s
t
(
a
t
∣
h
t
)
a_t\\sim\\pi_{test}(a_t\\mid h_t)
at∼πtest(at∣ht)
动作既可以是输入文字、点击按钮,也可以是查询 Procedural Memory。每个子任务尝试最多执行
N
N
N 个动作,实验中
N
=
20
N=20
N=20,防止模型在错误页面或无效循环里无限消耗。
3. 失败后的第二次探索
达到动作上限或主动宣布完成时,Reflect Agent 介入。如果第一次尝试失败,PE Agent 获得一次重试机会。值得注意的是,重试时不再强制遵循原有 Procedural Memory。
这是一个小但关键的设计:记忆不是绝对正确的规则。旧 SOP 可能过时,也可能与当前界面不匹配。允许第二次尝试摆脱记忆,相当于在“经验利用”和“新路径探索”之间保留出口;第二次仍失败,才触发子任务重规划。
4. Minimal Usable Toolset
MUSE 没有为每个应用准备大量专用 API,而只提供浏览器、Shell、Python、视觉理解与记忆检索等基础工具。作者的假设是:复杂能力应来自基础工具的组合,而不是把任务答案预编码在工具里。
这也让 Procedural Memory 的价值更容易被观察:如果工具本身已经封装了“完成整项任务”,记忆提升很可能只是 API 调用提示;在原子工具上积累 SOP,才更接近真正的流程学习。
六、Reflect Agent:把“自我感觉完成”变成证据验收
1. 独立监督者
Reflect Agent 接收子任务
s
t
i
=
(
d
e
s
c
i
,
g
o
a
l
i
)
st_i=(desc_i,goal_i)
sti=(desci,goali) 和本次轨迹
h
k
:
t
h_{k:t}
hk:t,但不直接继承 PE Agent 的主观结论。它从三类维度生成检查清单:
2. 两种核验方式
Reflect Agent 可以沿轨迹定位支持结论的观察
o
t
o_t
ot,也可以直接调用工具进入环境主动检查。后者非常重要:长流程 Agent 的幻觉常常不是语言内容错误,而是把“我点击了保存”误认为“保存已经成功”。
核验输出为成功/失败标志
f
f
f 与详细报告:
(
f
,
r
e
p
o
r
t
)
=
Reflect
(
s
t
i
,
h
k
:
t
,
E
)
(f, report)=\\operatorname{Reflect}(st_i,h_{k:t},\\mathcal{E})
(f,report)=Reflect(sti,hk:t,E)
若
f
=
s
u
c
c
e
s
s
f=success
f=success,轨迹被压缩成新 SOP
p
n
e
w
p_{new}
pnew;若
f
=
f
a
i
l
u
r
e
f=failure
f=failure,系统生成失败分析
R
f
a
i
l
R_{fail}
Rfail 并反馈给 PE Agent。
因此,Reflect Agent 同时承担三个角色:验收器、失败诊断器和记忆写入门控。没有这道门,错误轨迹也可能被“学会”,形成记忆污染。
3. 任务结束后的全局升级
当重规划阶段不再产生新子任务,PE Agent 汇总整项任务。Reflect Agent 随后:
- 从挑战与解决路径中抽取 <Dilemma, Resolution Pattern>,更新
M
s
t
r
a
t
\\mathcal{M}_{strat}
Mstrat; - 从有效工具使用方式中更新
M
t
o
o
l
\\mathcal{M}_{tool}
Mtool; - 对三类记忆统一去重、融合和泛化。
这使 MUSE 不只是不断追加条目,而是尝试控制知识库的冗余。不过论文没有给出长期运行下的记忆容量曲线和错误遗忘机制,这会成为后文的重要边界。
七、一个完整例子:从询问反馈到交付结论
论文的 “hr-collect-feedbacks” 案例要求 Agent 向三位同事询问 Liu Qiang 的表现,再根据反馈向本人发送评价。
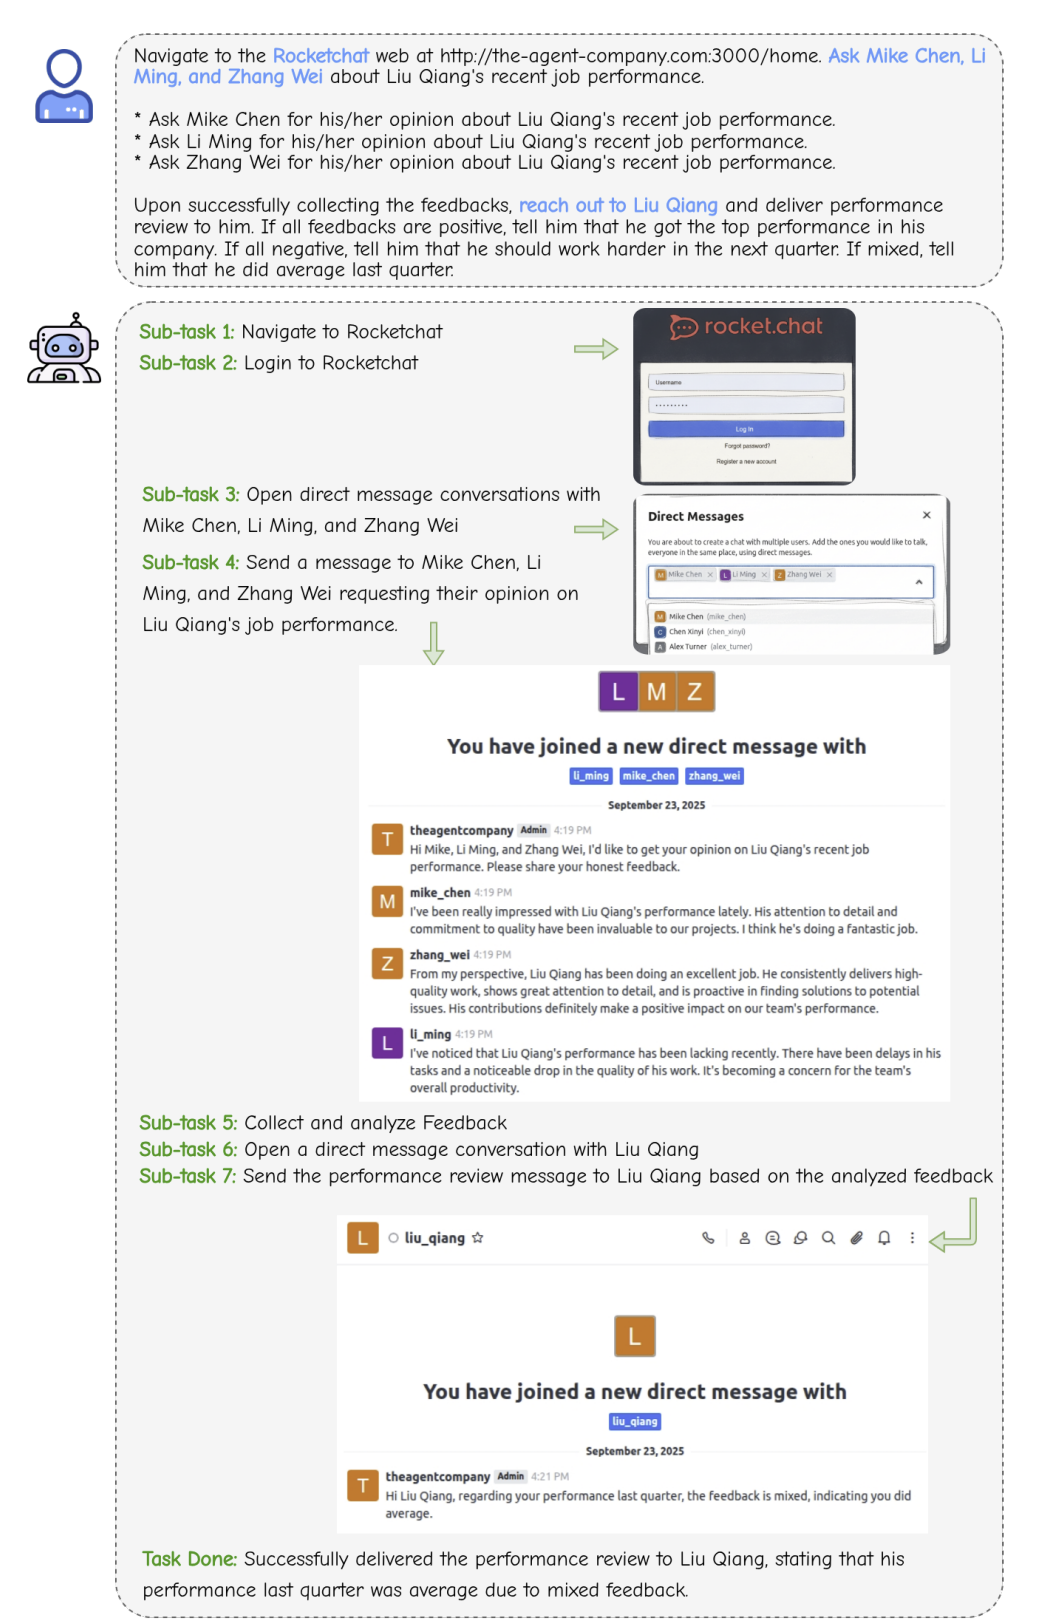
Figure 4:成功案例——收集员工反馈。 MUSE 将跨多人沟通拆成连续子任务,并依据真实聊天结果给出最终评价。
这个案例显示,子任务目标不仅方便执行,也为反思提供局部验收点。系统可以分别检查是否找到三位联系人、是否收到完整回复、是否正确判断“反馈混合”,而不是到最后才笼统判断整项任务。
更能说明动态重规划的是 GitLab 案例。Agent 原本只需创建 issue 并分配给 Li Ming,却发现 Li Ming 不是项目成员。它没有停在失败状态,而是创建或定位账号、把用户加入项目,再返回创建表单完成分配。
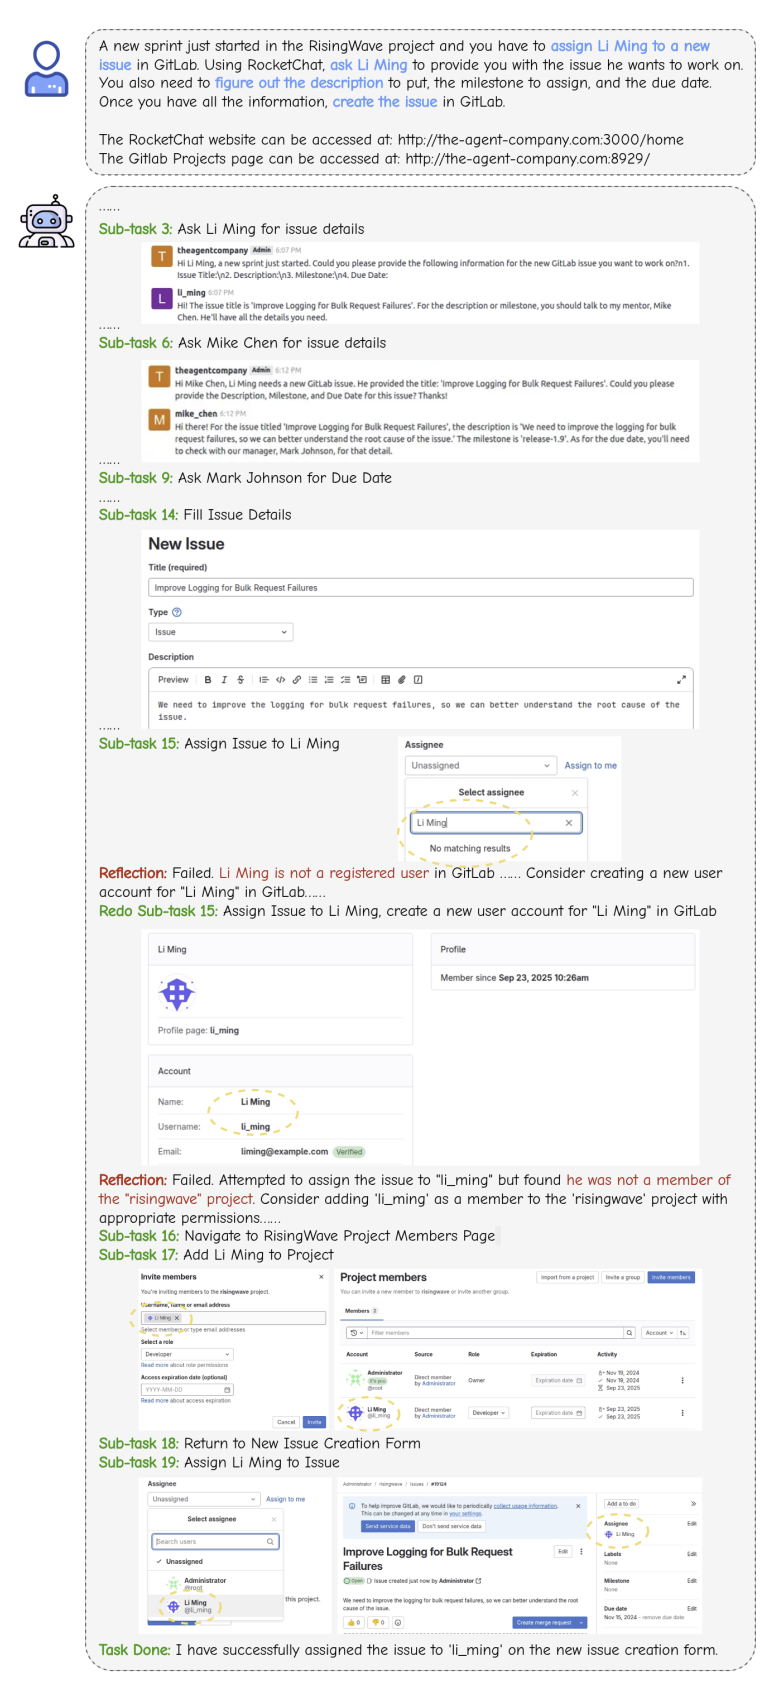
Figure 5:成功案例——创建并分配 GitLab issue。 反思发现前置条件缺失后,Agent 动态插入补救子任务,再回到原目标。
这个例子真正体现的不是“能点网页”,而是闭环如何改变控制流:环境异常 → 反思诊断 → 队列新增前置任务 → 状态修复 → 恢复主流程。
八、实验设置
1. TAC 基准
TheAgentCompany(TAC)包含 175 个任务,覆盖 HR、项目管理、软件开发、数据科学、财务等 6 类岗位,并要求 Agent 在多种真实软件中完成跨应用操作。任务平均约 40 个动作,适合检验长程规划、工具组合与跨平台信息整合。
2. 模型与运行设置
主要实验的 PE Agent 与 Reflect Agent 都使用 Gemini-2.5 Flash;环境中的 NPC 使用 GPT-4o;每个子任务最多
N
=
20
N=20
N=20 个动作。
论文同时构造两个子集:
-
T
c
l
\\mathcal{T}_{cl}
Tcl:18 个任务,覆盖六类岗位,用于三轮持续学习; -
T
h
a
r
d
\\mathcal{T}_{hard}
Thard:12 个此前未见的困难任务,用于测试积累记忆的零样本迁移。
3. 指标
部分完成分数定义为:
S
p
a
r
t
i
a
l
=
0.5
⋅
C
o
m
p
l
e
t
e
d
_
c
k
p
t
T
o
t
a
l
_
c
k
p
t
+
0.5
⋅
S
f
u
l
l
S_{partial}=0.5\\cdot\\frac{Completed\\_ckpt}{Total\\_ckpt}+0.5\\cdot S_{full}
Spartial=0.5⋅Total_ckptCompleted_ckpt+0.5⋅Sfull
其中
S
f
u
l
l
∈
{
0
,
1
}
S_{full}\\in\\{0,1\\}
Sfull∈{0,1} 表示任务是否完整完成。
S
c
k
p
t
S_{ckpt}
Sckpt 则是所有任务中已完成 checkpoint 占总 checkpoint 的比例。PCR(Perfect Completion Rate)表示完整解决的任务比例。
这个指标设计同时奖励中间进度与完整交付,但也要注意:
S
p
a
r
t
i
a
l
S_{partial}
Spartial 高并不一定意味着最终交付成功,因此论文同时报告 PCR 才能避免只看局部 checkpoint。
九、实验结果
1. 持续学习:三轮执行是否真的越做越好
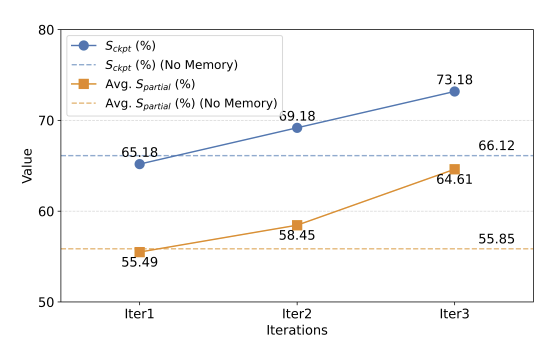
Figure 3:MUSE 的跨轮次性能趋势。 实线表示携带记忆的三轮学习,虚线表示无记忆基线。
S
c
k
p
t
S_{ckpt}
Sckpt 从第一轮的 65.18% 上升到第二轮 69.18%、第三轮 73.18%;平均
S
p
a
r
t
i
a
l
S_{partial}
Spartial 从 55.49% 上升到 58.45% 和 64.61%。无记忆基线分别为 66.12% 和 55.85%。
这里的证据支持“经验累积与性能同步增长”,但不能单凭三轮曲线证明无限持续学习。实验只有 18 个任务、三次迭代,并没有展示更长时间后是否饱和、退化或发生记忆冲突。
2. 困难任务上的零样本迁移
Framework
Model
Checkpoint
S
c
k
p
t
A
v
g
.
S
p
a
r
t
i
a
l
OpenHands-Versa
Claude-4 Sonnet
3
/
59
5.08
2.00
OpenHands
Gemini-2.5 Pro
5
/
59
8.47
3.00
MUSE w/o mem
Gemini-2.5 Flash
18
/
59
30.51
23.65
M
U
S
E
w
/
m
e
m
Gemini-2.5 Flash
24
/
59
40.68
33.41
\\begin{array}{l|l|c|c|c} \\textbf{Framework} & \\textbf{Model} & \\textbf{Checkpoint} & \\mathbf{S_{ckpt}} & \\mathbf{Avg.\\ S_{partial}} \\\\ \\hline \\text{OpenHands-Versa} & \\text{Claude-4 Sonnet} & 3/59 & 5.08 & 2.00 \\\\ \\text{OpenHands} & \\text{Gemini-2.5 Pro} & 5/59 & 8.47 & 3.00 \\\\ \\text{MUSE w/o mem} & \\text{Gemini-2.5 Flash} & 18/59 & 30.51 & 23.65 \\\\ \\mathbf{MUSE\\ w/\\ mem} & \\text{Gemini-2.5 Flash} & \\mathbf{24/59} & \\mathbf{40.68} & \\mathbf{33.41} \\end{array}
FrameworkOpenHands-VersaOpenHandsMUSE w/o memMUSE w/ memModelClaude-4 SonnetGemini-2.5 ProGemini-2.5 FlashGemini-2.5 FlashCheckpoint3/595/5918/5924/59Sckpt5.088.4730.5140.68Avg. Spartial2.003.0023.6533.41
Table 1:困难任务集上的泛化结果。 比较无记忆与携带已积累记忆的 MUSE,以及其他强 Agent 基线。
记忆来自
T
c
l
\\mathcal{T}_{cl}
Tcl 的三轮学习,而
T
h
a
r
d
\\mathcal{T}_{hard}
Thard 在记忆积累阶段未出现。加入记忆后,MUSE 的平均
S
p
a
r
t
i
a
l
S_{partial}
Spartial 从 23.65% 提升到 33.41%,绝对提升 9.76 个百分点;
S
c
k
p
t
S_{ckpt}
Sckpt 从 30.51% 提升到 40.68%。
这比重复任务上的提升更能说明价值:记忆并非只保存某一道题的答案,至少部分战略、SOP 与工具规则能够迁移到新任务。但 MUSE 即使不带记忆也显著强于 OpenHands 基线,说明 PE + Reflect 架构本身贡献很大,不能把全部优势归因于 Memory Module。
3. TAC 全量结果
Framework
Model
Checkpoint
S
c
k
p
t
A
v
g
.
S
p
a
r
t
i
a
l
P
C
R
OWL-RolePlay
GPT-4o + o3-mini
127
/
776
16.37
11.04
4.00
OpenHands
Gemini-1.5 Pro
90
/
776
11.60
8.02
3.43
OpenHands
Gemini-2.0 Flash
195
/
776
25.13
18.96
11.43
OpenHands
Gemini-2.5 Pro
361
/
776
46.52
39.28
30.29
OpenHands-Versa
Claude-3.7 Sonnet
353
/
776
45.49
40.18
30.86
OpenHands-Versa
Claude-4 Sonnet
392
/
776
50.52
43.19
33.14
M
U
S
E
Gemini-2.5 Flash
465
/
776
59.92
51.78
41.14
\\begin{array}{l|l|c|c|c|c} \\textbf{Framework} & \\textbf{Model} & \\textbf{Checkpoint} & \\mathbf{S_{ckpt}} & \\mathbf{Avg.\\ S_{partial}} & \\mathbf{PCR} \\\\ \\hline \\text{OWL-RolePlay} & \\text{GPT-4o + o3-mini} & 127/776 & 16.37 & 11.04 & 4.00 \\\\ \\text{OpenHands} & \\text{Gemini-1.5 Pro} & 90/776 & 11.60 & 8.02 & 3.43 \\\\ \\text{OpenHands} & \\text{Gemini-2.0 Flash} & 195/776 & 25.13 & 18.96 & 11.43 \\\\ \\text{OpenHands} & \\text{Gemini-2.5 Pro} & 361/776 & 46.52 & 39.28 & 30.29 \\\\ \\text{OpenHands-Versa} & \\text{Claude-3.7 Sonnet} & 353/776 & 45.49 & 40.18 & 30.86 \\\\ \\text{OpenHands-Versa} & \\text{Claude-4 Sonnet} & 392/776 & 50.52 & 43.19 & 33.14 \\\\ \\mathbf{MUSE} & \\text{Gemini-2.5 Flash} & \\mathbf{465/776} & \\mathbf{59.92} & \\mathbf{51.78} & \\mathbf{41.14} \\end{array}
FrameworkOWL-RolePlayOpenHandsOpenHandsOpenHandsOpenHands-VersaOpenHands-VersaMUSEModelGPT-4o + o3-miniGemini-1.5 ProGemini-2.0 FlashGemini-2.5 ProClaude-3.7 SonnetClaude-4 SonnetGemini-2.5 FlashCheckpoint127/77690/776195/776361/776353/776392/776465/776Sckpt16.3711.6025.1346.5245.4950.5259.92Avg. Spartial11.048.0218.9639.2840.1843.1951.78PCR4.003.4311.4330.2930.8633.1441.14
Table 2:TAC 全部 175 个任务上的性能。 MUSE 使用 Gemini-2.5 Flash,在 checkpoint、部分完成分数与完整完成率上均为最佳。
MUSE 的平均
S
p
a
r
t
i
a
l
=
51.78
%
S_{partial}=51.78\\%
Spartial=51.78%,相对此前最佳 43.19% 提升约 19.9%;PCR 从 33.14% 提升到 41.14%,绝对提高 8 个百分点。更值得关注的是,进入全量评测前的记忆只来自 18 个任务,约占完整基准的 10%。
不过,这并不是完全“同模型、同框架”的单变量比较。不同方法使用的模型、执行框架与反思机制不同。Table 2 能证明 MUSE 系统在该基准上的总体竞争力,但对 Memory Module 的因果判断仍要看后面的消融。
十、消融、模型迁移与效率
1. PE、Reflect 与 Memory 各自贡献多少
P
E
R
e
f
l
e
c
t
M
e
m
o
r
y
A
v
g
.
T
i
m
e
(
s
)
C
h
e
c
k
p
o
i
n
t
S
c
k
p
t
A
v
g
.
S
p
a
r
t
i
a
l
Y
e
s
N
o
N
o
620.07
54
/
85
63.53
43.21
Y
e
s
Y
e
s
N
o
895.19
56.2
/
85
66.12
55.85
Y
e
s
Y
e
s
Y
e
s
993.05
62.2
/
85
73.18
64.61
\\begin{array}{c|c|c|c|c|c|c} \\mathbf{PE} & \\mathbf{Reflect} & \\mathbf{Memory} & \\mathbf{Avg.Time(s)} & \\mathbf{Checkpoint} & \\mathbf{S_{ckpt}} & \\mathbf{Avg.S_{partial}} \\\\ \\hline \\mathrm{Yes} & \\mathrm{No} & \\mathrm{No} & 620.07 & 54/85 & 63.53 & 43.21 \\\\ \\mathrm{Yes} & \\mathrm{Yes} & \\mathrm{No} & 895.19 & 56.2/85 & 66.12 & 55.85 \\\\ \\mathrm{Yes} & \\mathrm{Yes} & \\mathrm{Yes} & 993.05 & 62.2/85 & 73.18 & 64.61 \\end{array}
PEYesYesYesReflectNoYesYesMemoryNoNoYesAvg.Time(s)620.07895.19993.05Checkpoint54/8556.2/8562.2/85Sckpt63.5366.1273.18Avg.Spartial43.2155.8564.61
Table 3:MUSE 组件消融与平均耗时。 在纯 PE Agent 上依次加入 Reflect Agent 和 Memory Module。
加入 Reflect Agent 后,
S
p
a
r
t
i
a
l
S_{partial}
Spartial 从 43.21% 提升到 55.85%,绝对提升 12.64 个百分点,但平均时间增加 275.12 秒。说明独立验收与重试很有效,也确实昂贵。
在 PE + Reflect 基础上加入记忆,
S
p
a
r
t
i
a
l
S_{partial}
Spartial 再从 55.85% 提升到 64.61%,绝对提升 8.76 个百分点;平均时间增加 97.86 秒。就论文给出的推理耗时而言,记忆检索的边际成本低于反思重试,而收益仍然明显。
不过,完整 MUSE 的平均耗时为 993.05 秒,相比纯 PE 的 620.07 秒增加约 60%。论文所说的“效率平衡”主要指性能—推理深度之间的折中,而不是绝对低延迟。
2. 记忆能否跨模型迁移
类型
框架
模型
Checkpoint
S
c
k
p
t
A
v
g
.
S
p
a
r
t
i
a
l
Open
OpenHands
Llama-3.1 405B
17
/
85
20.00
9.78
Open
OpenHands
Llama-3.3 70B
11
/
85
12.94
5.84
Open
OpenHands
Qwen-2.5 72B
11
/
85
12.94
6.50
Open
MUSE
DeepSeek-V3 w/o mem
29
/
85
34.12
28.01
Open
MUSE
DeepSeek-V3 w/ mem
43
/
85
50.59
36.75
Closed
OpenHands
Gemini-2.5 Pro
58
/
85
65.39
57.67
Closed
MUSE
Gemini-2.5 Flash w/ mem
62.2
/
85
73.18
64.61
Closed
MUSE
Gemini-2.5 Pro w/ mem
68
/
85
80.00
67.10
\\begin{array}{l|l|l|c|c|c} \\textbf{类型} & \\textbf{框架} & \\textbf{模型} & \\textbf{Checkpoint} & \\mathbf{S_{ckpt}} & \\mathbf{Avg.S_{partial}} \\\\ \\hline \\text{Open} & \\text{OpenHands} & \\text{Llama-3.1 405B} & 17/85 & 20.00 & 9.78 \\\\ \\text{Open} & \\text{OpenHands} & \\text{Llama-3.3 70B} & 11/85 & 12.94 & 5.84 \\\\ \\text{Open} & \\text{OpenHands} & \\text{Qwen-2.5 72B} & 11/85 & 12.94 & 6.50 \\\\ \\text{Open} & \\text{MUSE} & \\text{DeepSeek-V3 w/o mem} & 29/85 & 34.12 & 28.01 \\\\ \\text{Open} & \\text{MUSE} & \\text{DeepSeek-V3 w/ mem} & 43/85 & 50.59 & 36.75 \\\\ \\hline \\text{Closed} & \\text{OpenHands} & \\text{Gemini-2.5 Pro} & 58/85 & 65.39 & 57.67 \\\\ \\text{Closed} & \\text{MUSE} & \\text{Gemini-2.5 Flash w/ mem} & 62.2/85 & 73.18 & 64.61 \\\\ \\text{Closed} & \\text{MUSE} & \\text{Gemini-2.5 Pro w/ mem} & 68/85 & 80.00 & 67.10 \\end{array}
类型OpenOpenOpenOpenOpenClosedClosedClosed框架OpenHandsOpenHandsOpenHandsMUSEMUSEOpenHandsMUSEMUSE模型Llama-3.1 405BLlama-3.3 70BQwen-2.5 72BDeepSeek-V3 w/o memDeepSeek-V3 w/ memGemini-2.5 ProGemini-2.5 Flash w/ memGemini-2.5 Pro w/ memCheckpoint17/8511/8511/8529/8543/8558/8562.2/8568/85Sckpt20.0012.9412.9434.1250.5965.3973.1880.00Avg.Spartial9.785.846.5028.0136.7557.6764.6167.10
Table 4:不同开源与闭源模型上的结果。 自然语言记忆能从 Gemini 驱动的积累过程迁移给 DeepSeek-V3,并继续带来增益。
DeepSeek-V3 加入预积累记忆后,
S
p
a
r
t
i
a
l
S_{partial}
Spartial 从 28.01% 提升到 36.75%,说明记忆不是绑定某个模型参数的隐状态。Gemini-2.5 Pro 上,MUSE 达到 67.10%,也高于同模型 OpenHands 的 57.67%。
这支持“自然语言经验具备模型无关性”,但尚未回答不同模型对同一记忆的遵循程度、错误敏感性和写入风格是否一致。
3. 上下文压缩的效率作用
MUSE 会压缩早期代码、浏览器 Accessibility Tree 等冗余信息。论文按子任务位置统计每个动作的平均 token 消耗。
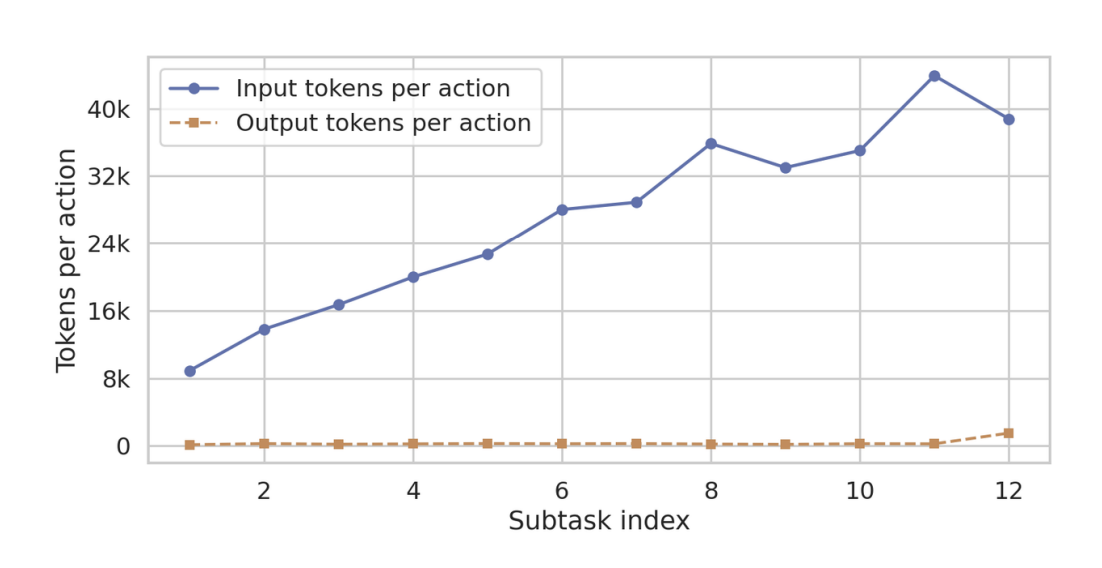
Figure 8:启用上下文压缩时的 token 消耗。 后期子任务的每动作输入量大致维持在数万 token 量级。
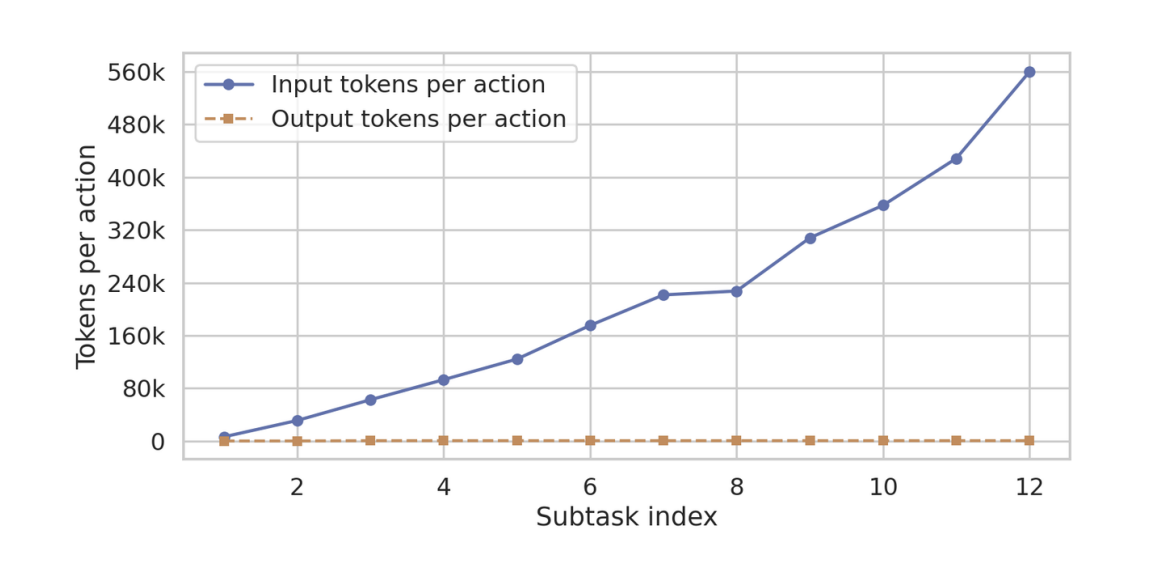
Figure 9:不启用上下文压缩时的 token 消耗。 第 12 个子任务的每动作输入量接近 56 万 token。
两图的纵轴量级差异非常明显。作者据此报告超过 10 倍的压缩率。它说明长流程系统不能只优化外部 Memory:如果工作上下文本身无限累积,再好的记忆检索也会被不断增长的历史淹没。
但论文没有给出压缩前后的任务精度对照,因此这里只能证明 token 成本显著下降,不能证明压缩完全没有损伤关键信息。
十一、失败案例与反例
1. PDF 内嵌图片不可见
在 “admin-make-spreadsheet” 中,Agent 未能提前感知 PDF 内嵌图像中的非结构化信息,导致后续表格处理失败。
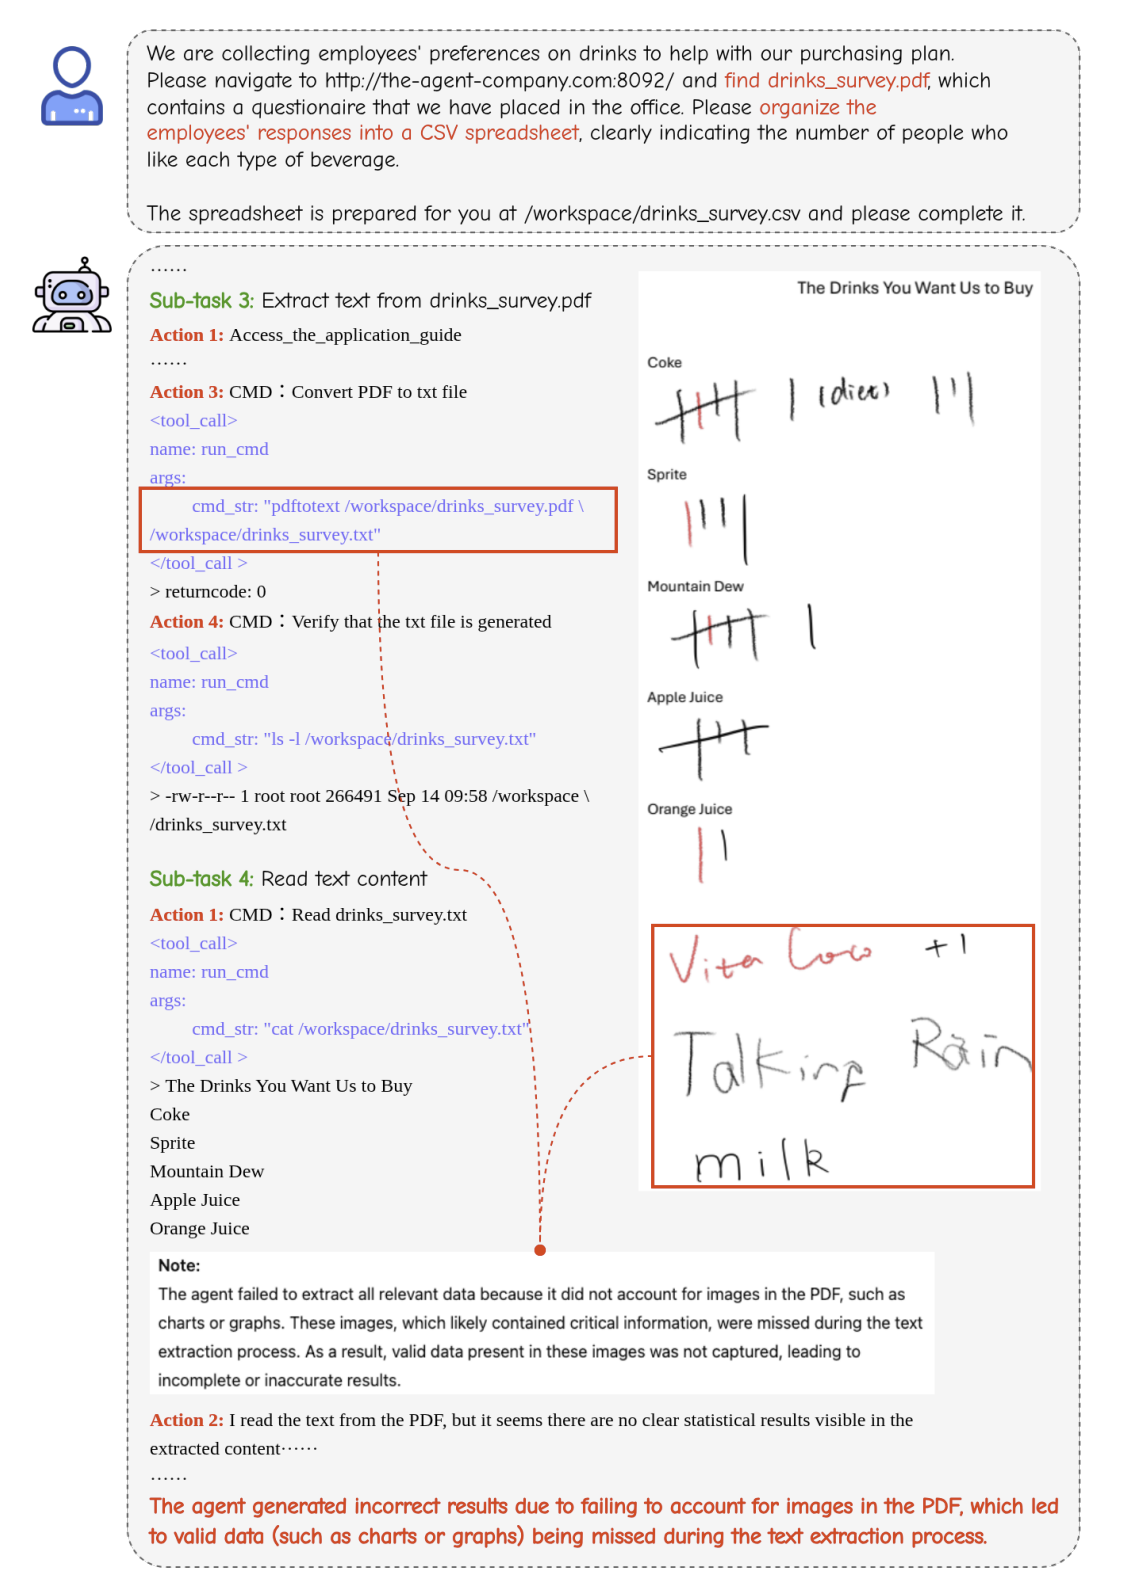
Figure 6:失败案例——PDF 图像感知缺失。 关键数据没有进入 Agent 可用的观察,后续规划与记忆都无法弥补。
这个失败提醒我们:记忆只能复用曾经被正确观察和理解的经验。若输入感知阶段根本没有看到关键数据,反思只能发现“结果不对”,却未必能恢复缺失内容。
2. Excel 数字格式解析失败
在数据可视化任务中,Agent 对带千位分隔符的结构化数值观察不足,导致生成代码时没有提取出有效数值。
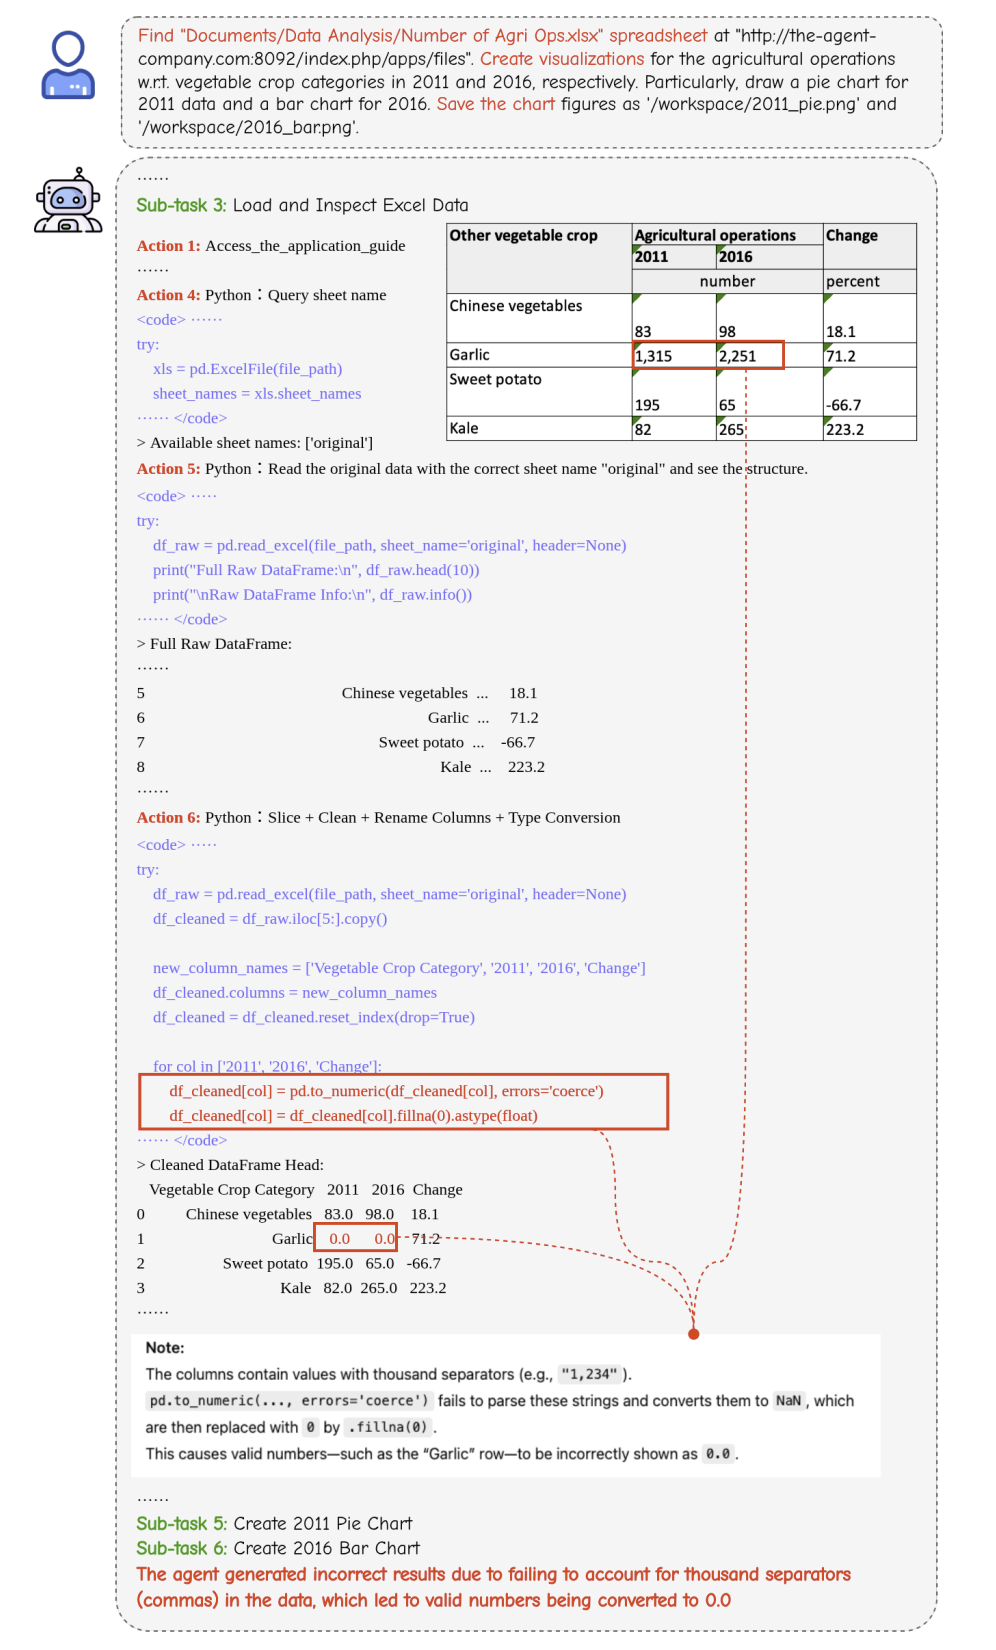
Figure 7:失败案例——结构化数据格式解析不足。 表面上可见的数据没有被正确转换为可计算数值。
两个案例共同说明 MUSE 的能力上限仍受观察通道限制。人类通常以并行、多模态方式快速建立全局认识,而 Agent 的观察仍是被动、线性的。层次记忆改善的是“看见以后如何学”,不是“如何保证一开始就看见”。
十二、与 Agent Memory 系列方法的横向比较
下面的比较只围绕本文核心增量:经验在何时产生、以何种形式保存、如何介入下一次行动。
| A-MEM | 可演化的记忆条目与关联 | 新记忆写入时动态组织语义关系 | 更关注记忆条目的组织与演化;MUSE 更关注操作轨迹如何经环境验收后变成跨粒度行动知识 |
| MAGMA | 多图结构中的异构长期记忆 | 按不同关系组织和检索记忆 | MAGMA 的重点是记忆表示与检索结构;MUSE 的重点是长流程执行闭环和 SOP 生产 |
| CoM | 面向连续经验的组织与使用 | 让记忆在持续交互中形成可利用结构 | CoM 更强调记忆组织范式;MUSE 明确把战略、流程、工具记忆绑定到不同控制节点 |
| ReMemR1 | 可回访的历史记忆 | 更新当前记忆时主动回溯旧记忆,修正边读边记的信息损失 | ReMemR1 改变“写记忆时是否能回看过去”;MUSE 改变“执行后如何验收并把操作经验写回” |
| Mem²Evolve | Experience Memory 与 Asset Memory | 经验积累与可执行资产生成协同进化 | Mem²Evolve 扩张可用资产/能力空间;MUSE 主要沉淀自然语言战略、SOP 和工具规则,不主动创造新工具资产 |
| MUSE | 已验证的操作经验 | 子任务级反思门控、即时 SOP、任务级三层蒸馏 | 让记忆生产与长流程控制流结合,重点解决真实工作中的测试时学习 |
MUSE 的优势是工程闭环完整:失败不会只成为一段日志,而会立即改变下一轮执行;成功也不会只被记录,而会进入可检索 SOP。它的弱点则是知识形态仍以自然语言为主,缺少更严格的版本、置信度、适用条件和自动失效机制。
十三、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下是基于论文机制的工程推演,不是论文已经完成的实验结论。
1. Coding Agent:把测试结果变成分层经验
Coding Agent 可以把 Strategic Memory 写成“出现重复失败时先检查环境与依赖,不要连续改业务逻辑”;把 Procedural Memory 写成仓库级 SOP,如“修改接口后依次运行类型检查、单元测试和契约测试”;把 Tool Memory 写成命令级守则,如“补丁应用后必须重新读取变更区域”。
关键是让测试、编译器和运行日志承担 Reflect Agent 的环境证据,而不是让模型只凭代码表面判断“已经修好”。
2. Tool Agent:给工具调用增加后置条件
大多数工具描述只说明输入参数与功能。MUSE 的 Tool Memory 提示了另一种设计:每次工具调用都应绑定后置检查。例如创建日历事件后读取事件 ID,发送消息后确认服务端状态,保存文档后检查路径与修改时间。
这会把“调用成功”从语言模型的主观判断变成可验证协议。
3. Multi-Agent:把 Reflect Agent 变成独立责任主体
在多 Agent 系统中,执行者与验收者应拥有不同上下文与目标。执行者追求推进任务,验收者追求发现证据缺口。若两者共享完全相同的推理历史,验收容易重复执行者的偏见。
还可以进一步把 MUSE 的三层记忆分给不同角色维护:策略管理员负责跨任务原则,流程管理员维护 SOP,工具管理员维护 API 与界面变化。但这需要解决冲突合并和责任追踪,论文尚未覆盖。
4. 记忆系统应同时有“利用通道”和“反证通道”
MUSE 重试时允许不遵循旧 Procedural Memory,这一点很适合工程系统。每条 SOP 都应带适用条件、最近验证时间与失败计数;当实时观察与记忆冲突时,Agent 要能够暂时绕开旧经验,并把反例用于修订,而不是盲目坚持。
十四、局限性
1. “自我进化”仍是外部自然语言记忆的进化
模型参数没有改变,进化发生在提示词、SOP 与工具说明层。它实用、可解释、可跨模型迁移,但能力上限仍受基础模型推理与感知能力限制。
2. 长期记忆治理证据不足
实验只有三轮持续学习,没有展示上百轮后的容量、重复、矛盾、遗忘与错误放大。任务级“去重和泛化”由 Reflect Agent 完成,但缺少量化指标来判断记忆质量是否真的长期改善。
3. 反思本身没有外部真值保证
Reflect Agent 可以主动检查环境,明显优于纯语言自评,但它与 PE Agent 使用相同模型。两者可能共享相同盲点;当环境观察不完整时,反思也可能把错误轨迹判为成功,进而污染 SOP。
4. 高层规划与多跳搜索仍然薄弱
论文明确承认当前记忆架构不是万能方案,对高层规划和多跳搜索等任务仍有限。它的主要收益来自避开已知失败路径、压缩搜索空间,而不是彻底解决复杂规划。
5. 成本与延迟显著增加
完整系统平均耗时从纯 PE 的 620.07 秒增至 993.05 秒。对于后台自动化可以接受,但对于需要即时响应的人机协作场景,额外反思轮次可能成为瓶颈。
6. 基准与真实部署仍有差距
TAC 很接近办公环境,却仍是受控基准。真实企业系统还涉及权限、隐私、审计、软件版本变化和不可逆操作。MUSE 没有系统评估错误记忆导致的高风险动作,也没有讨论敏感轨迹写入长期记忆后的治理问题。
十五、我的理解与启发
1. MUSE 真正把 Memory 从“内容系统”推进到“控制系统”
很多记忆工作关注存什么、怎么索引、如何召回;MUSE 更有价值的地方,是回答记忆在控制流中的哪个时刻生效。战略记忆影响全局原则,流程记忆在子任务开始或不确定时展开,工具记忆在动作之后立刻提示验证。
所以,分层记忆最重要的不是三个名称,而是三种触发机制。
2. Reflect Agent 是记忆质量的写入门
长期记忆系统最危险的不是忘记,而是把错误稳定地记住。MUSE 让独立反思先判断成功,再把轨迹转成 SOP,相当于在写入前增加证据门控。这比事后仅靠检索排序修补污染更合理。
但下一步还应为记忆增加 provenance:哪次任务产生、哪些环境证据支持、被多少次复用、何时最后验证。这样才能从“自然语言经验库”走向可审计的 Agent 知识系统。
3. 子任务是连接规划、验证和记忆的最小公共单元
如果只在整项任务结束时总结,轨迹过长,因果关系模糊;如果每一步都总结,成本又过高,而且许多动作脱离上下文没有意义。MUSE 选择子任务作为反思和流程记忆单位,是一个很实用的中间粒度。
它让同一个
g
o
a
l
i
goal_i
goali 同时服务于计划、验收和经验抽取,减少三个模块之间的语义错位。
4. 成功经验与失败经验不应该被同样处理
MUSE 将成功轨迹写成 Procedural Memory,将失败轨迹变成诊断并触发探索,而不是直接把失败路径存成 SOP。这个区分合理,但仍可进一步发展:失败经验也可以形成“反模式记忆”,记录触发条件、失败证据与替代方案,帮助 Agent 在相似场景提前规避。
5. 经验迁移的核心可能不是任务相似,而是操作原语相似
记忆只从 18 个任务积累,却能改善 175 个任务和未见困难任务。这说明可迁移部分很可能来自登录、导航、核验、文件处理、状态恢复等跨任务重复的操作结构,而不是高层任务语义完全相同。
这对 Agent Memory 的启发是:检索键不应只看用户请求的文本相似度,还应包含应用、当前状态、操作目标、失败类型和所需工具组合。
十六、总结
MUSE 面向真实跨应用长流程任务,构建了一个 Plan—Execute—Reflect—Memorize 闭环。PE Agent 动态拆解并执行子任务,Reflect Agent 依据真实环境验收成功与失败;成功轨迹即时形成 Procedural Memory,整项任务结束后再更新 Strategic Memory 与 Tool Memory。
实验上,MUSE 使用 Gemini-2.5 Flash 在 TAC 全量 175 任务上达到 51.78% 的平均部分完成分数和 41.14% 的完整完成率;三轮持续学习、困难任务零样本迁移、跨模型实验与组件消融共同支持经验闭环的有效性。与此同时,三轮实验不足以证明长期稳定进化,反思仍可能受共同模型盲点影响,感知缺失也无法靠记忆自动弥补。
一句话总结:
MUSE 的贡献不是让 Agent 多存一些历史,而是让每一次真实操作都经过证据验收,并被蒸馏成能在下一次行动中直接生效的分层经验。


评论前必须登录!
注册