 网硕互联帮助中心
文档越来越多,真正的问题却不是“存在哪里”,而是:谁能看、能不能快速找到、AI 回答有没有依据、内部知识能否继续转化为内容。
本项目是一套可私有化部署的多部门权限企业知识库。它用 Spring Boot + React 管理文档与权限,用关键词和向量检索定位知识,用 DeepSeek 完成 RAG 问答,并通过火山方舟生成可审校的微信公众号文章初稿。
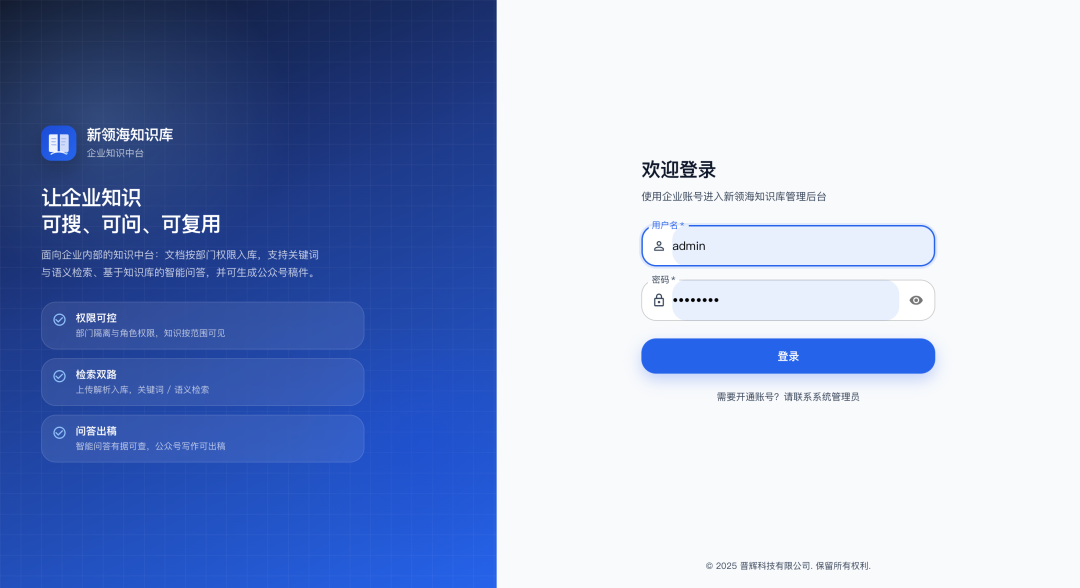
一句话看懂:
文档入库 → 部门隔离 → 分块索引 → 语义检索 → 有来源问答 → 公众号内容复用。
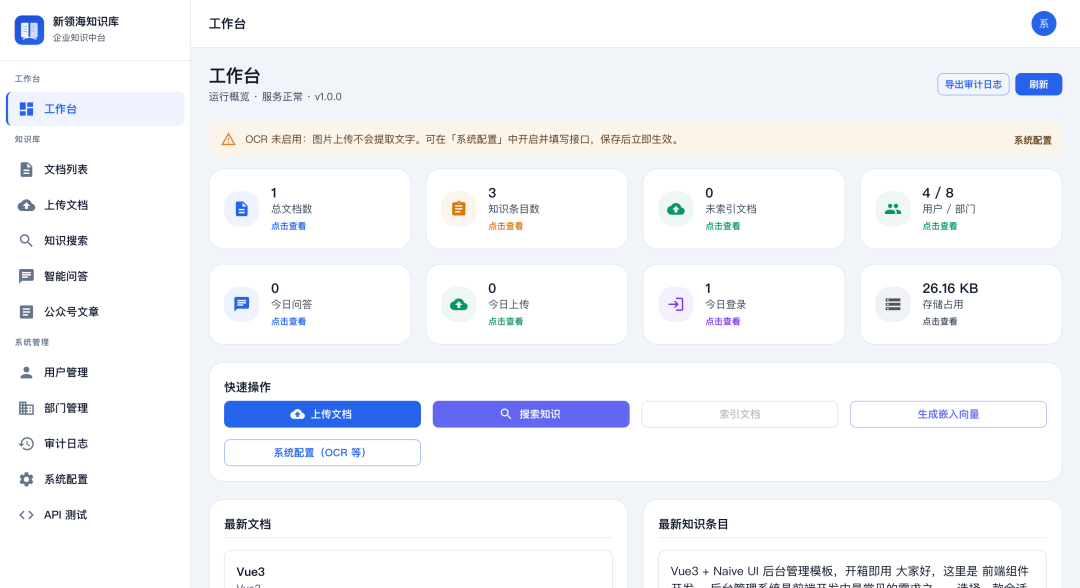
当前版本:2.1核心技术:Spring Boot 2.7、React 18、MySQL 8、DeepSeek、火山方舟、可选 Milvus
本文参考 2026 年 IT 技术内容常见的移动端编辑方式:结论前置、标题明确、短段落、少堆概念、关键步骤可执行。不存在微信官方统一的“爆款评分标准”,因此本文不做夸大承诺。
一、项目背景及简介
1.1 为什么要做
企业知识管理经常卡在四个地方:
资料散: 制度、手册和项目经验分散在网盘、群文件与个人电脑。
检索慢: 文件名记不清,关键词不一致,知道“有这份资料”却找不到。
回答虚: 通用大模型不了解企业内部事实,答案听起来合理,却无法核验。
复用难: 内部资料很多,对外写案例、公众号和项目介绍时仍要重新整理。
这个项目没有再造一个网盘,而是让文档进入一条可持续使用的知识链路:
上传原文
↓
解析并分块
↓
关键词 / 向量检索
↓
RAG 问答与来源引用
↓
公众号文章初稿与人工终审
1.2 项目能解决什么
|
存得进 |
单文件/批量上传,Tika 解析正文 |
|
找得到 |
关键词检索 + Embeddings 语义检索 |
|
问得准 |
DeepSeek RAG 问答,返回相关来源 |
|
管得住 |
RBAC + 多部门数据隔离 |
|
写得出 |
基于权限内资料生成公众号初稿 |
|
可上线 |
MySQL、Nginx、可执行 jar,支持私有化部署 |
1.3 产品边界
-
系统提供可核验的知识入口,不替代正式制度原文。
-
公众号功能生成的是可编辑初稿,不替代人工事实核验。
-
微信能力只同步到草稿箱,不自动群发。
-
小规模知识库可直接使用内存向量检索,大规模场景再接入 Milvus。
二、目标客户
2.1 适合谁
-
中大型企业: 需要部门级资料隔离和统一知识入口。
-
技术团队: 需要检索规范、API 文档、故障记录与项目经验。
-
制造与工程企业: 需要复用设备手册、SOP、项目案例和维保资料。
-
咨询与项目制团队: 需要快速查找历史方案与行业案例。
-
内容运营团队: 希望基于企业真实资料生成公众号文章初稿。
2.2 不适合谁
-
只需要个人笔记:语雀、Notion 等工具更轻。
-
需要复杂 Agent/Workflow 编排:应选择专门的 AI 应用平台。
-
希望完全无人审核自动发文:本系统明确保留人工终审环节。
三、平台定位
3.1 一句话定位
企业知识资产的“存、搜、问、写”中台。
它位于文件存储与通用大模型之间:先解决权限和知识检索,再让 AI 基于可见资料回答和写作。
3.2 与普通网盘、通用大模型的区别
|
文档管理 |
有 |
无 |
有 |
|
部门权限 |
基础目录权限 |
无企业边界 |
全链路部门过滤 |
|
语义检索 |
通常较弱 |
不检索企业资料 |
关键词 + 向量 |
|
回答依据 |
无问答 |
依赖模型记忆 |
优先引用知识条目 |
|
内容复用 |
人工整理 |
容易脱离企业事实 |
权限内取材后生成初稿 |
|
部署方式 |
SaaS/私有化 |
多为外部服务 |
支持私有化部署 |
3.3 核心差异
权限不是页面筛选,而是后端接口级约束。
问答不是裸聊,而是检索增强生成(RAG)。
写稿不是凭空创作,而是优先复用企业知识。
AI 能力可选,关键词检索等基础链路仍可独立工作。
四、平台技术与系统架构
4.1 整体架构
flowchart LR
U[浏览器] –> N[Nginx /knowledgeWeb]
N –> F[React 18 管理后台]
N –> B[Spring Boot 2.7 API]
B –> DB[(MySQL 8 / H2)]
B –> FS[本地文件存储]
B –> AI[DeepSeek / 火山方舟 / Embeddings]
B –> V[(可选 Milvus)]
B –> WX[可选微信草稿箱]
4.2 核心技术栈
|
前端 |
React 18、TypeScript、MUI、Axios |
管理后台、路由、表单、状态与 API 调用 |
|
后端 |
Java 8、Spring Boot 2.7.17 |
REST API、业务逻辑与可执行 jar |
|
安全 |
Spring Security、JWT、BCrypt |
登录认证、角色授权与接口保护 |
|
数据 |
JPA、MySQL 8、H2 |
业务数据、本地开发与测试 |
|
文档 |
Apache Tika 2.9 |
PDF、Office、TXT、HTML 等正文抽取 |
|
AI |
DeepSeek、火山方舟、Embeddings |
问答、写稿与语义向量 |
|
向量 |
内存余弦相似度 / Milvus |
小库检索与可选大规模 ANN |
|
工程 |
Maven、Playwright、Nginx |
构建、自动化测试与生产部署 |
4.3 四条核心业务链路
文档入库
上传 → Tika 解析 → 文档落库 → process-and-index → KnowledgeEntry 分块 → 可选向量化
智能搜索
查询 → 部门权限过滤 → 关键词/向量召回 → 相似度排序 → 返回来源
智能问答
问题 → 检索知识条目 → 组装上下文 → DeepSeek 生成 → 保存会话与来源
公众号写作
主题 → 权限内取材 → 火山方舟生成 → 富文本复制/草稿箱 → 人工终审
4.4 权限与配置
登录后由 JWT 标识用户,@PreAuthorize 控制角色,PermissionUtil 继续按 department_id 过滤数据。
运行时配置保存在 data/runtime-settings.json,系统配置页保存后生效:
-
DeepSeek 智能问答
-
火山方舟公众号写稿
-
Embeddings 语义检索
-
微信公众号草稿同步
-
OCR
五、平台核心业务功能
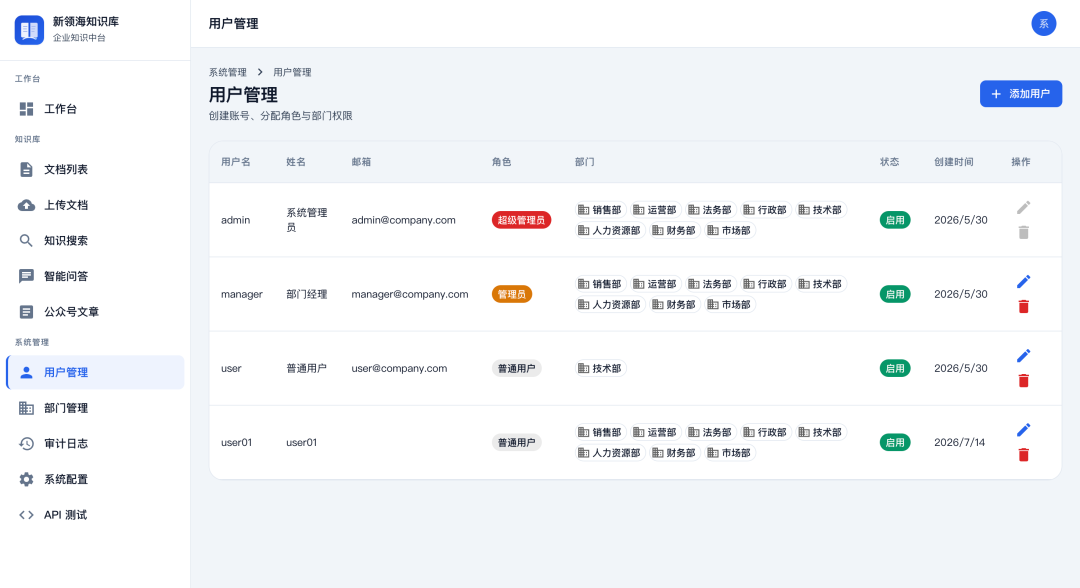
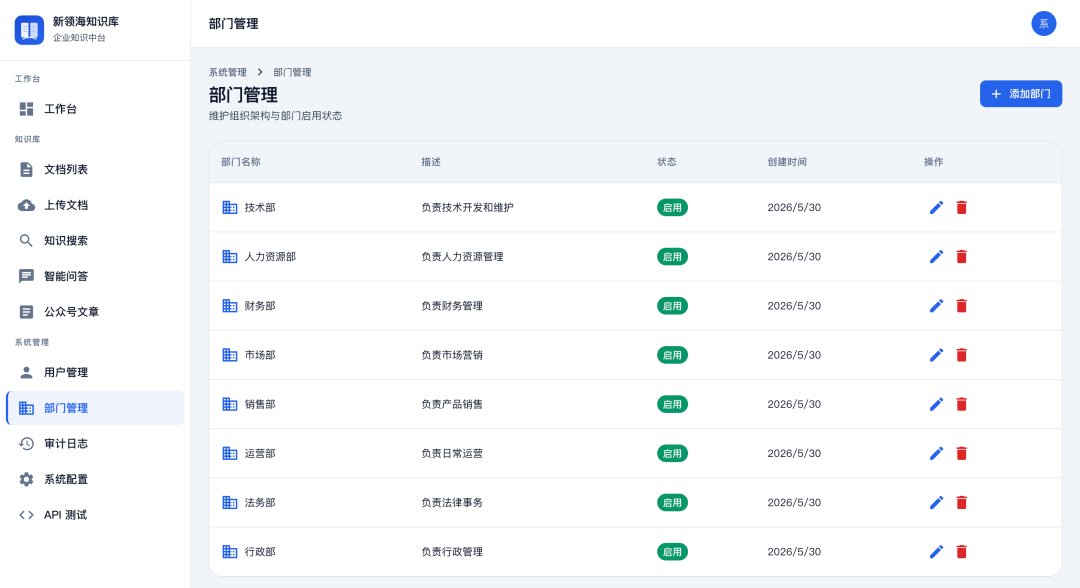
5.1 用户与部门权限
| SUPER_ADMIN |
全系统、全部门、用户、配置与审计 |
| ADMIN |
本部门文档、搜索、问答等业务 |
| USER |
所属部门内的日常查询与使用 |
用户可关联多个部门。文档、搜索、问答和公众号取材均按可见部门过滤。
5.2 文档管理与知识索引
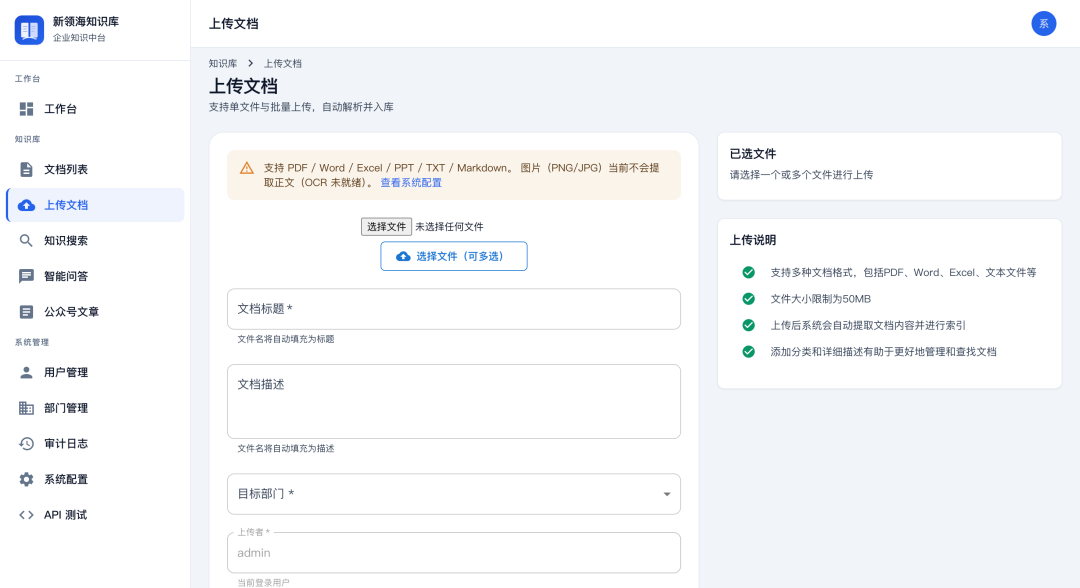
-
支持 PDF、Office、TXT、Markdown、HTML 等常见格式。
-
支持单文件与批量上传。
-
上传后调用 process-and-index 生成知识条目。
-
支持分类、部门归属、索引状态与删除操作。
-
Embeddings 不可用时仍可使用关键词检索。
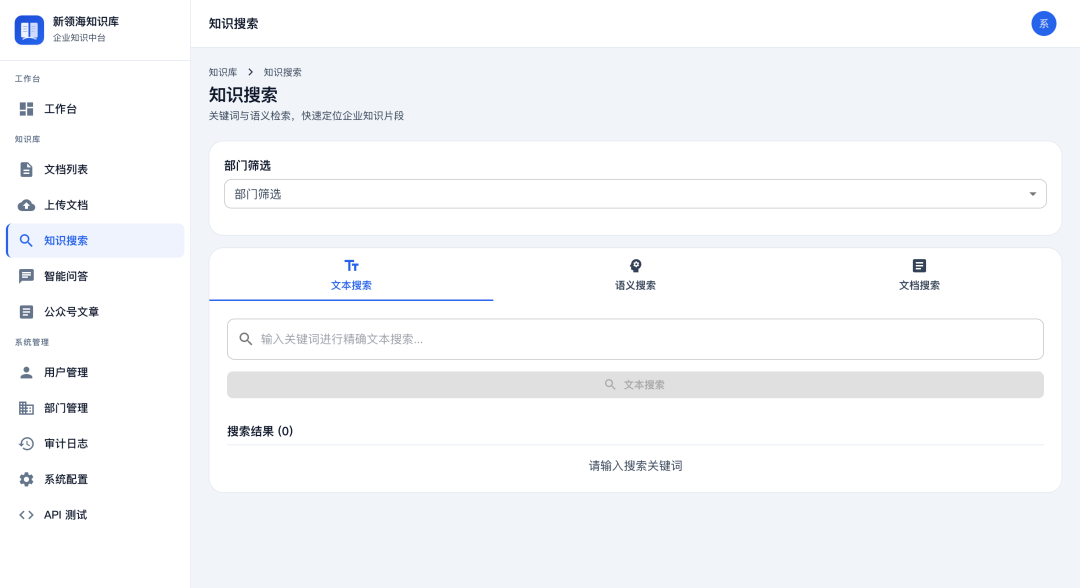
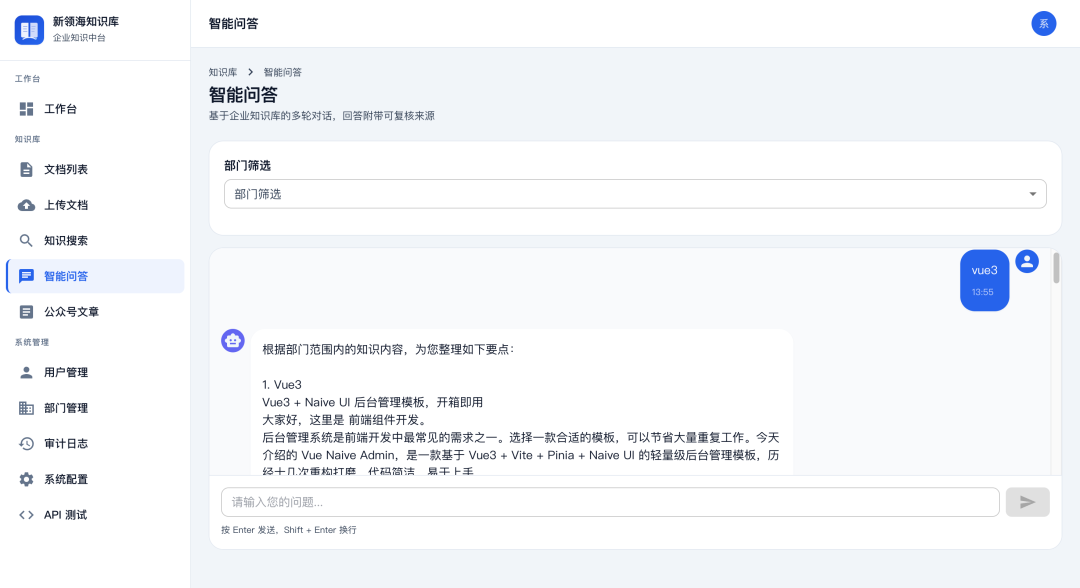
5.3 智能搜索与 RAG 问答
-
关键词检索负责稳定兜底。
-
向量检索解决“意思相同、措辞不同”的召回问题。
-
问答支持多轮会话和来源引用。
-
会话按用户隔离,不能读取他人的 sessionId。
-
DeepSeek 未配置或不可用时,可退回本地知识片段整理。
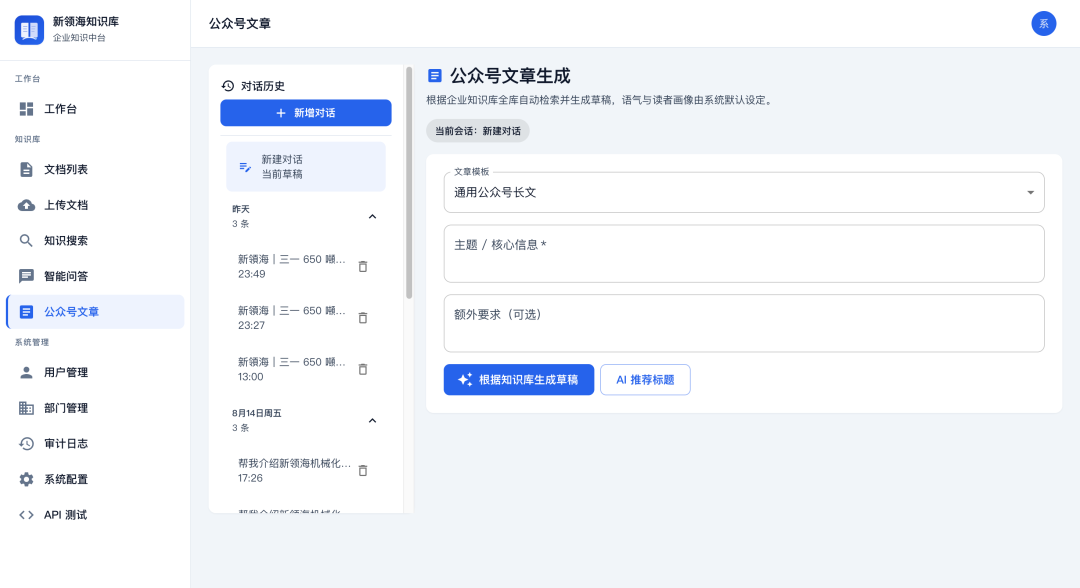
5.4 公众号文章助手
系统先检索用户权限范围内的知识,再调用火山方舟生成文章。
默认模型:doubao-seed-2-1-turbo-260628深度思考: 默认关闭,codeplan.thinking=disabled
当前体验包括:
-
预计生成进度条
-
今天/昨天/更早的历史分组与折叠
-
单条历史删除
-
富文本“复制到公众号”
-
Markdown 复制
-
可选同步到微信草稿箱
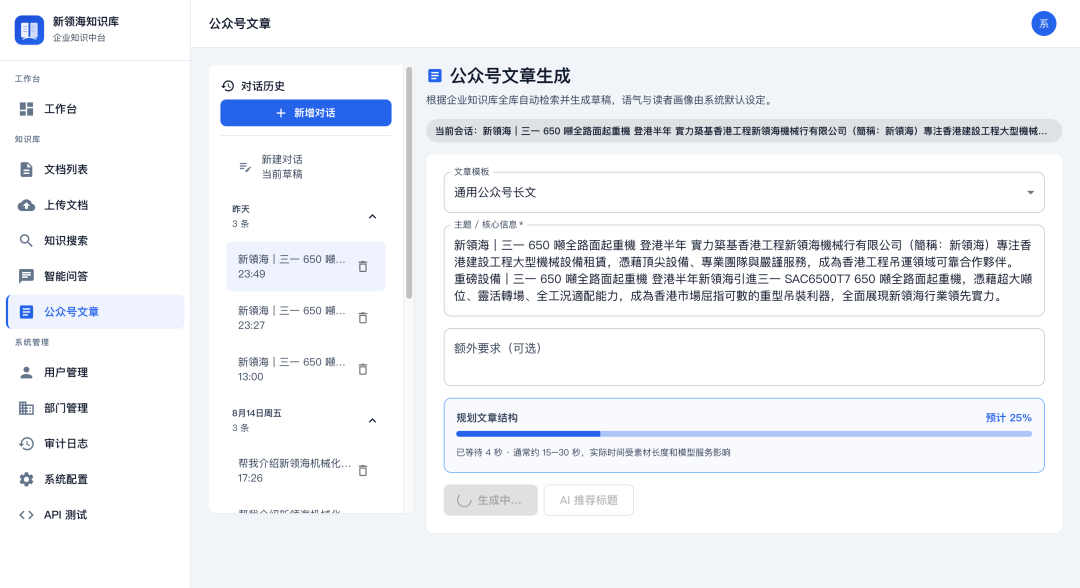
当前生成接口为非流式。固定业务开销较小,等待时间主要取决于模型输出字数。进度条是体验层估算,并非真实 Token 进度。
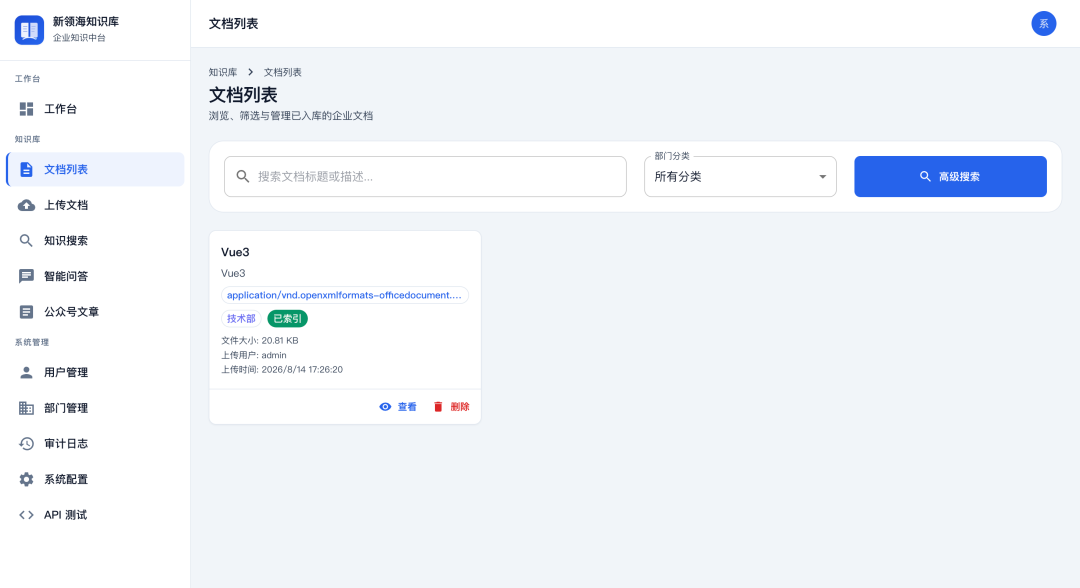
5.5 工作台与系统管理
-
总文档、知识条目、未索引文档、用户/部门等统计。
-
今日问答、上传、登录及存储占用。
-
统计卡片可点击进入对应业务页面。
-
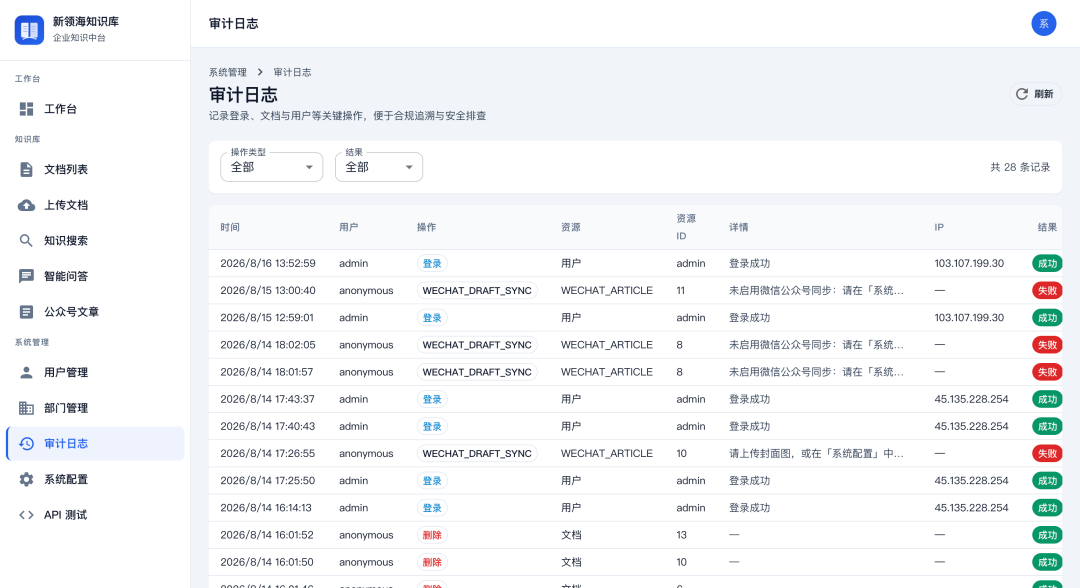
用户、部门、运行时配置和审计日志集中管理。
六、平台独特优势
6.1 权限贯穿完整链路
部门权限不仅作用于文档列表,也覆盖搜索、问答和公众号取材,避免前端隐藏但后端仍可访问的问题。
6.2 AI 可增强,也可降级
Embeddings 或 DeepSeek 暂时不可用时,系统仍保留关键词检索与本地知识整理能力,避免所有功能绑定单一外部服务。
6.3 对内知识可以继续对外复用
同一批经过权限管理的资料,既服务内部查询,也可用于公众号初稿,减少重复整理素材。
6.4 适合 Java 技术体系私有化落地
后端为 Spring Boot 可执行 jar,前端为静态资源,生产环境可使用 MySQL + Nginx;对于已有 Java 运维体系的企业,上手路径清晰。
6.5 小库轻量,大库可扩展
小型知识库无需先部署 Milvus;数据量增长后,可通过 -Pwith-milvus 构建并接入 Milvus ANN 检索。
七、平台安装使用
7.1 环境要求
-
JDK 8+
-
Maven 3.6+
-
Node.js 16+
-
MySQL 8(本地开发可使用 H2)
-
Nginx 1.18+(生产推荐)
7.2 本地启动
# 后端:H2,默认 8080
cd backend
mvn spring-boot:run -Dspring-boot.run.profiles=local
# 前端:默认 3000
cd frontend
npm install
npm start
访问:http://localhost:3000/本地账号:admin / admin123
7.3 生产构建
# 后端默认包
cd backend
mvn clean package -DskipTests
# 产物:backend/target/knowledgebase.jar
# 前端
cd ../frontend
npm install
npm run build
# 产物:frontend/build/
需要 Milvus SDK 时:
cd backend
mvn clean package -DskipTests -Pwith-milvus
7.4 生产运行
java -Xms512m -Xmx1024m \\
-jar backend/target/knowledgebase.jar \\
–spring.profiles.active=prod
建议通过环境变量提供数据库密码、JWT Secret 和外部 API Key,不要提交到仓库。
关键配置:
server.port=13085
deepseek.api.key=${DEEPSEEK_API_KEY:}
codeplan.api.key=${CODEPLAN_API_KEY:}
codeplan.model=${CODEPLAN_MODEL:doubao-seed-2-1-turbo-260628}
codeplan.thinking=${CODEPLAN_THINKING:disabled}
embeddings.enabled=${EMBEDDINGS_ENABLED:true}
milvus.enabled=${MILVUS_ENABLED:false}
7.5 Nginx 核心配置
location /knowledgeWeb/ {
alias /etc/www/website/knowledgeWeb/;
try_files $uri $uri/ /knowledgeWeb/index.html;
}
location /knowledgeWeb/api/ {
proxy_pass http://127.0.0.1:13085/api/;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
}
完整示例见 nginx.conf。
7.6 验证与测试
# 健康检查
curl http://127.0.0.1:13085/api/auth/health
# 后端测试
cd backend && mvn test
# 前后端 E2E
cd e2e
npm install
npx playwright install chromium
npm test
产品操作手册:docs/product-manual/企业知识中台-产品使用操作手册.pdf
八、应用场景及使用案例说明
8.1 制造业:设备手册与 SOP
资料: 设备说明书、工艺文件、质量标准、维修记录。
路径: 批量入库 → 部门隔离 → 员工提问 → 查看来源原文。
价值: 减少翻找长篇 PDF 和重复咨询,安全与质量要求仍以正式文件为准。
8.2 工程与设备服务:项目内容复用
资料: 设备参数、项目案例、施工方案、维保能力。
路径: 搜索历史案例 → 生成项目介绍或公众号初稿 → 核对参数 → 复制到公众号。
价值: 减少重复整理,提高企业对外内容的一致性。
8.3 技术团队:规范与故障经验
资料: API 文档、编码规范、部署手册、故障复盘。
路径: 按项目入库 → 语义搜索 → RAG 问答 → 来源核验。
价值: 帮助新人快速定位资料,让经验留在知识库而不是聊天记录里。
8.4 咨询与培训:案例和制度查询
资料: 历史方案、培训课件、员工手册、流程与 FAQ。
路径: 按部门/行业隔离 → 搜索相似内容 → 提炼要点 → 人工调整。
价值: 提高资料复用率,建立统一知识入口。
8.5 落地建议
先统一分类、命名和部门边界,再批量迁移。
优先导入高频、正式、仍有效的文档。
问答效果不好时,先检查知识条目和来源,不要只调模型。
定期清理过期资料,避免新旧制度同时被召回。
公众号文章必须核对数字、型号、客户名称和敏感信息。
知识库体验:
知识库新版已经部署: https://jinhuitech.top/knowledgeWeb/管理员账号:manager 密码: admin123普通账号:user 密码: user123


评论前必须登录!
注册