 网硕互联帮助中心
单日 2,305 个 star,占它全部星标的 28%。这个 Go 项目把 YAML、apply、describe 那一整套,原封不动搬给了 AI Agent
一、今天的 GitHub 日榜,被一个 Go 项目刷屏了
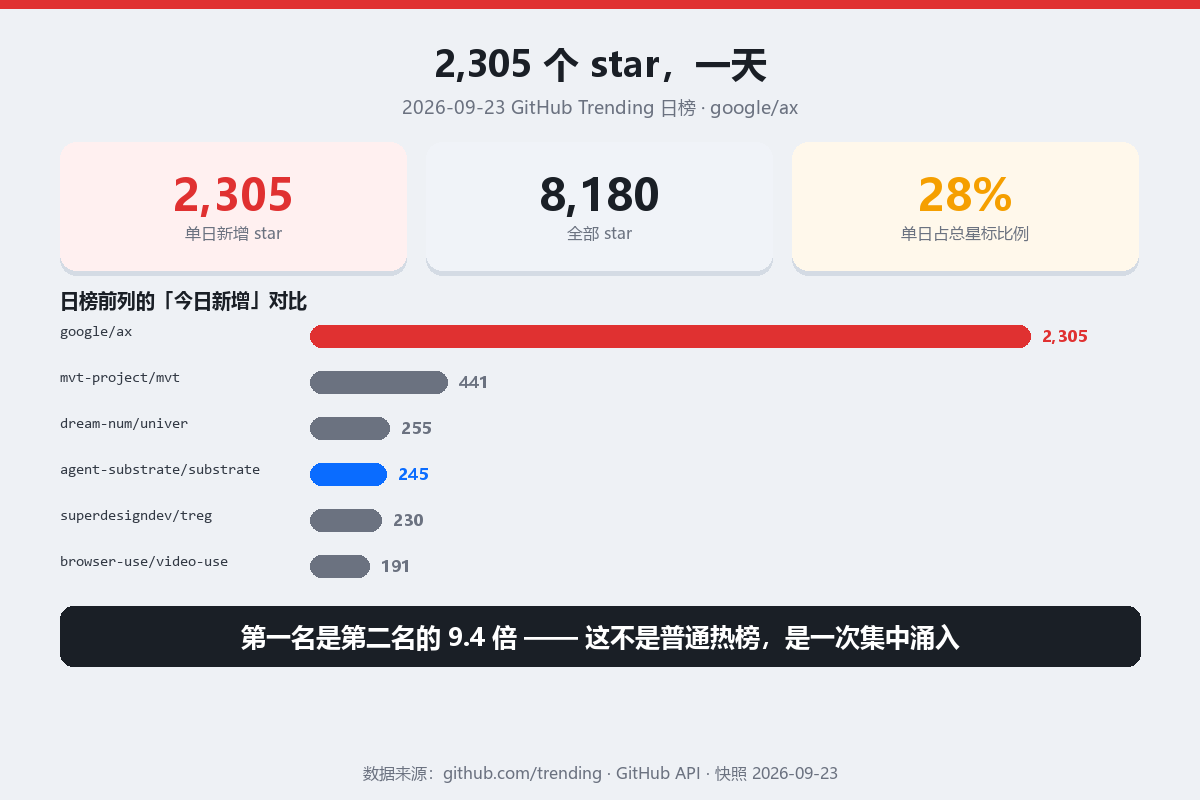
2026 年 9 月 23 日的 GitHub Trending 日榜,第一名和第二名之间有一道断层。
第一名是 google/ax,单日新增 2,305 个 star。第二名是 245 个。
这个倍数值得停下来看一眼:它不是一个"正常"的热榜数字,而是一次集中的注意力涌入。
更值得看的是这 2,305 意味着什么。截至今天,google/ax 的全部 star 数是 8,180。也就是说,它建仓半年积累下来的星标里,有 28% 是今天一天涨的。
这个仓库 2026 年 3 月 30 日创建,Apache 2.0 协议,Go 语言,最后一次代码提交停在 9 月 20 日——今天并没有发新版,也没有发公告。它是被开发者自己翻出来的。
那它到底是什么?
仓库的描述只有一行:Google’s open agentic orchestration runtime(Google 开源的 Agent 编排运行时)。
官网 agentexecutor.io 的标题更直白:
Declare an agentic task. AX runs it at scale.
声明一个 Agent 任务,AX 负责大规模地跑起来。
如果你是个写过 YAML 的后端,看到"声明式"“运行时”"at scale"这三个词连在一起,脑子里应该已经跳出一个东西了。往下看,你会发现自己没猜错。
二、它把 Agent 当"工作负载",不是"应用"
理解 ax 的关键,是它对自己要解决的问题的定性。README 的 “Why” 部分只有一段话,但这段话是整个项目的出发点:
Agents are a new kind of workload. They are neither stateless microservices nor run-to-completion batch jobs.
Agent 是一种新的工作负载。它既不是无状态微服务,也不是跑完就结束的批处理任务。
官网把这句话展开得更具体:
它们会累积状态、需要严格隔离、要调用模型 API 和工具服务器,而且——如果没有人盯着——会在循环里持续浪费资源。
最后半句是重点。传统编排系统面对的是"进程",进程跑飞了大不了杀掉重启;Agent 面对的是"会花钱的循环",一个卡住的 Agent 能安安静静烧掉一整晚的 token 预算。
而现有工具都不对口:
- 拿无状态微服务的那套来编排 Agent,会一直为闲置的沙箱付费——Agent 大部分时间在等模型返回、等工具返回、等人审批,这段时间它什么也不干,但你得让它活着
- 拿批处理作业的那套来编排 Agent,又缺少原生的挂起与恢复能力——批处理的世界里没有"暂停三秒再从中断处精确继续"这种需求
所以 ax 的结论是:这两条路都不行,得为 Agent 单造一个控制平面。
三、四个原语,就是四个 kubectl 动作
ax 的 API 长得非常眼熟。清单的 apiVersion 是 ax.io/v1alpha1,写法是标准的 kind + metadata + spec。
它把 Agent 跑起来需要的东西拆成四个原语:
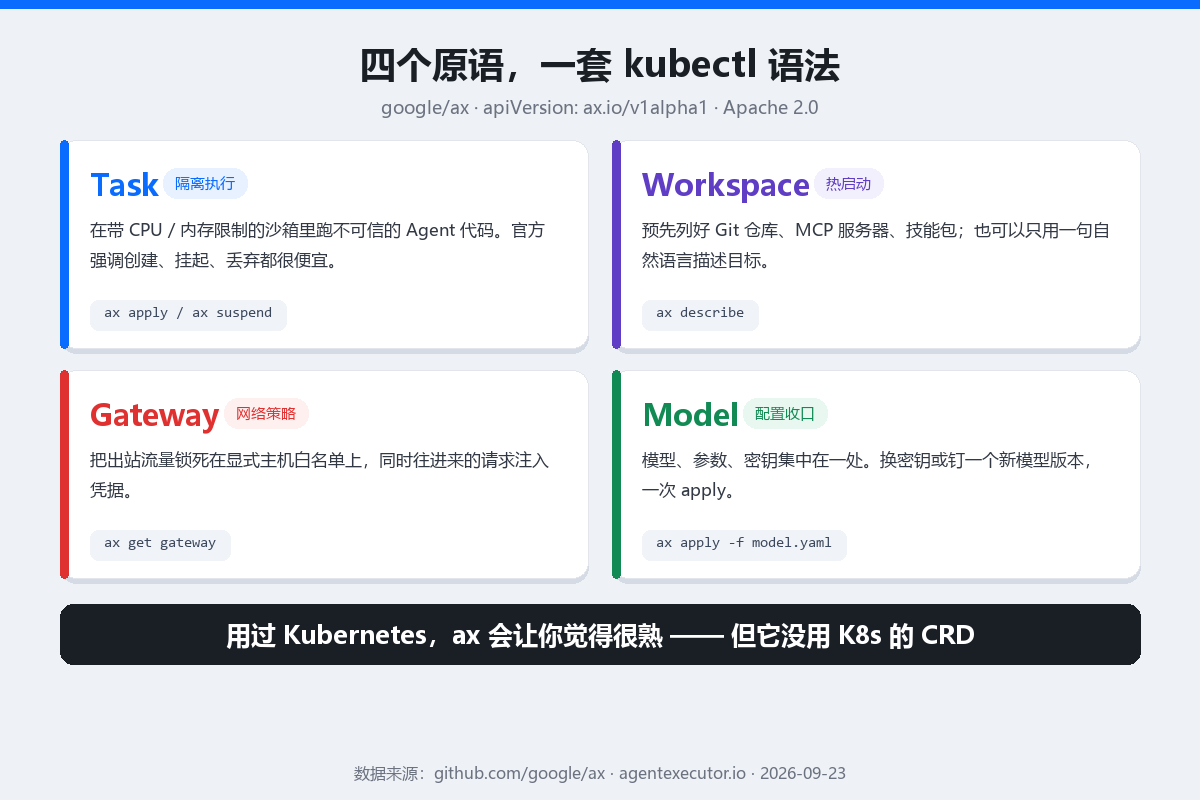
- Task:在带 CPU 和内存限制的沙箱里跑不可信的 Agent 代码。官方强调它"创建、挂起、丢弃都很便宜"
- Workspace:预先把 Git 仓库、MCP 服务器、技能包配好,让每个 Agent"热启动"。可以直接列清单,也可以只用一句自然语言描述目标
- Gateway:把 Agent 的出站流量锁死在一份显式的主机白名单上,同时往进来的请求里注入凭据
- Model:模型、模型参数、密钥集中在一处配置,换密钥或钉一个新模型版本只需要一次 apply
命令行更直接。ax 的 CLI 刻意做成了 kubectl 的形态:
- ax apply / ax get / ax describe / ax watch / ax delete
- 以及 Agent 特有的 ax ssh(钻进正在跑的 Agent 里看它在干什么)、ax suspend / ax resume
它甚至兼容 kubectx,能跟着当前活跃的 Kubernetes 上下文切集群。
README 里有一句写得毫不掩饰:If you have used Kubernetes, ax will feel similar. 如果你用过 Kubernetes,ax 会让你觉得很熟。
四、最反直觉的一个技术选择:它没用 K8s 的 CRD
到这里你可能会想:既然做得这么像 K8s,那它应该就是一组 CRD 加几个 controller 吧?
不是。这是整个项目里最值得琢磨的一个决定。
ax 拆成了三个二进制:
- ax-server:对外暴露 gRPC API,接收 Task 清单
- ax-controller:可水平扩展的 reconciler,从 Redis Streams 消费工作
- ax-task-runner:在沙箱化的 worker 里真正执行任务
注意第二行——任务状态存在 Redis 里,不是存进 Kubernetes 的 CRD。
理由说得很清楚:为了不给 etcd 造成压力。
这是个很工程化的取舍。Kubernetes 的 CRD 是给"数量有限、生命周期较长、需要被反复 reconcile"的对象设计的。而 Agent 任务的特征是数量极多、生命周期极短。官方给出的目标量级是"单集群十亿个任务"——这个数量级的短生命周期对象塞进 etcd,会把整个集群的元数据层压垮。
所以 ax 做了个很务实的切割:借 K8s 的语法和心智模型,但不借 K8s 的存储。
用起来像 Kubernetes,是给开发者的;底层不真的依赖 Kubernetes 的那套机制,是给运维的。
五、“十亿个任务"和"亚秒级恢复”
官网给三个数字,每一个都对应一个具体的工程问题。
十亿个任务。 每个任务是一个轻量级的 actor,所以单集群可以扩展到十亿个并发的 Agent 会话,而不会撞上编排器本身的上限。这个数字大概率是设计目标而不是实测值——但它决定了架构必须是"任务状态与编排器解耦"的,前面说的 Redis 那个选择,就是为了这个数字服务的。
亚秒级恢复。 空闲的 Agent(在等模型响应、等外部工具调用、等人审批)会被检查点化、挂起,然后在一秒以内被拉回来,且没有冷启动延迟。这条直击前面说的"为闲置付费"问题——传统编排器让闲置沙箱一直跑着,成本高得离谱;ax 让"等"这件事本身变得几乎免费。
密集复用。 几十个任务共享同一批 worker 资源,把"等"的时间变成可用的算力。官方的说法是:你只为 Agent 真正在思考和跑代码的时间付费。
这三个数字连起来看,ax 想做的事就清楚了:它不是在帮你会写 Agent,它是在帮你把 Agent 的账单打下来。
顺带一个细节:官方文档的示例里出现的模型是 gemini-3.8-flash。这个选择本身也说明了它假设的工作负载形态——高频、短、量大。
六、它的底座今天也在榜上
还有个细节容易被忽略:同一天的 GitHub 日榜上,ax 的底座也在。
agent-substrate/substrate,今天新增 245 个 star,总星标 3,192。仓库描述只有一句 “Agent Substrate: the core system”。
ax 官方说得很清楚:它重度依赖 Agent Substrate 来做沙箱化执行,自己只负责提供 Agent 层面的抽象和生成式运行时组件。
两个仓库,一个是上层编排,一个是底层执行,同一天一起出现在热榜上。这不是巧合,是一个技术栈被整体发现的信号。
有意思的是这两个仓库的状态差异:
- google/ax:8,180 star,36 个 open issue,37 个 watcher
- agent-substrate/substrate:3,192 star,525 个 open issue,24 个 watcher
substrate 的 issue 数是 ax 的十四倍还多,而 star 数只有它的四成。这个比例通常意味着:用的人已经比看懂的人多了。 底层在执行上被真实踩到的坑,远多于上层编排。
另外,ax 自己在 README 里挂了一句风险提示:项目仍在积极完善核心概念、协议和规范,在稳定版本发布前可能引入破坏性变更。
换句话说:这东西现在是"可以看、可以试、别急着上生产"的状态。
七、把镜头拉远:这一周的 GitHub 在说什么
单个项目刷榜可能是偶然。但如果把日榜和周榜放在一起看,信号就很一致了。
本周 GitHub Trending 前 12 名里,AI 编码 Agent 主题占了大半:
- alibaba/open-code-review:39,987 star,一周涨 12,590。混合架构的代码审查工具——确定性流水线 + LLM Agent,支持精确行级评论,内置多语言规则集(空指针、线程安全、XSS、SQL 注入)。这是本周的增长冠军之一,而且方向很明确:用 Agent 去做本来靠人工 review 的事
- anthropics/claude-code:147,723 star,一周涨 2,754。终端里的编码 Agent
- affaan-m/ECC:265,758 star,一周涨 6,904。给 Claude Code、Codex、Opencode、Cursor 提供技能、直觉、记忆和安全能力
- addyosmani/agent-skills:98,571 star,一周涨 4,224。面向 AI 编码 Agent 的生产级工程技能
- stablyai/orca:76,071 star,一周涨 6,205。用来管理并行 Agent 集群的 ADE,可以用自己的订阅跑任意编码 Agent,支持桌面、移动和远程运行时
- Tencent/WeKnora:29,187 star,一周涨 5,303。把原始文档变成可查询 RAG、自主推理 Agent 和自维护 Wiki
- JustVugg/colibri:37,232 star,一周涨 4,036。纯 C 实现、零依赖,把前沿 MoE 模型跑在自己的硬件上
- cloudflare/security-audit-skill:一周涨 15,381,本周增速最猛的项目之一
再看今天的日榜,除了 ax 和 substrate:
- dream-num/univer(255):The Office Harness for AI Agents——表格、文档、幻灯片、画布、关系表、PDF 全在一个运行时里
- mvt-project/mvt(441):移动设备取证工具,用来在手机里找被入侵的痕迹
- superdesigndev/treg(230):自称"Agent 工具的 OpenRouter"
- browser-use/video-use(191):用编码 Agent 剪视频
把这些名字排在一起,会看到三件事:
第一,Agent 已经从"应用"变成了"基础设施"。 榜上真正在做模型的公司不多,绝大多数在做的是围着 Agent 转的周边——技能、记忆、集群管理、代码审查、办公套件、编排运行时。
第二,编排层是最后一块被补上的拼图。 技能有了、记忆有了、集群管理有了,但"怎么把成千上万个 Agent 可靠地调度起来"这件事,在 ax 之前没有一个来自大厂的、声明式的、开源的标准答案。
第三,安全正在变成一个独立赛道。 cloudflare/security-audit-skill 一周 15,381 个 star,mvt 单日 441——和 Agent 相关的是"用 Agent 审代码",和设备相关的是"查设备有没有被入侵"。这和我们前两天写过的那篇 Plugin4Shell 是同一个方向:当 Agent 拿到真实权限,安全问题的性质就变了。
八、一个 2014 年的既视感
把上面这些放在一起,很难不想到容器那一段历史。
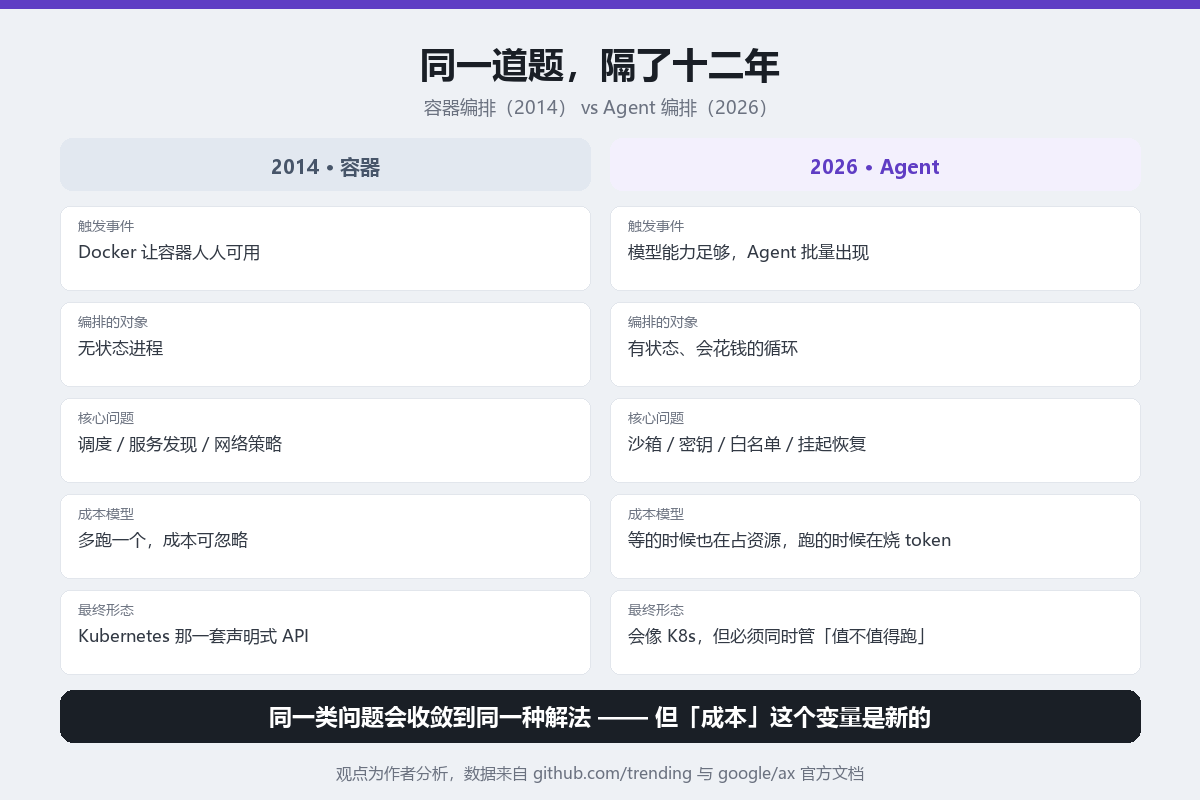
2014 年前后,Docker 把容器这件事变得人人可用,但紧接着所有人发现:能跑起来一个容器,和能管理一万个容器,是完全不同的两个问题。 于是调度、编排、服务发现、网络策略、密钥管理这些事被逐个抽象出来,最后收敛成了 Kubernetes 那一套声明式 API。
今天的 Agent 走到了同一个位置。
单个 Agent 不难,一个 while 循环加几次工具调用就能跑。但一旦你要同时跑几百上千个,问题立刻变成:它跑在哪个沙箱里?它的密钥从哪来?它能访问哪些地址?它卡住了怎么办?它挂起之后还能不能精确恢复?它一晚花了多少钱?
这些问题的答案,和当年容器编排要回答的问题,结构上几乎一模一样。
所以 ax 的形态其实是可以预判的:声明式 API、YAML 清单、apply/get/describe 这一套动词、把策略和数据面切开。 这不是 Google 在抄 Kubernetes,而是同一类问题会自然收敛到同一种解法。
真正有意思的不是"它们像",而是它们哪里不一样。
九、但这次多了一个新变量:钱
Kubernetes 编排的是无状态进程。进程是免费的——多跑一个容器,成本可以忽略;跑飞了,杀掉重启就行。
Agent 不是。Agent 的每一次思考都要花钱,而且它在等的时候也在占用资源,在跑的时候在烧 token。
这是本质区别。它直接改写了编排系统的设计目标:
- 传统编排器优化的目标是吞吐和可用性
- Agent 编排器必须同时优化成本——因为"一直开着"这件事在 Agent 场景下是真的会破产的
回头看 ax 那三个数字,全都是在回答成本问题:
- 亚秒级挂起恢复:让"等"不花钱
- 密集复用:让闲置算力不浪费
- 十亿任务:让单位成本随规模下降
官网有一句话把这件事说得很坦白:“you only pay when agents are actively thinking and running code”——你只为 Agent 真正在思考和跑代码的时候付费。
这句话如果放到 2014 年,容器世界里是没有人会这么说的。因为那时候"一直开着"不贵。
所以 Agent 编排的最终形态,可能不会长得像 Kubernetes。 它会更像 Kubernetes 和云成本管理系统的合体——一套既要管"能不能跑对",又要管"值不值得跑"的控制平面。
十、那现在该做什么
具体到 google/ax 这个项目:
- 值得花半小时读 README 和 docs/concepts.md。 它把 Task / Workspace / Gateway / Model 四个原语的边界划得很清楚,这套抽象不管最后是不是它胜出,都会影响后面一批产品的设计
- 别急着上生产。 项目自己写了"稳定版之前可能有破坏性变更"。API 还是 v1alpha1,这个版本号本身就是提示
- Gateway 那个原语值得单独看。 “把出站流量锁死在一份显式主机白名单上”——如果你读过 Plugin4Shell,会知道 Agent 的插件供应链最缺的就是这一层
- 如果你在选型,先问自己一个问题: 你是在跑"几个 Agent",还是在跑"一批 Agent"?前者用现成的 CLI 工具就够了,ax 这类东西的价值要到几百个以上才显现
更值得记住的是那个趋势本身。
过去两年,AI 工程的重心从"提示词"移到"上下文",再移到"Agent"。而这一周的 GitHub 热榜在说:下一站是"运行时"。
当模型能力不再是最稀缺的资源,能不能把成百上千个 Agent 可靠、便宜、安全地跑起来,就会变成真正的分水岭。
2014 年没人在意容器编排,觉得那是运维的活。两年后,它成了所有后端工程师的必备技能。
这次可能不用两年。
关于本文
本文的数据来自 2026 年 9 月 23 日抓取的 GitHub Trending 日榜与周榜页面,以及 GitHub 官方 API 返回的仓库实时数据(google/ax、agent-substrate/substrate)。项目定位与技术细节来自 github.com/google/ax 的 README 与官方文档、官网 agentexecutor.io。文中所有 star 数、fork 数、issue 数与时间均为抓取时刻的快照,会随时间变化。项目自述仍处于稳定版发布前,API 与概念可能发生破坏性变更。
如果你也在用 AI 处理日常工作和资料整理,WorkBuddy 是我自己在用的一个选择——它把文档处理、数据分析和多步任务编排放在同一个对话里完成,省掉了很多在工具之间来回切换的时间。


评论前必须登录!
注册