 网硕互联帮助中心
把矩阵拆成秩一叠加:奇异值分解、条件数与低秩逼近在算什么
一、一个具体的矩阵,把单位球拉成了什么形状
先摆一个 3×3 的整数矩阵,它只有九个数字:
A = [[ 1, 2, 3],
[ 4, 5, 6],
[ 7, 8, 10]]
矩阵可以看成一个动作:给它一个向量,它吐出另一个向量。把单位球面上所有的向量都喂进去,出来的像是一个椭球——矩阵做的事情无非是把球捏成椭球,椭球的三个半轴长度就是三个奇异值:
17.412505166809 0.875161350110 0.196866521117
三个数放在一起就已经说清了这台「机器」的性格。最长的那根半轴是 17.412505166809,最短的那根只有 0.196866521117,相差 88 倍多。任何落在最短半轴方向上的输入,都会被压到原来的五分之一左右;任何落在最长半轴方向上的输入,会被放大十七倍多。这两个方向的比值有一个专门的名字——条件数:
条件数 = 最长半轴 / 最短半轴 = 17.412505166809 / 0.196866521117 = 88.448279920699
还有一条随手可验的关系:三个奇异值乘起来等于 3.000000000000,而这个矩阵的行列式是 −3。这不是巧合,下一节会把它说清楚。
三维的椭球画在纸上不好看,所以先用一个二维的同类例子把图景立起来。取
B = [[1, 1],
[0, 1]]
它把平面上的单位圆(圆上每一点到原点距离都是 1)变成一个椭圆。这个椭圆的半轴长是 1.618033988750 与 0.618033988750——正好是黄金比 φ 与它的倒数 1/φ,条件数是 2.618033988750,也就是 φ²。
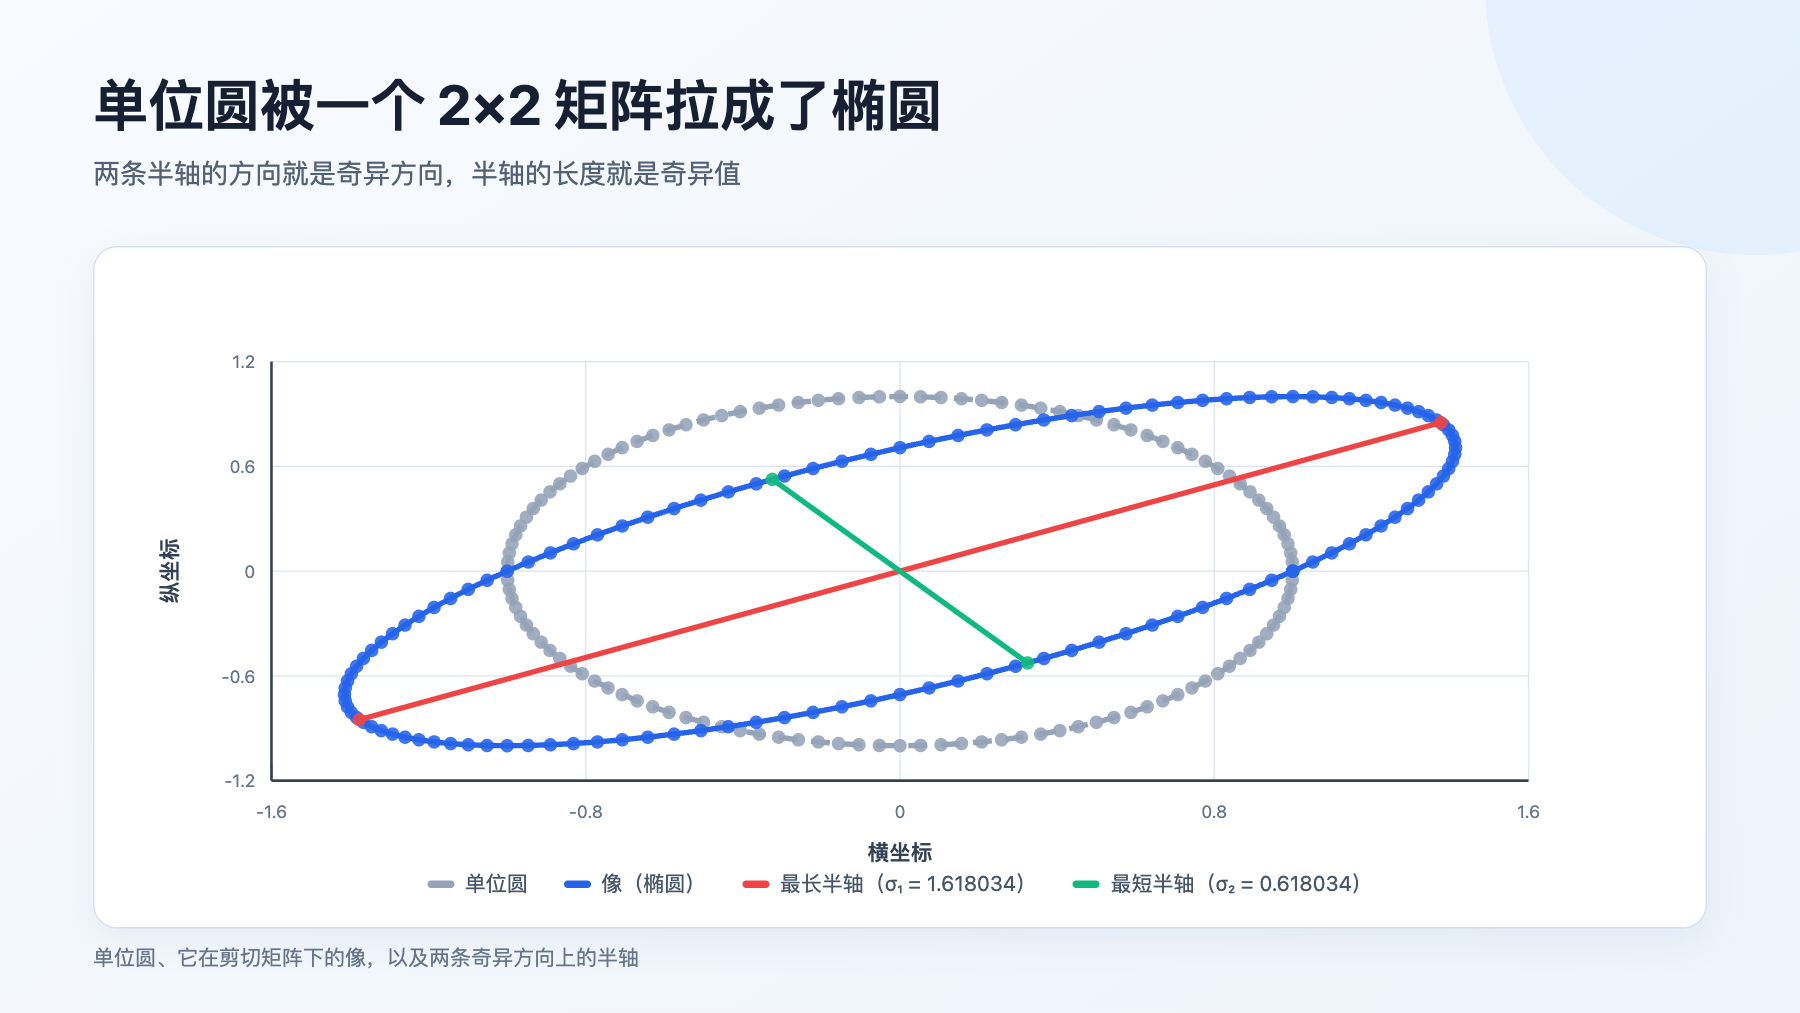
图 1:单位圆、它在剪切矩阵下的像,以及两条奇异方向上的半轴
图 1 里有两个圆和两种线。虚线是原来的单位圆;实线是它被 B 作用之后的像——一个斜着躺的椭圆。两条短线段是椭圆的两条半轴,它们的方向就是「输入空间里最值得关心」的两个方向:沿其中一条输入,输出被拉得最长;沿另一条输入,输出缩得最短。值得留意的是这两条半轴彼此垂直——这一点不是这个例子的巧合,而是所有矩阵共同的性质:椭圆的两条半轴永远是垂直的,而它们对应的输入方向也永远是垂直的。这两组互相垂直的方向,就是下一节的主角。
二、三个动作:转一下、沿互相垂直的方向各自拉伸、再转一下
奇异值分解说的就是这句话:
A = U Σ Vᵀ
其中 V 的列是一组互相垂直的单位向量(输入方向),U 的列是另一组互相垂直的单位向量(输出方向),Σ 是一个对角矩阵,对角元就是那串按从大到小排好的奇异值。把这个式子从右往左读,就是三个动作:
- 先把输入向量按 V 的这组方向重新描述一遍(相当于转一下坐标架);
- 然后每个方向上的分量各自乘一个系数 σᵢ——有的被放大,有的被缩小,互不干扰;
- 最后按 U 的这组方向拼回输出向量(再转一下)。
两个「转」都是正交变换,不改变长度;所有改变长度的活都交给中间那一步的对角矩阵 [1]。这也解释了为什么奇异值一定是非负的、而且总可以按降序排列:它们是一组长度,顺序只是书写习惯。
三个概念在这里要分清楚,它们的地位并不相同:
- 两组方向(U 与 V)回答「哪些方向是特殊的」;
- 奇异值(Σ 的对角元)回答「这些方向上各自被放大多少倍」;
- 由奇异值派生出来的量——秩、条件数、截断误差——回答「这个矩阵在具体任务里会表现成什么样」。
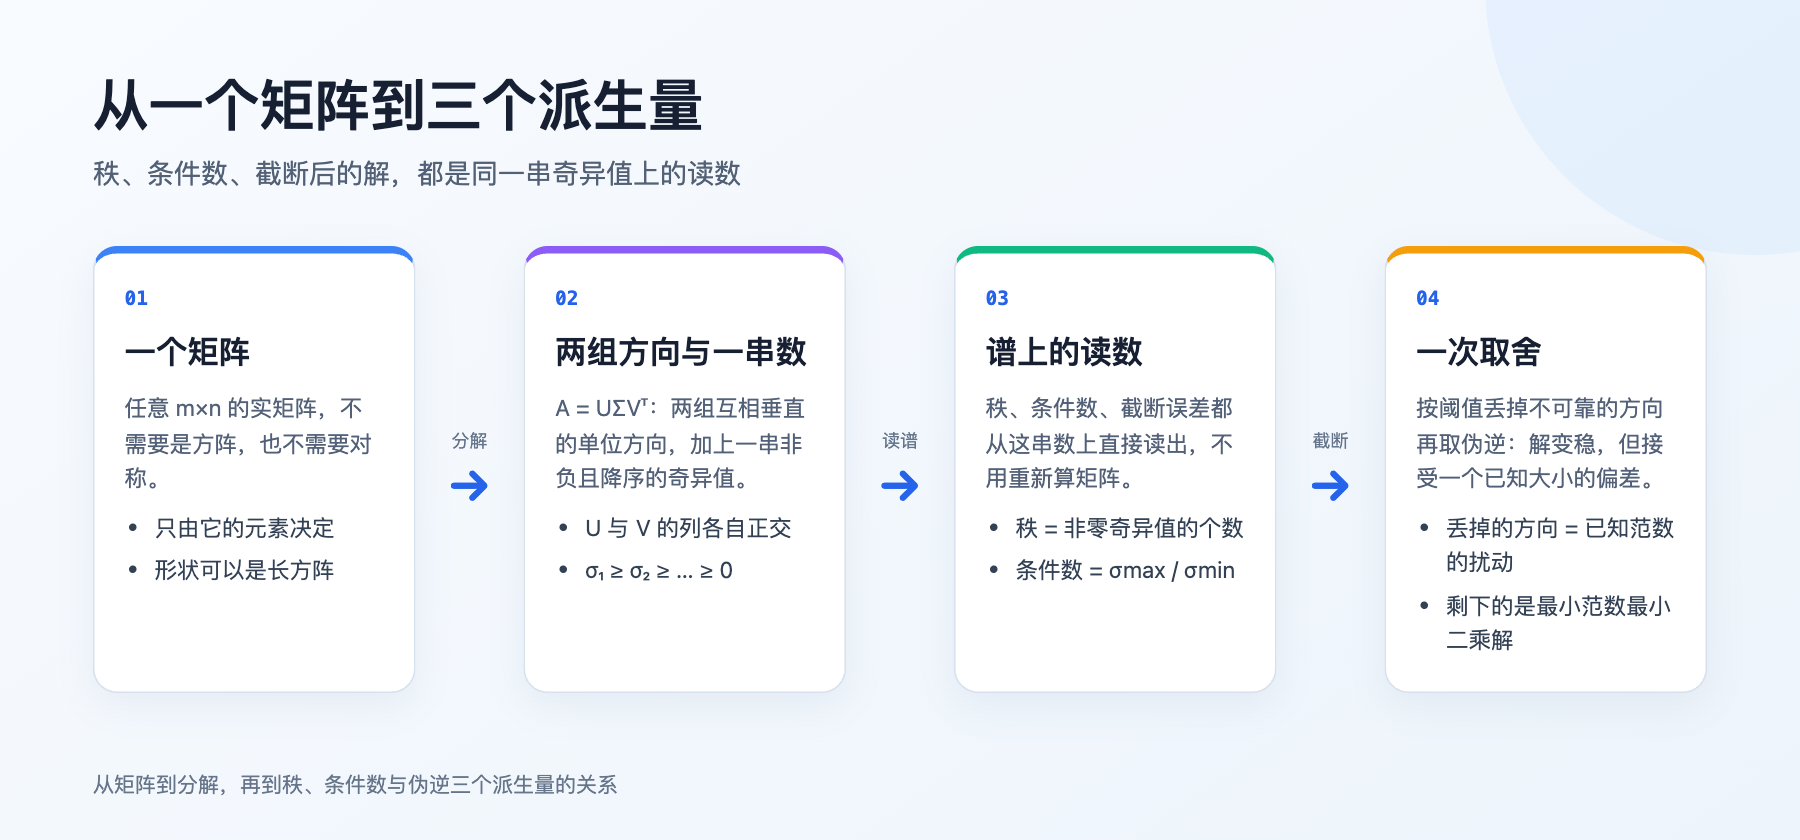
图 2:从矩阵到分解,再到秩、条件数与伪逆三个派生量的关系
图 2 把这条关系画成四步:左边是一个普通的 m×n 矩阵,中间是它的分解,右边三个方框是从同一串奇异值上读出来的三个量,最右边是按阈值截断之后得到的解。整篇文章就是沿着这条线走:先学会读这串数,再用它回答两个不同的问题——「哪个低秩矩阵离它最近」和「解方程时输入误差会被放大多少」。
顺便说一句这件工具的来路。把矩阵先化成两条带、再把带消成对角,这条计算路线是 Golub 与 Kahan 在 1965 年给出的 [1];那篇文章目前在作者之一的主页上可以公开读到,它开篇就把两个用途写在一起:算出奇异值,以及用伪逆解最小二乘 [4]。而「用一个低秩矩阵去逼近给定矩阵」这个问题本身更早,1936 年就有人把它写成了最小二乘问题 [2]。
要把两组方向真的算出来,用的是一种叫 Jacobi 迭代的方法。它的想法很朴素:一次只盯住两个方向,如果这两个方向在输出里还不够垂直,就把它俩一起转一个小角度,直到所有方向两两垂直为止。
概念性伪代码:单边 Jacobi 迭代(不是论文算法框的复现)
输入:m×n 实矩阵 A(m ≥ n),收敛阈值 tol
输出:三个量 U、S、V,满足 A ≈ U · diag(S) · Vᵀ
初始化:工作矩阵 B ← A;方向矩阵 V ← n 阶单位阵
重复以下一轮(每轮把所有方向对扫一遍):
对每一对下标 (p, q),p < q:
算出第 p 列与第 q 列的长度平方 α、β,以及两列的内积 γ
若 |γ| 不超过 tol · √(α·β):这一对已经足够垂直,跳过
否则:
由 α、β、γ 算出一个旋转角的正切 t
用这个角同时旋转 B 的第 p、q 两列
对 V 的第 p、q 两列做同一个旋转(把这次旋转记下来)
若本轮所有方向对都已被跳过:结束循环
收尾:
S ← B 各列的长度,按从大到小排序
U 的各列 ← B 的各列除以对应的长度
V 的列按同一顺序重排
这段伪代码里有两个细节值得停一下。第一,旋转只作用在两列上,所以每一小步都是可逆的、不会放大已有的误差;这也是这类方法在数值上稳的原因。第二,代码从来没有显式算过 AᵀA——它只比较列的长度与内积,而 α、β、γ 恰好就是 AᵀA 在这一对方向上对应的三个元素。绕开 AᵀA 直接算,正是这套办法比「先把 AᵀA 乘出来再求特征值」更可靠的地方;第七节会看到显式乘出 AᵀA 的代价。
三、秩一展开:把矩阵拆成一层层的叠加
把 A = UΣVᵀ 按列摊开,就得到另一种写法。设 σ₁ ≥ σ₂ ≥ … ≥ σ_min,uᵢ 是 U 的第 i 列,vᵢ 是 V 的第 i 列,那么
A = σ₁u₁v₁ᵀ + σ₂u₂v₂ᵀ + … + σ_min u_min v_minᵀ
每一项 σᵢuᵢvᵢᵀ 都是一个秩一矩阵:它把任何输入先投影到 vᵢ 这个方向上(算一个系数),再把这个系数乘上 σᵢ 放到 uᵢ 这个方向上。换句话说,每一层只认一个输入方向、只产出一个输出方向。整个矩阵就是这些层的叠加。
对第一节那个 3×3 矩阵,三层各自的厚度是:
| σ₁u₁v₁ᵀ | 17.412505166809 | 0.99735308 |
| σ₂u₂v₂ᵀ | 0.875161350110 | 0.00251943 |
| σ₃u₃v₃ᵀ | 0.196866521117 | 0.00012749 |
第一层一层就占了全部「能量」的 99.74%,中间那层占 0.25%,最后一层只剩 0.013%。这个份额是可以手算的:因为两组方向都是单位向量且彼此垂直,把 A 的平方和展开时交叉项全部消失,只剩下 σᵢ² 相加,所以第 i 层的份额就是 σᵢ² 除以全部 σᵢ² 的和。这份「能量账」是整个低秩逼近的依据——如果只留一层,丢掉的正好是后面两层。
顺带把第一节留下的那句说清楚:把 A = UΣVᵀ 代进行列式,两端的正交矩阵行列式绝对值都是 1,剩下的只有对角阵,于是 |det A| 就等于三个奇异值的乘积。3.000000000000 与 |−3| 相等,正是这条关系;换个角度说,行列式「体积缩放倍数」本身就是各方向拉伸倍数的乘积。
四、秩到底是多少:从谱上看,以及浮点下什么叫零
矩阵的秩,最朴素的定义是「线性无关的列数」。放到奇异值分解上看,它有一个等价的说法:秩等于非零奇异值的个数。道理很直接:每一层 σᵢuᵢvᵢᵀ 的秩是 1(只要 σᵢ 不为零),而互相垂直的方向之间无法互相表示,所以这些层加起来的秩恰好等于非零层的数量。
于是秩从一个消元过程的副产物,变成了谱上的一次读数。可「非零」这两个字在浮点计算里会立刻变成麻烦。看一个具体的 6×4 矩阵:
C = [[1, 2, 3, 4],
[2, 3, 4, 5],
[3, 4, 5, 6],
[4, 5, 6, 7],
[5, 6, 7, 8],
[6, 7, 8, 9]]
它的每个元素都等于行号加列号再加一(行号、列号都从 0 开始),所以每一行都是上一行逐元素加一、每一列都是左边一列逐元素加一。这种结构意味着它可以写成两部分之和:一部分只跟行号有关,一部分只跟列号有关。写出来是
C = u · 1ᵀ + 1 · wᵀ, u = (1,2,3,4,5,6)ᵀ, w = (0,1,2,3)
前一项的每一行都是同一个行向量的倍数,秩是 1;后一项的每一列都是同一个列向量的倍数,秩也是 1。两项之和的秩最多是 2,而它显然不是秩 1(行与行不成比例),所以它的精确秩就是 2。按这个式子复算,最大绝对误差是 0——不是「很小」,是逐位相等。
按定义算出它的四个奇异值,会得到:
26.400511954467 1.735790466056 8.887071185757784×10⁻¹⁶ 5.948736790578536×10⁻¹⁶
后两个数不是零,但相对于最大的那个只有 3.366×10⁻¹⁷ 与 2.253×10⁻¹⁷——这是双精度浮点在此规模下的舍入噪声量级。它们本该精确为零,机器给出的却是一点点灰尘。如果直接拿「奇异值是否等于 0」当判据,这个秩 2 的矩阵会被判成秩 4。
工业上的做法是换一个判据:给定一个阈值 τ,把满足 σᵢ > τ·σ_max 的个数当作秩。这样定义的量叫数值秩,它不是一个数,而是一个「数 + 口径」的组合。τ 的常见取法跟矩阵维数与机器精度同量级(例如维数乘上机器 epsilon 再乘最大奇异值),但具体取多少是使用者的选择,不是数学定理规定的。第四节这个矩阵在 10⁻¹⁶ 量级的阈值下数值秩是 2,与精确秩一致;第八节的拟合算例里,那个 11×10 的设计矩阵在不同阈值下会给出 10 与 9 两个不同的数值秩——那是同一件事的另一面。
这条「秩很难判」的困难不是我编出来的。1965 年那篇文章用整整两页讨论它:作者先指出用 AᵀA 的逆去算伪逆是「我们常做的事」,但当 AᵀA 近似奇异时会有无穷多个向量近似地最小化 ‖b − Ax‖,必须用某种方式把秩考虑进去;接着指出传统做法是看行阶梯形对角线上的非零元,可浮点计算下「某个数是否可视为零」本身就很难判断,于是改用「第 r 行之后是否相对前 r 行可忽略」这个判据,并承认这个判据同样难用;最后给了一个反例——一个行阶梯形对角元全为 ±1 的矩阵,把其中所有 −1 换成 +1 之后矩阵就变得温顺,说明只看消元结果根本无法判断原矩阵是否含足够小、可以被删掉的奇异值。他们的结论是:不显式看奇异值,似乎没有满意的定秩方法 [1]。
五、低秩逼近:丢掉的那部分误差等于多少
现在可以回答第一个核心问题了:一个矩阵在什么意义下最接近某个低秩矩阵。
把秩一展开按层从厚到薄排好,然后只保留前 r 层:
A_r = σ₁u₁v₁ᵀ + σ₂u₂v₂ᵀ + … + σ_r u_r v_rᵀ
丢掉的是第 r+1 层往后的全部内容。1936 年那篇文章把这个问题写成了最小二乘问题,并指出它总有解、而且通常唯一 [2];二十多年后又有人专门为它补了一个证明,那篇文章的摘要写得很直白:证明的是 Eckart 与 Young 在 1936 年「提出但未证明」的一条定理 [3]。以 Frobenius 范数(把矩阵所有元素的平方和开方)为误差口径,结论是:
-
在所有秩不超过 r 的矩阵里,A_r 的误差最小;
-
最小误差有闭式:
‖A − A_r‖F = √(σ{r+1}² + σ_{r+2}² + … + σ_min²)
也就是说,「保留几层」这个决定可以事先算清楚代价:丢掉的那部分误差,恰好等于所有被丢掉的奇异值的平方和再开方。这条恒等式的证明思路只用一条性质——Frobenius 范数在正交变换下不变:把 A 与任意候选矩阵 B 同时用两组方向夹住,问题就化成对角矩阵与某个一般矩阵的逐元比较,任何非对角元都只会让平方和变大,对角元取 σᵢ 时最小 [1]。
把它放到两个具体矩阵上复算,两条路径(直接算差矩阵的范数,与按闭式把尾部奇异值平方和开方)给出的数字应当一致:
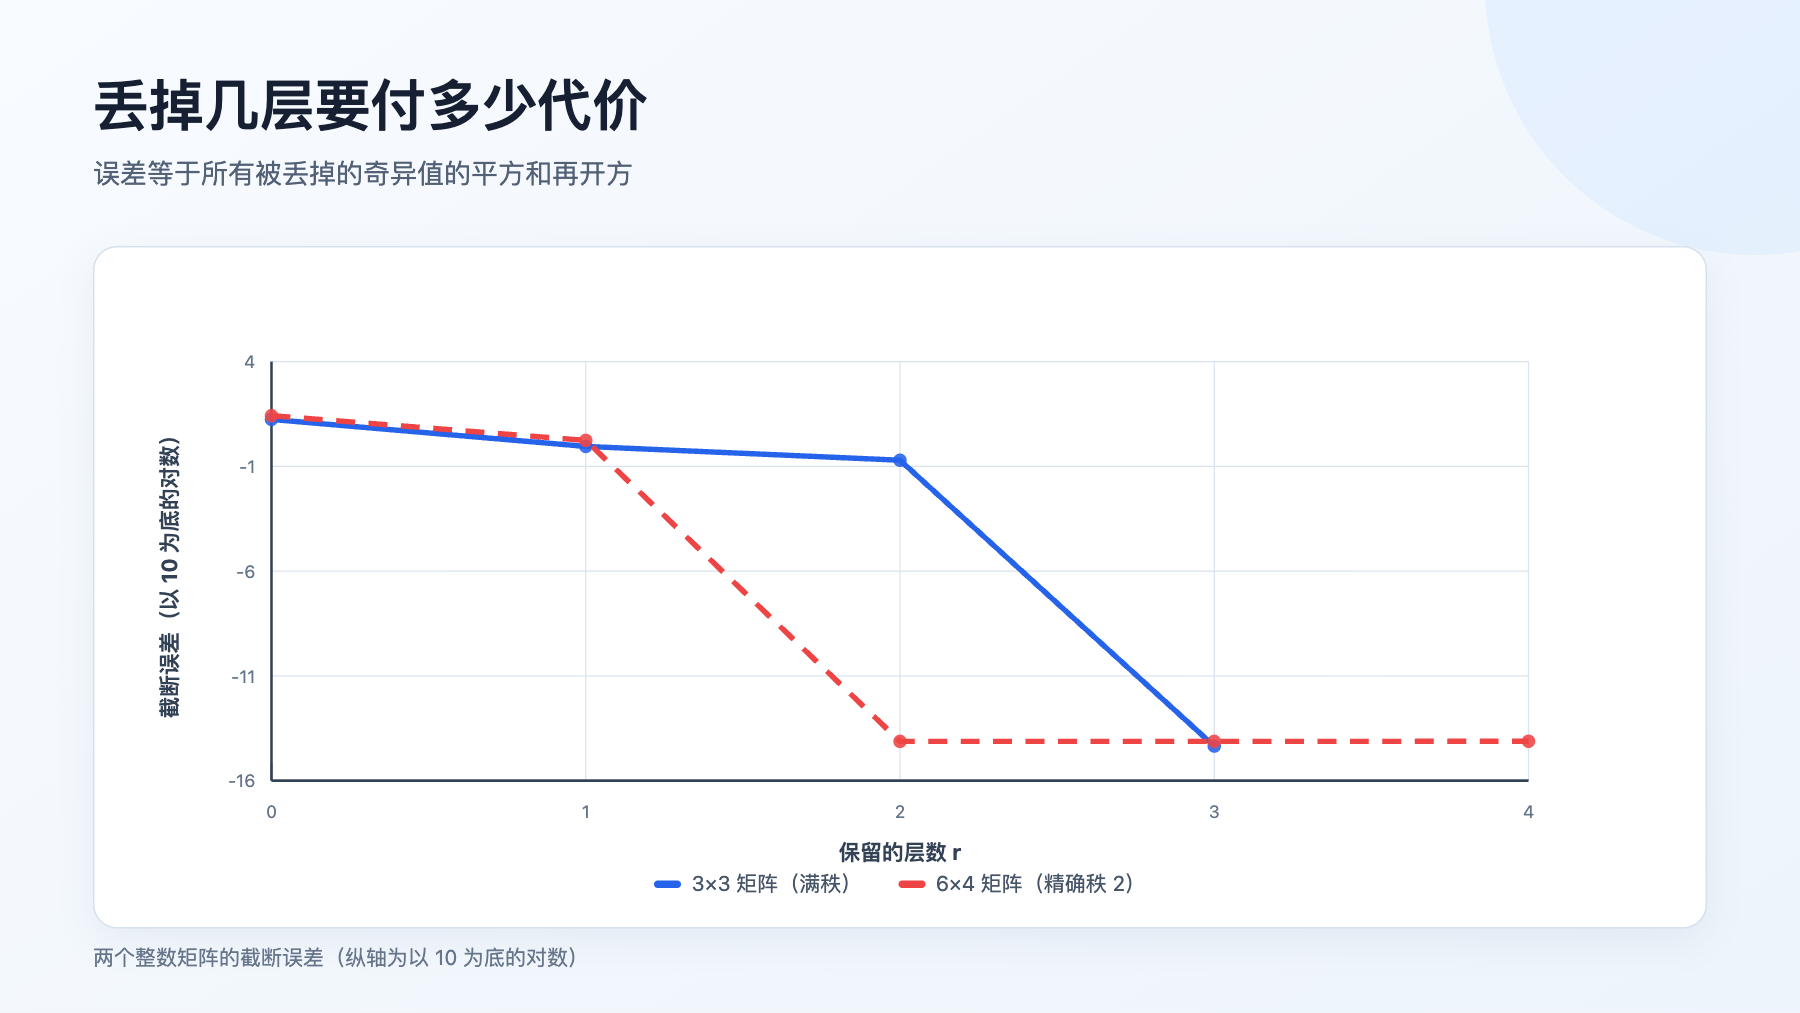
图 3:两个整数矩阵的截断误差(纵轴为以 10 为底的对数)
图 3 的纵轴是误差的以 10 为底的对数。之所以要取对数,是因为两条曲线的量程差得太远:3×3 那个矩阵(下方那条)在 r = 1 时误差是 0.897030554588,正好等于 √(0.875161² + 0.196867²);r = 2 时降到 0.196866521117,也就是第三个奇异值本身;r = 3 时两条路径分别给出 4.446×10⁻¹⁵ 与 0——都已经是零,差别只是浮点舍入的方向。6×4 那个矩阵(上方那条)在 r = 1 时误差是 1.735790466056,而 r = 2 时直接落到 7.5×10⁻¹⁵——图上是那条笔直下坠的虚线。两个矩阵在「该丢的都丢掉之后」都停在 10⁻¹⁴ 到 10⁻¹⁵ 这一带,那不是零,而是双精度在这个规模上的舍入地板;0.197 与 10⁻¹⁴ 之间差了十四个数量级,只有对数刻度能同时容下它们。四种保留层数下,两条路径(直接算差矩阵的范数、按闭式把尾部平方和开方)的最大差就是这 4.446×10⁻¹⁵,出现在 3×3 矩阵的 r = 3 那一点上。
有一个对照能说明「最优」这两个字的分量。3×3 那个矩阵如果不用奇异值分解,而是随手挑九个「只留一个元素」的秩一矩阵里最好的一个,误差是 14.282857;截断奇异值分解给出的 0.897031 比它小了将近十六倍。而 0.897031 这个数还不是「碰巧不错」——按上面的闭式,它就是理论下界。
下面这段代码把上面这些数字当场算一遍。它只用标准库,不含任何随机数,重复运行结果完全一致:
# 最小可运行示例:单边 Jacobi 迭代求奇异值,并逐项验证截断误差恒等式
import math
def svd_jacobi(A, tol=1e-15, max_sweeps=100):
"""返回 U、S、V,满足 A 约等于 U 乘 diag(S) 乘 V 的转置(A 为 m 乘 n,m 不小于 n)。"""
m, n = len(A), len(A[0])
B = [[float(v) for v in row] for row in A]
V = [[1.0 if i == j else 0.0 for j in range(n)] for i in range(n)]
for _ in range(max_sweeps):
rotated = False
for p in range(n – 1):
for q in range(p + 1, n):
alpha = sum(B[i][p] ** 2 for i in range(m))
beta = sum(B[i][q] ** 2 for i in range(m))
gamma = sum(B[i][p] * B[i][q] for i in range(m))
if gamma == 0.0 or abs(gamma) <= tol * math.sqrt(alpha * beta):
continue
zeta = (beta – alpha) / (2.0 * gamma)
t = math.copysign(1.0, zeta) / (abs(zeta) + math.sqrt(1.0 + zeta * zeta))
c = 1.0 / math.sqrt(1.0 + t * t)
s = c * t
for i in range(m):
bp, bq = B[i][p], B[i][q]
B[i][p] = c * bp – s * bq
B[i][q] = s * bp + c * bq
for i in range(n):
vp, vq = V[i][p], V[i][q]
V[i][p] = c * vp – s * vq
V[i][q] = s * vp + c * vq
rotated = True
if not rotated:
break
norms = [math.sqrt(sum(B[i][j] ** 2 for i in range(m))) for j in range(n)]
order = sorted(range(n), key=lambda j: –norms[j])
S = [norms[j] for j in order]
U = [[B[i][j] / norms[j] for j in order] for i in range(m)]
Vs = [[V[i][j] for j in order] for i in range(n)]
return U, S, Vs
def frobenius(M):
return math.sqrt(sum(v * v for row in M for v in row))
def best_rank_r(U, S, V, r):
m, n = len(U), len(S)
return [[sum(U[i][k] * S[k] * V[j][k] for k in range(r)) for j in range(n)] for i in range(m)]
A = [[1.0, 2.0, 3.0], [4.0, 5.0, 6.0], [7.0, 8.0, 10.0]]
U, S, V = svd_jacobi(A)
print("奇异值:", ["%.12f" % s for s in S])
print("条件数: %.12f" % (S[0] / S[2]))
print("行列式绝对值: 3.0 奇异值乘积: %.12f" % (S[0] * S[1] * S[2]))
for r in range(4):
Ar = best_rank_r(U, S, V, r)
direct = frobenius([[A[i][j] – Ar[i][j] for j in range(3)] for i in range(3)])
tail = math.sqrt(sum(s * s for s in S[r:]))
print("r=%d 直接算出=%.12f 尾部平方和开方=%.12f" % (r, direct, tail))
在 Python 3.9 与 3.12 两个版本下运行,输出逐字节相同:
奇异值: ['17.412505166809', '0.875161350110', '0.196866521117']
条件数: 88.448279920699
行列式绝对值: 3.0 奇异值乘积: 3.000000000000
r=0 直接算出=17.435595774163 尾部平方和开方=17.435595774163
r=1 直接算出=0.897030554588 尾部平方和开方=0.897030554588
r=2 直接算出=0.196866521117 尾部平方和开方=0.196866521117
r=3 直接算出=0.000000000000 尾部平方和开方=0.000000000000
每一行都是两条路径并排:左边把 A 与重建出来的 A_r 相减、再算全部元素的平方和开方;右边只把第 r 层之后的奇异值平方相加再开方。四种保留层数下两列数字完全相同,这就是第五节那条恒等式在具体矩阵上的样子。
六、换一个任务:同一个矩阵去解方程,条件数把误差放大多少
低秩逼近问的是「哪个矩阵离它最近」,现在换一个问题:把这个矩阵当作线性方程组 Ax = b 的系数矩阵,它的谱结构会干什么。
答案还是那串奇异值,只不过这次关心的是比值。条件数定义为
κ(A) = σ_max / σ_min
它大,说明椭球被拉得又长又扁:某些方向的输入被放大很多,另一些被压得很小。这件事对解方程的影响是直接的。设右端有一个扰动 δb,解就从 x 变成 x + δx。把两件事分别写成
x = A⁻¹b 与 δx = A⁻¹δb
各自取范数再相除,中间插入 ‖A‖·‖A‖⁻¹ 这个等于 1 的因子,就得到
‖δx‖ / ‖x‖ ≤ κ(A) · ‖δb‖ / ‖b‖
左边是解的相对误差,右边是输入相对误差乘上条件数。这条推导只用范数的两条性质(‖A⁻¹δb‖ ≤ ‖A⁻¹‖·‖δb‖ 与 ‖b‖ ≤ ‖A‖·‖x‖),不依赖任何具体算法,因此对任何求解方法都成立。它是一条最坏情况的界:它说的是「放大倍数不会超过 κ」,不是「一定会放大 κ 倍」。扰动方向与解向量的几何关系决定了实际放大多少。
这句话可以量出来。取 10 个等距点、9 次多项式的拟合问题(下一节会用到同一批点),设计矩阵是一个 10×10 的方阵,它的条件数是 2.568136×10⁷。往右端加一个相对大小 10⁻¹⁰ 的扰动:
- 如果扰动方向是「最敏感」的那个方向,解的相对误差是 6.089035×10⁻⁴,放大了 6.089035×10⁶ 倍;
- 如果扰动方向换成「最不敏感」的那个方向,解的相对误差只有 2.370996×10⁻¹¹,放大倍数 0.237099——不但没放大,反而缩小了。
把扰动幅度从 10⁻¹⁰ 一路加到 10⁻⁴,这两个放大倍数一位不变(扰动是精确线性的),而它们都落在条件数 2.568136×10⁷ 这条界之内。所以条件数的正确读法是:它是一个承诺上限的指标。看到 κ = 10⁷,能确定的只是「最坏情况下解会丢掉 7 位有效数字」;至于手上的这一份数据实际丢掉几位,要看误差落在哪个方向上。
七、为什么不该直接解正规方程
最小二乘问题的标准解法是解正规方程:
AᵀA x = Aᵀb
它的推导很漂亮:把残差平方和 ‖Ax − b‖² 对 x 求导、令导数为零,就得到这组方程。可惜它的数值性质很差,原因可以一行写完——AᵀA 的奇异值是 A 的奇异值的平方。把 A = UΣVᵀ 代进去:
AᵀA = (UΣVᵀ)ᵀ(UΣVᵀ) = VΣᵀUᵀUΣVᵀ = VΣ²Vᵀ
中间那步 UᵀU = I 是正交矩阵的性质。于是 AᵀA 的奇异值就是 σ₁², σ₂², …, σ_min²,条件数随之变成
κ(AᵀA) = σ_max² / σ_min² = κ(A)²
条件数被平方,意味着解的相对误差界从 κ·ε 变成 κ²·ε(ε 是机器精度)。在双精度下 ε ≈ 2.2×10⁻¹⁶:如果 κ 是 10⁶,直接对 A 做正交变换时界是 2.2×10⁻¹⁰,还能保住九到十位有效数字;显式乘出 AᵀA 之后界变成 10¹²·ε ≈ 2.2×10⁻⁴,只剩三到四位。而且 AᵀA 一旦在浮点里被乘出来,那些在 A 里只是「很小」的奇异值会在平方后沉到舍入噪声以下,信息在那一步就已经丢了——1965 年那篇文章在讨论伪逆时正是这么说的:用普通浮点算术计算 AᵀA,会严重损害较小的奇异值以及对应的方向 [1]。
替代路线是用正交变换。把 A 分解成 A = QR(Q 的列正交,R 上三角),残差平方和就变成 ‖QRx − b‖² = ‖Rx − Qᵀb‖²(正交变换不改变长度),于是最小二乘问题化成一个三角形方程组,回代即可。这条路线的条件数由 R 决定,而 R 的奇异值与 A 的相同,所以放大倍数是 κ 而不是 κ²。用 Householder 反射把矩阵逐步化成三角形形式,是 1965 年就写清楚的做法 [4];五年后,把奇异值分解本身拿来解最小二乘、并把它写成可复用过程的方案也出现了 [5]。
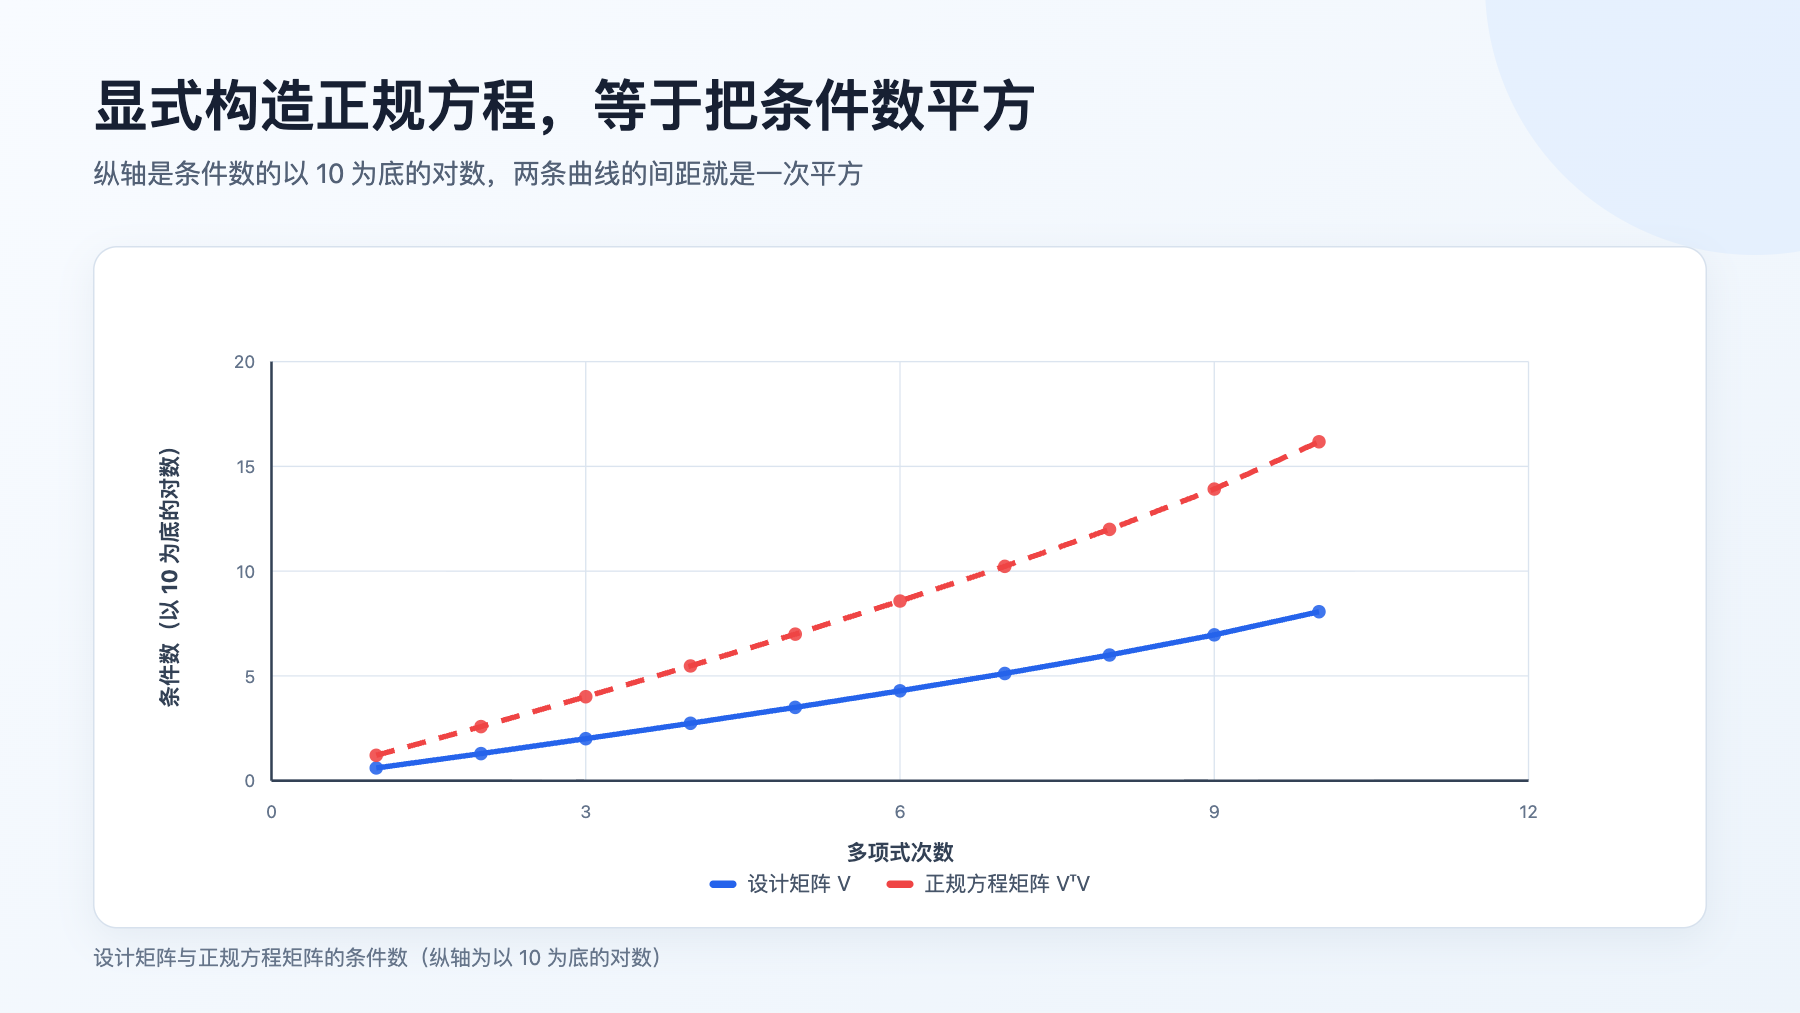
图 4:设计矩阵与正规方程矩阵的条件数(纵轴为以 10 为底的对数)
图 4 把这条「平方」关系画出来:横轴是多项式的次数,纵轴是条件数的以 10 为底的对数,下面那条是设计矩阵,上面那条是它的正规方程矩阵。两条曲线几乎处处相差一倍——在对数轴上差一倍,就是真值上差一个平方。同一批 11 个等距点上,1 次多项式的设计矩阵条件数是 4.020340,10 次时涨到 115575200;对应的正规方程矩阵从 16.16313 涨到 1.491006×10¹⁶,后者已经超出双精度能可靠表示的范围(1/ε ≈ 4.5×10¹⁵)。
八、一个病态拟合算例:三条路线给出三组系数
把上面这些量放到一个具体问题上。取 11 个等距点 x = 0, 0.1, 0.2, …, 1.0,用 0 到 9 次的多项式去拟合一条给定的曲线;为了让问题不是「插值」而是真正的最小二乘,给每个点的函数值加一个固定的小扰动:
f(x) = 1 / (1 + x)
y_i = f(x_i) + δ_i, δ_i = (−1)^i · (i + 1) / 100000
这个扰动最大只有 1.1×10⁻⁴,肉眼看曲线完全不变。设计矩阵 V 是 11×10 的单项式矩阵(第 i 行是 1, x_i, x_i², …, x_i⁹),它的奇异值从 4.694490 一路衰减到 5.167242×10⁻⁷,条件数
κ(V) = 9.085098×10⁶
而它的正规方程矩阵 VᵀV 的条件数是
κ(VᵀV) = 8.257747×10¹³
两者之比是 9.089332×10⁶,与 κ(V) 同量级——第七节那条 κ² 的关系在真实矩阵上就是这样落地的。
现在用三条路线解同一个最小二乘问题。为了能判断谁对谁错,另外用精确有理数算术(Python 的 Fraction,没有任何浮点舍入)把同一个问题精确求解一遍,作为参考解:
| 精确参考解(有理数算术) | 51.712921 | 0 | 1.429520×10⁻⁴ |
| 正规方程(显式构造 VᵀV) | 51.747553 | 5.797176×10⁻² | 1.429520×10⁻⁴ |
| Householder QR | 51.712921 | 1.395630×10⁻⁸ | 1.429520×10⁻⁴ |
| 基于分解的伪逆 | 51.712921 | 2.281649×10⁻⁹ | 1.429520×10⁻⁴ |
这张表最值得看的是最后两列的关系。四行的残差范数都等于 1.429520×10⁻⁴——打印到七位有效数字完全一样。如果只盯着残差判断解法好坏,会得出「三条路线没有区别」的结论。可系数与参考解的差完全是另一回事:正规方程解的差是 5.797176×10⁻²,QR 是 1.395630×10⁻⁸,伪逆是 2.281649×10⁻⁹。正规方程的系数误差是 QR 的 4153805 倍,而 κ(V) 是 9.085098×10⁶——两者的数量级对得上。这就是条件数平方的代价:残差看起来一样好,解却已经错到第五位。
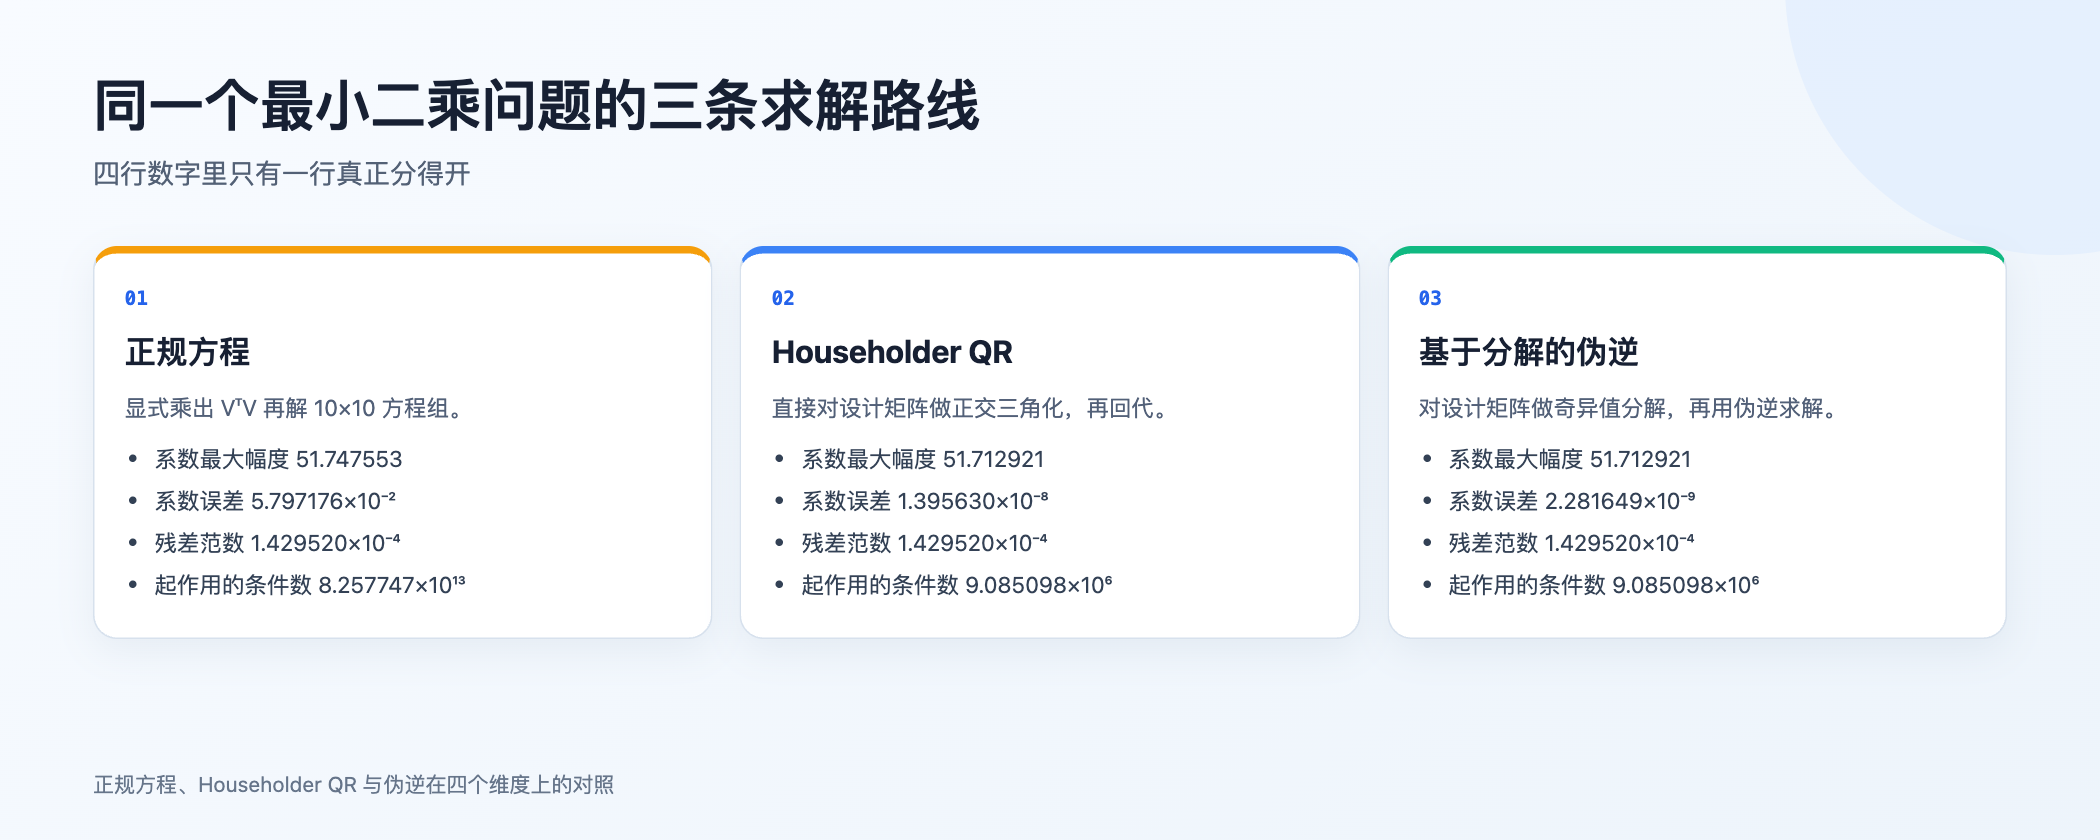
图 5:正规方程、Householder QR 与伪逆在四个维度上的对照
图 5 把三条路线并排放在四个维度上。左边一列是正规方程,中间是 QR,右边是伪逆。四行分别是系数最大幅度、系数误差、残差范数,以及求解过程中实际起作用的条件数。可以看到差别集中在系数误差那一行,而残差那一行三列几乎相同——这正是这张表容易骗人的地方。
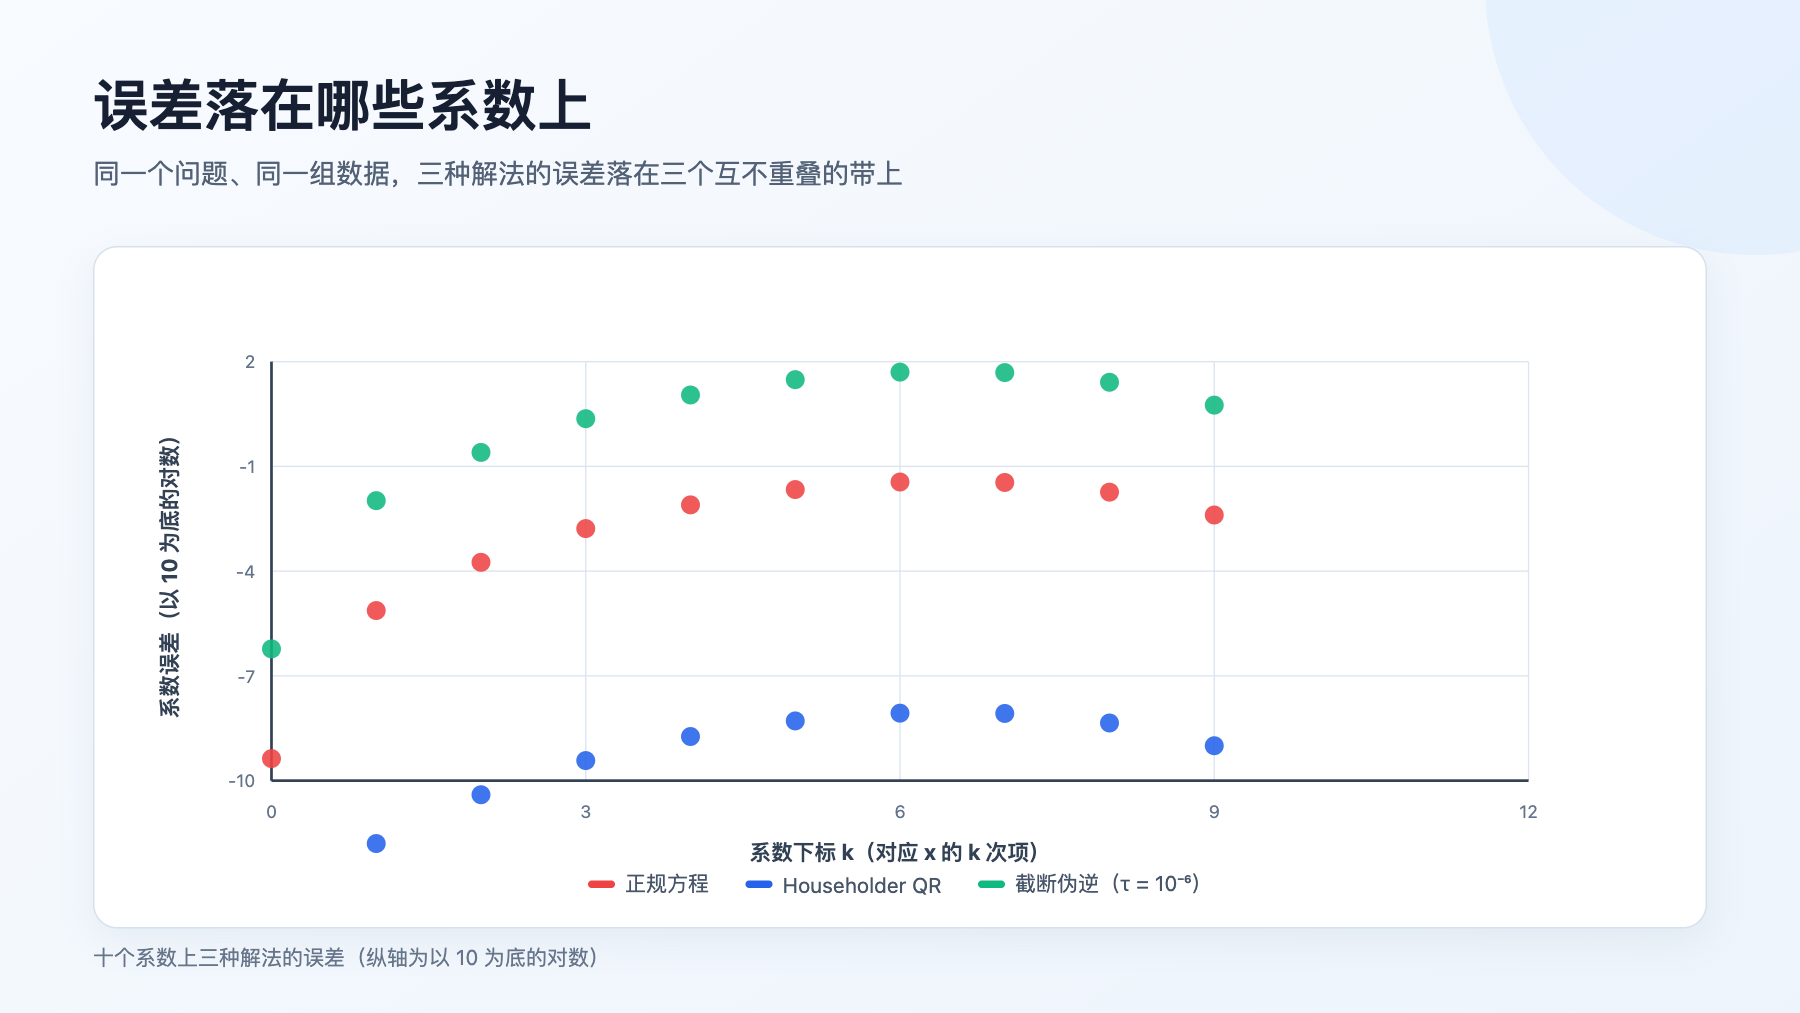
图 6:十个系数上三种解法的误差(纵轴为以 10 为底的对数)
图 6 把误差拆到每个系数上看。横轴是系数下标(x⁰ 到 x⁹),纵轴是这一个系数上与参考解之差的对数。红色那组是正规方程,蓝色是 QR,绿色是按 10⁻⁶ 阈值截断后的伪逆。前两组之间的差距在十个系数上都存在,稳定在五到七个数量级;绿色那组则整体落在 5.9×10⁻⁷ 到 50.1 之间——最高的那一点已经与解本身的量级相当(参考解的系数最大幅度是 51.712921)。那不是舍入误差,而是主动丢掉方向换来的代价,第九节会把这笔账算清楚。
九、伪逆与截断:把不可靠的方向丢掉之后
如果 A 不是方阵、或者不满秩,A⁻¹ 根本不存在,但最小二乘问题仍然可以回答。把 A = UΣVᵀ 代进正规方程,可以得到一个形式上很干净的解:
A⁺ = V Σ⁺ Uᵀ
其中 Σ⁺ 是把 Σ 里每个非零奇异值取倒数、其余保持零得到的结果。这个 A⁺ 叫伪逆,用它算出的 x = A⁺b 就是最小二乘解 [1]。为什么它是最小范数的那个?因为把解写成 A⁺b 时,用到的只有 U 的前若干列,也就是 Aᵀ 的值空间;最小二乘问题的解集是一个仿射集合,而集合里 2 范数最小的那个点恰好落在 Aᵀ 值空间里(零空间的正交补上)。所以「伪逆」这个名字里其实藏了两个条件:最小二乘,以及最小范数。
伪逆真正的实用价值在截断。所谓截断,就是在取倒数之前先做一个决定:哪些奇异值算「够大」,哪些算「不可靠」。只保留 σᵢ > τ·σ_max 的那些方向,其余当作零——与第四节定义数值秩用的是同一个阈值。
这个决定值多少钱,前面的算例可以量出来。第八节的拟合问题在两种阈值下:
| 10⁻⁸ | 10 | 51.712921 | 81.76810 | 1.429520×10⁻⁴ |
| 10⁻⁶ | 9 | 4.424275 | 8.194994 | 1.490051×10⁻⁴ |
矩阵一个字没改、数据一个字没改,只把阈值改了两个数量级:系数最大幅度从 51.712921 掉到 4.424275,系数范数从 81.76810 掉到 8.194994,而残差只从 1.429520×10⁻⁴ 涨到 1.490051×10⁻⁴——大约 4%。丢掉最后一个方向,换来的是一个「小得多」的解,代价是拟合误差略微变大。
对这件事有两种读法,都成立,但必须知道自己在用哪一种。第一种是把它读成正则化:不稳定的方向本来就被噪声主导,丢掉它等于放弃「精确复现噪声」,这正是 1965 年那篇文章说伪逆能抑制虚假振荡与相消的意思 [1]。第二种是把它读成主动引入的模型误差:1965 年那篇文章在同一页写得很清楚——忽略 σ_{r+1} 到 σ_n 这些方向,等价于给 A 加了一个范数为 √(σ_{r+1}² + … + σ_n²) 的扰动 [1]。所以「截断之后解更准」这句话没有普适版本;能说的是:截断用一个已知大小的偏差,换掉了不受控的误差放大。
这也是为什么报告数值秩必须同时报告阈值。同一组数据在 τ = 10⁻⁸ 下数值秩是 10,在 τ = 10⁻⁶ 下是 9,两个答案都对,因为口径不同;只报「秩 = 10」而不说阈值,别人就无法复核这个数字是怎么来的。
十、边界:范数的选择,以及这套分解不利用的东西
第一条边界:换一个范数,闭式就换了。 第五节那条「误差等于尾部奇异值平方和开方」是在 Frobenius 范数口径下成立的。把误差口径换成别的酉不变范数(在正交变换下保持不变的范数,比如谱范数——最大的奇异值),截断仍是最优的,但误差不再有那条闭式:谱范数口径下,秩 r 截断的误差等于最大的那个被丢掉的奇异值 σ_{r+1}。把结论从 Frobenius 推到一般酉不变范数的工作出现在 1960 年的一篇文章里 [6];那条推广的完整条件与证明超出这里的范围,这里只说明「推广存在、闭式会变」这一层。
第二条边界:这套分解完全不看稀疏结构。 一个大部分元素为零的大矩阵,用稀疏直接法求解可能只需要和「非零元素个数」成正比的存储与时间;而奇异值分解会把这些零当成普通数字处理,并且通常需要反复迭代。稀疏结构是一种可以被别的算法利用的信息,谱结构是另一种,两者并不互相包含——一个矩阵可以既稀疏又病态,也可以既稠密又良态。
第三条边界:条件数是界,不是预言。 第六节已经量过:同一个矩阵、同一个右端,沿一个方向扰动放大 6.089035×10⁶ 倍,沿另一个方向只有 0.237099 倍。κ 给的是上限。
第四条边界:这里讨论的「秩」始终是一个带口径的量。 精确算术下的秩唯一,浮点下的数值秩依赖阈值;本文所有出现「秩」的地方都注明了是哪一个。第一节那个矩阵条件数是 88.448279920699,属于良态;第八节那个设计矩阵条件数 9.085098×10⁶,已经能让人在完全看不出异常的情况下丢掉五位有效数字。判断一个最小二乘问题要不要紧,先算条件数通常比先看残差有用得多。
参考文献
[1] G. Golub, W. Kahan. Calculating the Singular Values and Pseudo-Inverse of a Matrix. Journal of the Society for Industrial and Applied Mathematics Series B Numerical Analysis, 2(2):205-224, 1965. DOI: 10.1137/0702016
[2] Carl Eckart, Gale Young. The Approximation of One Matrix by Another of Lower Rank. Psychometrika, 1(3):211-218, 1936. DOI: 10.1007/BF02288367
[3] Richard M. Johnson. On a Theorem Stated by Eckart and Young. Psychometrika, 28(3):259-263, 1963. DOI: 10.1007/BF02289573
[4] Peter Businger, Gene H. Golub. Linear least squares solutions by householder transformations. Numerische Mathematik, 7(3):269-276, 1965. DOI: 10.1007/BF01436084
[5] G. H. Golub, C. Reinsch. Singular value decomposition and least squares solutions. Numerische Mathematik, 14(5):403-420, 1970. DOI: 10.1007/BF02163027
[6] L. Mirsky. SYMMETRIC GAUGE FUNCTIONS AND UNITARILY INVARIANT NORMS. The Quarterly Journal of Mathematics, 11(1):50-59, 1960. DOI: 10.1093/qmath/11.1.50


评论前必须登录!
注册