 网硕互联帮助中心
原论文:Test-Time Prototype Adaptation for Open-Vocabulary Semantic Segmentation
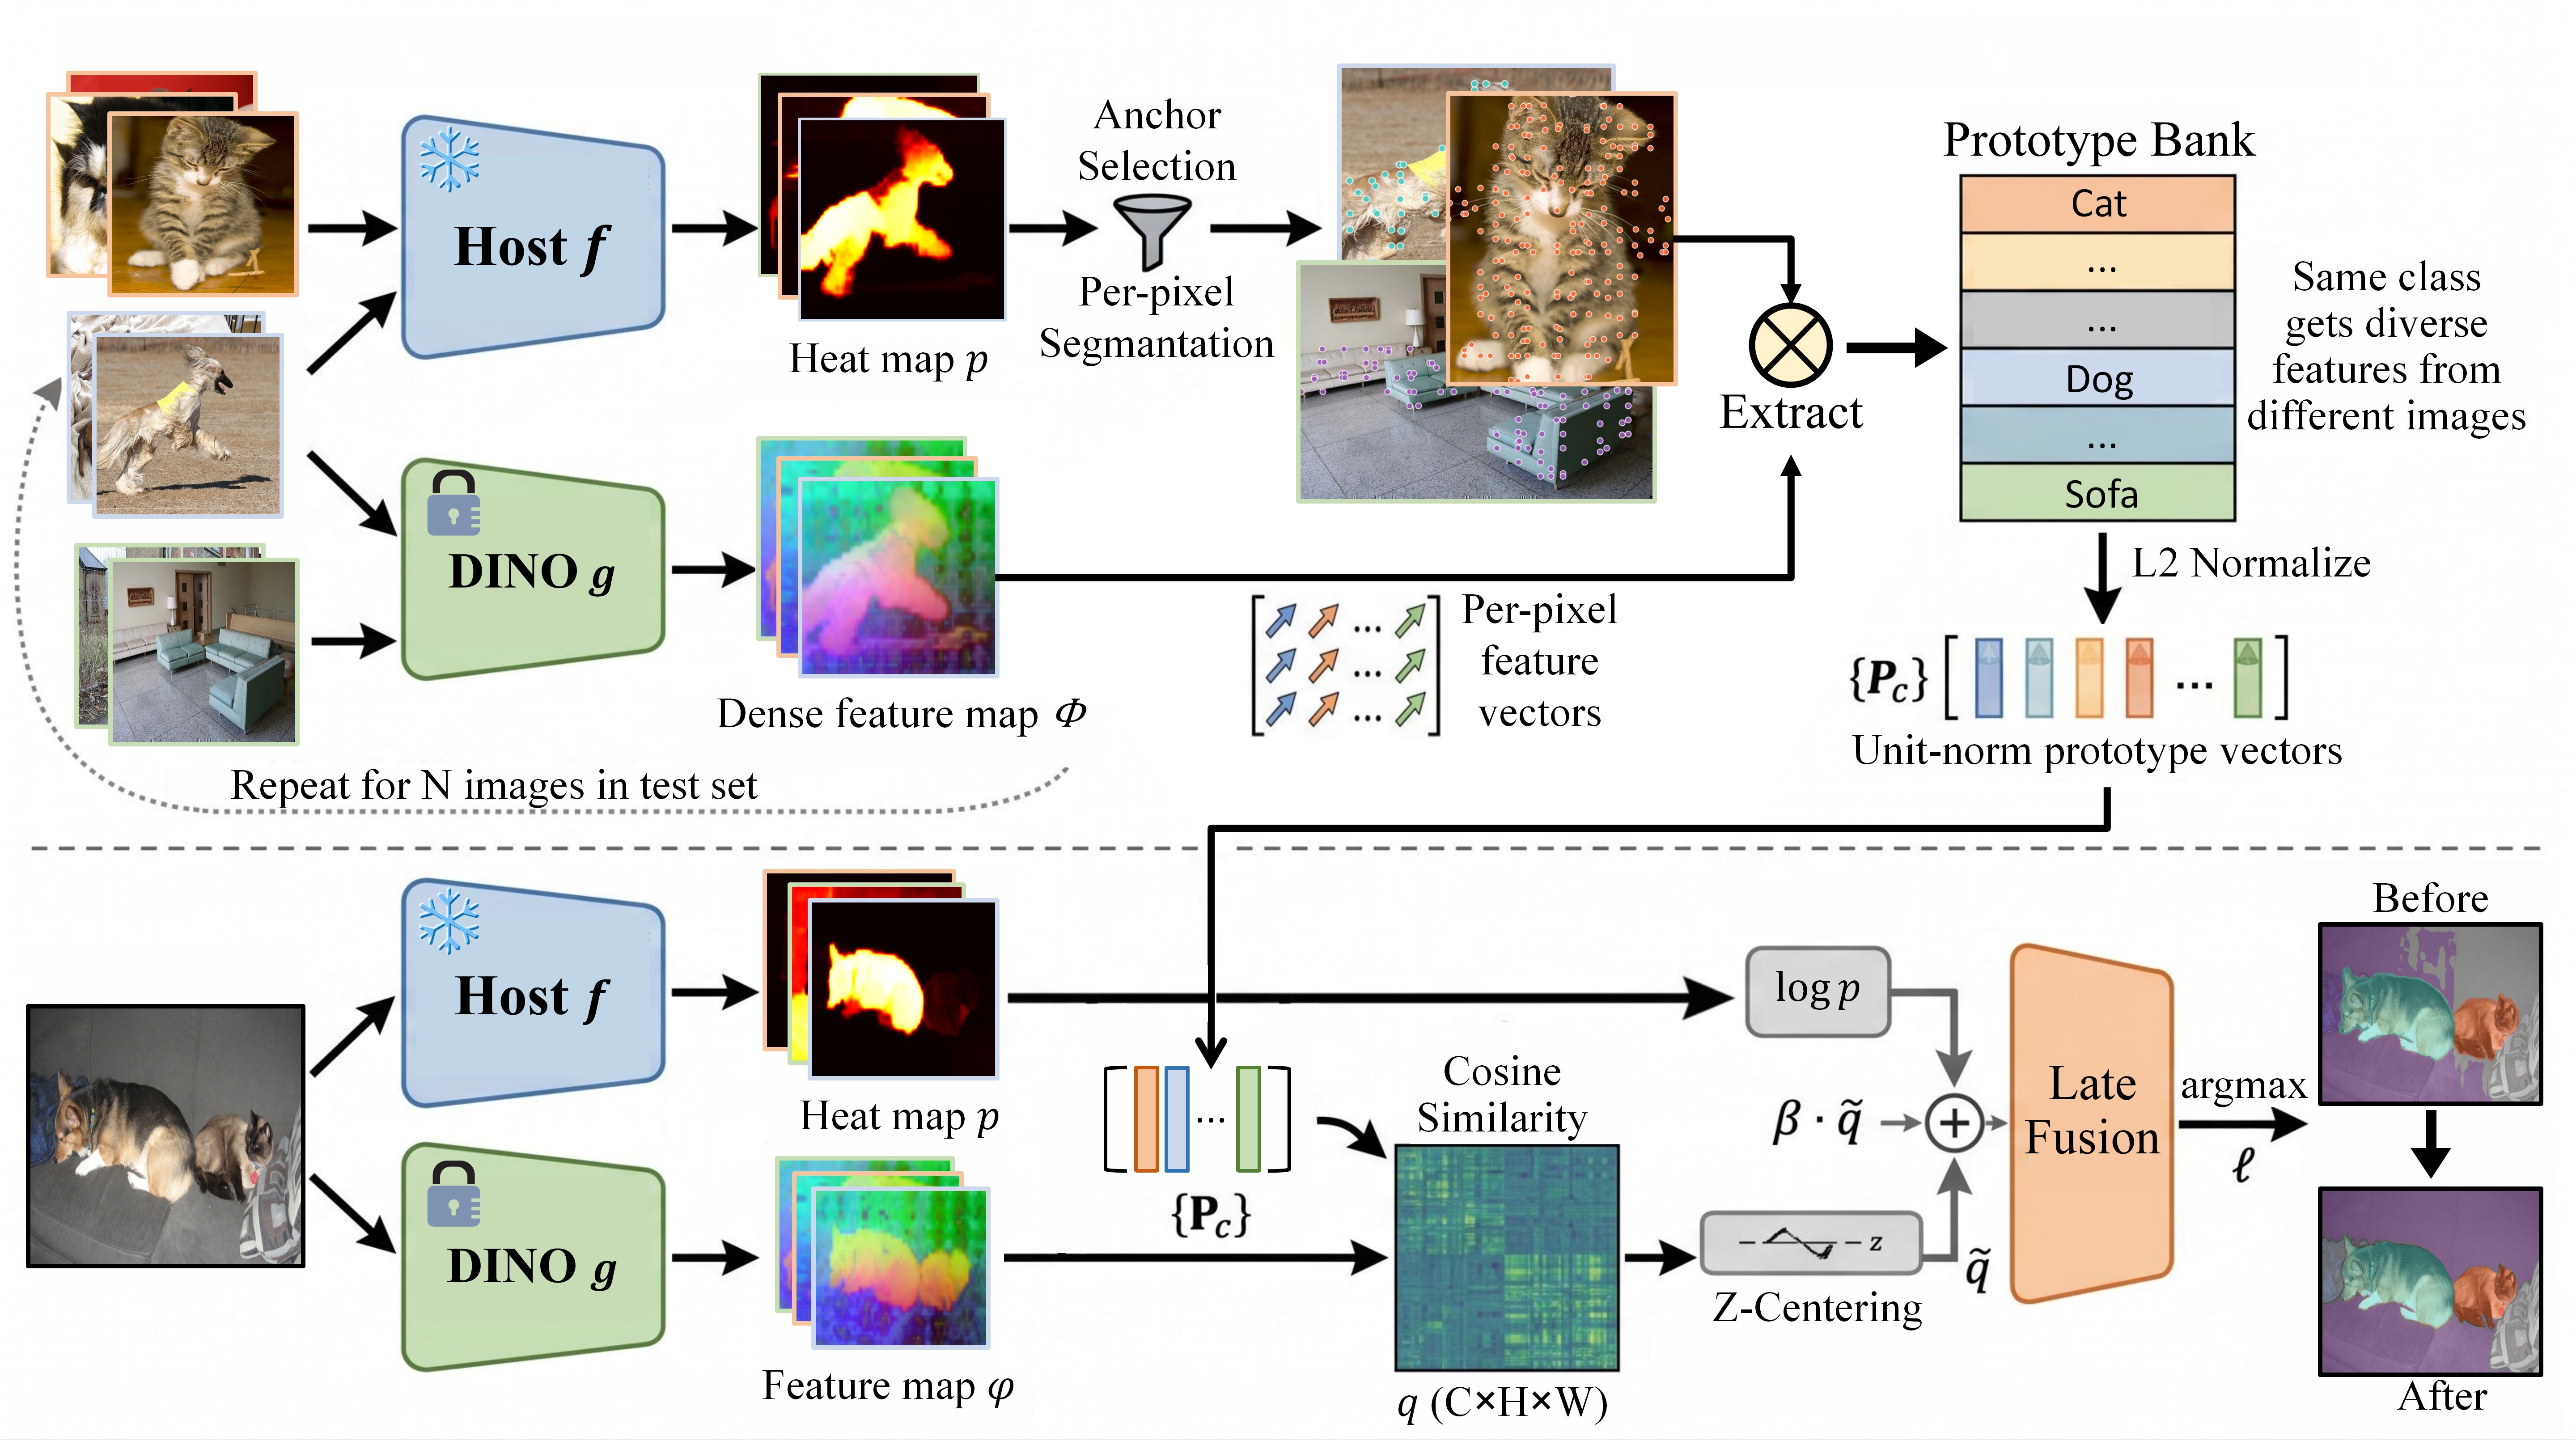
TPA 先用宿主分割模型在一批无标注部署域图像上挑出可靠位置,再用冻结的 DINOv2 ViT-B/14 提取这些位置的特征,按类别汇成原型。之后每张图都有两路分类分数:宿主原本的预测,以及像素和类别原型的相似度。TPA 在输出端合并这两路分数。
建库:类别得分最高,还要超过阈值
对每张建库图像,先看宿主给每个位置的类别概率。某个位置要成为类别
c
c
c 的锚点,
c
c
c 必须是该位置概率最高的类别,且概率严格大于
2
/
C
2/C
2/C,其中
C
C
C 是候选类别数。这个阈值是均匀猜测概率
1
/
C
1/C
1/C 的两倍。某类合格位置少于
K
min
=
5
K_{\\min}=5
Kmin=5 时,直接跳过这批位置。
把合格位置对应的 DINO 特征按类别跨图累加,最后将每类的累加向量做 L2 归一化,得到一个单位长度的视觉原型。一次误判可能混进原型,跨图累加可以稀释偶发噪声。若宿主持续把同一种外观认错,错误也可能随累加保留下来。
推理:用原型分数修正宿主输出
对待分割图像,计算每个位置的归一化 DINO 特征与各类别原型的余弦相似度。DINO 特征有共同方向,原始相似度可能普遍偏正。TPA 在同一像素上减去已有原型类别的平均相似度,得到相对分数
q
~
c
\\tilde q_c
q~c。没有原型的类别,其修正项置零。
ℓ
c
=
log
p
c
+
(
1
−
α
)
λ
q
~
c
\\ell_c = \\log p_c + (1-\\alpha)\\lambda\\,\\tilde q_c
ℓc=logpc+(1−α)λq~c
p
c
p_c
pc 是宿主的类别概率。论文用
α
=
0.5
\\alpha=0.5
α=0.5、
λ
=
5
\\lambda=5
λ=5,取融合分数最高的类别。这里的视觉传播是把跨图积累的类别信息通过原型相似度传给新图像的像素。TPA 读取宿主的输出即可接入,宿主和 DINO 的参数全程冻结。
实验覆盖与组合方式
作者把 TPA 接在 SCLIP、ClearCLIP、NACLIP、ProxyCLIP 和 Trident 上,覆盖三种 ViT 规格和八个评测设置。类别规模有跨度:VOC 是 20/21 类,Context 是 59/60 类,也有 ADE20K 和 COCO-Stuff 这样类别更多的设置。建库用同测试域、隐藏标签的图像。Trident B/16 的建库规模实验中,多数基准在约 10% 的适配池时趋于饱和,Context59 在之后还有小幅收益。
FSA 在单图内部无梯度地调节注意力。MLMP 用多层熵最小化在推理时更新模型参数。两者可以先处理当前图像,再把输出交给 TPA 做跨图原型修正。论文表 6 中,ProxyCLIP B/16 单加 TPA 平均提升 2.0 mIoU 点,与 FSA 叠加提升 3.1 点。NACLIP L/14 与 MLMP 叠加的 7.5 点来自该表单独采用的 MLMP 评测协议。




评论前必须登录!
注册