 网硕互联帮助中心
深度学习毕设选题:基于深度学习的灾害应急响应多目标检测方法研究"
本文是「基于深度学习的灾害应急响应多目标检测方法研究」项目的完整技术复盘:从 1.2 万张灾害图像的数据工程,到 YOLO26m / RT-DETR-L / YOLO11m 三模型同协议对比实验,再到 ONNX 部署与带统计大屏的 Web 系统落地。所有指标均来自项目真实训练日志与实验产物,不含任何编造数字。
基于深度学习的应急灾害目标检测系统
一、开发背景与意义
火灾、爆炸等灾害发生时,前 10 分钟是救援的黄金窗口。但传统依赖人工瞭望和电话上报的方式,往往存在发现晚、误报多、现场信息碎片化的问题:值班员看到浓烟时,火势可能已经蔓延;监控画面里 24 小时人盯屏幕,漏报几乎不可避免。
这个项目想回答的问题很朴素:能不能让摄像头自己"看懂"灾害现场?
具体来说,系统需要在灾害画面中同时识别 6 类关键目标:
- 火焰(fire)、烟雾(smoke)——灾害本身的直接信号;
- 行人(person)——被困或疏散人员;
- 小型车辆、大型车辆、两轮车——救援车辆与社会车辆调度。
一句话概括:让 AI 充当灾害现场的"瞭望塔",火一冒头就报警,人车分布一目了然。
除了识别本身,项目还重点解决两个工程上的"老大难":
二、技术栈
整个项目围绕"训练—评估—导出—部署"一条链搭建,核心选型如下:
| 深度学习框架 | PyTorch 2.6 + CUDA 12.6 | GPU 训练(RTX 4060 Laptop 8GB) |
| 检测框架 | Ultralytics YOLO(8.4.x) | YOLO26m 主模型 + YOLO11m、RT-DETR-L 对照 |
| 数据质量 | cleanlab 2.7.1 | 目标检测标签噪声筛查 |
| 超参搜索 | 自研 sweep 脚本 | 学习率 × 优化器网格快扫 |
| 部署推理 | ONNX Runtime(opset 17) | end2end NMS-free 导出,Web 端直接推理 |
| 可视化 | Matplotlib(论文级 300dpi) | 23 张实验图表脚本化生成 |
| 系统端 | Web 前后端 + 统计大屏 | 图片/视频/摄像头识别、历史记录、大屏 |
几个值得说的细节:
- 训练可复现性:统一 seed=42 + deterministic,数据集打了哈希指纹(08ec6545…),Git 提交号写入模型元数据,任何一次实验都能精确复现;
- 先扫后训:正式训练前用 3 epoch 快扫跑了一遍学习率网格(0.001 / 0.005 / 0.01 / 0.02)和 SGD vs AdamW 对比,用最小成本锁定 SGD + lr0=0.001 再开 300 epoch 大战;
- 数据先体检再开训:用 5 epoch 的轻量基线模型 + cleanlab 给全量标注做"胃镜",发现约 4.25% 可疑标注,低于 10% 自动清洗阈值,保留原标注但全程留痕。
三、功能介绍
系统最终落地为一个完整的 Web 应用,围绕"识别 — 记录 — 分析"三个环节展开。
1)图片识别:上传单张或多张图片,右侧面板实时给出检测类别、置信度和推理耗时(实测约 117–143ms),检测结果缩略图自动入列。
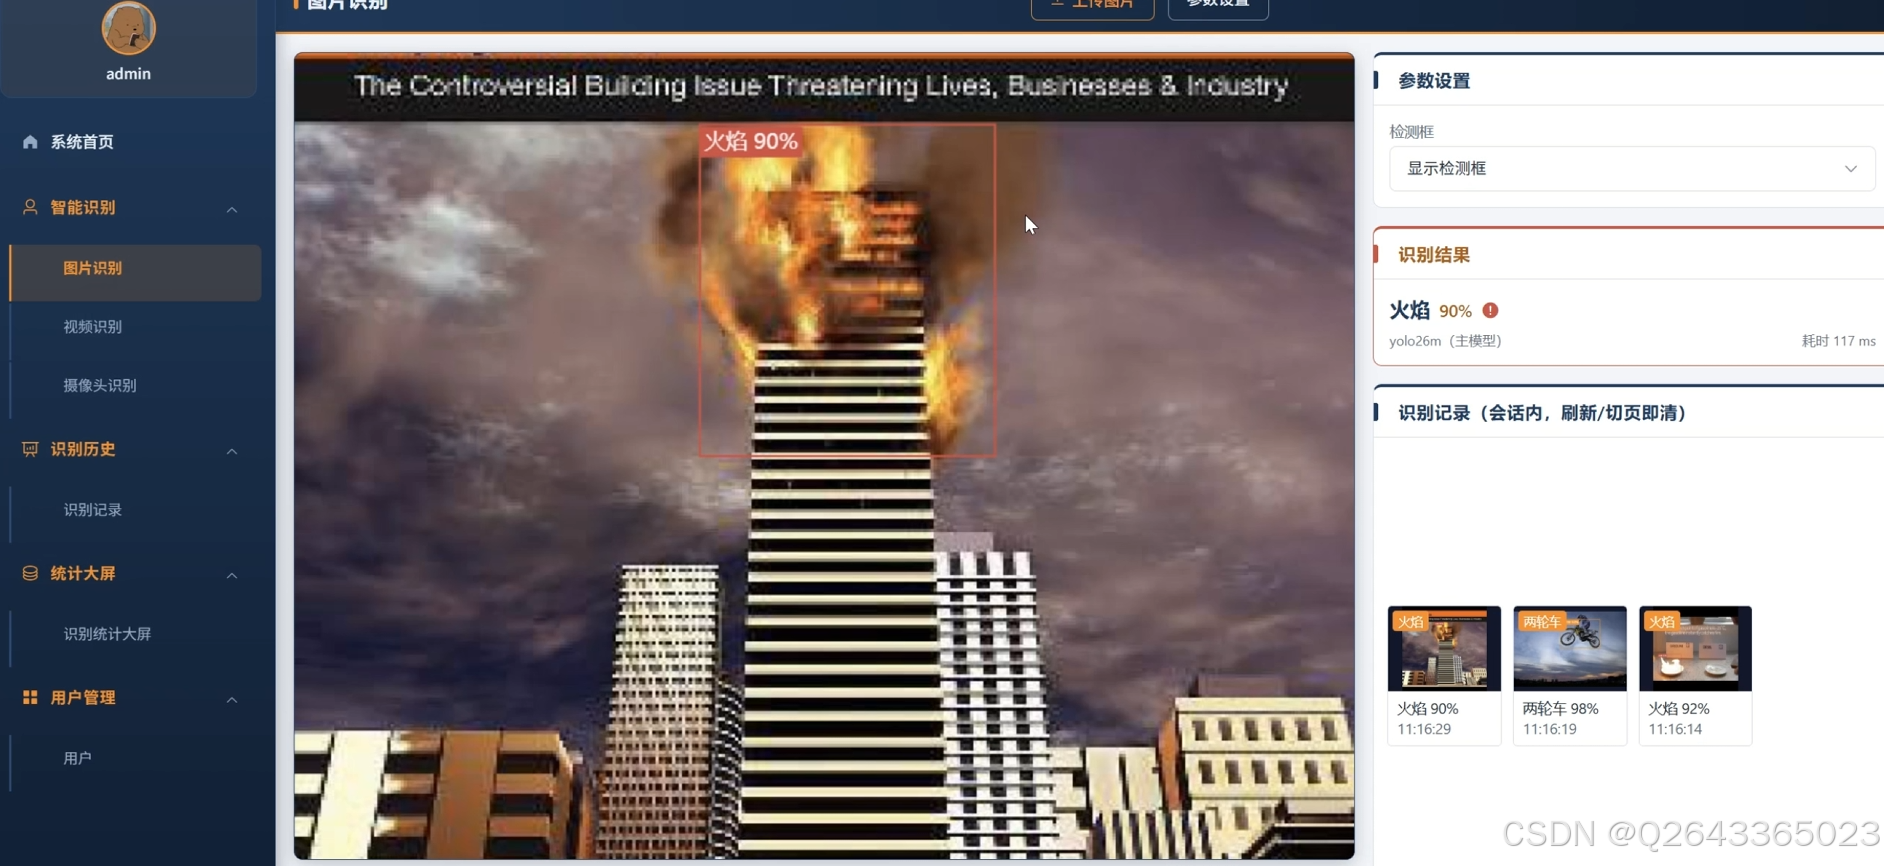
图:图片识别页面。左侧主画布绘制检测框(“火焰 90%”),右侧展示识别结果与本次会话的识别记录。
2)视频识别:上传视频后逐帧推理,画面实时叠加检测框;右侧同步统计"近 60s 类别占比"柱状图,火、烟、人、车的动态变化一眼可见。
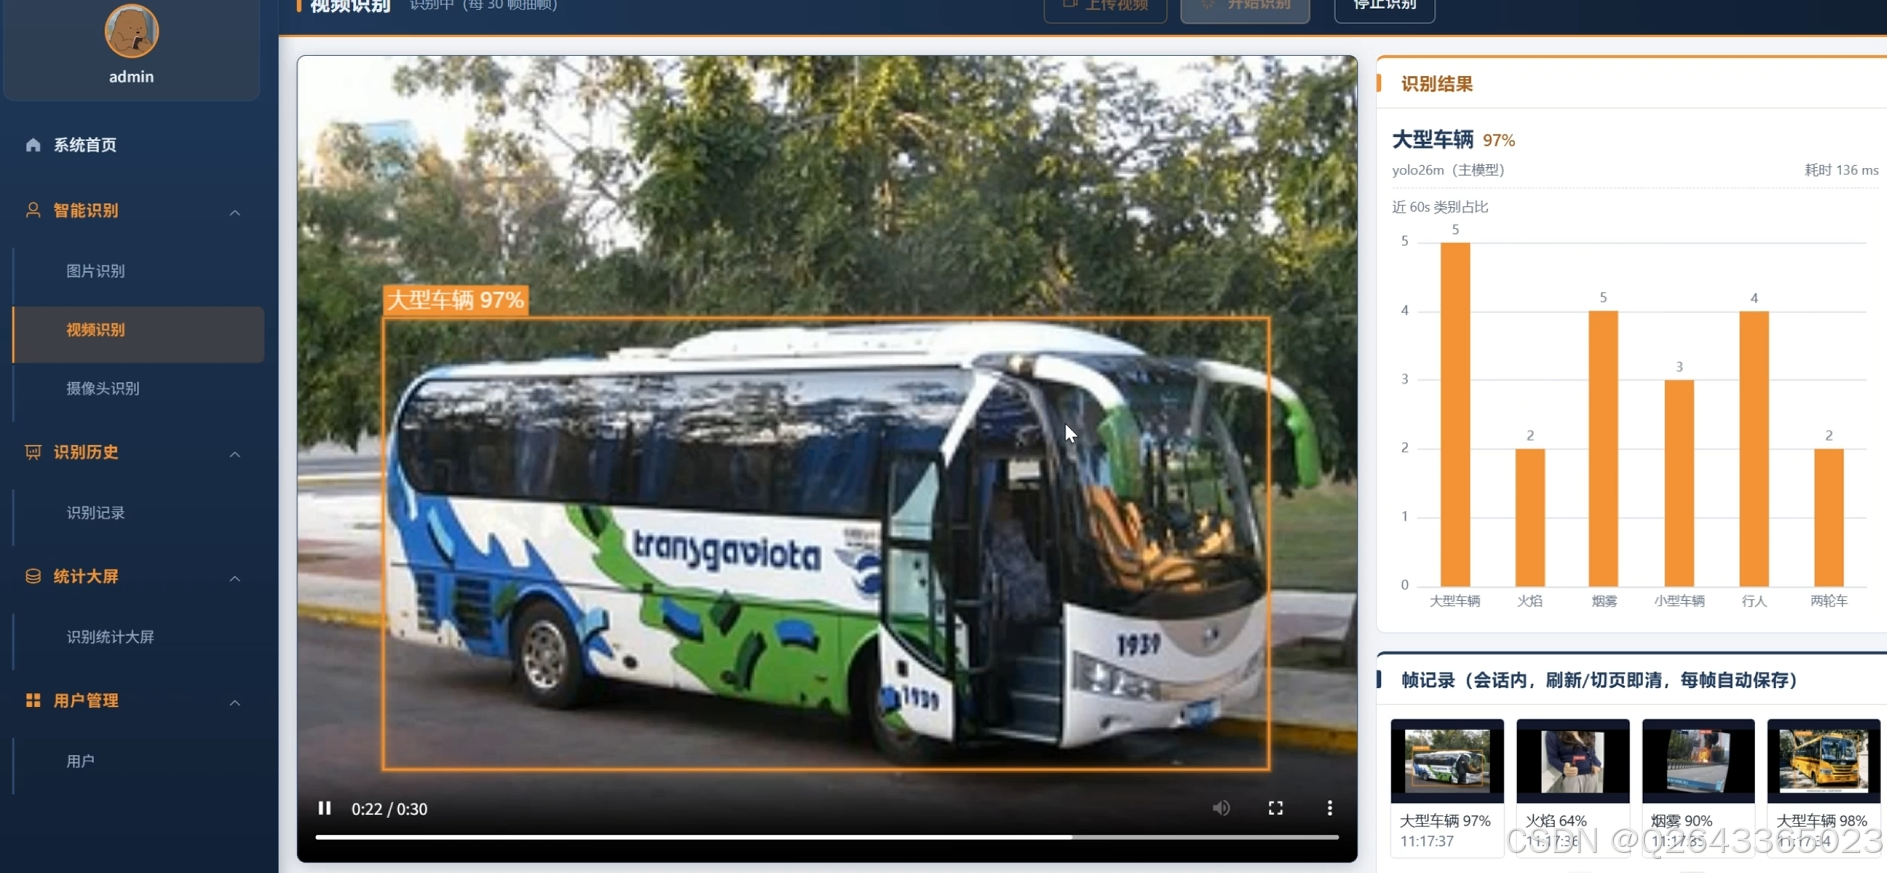
图:视频识别页面对大巴车检出"大型车辆 97%",右侧柱状图实时统计各类别出现频次。
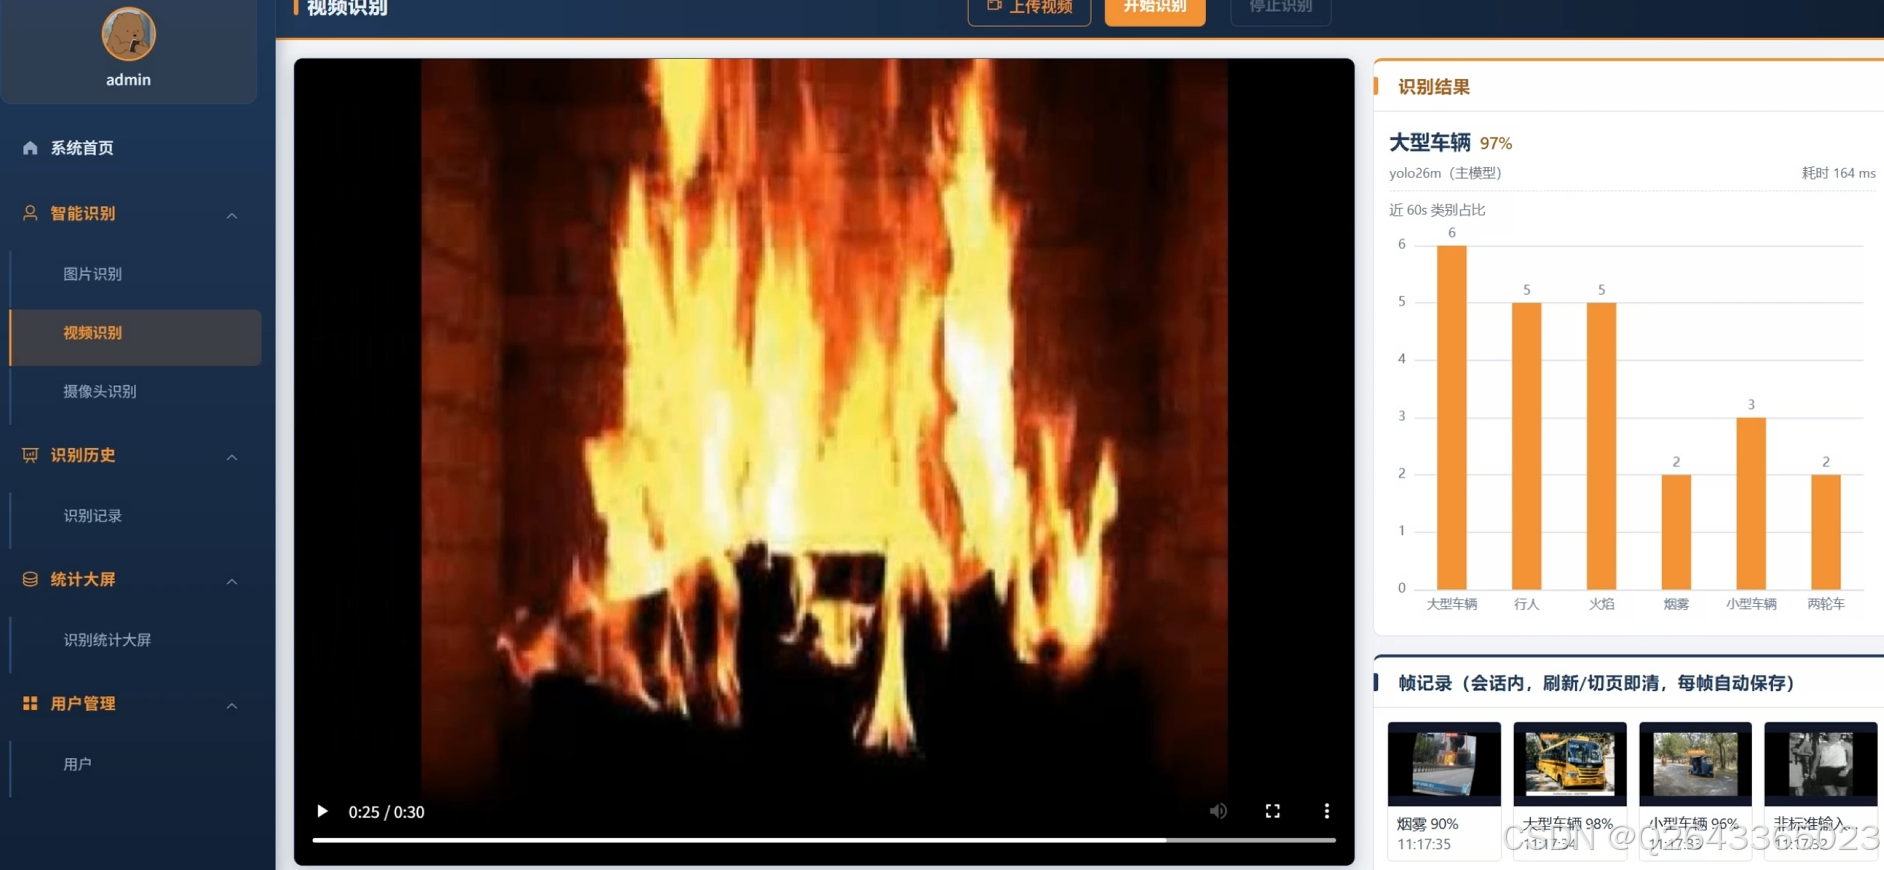
图:灾害视频检测示例,火焰检出置信度 74%,面板同时显示主模型型号与推理耗时。
3)识别历史:每次识别自动落库,按时间线记录媒体类型、检测类别、平均置信度、所用模型,支持详情查看与删除——这就是应急场景的"出警台账"。
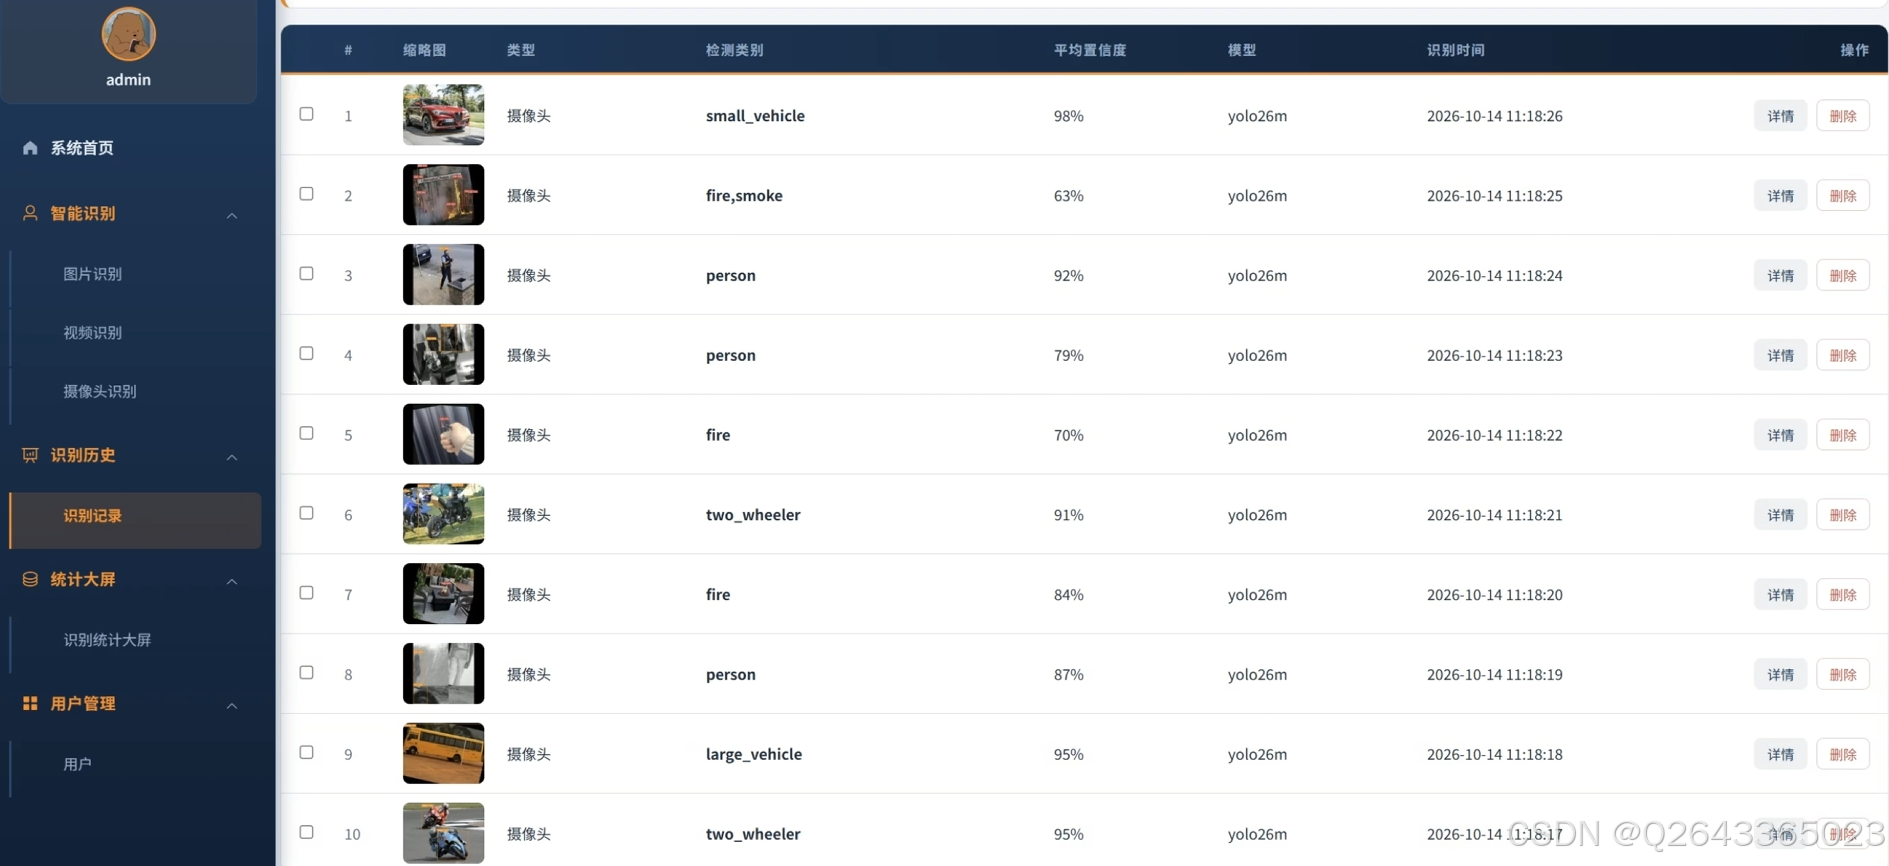
图:识别记录列表页,涵盖摄像头/图片等多种来源,按时间倒序排列。
4)统计大屏:把所有识别行为汇聚成运营视图——类别分布 Top8、近 14 天识别趋势、24h×7 识别时段热力图、置信度分布、识别成功率仪表盘。
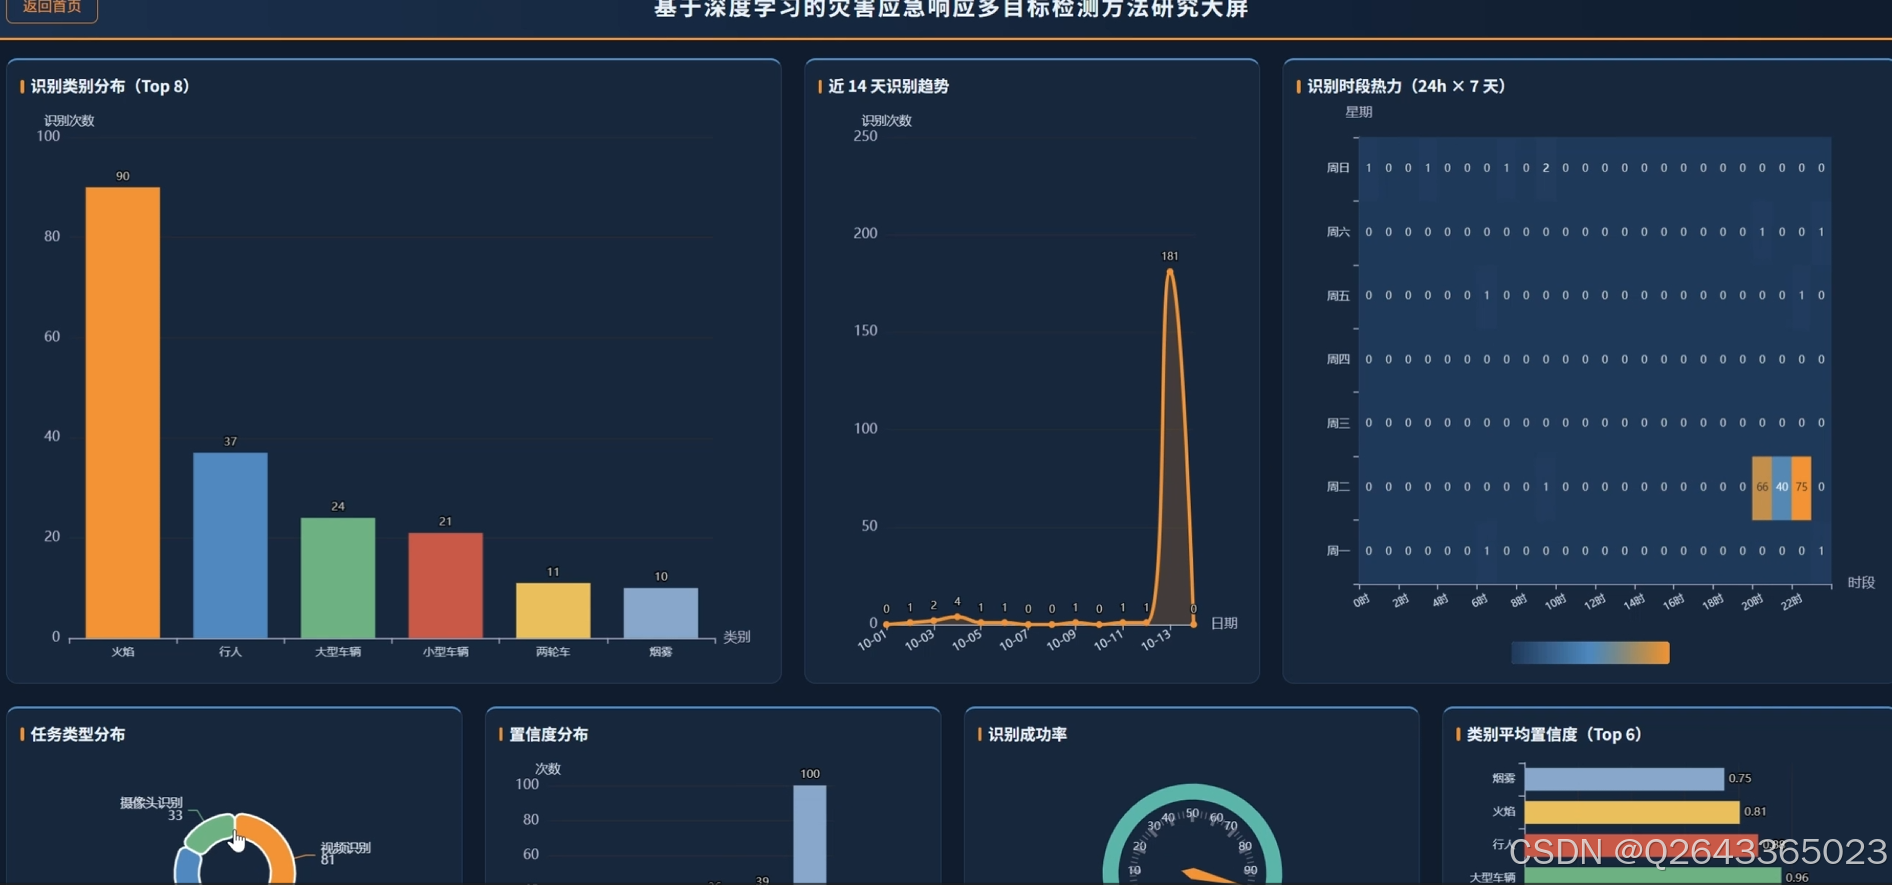
图:识别统计大屏,六个数据面板实时反映系统运行状态。
四、数据来源
项目使用 Kaggle 公开的 Disaster Response Object Detection Dataset(灾害应急响应目标检测数据集),并在其基础上完成了一整套数据工程。
基本盘:共 12,440 张图像、21,165 个标注框,按官方划分冻结使用——训练 10,450 张、验证 1,556 张、测试 434 张。6 类目标分布并不均匀,最多的 fire(6,173 框)是最少的 smoke(1,513 框)的 4.08 倍,这也是后面指标分析里"烟雾难检"的伏笔。
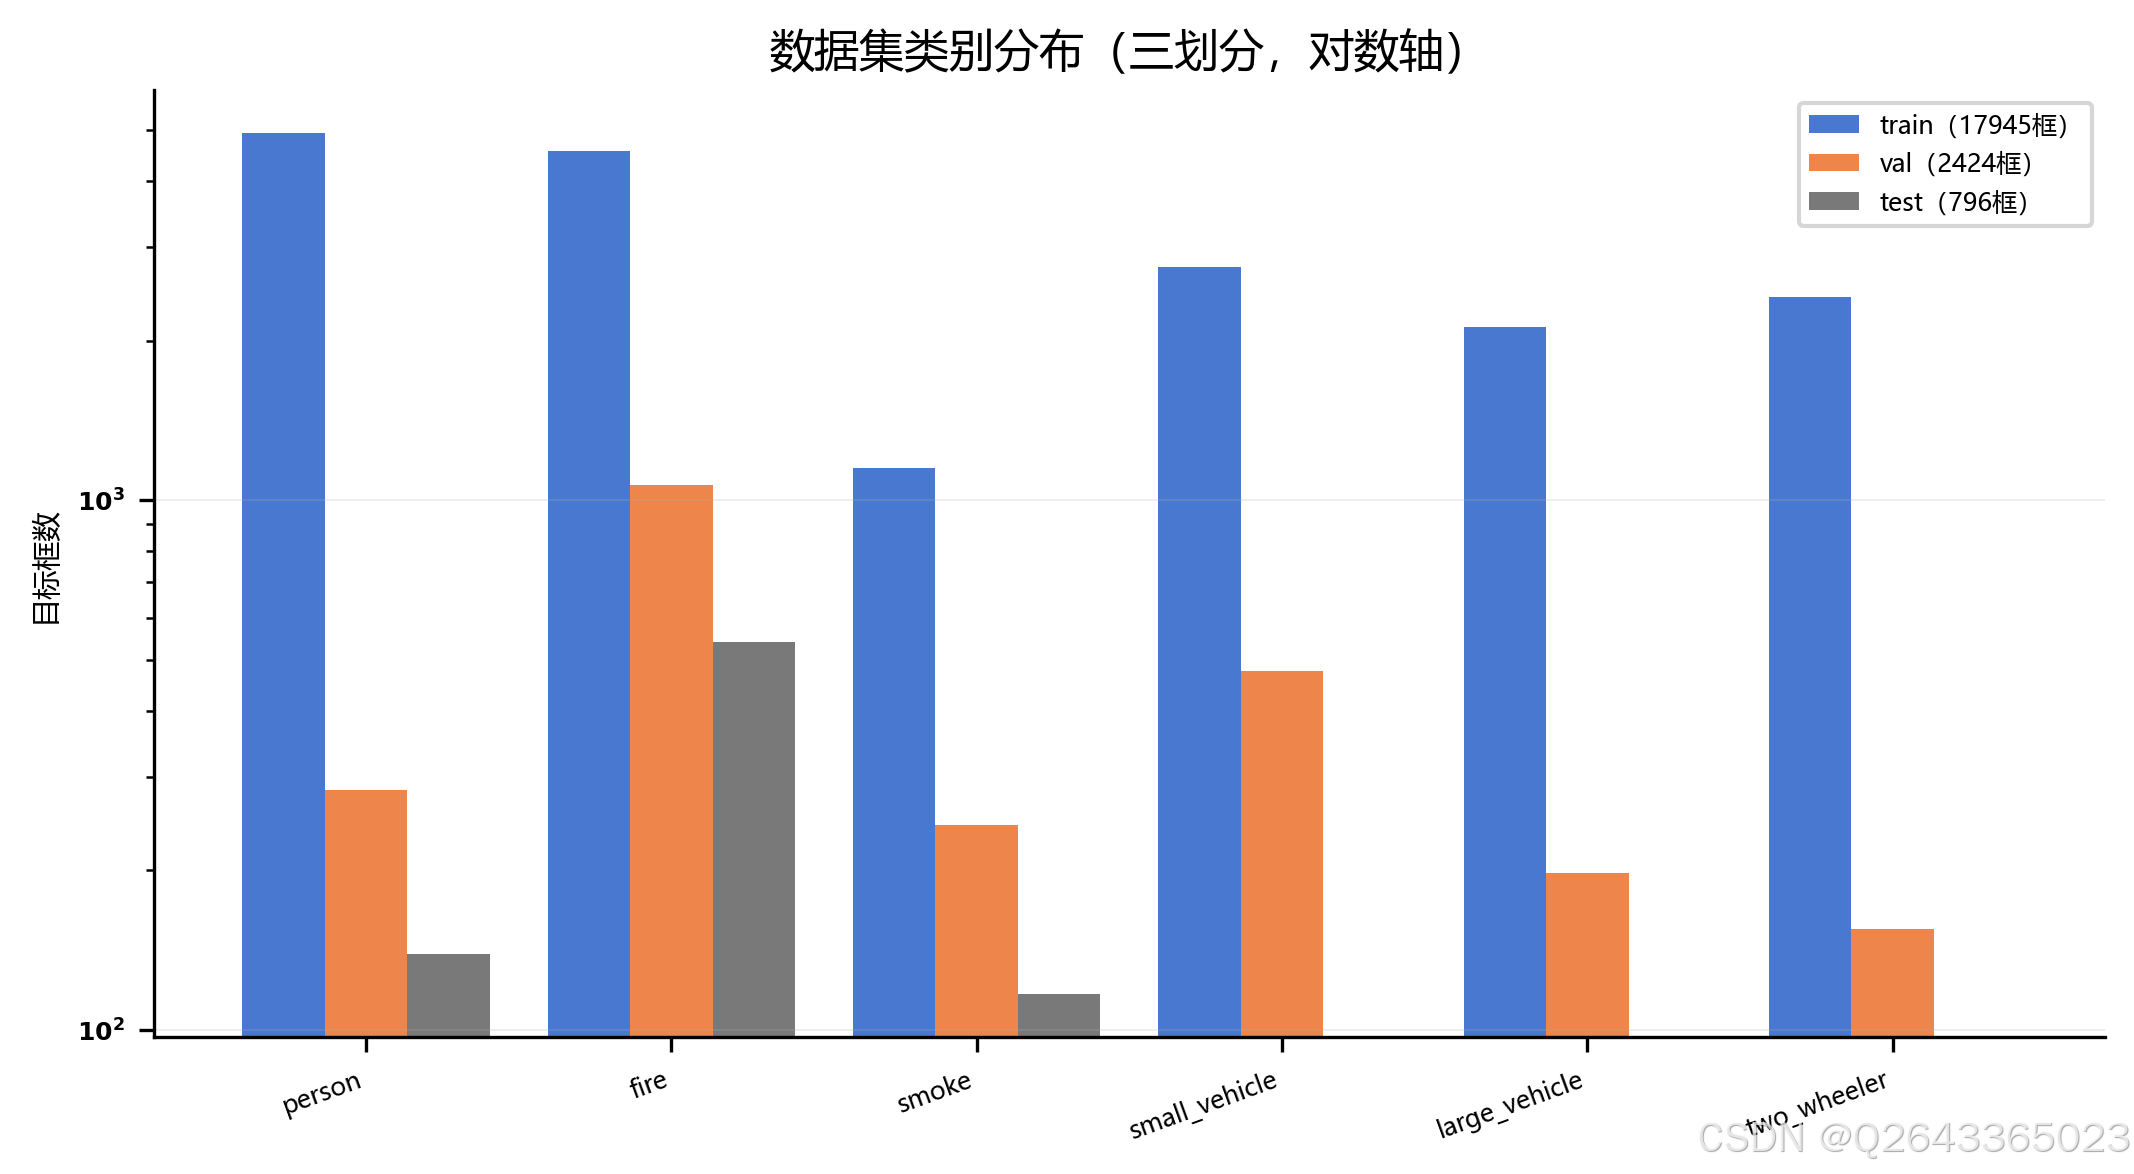
图:三划分下的各类别标注框数量(对数轴)。fire/person 占比最高,smoke 最稀缺。
数据体检三件套(训练前全部留痕):
- 完整性校验:全量图像 PIL 解码检查,损坏率 0;缺失标注/缺失图像各 1 对,142 张空标注背景图保留(负样本是有价值的);
- 标签噪声筛查:用 yolov8n 训练 5 epoch 作基线,cleanlab 扫出约 4.25% 可疑标注(34 处),低于 10% 阈值不自动删改,但生成了完整的隔离清单备查;
- 可行性评估:从每类最少实例数、小目标占比(2.8%)、类别不均衡度等 6 个维度打分,结论是"可实现但有风险"——风险点被精确锁定在 test 集缺 3 类车辆目标 上,并在模型卡片中如实披露。
五、实验对比
所有实验遵循"同一数据集、同一验证协议、同一随机种子"的公平对比原则。
主模型:YOLO26m
配置为 512×512 输入、batch=16、SGD(lr0=0.001,余弦退火)、Mosaic 增强收尾前 10 轮关闭。训练在 103 轮触发早停(patience=20),最优出现在第 54 轮,总耗时约 9 小时:
- mAP@0.5 = 0.8594(官方验证协议,fitness 峰值 0.861)
- mAP@0.5:0.95 = 0.6960
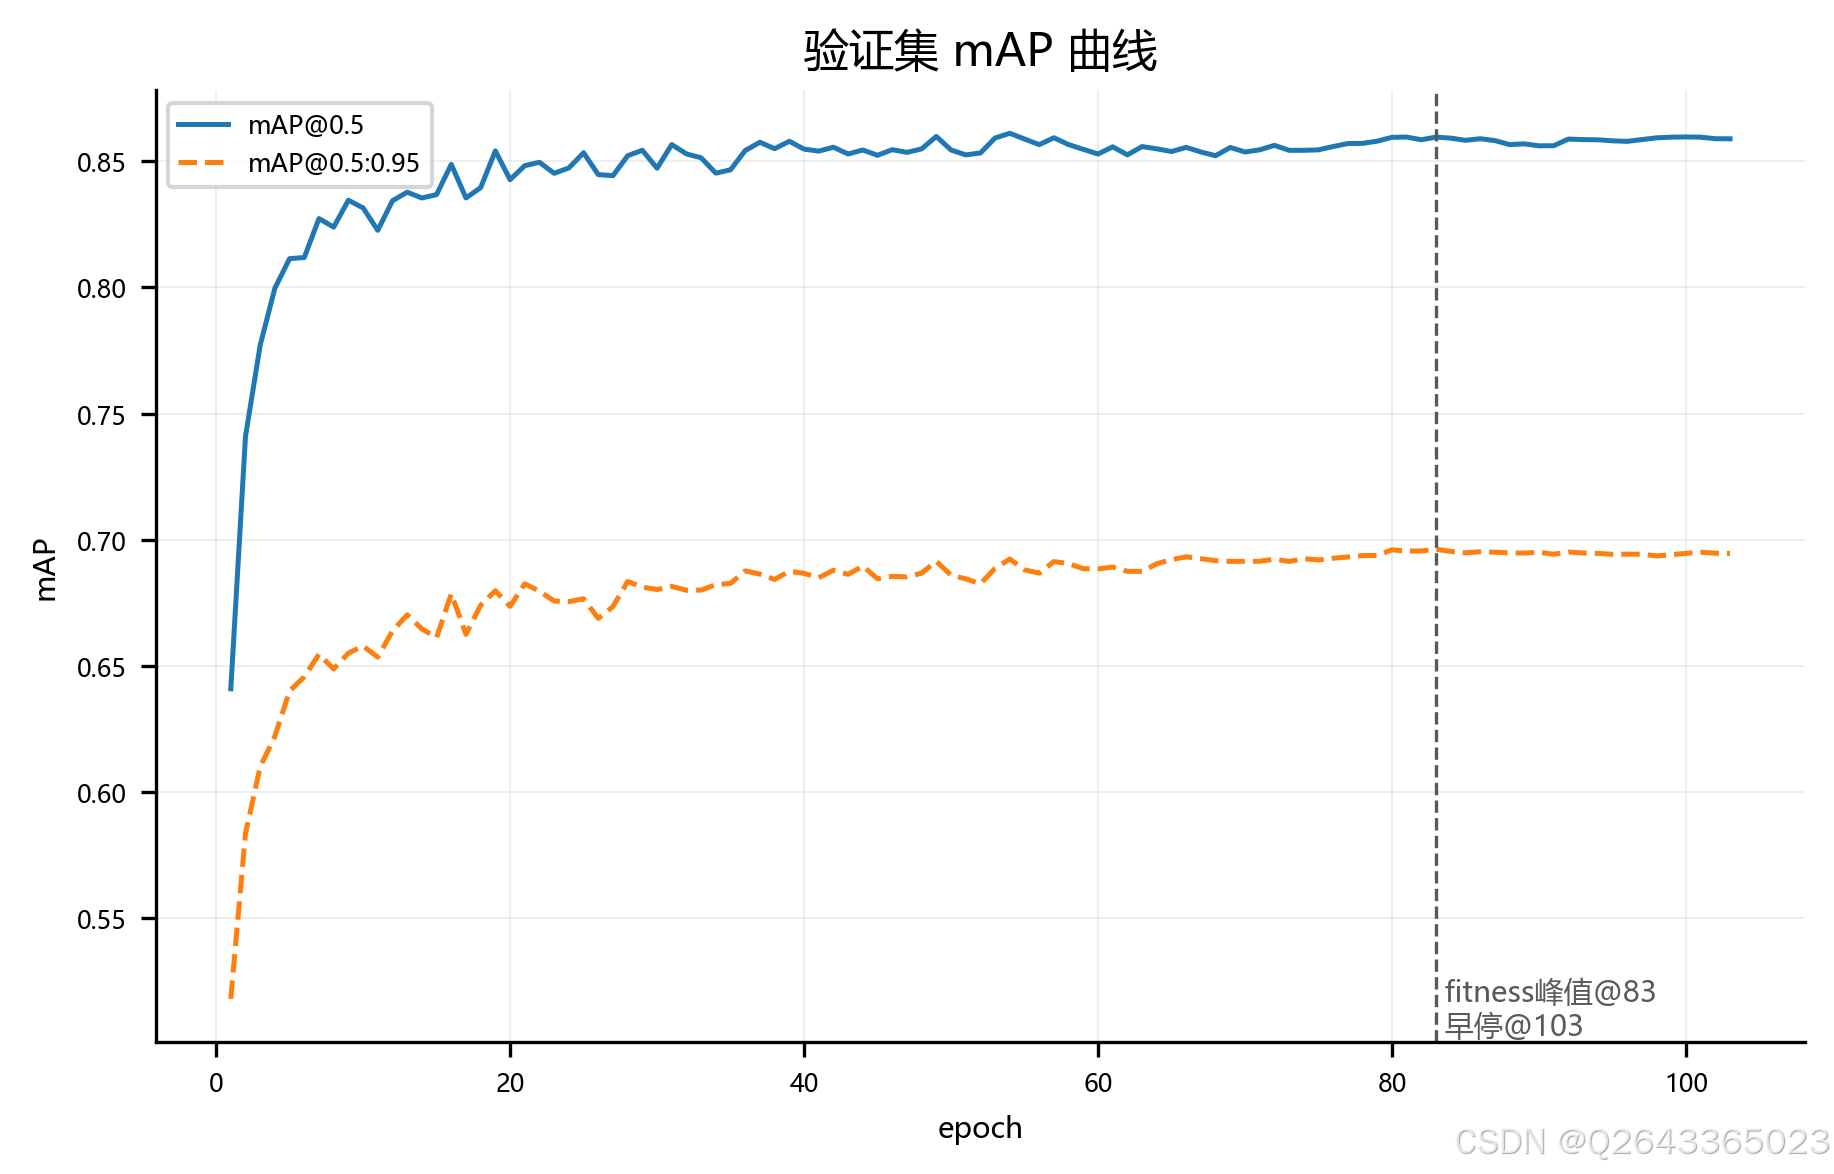
图:YOLO26m 验证集 mAP 曲线。前 10 轮快速爬升,约 30 轮后进入平台期,fitness 峰值出现在第 83 轮,第 103 轮早停。
对照组一:RT-DETR-L
Transformer 路线的 RT-DETR-L(32.8M 参数)最终 mAP@0.5 = 0.8532,与 YOLO26m 差距仅 0.8 个点,但训练耗时 12.1 小时比主模型多 34%,且 8GB 显存跑不下统一 batch=16(实测显存溢出到共享内存,速度骤降),被迫降为 batch=8——同精度下,YOLO26m 在消费级显卡上的工程友好度明显更高。
对照组二:YOLO11m(诚实披露)
YOLO11m 对照组在第 11 轮训练进程异常中断,只留下 10 轮记录(mAP@0.5 = 0.7598)。这个数字不构成完整对照——按 YOLO26m 前 10 轮约 0.84 的爬升速度看,中断时尚在爬坡期。项目中如实在元数据里记录了中断事实,也提醒我们:长训练任务必须配进程守护。
三方对比一览
| YOLO26m(主模型) | 20.4M | 0.8594 | 0.6960 | 103(早停) | ~9.0 h |
| RT-DETR-L | 32.8M | 0.8532 | 0.6802 | 82(早停) | ~12.1 h |
| YOLO11m(中断) | 20.1M | 0.7598* | 0.5634* | 仅 10 轮 | — |
注:YOLO11m 为训练中断时的中间值,仅供参考。
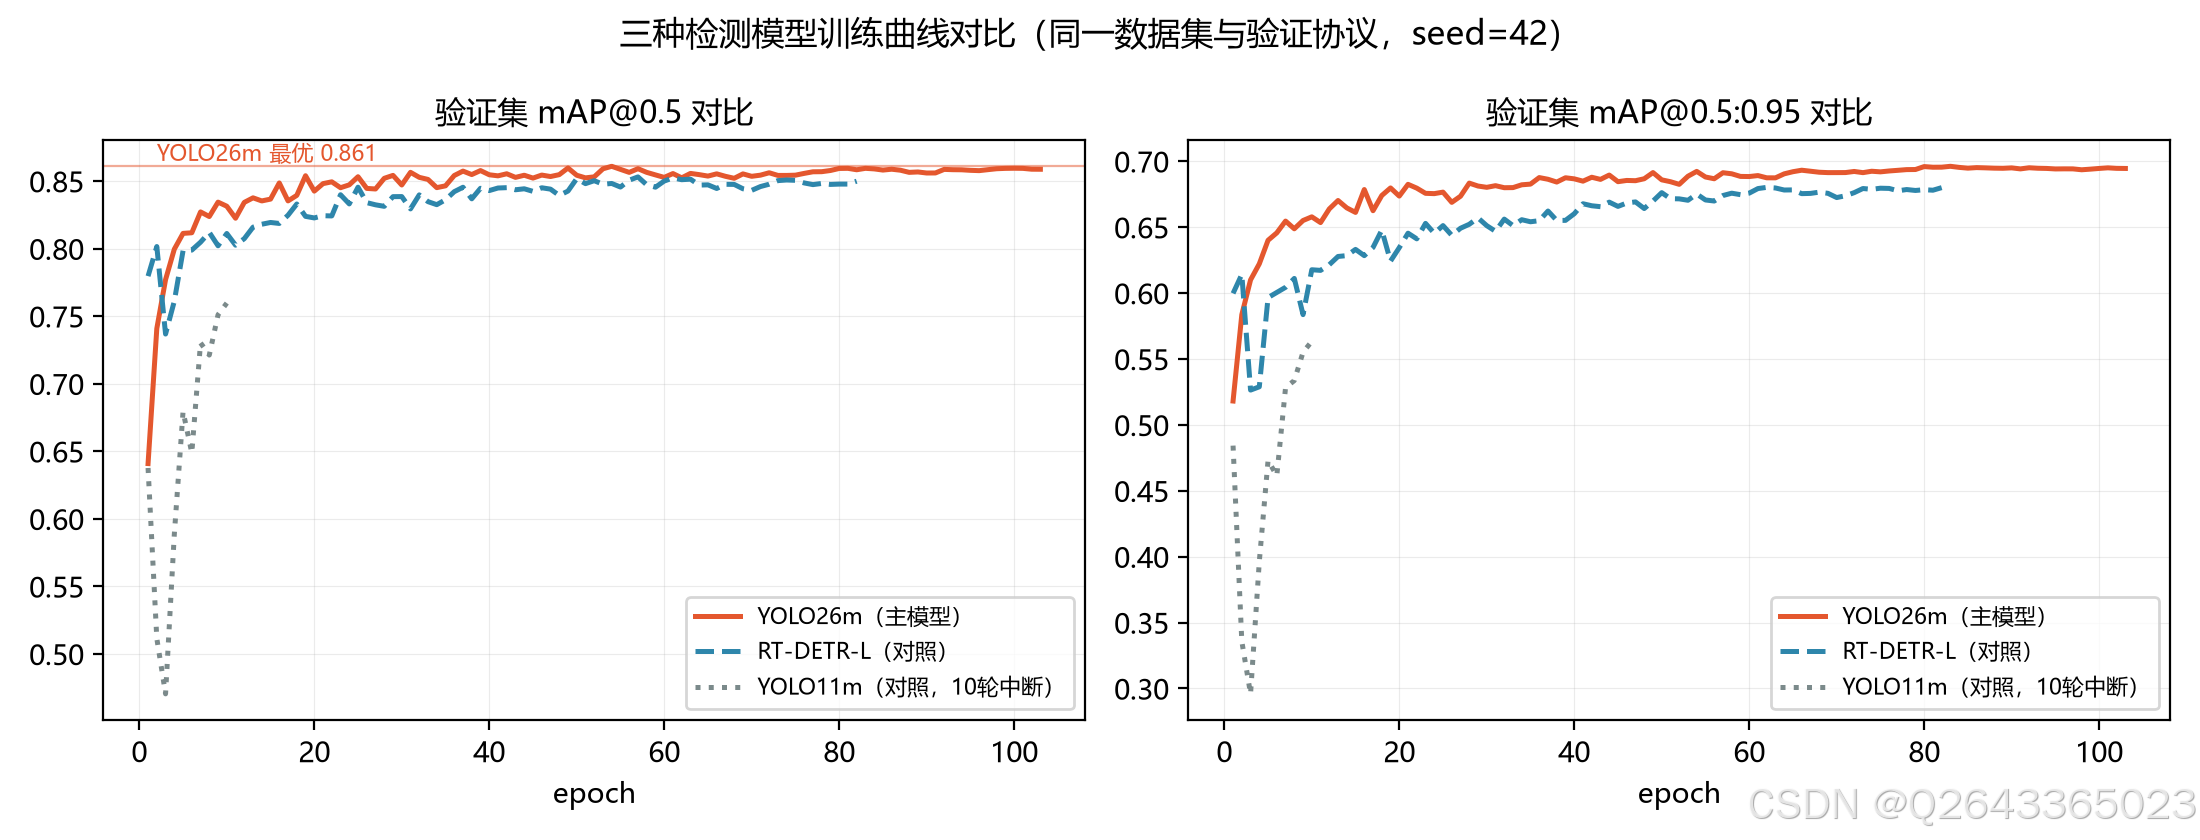
图:三种模型在同一数据集、同一验证协议下的 mAP 训练曲线对比(seed=42)。
导出部署环节的一致性校验:主模型导出为 end2end NMS-free 的 ONNX(opset 17,输出形状 (N,300,6)),与 PyTorch 原生推理做了三项 parity 校验——框数量差为 0,置信度最大绝对误差 0.000222,全部通过。也就是说,部署到 Web 端的模型和实验室里那个是"同一个大脑"。
域外拒识标定:用 Energy Score(95% 分位标定,阈值 0.6298)在 avatar / house / landscape 三类非灾害图像上测试,拒识率 100%,验证集正常样本通过率 94.99%——风景照进来会被直接劝退,而不是硬编检测框。
六、可视化分析
这一节从 23 张实验图表中挑出最有信息量的几张(训练曲线与模型对比见第五节、数据分布见第四节),带你看懂模型的"强项与软肋"。
① 混淆矩阵:谁是"惯犯",谁是"冤案"
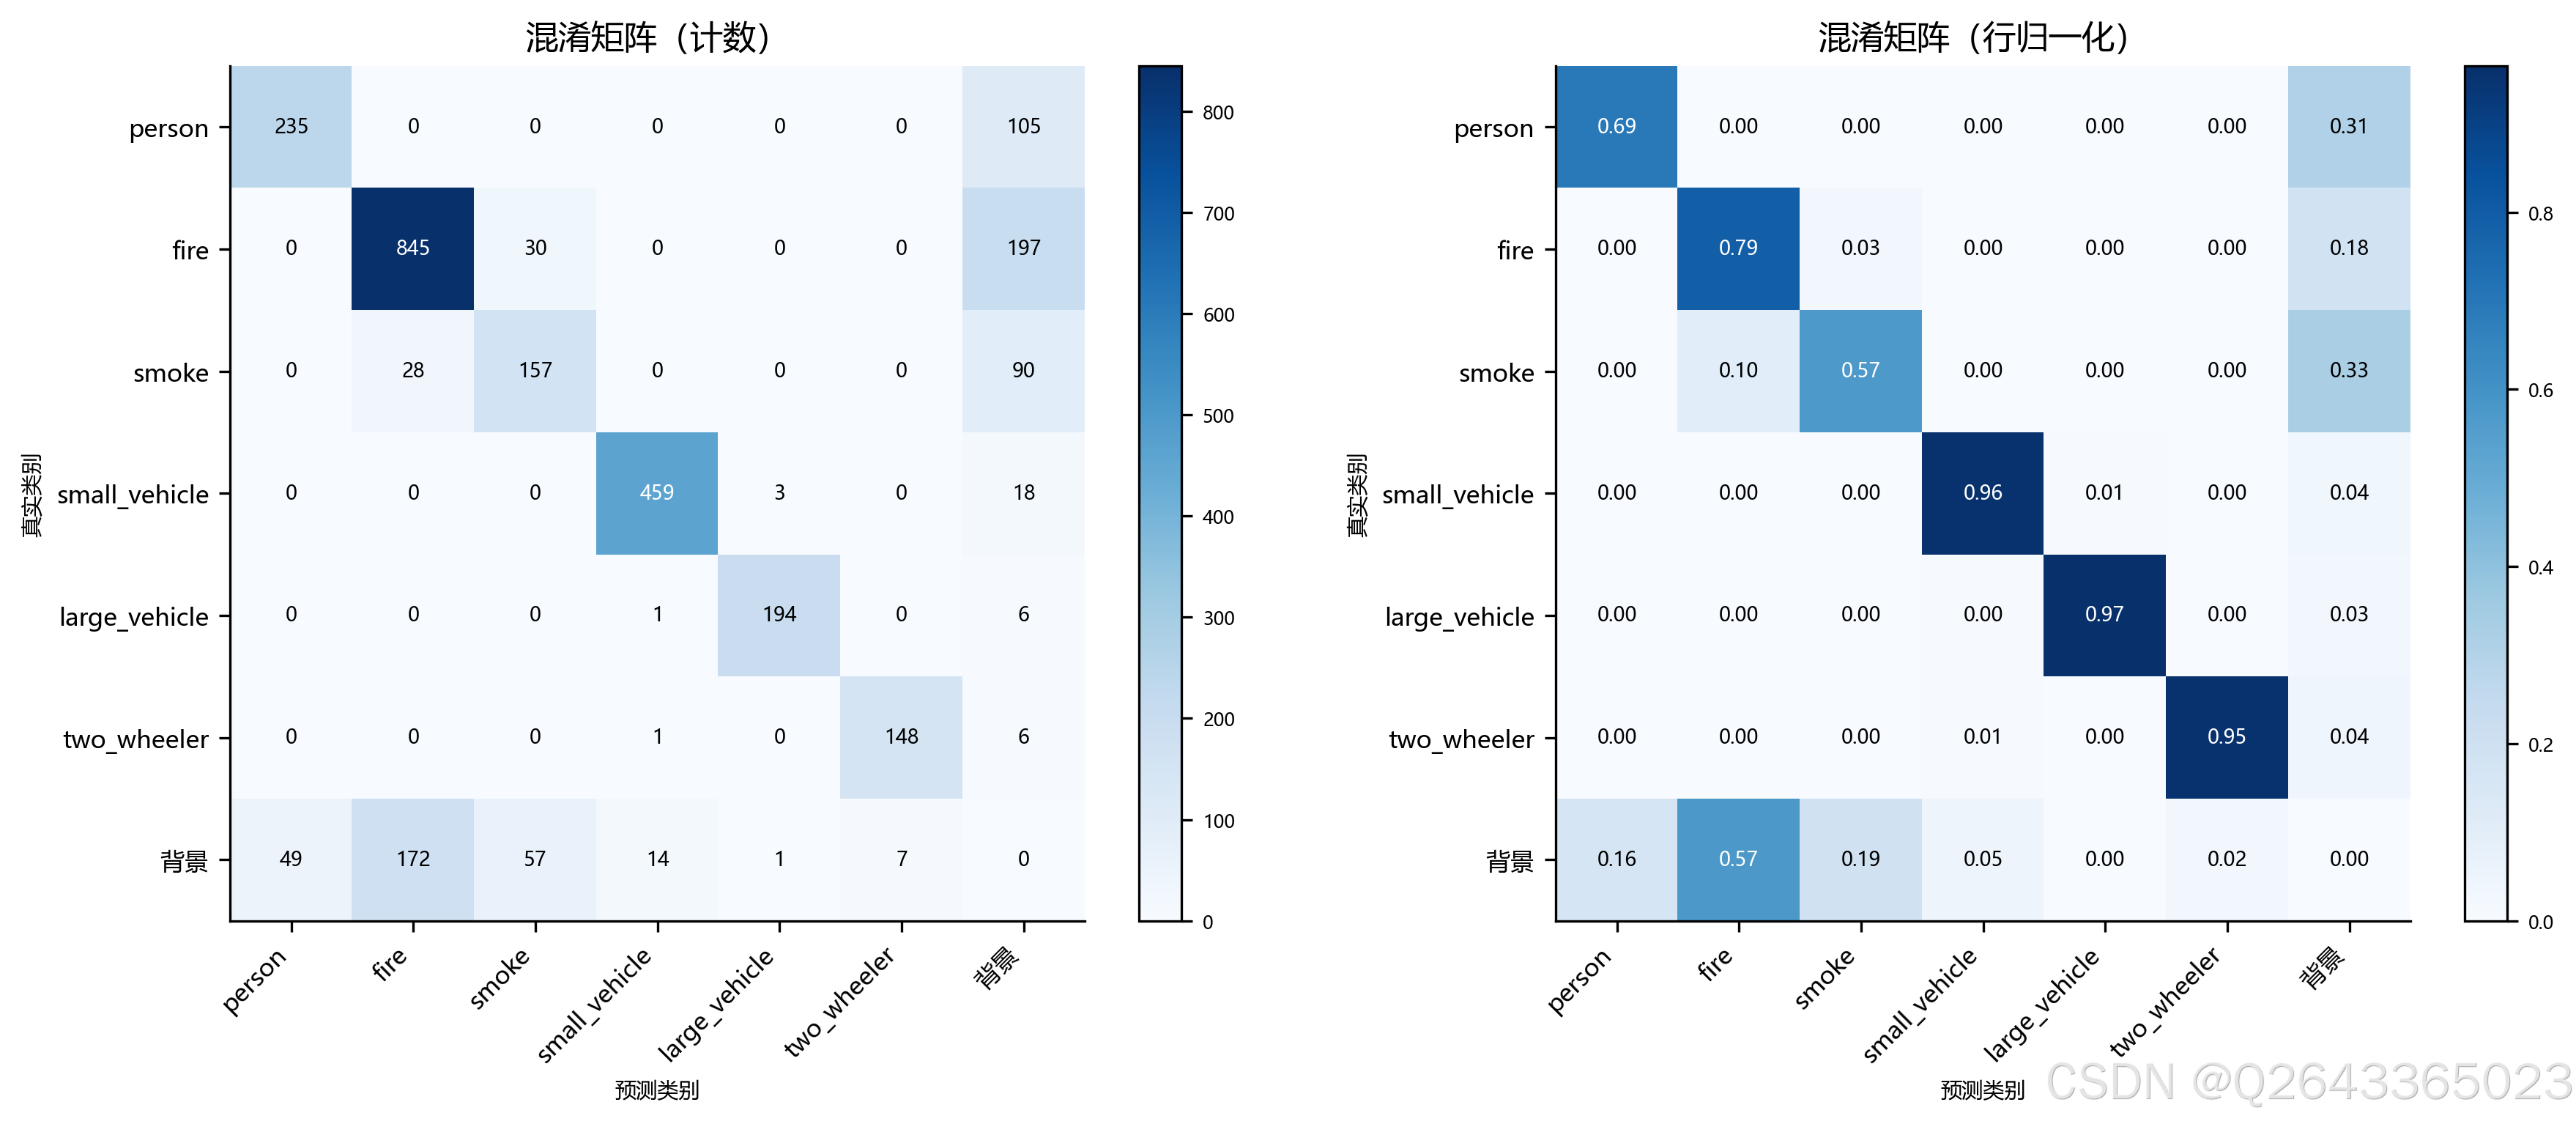
图:验证集混淆矩阵(左:计数,右:行归一化)。对角线上车辆类高达 0.95–0.97,而非对角线上大量目标被误判为"背景"。
混淆矩阵暴露出两个典型问题:person 有 31% 漏成了背景(弱光、远小目标下人形特征不稳定),smoke 的对角值只有 0.57——烟雾没有固定形状、边界模糊,是全场最难的类别。反过来,车辆类几乎不犯类间混淆,说明"火烟人车"这种跨模态类目组合下,模型优先学会了区分差异大的类别。
② 逐类别 AP:长尾的代价
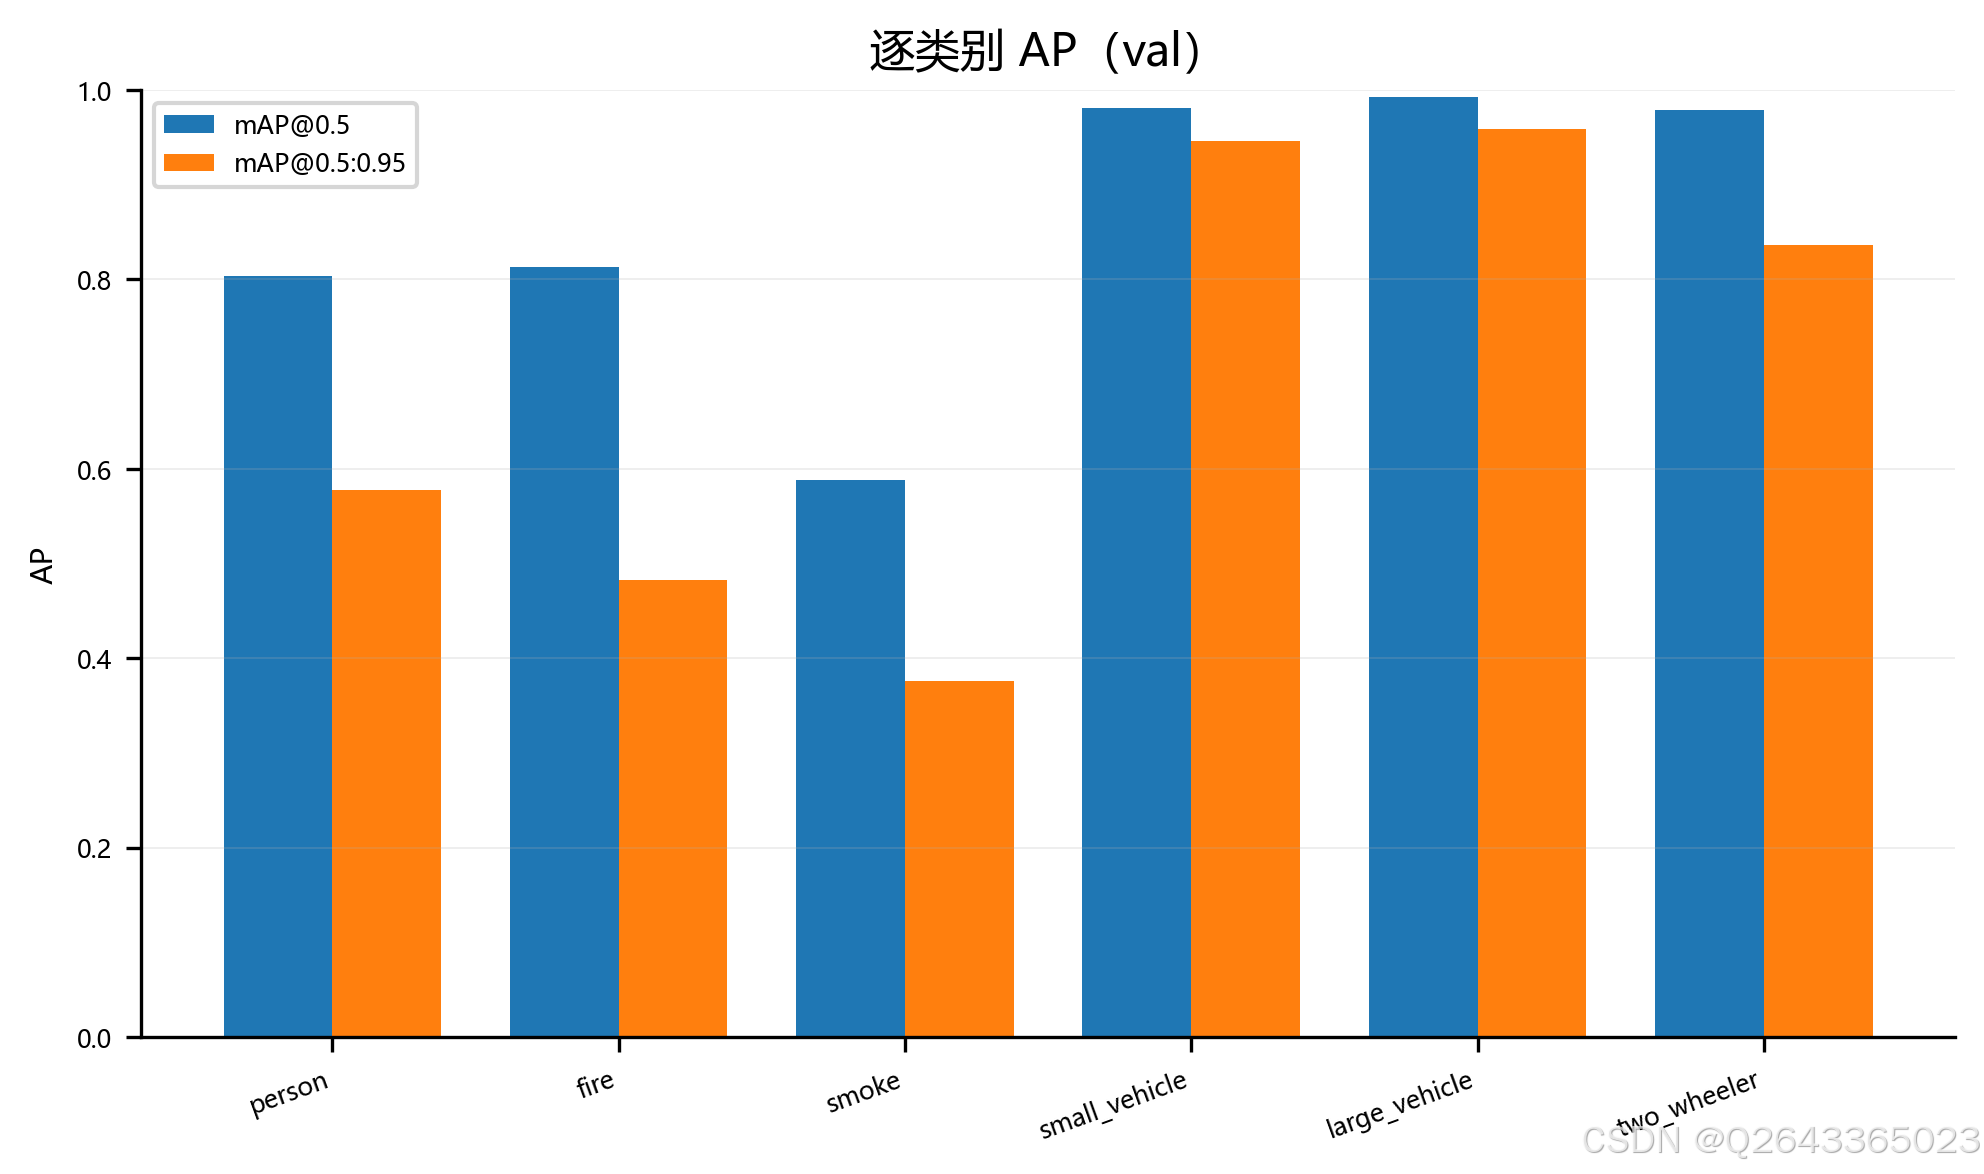
图:各类别 mAP@0.5 与 mAP@0.5:0.95。车辆三兄弟(0.96+)与 smoke(0.59)差距悬殊。
smoke 的 AP@0.5 仅 0.59,而它的训练样本恰好是最少的(1,513 框)——类不均衡 + 目标形态无定式的双重打击。这也是后续改进方向(如针对 smoke 的过采样与增强加权)的直接依据。
③ 误检/漏检分解:错在哪一类
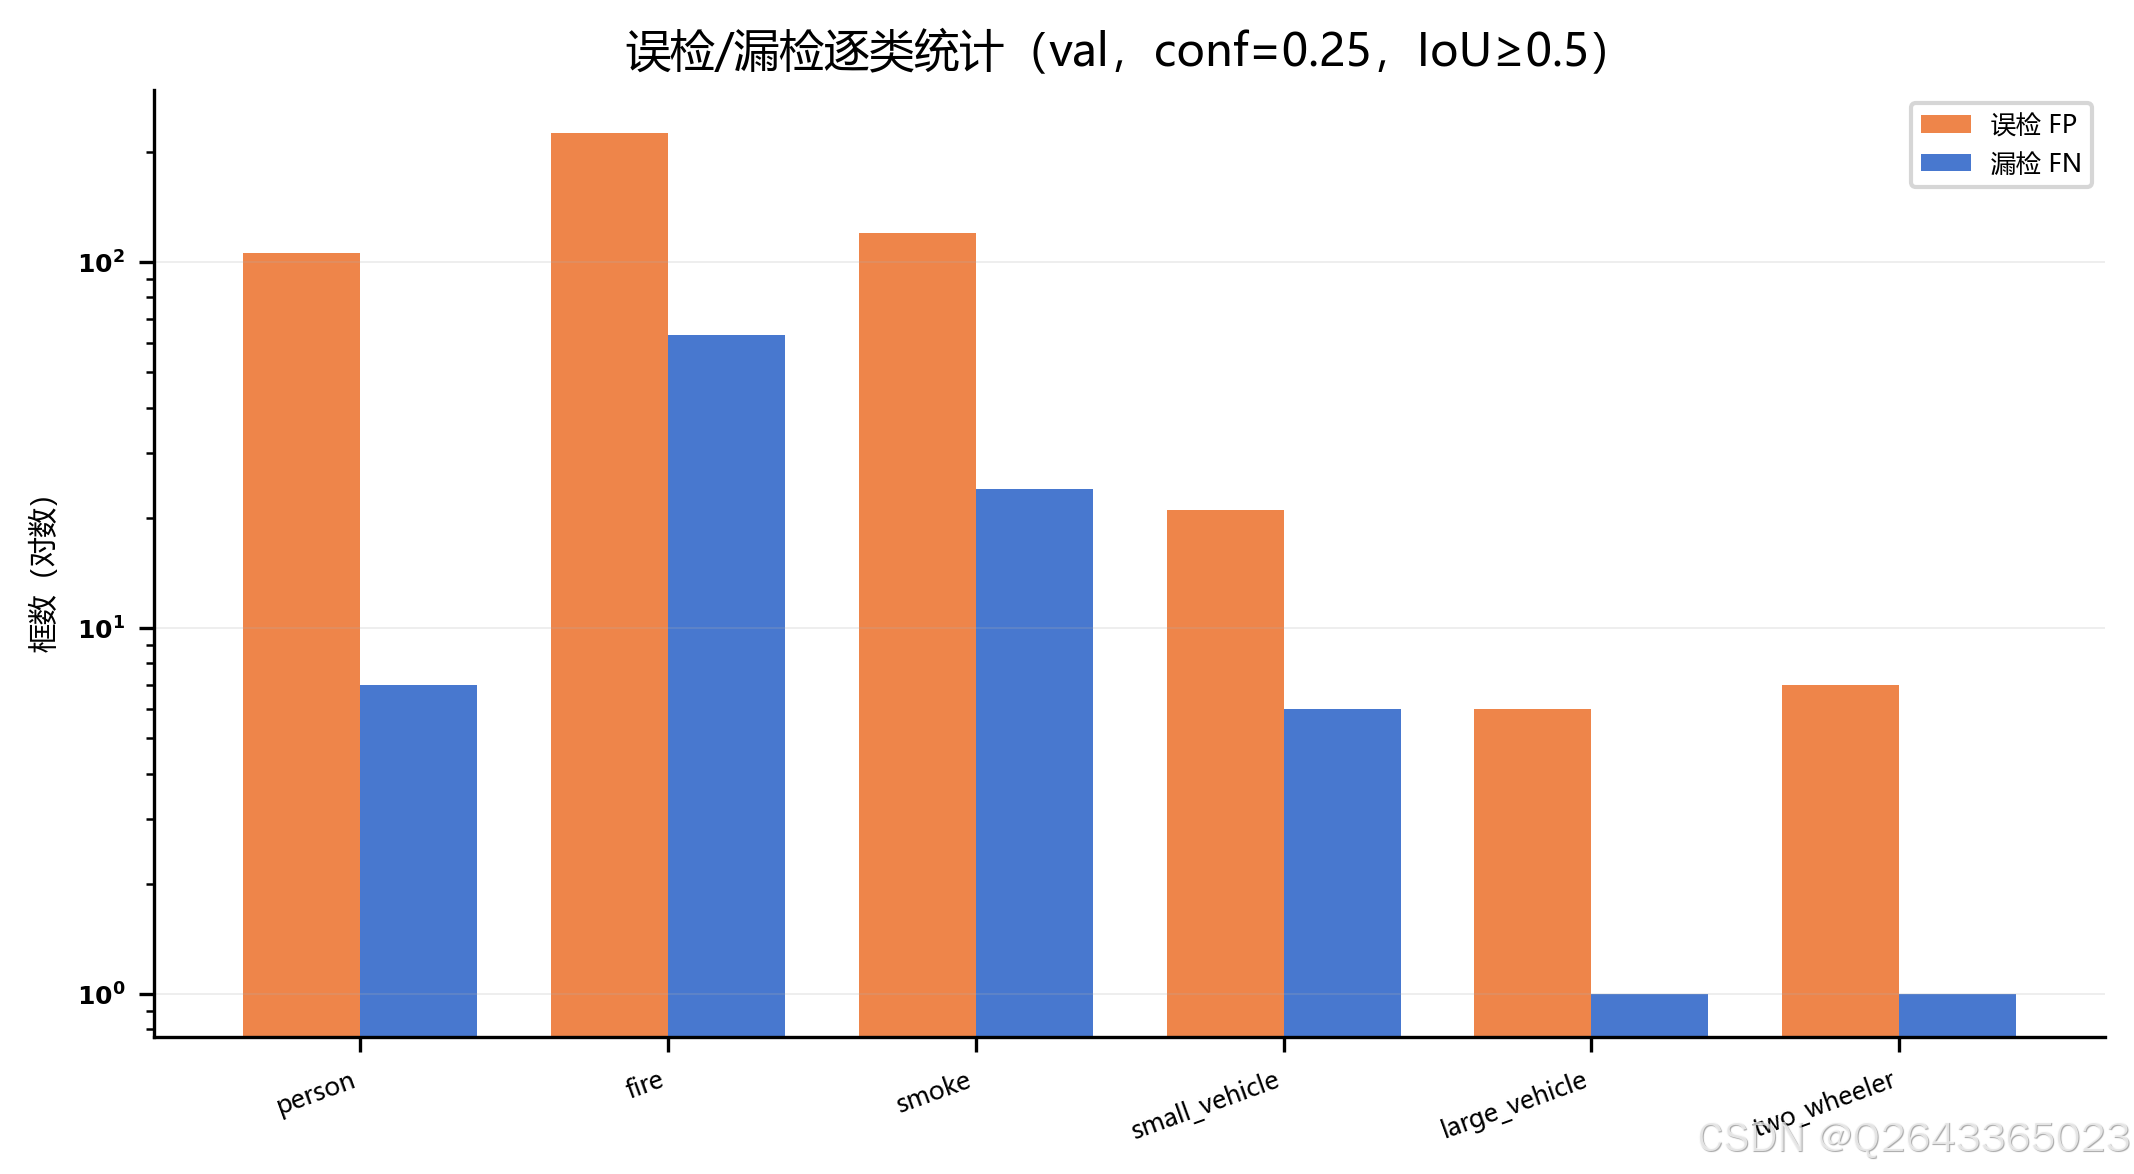
图:conf=0.25、IoU≥0.5 下的逐类别误检(FP)与漏检(FN)统计(对数轴)。
fire 是误检重灾区(约 240 个 FP)——晚霞、灯光这类"长得像火"的场景最容易翻车,这恰好印证了域外拒识机制的必要性;车辆类 FP/FN 双低,表现最稳。
④ 数据分布(见第四节图):smoke 样本只有 fire 的 1/4,读指标前先看盘子里的菜——任何低分都要放在"样本稀缺"的背景下解读。
⑤ 收尾策略对比(文字速览):项目还对比了标准 val、调优工作点、640 高分辨率推理与 TTA 四种收尾方案:标准与调优工作点并列 0.8610,640 高分辨率反而掉到 0.7942(训练 512 推理 640 的尺寸失配),TTA 0.8200。结论清晰:保持与训练一致的 512 工作点就是最优解,花哨的收尾技巧不加分。
⑥ 系统侧数据回流:统计大屏把每一次线上识别变成可分析的数据资产:类别分布、时段热力图、置信度分布持续累积,为下一轮"数据回流 → 模型迭代"提供弹药。
七、总结
这个项目把"灾害应急目标检测"从论文构想一路做到了可用的系统,回顾全程,有三条经验值得复用:
1)工程纪律比调参玄学更涨分。 学习率先快扫再决战、seed 固定、数据哈希指纹、Git 提交号写入模型元数据——这些不起眼的习惯,让每一次实验都可追溯、可复现,排错时省下大量时间。
2)"知边界"和"提精度"同样重要。 Energy 拒识把风景照 100% 拦在门外,parity 校验保证部署零精度损失,模型卡片如实披露 test 集缺 3 类的局限——一个敢说"我不认识"和"我做不到"的系统,才敢被用在应急场景。
3)诚实的实验记录是资产。 YOLO11m 中断了就标注"仅 10 轮,不构成对照",而不是硬凑一个好看的表格。真实数据 0.8594 的 mAP@0.5,比注水的故事更有说服力。
下一步计划:针对 smoke 类别做定向增强与过采样;引入小目标场景(航拍视角)专项优化;把 Energy 单防线升级为 Energy + 特征库双防线,进一步压缩漏拒风险。
更多推荐
毕设哪些能做,哪些会把你坑到延毕 [毕设选题这件事,选对了是加分项,选错了是噩梦开始](https://blog.csdn.net/IT_YQG_/article/details/166254222?spm= 1011.2415.3001.5331) 从大模型到多模态:2027届计算机毕设最值得冲的AI选题方向 选对毕设题目,等于答辩过了一半,哪些能做,哪些会把你坑到延毕
源码项目、定制开发、文档报告、PPT、代码答疑 希望和大家多多交流 ↓↓↓↓↓




评论前必须登录!
注册