 网硕互联帮助中心
前言

上一篇《Django篇 01》中,我们创建了第一个Django项目和应用,写出了第一个视图函数——return HttpResponse("你好!")。但你可能会想:为什么访问/blog/会执行那个函数?如果我想访问/blog/article/1/怎么办?如果我想从URL中提取参数(比如文章ID)传给视图怎么办?
这些问题的答案都在Django的URL路由系统中。URL路由是Django请求处理流程的入口——用户访问的每一个URL,都要通过路由表找到对应的视图函数。如果说Django是一个"餐厅",URL路由就是"菜单"——用户说"我要这个菜",路由告诉后厨"做这个菜"。
本篇将系统学习Django的URL路由配置和视图函数基础。两者密不可分——URL决定了请求发给谁,视图决定了请求怎么处理。学完本篇,你就能定义任意URL模式,将请求精确分发到对应的视图函数。
本节核心学习内容:
文章目录
- 前言
- 一、URL路由工作机制
-
- 1.1 从浏览器到视图的完整路径
- 1.2 path()函数详解
- 二、路径转换器:从URL中提取参数
-
- 2.1 内置路径转换器
- 2.2 path()实战:各种URL模式
- 2.3 对应的视图函数
- 2.4 转换器匹配失败的情况
- 三、re_path() 正则表达式路由
-
- 3.1 为什么需要re_path
- 3.2 path vs re_path 选型
- 四、include() 路由分发
-
- 4.1 为什么要用include
- 4.2 include的命名空间(namespace)
- 五、命名路由:告别硬编码URL
-
- 5.1 为什么要给路由命名
- 5.2 在视图中使用命名路由:reverse()
- 5.3 在模板中使用命名路由:url标签
- 六、视图(函数)详解
-
- 6.1 视图的本质
- 6.2 HttpRequest对象:请求的身份证
- 6.3 HttpResponse与子类:各种响应类型
- 6.4 实战:搜索功能(GET请求)
- 6.5 实战:留言板(POST请求)
- 七、综合实战:一个完整的URL路由配置
- 八、常见误区与避坑指南
- 九、核心总结
-
- URL路由
- 视图函数
- 请求处理流程
- 十、专栏订阅
一、URL路由工作机制
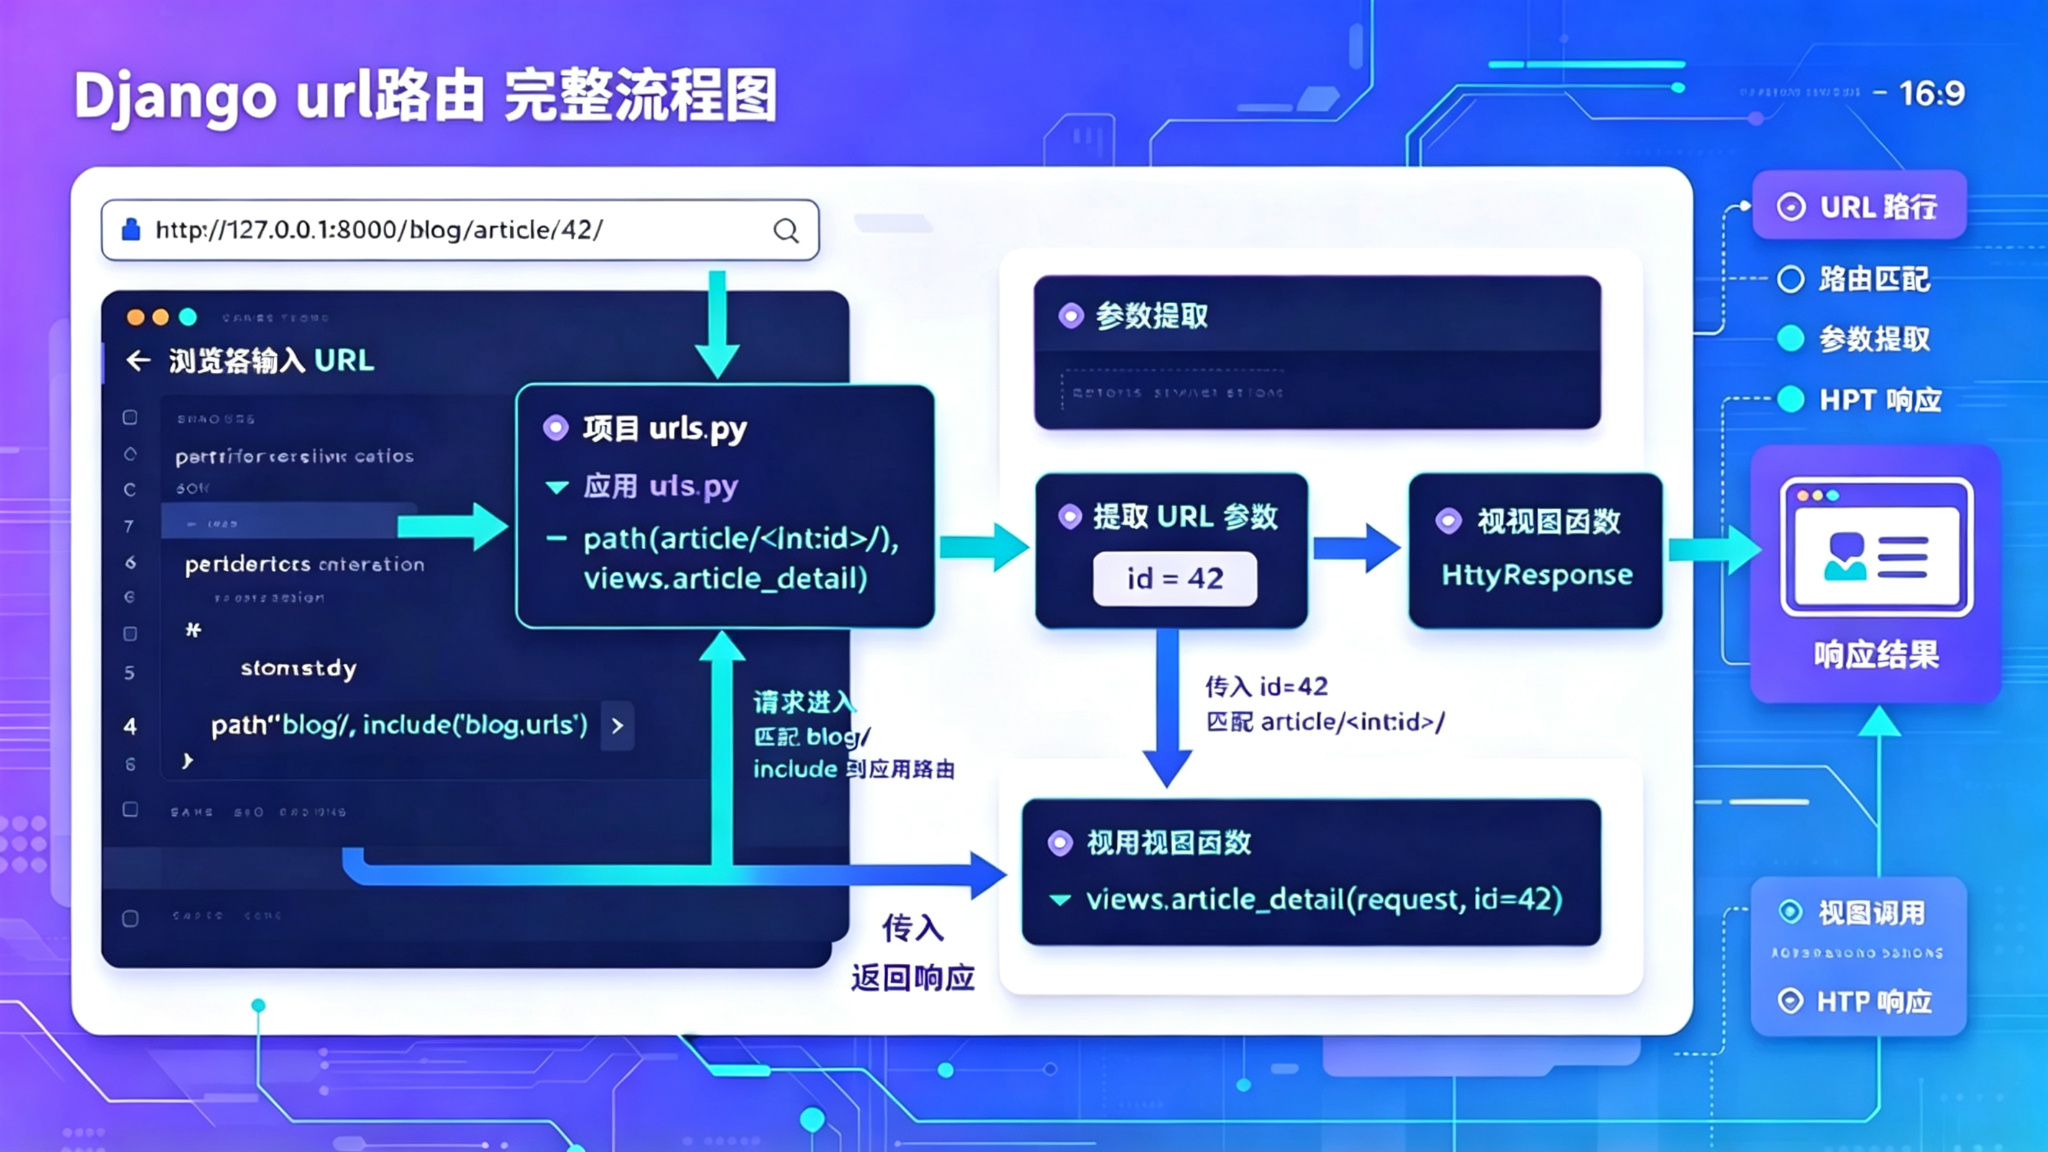
1.1 从浏览器到视图的完整路径
用户输入 http://127.0.0.1:8000/blog/article/42/
│
▼
项目 urls.py(总路由)
│ path('blog/', include('blog.urls'))
│ 匹配到 blog/ 前缀
│
▼
应用 urls.py(子路由)
│ path('article/<int:id>/', views.article_detail)
│ article/42/ 匹配成功 ← 42 被提取为参数 id
│
▼
views.py 中的 article_detail(request, id=42)
│ 接收请求,处理业务逻辑
│
▼
返回 HttpResponse(或渲染模板)
│
▼
浏览器显示结果
关键点:
- URL路由是从上到下依次匹配的,匹配到第一个就停止
- 项目级路由用include分发到应用级路由
- URL中可以通过路径转换器提取动态参数传给视图
1.2 path()函数详解
path()是定义URL规则的核心函数,四个参数:
from django.urls import path
path(
route='article/<int:id>/', # URL模式(字符串)
view=views.article_detail, # 视图函数(不写括号!不要 views.article_detail())
name='article-detail', # 路由名称(可选,强烈推荐)
kwargs=None # 额外的关键字参数(可选,很少用)
)
| route | URL匹配模式,支持路径转换器 | 'article/<int:id>/' |
| view | 匹配成功后调用的视图函数 | views.article_detail(不要加括号) |
| name | 路由的别名(用于反向解析URL) | 'article-detail' |
| kwargs | 传给视图的额外固定参数 | {'category': 'tech'} |
为什么view不加括号? path('…', views.article_detail) 传递的是函数引用——告诉Django:“匹配到这个URL时,调用这个函数”。如果写成views.article_detail(),会在服务器启动时就立即调用一次函数(而不是等请求来才调用),这显然是错的。
二、路径转换器:从URL中提取参数

2.1 内置路径转换器
Django提供了五种内置的路径转换器,用于从URL中提取不同类型的参数:
| str | 非空字符串(不含/) | <str:username>/ | "zhangsan" |
| int | 正整数(包括0) | <int:id>/ | 42 |
| slug | 字母/数字/连字符/下划线 | <slug:title>/ | "python-django-tutorial" |
| uuid | UUID格式 | <uuid:pk>/ | UUID对象 |
| path | 完整路径(含/) | <path:filepath>/ | "a/b/c.html" |
str是默认转换器,如果不指定类型,Django默认用str:<username>/ 等价于 <str:username>/。
2.2 path()实战:各种URL模式
# blog/urls.py
from django.urls import path
from . import views
urlpatterns = [
# 基础路由
path('', views.index, name='index'), # /blog/
# int 转换器:文章ID
path('article/<int:id>/', views.article_detail, name='article-detail'), # /blog/article/42/
# str 转换器:用户名
path('user/<str:username>/', views.user_profile, name='user-profile'), # /blog/user/zhangsan/
# str 是默认转换器,可以省略
path('category/<category>/', views.category_list, name='category-list'), # /blog/category/python/
# slug 转换器:文章别名
path('post/<slug:slug>/', views.post_by_slug, name='post-slug'), # /blog/post/python-django-guide/
# 多个转换器同时使用
path('article/<int:year>/<int:month>/', views.article_archive, name='article-archive'), # /blog/article/2026/07/
]
2.3 对应的视图函数
# blog/views.py
from django.http import HttpResponse
def index(request):
"""首页"""
return HttpResponse("博客首页")
def article_detail(request, id):
"""文章详情页 —— 接收URL中提取的id参数"""
article_title = f"这是第 {id} 篇文章"
return HttpResponse(article_title)
def user_profile(request, username):
"""用户主页 —— 接收用户名参数"""
return HttpResponse(f"用户 {username} 的主页")
def category_list(request, category):
"""分类列表 —— 接收分类slug"""
return HttpResponse(f"{category} 分类下的文章列表")
def post_by_slug(request, slug):
"""通过slug访问文章"""
return HttpResponse(f"文章:{slug}")
def article_archive(request, year, month):
"""文章归档 —— 按年月"""
return HttpResponse(f"{year}年{month}月的归档文章")
现在启动服务器,访问以下地址试试:
- http://127.0.0.1:8000/blog/article/42/ → “这是第 42 篇文章”
- http://127.0.0.1:8000/blog/user/zhangsan/ → “用户 zhangsan 的主页”
- http://127.0.0.1:8000/blog/article/2026/07/ → “2026年07月的归档文章”
2.4 转换器匹配失败的情况
如果URL中的参数不符合转换器的格式,Django会返回404(找不到页面):
# path('article/<int:id>/', …)
# /blog/article/abc/ → 404!因为 "abc" 不是 int
# /blog/article/42/ → 正常匹配
可以在开发模式下看到Django的调试页面,里面会告诉你"哪个URL没有匹配上",非常有助于排查路由问题。
三、re_path() 正则表达式路由
3.1 为什么需要re_path
path()自带的转换器虽然覆盖了大多数场景,但有时你需要更灵活的匹配规则(如匹配特定格式的字符串、限定数字范围等),这时就需要re_path()——使用正则表达式定义URL模式。
from django.urls import re_path
urlpatterns = [
# 只匹配4位数年份和2位数月份
re_path(r'^article/(?P<year>\\d{4})/(?P<month>\\d{2})/$', views.article_archive),
# 匹配以 .html 结尾的URL
re_path(r'^post/(?P<slug>[\\w-]+)\\.html$', views.post_by_slug),
# 匹配UUID格式
re_path(r'^api/v1/user/(?P<uuid>[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12})/$',
views.user_detail),
]
语法说明:
- ?P<name>:命名捕获组,name是传给视图的参数名
- 正则表达式需要用^开头、$结尾(Django 2.0+的path自动做了这个)
- r''表示raw string,避免Python对反斜杠转义
3.2 path vs re_path 选型
| 提取基本类型(int/str/slug) | path() | 简洁、明确 |
| 复杂的格式匹配(如年份4位) | re_path() | 正则表达式更灵活 |
| 大部分日常路由 | path() | 99%的场景够用 |
四、include() 路由分发

4.1 为什么要用include
在一个真实项目中,可能有几十上百条URL规则。如果把所有URL都写在项目级urls.py中,文件会变得非常臃肿、难以维护。include()解决了这个问题:将URL按应用模块拆分,每个应用管理自己的路由。
# 项目 urls.py(总路由)
from django.urls import path, include
urlpatterns = [
path('admin/', admin.site.urls),
path('blog/', include('blog.urls')), # 博客应用
path('users/', include('users.urls')), # 用户应用
path('api/', include('api.urls')), # API应用
]
路由拼接逻辑:
访问 /blog/article/42/
→ path('blog/', …) 消耗掉 blog/ 前缀
→ 剩余 /article/42/ 传给 blog/urls.py 继续匹配
→ blog/urls.py 中 path('article/<int:id>/', …) 匹配成功
4.2 include的命名空间(namespace)
当多个应用有同名的URL名称时(比如两个应用都有自己的index路由),需要使用命名空间区分:
# 项目 urls.py
urlpatterns = [
path('blog/', include('blog.urls', namespace='blog')),
path('shop/', include('shop.urls', namespace='shop')),
]
然后在模板或reverse()中使用'blog:index'、'shop:index'来区分:
from django.urls import reverse
reverse('blog:index') # → /blog/
reverse('shop:index') # → /shop/
五、命名路由:告别硬编码URL
5.1 为什么要给路由命名
假设你在多个视图和模板中需要生成文章详情页的链接。如果直接把URL写死:/blog/article/42/,将来有一天你决定把URL改成/blog/post/42/,你需要全局搜索替换所有出现这个URL的地方。命名路由解决了这个问题:你给每个URL一个名字,然后通过名字来获取URL——无论URL怎么改,名字不变。
# urls.py
path('article/<int:id>/', views.article_detail, name='article-detail')
# 给这个URL起个名字 ↑
5.2 在视图中使用命名路由:reverse()
from django.urls import reverse
from django.shortcuts import redirect
def article_create(request):
# 假设创建文章后要跳转到详情页
article_id = 42
# 方式1:硬编码(不推荐)
# return redirect(f'/blog/article/{article_id}/')
# 方式2:命名路由(推荐)
url = reverse('article-detail', kwargs={'id': article_id})
return redirect(url) # → /blog/article/42/
5.3 在模板中使用命名路由:url标签
<!– 硬编码(不推荐) –>
<a href="/blog/article/{{ article.id }}/">查看文章</a>
<!– 命名路由(推荐) –>
<a href="{% url 'article-detail' id=article.id %}">查看文章</a>
命名路由的优势:
- URL结构改变时,只需修改urls.py一处,所有使用名字的地方自动更新
- 防止拼写错误导致的死链
- 配合命名空间,大型项目中也不会冲突
六、视图(函数)详解
6.1 视图的本质
Django视图的本质是一个Python函数(先学函数视图,后面再学类视图)。它接收一个HttpRequest对象作为第一个参数,返回一个HttpResponse对象。
def 视图函数名(request):
# 处理请求
return HttpResponse("响应内容")
Python类比:如果你写的JS事件处理函数是(event) => { … },Django的视图函数就是(request) => { … }。request包含了"谁请求"、“用什么方法请求”、"带了什么参数"等所有信息。
6.2 HttpRequest对象:请求的身份证
request对象包含了用户请求的所有信息。重点掌握以下属性:
def demo_view(request):
# 1. 请求方法
method = request.method # "GET" / "POST" / "PUT" / "DELETE"
# 2. GET请求参数(URL问号后面的参数)
# 例如:/search/?q=python&page=2
get_params = request.GET # <QueryDict: {'q': 'python', 'page': '2'}>
keyword = request.GET.get('q', '') # 'python'(推荐:不存在返回None)
page = request.GET.get('page', '1') # '2'(可设默认值)
# 3. POST请求参数(表单提交的数据)
if request.method == 'POST':
username = request.POST.get('username')
password = request.POST.get('password')
# 4. 请求路径
path = request.path # "/blog/article/42/"
full_path = request.get_full_path() # "/blog/article/42/?page=2"
# 5. 请求头
user_agent = request.headers.get('User-Agent')
# 6. 用户信息(通过认证中间件设置的)
user = request.user # 当前登录用户(匿名用户为AnonymousUser)
# 7. 客户端IP
ip = request.META.get('REMOTE_ADDR')
return HttpResponse(f"方法:{method},搜索关键词:{keyword}")
6.3 HttpResponse与子类:各种响应类型
from django.http import HttpResponse, JsonResponse, FileResponse
from django.shortcuts import render, redirect
def response_demo(request):
# 1. HttpResponse:返回纯文本
return HttpResponse("Hello World")
# 2. 设置响应状态码和头
return HttpResponse("Not Found", status=404)
# 3. JsonResponse:返回JSON数据(前后端分离常用)
return JsonResponse({
'status': 'ok',
'data': {'name': '张三', 'age': 25}
})
# 4. render():渲染HTML模板(最常用,下篇详讲)
return render(request, 'blog/index.html', {'title': '首页'})
# 5. redirect():重定向到另一个页面
return redirect('/blog/') # 硬编码URL
return redirect('article-detail', id=42) # 使用命名路由
return redirect('https://www.baidu.com') # 跳转到外站
6.4 实战:搜索功能(GET请求)
# blog/views.py
from django.http import HttpResponse
def search(request):
"""搜索视图:接收GET参数 q,返回搜索结果"""
keyword = request.GET.get('q', '').strip()
if not keyword:
return HttpResponse("请输入搜索关键词")
# 实际项目中这里会查询数据库
# 现在模拟一些结果
results = [
f"关于 {keyword} 的搜索结果1",
f"关于 {keyword} 的搜索结果2",
f"关于 {keyword} 的搜索结果3",
]
html = f"<h2>搜索:{keyword}</h2><ul>"
for item in results:
html += f"<li>{item}</li>"
html += "</ul>"
return HttpResponse(html)
# blog/urls.py
urlpatterns = [
path('search/', views.search, name='search'),
]
在浏览器访问:http://127.0.0.1:8000/blog/search/?q=python → 显示搜索"python"的结果。
6.5 实战:留言板(POST请求)
# blog/views.py
from django.http import HttpResponse
from django.views.decorators.csrf import csrf_exempt
# 开发阶段暂时关闭CSRF验证(生产环境必须开启)
@csrf_exempt
def message_board(request):
if request.method == 'GET':
return HttpResponse('''
<form method="POST">
<input type="text" name="message" placeholder="请输入留言">
<button type="submit">提交</button>
</form>
''')
elif request.method == 'POST':
message = request.POST.get('message', '')
if not message.strip():
return HttpResponse("留言内容不能为空")
return HttpResponse(f"你的留言:{message}")
关于CSRF:@csrf_exempt是关闭CSRF保护(临时用于演示),真实项目必须正确处理CSRF token(将在表单篇详解)。
七、综合实战:一个完整的URL路由配置
下面是一个博客应用完整的路由配置示例,涵盖了各种常见场景:
# blog/urls.py
from django.urls import path, re_path
from . import views
# 定义应用命名空间(在项目include中指定,或在这里指定app_name)
app_name = 'blog'
urlpatterns = [
# 首页
path('', views.index, name='index'),
# 文章相关
path('article/<int:id>/', views.article_detail, name='article-detail'),
path('post/<slug:slug>/', views.article_by_slug, name='article-slug'),
# 搜索
path('search/', views.search, name='search'),
# 分类和标签
path('category/<str:category>/', views.category_list, name='category-list'),
path('tag/<str:tag>/', views.tag_list, name='tag-list'),
# 归档(按年月)
path('archive/<int:year>/', views.year_archive, name='year-archive'),
path('archive/<int:year>/<int:month>/', views.month_archive, name='month-archive'),
# 用户
path('user/<str:username>/', views.user_profile, name='user-profile'),
# 留言板
path('message/', views.message_board, name='message-board'),
# RSS订阅
path('rss/', views.rss_feed, name='rss-feed'),
]
八、常见误区与避坑指南
URL末尾的斜杠/:Django默认要求URL以斜杠结尾(APPEND_SLASH = True在settings中)。如果请求/blog/article(没有斜杠),Django会自动301重定向到/blog/article/。这个行为是可配置的,但建议保持默认,养成带斜杠的习惯。
路由顺序问题:Django按从上到下的顺序匹配URL,匹配到第一个就停止。把最具体的路由放前面,最通用的放后面。
# ✓ 正确的顺序
path('article/new/', views.new_article), # 先匹配具体的
path('article/<int:id>/', views.article_detail), # 再匹配通用的
# ✗ 错误:article/new/ 会被第一个匹配,永远访问不到
path('article/<int:id>/', views.article_detail),
path('article/new/', views.new_article), # 永远不会被执行!
视图函数不加括号:path('…', views.index)是正确的,path('…', views.index())会报错或在启动时就被调用。
路由名称冲突:不同应用不要用相同的路由名称。要么使用命名空间namespace,要么在名称中加应用前缀(如blog:index、shop:index)。
忘记include的namespace:如果在项目urls.py中使用了namespace='blog',在应用urls.py中也需要设置app_name = 'blog'。
GET.get()和POST.get()的默认值:始终给get()提供默认值,防止KeyError:request.GET.get('page', '1')。
九、核心总结
URL路由
| 基础路由 | path('blog/', views.index) |
| 提取整数 | path('article/<int:id>/', …) |
| 提取字符串 | path('user/<str:name>/', …) |
| 正则匹配 | re_path(r'^year/(?P<year>\\d{4})/$', …) |
| 应用分发 | path('blog/', include('blog.urls')) |
| 命名空间 | path('blog/', include('blog.urls', namespace='blog')) |
视图函数
| 返回文本 | return HttpResponse("Hello") |
| 返回JSON | return JsonResponse({'key': 'value'}) |
| 渲染模板 | return render(request, 'template.html', ctx) |
| 重定向 | return redirect('name') |
| 获取GET参数 | request.GET.get('key', 'default') |
| 获取POST参数 | request.POST.get('key', 'default') |
| 获取URL中的变量 | 视图函数参数名和URL转换器名一致 |
请求处理流程
用户请求 URL → 项目urls.py → include() → 应用urls.py → path()匹配
→ 提取URL参数 → 调用视图函数(request, **kwargs) → 返回HttpResponse
十、专栏订阅
- 专栏优点?《Python从入门到实战》,专栏内容涵盖:Python基础到高级编程、并发编程(进程/线程/协程)、网络编程(TCP/UDP/Socket)、核心内置/第三方模块、数据库核心实战、Web开发(Django/Flask/FastAPI框架)、数据库(MySQL/ORM/异步数据库)、网络爬虫(同步/异步/分布式)、AI实战、Linux部署运维、前端开发、JavaScript全栈等核心知识,以项目驱动教学,构建清晰学习路径,适合零基础入门和进阶提升的同学,跟着一步步从入门到精通!专栏地址:https://blog.csdn.net/zsh_1314520/category_13108073.html
- 文章是永久吗? 一次订阅后可永久免费查看专栏内所有文章,后续会持续更新全栈相关内容,第一时间获取最新教程!
- 有答疑交流群吗? 订阅专栏后有专属的全栈学习答疑群,群内提供专业问题答疑、和众多学习者抱团取暖,一起沉淀技术、赋能成长!
- 进群方式? 订阅专栏后可直接在专栏内申请加入答疑群,或私信博主沟通进群事宜:https://bbs.csdn.net/topics/620104702
- 更多干货? 点赞+收藏+关注博主不迷路!博主博客链接:https://blog.csdn.net/zsh_1314520?spm=1000.2115.3001.5343,专注Python全栈技术分享,评论区留言问题会一一回复,助力大家轻松搞定Python全栈!
【原创声明】 除本文原文地址以外,如发现同款内容皆为盗版,本文已收录于《Python全栈:从入门到实战》,请勿购买盗版文章和专栏,如购买盗版内容不提供任何服务。原文地址:https://blog.csdn.net/zsh_1314520/article/details/166490547


评论前必须登录!
注册