 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
概述
GPU 内存模型描述的是:数据存在哪里、离计算单元(SM)有多远、访问有多快、谁来管理。
核心思想是存储层次结构(Memory Hierarchy):
越靠近 SM(计算核心) → 越快、越小、越贵
越远离 SM → 越慢、越大、越便宜
A100 的四层结构:
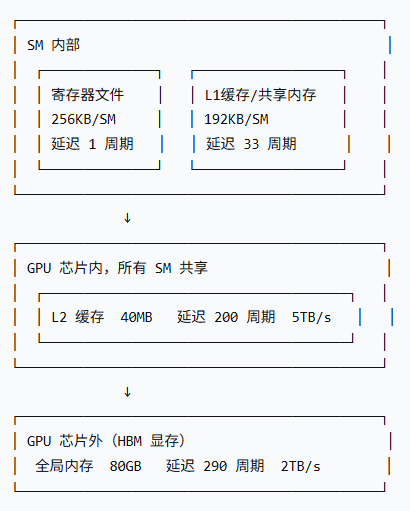
小结: 寄存器 1 周期,共享内存 33 周期,L2 200 周期,全局内存 290 周期。从共享内存到全局内存,延迟差了近 9 倍。
如果计算单元等全局内存,大量时间在空转。
四层存储的作用与编程控制
全局内存(Global Memory)
| 位置 | GPU 芯片外 HBM 显存 |
| 容量 | A100 80GB |
| 带宽 | 约 2 TB/s |
| 延迟 | 约 290 周期 |
| 编程控制 | 手动 cudaMalloc,所有线程可见 |
作用: 存放模型权重、激活值、梯度、训练数据、中间结果、最终输出。是 GPU 的“大仓库”,容量大但速度慢。
编程控制: 需要手动分配、手动拷贝(CPU→GPU 通过 PCIe)。所有线程都能访问,但每次访问都要付出高延迟。
L2 缓存
| 位置 | GPU 芯片内,所有 SM 共享 |
| 容量 | 40MB (A100) |
| 带宽 | 约 5 TB/s |
| 延迟 | 约 200 周期 |
| 编程控制 | 硬件自动管理,不可手动控制 |
作用:
- 缓存全局内存的热点数据(如频繁访问的权重),避免每次都访问 HBM;
- 所有 SM 与 HBM 之间的数据通信都必须经过 L2,是 GPU 的“数据总枢纽”;
- 不同 SM 上的线程可以通过 L2 高效共享数据,保证数据一致性。
编程控制: 完全自动,程序员无法显式指定“把某数据放 L2”。但可以通过访问模式影响 L2 命中率。
L1 缓存 / 共享内存
| 位置 | 每个 SM 内部 |
| 容量 | 192KB/SM |
| 延迟 | 约 33 周期 |
| 编程控制 | 共享内存手动 __shared__;L1 自动 |
作用:
- 共享内存: Block 内线程协作的“小仓库”,用于交换数据(如矩阵乘法的分块数据 Tiling);
- L1 缓存: 不手动用共享内存时,自动缓存全局内存数据。
编程控制: 共享内存完全手动。程序员用 __shared__ 声明,用 __syncthreads() 同步。这是 GPU 性能优化的核心手段。
寄存器文件
| 位置 | SM 内,每个 CUDA 核心旁 |
| 容量 | 256KB/SM |
| 带宽 | 约 10 TB/s(理论) |
| 延迟 | 1 周期(零开销) |
| 编程控制 | 编译器自动分配,线程私有 |
作用: 存储线程的局部变量、临时结果。每个线程最多 255 个寄存器。速度极快,但容量有限。
编程控制: 完全自动,编译器决定变量放寄存器还是溢出到本地内存。程序员可以通过减少变量、简化代码来降低寄存器用量,从而让 SM 驻留更多 Warp。
矩阵乘法分块,展示四层存储的威力
问题设定
计算 C=A×BC = A \\times BC=A×B,其中 AAA、BBB 是 N×NN \\times NN×N 矩阵,N=1024N = 1024N=1024。
每个输出元素 C[i][j]C[i][j]C[i][j] 需要:
C[i][j]=∑k=0N−1A[i][k]×B[k][j]
C[i][j] = \\sum_{k=0}^{N-1} A[i][k] \\times B[k][j]
C[i][j]=k=0∑N−1A[i][k]×B[k][j]
共 NNN 次乘加。总计算量:
N3=10243≈1.07×10⁹ 次乘加
N^3 = 1024^3 \\approx 1.07 \\times 10^9 \\text{ 次乘加}
N3=10243≈1.07×10⁹ 次乘加
方案一:不分块,直接从全局内存读
每个线程计算一个 C[i][j]C[i][j]C[i][j],循环 kkk 从 0 到 1023:
for (int k = 0; k < N; k++) {
C[i][j] += A[i][k] * B[k][j]; // 每次从全局内存读 A 和 B
}
全局内存访问次数:
- 每个线程读 A[i][k]A[i][k]A[i][k] 共 NNN 次,读 B[k][j]B[k][j]B[k][j] 共 NNN 次;
- 总线程数 N2=10242≈1.05×10⁶N^2 = 1024^2 \\approx 1.05 \\times 10^6N2=10242≈1.05×10⁶;
- 总读取次数:
2×N3=2×1.07×109≈2.14×10⁹ 次
2 \\times N^3 = 2 \\times 1.07 \\times 10^9 \\approx 2.14 \\times 10^9 \\text{ 次}
2×N3=2×1.07×109≈2.14×10⁹ 次
每次访问延迟约 290 周期。即使有 L2 缓存,大量重复读取也会造成严重瓶颈。
估算时间(不考虑缓存命中):
2.14×109×290 周期≈6.2×10¹¹ 周期
2.14 \\times 10^9 \\times 290 \\text{ 周期} \\approx 6.2 \\times 10^{11} \\text{ 周期}
2.14×109×290 周期≈6.2×10¹¹ 周期
A100 约 1.4 GHz,时间约:
6.2×10¹¹/1.4×109≈443 秒
6.2 \\times 10^{11} / 1.4 \\times 10^9 \\approx 443 \\text{ 秒}
6.2×10¹¹/1.4×109≈443 秒
这还只是内存访问,计算本身远小于这个数。
方案二:分块加载到共享内存(Tiling)
把矩阵切成 T×TT \\times TT×T 的小块,T=32T = 32T=32。每个 Block 负责计算 C 的一个 32×3232 \\times 3232×32 块。
每个 Block 的线程协作:
__shared__ float As[32][32];
__shared__ float Bs[32][32];
for (int t = 0; t < N/32; t++) {
// 协作加载 A 和 B 的块到共享内存
As[ty][tx] = A[i][t*32 + tx];
Bs[ty][tx] = B[t*32 + ty][j];
__syncthreads();
// 用共享内存做 32 次乘加
for (int k = 0; k < 32; k++) {
C[i][j] += As[ty][k] * Bs[k][tx];
}
__syncthreads();
}
全局内存访问次数:
- 每个 Block 加载 A 块和 B 块,每次 32×32 个元素;
- 共 N/T = 32 次滑动;
- 每个 Block 全局读取:
2×32×32×32=2×32768=65536 次
2 \\times 32 \\times 32 \\times 32 = 2 \\times 32768 = 65536 \\text{ 次}
2×32×32×32=2×32768=65536 次
- Block 总数:
(N/32)2=322=1024
(N/32)^2 = 32^2 = 1024
(N/32)2=322=1024
- 总全局读取:
1024×65536≈6.7×10⁷ 次
1024 \\times 65536 \\approx 6.7 \\times 10^7 \\text{ 次}
1024×65536≈6.7×10⁷ 次
对比方案一:
2.14×1096.7×107≈32
\\frac{2.14 \\times 10^9}{6.7 \\times 10^7} \\approx 32
6.7×1072.14×109≈32
全局内存访问减少了 32 倍。
共享内存访问次数:
每个线程做 NNN 次乘加,每次读共享内存:
N3=1.07×10⁹ 次共享内存读取
N^3 = 1.07 \\times 10^9 \\text{ 次共享内存读取}
N3=1.07×10⁹ 次共享内存读取
共享内存延迟 33 周期,远低于全局内存 290 周期。
估算时间:
- 全局内存:6.7×107×290≈1.94×10106.7 \\times 10^7 \\times 290 \\approx 1.94 \\times 10^{10}6.7×107×290≈1.94×10¹⁰ 周期;
- 共享内存:1.07×109×33≈3.53×10101.07 \\times 10^9 \\times 33 \\approx 3.53 \\times 10^{10}1.07×109×33≈3.53×10¹⁰ 周期;
- 但共享内存访问可以流水线化,且 Warp 切换能隐藏延迟。
总时间约:
(1.94+3.53)×1010/1.4×109≈39 秒
(1.94 + 3.53) \\times 10^{10} / 1.4 \\times 10^9 \\approx 39 \\text{ 秒}
(1.94+3.53)×1010/1.4×109≈39 秒
对比方案一 443 秒,加速约 11 倍。这就是共享内存分块的价值。
方案三:寄存器进一步优化
每个线程计算 C 的一个 4×4 小块(而不是单个元素),把 A、B 的中间结果放在寄存器:
float c[4][4] = {0}; // 16 个寄存器
float a[4], b[4]; // 8 个寄存器
每个线程用 24 个寄存器,共享内存读取次数减少:
- 原来每个线程读 2N 次共享内存;
- 现在每个线程计算 16 个输出,共享内存读取分摊到 16 个输出上。
共享内存访问次数从 N^3 降到约 N^3/4,进一步减少。
寄存器延迟 1 周期,几乎零开销。但寄存器用量增加会限制 SM 驻留的 Warp 数:
- 每个线程 24 个寄存器,SM 有 65536 个寄存器,最多驻留 65536/(24 × 32) ≈ 85 个 Warp;
- 实际受 64 个 Warp 槽位限制,仍能满负荷。
如果每个线程用 128 个寄存器,最多驻留 65536/(128 × 32) = 16 个 Warp,并行度下降,延迟隐藏能力变差。
为什么 GPU 内存要分这么多层?
物理原因:距离决定延迟
电信号在导线中传播需要时间,物理距离越短,延迟越低:
- 寄存器在 CUDA 核心旁,距离最近,1 周期;
- 共享内存在 SM 内,33 周期;
- L2 在芯片内但跨 SM,200 周期;
- 全局内存在芯片外 HBM,290 周期。
容量与成本的权衡
| 寄存器 | 256KB/SM | 极贵 | 1 周期 |
| 共享内存 | 192KB/SM | 贵 | 33 周期 |
| L2 | 40MB | 中 | 200 周期 |
| 全局内存 | 80GB | 相对便宜 | 290 周期 |
芯片面积有限,不可能把 80GB 都做成寄存器。只能分层:小容量高速存储靠近计算,大容量低速存储放外面。
局部性原理
- 时间局部性:刚访问的数据很可能再次访问(如循环中的权重)→ L2 缓存;
- 空间局部性:相邻数据很可能一起访问(如矩阵同行元素)→ 共享内存分块;
- 广播特性:Warp 内 32 线程读同一常量 → 常量内存一次读取服务 32 线程。
数值直觉:延迟隐藏
设一个 Warp 访问全局内存需要 290 周期,计算需要 4 周期。
如果 SM 只驻留 1 个 Warp:
利用率=44+290≈1.4%利用率 = \\frac{4}{4 + 290} \\approx 1.4\\%利用率=4+2904≈1.4%
如果驻留 64 个 Warp,轮流上计算单元:
利用率≈100%
利用率 \\approx 100\\%
利用率≈100%
所以 GPU 用“大量 Warp 并行”来隐藏高延迟,这是吞吐量优化的核心。
GPU 内存与 CPU 内存的本质区别
| 主存带宽 | 约 2 TB/s | 数百 GB/s |
| 缓存控制 | 共享内存手动控制 | 缓存完全自动 |
| 线程寄存器 | 255 个/线程 | 16 个/线程(x86-64) |
| 延迟容忍 | 通过 Warp 切换隐藏延迟 | 尽量降低延迟 |
| 内存模型 | 共享内存显式同步 | 缓存一致性协议 |
本质区别:
- CPU 为延迟优化:用大缓存、乱序执行、分支预测,尽量让单次访问快;
- GPU 为吞吐量优化:容忍高延迟,用海量 Warp 并行隐藏延迟,追求单位时间处理更多数据。
数值例子:CPU 访问一次内存 100 周期,但缓存命中率 95%,平均延迟 0.95×5+0.05×100≈9.750.95 \\times 5 + 0.05 \\times 100 \\approx 9.750.95×5+0.05×100≈9.75 周期。
GPU 不追求单次快,而是让 64 个 Warp 同时跑,某个 Warp 等内存时其他 Warp 继续算。
总结
| 全局内存 | 存权重、数据、输出 | 手动 cudaMalloc | 不分块时读 21.4 亿次,分块后读 6700 万次 |
| L2 缓存 | 缓存热点、跨 SM 共享 | 自动 | 缓存重复访问的 A、B 块 |
| 共享内存 | Block 内协作、分块 | 手动 __shared__ | 矩阵分块,全局访问减少 32 倍 |
| 寄存器 | 线程局部变量 | 编译器自动 | 每线程 24 个寄存器,加速计算 |
一句话: GPU 内存模型是“近快小、远慢大”的四层结构。
寄存器 1 周期、共享内存 33 周期、L2 200 周期、全局内存 290 周期。矩阵乘法例子中,不分块直接读全局内存约 443 秒,分块到共享内存后约 39 秒,加速 11 倍。GPU 用分层存储 + 海量 Warp 并行来隐藏高延迟,追求吞吐量;CPU 用大缓存和复杂控制来降低延迟。
理解这个层次结构,是写出高性能 GPU 代码的关键。


评论前必须登录!
注册