 网硕互联帮助中心
Linux网络编程:彻底理解UDP协议!从端口号、五元组、8字节报头到手写UDP服务器
🔥 星恒随风:
个人主页
❄️ 个人专栏:
《Linux网络编程从0到1》
|
《C语言基础》
|
《数据结构》
|
《机器学习导论》
|
《前端基础》
|
《python基础》
|
《C++从入门到入土》
|
《Linux的学习之旅》
✨ 数据即知识,压缩即智能
文章目录
- Linux网络编程:彻底理解UDP协议!从端口号、五元组、8字节报头到手写UDP服务器
-
- 前言:为什么学习Socket编程后,还要深入理解UDP协议?
- 一、传输层究竟负责什么?
-
- 1.1 回顾TCP/IP五层模型
- 1.2 为什么仅有IP地址还不够?
- 二、什么是端口号?
-
- 2.1 端口号的定义
- 2.2 用一个例子理解
- 2.3 端口号和进程PID是同一个东西吗?
- 三、什么是通信五元组?
-
- 3.1 五元组包含哪些信息?
- 3.2 为什么需要协议号?
- 3.3 两个客户端访问同一个服务器
- 3.4 Linux中怎样观察通信信息?
- 四、端口号的范围是怎样划分的?
-
- 4.1 为什么端口号最大是65535?
- 4.2 常见的基础划分
- 4.3 端口0有什么特殊含义?
- 五、认识知名端口号
-
- 5.1 如何查看Linux系统中的服务端口记录?
- 5.2 为什么自己写服务器时通常避开知名端口?
- 六、两个非常重要的端口绑定问题
-
- 6.1 一个进程可以bind多个端口吗?
- 6.2 一个端口能否被多个进程bind?
- 6.3 是否绝对不允许?
- 七、正式认识UDP协议
- 八、UDP协议报头格式
-
- 8.1 源端口号
- 8.2 目的端口号
- 8.3 UDP长度
- 8.4 UDP校验和
- 九、UDP的三个核心特点
- 十、特点一:UDP是无连接的
-
- 10.1 什么叫无连接?
- 10.2 为什么sendto需要目的地址?
- 10.3 UDP服务器如何知道是谁发送的?
- 10.4 UDP能调用connect吗?
- 十一、特点二:UDP是不可靠的
-
- 11.1 什么叫不可靠?
- 11.2 UDP没有确认机制
- 11.3 UDP没有自动重传机制
- 11.4 UDP不保证到达顺序
- 11.5 UDP不可靠,应用层能否实现可靠传输?
- 十二、特点三:UDP是面向数据报的
-
- 12.1 什么叫面向数据报?
- 12.2 为什么一次发送100字节不能用10次recvfrom接收?
- 12.3 如果客户端发送10次呢?
- 12.4 TCP与UDP在这里有什么区别?
- 十三、UDP缓冲区是怎样工作的?
-
- 13.1 UDP没有TCP那样的可靠发送缓冲机制
- 13.2 UDP具有接收缓冲区
- 13.3 如果应用程序不及时读取怎么办?
- 13.4 UDP是否保证数据报顺序?
- 十四、为什么说UDP支持全双工?
-
- 14.1 什么是全双工?
- 14.2 为什么UDP没有连接也能全双工?
- 14.3 全双工是否表示应用程序一定同时调用sendto与recvfrom?
- 十五、UDP单条数据报能传输多大的数据?
-
- 15.1 仅考虑UDP报头
- 15.2 为什么IPv4下通常还要减去IP报头?
- 15.3 为什么通常不建议发送特别大的UDP数据报?
- 15.4 超过UDP单条数据报限制怎么办?
- 十六、有哪些基于UDP的应用层协议?
-
- 16.1 NFS
- 16.2 TFTP
- 16.3 DHCP
- 16.4 BOOTP
- 16.5 DNS
- 16.6 自定义UDP应用层协议
- 十七、总结
前言:为什么学习Socket编程后,还要深入理解UDP协议?
在前面的Linux网络编程中,我们已经使用过:
socket()
bind()
sendto()
recvfrom()
等接口,并编写过简单的UDP通信程序。
例如,客户端发送:
hello
服务器接收后返回:
server echo# hello
这样的程序虽然能够正常运行,但仍然存在几个值得思考的问题:
- 为什么UDP服务器需要绑定端口号?
- 为什么一台主机能够同时运行多个网络程序?
- 为什么UDP不需要建立连接就能发送消息?
- 为什么UDP不能保证数据一定到达?
- 为什么UDP发送一次100字节的数据,不能用10次10字节的接收操作把它依次取出来?
- 为什么说UDP没有TCP那样的发送缓冲机制,却仍然可以进行全双工通信?
- UDP一个数据报究竟能够传输多少字节?
要理解这些问题,不能只停留在Socket API的调用方法上,而需要深入传输层协议本身。
一、传输层究竟负责什么?
1.1 回顾TCP/IP五层模型
前面已经学习过TCP/IP五层模型:
应用层
|
v
传输层
|
v
网络层
|
v
数据链路层
|
v
物理层
其中,我们今天讨论的是:
传输层(Transport Layer)。
传输层的重要职责,是为两端的应用程序提供端到端的数据传输服务。
例如:
主机A 主机B
聊天客户端 聊天服务器
| ^
v |
UDP —————————–> UDP
| ^
v |
IP —————————–> IP
这里需要区分两个问题。
网络层主要关注:
数据如何到达目标主机?
而传输层还需要关注:
数据应该交给目标主机中的哪个应用程序?
因此,传输层不仅要解决数据传输问题,还需要能够区分不同的网络应用。
1.2 为什么仅有IP地址还不够?
假设一台Linux主机的IP地址是:
172.23.12.14
这台主机同时运行:
SSH服务器
HTTP服务器
FTP服务器
某个数据包通过网络到达这台主机以后,操作系统还需要知道:
它应该交给SSH?
还是交给HTTP?
还是交给FTP?
仅凭目标IP地址,无法完成应用程序层面的区分。
因此,需要进一步引入:
端口号(Port)。
二、什么是端口号?
2.1 端口号的定义
端口号是传输层用于区分一台主机上不同网络通信端点的重要标识。
例如:
主机IP:172.23.12.14
同一台主机上可以有:
SSH服务器:TCP 22
HTTP服务器:TCP 80
FTP控制服务器:TCP 21
当一个TCP数据段到达主机时,操作系统会根据协议、目的地址和端口等信息,将数据交给适当的Socket。
2.2 用一个例子理解
假设一台服务器同时提供三种服务:
服务器IP:192.168.1.100
对应:
192.168.1.100:22
|
v
SSH服务
192.168.1.100:80
|
v
HTTP服务
192.168.1.100:8888
|
v
自定义服务
其中:
192.168.1.100
用于定位主机。
而:
22、80、8888
用于标识不同的传输层通信端点。
因此,可以先建立一个简化认识:
IP地址帮助定位主机,端口号帮助区分主机上的网络服务。
不过在操作系统内部,实际的数据分发还会考虑传输层协议、绑定地址、连接状态等信息,并不是只看端口号一个数字。
2.3 端口号和进程PID是同一个东西吗?
不是。
例如:
HTTP服务器PID:2357
HTTP服务端口:80
两者没有直接的数值对应关系。
PID由操作系统用于标识进程。
端口号用于网络通信端点的标识。
所以:
PID ≠ Port
一个进程可以使用多个Socket,甚至绑定多个不同端口。
一个端口也并不天然等于一个进程ID。

三、什么是通信五元组?
现在我们已经知道:
IP地址
端口号
但一次网络通信不仅涉及一方。
例如:
客户端A —> 服务器
需要知道:
客户端IP
客户端端口
服务器IP
服务器端口
同时还需要知道使用什么传输层协议。
因此,可以使用一个五元组描述通信:
(
源IP
,
源端口
,
目的IP
,
目的端口
,
协议号
)
(\\text{源IP},\\text{源端口},\\text{目的IP},\\text{目的端口},\\text{协议号})
(源IP,源端口,目的IP,目的端口,协议号)
3.1 五元组包含哪些信息?
例如:
源IP:192.168.1.10
源端口:50001
目的IP:192.168.1.100
目的端口:8888
协议:UDP
可以表示为:
(
192.168.1.10,
50001,
192.168.1.100,
8888,
UDP
)
如果另一台客户端连接同一个服务器:
源IP:192.168.1.11
源端口:50002
目的IP:192.168.1.100
目的端口:8888
协议:UDP
它对应另一个五元组。
3.2 为什么需要协议号?
因为:
TCP端口8888
和:
UDP端口8888
属于不同的传输层协议空间。
例如:
socket(AF_INET, SOCK_STREAM, 0);
创建TCP Socket。
而:
socket(AF_INET, SOCK_DGRAM, 0);
创建UDP Socket。
即使二者使用相同的数字端口,通信协议仍然不同。
因此,通信五元组需要包含:
协议号
在IP协议中:
TCP协议号:6
UDP协议号:17
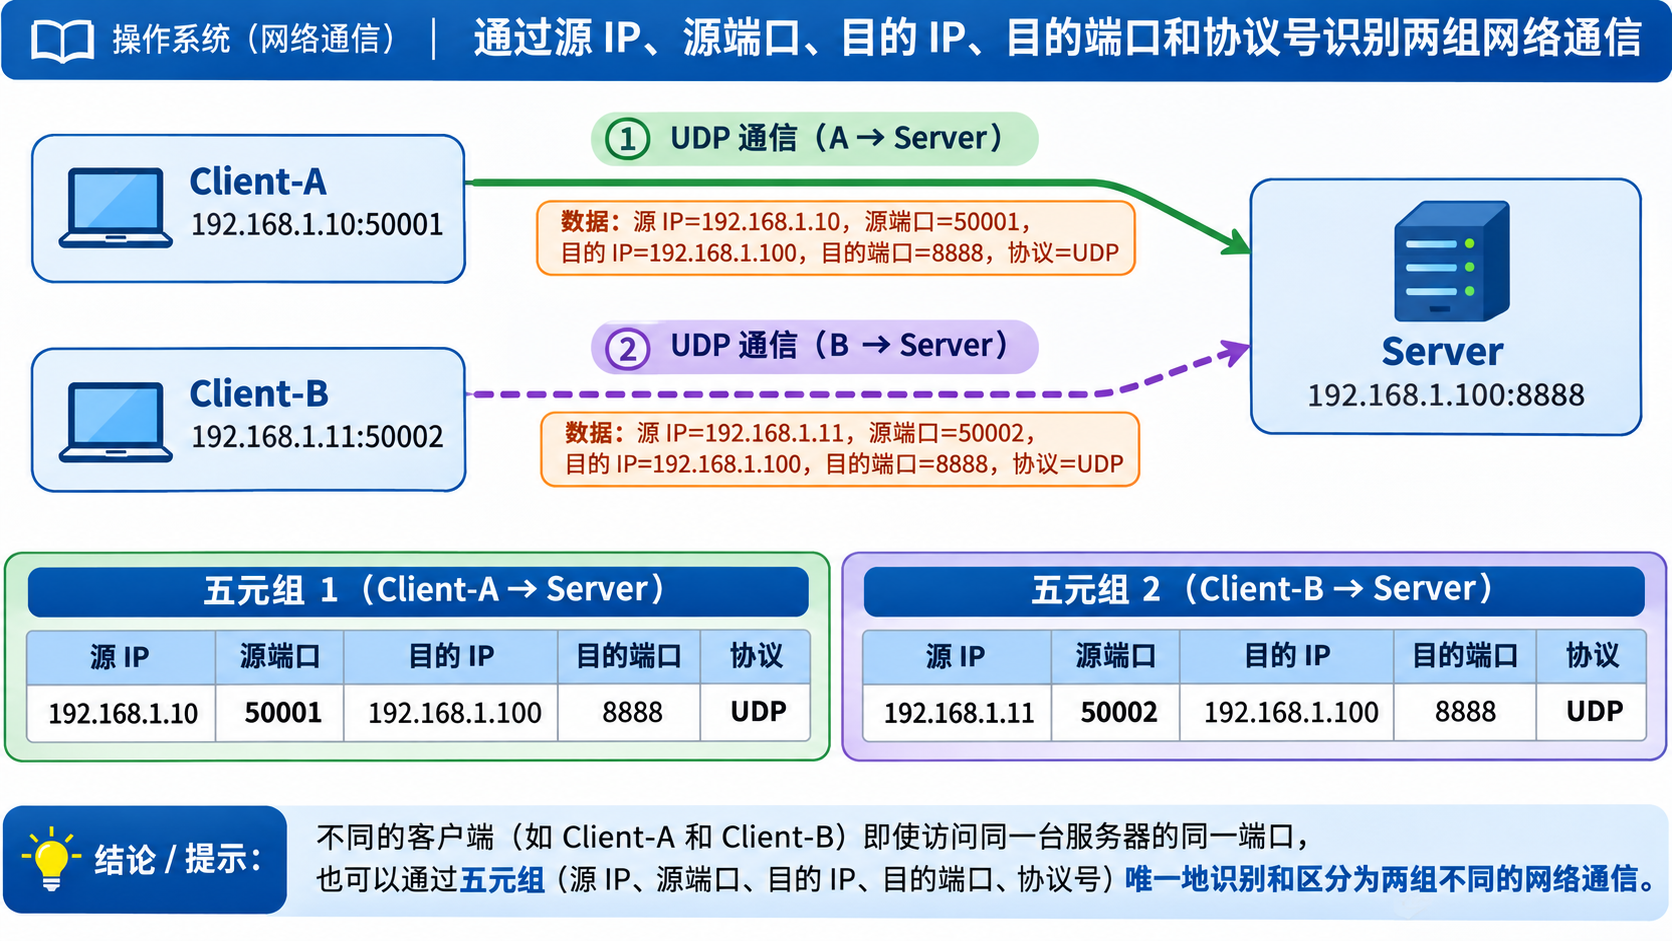
3.3 两个客户端访问同一个服务器
Client-A
192.168.1.10:50001
|
| UDP
v
Server
192.168.1.100:8888
^
| UDP
|
Client-B
192.168.1.11:50002
虽然两个客户端访问的:
目的IP
目的端口
传输层协议
都相同,但它们的源地址和源端口不同。
因此可以用不同的五元组描述对应通信。
3.4 Linux中怎样观察通信信息?
可以使用:
ss -tun
其中:
-t:TCP
-u:UDP
-n:以数字形式显示地址和端口
也可以使用:
netstat -n
不过在现代Linux环境中,ss 通常更方便,也更常见。
注意:UDP是无连接协议,因此 ss 显示的UDP Socket状态与TCP连接状态有所区别,不能机械地把UDP输出理解为TCP那样的已建立连接。
四、端口号的范围是怎样划分的?
4.1 为什么端口号最大是65535?
TCP与UDP报头都使用:
16位
表示端口号。
16位无符号整数可表示:
0
∼
2
16
−
1
0 \\sim 2^{16}-1
0∼216−1
因此端口号的数值范围为:
0
∼
65535
0 \\sim 65535
0∼65535
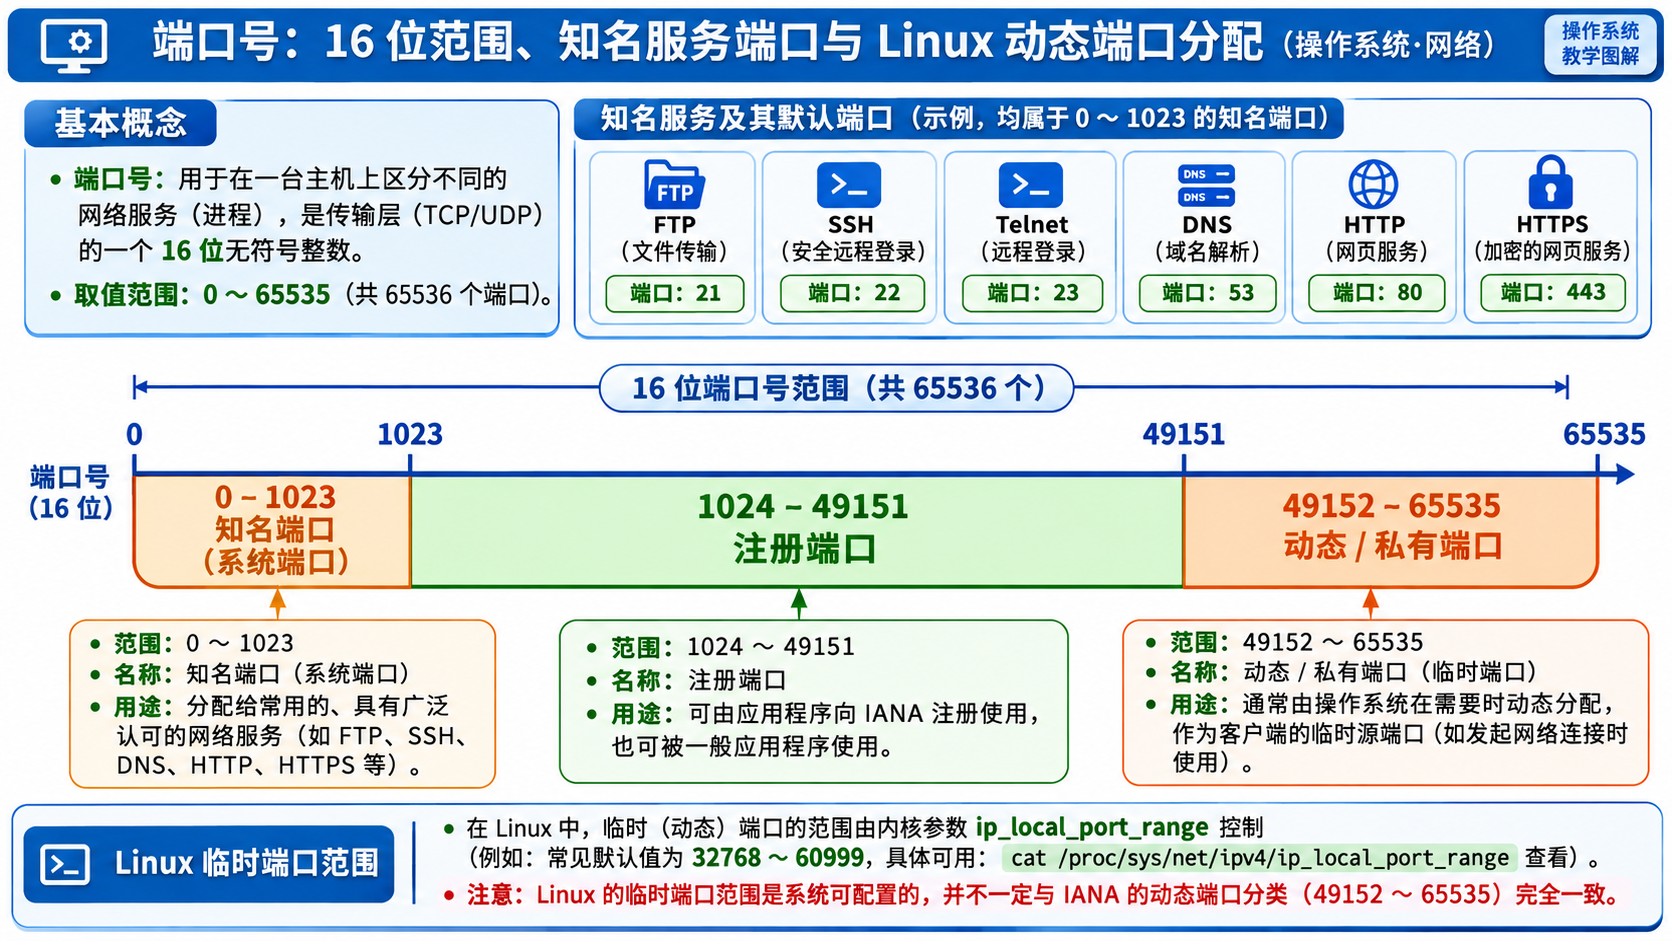
4.2 常见的基础划分
学习端口号时,通常先进行以下划分:
| 0~1023 | 知名端口范围 |
| 1024~65535 | 非知名端口范围,包含注册端口和动态端口 |
这里需要说明:
将1024~65535全部称为“操作系统动态分配的端口”,是一种便于入门理解的粗略说法。
更细致的划分是:
0~1023:系统端口范围
1024~49151:注册端口范围
49152~65535:IANA动态或私有端口范围
此外,Linux自动选择临时端口时,实际使用的范围由系统配置决定,不一定等于49152~65535。
在Linux中可以查看:
cat /proc/sys/net/ipv4/ip_local_port_range
例如可能输出:
32768 60999
这表示当前系统配置的IPv4自动临时端口选择范围。
4.3 端口0有什么特殊含义?
虽然端口字段能够表示0,但普通服务不使用0作为固定服务端口。
例如在Linux Socket编程中:
local.sin_port = htons(0);
再调用:
bind();
可以请求操作系统自动选择一个可用的本地端口。
因此:
bind端口0
通常表示:
让系统分配端口。
五、认识知名端口号
一些广泛使用的网络服务,通常具有约定的默认端口。
| FTP控制连接 | TCP | 21 |
| SSH | TCP | 22 |
| Telnet | TCP | 23 |
| DNS | UDP/TCP | 53 |
| HTTP | TCP | 80 |
| HTTPS | TCP,HTTP/3则使用QUIC/UDP | 443 |
| DHCP服务器 | UDP | 67 |
| DHCP客户端 | UDP | 68 |
这些是常见的默认服务端口。
例如:
SSH:22
HTTP:80
HTTPS:443
5.1 如何查看Linux系统中的服务端口记录?
执行:
cat /etc/services
可以看到很多服务名称与端口号的对应关系。
例如:
ssh 22/tcp
domain 53/udp
domain 53/tcp
http 80/tcp
还可以:
grep -E '^(ssh|http|https|domain)' /etc/services
查看指定服务。
需要注意:
/etc/services 是常用服务名称及端口号的注册映射文件,不表示这些服务一定正在运行。
5.2 为什么自己写服务器时通常避开知名端口?
因为这些端口已经具有常见用途。
另外,在普通Linux环境下,绑定1024以下的端口通常需要相应权限。
因此我们进行课程实验时,更适合使用:
8080
8888
9090
等非知名端口。
例如:
./udp_server 8888
这样可以减少与常见服务端口发生冲突的可能性。
六、两个非常重要的端口绑定问题
现在思考两个问题:
问题一:一个进程是否可以bind多个端口号?
问题二:一个端口号是否可以被多个进程bind?
这两个问题在Socket编程中很常见。
6.1 一个进程可以bind多个端口吗?
可以,但需要有多个相应的Socket。
例如:
int sockfd1 = socket(
AF_INET,
SOCK_DGRAM,
0
);
int sockfd2 = socket(
AF_INET,
SOCK_DGRAM,
0
);
分别绑定:
sockfd1 → 8888
sockfd2 → 9999
那么:
同一个进程
|
+—— UDP Socket 8888
|
+—— UDP Socket 9999
这是允许的。
需要注意:
同一个Socket在正常使用中不是通过多次 bind() 来绑定多个端口的。
而是:
一个进程创建多个Socket,分别绑定不同端口。
6.2 一个端口能否被多个进程bind?
一般情况下,如果多个UDP Socket试图绑定相同的:
本地IP
本地端口
协议
后面的绑定可能因为地址已被占用而失败。
典型错误:
bind: Address already in use
例如:
Process-A
|
v
127.0.0.1:8888
再启动:
Process-B
|
v
127.0.0.1:8888
在默认配置下,第二个进程通常不能直接绑定完全相同的Socket地址。
6.3 是否绝对不允许?
并不是。
Linux提供:
SO_REUSEADDR
SO_REUSEPORT
等Socket选项。
在满足对应条件时,可以实现某些地址或端口复用行为。
此外:
127.0.0.1:8888
192.168.1.100:8888
也不等同于完全相同的本地绑定地址。
因此,不能简单得出:
某个数字端口在整台主机上永远只能出现一次
这样的结论。
但对于初学者编写的普通UDP服务器,可以先按照:
相同协议、相同本地地址和端口,默认情况下避免重复绑定。
这个原则理解。
七、正式认识UDP协议
UDP全称:
User Datagram Protocol
中文:
用户数据报协议。
它属于TCP/IP体系结构中的传输层协议。
创建UDP Socket:
int sockfd = socket(
AF_INET,
SOCK_DGRAM,
0
);
其中:
AF_INET:IPv4
SOCK_DGRAM:数据报Socket
0:使用对应的默认协议
与TCP最大的区别之一是:
UDP不需要通过连接建立过程,就能向指定地址发送数据报。
例如:
sendto(
sockfd,
message,
length,
0,
...
);
只需要提供对端地址和端口,就可以尝试发送数据。
但这并不意味着数据一定能够到达。
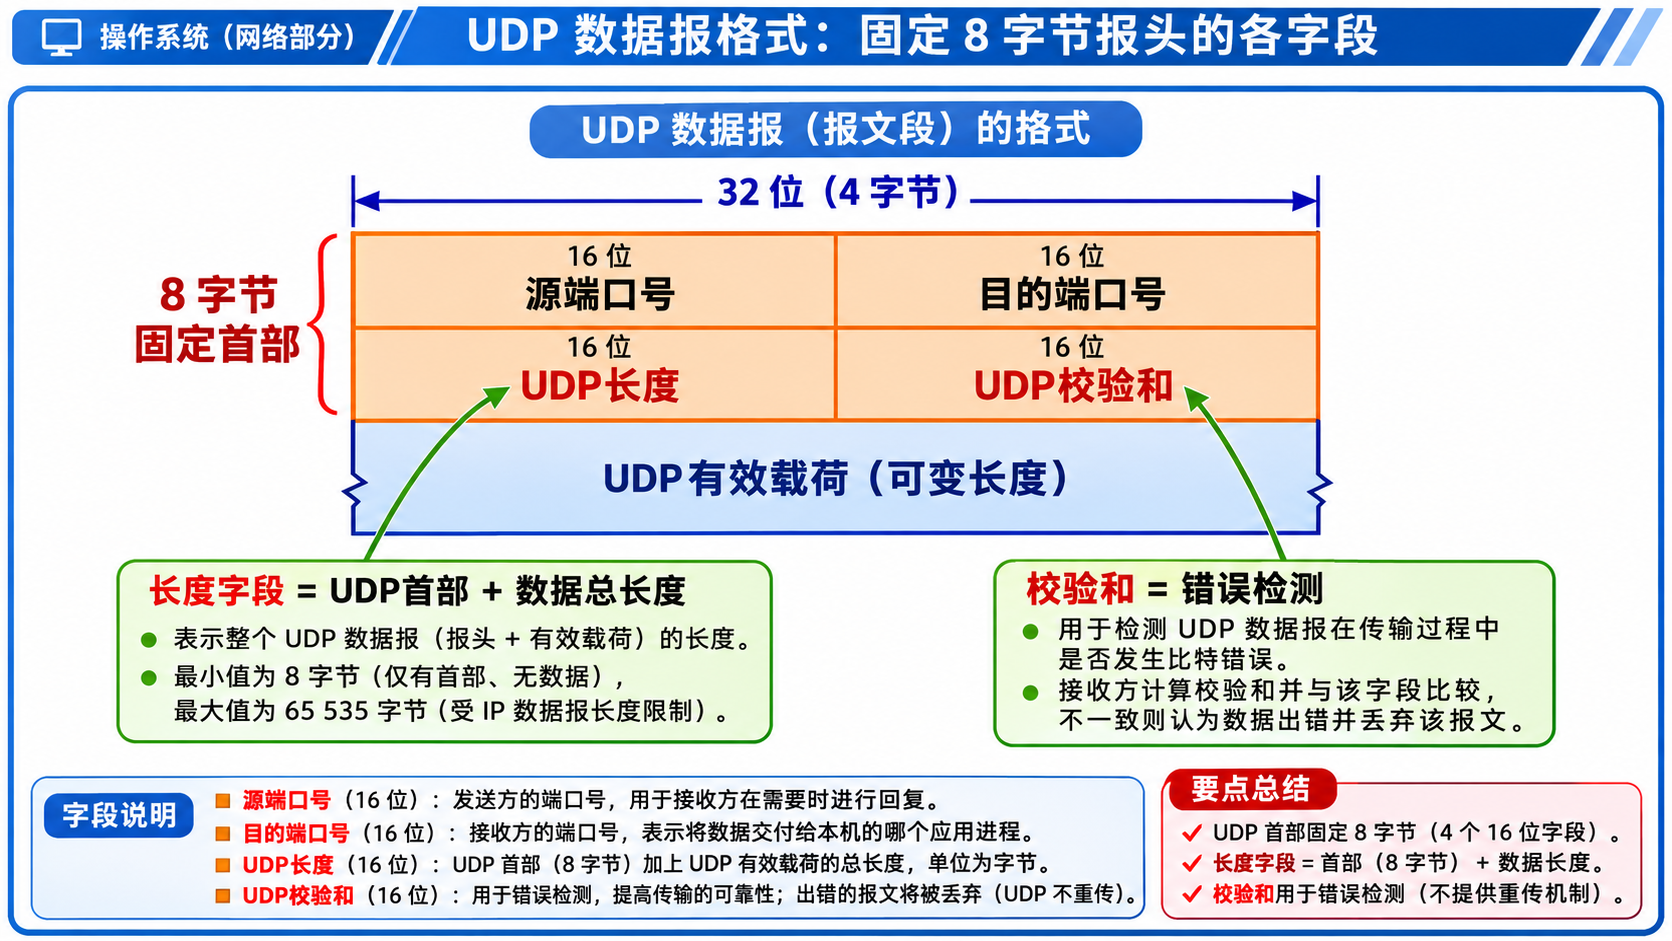
八、UDP协议报头格式
理解UDP,首先需要理解其报头。
UDP报头非常简单。
基本格式:
0 15 16 31
+———————-+———————-+
| 16位源端口号 | 16位目的端口号 |
+———————-+———————-+
| 16位UDP长度 | 16位UDP校验和 |
+———————-+———————-+
| |
| UDP有效载荷 |
| |
+———————————————+
UDP报头包含四个16位字段:
源端口号
目的端口号
UDP长度
UDP校验和
因此:
4
×
16
=
64
bit
4 \\times 16 = 64 \\text{ bit}
4×16=64 bit
换算为字节:
64
/
8
=
8
Byte
64 / 8 = 8 \\text{ Byte}
64/8=8 Byte
所以:
UDP固定报头长度为8字节。
8.1 源端口号
表示发送方的端口号。
例如:
Client:50001
8.2 目的端口号
表示接收方的端口号。
例如:
Server:8888
服务器可以根据目的端口等信息找到对应Socket。
8.3 UDP长度
UDP长度字段占:
16位
它表示:
UDP报头 + UDP数据
的总长度。
公式:
L
UDP
=
L
Header
+
L
Data
L_{\\text{UDP}} = L_{\\text{Header}} + L_{\\text{Data}}
LUDP=LHeader+LData
由于UDP报头固定为8字节:
L
UDP
=
8
+
L
Data
L_{\\text{UDP}} = 8 + L_{\\text{Data}}
LUDP=8+LData
例如应用层发送:
100字节
的有效数据。
那么:
L
UDP
=
8
+
100
=
108
Byte
L_{\\text{UDP}} = 8 + 100 = 108\\text{ Byte}
LUDP=8+100=108 Byte
因此UDP报头中的长度字段是:
108
而不是100。
8.4 UDP校验和
UDP校验和用于检测数据在传输过程中是否出现某些错误。
可以简单理解为:
发送端计算校验和
|
v
将校验和写入UDP报头
|
v
接收端进行校验
|
v
发现校验错误
|
v
丢弃错误数据报
需要注意,校验和用于错误检测,不是加密,也不能保证数据可靠送达。
另外,IPv4 UDP存在校验和未使用的特殊情况;这里先重点理解正常启用校验时的错误检测作用。
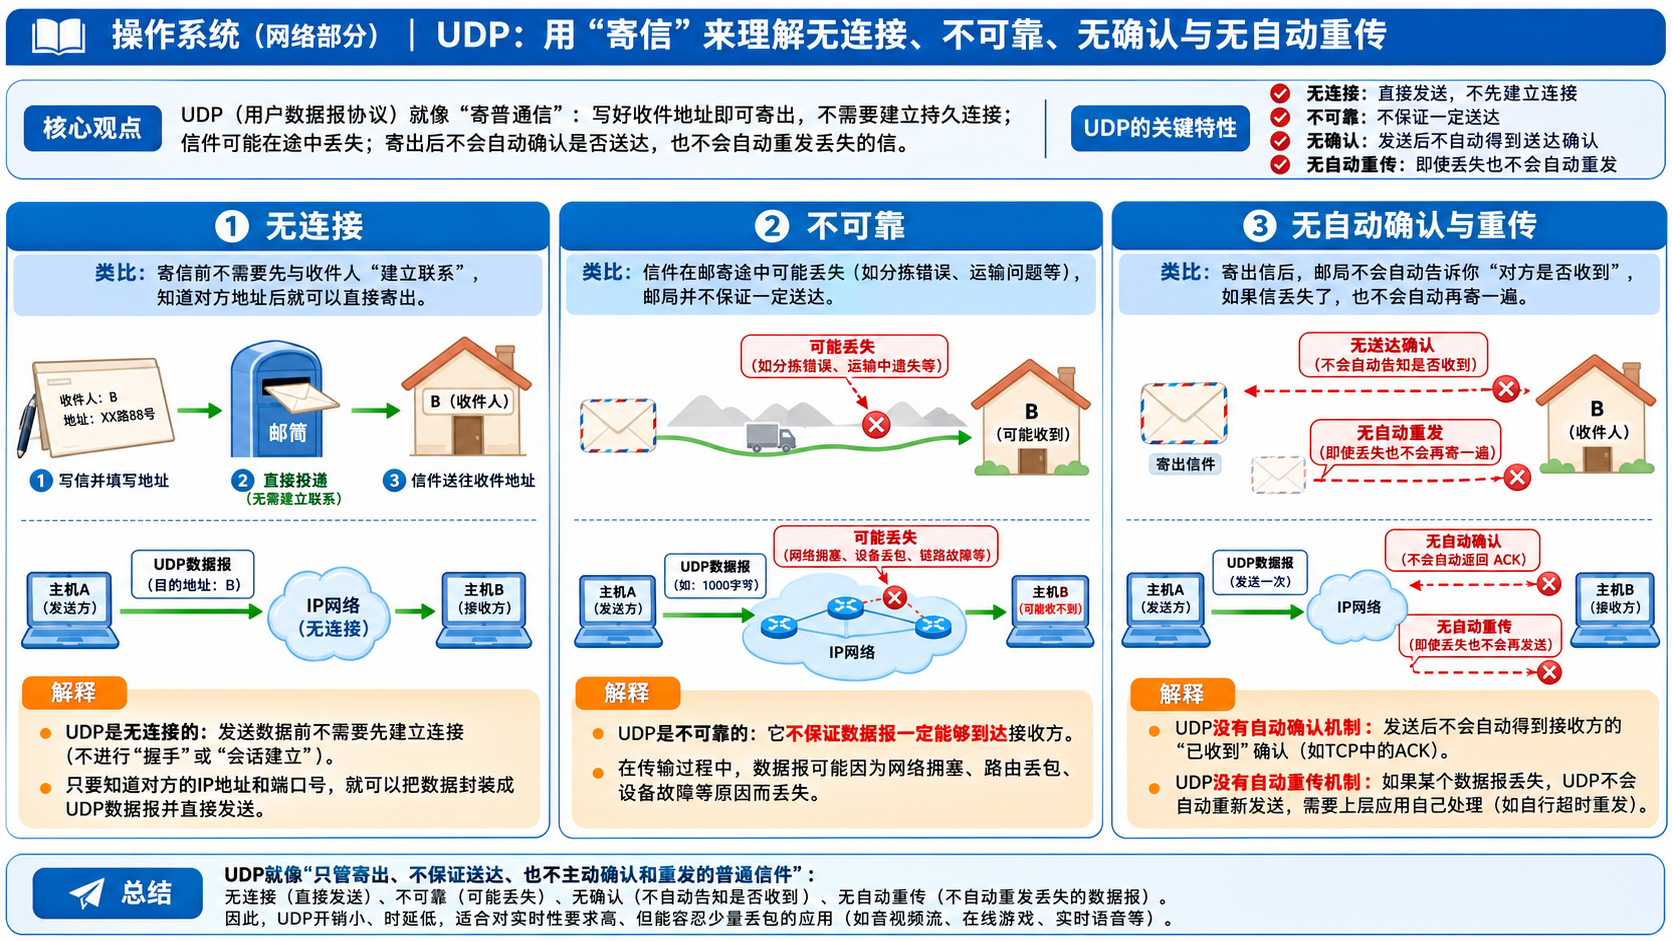
九、UDP的三个核心特点
理解UDP时,最重要的是记住三个关键词:
无连接
不可靠
面向数据报
可以把UDP的数据传输过程类比为:
寄信。
寄信之前,我们需要知道:
收件人的地址
但不需要与收件人建立一条持续存在的连接。
信件寄出以后,也不能仅凭“已经寄出”就认定对方一定收到。
此外,一封信仍然是一封独立的信件,不会因为其中内容有100个字符,就自动变成10封各包含10个字符的信件。
这个类比有助于理解UDP的主要特征。
十、特点一:UDP是无连接的
10.1 什么叫无连接?
TCP通信通常需要:
服务器listen
|
v
客户端connect
|
v
连接建立
|
v
发送与接收数据
而UDP不需要相同的连接建立过程。
例如:
sendto(
sockfd,
message,
length,
0,
reinterpret_cast<sockaddr*>(&peer),
sizeof(peer)
);
调用时就可以指定目的IP和端口。
10.2 为什么sendto需要目的地址?
因为UDP通常没有TCP那样通过连接建立过程形成的通信关系。
因此在普通UDP程序中,每次发送数据时都需要知道发送给谁。
例如:
目的IP:127.0.0.1
目的Port:8888
10.3 UDP服务器如何知道是谁发送的?
使用:
recvfrom()
时,可以接收数据并取得来源地址。
例如:
sockaddr_in peer{};
socklen_t len = sizeof(peer);
ssize_t n = recvfrom(
sockfd,
buffer,
sizeof(buffer),
0,
reinterpret_cast<sockaddr*>(&peer),
&len
);
成功接收后:
peer
中包含发送方地址信息。
服务器就可以使用:
sendto()
向该地址回复消息。
10.4 UDP能调用connect吗?
可以。
UDP Socket也可以调用 connect(),用于设置默认通信对端等行为。
但这并不意味着UDP变成了TCP,也不会执行TCP三次握手。
因此:
UDP无连接指的是协议不需要建立TCP式连接,并不是说UDP Socket API绝对不能调用connect。
十一、特点二:UDP是不可靠的
11.1 什么叫不可靠?
这里的“不可靠”,不是说UDP程序一定经常出错。
而是指:
UDP协议本身不提供TCP那样的可靠传输保证。
例如客户端发送:
hello
执行:
sendto()
成功。
这并不保证:
服务器已经接收到hello
原因在于:
sendto成功
通常表示数据报已经被本机系统接受用于发送处理。
不等于:
数据已经到达接收端应用程序
11.2 UDP没有确认机制
例如:
Client Server
| |
|——– Datagram ——–>|
| |
UDP本身没有要求接收方必须通过UDP确认机制回复:
我已经成功收到这条数据报
11.3 UDP没有自动重传机制
例如:
Client Server
| |
|——- Datagram ———-X
| 丢失 |
如果数据报在网络中丢失,UDP协议层不会自动按照TCP式重传机制重新发送这条数据。
11.4 UDP不保证到达顺序
假设客户端依次发送:
Datagram-A
Datagram-B
Datagram-C
接收端可能只收到:
Datagram-A
Datagram-C
也可能按不同顺序收到数据报。
UDP协议本身不保证数据报一定按照发送顺序交给接收应用。
11.5 UDP不可靠,应用层能否实现可靠传输?
可以。
如果应用程序需要更可靠的传输,可以自行设计:
消息编号
确认机制
超时检测
重传机制
等功能。
不过这些机制属于应用层额外设计,并不是UDP默认就提供的能力。
当前阶段只需要明确:
UDP的设计没有提供TCP那样的可靠、有序传输保证。
补充一点:某些网络或本地错误仍可能通过Socket错误机制反馈给程序,因此不能把UDP不可靠理解为“Socket永远不会报告任何错误”。
十二、特点三:UDP是面向数据报的
这是UDP与TCP非常重要的区别。
12.1 什么叫面向数据报?
应用层每次向UDP提交一条数据报,UDP会将其作为一个独立的数据报进行处理。
例如:
sendto(
sockfd,
buffer,
100,
0,
...
);
表示发送:
一条包含100字节有效载荷的UDP数据报
UDP不会自行把它变成:
第一条10字节UDP数据报
第二条10字节UDP数据报
……
第十条10字节UDP数据报
也不会把多次应用层发送自动合并为一条新的UDP数据报。
需要注意:这是UDP数据报的边界语义,不应与底层IP可能进行的分片处理混淆。
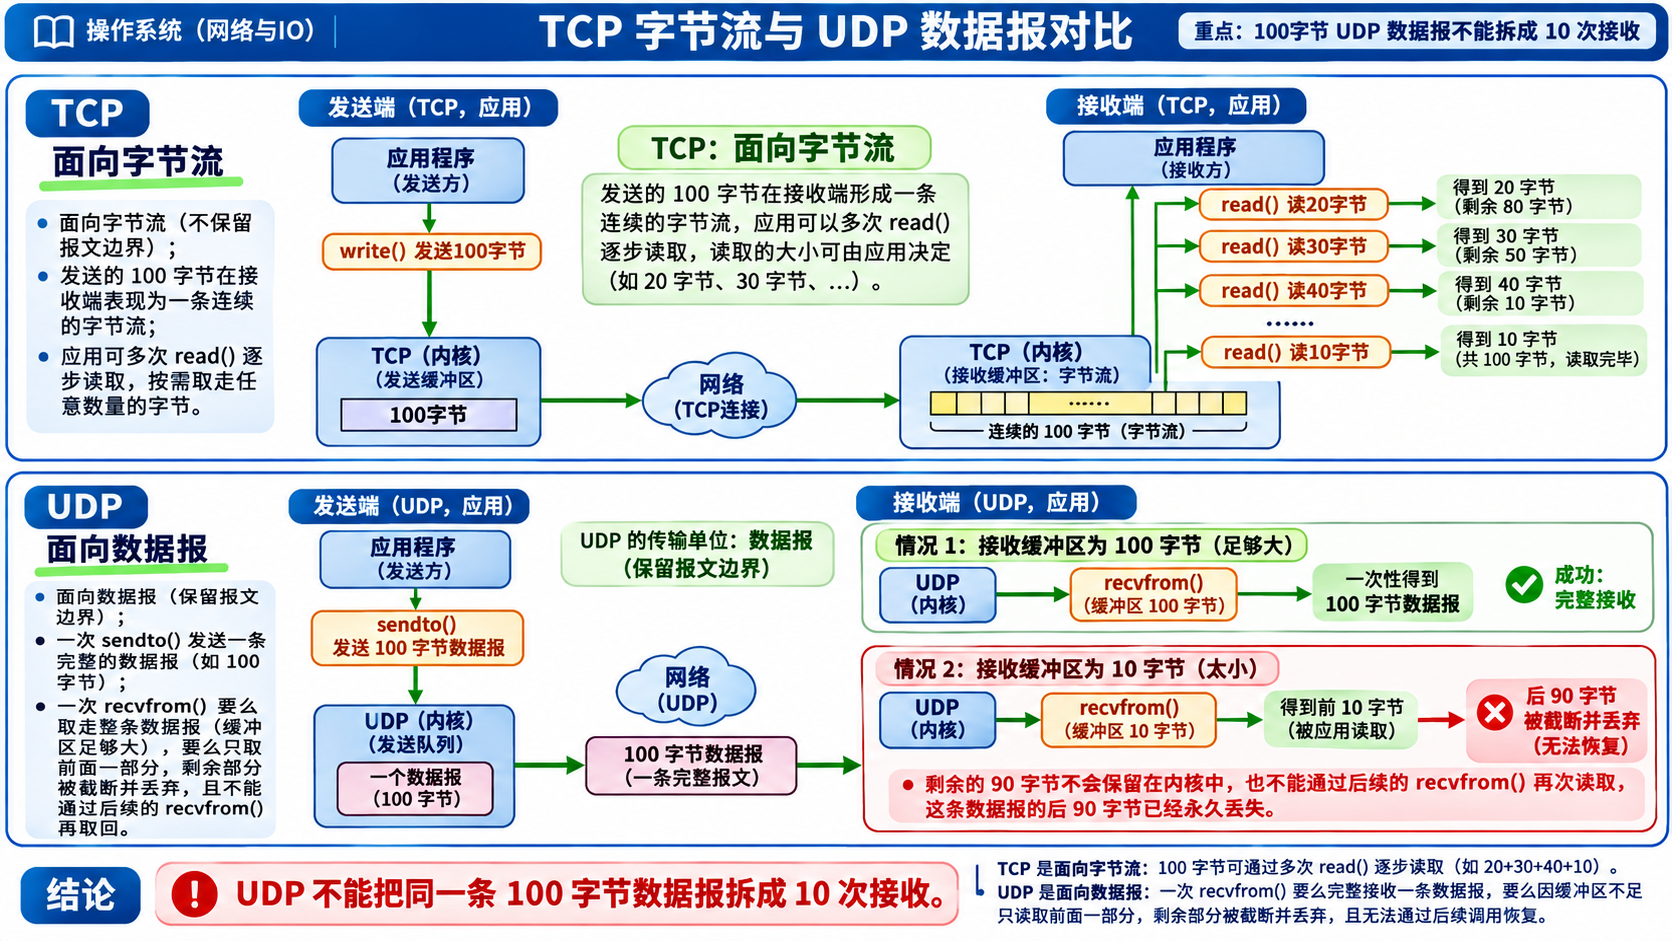
12.2 为什么一次发送100字节不能用10次recvfrom接收?
假设发送方执行一次:
sendto(
sockfd,
buffer,
100,
0,
...
);
这表示:
发送一条100字节的数据报
接收方如果执行:
char buffer[100];
recvfrom(
sockfd,
buffer,
100,
0,
...
);
在该数据报成功到达、缓冲区足够大的情况下,可以一次取出整条100字节数据报。
但如果:
char buffer[10];
recvfrom(
sockfd,
buffer,
10,
0,
...
);
则接收缓冲区只能容纳10字节。
对于普通UDP接收操作,这条数据报会被截断。
剩余部分不会留着等待后续9次 recvfrom() 继续读取。
所以:
一条100字节UDP数据报
|
v
recvfrom读取10字节
|
v
剩余90字节被丢弃
不能写成:
recvfrom第1次:10字节
recvfrom第2次:10字节
…
recvfrom第10次:10字节
来接收同一条数据报。
12.3 如果客户端发送10次呢?
例如客户端执行:
for (int i = 0; i < 10; ++i)
{
sendto(
sockfd,
buffer,
10,
0,
...
);
}
那么这对应:
10条UDP数据报
接收端如果全部收到,通常需要分别接收这10条数据报。
但由于UDP不保证可靠性,也不能保证一定收到10条。
12.4 TCP与UDP在这里有什么区别?
TCP面向字节流。
例如:
发送100字节
接收端可以通过多次 read() 累计读取这些字节。
而UDP面向独立的数据报。
一个UDP接收操作针对一条数据报,普通接收不会将同一条数据报的剩余部分保留给后续读取。
可以概括为:
TCP:
连续字节流
|
v
应用层自行确定消息边界
UDP:
一条条独立数据报
|
v
保留数据报边界
这也是为什么UDP通常不需要像TCP那样,专门通过长度前缀来恢复原始数据报边界。
但如果UDP数据报过大、被截断或者丢失,应用程序仍然需要处理相应问题。
十三、UDP缓冲区是怎样工作的?
前面理解了UDP数据报,现在进一步讨论UDP Socket与内核缓冲区的关系。
13.1 UDP没有TCP那样的可靠发送缓冲机制
在TCP中,发送缓冲区与可靠传输机制密切相关。
发送出去但尚未完成相应确认处理的数据,可能需要继续保留,以支持可靠传输。
UDP不提供这种确认与自动重传机制。
因此通常说:
UDP没有TCP那种意义上的发送缓冲机制。
例如调用:
sendto()
以后,内核接收应用程序提交的数据报,并进行后续发送处理。
但不需要为了TCP式确认和重传,长期保留每条已发送数据报。
需要注意:
这不等于Linux内核在UDP发送路径中完全不存在任何缓冲或队列。
UDP发送时仍然可能涉及内核内存与队列资源,只是它没有TCP那样的可靠重传缓冲语义。
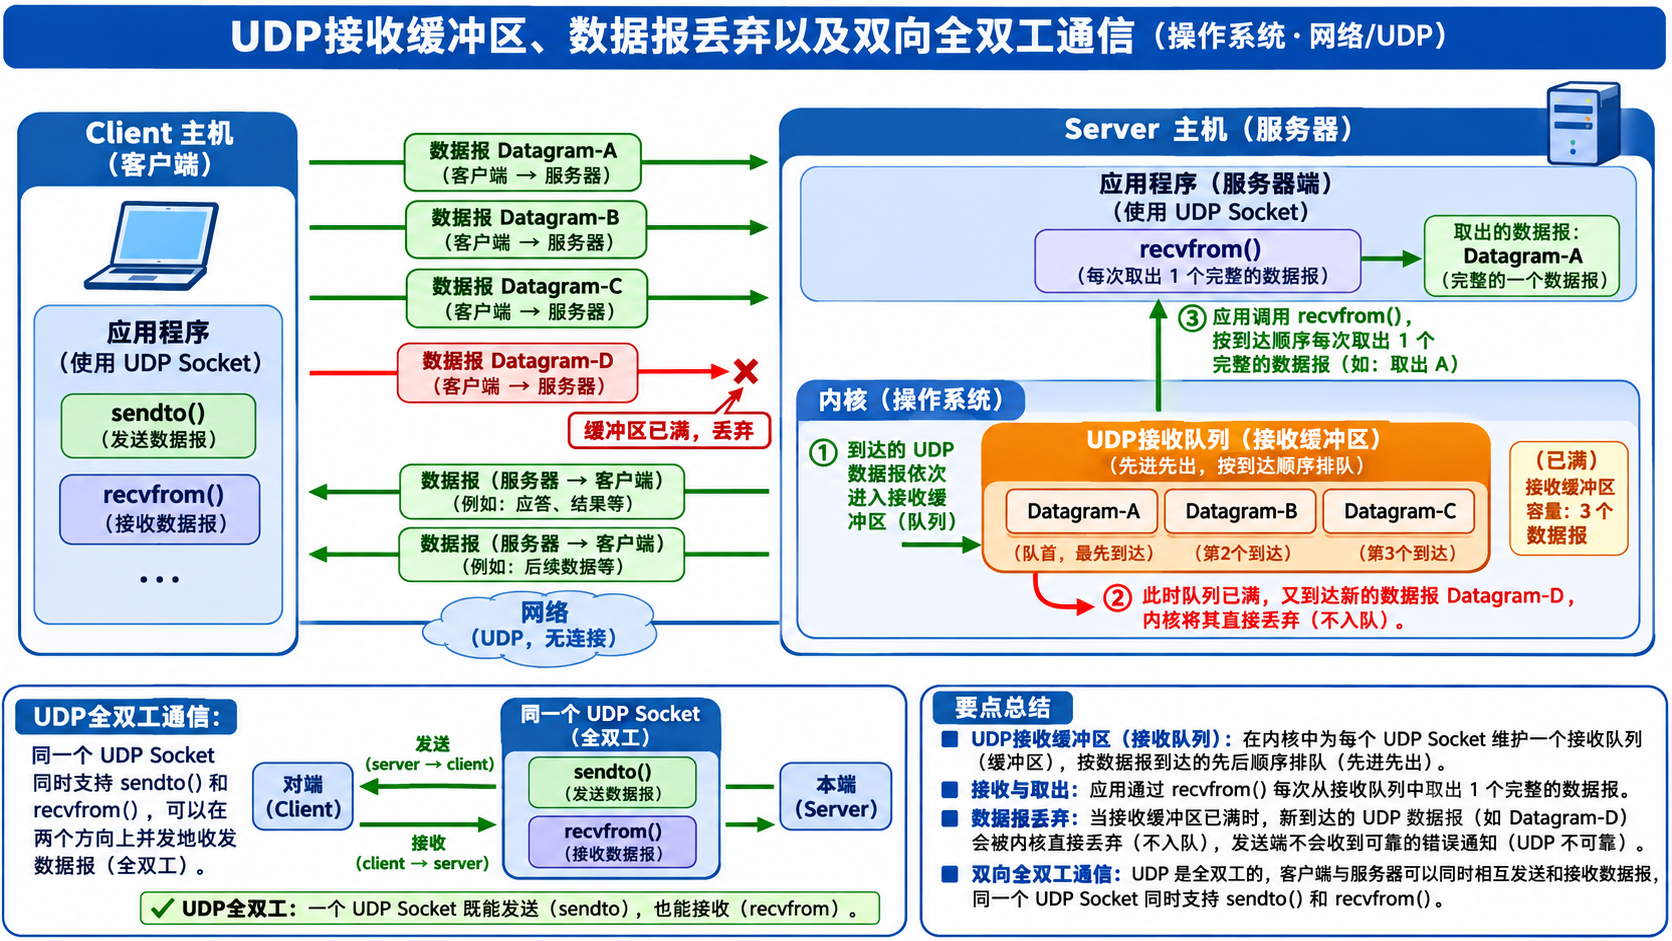
13.2 UDP具有接收缓冲区
UDP Socket具有接收队列或缓冲机制。
例如:
Datagram-A
Datagram-B
Datagram-C
到达接收主机后,内核可以将它们放入对应Socket的接收队列。
应用程序随后调用:
recvfrom()
取出数据报。
13.3 如果应用程序不及时读取怎么办?
假设服务器运行很慢。
客户端不断发送:
Datagram-1
Datagram-2
Datagram-3
…
服务器却迟迟不执行:
recvfrom()
那么Socket接收缓冲区可能逐渐被占满。
当没有足够空间容纳新的数据报时,就可能发生丢包。
因此:
UDP接收缓冲区不能保证到达的数据报永远不丢失。
13.4 UDP是否保证数据报顺序?
UDP协议本身不保证数据报的到达顺序。
即使接收缓冲区能够保存到达的数据报,也不等于整个网络传输过程一定保持发送顺序。
因此:
发送顺序
不一定等于:
接收顺序
十四、为什么说UDP支持全双工?
14.1 什么是全双工?
全双工意味着:
通信双方可以同时发送和接收数据。
例如:
Client Server
| |
|——- Datagram-A ———->|
| |
|<—— Datagram-B ———–|
| |
UDP Socket既可以执行:
sendto()
也可以执行:
recvfrom()
所以同一个UDP Socket可以参与双向数据通信。
14.2 为什么UDP没有连接也能全双工?
因为:
是否需要建立连接
与:
是否能够双向收发数据
是两个不同的问题。
UDP不需要TCP式连接建立过程。
但每一方仍然可以:
发送UDP数据报
接收UDP数据报
因此UDP可以支持全双工通信。
14.3 全双工是否表示应用程序一定同时调用sendto与recvfrom?
不是。
例如我们接下来实现的UDP Echo程序采用:
客户端发送
|
v
服务器接收
|
v
服务器返回
|
v
客户端接收
这是一种请求—响应式业务流程。
虽然业务上按顺序执行,但UDP Socket本身仍然具有双向通信能力。
十五、UDP单条数据报能传输多大的数据?
UDP报头中的长度字段是:
16位
因此最大能够表示:
2
16
−
1
=
65535
2^{16}-1=65535
216−1=65535
即:
65535字节
但需要注意:
这个长度包括:
UDP报头
UDP有效载荷
15.1 仅考虑UDP报头
UDP报头占8字节。
因此按UDP长度字段计算,最大有效载荷为:
65535
−
8
=
65527
65535-8=65527
65535−8=65527
即:
65527字节
15.2 为什么IPv4下通常还要减去IP报头?
因为UDP数据报还需要由IP层进行传输。
在普通IPv4、不包含IP选项的情况下,IPv4头部通常占20字节。
IPv4数据报的总长度字段也是16位。
所以单个普通IPv4数据报中,UDP有效载荷的最大值通常为:
65535
−
20
−
8
=
65507
65535-20-8=65507
65535−20−8=65507
即:
65507字节。
这与单纯从UDP长度字段计算出的65527字节不同。
因此,学习时不要简单认为:
UDP可以发送65535字节用户数据
更准确的说法是:
UDP长度字段最多能表示65535字节的UDP数据报,实际允许的用户数据长度还受到IP层等条件限制。
15.3 为什么通常不建议发送特别大的UDP数据报?
因为实际网络中存在:
不同链路和路径的报文大小限制
非常大的数据报可能增加底层分片、丢失等问题的影响。
因此在实际应用中,通常会谨慎控制UDP报文大小,而不是默认每条数据报都接近64KB。
15.4 超过UDP单条数据报限制怎么办?
如果应用程序需要发送超过单条UDP数据报上限的数据,就不能通过一条普通UDP数据报完成。
需要在应用层设计:
拆分数据
|
v
多次发送
|
v
接收多个数据报
|
v
按照规则重新拼装
例如:
一份大文件
|
+—- Datagram-1
|
+—- Datagram-2
|
+—- Datagram-3
接收端需要知道:
哪个数据报属于哪份数据?
各数据报的顺序是什么?
有没有发生丢失?
因此简单拆分还不够。
如果业务要求完整、正确的重组,就需要进一步设计编号、完整性检查及必要的丢失处理机制。
当前先理解:
UDP单条数据报存在长度限制,超过限制需要应用程序自行设计更高层的数据组织方式。
十六、有哪些基于UDP的应用层协议?
UDP虽然不提供可靠、有序传输保证,但它仍然被许多应用层协议采用。
常见例子:
16.1 NFS
NFS全称:
Network File System
中文:
网络文件系统
它用于通过网络访问文件系统资源。
一些NFS版本或实现能够使用UDP,现代部署中也广泛使用TCP。
16.2 TFTP
TFTP全称:
Trivial File Transfer Protocol
中文:
简单文件传输协议
它采用UDP作为传输层协议,并在应用层规定数据块、确认等机制。
16.3 DHCP
DHCP全称:
Dynamic Host Configuration Protocol
中文:
动态主机配置协议
用于为客户端分配或协商:
IP地址
子网掩码
网关
DNS服务器地址
等网络配置信息。
16.4 BOOTP
BOOTP全称:
Bootstrap Protocol
是一种用于网络启动配置的协议。
它与早期的网络启动、无盘设备等场景有关。
16.5 DNS
DNS全称:
Domain Name System
即:
域名系统
例如将:
www.example.com
解析为相应IP地址。
DNS既可以使用UDP,也可以使用TCP。
因此不能简单认为:
DNS只能使用UDP
16.6 自定义UDP应用层协议
除了这些已有协议,我们自己编写UDP程序时,也可以定义应用层规则。
例如:
客户端发送hello
服务器返回server echo# hello
这就是一个简单的UDP回显业务约定。
接下来,我们使用Linux Socket编程完整实现它。
十七、总结
本文首先从传输层的职责出发,解释了为什么一台主机上的多个应用程序需要使用端口号区分网络通信。
随后学习了:
源IP
源端口
目的IP
目的端口
协议号
构成的通信五元组。
并认识:
知名端口
端口范围
临时端口分配
端口绑定关系
等基础概念。
接下来正式分析UDP固定8字节报头:
16位源端口
16位目的端口
16位UDP长度
16位UDP校验和
以及UDP的三个核心特点:
无连接、不可靠、面向数据报。
其中最需要掌握的是:
UDP面向数据报,能够保留应用程序提交的数据报边界,但不保证数据报一定送达,也不保证数据报按发送顺序到达。
随后学习了UDP接收缓冲区、全双工能力和单条数据报的长度限制。



评论前必须登录!
注册