 网硕互联帮助中心
上个文章做了对标题/正文识别的预处理,接下来就是训练模型识别标题/正文了。
流程描述部分
这里我用的是随机森林做决策,先看下具体流程
准备训练集
提取训练集中的数据特征
训练模型
预测测试
一些思考:
准备训练集
上个文章说到,这个模型识别的是标题/正文,同时上个文章对识别做了些预处理,这里就只需要识别那些无句子结束符的短句即可。
例如:
工作经历(这是个标题)
在什么什么做了什么什么
在什么什么地方任职了什么什么几年
这里准备的训练集就是这些短句,每个短句都有一个标签,标签就是标题/正文。
训练集格式:
标题1
标题1的描述。。。
标题1的另一个描述。。。
标题2
标题2的描述。。。
标题2的另一个描述。。。
每一小块都是完整的标题正文,这一块的第一个是标题,后面的是正文,为了打标签方便。
提取训练集中的数据特征
提取文字特征,这里不用embedding,而是用分词结合TF-IDF构建词频矩阵
为什么不用embedding?看下面的图片

看不清的话有下面文字:
句子 A:【制作工艺】郎川墨玉石砚的制作工序繁复精细,主要包括以下环节:一、选石:于郎川河床及山麓采选墨玉原石,以色纯无瑕、质地均匀者为上。二、制坯:将原石依纹理解理,切削成砚坯,粗磨定形。三、设计:规划砚池、砚边及纹饰布局,因石构图、巧借天然。四、雕刻:以刻刀精雕纹饰,技法有深雕、浅雕、线刻等,刀法沉稳流畅。
句子 B:郎川墨玉石砚可以用来做端午节的粽子,孙悟空吃了这个粽子之后就能和林黛玉一较高下了,武松吃了这个粽子也可以去向诸葛亮七星续命了。
余弦相似度:0.5932
可以看到,两个意思差的比较远的句子,相似度居然接近0.6
把第一个相同的词去掉,再计算相似度,发现相似度就下降为0.3了

看不清的话有下面文字:
句子 A:【制作工艺】郎川墨玉石砚的制作工序繁复精细,主要包括以下环节:一、选石:于郎川河床及山麓采选墨玉原石,以色纯无瑕、质地均匀者为上。二、制坯:将原石依纹理解理,切削成砚坯,粗磨定形。三、设计:规划砚池、砚边及纹饰布局,因石构图、巧借天然。四、雕刻:以刻刀精雕纹饰,技法有深雕、浅雕、线刻等,刀法沉稳流畅。
句子 B:它可以用来做端午节的粽子,孙悟空吃了这个粽子之后就能和林黛玉一较高下了,武松吃了这个粽子也可以去向诸葛亮七星续命了。
余弦相似度:0.3503
肯定会有这么个思想,换embedding模型,看哪个能解决这个问题就用哪个,但是,embedding是我们看不到内部实现的,它可能对具有部分相同关键词的不同句子区分效果不太好。
embedding也可能受到关键词较大的影响,我就直接用分词和TF-IDF代表一定程度的语义了。同时减少单字(例如“的”)对语义的影响。
总体来说,选用TF-IDF的原因
但是单纯根据分词提取特征还有缺陷,例如描述一个人的经历的时候,下面这种格式:
职位名字 | 2026-01-01 至 2026-02-01
这种格式的话提取到的就只有职位的名字,如果职位名字还没几个词,那这个特征提取的效果就很差。
所以训练的时候还要根据本身内部知识库的特征,增加适当的训练集数据,将这种正文的特征也提取出来。
由于代码较多,就不一边描述流程一边贴代码了,先把整体流程描述清楚之后再贴代码。
训练模型
从上面可以看出,这是一个分类问题,而且是一个二分类问题,所以可以采用分类模型进行决策。我这里用到的是随机森林,当然可以跑其他分类模型进行测试,寻求最好的效果。
代码实现部分(只列出必要代码)
分词提取
def _tokenize(text):
# 返回的是字符串,用空格拼接,TfidfVectorizer要求输入是字符串,它内部按空格切词,
words = jieba.lcut(text)
# 保留长度大于1的词,去掉标点符号和单个字还有数字,数字根据结构化来做
words = [w for w in words if len(w) > 1 or re.match(r'[\\u4e00-\\u9fff]', w)] # 那个正则是Unicode中文的范围
words = [w for w in words if not re.match(r'\\d+', w)] # 去掉年份等数字,年份放到结构里
return ' '.join(words)
只提取词还不够,还要根据内部知识库的特征,提取对应的特征,这里我根据我的知识库里的内容特征提取六个
def _structural_features(text):
# 六个:字符数,分词后的词的数量,有没有冒号,有没有竖线,有没有数字(年份结构,不能丢弃), 是否有括号(第三版,这个也不能丢)
char_len = len(text)
word_count = len(jieba.lcut(text))
has_colon = 1 if (':' in text or ':' in text) else 0
has_pipe = 1 if '|' in text else 0
has_year = 1 if re.search(r'\\d{4}', text) else 0
has_paren = 1 if ('(' in text or '(' in text) else 0
return [char_len, word_count, has_colon, has_pipe, has_year, has_paren]
后面训练的时候,用到的特征矩阵就是词频矩阵拼接结构特征矩阵
训练模型
# 训练模型
def _train():
training_data = _load_training_data(TRAINING_DATA_PATH)
# 获取文本和结果,文本是每行的字,结果是标题还是正文
# 工作经历
# 2018.07-2022.06 某某公司 后端开发工程师。
# 负责订单系统的重构。
#
# 科研项目
# 基于深度学习的某某研究
#
# [
# ('工作经历', 1), # 第一行 → 标题
# ('2018.07-2022.06 某某公司 后端开发工程师。', 0), # 后面 → 正文
# ('负责订单系统的重构。', 0), # 后面 → 正文
# ('科研项目', 1), # 空行后新段第一行 → 标题
# ('基于深度学习的某某研究', 0), # 后面 → 正文
# ]
# 取文本
texts = [item[0] for item in training_data]
# 取结果
labels = [item[1] for item in training_data]
#把分词作为列表
tokenized = [_tokenize(t) for t in texts]
# TF-IDF向量化
vectorizer = TfidfVectorizer()
X_tfidf = vectorizer.fit_transform(tokenized)
# 提取结构特征
struct_arr = np.array([_structural_features(t) for t in texts], dtype=np.float64)
#拼接特征
X = hstack([X_tfidf, struct_arr])
# 训练随机森林
model = RandomForestClassifier(
n_estimators=N_ESTIMATORS,
random_state=RANDOM_STATE,
class_weight='balanced'
)
model.fit(X, labels)
return model, vectorizer
之后可以把模型存为两个文件,一个向量化器,存的词典,用来输出tfidf特征;一个用来决策的模型。
不用重复训练,方便调用预测看效果。
训练好模型之后就要对每个标题/正文进行识别
提取这个识别的句子的特征并决定是否保留,通过判断这句话是否大于“是正文”的阈值进行判断。
def _should_keep(line):
# 确保模型已加载
_ensure_model()
# 把文本转为特征向量
tokenized = _tokenize(line)
if not tokenized.strip():
return True # 分词后没词,不误删,认为是正文,保留,兜个底,不丢
X_tfidf = _vectorizer.transform([tokenized])
struct_arr = np.array([_structural_features(line)], dtype=np.float64)
X = hstack([X_tfidf, struct_arr])
if X_tfidf.nnz == 0:
# 分词的向量都是0,还有结构,先通过,但不返回true,
# 这个if写不写都一样,为了突出还有结构的事,所以写了这个if,后面加个pass
pass
# 决策树决策
proba = _model.predict_proba(X)[0]
# 正常情况直接取出来预测的值,如果预测出了异常的话用个0.5,实际上不会走到0.5,
# 比如就一类,全是正文,proba里就一个数字,这是个二分类,得俩数据,训练集已经保证不会走到这里
content_prob = proba[0] if len(proba) > 1 else 0.5
return content_prob >= CONTENT_THRESHOLD
对外暴露个方法识别是否保留
def is_content(line):
return _should_keep(line)
测试
看一下测试效果
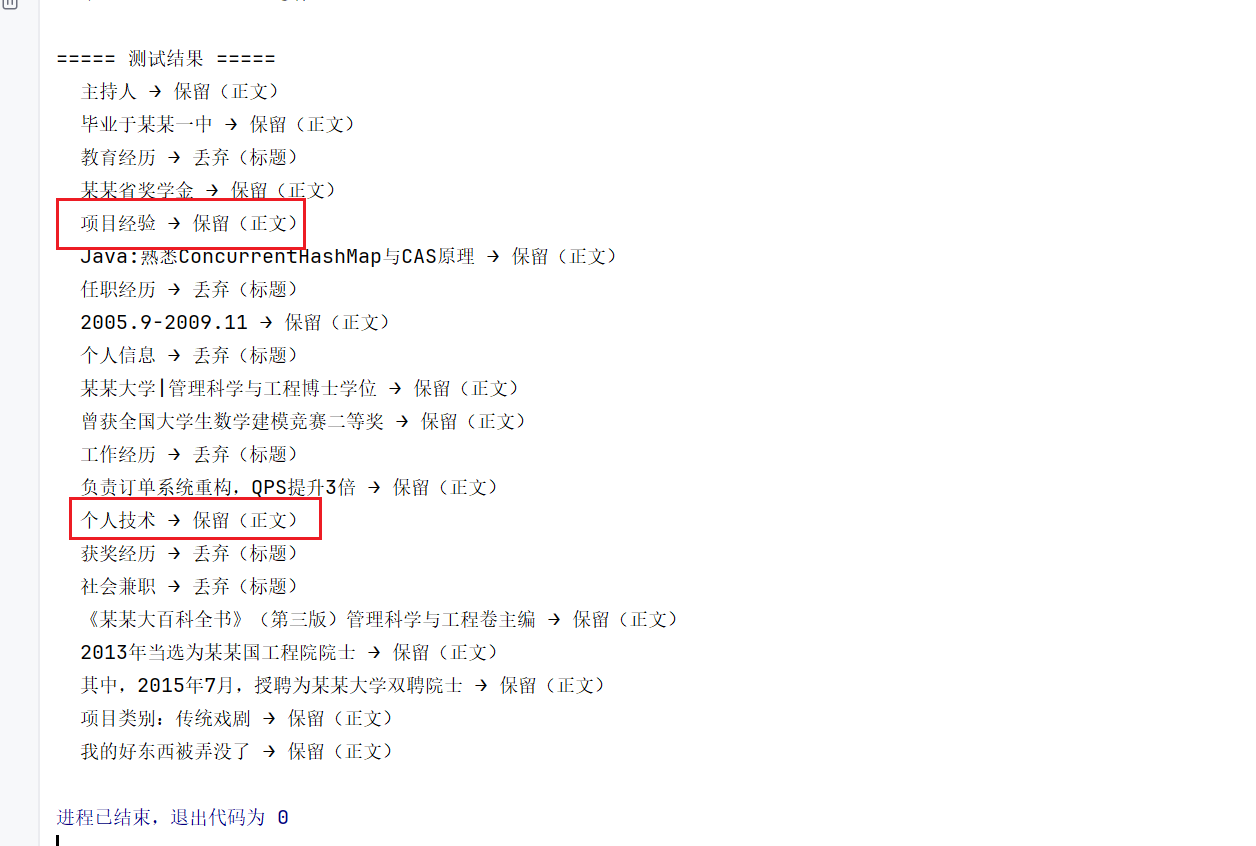
效果:认为是标题的,有两个识别为了正文,正文都识别对了。这个可以容忍
正文尽量不能识别为标题,否则会有丢弃的概率(下个文章说)
标题可以容忍被识别为正文,后期会把它和它对应的正文放一起(下个文章说)
达到的效果:
大部分的标题识别正确,会和它的正文放到一起,整个分片说的同一个东西。
少部分的标题识别为正文,它和它的正文有一定的概率会和上一段正文的内容放在一起,一个分片把本来应该是两个分片合在了一起。检索的时候会对这个现象做优化。
最后再看一下用数据较多的测试集测的结果
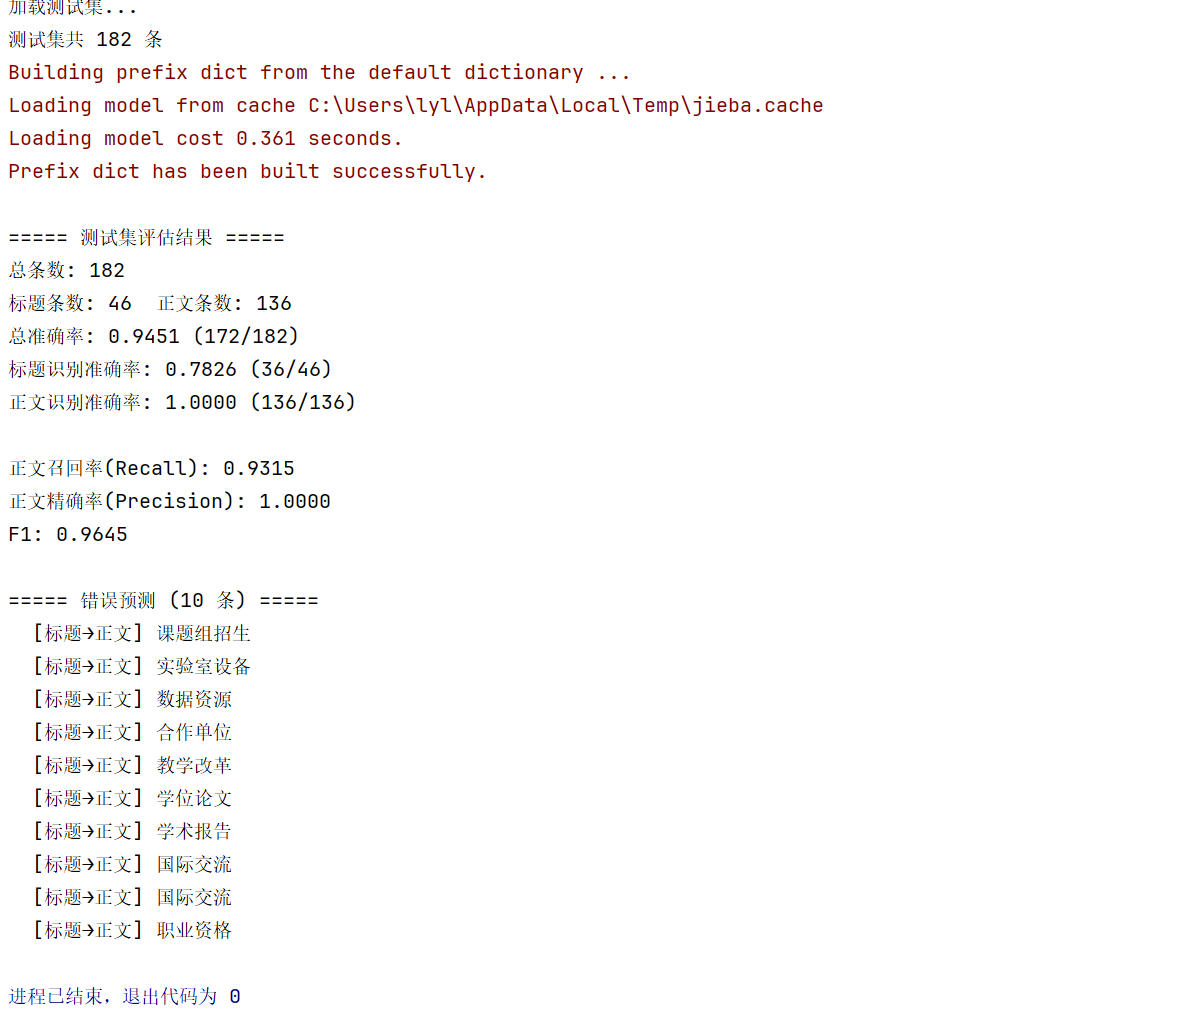
这些测试数据是基于知识库定位新写的,不和训练集重复,具有一定随机性。可以看到和上面效果基本一样:部分标题被识别为正文,正文都识别正确。
做到的效果是“一个分片可以有小概率脏的情况,但是正文不能丢”。同时后续检索过程中,对脏的情况进行了优化处理,降低检索回的是噪声的干扰。
现在解决了标题和正文的识别问题,后续就是思考如何把这些内容按照什么样的规则组合起来真正实现切片的效果。下个文章再说。




评论前必须登录!
注册