 网硕互联帮助中心
文章目录
- 1. 概述
- 2. 集成示例
-
- 2.1 使用方式
- 2.2 第三方集成
-
- 2.2.1 OpenTelemetry
- 2.2.2 LlamaTrace(托管版 Arize Phoenix)
- 2.2.3 SigNoz
- 2.2.4 Weights and Biases (W&B) Weave
- 2.2.5 MLflow
- 2.2.6 OpenLLMetry
- 2.2.7 Arize Phoenix(本地部署)
- 2.2.8 Langfuse
- 2.2.9 Literal AI
- 2.2.10 Comet Opik
- 2.2.11 Argilla
- 2.2.12 Agenta
- 2.2.13 Deepeval
- 2.2.14 Confident AI
- 2.2.15 Maxim AI
- 3. Callbacks(回调机制)
-
- 3.1 回调事件类型
- 3.2 内置回调模块
- 3.3 TokenCounting 迁移指南
- 4. Instrumentation(插桩模块)
-
- 4.1 核心类说明
- 4.2 使用插桩做可观测性
-
- 4.2.1 自定义 EventHandler
- 4.2.3 自定义 Event
- 4.2.3 自定义 Span & SpanHandler
- 4.2.4 Span 进入/退出
- 4.2.4 Dispatcher 层级机制
1. 概述
针对开发规范大模型应用(RAG 系统、智能 Agent),一项核心要求是:能够对系统整体以及各个组件进行观测、调试、评估。
LlamaIndex 提供一键可观测性🔭能力,让你能够在生产环境中构建规范可靠的大模型应用。
该功能可以让 LlamaIndex 库无缝对接合作伙伴提供的强大可观测/评估工具。只需配置一次变量,即可实现如下能力:
- 查看大模型 / Prompt 的输入与输出
- 保障任意组件(大模型、嵌入模型)输出符合预期
- 查看索引构建与查询阶段的调用链路追踪
注意 可观测性现已由 instrumentation(插桩)模块实现(v0.10.20 及以上版本可用)。
本页面提及的大量工具与集成仍在使用旧版 CallbackManager,或未使用 set_global_handler,我们已对这类集成做标记说明。
2. 集成示例
2.1 使用方式
开启能力通常只需要如下代码:
from llama_index.core import set_global_handler
# 通用用法
set_global_handler("<handler_name>", **kwargs)
set_global_handler 的所有关键字参数,都会透传给底层回调处理器。
配置完成!执行链路会自动流转到下游服务,你就可以使用应用执行链路追踪等能力。
2.2 第三方集成
2.2.1 OpenTelemetry
OpenTelemetry 是广泛使用的开源链路追踪与可观测套件,支持大量后端存储(Jaeger、Zipkin、Prometheus 等)。
LlamaIndex 的 OpenTelemetry 集成会追踪 LlamaIndex 产生的全部事件:大模型调用、Agent、RAG 流水线组件等。LlamaIndex 原生插桩采集到的所有数据,都可以导出为 OpenTelemetry 格式。
安装依赖:
pip install llama-index-observability-otel
RAG 流水线默认配置示例:
from llama_index.observability.otel import LlamaIndexOpenTelemetry
from llama_index.core import SimpleDirectoryReader, VectorStoreIndex
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.core import Settings
# 初始化插桩对象
instrumentor = LlamaIndexOpenTelemetry()
if __name__ == "__main__":
embed_model = OpenAIEmbedding(model_name="text-embedding-3-small")
llm = OpenAI(model="gpt-4.1-mini")
# 开始监听事件
instrumentor.start_registering()
# 加载文档、构建索引
documents = SimpleDirectoryReader(
input_dir="./data/paul_graham/"
).load_data()
index = VectorStoreIndex.from_documents(documents, embed_model=embed_model)
query_engine = index.as_query_engine(llm=llm)
query_result_one = query_engine.query("Who is Paul?")
query_result_two = query_engine.query("What did Paul do?")
自定义高级配置示例:
import json
from pydantic import BaseModel, Field
from typing import List
from llama_index.observability.otel import LlamaIndexOpenTelemetry
from opentelemetry.exporter.otlp.proto.http.trace_exporter import (
OTLPSpanExporter,
)
# 自定义 Span 导出器
span_exporter = OTLPSpanExporter("http://0.0.0.0:4318/v1/traces")
# 初始化插桩对象
instrumentor = LlamaIndexOpenTelemetry(
service_name_or_resource="my.test.service.1",
span_exporter=span_exporter,
debug=True,
)
if __name__ == "__main__":
instrumentor.start_registering()
# …业务代码
我们还提供演示仓库,展示如何追踪 Agent 工作流,并将链路数据存入 Postgres 数据库。
2.2.2 LlamaTrace(托管版 Arize Phoenix)
LlamaIndex 与 Arize AI 合作推出 LlamaTrace:托管式链路追踪、可观测与评估平台,原生适配开源 LlamaIndex 用户,并对接 LlamaCloud。
项目基于开源 Arize Phoenix 构建。Phoenix 以 Notebook 优先的体验监控模型与大模型应用,提供:
- 大模型链路追踪:跟踪大模型应用完整执行流程,理解内部逻辑,排查检索、工具调用等问题。
- 大模型评估:利用大模型能力评估生成模型/应用的相关性、有害性等指标。
安装集成包:
pip install -U llama-index-callbacks-arize-phoenix
前往 https://llamatrace.com/login 注册账号,创建 API Key,填入环境变量。
# Phoenix 可实时自动采集展示 LlamaIndex 应用链路
# 正常运行 LlamaIndex 业务,链路会自动采集展示
import llama_index.core
import os
PHOENIX_API_KEY = "<PHOENIX_API_KEY>"
os.environ["OTEL_EXPORTER_OTLP_HEADERS"] = f"api_key={PHOENIX_API_KEY}"
llama_index.core.set_global_handler(
"arize_phoenix", endpoint="https://llamatrace.com/v1/traces"
)
参考文档:
- Trace LlamaIndex with Arize AX
- Arize agent evaluation guide
- Arize LLM evaluation guide
2.2.3 SigNoz
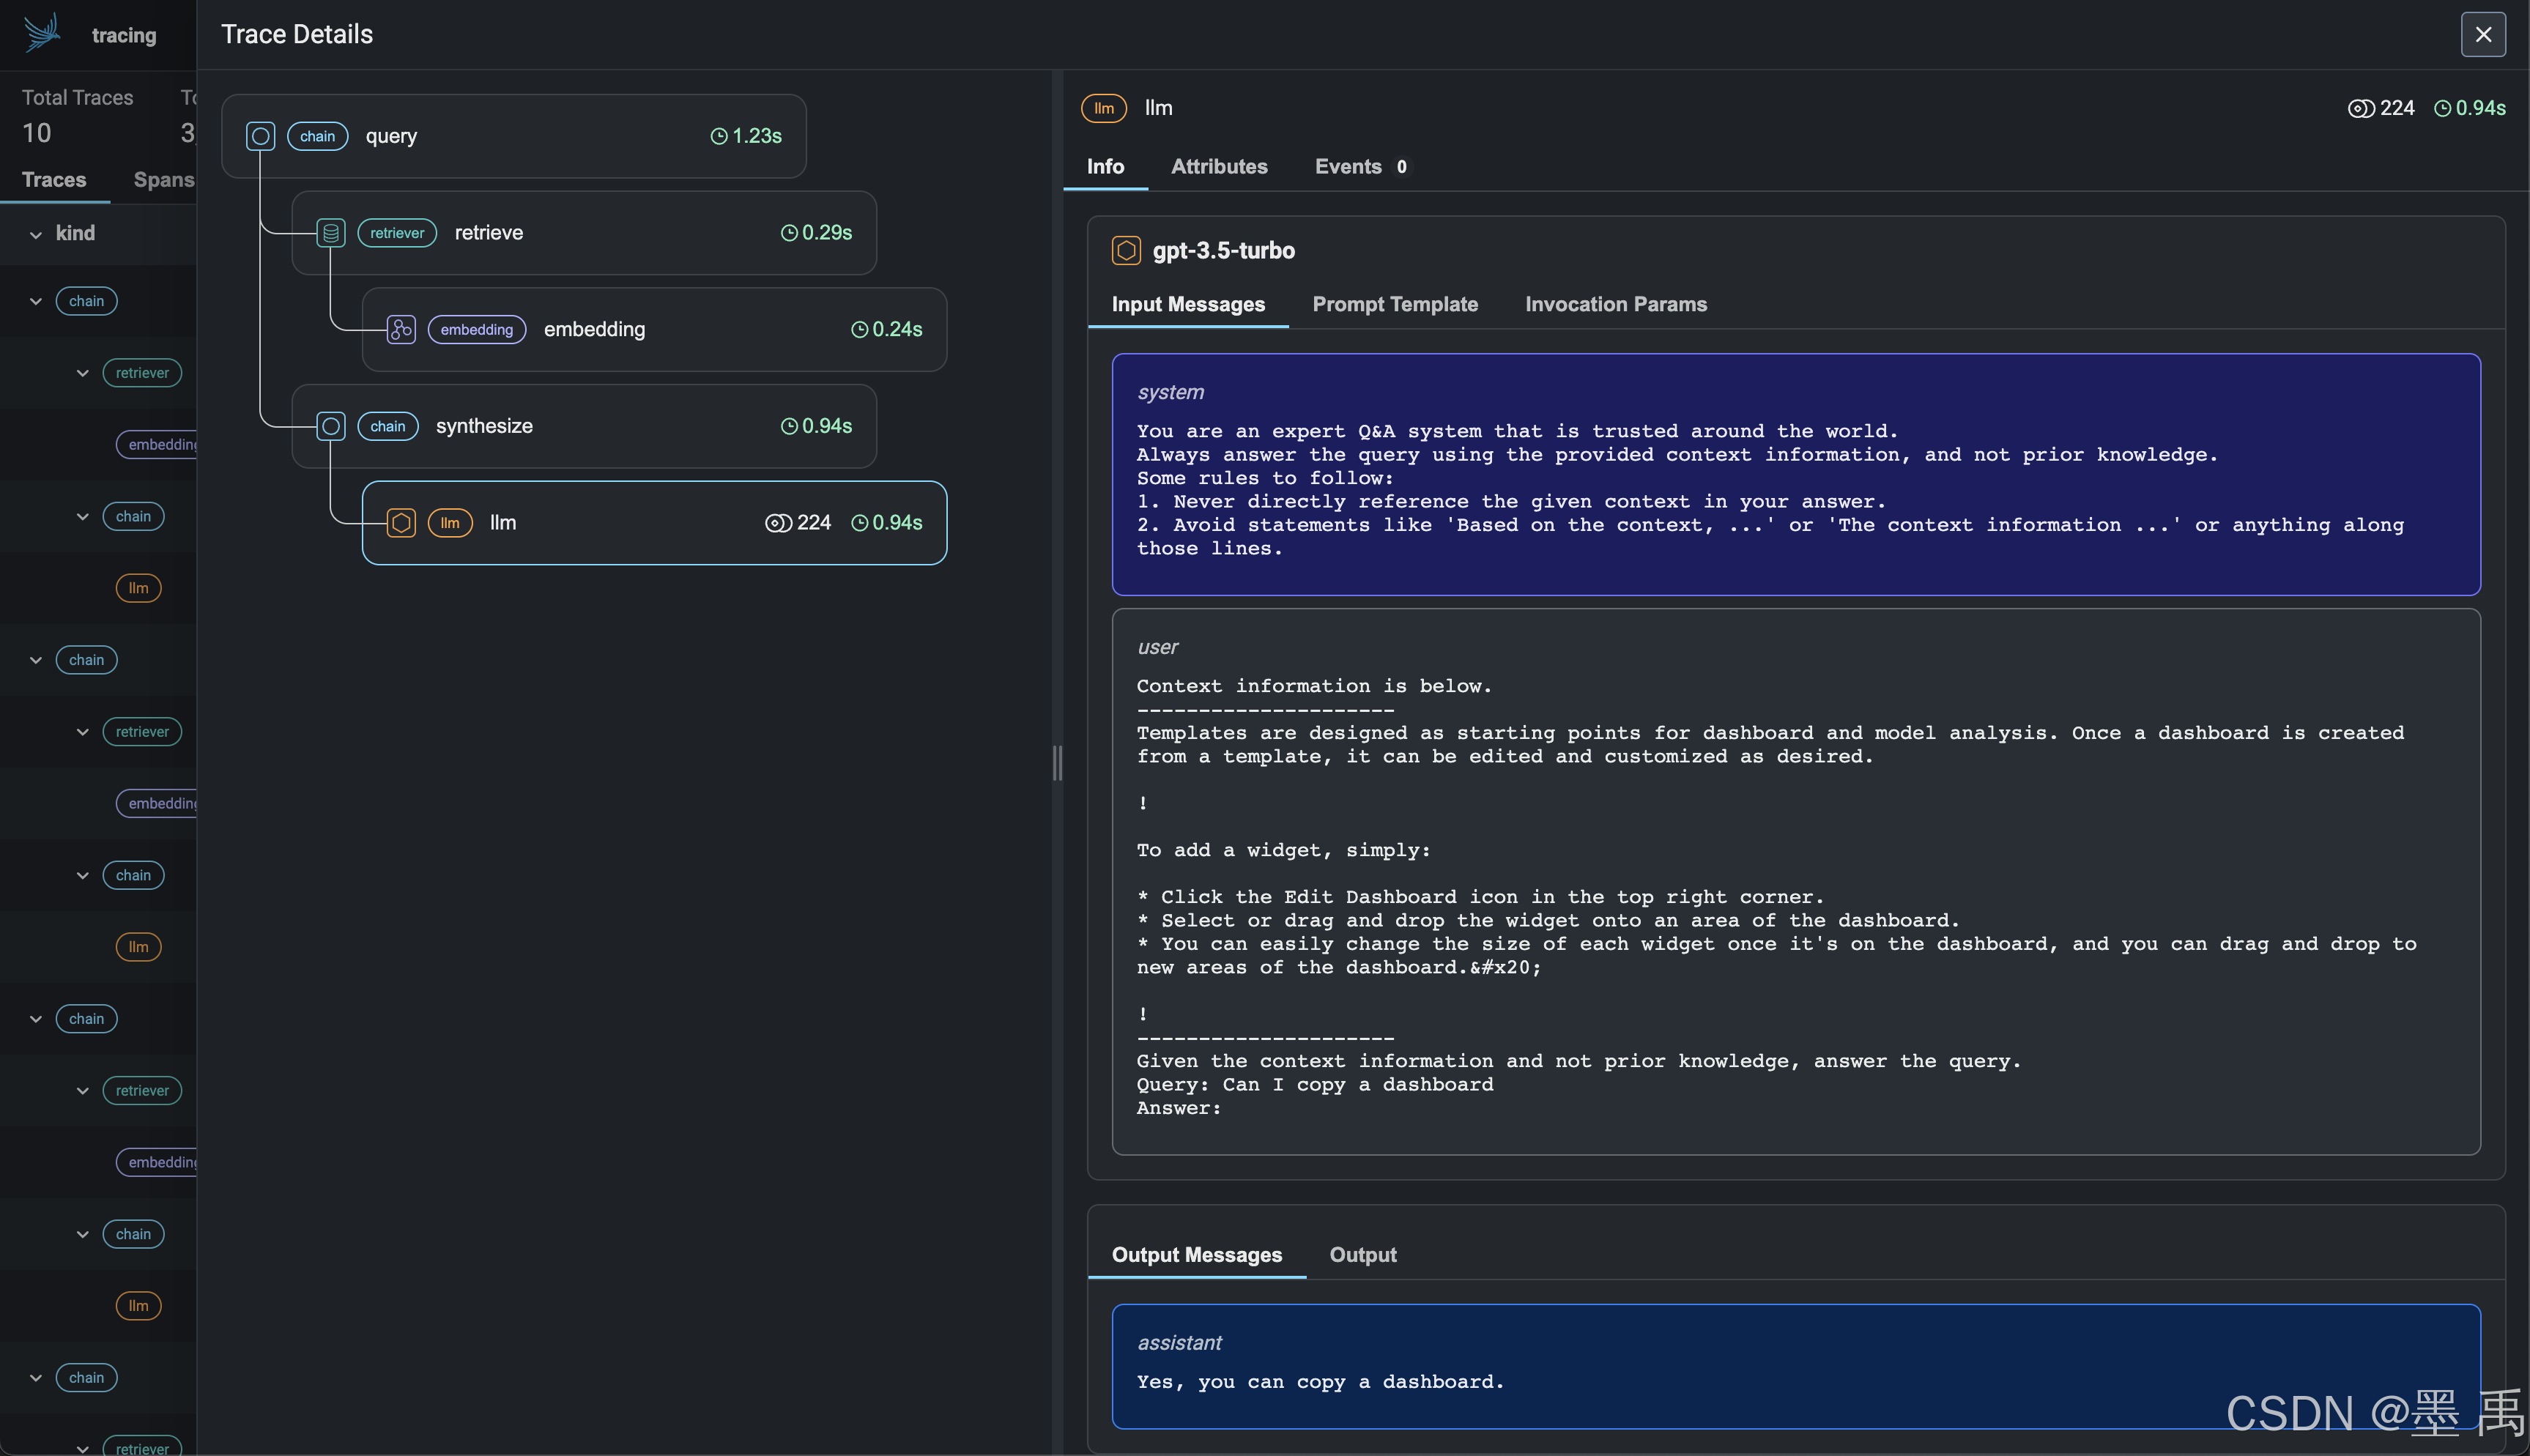
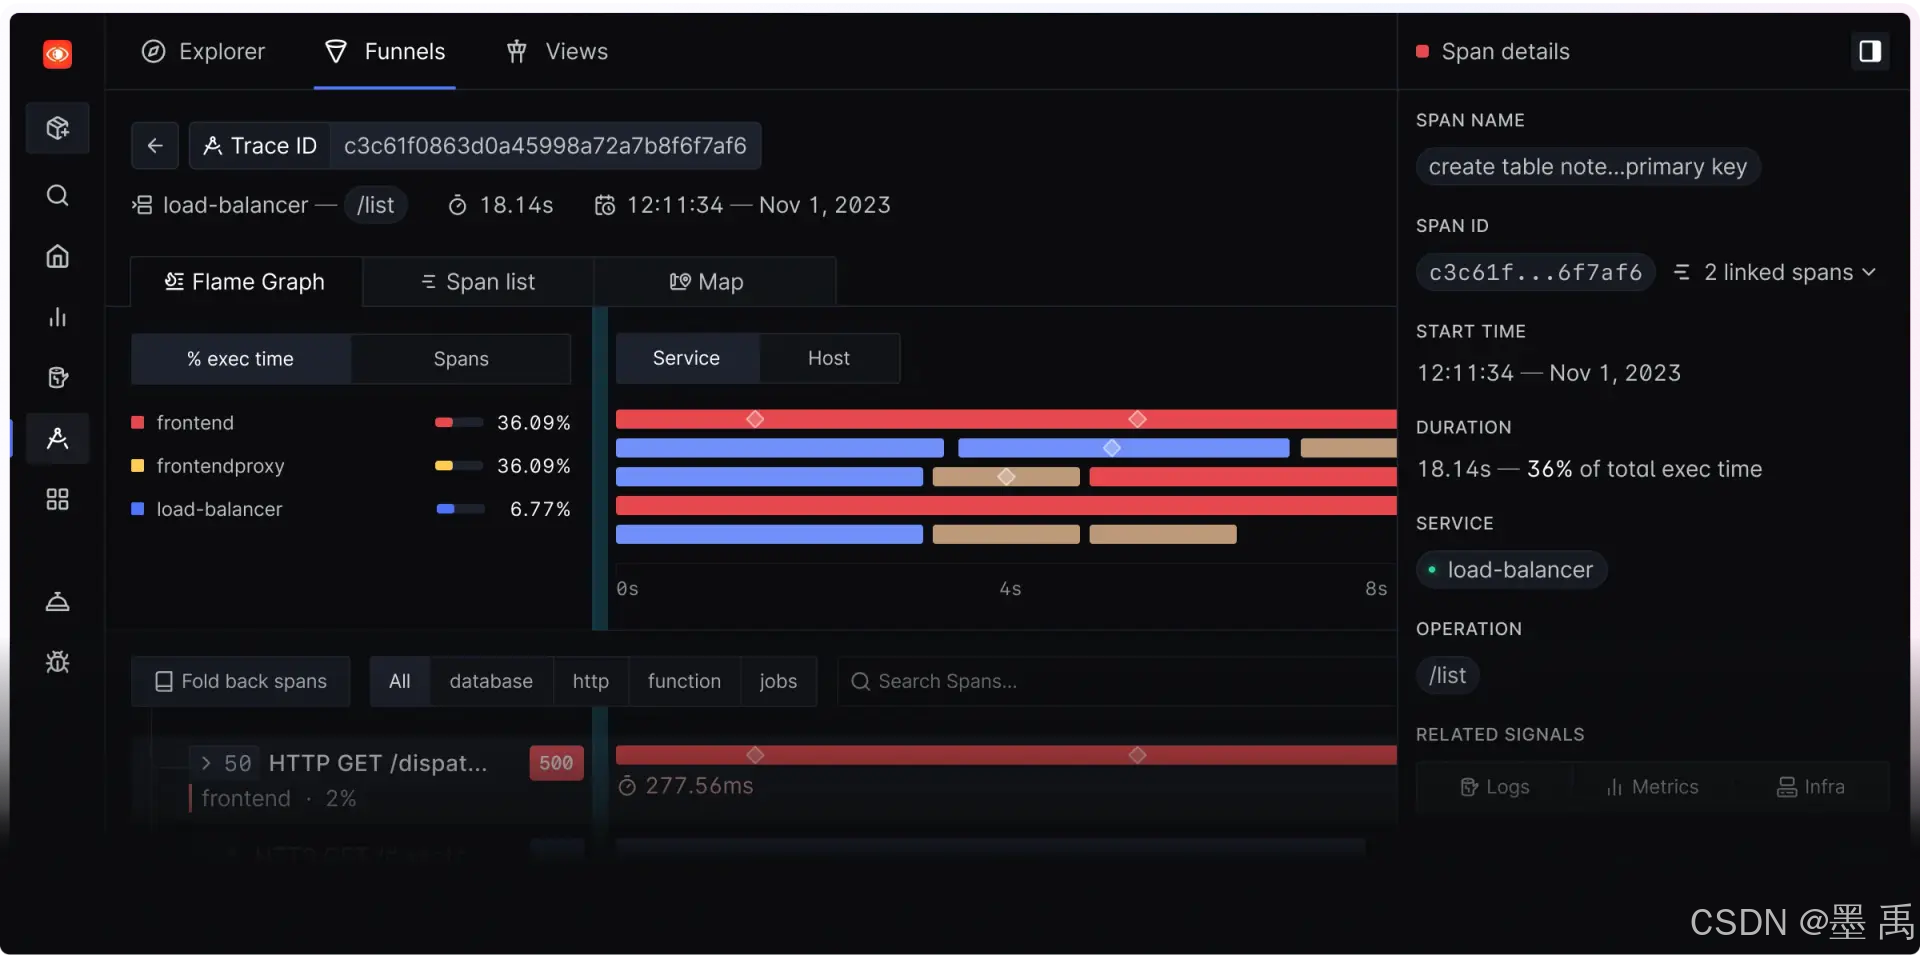
SigNoz 是开源可观测平台,原生基于 OpenTelemetry 构建,在统一面板提供链路、日志、指标,支持私有化部署与云服务。搭配 LlamaIndex,可以查看完整 RAG、Agent 工作流详细链路,同时监控 Token 消耗、延迟、错误率、大模型模型分布等核心指标。
安装依赖:
pip install \\
opentelemetry-distro \\
opentelemetry-exporter-otlp \\
opentelemetry-instrumentation-httpx \\
opentelemetry-instrumentation-system-metrics \\
llama-index \\
openinference-instrumentation-llama-index
执行自动插桩安装:
opentelemetry-bootstrap –action=install
通过 OpenTelemetry 启动 LlamaIndex 应用:
OTEL_RESOURCE_ATTRIBUTES="service.name=<service_name>" \\
OTEL_EXPORTER_OTLP_ENDPOINT="https://ingest.<region>.signoz.cloud:443" \\
OTEL_EXPORTER_OTLP_HEADERS="signoz-ingestion-key=<your_ingestion_key>" \\
OTEL_EXPORTER_OTLP_PROTOCOL=grpc \\
OTEL_TRACES_EXPORTER=otlp \\
OTEL_METRICS_EXPORTER=otlp \\
OTEL_LOGS_EXPORTER=otlp \\
OTEL_PYTHON_LOG_CORRELATION=true \\
OTEL_PYTHON_LOGGING_AUTO_INSTRUMENTATION_ENABLED=true \\
opentelemetry-instrument <your_run_command>
- <service_name>:你的服务名称
- <region>:SigNoz Cloud 对应区域
- <your_ingestion_key>:SigNoz 采集密钥
- <your_run_command>:启动应用命令,例如 python main.py
📌 私有化 SigNoz:绝大多数步骤一致,修改 Endpoint,移除 ingestion‑key 请求头即可。
之后即可查看 LlamaIndex 自动/手动导出的链路、日志、指标。
参考文档:
- SigNoz LlamaIndex Integration Docs
- SigNoz LLamaIndex Q&A RAG Demo
2.2.4 Weights and Biases (W&B) Weave
W&B Weave 用于跟踪、实验、评估、部署、迭代大模型应用。具备高可扩展性与灵活性,覆盖应用开发全流程。
该集成基于 LlamaIndex 插桩模块,将 Span/事件注册为 Weave 调用。默认 Weave 自动打补丁,追踪主流大模型库与框架调用。
安装:
pip install weave
获取 W&B API Key:访问 https://wandb.ai 注册账号,在 https://wandb.ai/authorize 复制密钥。
import weave
from llama_index.llms.openai import OpenAI
# 使用项目名初始化 Weave
weave.init("llamaindex-demo")
# 所有 LlamaIndex 操作自动开启追踪
llm = OpenAI(model="gpt-4o-mini")
response = llm.complete("William Shakespeare is ")
print(response)
链路包含执行耗时、Token 消耗、成本、输入输出、异常、嵌套调用、流式数据。自定义函数想要被追踪,加上装饰器 @weave.op()。
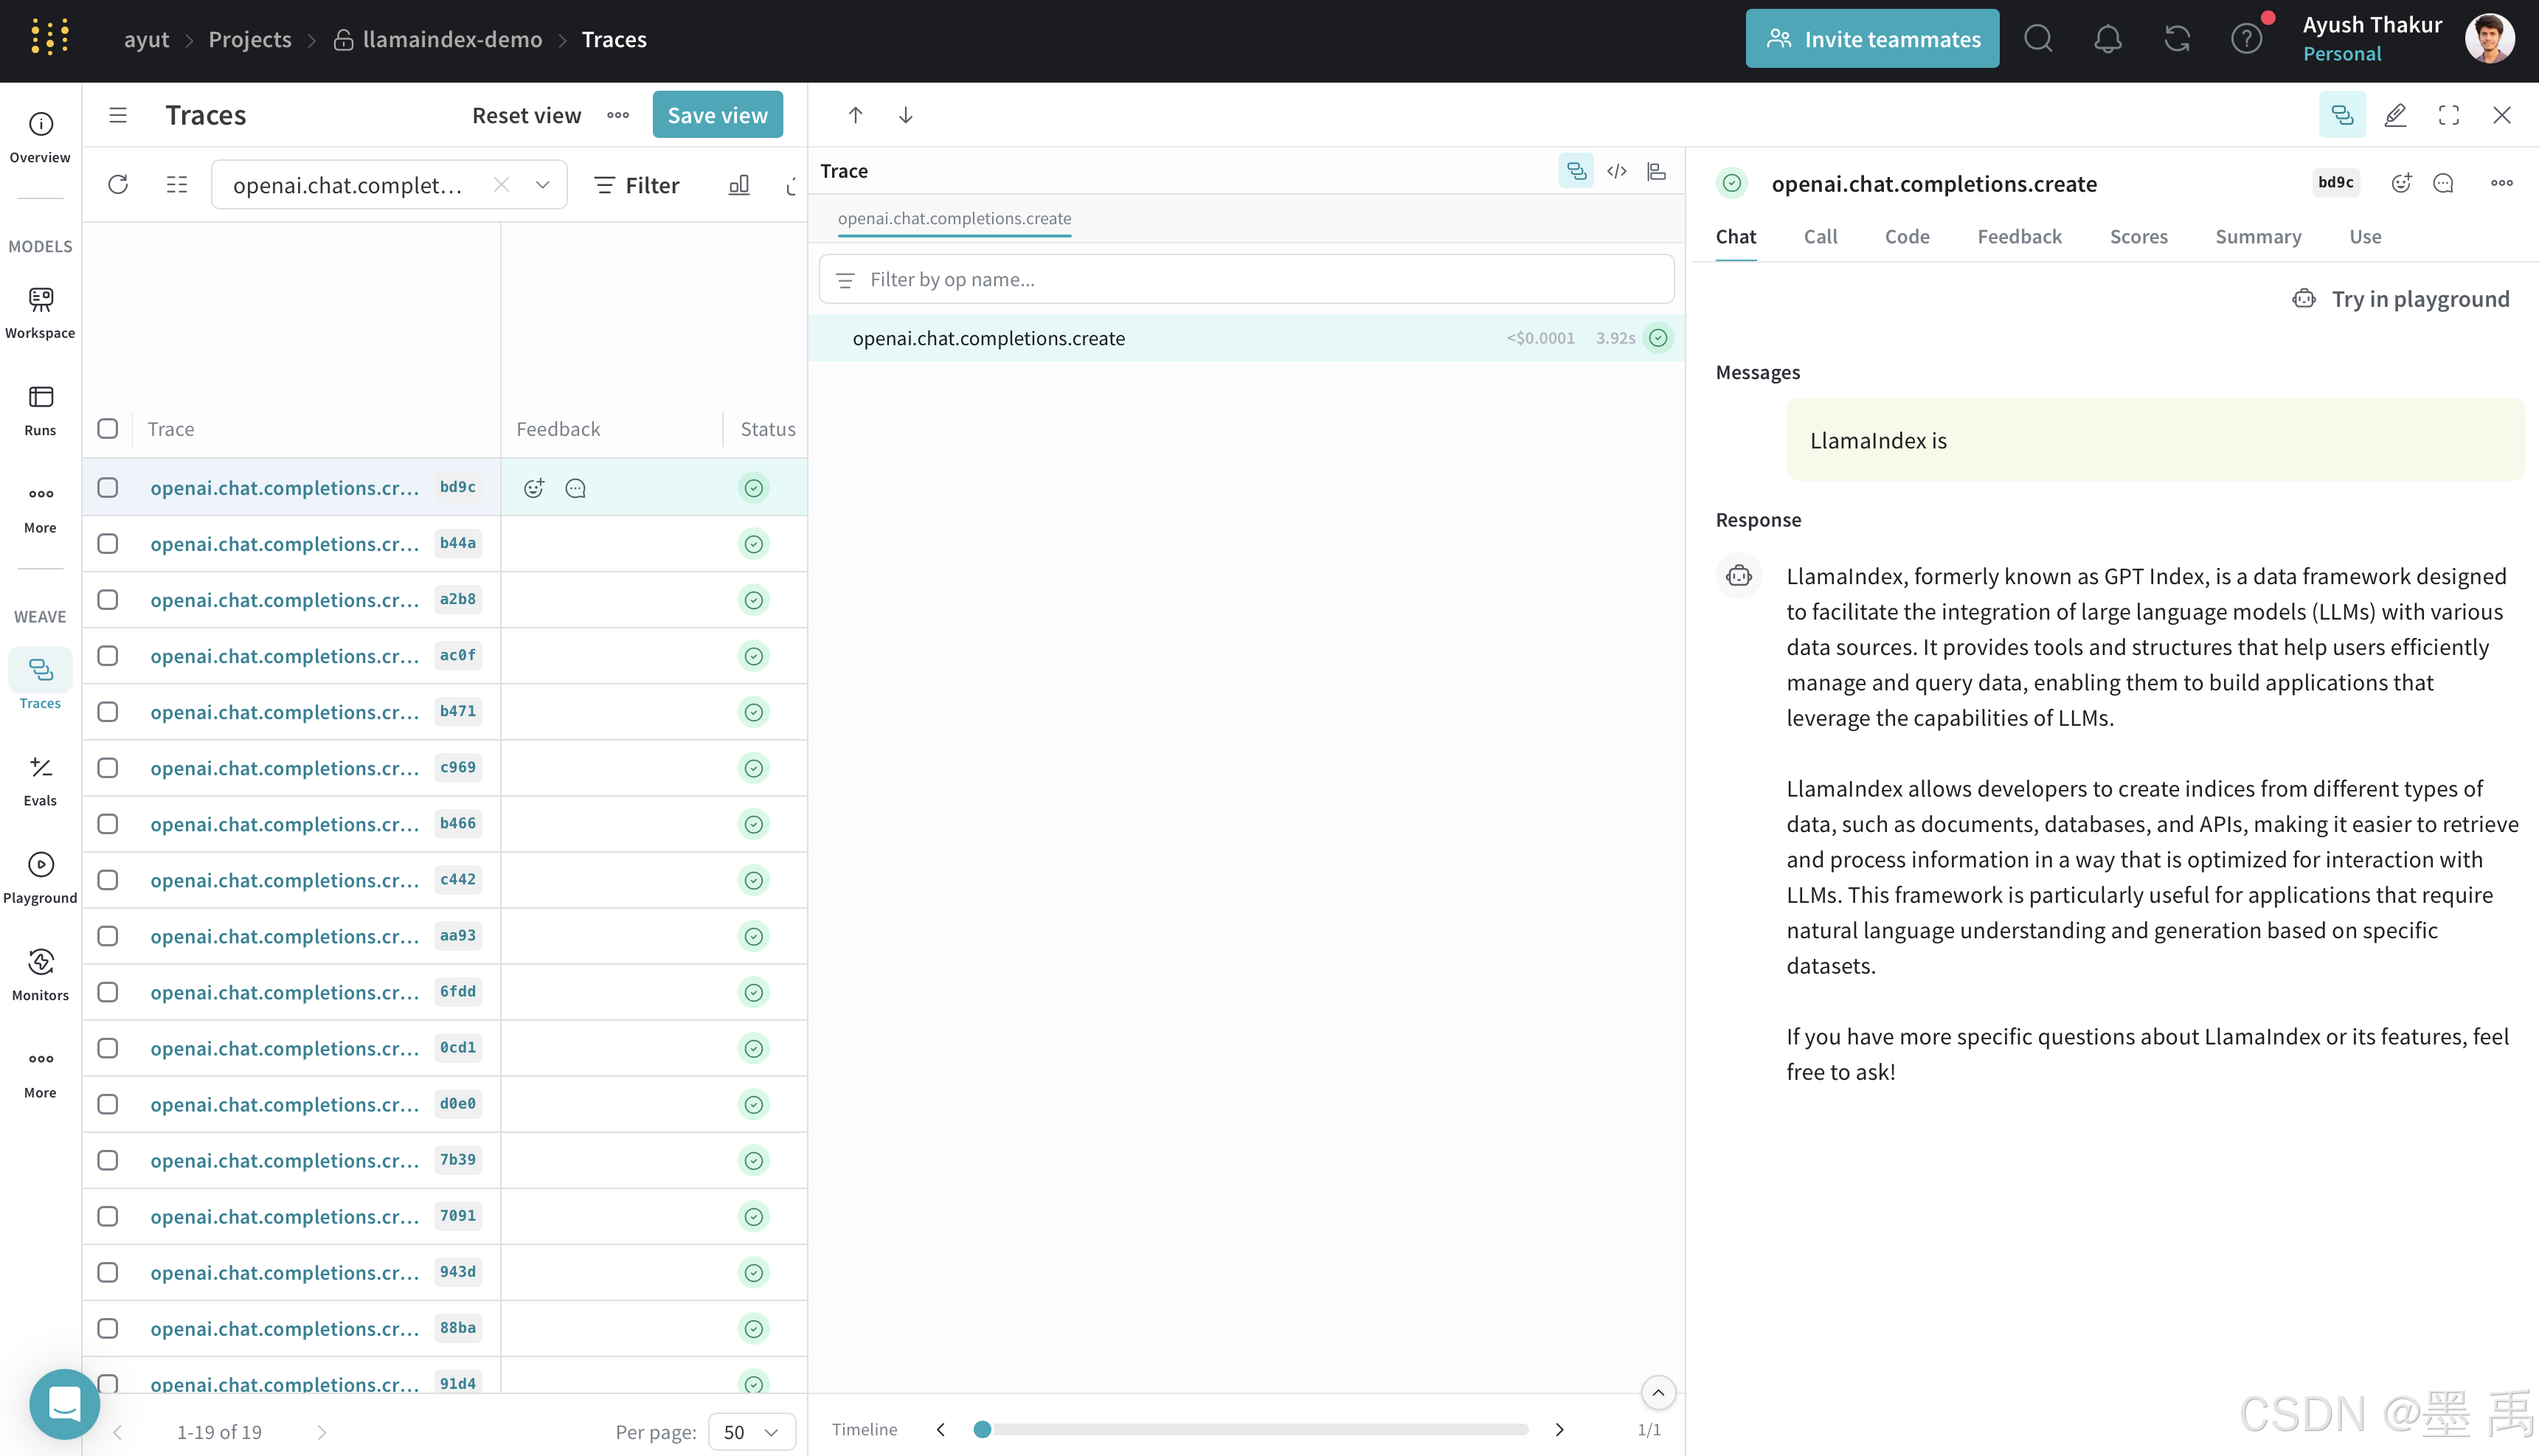
可通过 autopatch_settings 控制自动补丁行为:
weave.init(..., autopatch_settings={"openai": {"enabled": False}})
无需额外配置 LlamaIndex;调用 weave.init() 即开启追踪。
该集成几乎支持 LlamaIndex 全部组件:流式/异步、补全、对话、工具调用、Agent、工作流、RAG。参考官方 W&B Weave × LlamaIndex 文档。
2.2.5 MLflow
MLflow 是开源 MLOps/LLMOps 平台,聚焦机器学习项目完整生命周期,保障各阶段可管理、可追踪、可复现。MLflow Tracing 基于 OpenTelemetry,支持 LlamaIndex 应用一键插桩。
开源项目,无需注册账号、配置密钥,安装后直接编码。
import mlflow
mlflow.llama_index.autolog() # 开启 MLflow 追踪
支持能力表:AgentWorkflow 等新特性需要 MLflow >= 2.18.0
| ✅ | ✅ | ✅ | ✅ | ✅ (>=2.18) | ✅ (>=2.18) |
参考文档:MLflow LlamaIndex integration,支持实验跟踪、评估、依赖管理。
2.2.6 OpenLLMetry
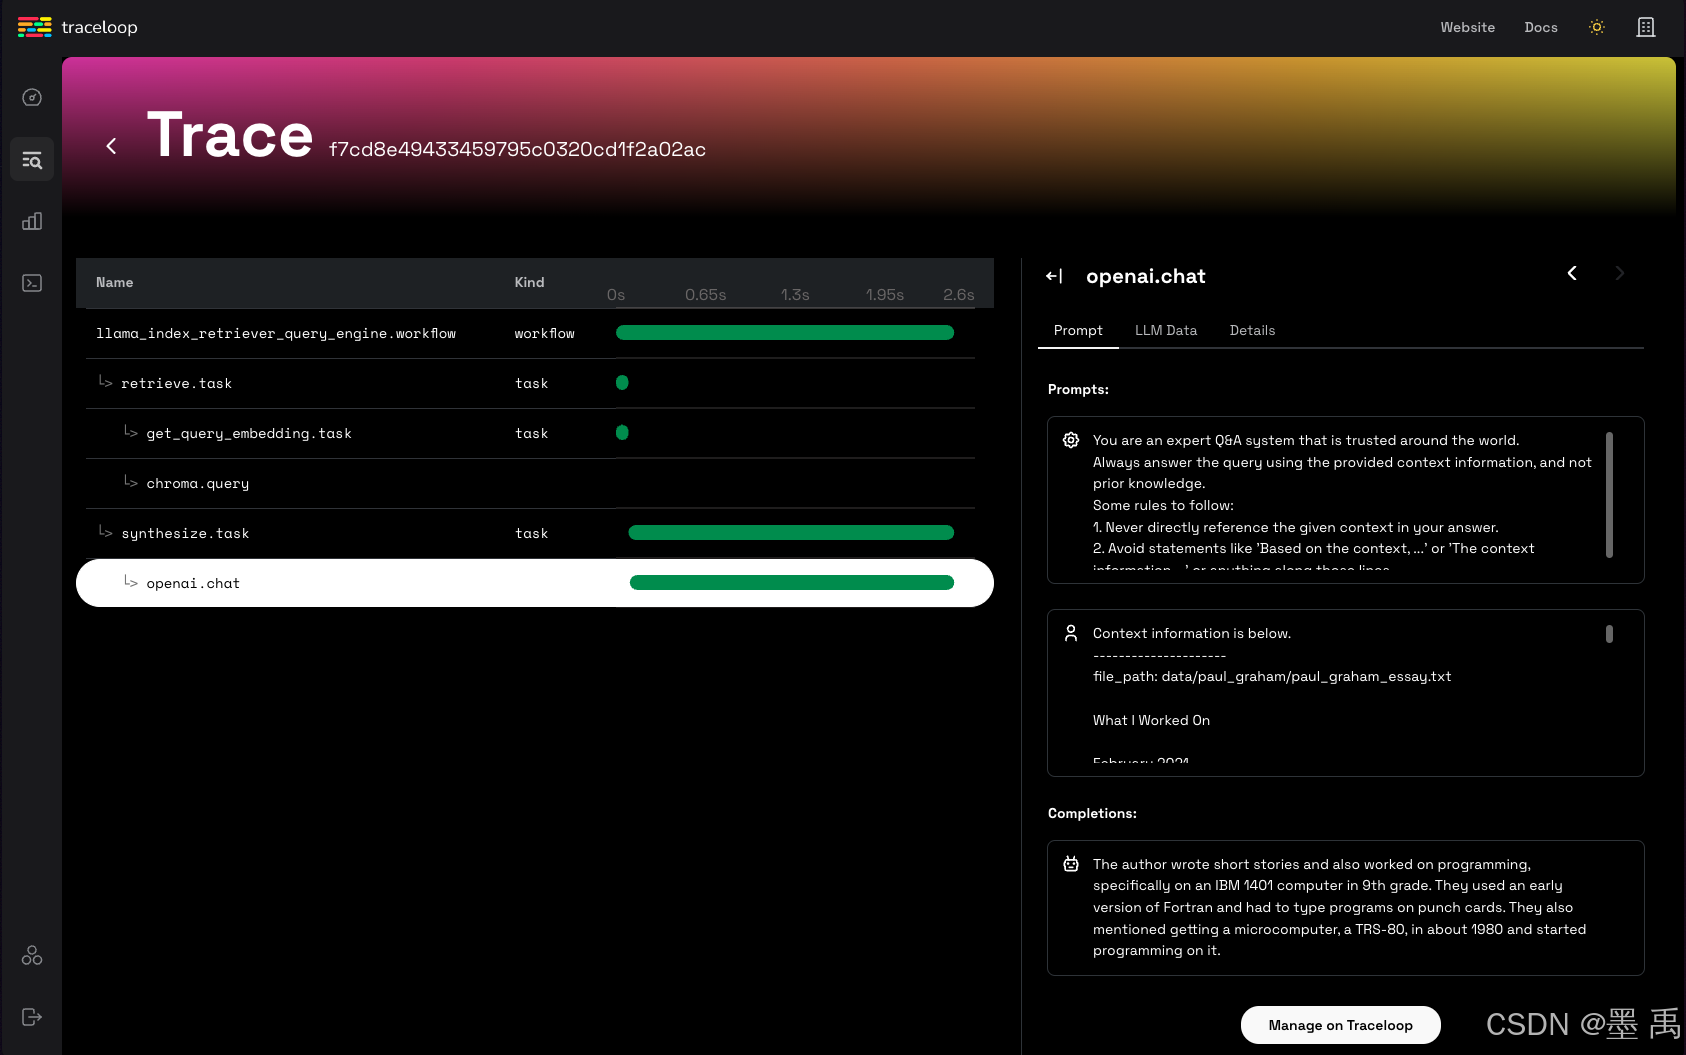
OpenLLMetry:基于 OpenTelemetry 的开源大模型应用追踪监控项目,对接主流可观测平台,数分钟完成安装部署。
from traceloop.sdk import Traceloop
Traceloop.init()
2.2.7 Arize Phoenix(本地部署)
可以直接使用开源版 Phoenix 本地实例,不需要 LlamaTrace 账号与 API Key,Phoenix 服务本地启动。
pip install -U llama-index-callbacks-arize-phoenix
import phoenix as px
# 控制台输出链接,浏览器打开 Web UI
px.launch_app()
# 页面初始为空,运行 LlamaIndex 业务后自动展示链路
import llama_index.core
llama_index.core.set_global_handler("arize_phoenix")
参考示例:
- Auto‑Retrieval Guide with Pinecone and Arize Phoenix
- Arize Phoenix Tracing Tutorial
2.2.8 Langfuse
Langfuse 开源大模型工程平台,帮助团队协作调试、分析、迭代大模型应用。LlamaIndex 集成可监控性能、链路、指标;完整记录上下文增强、大模型查询流程,可直接在 Langfuse UI 查看。
安装依赖:
pip install llama-index langfuse openinference-instrumentation-llama-index
配置环境变量:
import os
# 从 Langfuse 项目设置页获取密钥 https://cloud.langfuse.com
os.environ["LANGFUSE_PUBLIC_KEY"] = "pk-lf-…"
os.environ["LANGFUSE_SECRET_KEY"] = "sk-lf-…"
os.environ["LANGFUSE_HOST"] = "https://cloud.langfuse.com" # 欧洲区
# os.environ["LANGFUSE_HOST"] = "https://us.cloud.langfuse.com" # 美国区
初始化客户端并校验连通性:
from langfuse import get_client
langfuse = get_client()
if langfuse.auth_check():
print("Langfuse client is authenticated and ready!")
else:
print("Authentication failed. Please check your credentials and host.")
开启 OpenInference LlamaIndex 插桩,自动采集事件导出 OTel Span:
from openinference.instrumentation.llama_index import LlamaIndexInstrumentor
LlamaIndexInstrumentor().instrument()
即可在 Langfuse 查看 LlamaIndex 链路:
- LlamaIndex example trace
- Example trace link in Langfuse
参考文档:
- Langfuse Documentation
- Tracing LlamaIndex Agents
2.2.9 Literal AI
Literal AI 是大模型评估 & 可观测解决方案,帮助产研团队稳定、快速、规模化交付大模型应用。支持对话会话、Agent 运行记录自动落日志。
使用方式:
pip install literalai
云平台注册账号,在设置页面获取 API Key;私有化部署需要记录服务地址。
from llama_index.core import set_global_handler
# 通过环境变量 LITERAL_API_KEY、LITERAL_API_URL 配置凭证
set_global_handler("literalai")
参考文档:
- Literal AI integration with Llama Index
- Build a Q&A application with LLamaIndex and monitor it with Literal AI
2.2.10 Comet Opik
Opik 是 Comet 推出的开源端到端大模型评估平台。
注册 Comet 获取 API Key;私有化部署记录服务地址。
pip install opik
设置环境变量:
export OPIK_API_KEY="<OPIK_API_KEY>"
export OPIK_WORKSPACE="<OPIK_WORKSPACE>"
# export OPIK_URL_OVERRIDE="<OPIK_URL_OVERRIDE>" # 私有化可选
业务代码:
from llama_index.core import Document, VectorStoreIndex, set_global_handler
# 读取环境变量 OPIK_API_KEY, OPIK_WORKSPACE
set_global_handler("opik")
# 需要配置 OPENAI_API_KEY
index = VectorStoreIndex.from_documents([Document.example()])
query_engine = index.as_query_engine()
questions = [
"Tell me about LLMs",
"How do you fine‑tune a neural network ?",
"What is RAG ?",
]
for question in questions:
print(f"> \\033[92m{question}\\033[0m")
response = query_engine.query(question)
print(response)
运行后 Opik 后台可查看链路。
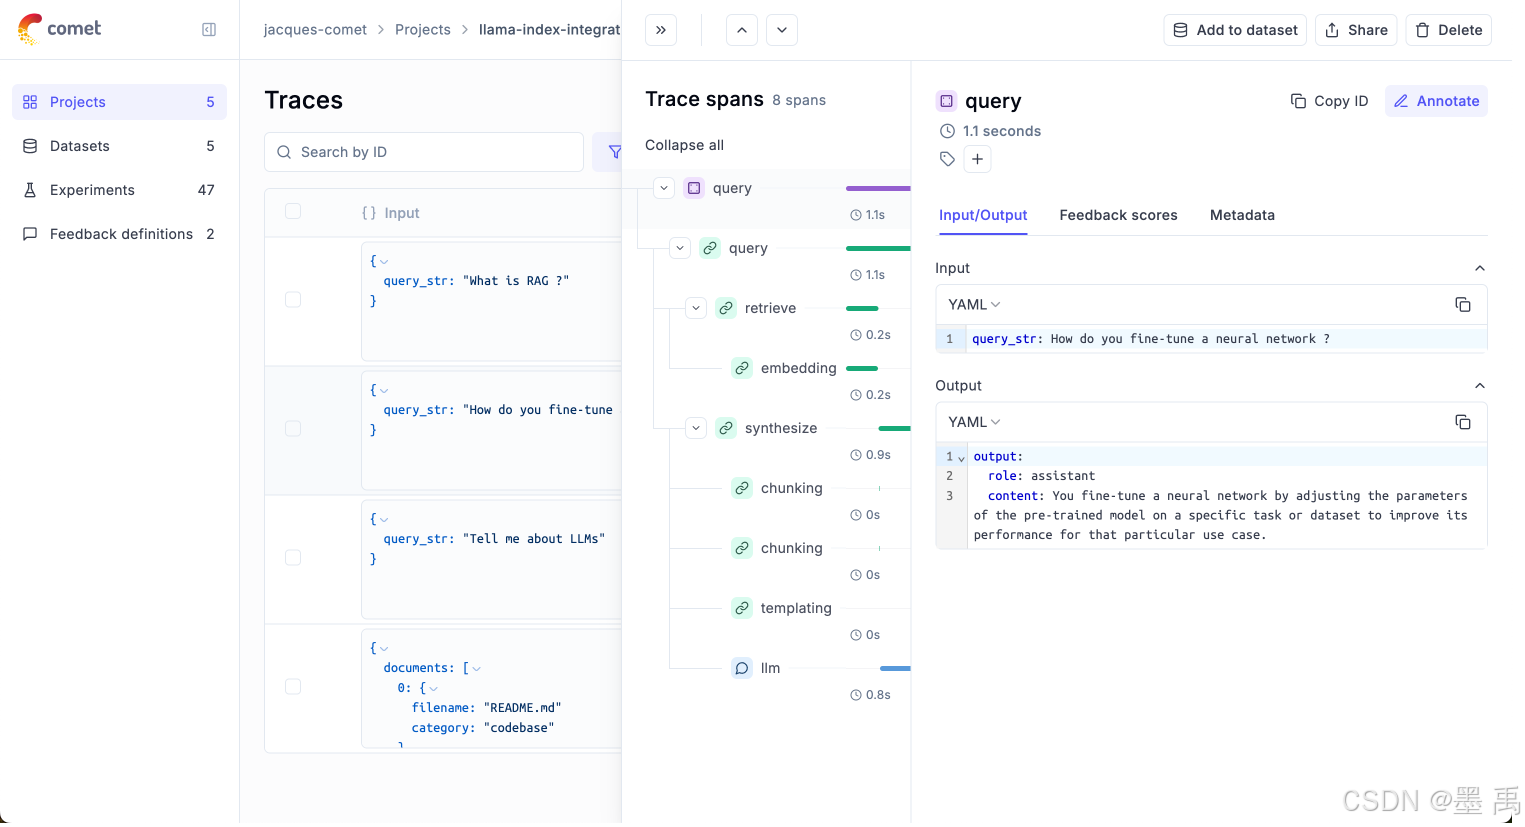
参考文档:
- Llama‑index + Opik documentation page
- Llama‑index integration cookbook
2.2.11 Argilla
Argilla 面向 AI 工程师与领域专家的协作工具,用于构建高质量数据集。
需要先部署 Argilla Server。
pip install argilla-llama-index
from llama_index.core.instrumentation import get_dispatcher
from argilla_llama_index import ArgillaHandler
argilla_handler = ArgillaHandler(
dataset_name="query_llama_index",
api_url="http://localhost:6900",
api_key="argilla.apikey",
number_of_retrievals=2,
)
root_dispatcher = get_dispatcher()
root_dispatcher.add_span_handler(argilla_handler)
root_dispatcher.add_event_handler(argilla_handler)
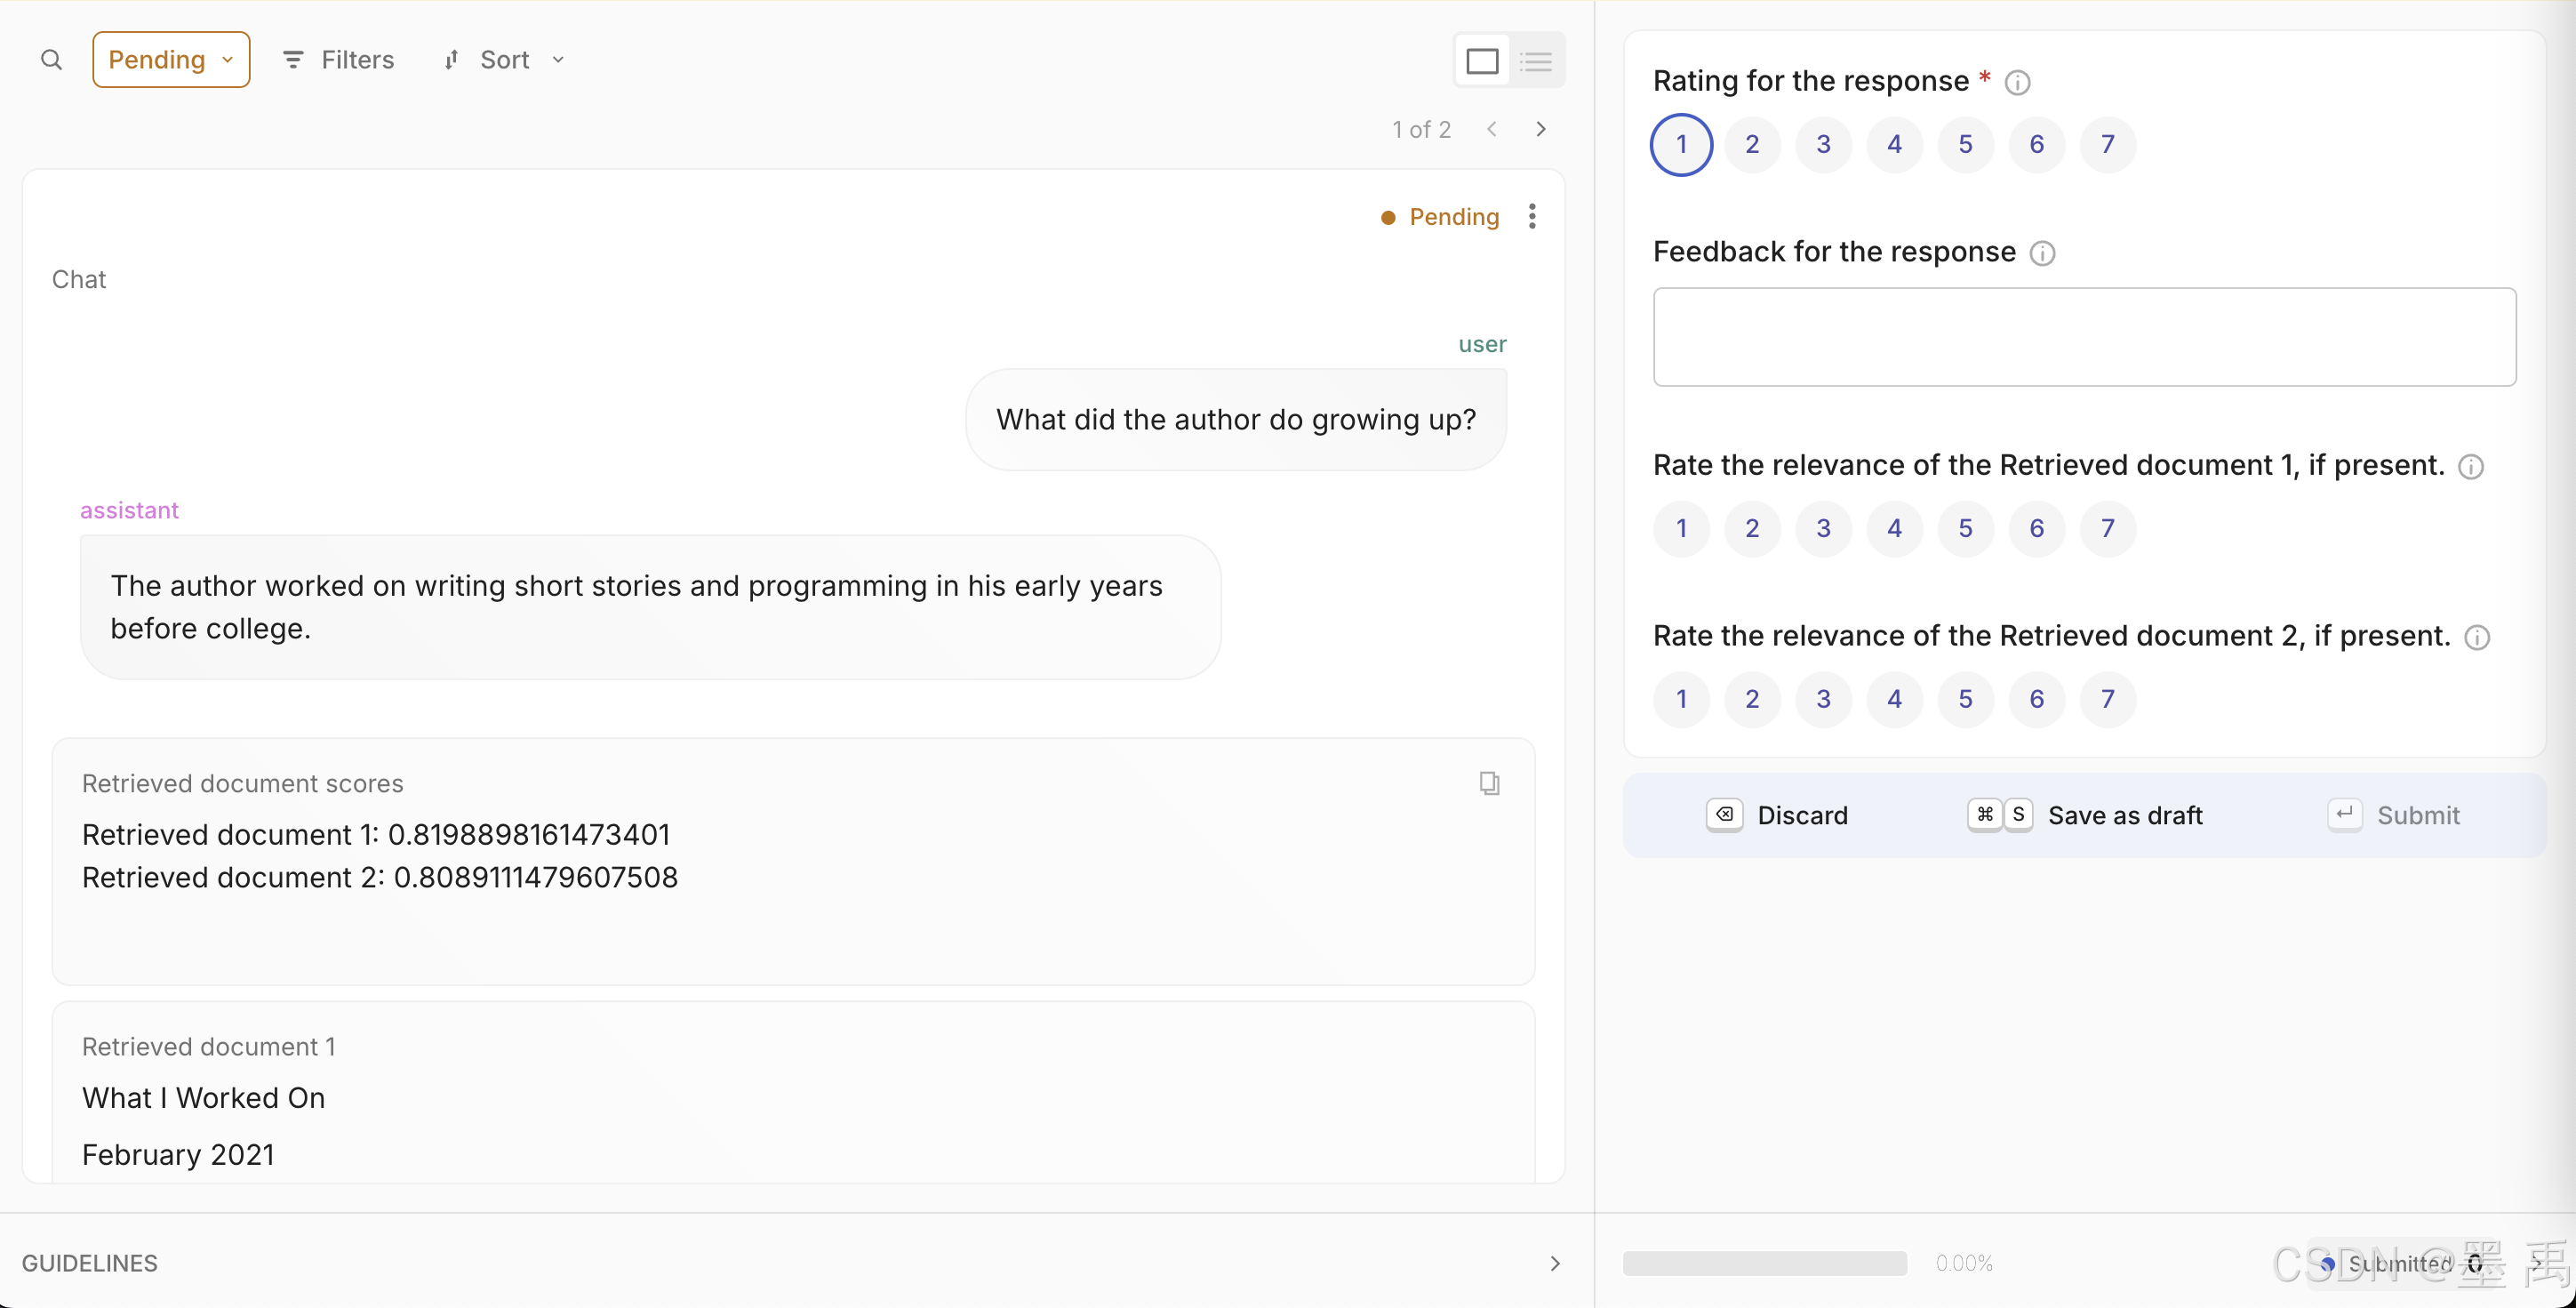
参考文档:
- Getting started with Argilla’s LlamaIndex Integration
- Other example tutorials
2.2.12 Agenta
Agenta 开源 LLMOps 平台,用于构建健壮大模型 AI 应用,提供可观测、Prompt 管理、大模型评估全套工具。
pip install agenta llama-index openinference-instrumentation-llama-index
import os
import agenta as ag
from openinference.instrumentation.llama_index import LlamaIndexInstrumentor
from llama_index.core import SimpleDirectoryReader, VectorStoreIndex
os.environ["AGENTA_API_KEY"] = "your_agenta_api_key"
os.environ["AGENTA_HOST"] = "https://cloud.agenta.ai" # 私有化替换地址
ag.init()
LlamaIndexInstrumentor().instrument()
@ag.instrument()
def document_search_app(user_query: str):
"""文档检索应用"""
docs = SimpleDirectoryReader("data").load_data()
search_index = VectorStoreIndex.from_documents(docs)
query_processor = search_index.as_query_engine()
answer = query_processor.query(user_query)
return answer
运行后,链路自动采集到 Agenta,用于调试、关联配置与 Prompt、评估性能、查询数据、监控指标。 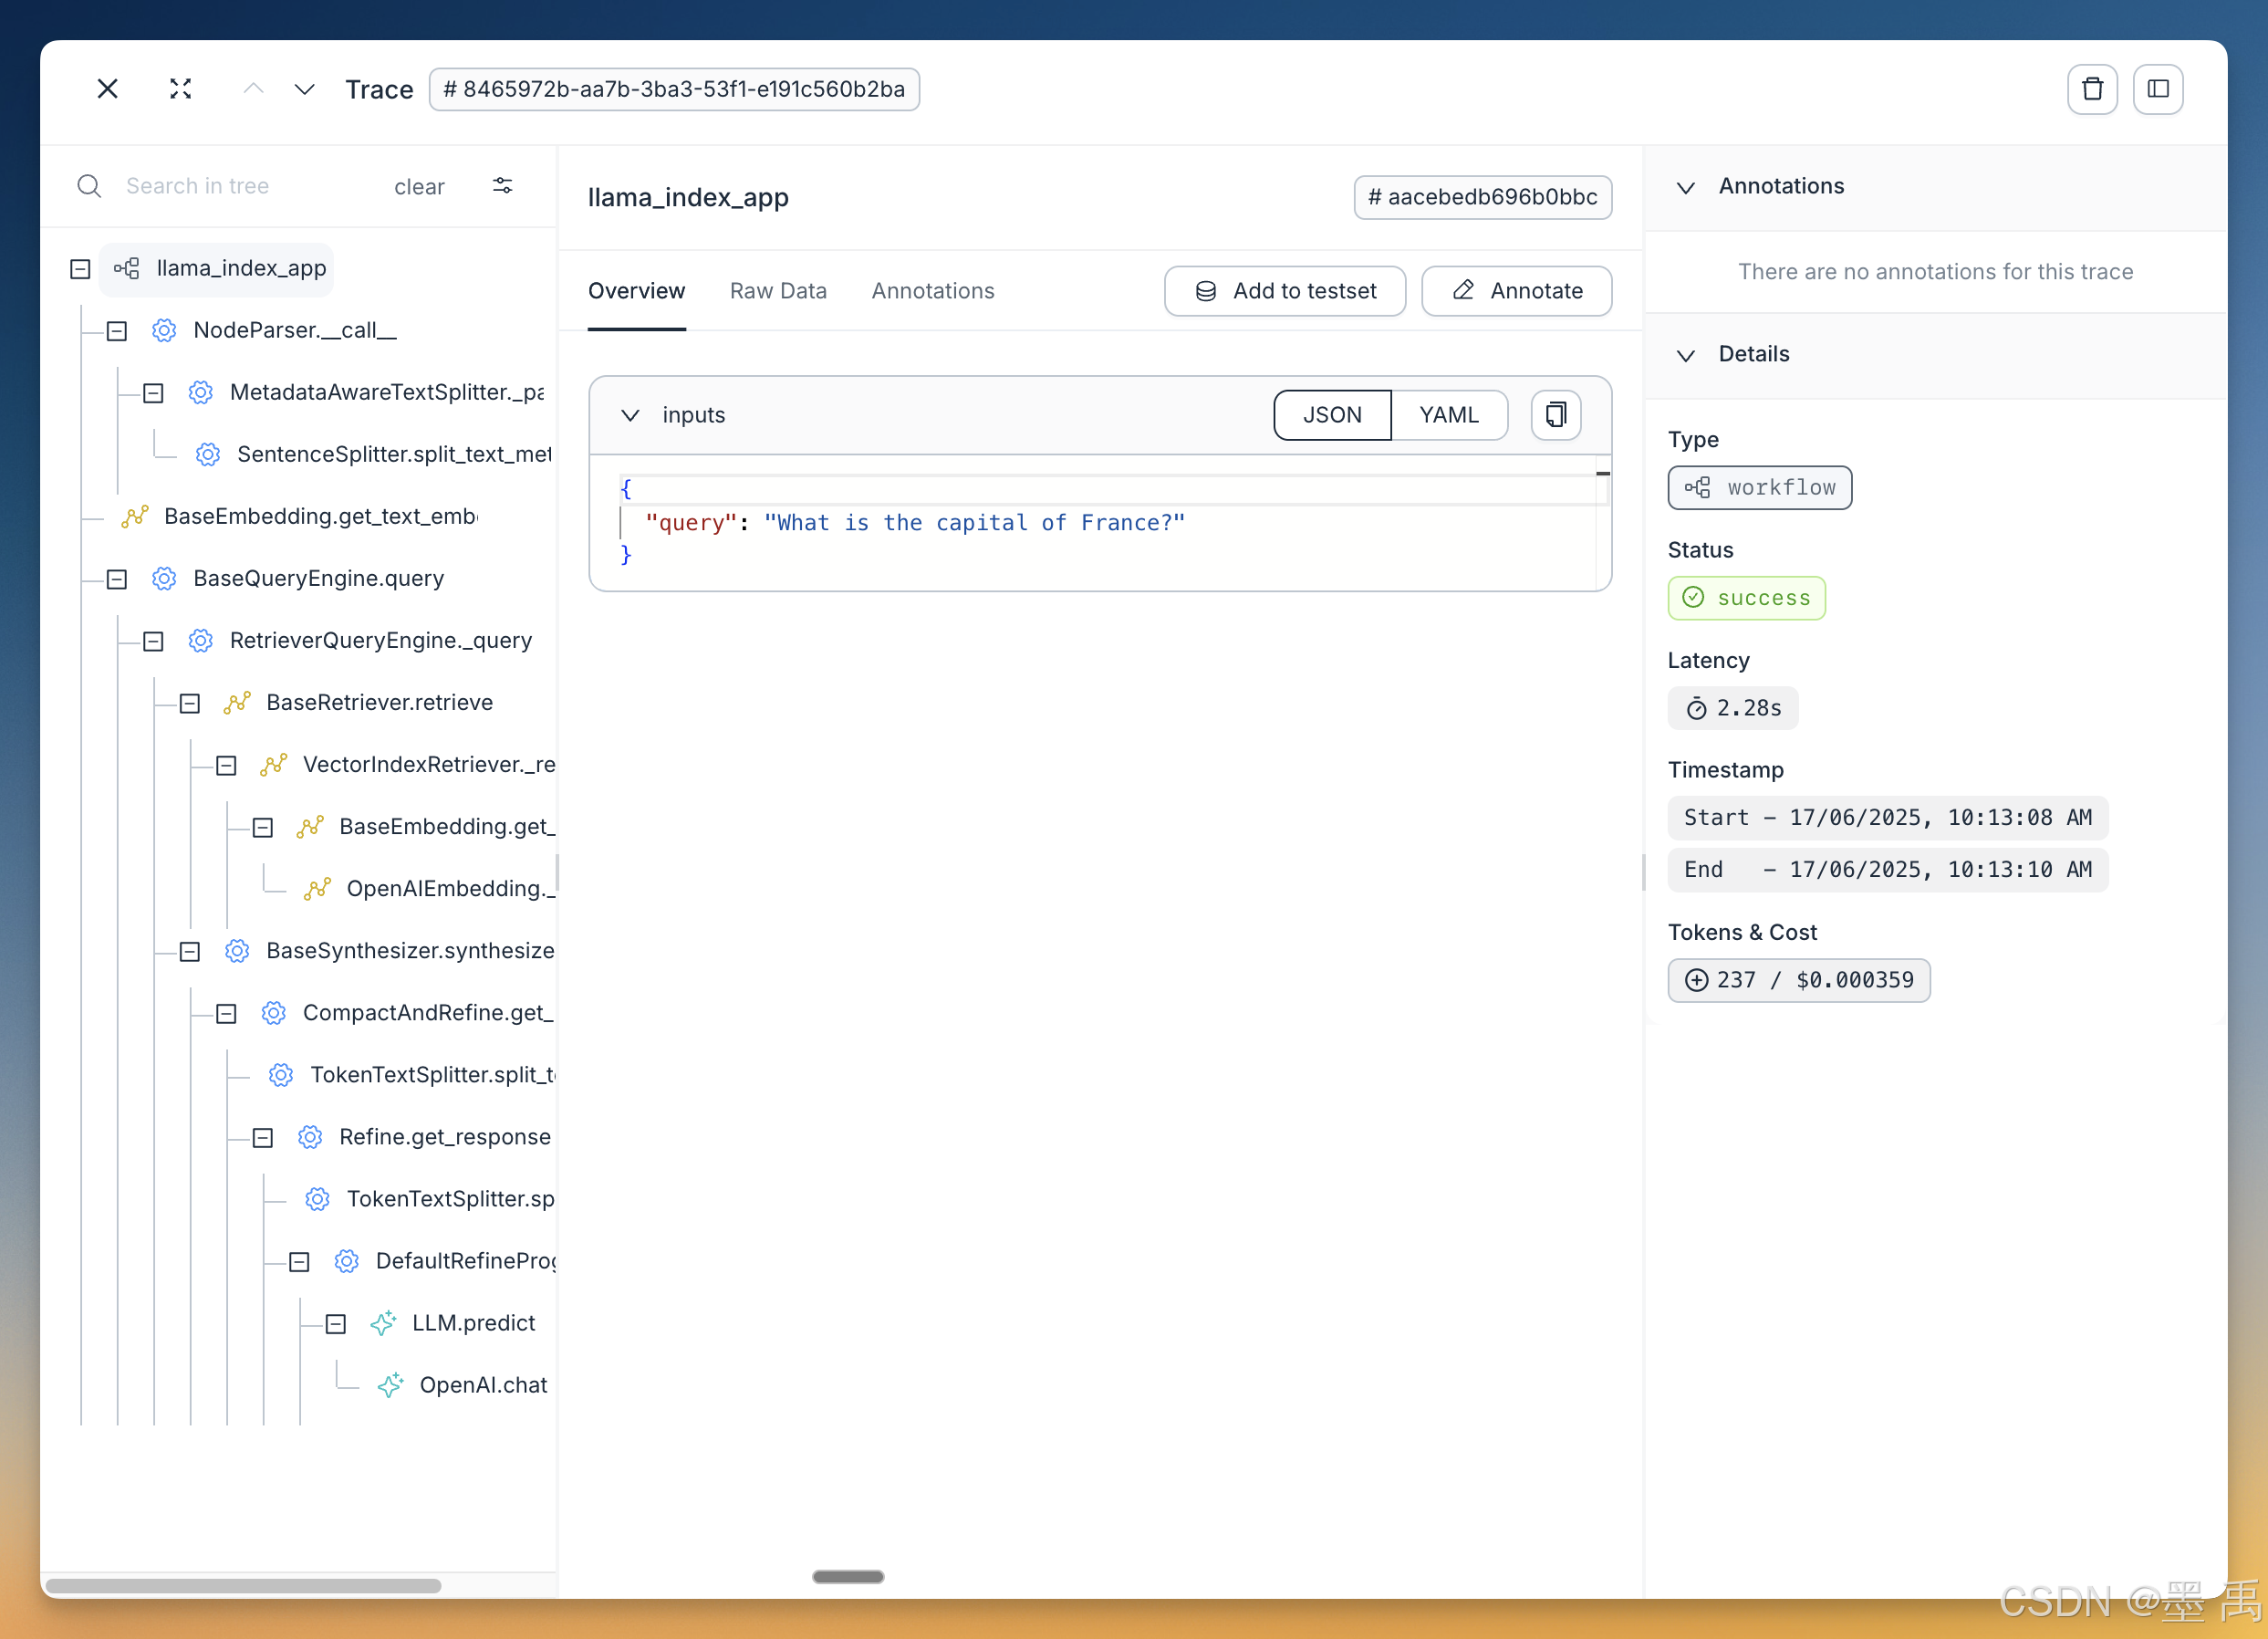 参考文档:
- Documentation Observability for LlamaIndex with Agenta
- Notebook Observability for LlamaIndex with Agenta
2.2.13 Deepeval
DeepEval(Confident AI)开源大模型评估框架,内置 14+ 评估指标(摘要、幻觉、回答相关性、忠实度、RAGAS 等)。可以结合 LlamaIndex 追踪调试失败用例;也可以对接 Confident AI 托管平台做线上无参考评估。
pip install -U deepeval llama-index
import deepeval
from deepeval.integrations.llama_index import instrument_llama_index
import llama_index.core.instrumentation as instrument
deepeval.login("<your-confident-api-key>")
instrument_llama_index(instrument.get_dispatcher())
2.2.14 Confident AI
Confident AI 是一款大模型可观测与评估平台。其原生支持 OpenTelemetry 的追踪 SDK confident-trace,可以订阅 LlamaIndex 的插桩调度器(instrumentation dispatcher),因此每一次 Agent 执行、工作流步骤、检索动作与工具调用,都会以完整层级结构展示在观测面板(Observatory)中。
使用方式:
pip install confident-trace llama-index-core llama-index-llms-openai
前往 Confident AI 获取项目 API Key,并和模型服务商密钥一起配置环境变量。 欧盟区域用户需要额外设置:
- CONFIDENT_OTEL_ENDPOINT="https://eu.otel.confident-ai.com/v1/traces";
- 不配置则链路数据默认上报至美国服务节点。
export CONFIDENT_API_KEY="<your-confident-api-key>"
export OPENAI_API_KEY="<your-openai-key>"
在程序启动阶段、定义/运行 Agent 之前,调用一次 init()。Agent 照常使用 agent.run(),无需额外配置回调与调度器:
import asyncio
from confident_trace import init, shutdown
from llama_index.core.agent.workflow import FunctionAgent
from llama_index.core.tools import FunctionTool
from llama_index.llms.openai import OpenAI
def multiply(a: float, b: float) –> float:
"""用于两个数字相乘"""
return a * b
async def main():
init()
try:
agent = FunctionAgent(
name="assistant",
llm=OpenAI(model="gpt-4o-mini"),
tools=[FunctionTool.from_defaults(multiply)],
system_prompt="你是一名可以执行计算的助手。",
)
print(await agent.run("3 乘以 12 等于多少?"))
finally:
shutdown()
if __name__ == "__main__":
asyncio.run(main())
Agent 执行记录、工作流步骤、检索、工具调用以及带 Token 消耗统计的模型调用都会被自动采集。
说明:模型 Span 依赖受支持的服务商 SDK;自定义封装、本地大模型只能采集到 Agent 结构,不会生成 LLM 内部 Span;向量 Embedding 调用目前不会被追踪。 如果是长时间运行的服务,只在服务启动时调用一次 init(),优雅关闭时调用 shutdown(),不要每个请求都重复调用。
你可以在 Confident AI 的工作流页面配置上报进来的链路数据处理规则:
- 评估规则:使用指标集对流入的 Trace 自动执行评估
- 分类器:按照问题类型、情感倾向或者自定义维度给 Trace 打标签,方便后续分组、筛选
- 队列接入:将生产链路送入标注队列,供内部评审团队人工复核
- 数据集接入:把线上真实 Trace 归集到数据集,复用为回归测试用例
Trace、Span、对话线程都可以单独配置工作流。如果想在代码里单独为某一条 Trace 指定评估指标集,可以调用 update_trace 方法。
参考教程:
- LlamaIndex 集成教程:完整部署、链路属性、多轮执行归集为对话线程
- Confident AI 大模型链路追踪
- 在线评估
2.2.15 Maxim AI
Maxim AI 是 Agent 仿真、评估、可观测平台,为 RAG、Agent 等大模型工作流提供完整追踪监控评估。
pip install maxim-py
import os
from dotenv import load_dotenv
from maxim import Config, Maxim
from maxim.logger import LoggerConfig
from maxim.logger.llamaindex import instrument_llamaindex
load_dotenv()
MAXIM_API_KEY = os.getenv("MAXIM_API_KEY")
MAXIM_LOG_REPO_ID = os.getenv("MAXIM_LOG_REPO_ID")
maxim = Maxim(Config(api_key=MAXIM_API_KEY))
logger = maxim.logger(LoggerConfig(id=MAXIM_LOG_REPO_ID))
instrument_llamaindex(logger, debug=True)
print("✅ Maxim instrumentation enabled for LlamaIndex")
示例 Agent 业务代码:
from llama_index.core.agent import FunctionAgent
from llama_index.core.tools import FunctionTool
from llama_index.llms.openai import OpenAI
def add_numbers(a: float, b: float) –> float:
"""两数相加"""
return a + b
add_tool = FunctionTool.from_defaults(fn=add_numbers)
llm = OpenAI(model="gpt-4o-mini", temperature=0)
agent = FunctionAgent(
tools=[add_tool],
llm=llm,
verbose=True,
system_prompt="You are a helpful calculator assistant.",
)
import asyncio
response = await agent.run("What is 15 + 25?")
print(f"Response: {response}")
3. Callbacks(回调机制)
LlamaIndex 提供回调机制,用于库内部逻辑调试、统计、追踪。CallbackManager 可以挂载任意多个回调处理器。
除记录事件数据,还可以统计每个事件耗时、触发次数;同时记录事件链路图,回调处理器可以自由消费这些数据。例如 LlamaDebugHandler 默认会在每次操作结束打印完整事件链路。
3.1 回调事件类型
- CHUNKING:文本分片前后日志
- NODE_PARSING:文档解析为节点的日志
- EMBEDDING:文本嵌入数量日志
- LLM:大模型调用模板与返回日志
- QUERY:查询开始、结束
- RETRIEVE:查询命中的检索节点日志
- SYNTHESIZE:结果合成调用日志
- TREE:摘要树生成日志
- SUB_QUESTION:子问题生成与应答日志
你可以自定义回调处理器消费事件,也可以使用内置实现。
3.2 内置回调模块
- TokenCountingHandler:灵活统计 Prompt、补全、嵌入 Token 用量
- LlamaDebugHanlder:基础事件追踪打印
- WandbCallbackHandler:对接 W&B 做事件链路跟踪
- AimCallback:记录大模型输入输出
- OpenInferenceCallbackHandler:AI 推理记录
- OpenAIFineTuningHandler:保存全部 LLM 输入输出,导出 OpenAI 微调数据集
3.3 TokenCounting 迁移指南
旧版 Token 统计逻辑已废弃。
旧方案:Token 统计直接写死在 llm_predictor、embed_model 对象,静态 gpt‑2 tokenizer,计数不准。 新方案:迁移为回调 TokenCountingHandler,支持自定义分词器、生命周期控制、多索引独立计数器。
示例代码:
import tiktoken
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.core.callbacks import CallbackManager, TokenCountingHandler
from llama_index.core import Settings
token_counter = TokenCountingHandler(
tokenizer=tiktoken.encoding_for_model("gpt-3.5-turbo").encode,
verbose=False,
)
Settings.callback_manager = CallbackManager([token_counter])
document = SimpleDirectoryReader("./data").load_data()
index = VectorStoreIndex.from_documents(documents)
print(token_counter.total_embedding_token_count)
token_counter.reset_counts()
response = index.as_query_engine().query("What did the author do growing up?")
print(
"Embedding Tokens: ", token_counter.total_embedding_token_count, "\\n",
"LLM Prompt Tokens: ", token_counter.prompt_llm_token_count, "\\n",
"LLM Completion Tokens: ", token_counter.completion_llm_token_count, "\\n",
"Total LLM Token Count: ", token_counter.total_llm_token_count,
)
4. Instrumentation(插桩模块)
instrumentation 模块(v0.10.20+)旨在替代旧版 Callbacks。过渡期两者同时可用;未来全部集成迁移完成后,旧 callbacks 模块将会移除。
新插桩模块用于 LlamaIndex 应用埋点观测:可以自定义逻辑处理事件、跟踪 Span;也允许用户自定义事件,在代码指定位置触发。
参考资源:
- Notebook Guides:Basic Usage、Observing Model Calls、Observing All Events
- API Reference:Instrumentation API Reference
4.1 核心类说明
- Event:代表代码执行过程中某一个时间点发生的事件。
- EventHandler:监听 Event,事件触发时执行业务逻辑。
- Span:代表一段代码的执行生命周期,内部包含多个 Event。
- SpanHandler:负责 Span 的进入、退出、异常中断。
- Dispatcher:分发 Event,发送 Span 进入/退出/中断信号给对应 Handler。
4.2 使用插桩做可观测性
核心用途就是可观测,对接第三方可以拿到完整调用栈详细链路。
使用三步:
即可捕获 LlamaIndex 库及扩展包产生的全部事件与 Span。
4.2.1 自定义 EventHandler
from llama_index.core.instrumentation.event_handlers.base import BaseEventHandler
from llama_index.core.instrumentation.events.llm import (
LLMChatEndEvent, LLMChatStartEvent, LLMChatInProgressEvent,
)
class ExampleEventHandler(BaseEventHandler):
events = []
@classmethod
def class_name(cls):
return "ExampleEventHandler"
def handle(self, event):
print("———————–")
print(event.id_)
print(event.timestamp)
print(event.span_id)
if isinstance(event, LLMChatStartEvent):
print(event.messages)
elif isinstance(event, LLMChatInProgressEvent):
print(event.response.delta)
elif isinstance(event, LLMChatEndEvent):
print(event.response)
self.events.append(event)
print("———————–")
# 挂载
import llama_index.core.instrumentation as instrument
dispatcher = instrument.get_dispatcher(__name__)
dispatcher.add_event_handler(ExampleEventHandler())
4.2.3 自定义 Event
继承 BaseEvent,基于 pydantic 定义字段,dispatcher 触发事件。
from llama_index.core.instrumentation.event.base import BaseEvent
from pydantic import Field
class MyEvent(BaseEvent):
new_field_1 = Field(...)
new_field_2 = Field(...)
import llama_index.core.instrumentation as instrument
dispatcher = instrument.get_dispatcher(__name__)
dispatcher.event(MyEvent(new_field_1=..., new_field_2=...))
4.2.3 自定义 Span & SpanHandler
Span 代表一段耗时执行过程。自定义 Span 需要配套实现 BaseSpanHandler,实现 new_span()、prepare_to_exit_span()、prepare_to_drop_span() 三个抽象方法,注册到 dispatcher。
4.2.4 Span 进入/退出
import llama_index.core.instrumentation as instrument
dispatcher = instrument.get_dispatcher(__name__)
def func():
dispatcher.span_enter(...)
try:
val = ...
except:
dispatcher.span_drop(...)
else:
dispatcher.span_exit(...)
return val
# 装饰器语法糖
@dispatcher.span
def func():
...
4.2.4 Dispatcher 层级机制
Dispatcher 具备层级关系,类似 Python logging。根 Dispatcher 的 Handler 接收全部子模块事件;子模块 Dispatcher 的 Handler 只捕获本模块事件。




评论前必须登录!
注册