 网硕互联帮助中心
技能越来越多,谁说了算它靠谱,上线前的三道验收
手里的技能攒到十几个,每个都能在演示里跑通。可到了要不要给别人用的关口,问题就来了。它到底靠不靠谱,好在哪,差在哪,边界在哪。
说不清的原因大多在于从来没定义过什么叫合格,技能本身倒未必差。演示看的是最好的一次,验收要看的是平均水平和最差的那次。
有一套开源技能的做法值得学。它把界面复核这件事拆成几个独立域,每个域配一份规则文档,输出强制走一个固定格式。这套设计让评审结果从主观印象变成可核验的清单。
三道验收分别看什么
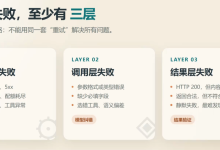
技能的质量要分三层看,混在一起测就会得到含糊的结论。
第一层是触发。该用的时候用上了吗,不该用的时候忍住了吗。
第二层是执行。真用起来,多步任务能走到最后吗,中间会不会跑偏。
第三层是输出。结果是不是结构化的,能不能定位到具体位置,有没有明确说出自己不确定的部分。
三层各有各的测法,也各有各的通过线。
触发要看负样本
只测正样本是自欺欺人。准备十个该触发的问题,全都触发成功,看着是一百分,其实什么都没证明。
负样本才是体验的分水岭。那些看起来相似但不该触发的问题,技能有没有忍住。比如一个专门处理退款流程的技能,用户问退货运费怎么算,它该不该接。这种边界情况才是用户投诉的来源。
负样本的准备方法是从正样本做改造。同一个话题换一个意图,或者同一句话换个说法去掉关键信息。
测的时候记录三件事,该触发的有没有触发,不该触发的有没有乱触发,以及分不清的时候它是不是先问了一句。
第三条最容易被忽略。模型在边界上主动澄清,比直接猜一个答案好得多。这条要算正面表现,别当成没完成任务。
执行要跑多次
多步任务的单次成功没有意义。同样的输入跑十次,成功八次和成功两次是完全不同的东西。
要记的除了成功率,还有步数和波动。同样的任务,有的跑五次就完成,有的跑十二次,说明后者在绕路。步数的方差比平均值更能暴露问题。
还要看失败的样子。失败是明确说做不到,还是编一个结果交上来。后者更危险,因为它看起来是成功的。
测执行的时候要把工具调用记录下来,看它调了哪些工具,参数对不对,有没有重复调用同一个工具。这些细节决定了失败之后能不能修。
输出要能核验
这是那套界面复核技能最值得借鉴的地方。
它强制评审报告必须包含三样东西,精确的检查范围,每条问题的位置和依据,以及结论对应的核验项。缺一样,报告就是不合格的。
这个思路可以搬到任何技能上。一个数据查询技能的输出,必须包含数据来源、查询条件、时间范围。一个代码审查技能的输出,必须包含文件名、行号、问题类型。一个文档摘要技能的输出,必须包含原文页码。
有了这三样,输出就能被程序检查,也能被人复核。没有这三样,你只能凭感觉判断它答得好不好。
把大技能拆成域
还有一个值得抄的设计是分域。
界面复核被拆成无障碍、色彩、布局、文案几个独立域,每个域有自己的规则文档,由一个总入口调度。好处是每个域可以单独评测、单独改进、单独替换。
一个巨型技能的问题在于,它失败了你说不清是哪一步不对。拆成域之后,无障碍那个域通过率低,你就能对症去改那部分规则。
拆分的原则是域与域之间不共享规则。如果两个域的规则大量重叠,说明拆得不对,合回去更好。
边界要写在明处
那套技能有一份边界说明,明确写出它不做什么,能力上限在哪,哪些场景下结论不可靠。这份东西的价值不低于技能本身。
原因很实际。用户知道边界,就知道什么时候该自己复核。不知道边界的用户,会把所有输出都当成可靠结论,出事之后才来问为什么。
所以技能交付物里应该有一节,写清楚它擅长什么、不擅长什么、哪些输入会导致不可靠的输出。这一节要在验收时一起检查,别当成可选项。
通过线怎么定
不要追求一百分,那不可能。定三条能守住就行。
触发层,负样本误触率低于一个明确的百分比,边界样本能主动澄清。
执行层,十次里成功次数达到一个明确下限,且失败时要明确报错而不是编造。
输出层,结构化字段完整率接近百分之百,可定位信息缺失率低于一个明确数值。
三个数字定下来之后,每次改动都跑一遍,和上一版比。改进了才算升级,退步了就别上。这套纪律和评测那篇讲的是同一个东西,只是对象从模型变成了技能。
结合系列
评测那篇讲的是给模型输出定标准,这篇讲的是给技能这个更大的单元定标准。技能上架那篇讲的是格式校验,这一篇讲的是能力校验,前者过不了门,后者过了门才敢用。工具设计篇讲的是描述要写清用途和限制,边界声明就是那个限制的具体化。可观测性篇的 trace 在技能验收里同样有用,它能告诉你失败发生在第几步。参数校验篇的提议与裁决,在这里变成模型给结论、程序核验结论。



评论前必须登录!
注册