 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
103.6k 星 claude-mem 跨会话记忆拆解
关键词:claude-mem、Agent 记忆、跨会话上下文、Claude Code、上下文压缩
目录
- 一、导语
- 二、先厘清:它是记忆层,不是新模型
- 三、工作原理:捕获、压缩、注入的闭环
- 四、为什么火:跨 Agent 的统一记忆层
- 五、现在就能试:两种安装路径
- 六、冷静视角:四个先别急着神话的地方
- 总结
一、导语
2026年11月5日,GitHub 上一个叫 claude-mem 的开源项目值得单独拆一拆:它做的事很朴素——给 AI 编程 Agent 装上"跨会话的长期记忆"。据项目官网标注,仓库星标已突破 10 万(官网显示 103.6k),并一度登上 GitHub Trending。但它火的不是因为概念新,而是因为它戳中了一个几乎所有用 Claude Code、Codex、Cursor 写代码的人都被折磨过的问题:每次新开会话,AI 都把昨天的决定、改过的文件、修过的 bug 忘得一干二净。本文把它从"是什么、怎么跑、值不值得装"三个层面讲清楚。
这背后是一条正在成形的工程共识:模型能力在卷 context window 的长度,但"跨会话的状态"长期没人系统管。claude-mem 踩中的,正是这个被忽视的缺口。
二、先厘清:它是记忆层,不是新模型
第一次看到"给 Agent 加记忆",容易误以为是在训练或微调模型。那它和微调模型到底差在哪?差在它根本不碰模型权重,只管上下文的存与取。
它不碰模型权重,只管上下文的存与取。 claude-mem 的本质是一层"记忆中间件":在 Agent 工作的时候默默记录它做了什么,会话结束后用 AI 把这些记录压缩成摘要,等下次会议开始时再把相关的那部分塞回上下文。模型本身一点没变,变的是"Agent 每次启动时手里有多少历史包袱"。
它不是让 AI 变聪明,而是让 AI 不重复劳动。 没有这层记忆,你每开一个新会话都要把"为什么这么设计、哪个文件动过、哪个坑踩过"重新讲一遍;长会话还会把上下文窗口撑爆,逼着你 /compact,而压缩往往把关键细节也一起压没了。claude-mem 要解决的,正是"会话一关,经验归零"这个断点。
它的对手不是某个模型,而是"无状态工作流"。 早期 Agent 都是单次会话思维,干完就散。真正复杂的研发流程需要跨天、跨工具地记住之前干了啥。claude-mem 代表的,是把"状态"从模型里抽出来、放到工具链里这个方向——这和 mem0、Zep 这类"记忆层"是同一赛道,只是它更贴 Claude Code 的钩子生态。
它和 mem0、Zep 是同一赛道,但切入点不同。 记忆层这条赛道上,mem0 偏"为应用注入用户画像"、Zep 偏"图结构沉淀对话图谱"、LangMem 偏"LangChain 生态的长期记忆"。claude-mem 的差异化在于它直接吃 Claude Code 的钩子生态,把"工具调用链"当成记忆的最小颗粒度——你改了哪个文件、为什么改,它比你记得清。
| claude-mem | 工具调用链 / 钩子 | SQLite+FTS5,可选 Chroma | Claude Code 等编程 Agent |
| mem0 | 用户画像 / 语义 | 向量+图 | 对话式应用个性化 |
| Zep | 对话图谱 / 时序 | 图数据库 | 长程对话推理 |
| LangMem | LangChain 生态 | 向量 | LangChain Agent |
所以别把它和传统"笔记软件"混为一谈。 Notion、Obsidian 记的是你主动写下的东西;claude-mem 记的是 Agent 自己干的事,你甚至不需要知道它记了什么,下次它自己会带着来。一句话:它不是要取代谁,而是把"Agent 干过的活"沉淀成可检索的工程资产,这点和 mem0 / Zep 殊途同归。
记忆层的工程价值,在"长周期项目"里最明显。 一个真实项目往往跨数天、数十个文件、好几个会话。没有记忆层,你每次都得把"为什么这么设计、哪个坑踩过"重讲一遍,时间和上下文都在空转。claude-mem 把这部分"项目上下文"外置,等于给 Agent 配了个不会离职、不会忘事的搭档。说到底,它卖的不是"更聪明的模型",而是一个"不会忘事的搭档"——这本该是工程基础设施,而不是某个模型的独占能力。
举个具体的例子:你周一在 Claude Code 里把一个并发 bug 修好了,周二换到 Cursor 接着写新功能,周三 Codex 帮你做代码评审。没有记忆层,这三次会话彼此是瞎子;有了 claude-mem,周二、周三开局就能看到周一那次 fix 的"决策点"和"踩坑点",不用你再复述背景。这种连续性,才是"Agent 搭档"和"一次性工具"的分水岭。
三、工作原理:捕获、压缩、注入的闭环
机制不复杂,是一条由五个生命周期钩子串起来的流水线。
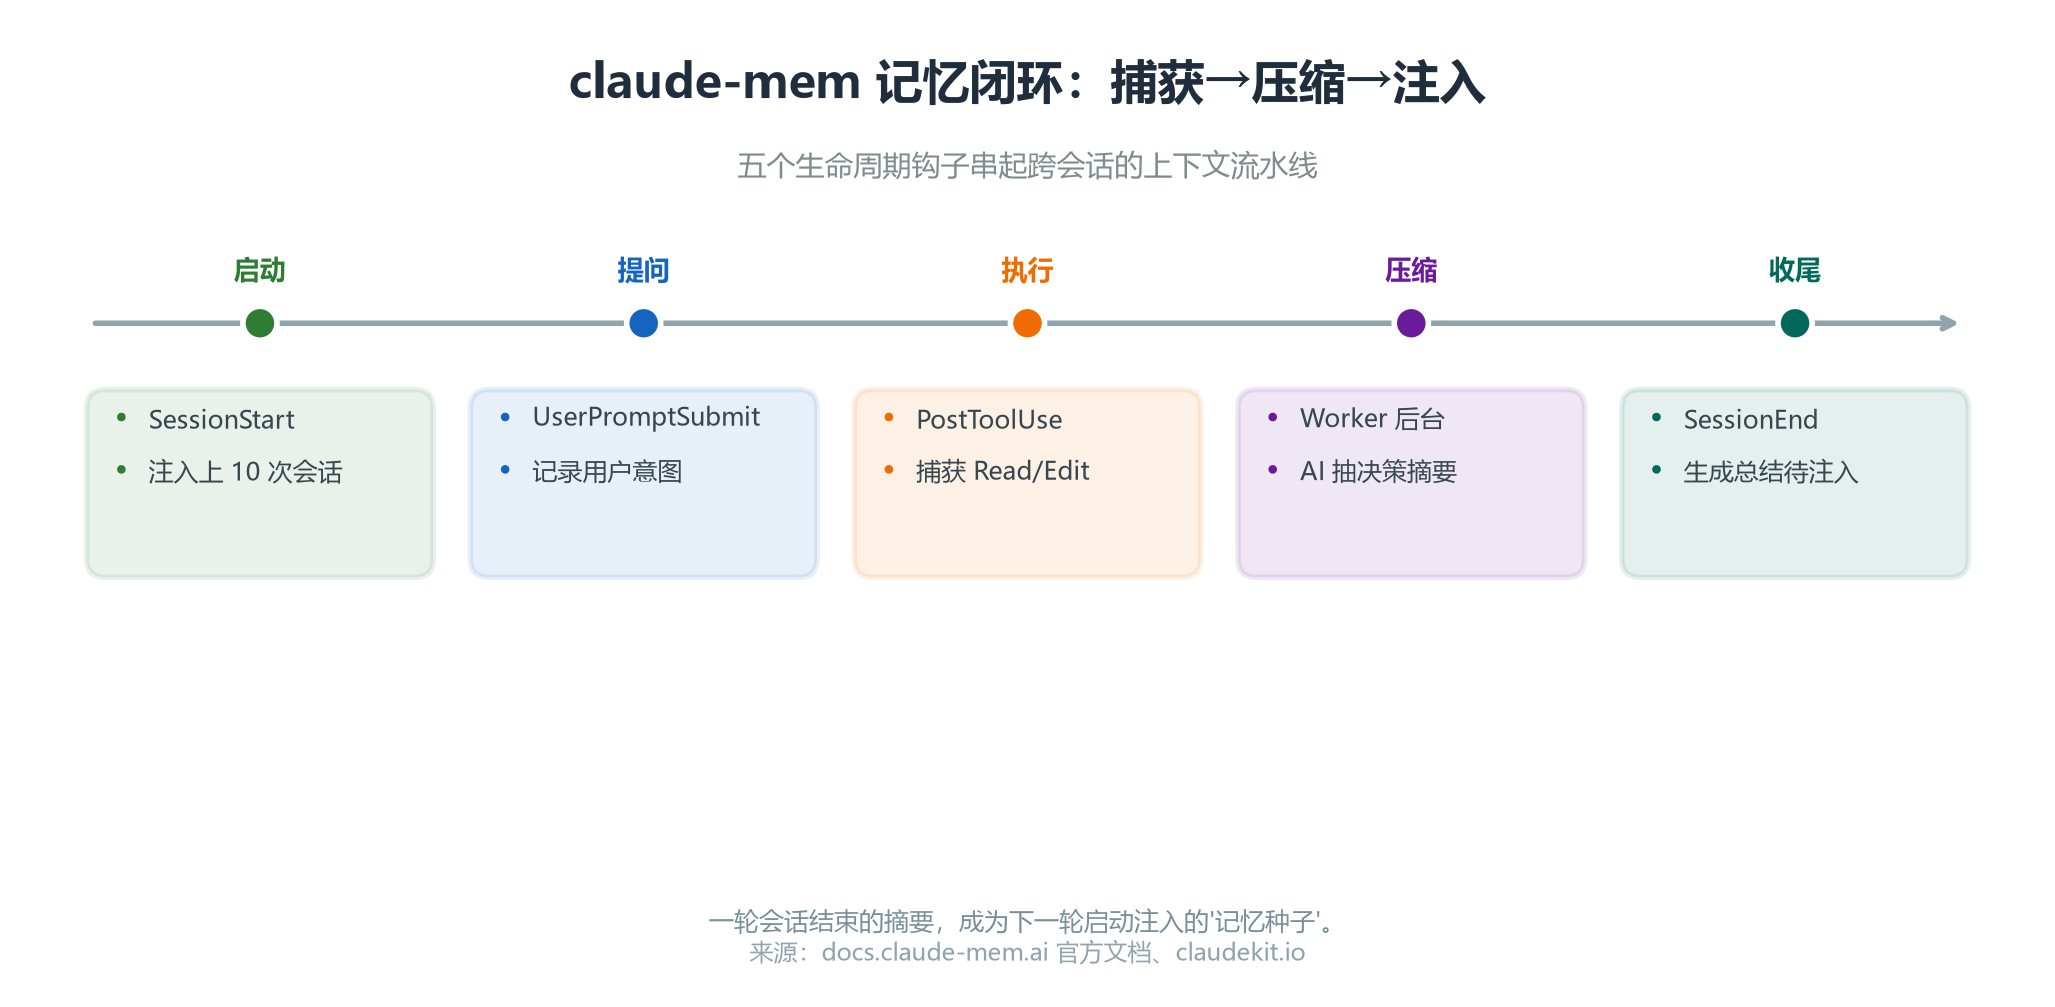
(图一:从会话启动注入、过程中的捕获,到后台 AI 压缩、结束生成摘要,形成跨会话的记忆闭环。)
- SessionStart(启动):从上次约 10 次会话里挑出相关上下文,注入新会话开头。
- UserPromptSubmit(提问):记录用户的真实意图,建立这次会话的索引。
- PostToolUse(执行):每发生一次 Read、Edit、Write 等工具调用,就写一条"观察"记录,并自动分类成"决策 / bug 修复 / 新功能 / 发现"。
- Worker 压缩(后台):一个常驻的 Worker 服务(Bun 上的 Express,按用户跑在 37700 + uid%100 端口)调用 Claude / Gemini 等 SDK,把原始观察提炼成结构化摘要。
- SessionEnd / Summary(收尾):会话结束时生成总结,作为下一轮的"记忆种子"。
存储上,它用 SQLite + FTS5 做本地全文检索,可选接 Chroma 向量索引做语义搜索。一个很实用的设计叫"渐进式披露(Progressive Disclosure)":会话启动只加载一个约 2.1k token 的轻量索引,每条详细观察约 850 token、按需加载,而且 token 开销可见。这避免了"把整个历史对话塞进提示词"的粗暴做法——只注入相关的那一片,而不是全部。
压缩之后的摘要,会不会把关键决策吞掉? 这是大家最担心的点。claude-mem 的应对是"自动分类 + 保留决策点":每条观察被标成"决策 / bug 修复 / 新功能 / 发现"四类之一,Worker 压缩时优先保留"决策点"和"踩坑点",把流水账压成可复用的经验,而不是无脑截断。下次你问"上次那个并发 bug 怎么改的",检索能直接定位到 bug 修复类,而不是把聊天记录全翻一遍。
钩子是这套设计的命门。 五个生命周期钩子串起整条链路,一旦某个钩子没挂上(比如斜杠命令没执行成功、权限被 IDE 拦截),捕获就会断点——你以为它在记,其实什么都没写。排查时先看钩子是否注册成功,比怀疑模型更靠谱。
端口和常驻进程要心里有数。 后台 Worker 按用户跑在 37700 + uid%100,装完如果 IDE 没反应,先 lsof -i:377xx 看进程起没起、日志在不在 ~/.claude-mem/ 下。它是常驻服务,不是"装完就忘"的一次性脚本。
token 开销是可观测的,这点很重要。 渐进式披露不只省 token,还把"这次注入花了多少"摊开给你看。对一个担心"记忆越攒越贵"的人,能看见开销比盲信"它会自己优化"踏实得多。预算敏感的项目,可以调小索引条数、只保留高置信度观察。
收尾时的 Summary 钩子也别忽视: 它生成的那段总结,是下一轮会话的"记忆种子"。种子质量决定下一次注入的相关性——如果某次会话你中途切出去干别的,种子可能混进无关内容,导致下次会议开头被喂了一堆噪音。理解这条链路,你才知道什么时候该手动清理记忆、什么时候可以放心交给它。
四、为什么火:跨 Agent 的统一记忆层
单看机制不算惊艳,真正让它出圈的是兼容面。
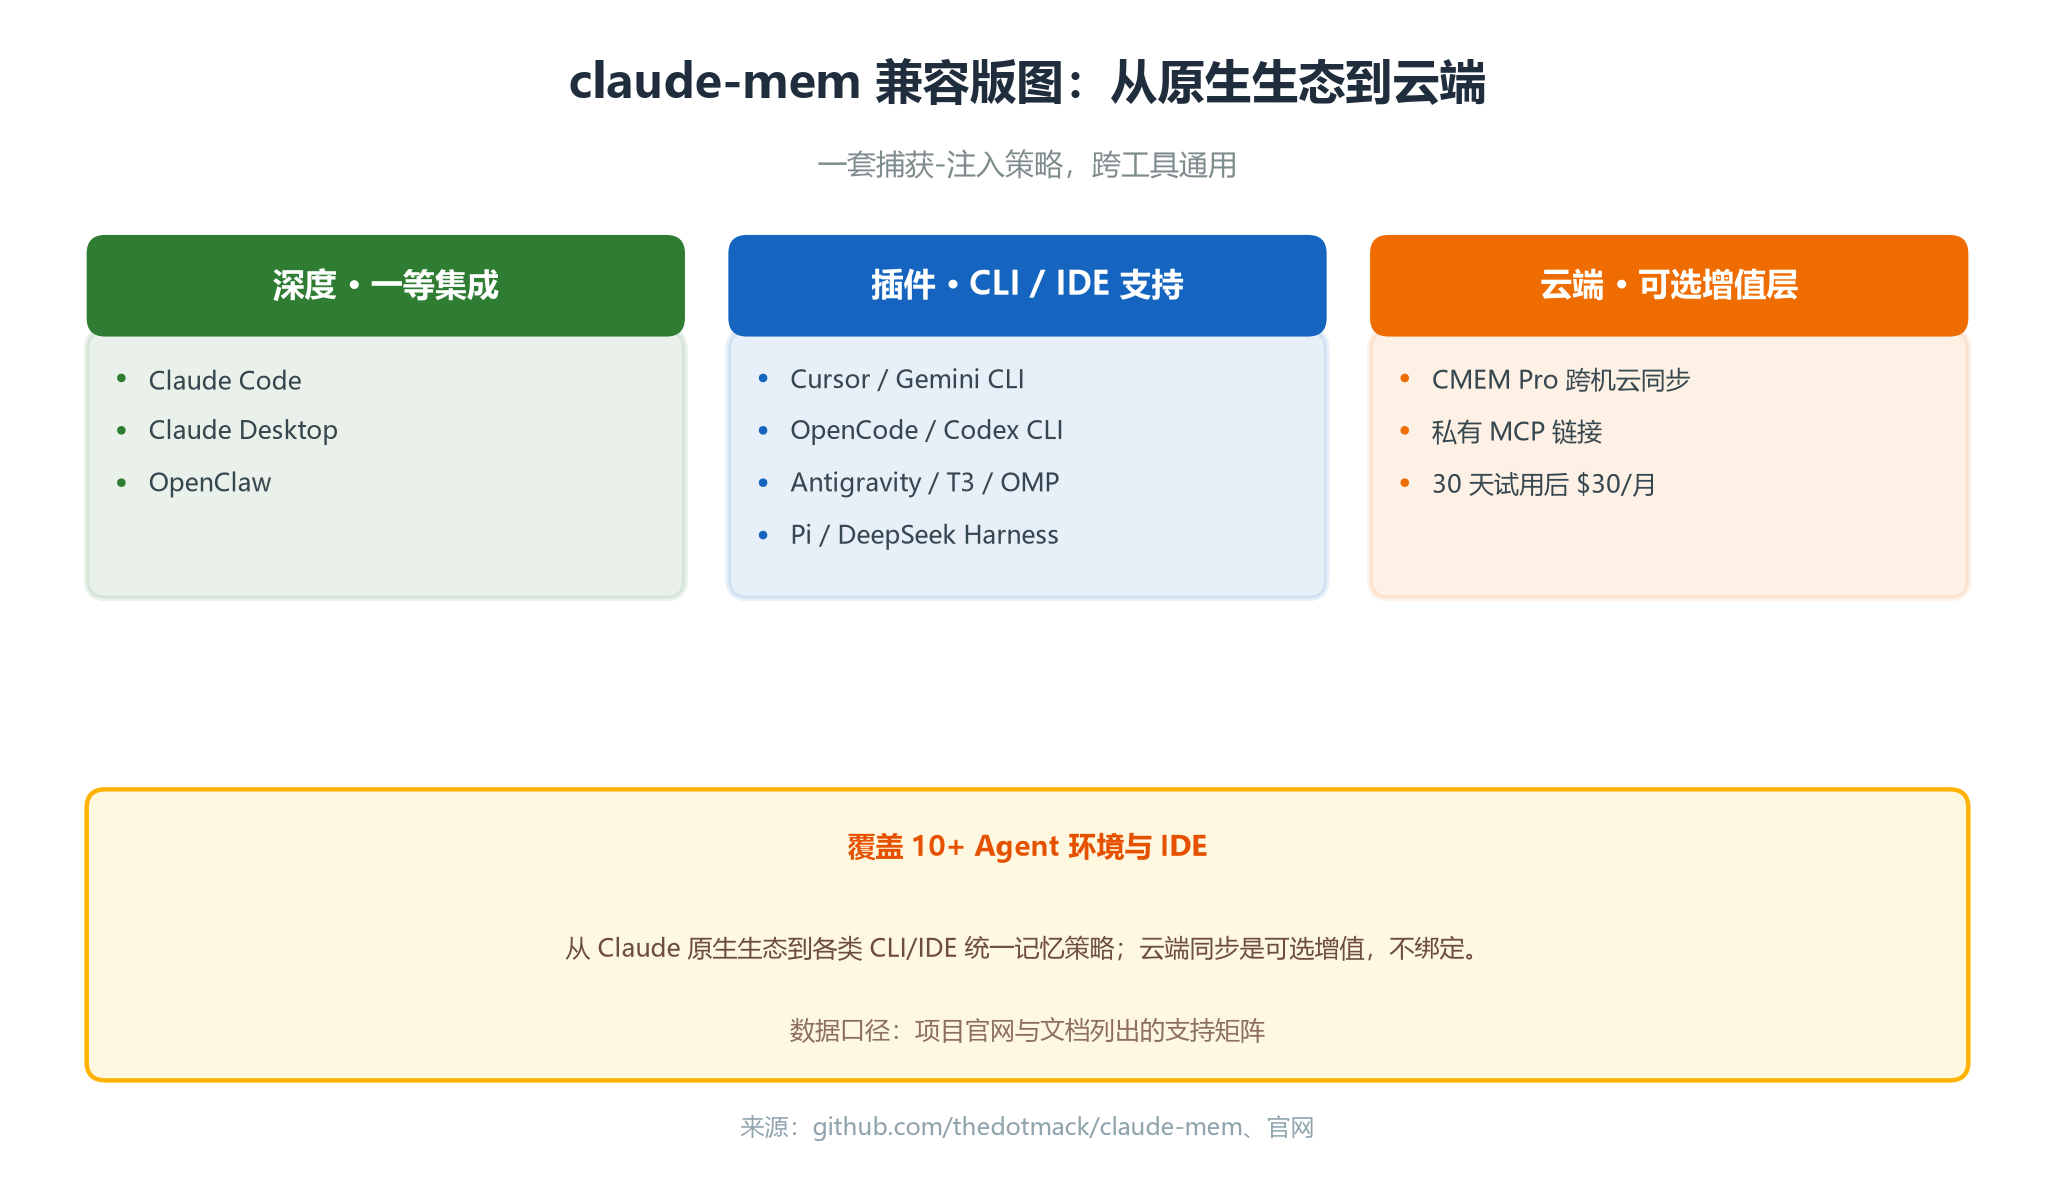
(图二:从 Claude 原生生态到各类 CLI/IDE,再到可选云端同步,claude-mem 试图做统一的记忆层。)
- 深度集成:Claude Code、Claude Desktop、OpenClaw 是它的一等公民,钩子和观察者开箱即用。
- 插件 / CLI 支持:Cursor、Gemini CLI、OpenCode、Codex CLI、Antigravity、T3 Code、OMP、Pi、DeepSeek Harness 等都能通过对应集成挂上。
- 云端同步(可选):CMEM Pro 提供托管观察、跨机云同步和私有 MCP 链接,30 天试用后 30 美元/月。
为什么一个记忆工具能横跨十几种环境? 关键在于它不绑定某个 IDE 的实现,而是吃各家的"钩子 / 插件"接口——Claude 系是一等公民,Cursor、Codex、Gemini CLI 等走对应集成。兼容面越广,"一套记忆跨工具通用"的价值就越大。
对同时在好几个工具里干活的人来说,价值在于"一套捕获-注入策略,跨工具通用"。今天在 Claude Code 里改的代码、踩的坑,明天在 Cursor 或另一台机器上能接着用——这才是"记忆"而不是"某个 IDE 的便签"。
"记忆"和"便签"的区别就在这。 很多工具能记笔记,但记的是"人写的东西"。claude-mem 记的是"Agent 自己干的事"——你没写、但它做了。当一个 bug 在三个 IDE 之间反复出现,只有跨工具的记忆层能把它连成一条线,而不是每次都从零排查。
28 种语言、知识 Agent、Web Viewer 是主线上的延伸。 多语言意味着非英文项目也能正常索引;知识 Agent 把观察历史变成可查询的"第二大脑";Web Viewer 让你在浏览器里实时看捕获流。它们都服务于同一个目标:让记忆可被检索、可被共享、可被审计。
TeamBrain 这类"共享记忆"是下一站。 当个人记忆跑通,自然延伸到团队:同一个仓库的 bug 修复、架构决策,让组里需要的人共享——claude-mem 的方向里已经有"团队脑"的影子,但权限、脱敏、谁有权写谁只读,这些还没标准答案。它能不能从"个人记忆"长成"团队知识库",是下一个要看的点。
放到更大的图景里看,"AI 应用该把状态存哪"正在分化成两派。 一派让模型厂商在云端托管记忆(各类"memory"功能属于这一类),另一派把记忆留在本地工具链(claude-mem 属于这一类)。前者省心但数据出域,后者可控但要自己运维。claude-mem 选了后者,并用"不碰模型、只管上下文"的轻量姿态,避开了和任何一家模型厂正面竞争。
时机也是它出圈的原因。 过去一年 AI 编程 Agent 从"玩具"变成"日常生产工具",单人单日跨多个会话、多个仓库是常态。当使用强度上来,“每次重讲背景"的摩擦被放大,记忆层就从"nice to have"变成"must have”。claude-mem 恰好踩在了 Agent 真正进入工作流的那一刻。
五、现在就能试:两种安装路径
它是真能跑的开源项目,装起来不麻烦。两条路径,看你接不接受把记忆上云。
路径一:联网版(带云端同步)
# 联网版:安装后浏览器登录(邮箱 magic link),30 天试用 CMEM Pro 云端同步
npx claude-mem install
# 或在 Claude Code 内从插件市场装
# /plugin marketplace add thedotmack/claude-mem
# /plugin install claude-mem
路径二:纯本地 / 离线模式(不登录)
# 跳过登录:observer 仍在本地跑,记忆只存本地 SQLite,不进云端
CLAUDE_MEM_ONLINE_OPTIN=false npx claude-mem install –provider anthropic
两条路都靠同一套钩子,区别只在记忆要不要同步到 cmem.ai。装完重启对应 IDE,下次开会话历史就会自动出现。隐私上也有兜底:用标签把敏感内容包起来可排除存储,还能开正则自动打码。
装完怎么确认它真的在跑? 重启 IDE 后开一个新会话,输入 /mem 或看启动日志里是否出现"injecting memories"字样;本地数据默认落在用户目录下的 .claude-mem/(SQLite + 向量文件),直接 ls 看有没有新写入。云端版登录后,去 cmem.ai 后台能看见同步的观察条目。
更新和卸载也不复杂。 升级走 npx claude-mem update,卸载用 npx claude-mem uninstall 会一并清掉钩子;离线模式的数据完全在本地,删目录即清零,不依赖任何远端。
离线模式的隐私实践,值得单独说一句。 走 CLAUDE_MEM_ONLINE_OPTIN=false 这条路,所有观察只落在本地 SQLite,不经过 cmem.ai 任何服务器。对必须守数据出域红线的团队,这是唯一能用的形态;敏感片段再用标签或正则排除,基本能把"记忆"和"泄密"隔开。代价是失去跨机同步——鱼和熊掌,按场景取。
谁最该先试? 如果你每天都在 Claude Code / Codex / Cursor 之间切、手头有跨周的长期项目,这套记忆层收益最明显;如果你只是偶尔问模型几个孤立问题,它的价值有限,反而多了层要维护的常驻进程。按自己的工作流密度决定要不要上,比跟风装更重要。
装之前确认环境: 它依赖 Bun 运行时加 Node 20+,技术栈是 TypeScript。绝大多数现代开发机都满足,但老旧的 CI 容器或受限环境可能要先把 Bun 装上。第一次 install 会拉不少依赖,耐心等它跑完,别中途 Ctrl-C——中断可能导致钩子只注册了一半,后面排查更麻烦。
六、冷静视角:四个先别急着神话的地方
火归火,下结论前先分清哪些是确认的、哪些还悬着。
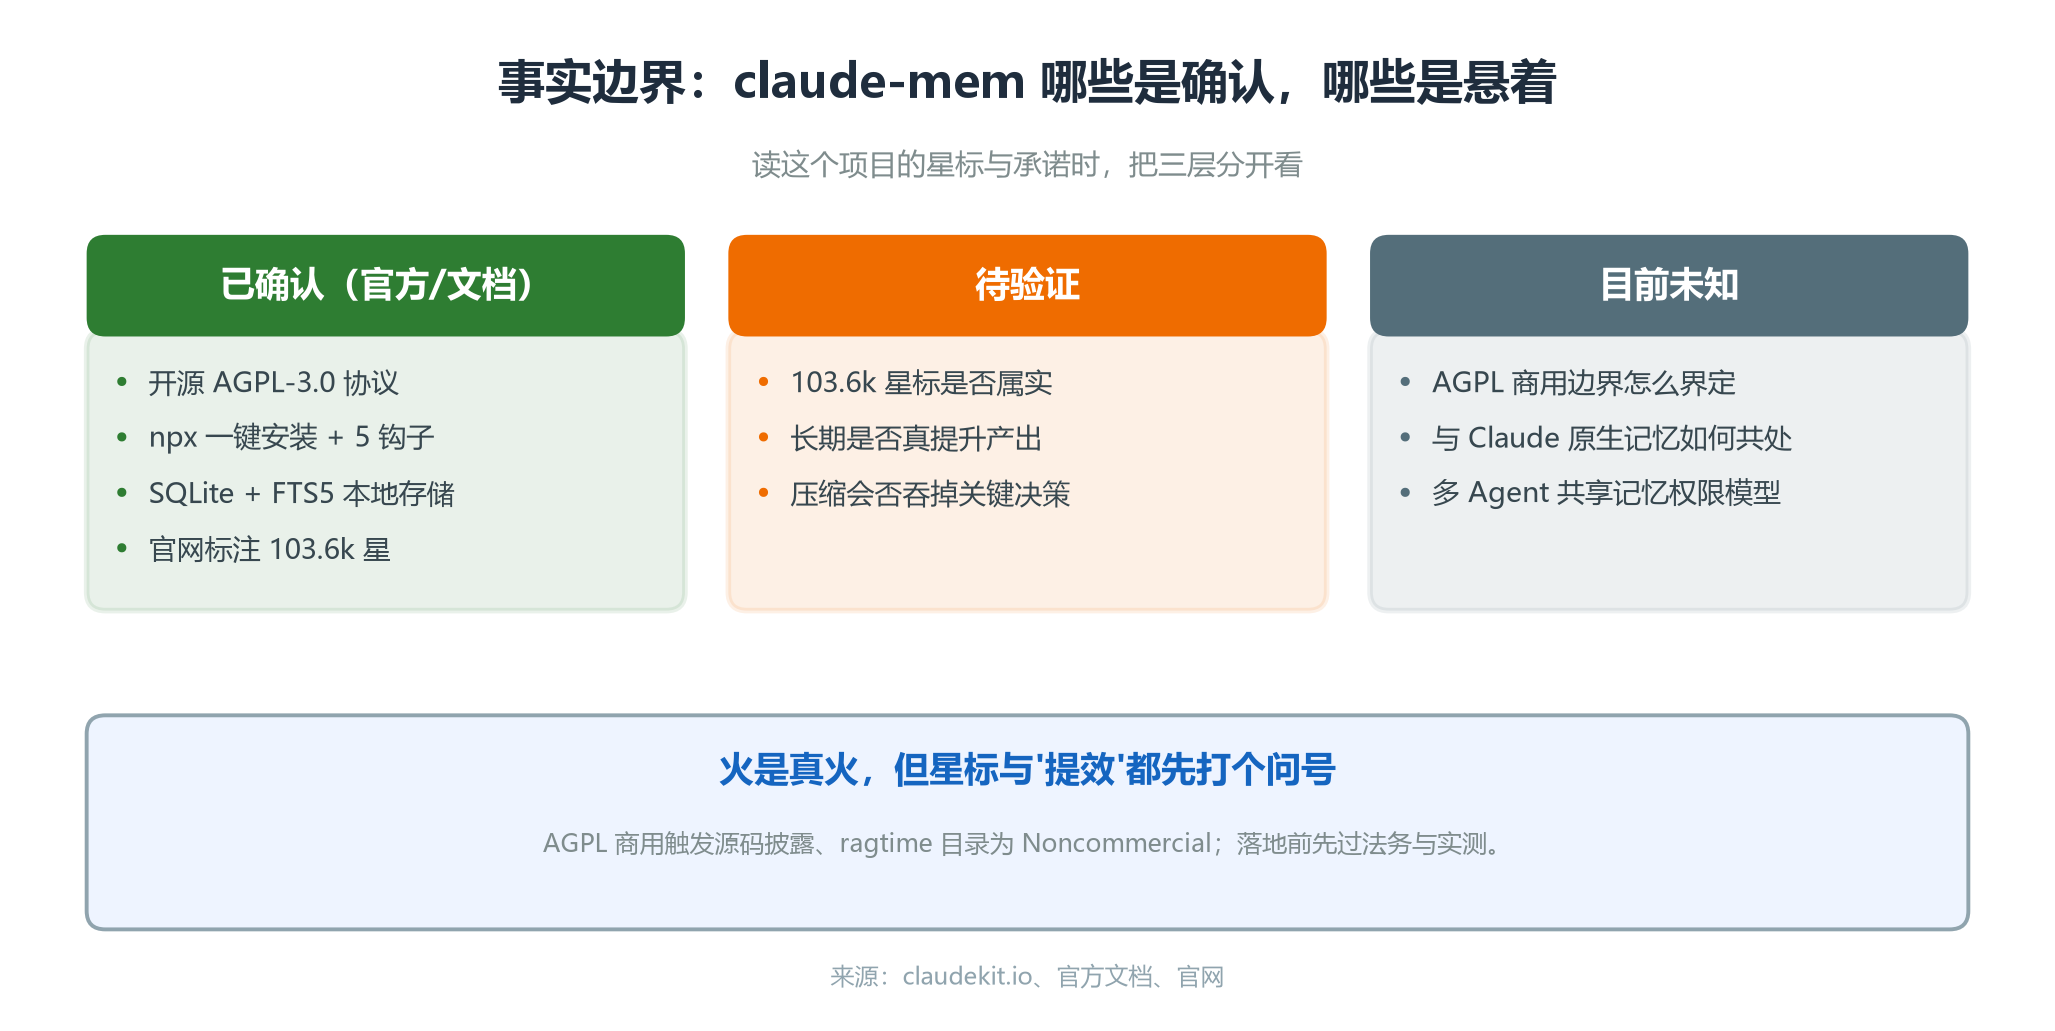
(图三:已确认的事实、待验证的点、目前未知的事,三层分开看。)
第一,星标数字先打个问号。 103.6k 星来自项目官网自述,我没能从独立的第三方源交叉验证。GitHub 上达到这个量级的仓库极少,这个数字可能含水分或统计口径特殊。把它当"很火"看没问题,当"已破 10 万实锤"下结论就冒进了。退一步说,星标衡量的是关注度,不是代码质量——它火,不代表人人在生产环境用得稳。
第二,AGPL-3.0 的商用边界要想清楚。 项目是 AGPL-3.0,网络部署会触发源码披露义务;ragtime/ 目录更是 PolyForm Noncommercial(非商业)。公司里要把它接进内部平台、尤其是 SaaS 化部署前,得先让法务过一遍,别等上线了才发现许可踩线。个人开发者本地用基本无虞,但凡要对外提供服务,这一步不能省。
第三,“记得多"不等于"做得好”。 记忆层解决的是"经验不丢失",但压缩摘要可能吞掉关键决策、多 Agent 共享记忆时权限难划、它和 Claude 自身原生记忆(如项目级 CLAUDE.md、记忆指令)怎么共处谁优先,这些目前都没有标准答案。断言"装上它产出立刻翻倍"和断言"它纯属多余"一样武断。
第四,敏感信息得主动管。 claude-mem 提供了隐私兜底:用标签把密钥、内网地址等包起来可排除存储,还能开正则自动打码。但这要你自己配——默认情况下,它忠实记录一切工具调用,包括你可能不想留下的东西。在接公司代码前,先想清楚哪些该进记忆、哪些该挡在门外,别等某天回顾时发现自己把 token 写进了历史。
总结
claude-mem 火得有道理:它把一个所有人都痛的"Agent 过目即忘"问题,用一层不碰模型权重的记忆中间件解决了——捕获、AI 压缩、按需注入,闭环干净,兼容面又广。对长期在 Claude Code / Codex / Cursor 里干活的开发者,它值得装来试试,尤其本地离线模式零门槛。但别把它神话:星标数字待验证、AGPL 商用要过法务、长期效果尚无定论。真正该记住的不是某个工具,而是这个方向本身——把"状态"从单次会话里解放出来、变成可携带的工程资产,会是 AI 研发工作流的标配,claude-mem 只是先把这条路走通的人之一。
#claude-mem #Agent记忆 #ClaudeCode #跨会话上下文 #AI工程





评论前必须登录!
注册