 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
AI智能体项目实战记录(25):智能体添加限流,MCP Server 添加限流与鉴权
1. 为什么要限流
前 24 篇把智能体能力做通了:对话、子智能体编排、知识库、MCP Server、桌面工作台接入。功能跑通之后,成本与稳定性就成了必须处理的问题。
1.1 不限流会出什么事
| 成本失控 | 一次对话会调用多次大模型(主管决策 + 子智能体 + 总结),单个用户刷一轮就可能上万 token;接口一旦被脚本刷,账单直接失控 |
| 资源打满 | 每次会话都要占用一个 SSE 长连接 + 线程池 + 向量库连接;3~5 个并发就足以把单机 GPU/CPU 吃满,其余用户直接卡死 |
| 单点雪崩 | Milvus / 大模型响应变慢 → 请求在服务端堆积 → 内存上涨 → 整个服务不可用 |
| 能力裸奔 | 第 23 篇写好的 MCP Server 没有任何鉴权,谁拿到地址谁就能调用内部知识库 |
| 额度不可控 | 对外提供的 MCP 能力没有用量上限,一个客户端可以把额度用光 |
1.2 本篇要落地的 5 件事
对话侧(本项目前端 / 登录用户)
├─ ① 同一用户最多 3 个并发会话 → 保护服务端资源
└─ ② 同一用户每天 token 上限 → 控制成本
MCP 侧(WorkBuddy / 第三方客户端)
├─ ③ API Key 鉴权(无 key 提示先获取) → 防止裸奔
├─ ④ 并发上限 + 熔断 → 保护下游 Milvus / 大模型
└─ ⑤ 每个 key(用户)每天 token 上限 → 防止单客户端刷额度
设计原则:限流组件本身绝不能成为故障点。所有 Redis 操作都有降级路径,限流判断失败不能阻断正常业务。
2. 整体结构
┌──────────────────────────────┐
前端对话 ──────▶│ chat_controller │
│ ① session_limit_service │──▶ Redis(并发计数,TTL 兜底)
│ ② token_quota_service │──▶ Redis(当日用量)──▶ PG(ai_invoke_log 汇总)
└──────────────┬───────────────┘
▼
supervisor_graph(主管编排)
│ 结束时写 ai_invoke_log
▼
token_quota_service.add_tokens(chat)
WorkBuddy ────▶ knowledge_server(SSE)
├─ ③ API Key 校验(401 提示先获取 key)
├─ ④ ConcurrencyGuard(并发 + 熔断)
└─ ⑤ 工具内校验 MCP 每日额度
│
▼
RAGTool.run_with_usage → 返回答案 + token
│
▼
log_external_invoke(SKILL_ID_ = mcp:xxx)
└─▶ add_tokens(mcp)
新增/改动文件:
| app/service/system/session_limit_service.py | 新增:并发会话计数 |
| app/service/system/token_quota_service.py | 新增:每日 token 配额 |
| app/controller/chat_controller.py | 接入两个校验,并在流结束时释放名额 |
| app/service/system/invoke_log_service.py | 落库后累加额度;新增外部调用日志 |
| app/tools/rag_tool.py | 新增 run_with_usage,返回答案与 token |
| app/mcp/knowledge_server.py | Key 鉴权 + 并发熔断 + 每日额度 |
| scripts/test_mcp_knowledge_sse.py | 支持 –key |
| app/config/settings.py、.env | 配置项 |
3. 配置项
.env:
# ============ 限流与配额 ============
# 同一登录用户同时进行的对话数上限
CHAT_MAX_CONCURRENT_SESSIONS=3
# 每个登录用户每天可消耗的 token 上限(<=0 不限制)
CHAT_DAILY_TOKEN_LIMIT=200000
# ============ 对外 MCP Server 的鉴权与限流 ============
# 是否开启 API Key 校验(生产环境务必开启)
MCP_AUTH_ENABLED=true
# API Key 列表:"key:userId,key2:userId2";不写 userId 时仅鉴权、不做用户配额
MCP_API_KEYS="sk-mcp-demo-key:1001"
# MCP 工具并发执行上限
MCP_MAX_CONCURRENCY=3
# 连续拒绝多少次后熔断
MCP_BREAKER_TRIP_THRESHOLD=5
# 熔断持续时间(秒)
MCP_BREAKER_COOLDOWN_SECONDS=30
# 每个用户每天通过 MCP 调用可消耗的 token 上限(<=0 不限制)
MCP_DAILY_TOKEN_LIMIT=50000
settings.py:
# 同一登录用户同时进行的对话数上限(SSE 流未结束时算占用一个)
chat_max_concurrent_sessions: int = 3
# 每个登录用户每天可消耗的 token 上限(普通对话,<=0 表示不限制)
chat_daily_token_limit: int = 200000
# 是否开启 API Key 校验(生产环境务必开启)
mcp_auth_enabled: bool = True
# API Key 列表,格式 "key:userId,key2:userId2"
mcp_api_keys: Optional[str] = ''
# MCP 工具并发执行上限,超过后拒绝请求
mcp_max_concurrency: int = 3
# 连续拒绝多少次后触发熔断
mcp_breaker_trip_threshold: int = 5
# 熔断持续时间(秒)
mcp_breaker_cooldown_seconds: int = 30
# 每个用户每天通过 MCP 调用可消耗的 token 上限(<=0 表示不限制)
mcp_daily_token_limit: int = 50000
两个设计取舍:
4. 对话侧①:同一用户最多 3 个并发会话
4.1 为什么用"计数"而不是"查会话表"
用户历史会话是持久化的,数量只增不减,不能用来判断"同时进行"。真正要限制的是正在进行的对话流:从请求开始生成,到最后一帧 SSE 返回为止。
所以用原子计数:请求进来 INCR,流结束 DECR,超过阈值就拒绝。
4.2 实现
app/service/system/session_limit_service.py:
_KEY_PREFIX = "chat:running:"
_KEY_TTL_SECONDS = 7200 # 兜底过期,防止进程崩溃后名额不释放
def acquire(user_id: str, limit: int) –> bool:
if not user_id or limit <= 0:
return True # limit<=0 视为不限制
try:
client = redis_service.get_client()
key = _key(user_id)
current = client.incr(key) # 原子自增
if current == 1:
client.expire(key, _KEY_TTL_SECONDS)
if current > limit:
client.decr(key) # 超限立刻回滚,避免计数虚高
logger.warning(f"[limit] 用户{user_id}并发会话已达上限 {limit}")
return False
return True
except Exception as e:
logger.warning(f"[limit] Redis 不可用,降级为进程内计数: {e}")
return _acquire_local(user_id, limit)
release 里有一个细节:decr 可能因为 key 已过期变成负数,所以要钳制到 0。
def release(user_id: str) –> None:
...
if client.exists(key):
if client.decr(key) < 0:
client.set(key, 0, ex=_KEY_TTL_SECONDS)
4.3 接入对话接口
app/controller/chat_controller.py:
# ———- 限流一:同一用户并发会话数 ———-
max_sessions = int(setting.chat_max_concurrent_sessions or 0)
slot_acquired = False
if max_sessions > 0:
slot_acquired = await asyncio.to_thread(
session_limit_service.acquire, user_id, max_sessions
)
if not slot_acquired:
return _reject_resp(
request_body,
f'当前同时进行的会话已达上限({max_sessions} 个),请结束其它会话后再试',
)
释放必须在 finally,且流式接口要放到生成器的 finally 里,因为客户端中途断开时生成器会被关闭:
finally:
# 无论正常结束、异常还是客户端断开,都要归还并发会话名额
if release_user_id:
await asyncio.to_thread(session_limit_service.release, release_user_id)
流式接口的 reject 事件前端已经认识(StreamDataRespType.REJECT),不需要改前端。
5. 对话侧②:每个用户每天 token 上限
5.1 统计口径
token 数据不重新采集,直接复用第 15/19 篇落库的调用日志:ai_invoke_log.COST_TOKEN。
SELECT COALESCE(SUM(COST_TOKEN), 0)
FROM ai_invoke_log
WHERE CREATE_BY_ = :user_id
AND CREATE_TIME_ >= :day_start
AND (SKILL_ID_ IS NULL OR SKILL_ID_ NOT LIKE 'mcp%') — 普通对话额度不含 MCP 调用
5.2 为什么要 Redis 包一层
每次对话前都 SUM 一遍全表是按用户+时间扫的,QPS 上来会很重。改成 Redis 计数器 + 数据库回源:
| 正常读 | 读 Redis quota:tokens:chat:{userId}:{yyyymmdd} |
| key 缺失(首次 / Redis 重启) | 查库汇总 → 回填 Redis(TTL 到当天结束) |
| 每次落库后 | INCRBY 累加,不再查库 |
| Redis 挂了 | 直接查库,功能不受影响 |
app/service/system/token_quota_service.py:
def used_tokens(user_id: str, scope: str = "chat") –> int:
key = _key(user_id, scope)
try:
client = redis_service.get_client()
value = client.get(key)
if value is not None:
return int(value or 0)
used = _sum_from_db(user_id, scope)
client.set(key, used, ex=_ttl_seconds())
return used
except Exception as e:
logger.warning(f"[quota] Redis 不可用,直接查库: {e}")
return _sum_from_db(user_id, scope)
def add_tokens(user_id: str, tokens: int, scope: str = "chat") –> None:
...
if not client.exists(key):
client.set(key, _sum_from_db(user_id, scope), ex=_ttl_seconds())
client.incrby(key, int(tokens))
add_tokens 里"先回源再自增"很关键:Redis 重启后 key 不存在,如果直接 INCRBY 会把数据库里已有的用量覆盖掉,等于给用户重置了额度。
5.3 累加时机
落库成功后立即累加,保证"写日志"与"扣额度"是同一步发生的(invoke_log_service._do_finalize):
logger.info(f"[invoke_log] 已写入调用日志 … tokens={run_log.total_tokens}")
# 累加当天普通对话额度(MCP 调用在 MCP Server 侧单独累加)
token_quota_service.add_tokens(run_log.user_id, run_log.total_tokens, "chat")
5.4 接入对话接口
# ———- 限流二:每日 token 配额 ———-
daily_limit = int(setting.chat_daily_token_limit or 0)
if daily_limit > 0:
allowed, used, quota = await asyncio.to_thread(
token_quota_service.check, user_id, daily_limit, 'chat'
)
if not allowed:
if slot_acquired:
await asyncio.to_thread(session_limit_service.release, user_id)
return _reject_resp(
request_body,
f'您今日的 token 额度已用完(已用 {used} / 上限 {quota}),暂不可用,请明天再试',
)
注意这里先归还并发名额再返回,否则用户每被额度拒绝一次就白占一个坑。
6. MCP 侧③:API Key 鉴权
6.1 现状:FastMCP 1.4.1 的 SSE 没有鉴权
# mcp 1.4.1 的 FastMCP.run_sse_async 内部实现(节选)
async def handle_sse(request):
async with sse.connect_sse(request.scope, request.receive, request._send) as streams:
await self._mcp_server.run(...) # 直接进入协议,没有任何校验
starlette_app = Starlette(routes=[
Route("/sse", endpoint=handle_sse),
Mount("/messages/", app=sse.handle_post_message),
])
它也没有暴露 sse_app(),所以不能简单加中间件。方案:照它的结构自己搭一个 Starlette 应用,在 handle_sse 里先校验 key。
6.2 校验逻辑
def _parse_api_keys(raw: str) –> Dict[str, str]:
"""解析 MCP_API_KEYS:'key1:userId1,key2:userId2' → {key: userId}"""
result: Dict[str, str] = {}
for item in (raw or "").split(","):
item = item.strip()
if not item:
continue
key, _, user_id = item.partition(":")
if key.strip():
result[key.strip()] = user_id.strip()
return result
def _extract_key(request: Request) –> str:
"""从 Authorization: Bearer / ?key= / X-API-Key 中取 key"""
auth = request.headers.get("authorization") or ""
if auth.lower().startswith("bearer "):
return auth[7:].strip()
return (request.query_params.get("key") or request.headers.get("x-api-key") or "").strip()
def _authenticate(request: Request) –> Tuple[str, str]:
if not setting.mcp_auth_enabled:
return "", ""
if not _API_KEYS:
return "", "服务端未配置任何 API Key(MCP_API_KEYS),请先在 .env 中配置"
key = _extract_key(request)
if not key:
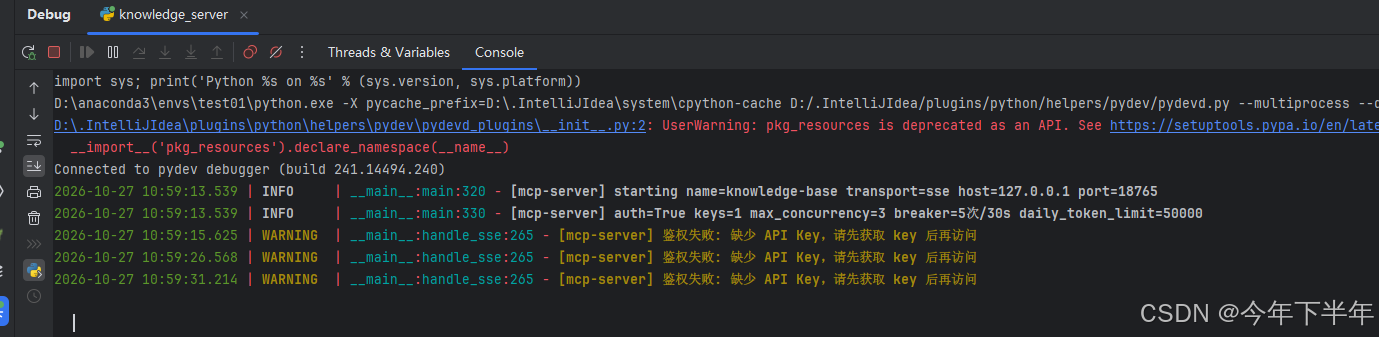
return "", "缺少 API Key,请先获取 key 后再访问"
for candidate, user_id in _API_KEYS.items():
if secrets.compare_digest(key, candidate):
return user_id, ""
return "", "API Key 无效,请确认 key 是否正确"
三个细节:
- 用 secrets.compare_digest 而不是 ==,避免时序攻击;
- 支持三种传递方式,是因为不同客户端能力不一样:WorkBuddy 的 mcp.json 里在 URL 上追加 ?key= 最省事,IDE / Claude Desktop 更适合 Authorization 头;
- 返回的 userId 就是后面算额度用的身份。
6.3 自己搭 SSE 应用
def _build_sse_app() –> Starlette:
sse = SseServerTransport("/messages/")
async def handle_sse(request: Request):
caller, err = _authenticate(request)
if err:
logger.warning(f"[mcp-server] 鉴权失败: {err}")
return JSONResponse(
{"error": err, "hint": "请先获取 API Key 后再连接"},
status_code=401,
)
if _GUARD.is_open():
return JSONResponse({"error": "服务繁忙(熔断中),请稍后重试"}, status_code=503)
# 同一条 SSE 连接上的所有工具调用都归属这个调用方
_caller_var.set(caller)
async with sse.connect_sse(request.scope, request.receive, request._send) as streams:
await mcp._mcp_server.run(
streams[0], streams[1], mcp._mcp_server.create_initialization_options()
)
return Starlette(
debug=mcp.settings.debug,
routes=[
Route("/sse", endpoint=handle_sse),
# /messages 用 SSE 握手时下发的 session_id 作短期凭证,不再重复校验 key
Mount("/messages/", app=sse.handle_post_message),
],
)
两个关键点:
_caller_var: ContextVar[str] = ContextVar("mcp_caller", default="")
@mcp.tool(name="search_knowledge_base", ...)
async def search_knowledge_base(question: str) –> str:
caller = _caller_var.get() # 由 key 解析出的用户ID
6.4 没有 key 的表现
$ curl.exe -s -i –max-time 3 http://127.0.0.1:18766/sse
HTTP/1.1 401 Unauthorized
content-type: application/json
{"error":"缺少 API Key,请先获取 key 后再访问","hint":"请先获取 API Key 后再连接"}
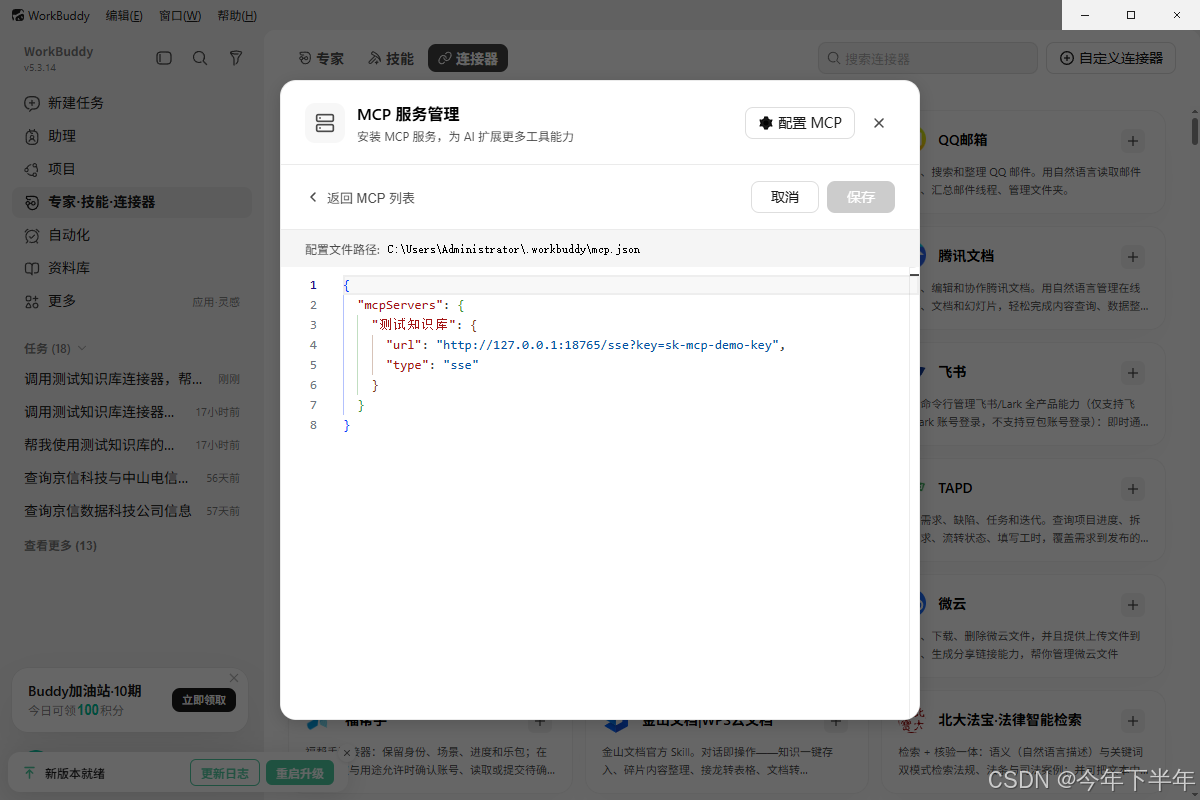
客户端(WorkBuddy)侧表现为连接失败、连接器红点。文档第 24 篇的接法要改成带 key:
{
"mcpServers": {
"测试知识库": {
"type": "sse",
"url": "http://127.0.0.1:18765/sse?key=sk-mcp-demo-key"
}
}
}
项目内测试脚本同步加了 –key:
D:\\anaconda3\\envs\\test01\\python.exe scripts\\test_mcp_knowledge_sse.py `
—url http://127.0.0.1:18766/sse —key sk-mcp-demo-key `
—question "知识库里有没有记录当前项目使用了什么技术栈?"
7. MCP 侧④:并发上限与熔断
7.1 为什么要"拒绝"而不是"排队"
排队看起来更友好,但在 Agent 场景里是灾难:每次工具调用 2~10 秒,排队会让客户端超时、SSE 长连接堆积,最后内存被打爆。快速失败 + 客户端稍后重试才是安全的做法。
7.2 实现
class ConcurrencyGuard:
"""
– 并发数达到 MCP_MAX_CONCURRENCY 时直接拒绝,不排队;
– 连续被拒绝 MCP_BREAKER_TRIP_THRESHOLD 次后熔断,
冷却 MCP_BREAKER_COOLDOWN_SECONDS 秒,期间所有请求快速失败。
"""
def try_acquire(self) –> Tuple[bool, str]:
now = time.monotonic()
if now < self._open_until:
return False, f"服务已熔断,请 {int(self._open_until – now) + 1} 秒后重试"
if self.inflight >= self.max_concurrency:
self._trips += 1
if self.cooldown_seconds > 0 and self._trips >= self.trip_threshold:
self._open_until = now + self.cooldown_seconds
self._trips = 0
return False, f"并发超过上限({self.max_concurrency}),服务熔断 {self.cooldown_seconds} 秒"
return False, f"当前请求过多(并发上限 {self.max_concurrency}),请稍后重试"
self.inflight += 1
return True, ""
def release(self) –> None:
if self.inflight > 0:
self.inflight -= 1
self._trips = 0 # 有请求成功完成就重置连击计数
工具里的用法(finally 必须释放):
ok, reason = _GUARD.try_acquire()
if not ok:
logger.warning(f"[mcp-server] 拒绝调用 caller={caller or '-'} reason={reason}")
return f"【限流】{reason}"
try:
...
finally:
_GUARD.release()
返回的是一段普通文本而不是抛异常,这样大模型拿到后能正常转述给用户,WorkBuddy 里看到的是"当前请求过多,请稍后重试",而不是一个红色报错。
7.3 实测
直接把守卫拿出来跑(max=1, 阈值=2, 冷却=30):
1 (True, '')
2 (False, '当前请求过多(并发上限 1),请稍后重试')
3 (False, '并发超过上限(1),服务熔断 30 秒')
open True
4 (False, '服务已熔断,请 31 秒后重试')
前两个请求占满并发 → 第 2 次拒绝记 1 次连击 → 第 3 次拒绝达到阈值 → 熔断打开 → 之后全部快速失败。
8. MCP 侧⑤:每个用户每天 token 上限
8.1 token 从哪来
原来的 RAGTool._run 只返回字符串,拿不到 token。给它加一个带用量的方法,_run 保持 LangChain 的工具契约不变:
def _run(self, question: str) –> str:
"""执行知识库问答(LangChain 工具契约:只返回文本)"""
answer, _ = self.run_with_usage(question)
return answer
def run_with_usage(self, question: str) –> Tuple[str, int]:
...
resp = deepseek_client.chat.completions.create(...)
answer = resp.choices[0].message.content or ""
# 统计 token:优先取 usage,缺失时按字符估算(2 字符 ≈ 1 token)
usage = getattr(resp, "usage", None)
tokens = 0
if usage is not None:
tokens = int(getattr(usage, "prompt_tokens", 0) or 0) + int(
getattr(usage, "completion_tokens", 0) or 0
)
if tokens <= 0:
tokens = max(1, (len(prompt) + len(answer)) // 2)
return answer, tokens
8.2 落日志 + 扣额度
MCP 调用不经过主管编排,所以要单独落一条日志。SKILL_ID_ 记 mcp:knowledge-base,这就是和对话额度区分的标记:
def log_external_invoke(user_id, question, answer, tokens,
source="mcp:knowledge-base", success=True, fail_msg=""):
...
with db_service.get_engine().begin() as conn:
conn.execute(text(text_insert_invoke()), {
...
"cost_token": int(tokens or 0),
"skill_id": _safe_text(source, 64), # mcp:knowledge-base
"create_by": _safe_text(user_id, 64) or "mcp",
...
})
# 台账写成功后再累加 MCP 额度,避免日志失败时额度被多扣
token_quota_service.add_tokens(user_id, tokens, "mcp")
8.3 工具内校验
# 1. 每日额度校验(未绑定用户的 key 不做额度限制)
quota_limit = int(setting.mcp_daily_token_limit or 0)
if caller and quota_limit > 0:
allowed, used, quota = await asyncio.to_thread(
token_quota_service.check, caller, quota_limit, "mcp"
)
if not allowed:
return (f"【额度】您今日通过 MCP 调用已消耗 {used} / {quota} token,"
f"暂不可用,请明天再试")
8.4 实测
先用默认额度跑一次正常调用(MCP_DAILY_TOKEN_LIMIT=50000):
[mcp-server] SSE 连接建立 caller=1001
[invoke_log] 已写入外部调用日志 source=mcp:knowledge-base user=1001 tokens=1068
[mcp-server] 调用完成 caller=1001 tokens=1068 cost=2.583s inflight=1
Redis 里能看到当日用量:
quota:tokens:mcp:1001:20261027 = 1068
把额度调到 1000 后再启动一个实例,同样的调用直接被拦截:
[tools] count=1
[call] search_knowledge_base question=技术栈是什么
[call] isError=False
【额度】您今日通过 MCP 调用已消耗 1068 / 1000 token,暂不可用,请明天再试
再验证两套额度确实隔离:用户 1001 已经有 1068 的 MCP 消耗,查对话额度仍然是 0:
chat_quota (True, 0, 200000)
9. 联调与验证
9.1 启动
cd e:\\myProject\\my-langchain\\agent\\chat_py_server
D:\\anaconda3\\envs\\test01\\python.exe –m app.mcp.knowledge_server —preload
[mcp-server] starting name=knowledge-base transport=sse host=127.0.0.1 port=18765
[mcp-server] auth=True keys=1 max_concurrency=3 breaker=5次/30s daily_token_limit=50000
9.2 三个必测点
| 无 key | curl.exe -s -i –max-time 3 http://127.0.0.1:18765/sse | 401 + “缺少 API Key,请先获取 key 后再访问” |
| 带 key | curl.exe -s -i –max-time 3 "http://127.0.0.1:18765/sse?key=sk-mcp-demo-key" | 200 + event: endpoint |
| 工具调用 | 脚本加 –key | isError=False,返回知识库答案 |
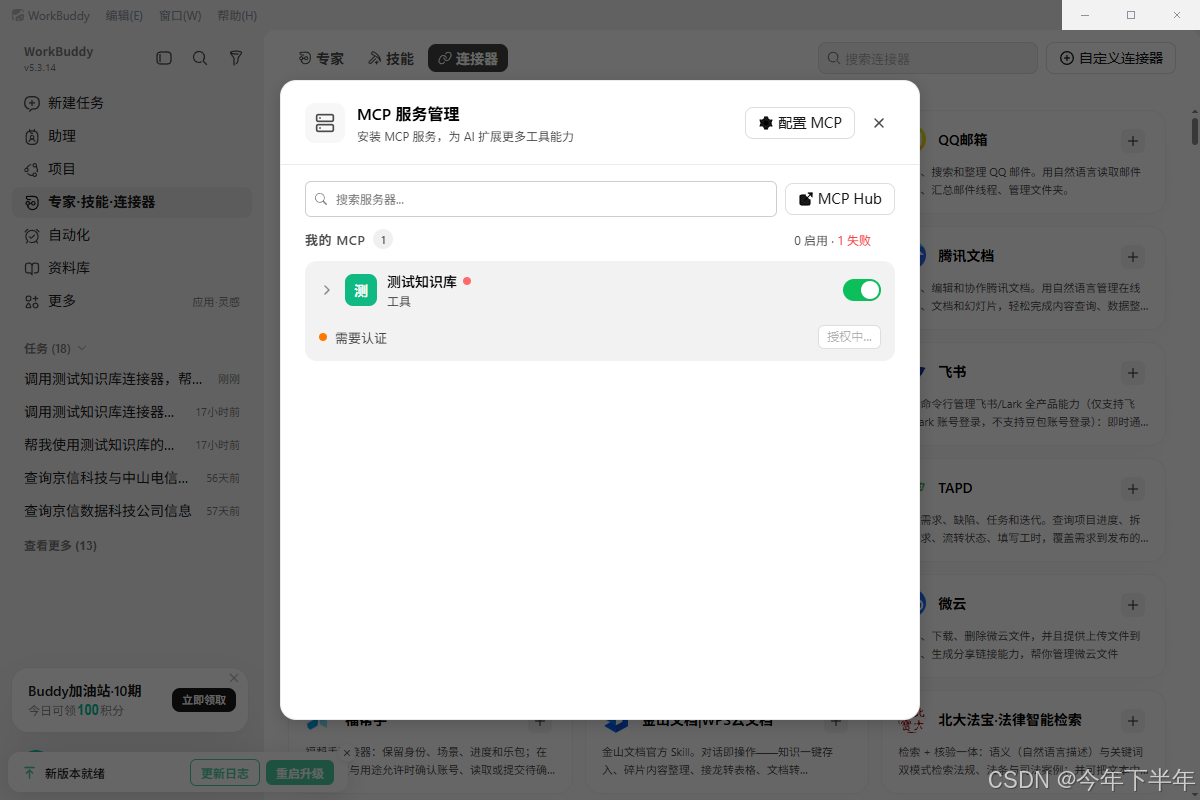
1.mcp连接器状态变为需要认证
2.后端提示
3.连接器添加key
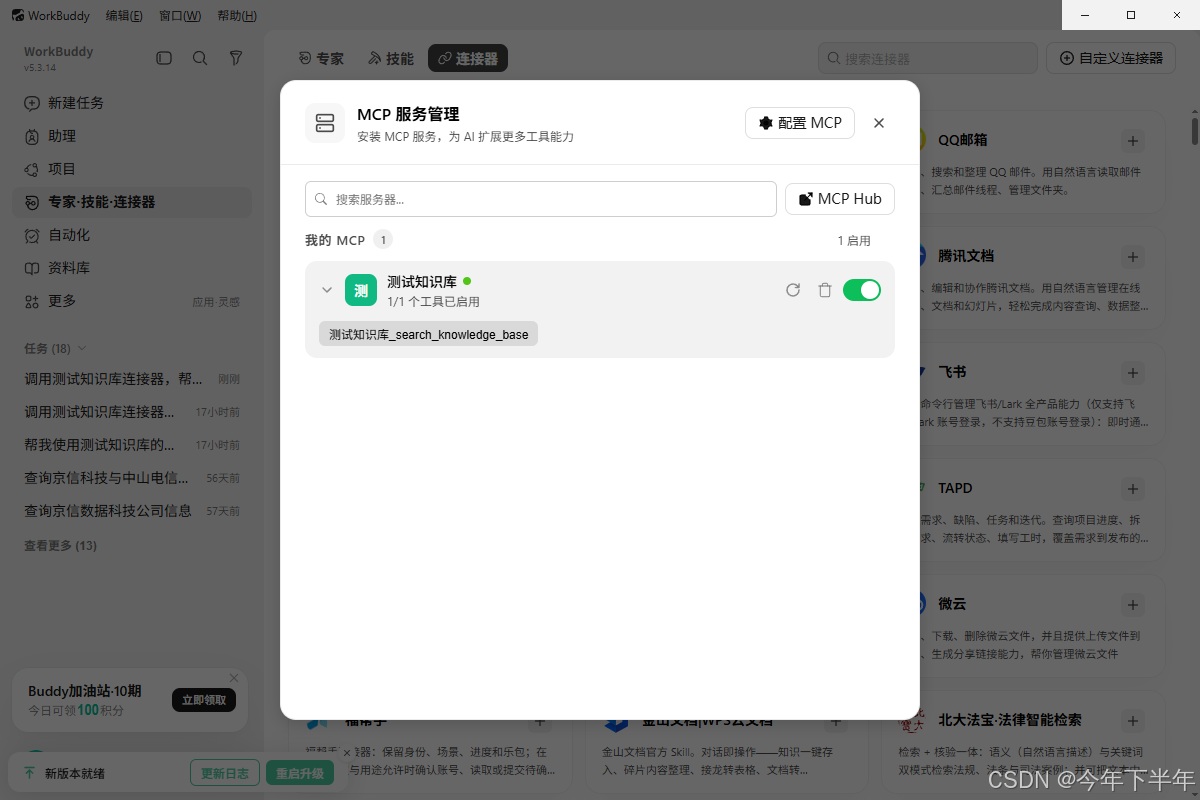
4.连接成功
9.3 会话并发实测
[True, True, True, False] # 第 4 次申请被拒
count 3
after_release 0
9.4 检查清单
- 第 4 个并发会话收到 reject 事件,提示"已达上限(3 个)"
- 关闭其中一个会话后,可以重新发起
- 额度用尽时收到"token 额度已用完(已用 X / 上限 Y)"
- MCP 无 key 返回 401,带 key 正常
- ai_invoke_log 里 MCP 调用行的 SKILL_ID_ 是 mcp:knowledge-base
- Redis 里 quota:tokens:mcp:{userId}:{日期} 随调用递增
10. 常见问题
| 所有 MCP 请求都 401 | MCP_AUTH_ENABLED=true 但 MCP_API_KEYS 为空 | 配置 key;启动日志会打印 keys=0 的告警 |
| 改了 key 不生效 | key 在进程启动时解析一次 | 重启 MCP Server |
| 并发没到上限也被拒 | 熔断已打开 | 等 MCP_BREAKER_COOLDOWN_SECONDS 秒 |
| 额度永远是 0 | CREATE_BY_ 为空(stdio 模式没有用户身份) | stdio 不校验额度,属预期 |
| 额度算少了 | Redis 里 key 被手工改过 / 数据库写入失败 | 删掉 quota:tokens:* 让系统回源重算 |
| 会话名额一直不释放 | 进程被强杀,finally 没执行 | 等 TTL(2 小时)自动归零;必要时手动删 chat:running:* |
| 用户被限流后一直进不去 | 前端没处理 reject | 前端已支持,若自定义客户端需单独处理该事件 |
11. 小结
本篇把"能跑"变成了"敢开出去":
| 并发资源 | Redis 原子计数 + TTL 兜底 | session_limit_service |
| 对话成本 | ai_invoke_log 汇总 + Redis 计数 | token_quota_service(scope=chat) |
| 接入安全 | API Key(Bearer / query / header) | knowledge_server._authenticate |
| 服务稳定 | 并发闸门 + 熔断 | ConcurrencyGuard |
| 外部成本 | 外部调用日志 + 独立额度 | log_external_invoke + scope=mcp |
三条经验:
后续还能继续做:网关层按 IP 限流、滑动窗口替代固定日额度、把 inflight / 熔断状态暴露成 Prometheus 指标、按 key 做更细的 QPS 限制。
附:本文配置汇总
CHAT_MAX_CONCURRENT_SESSIONS=3
CHAT_DAILY_TOKEN_LIMIT=200000
MCP_AUTH_ENABLED=true
MCP_API_KEYS="sk-mcp-demo-key:1001"
MCP_MAX_CONCURRENCY=3
MCP_BREAKER_TRIP_THRESHOLD=5
MCP_BREAKER_COOLDOWN_SECONDS=30
MCP_DAILY_TOKEN_LIMIT=50000
WorkBuddy mcp.json:
{
"mcpServers": {
"测试知识库": {
"type": "sse",
"url": "http://127.0.0.1:18765/sse?key=sk-mcp-demo-key"
}
}
}


评论前必须登录!
注册