 网硕互联帮助中心
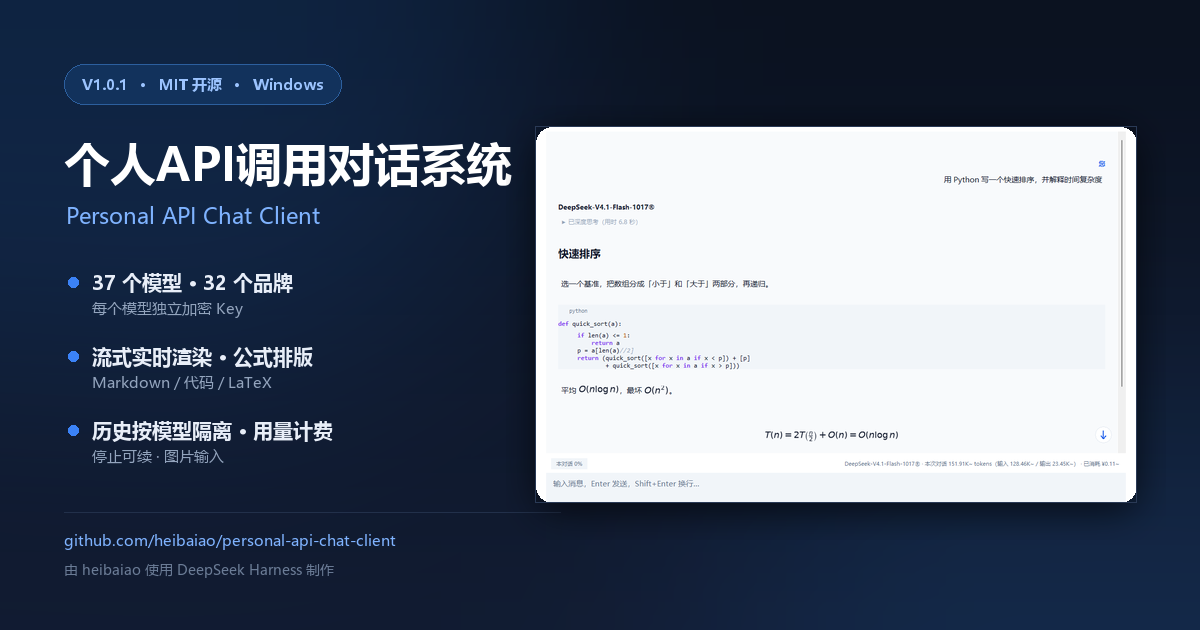
这个项目叫 个人API调用对话系统(Personal API Chat Client):一个 Windows 桌面 AI 对话客户端,支持 37 个模型、32 个品牌,单文件 6749 行,MIT 开源。
它的几乎每一行代码、每一次调试、每一版打包,都是在 DeepSeek Harness 里完成的——不是我贴代码给 AI 看,而是 AI 在我的机器上读文件、改代码、跑命令、编译、打包、跑回归测试,我负责提需求、定标准和验收。
目录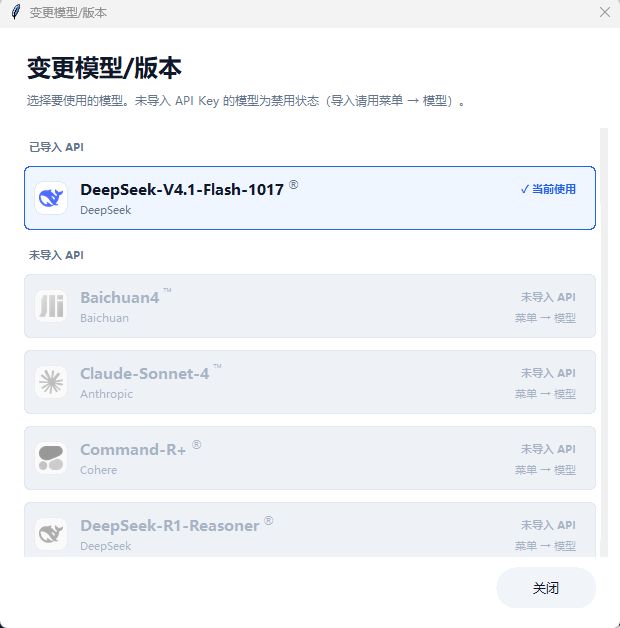
- 我们怎么分工
- 项目本身
- 三个「人机协作」的瞬间
- AI 写代码,人负责什么
- 获取
我们怎么分工
| 我(heibaiao) | 产品定义、界面审美、功能取舍、验收标准、最终拍板 |
| DeepSeek Harness | 写代码、重构、定位 bug、批量改文案、打包、写文档、跑回归、准备发版 |
举几个真实例子:
- 我说「把思考过程做成 DeepSeek 那种可折叠的」,它给出实现、自己截图验证、发现点击区域按整行判断,又改成按字符区间精确命中;
- 我说「历史对话要按模型分开」,它不只改了侧栏过滤,还发现旧数据缺 model_id 会跟着当前模型漂移,顺手补了迁移;
- 我贴一张报错截图,它去翻日志、复现、定位到「停止标记没清理」,改完再跑一遍 14 项回归。
我不是在写代码,我是在做 code review 和产品决策。
项目本身
技术栈:Python + Tkinter,单文件 266 KB,只依赖 openai 和 matplotlib;界面全是 Canvas 手绘(圆角按钮、胶囊开关、品牌徽标)。
能力清单:
- 37 个模型 / 32 个品牌,每个模型独立加密保存 Key
- 流式生成时按行实时渲染 Markdown(标题、列表、代码块、加粗)
- LaTeX 公式与化学式优先排版成图,失败自动降级 Unicode
- 推理过程实时显示,结束后折叠为「▼ 已深度思考(用时 X 秒)」
- 对话级 token 用量与费用估算(151.91K~ tokens · ¥0.11~)
- 历史按模型隔离,查看其他模型时只读
- 停止生成 = 真断开,可「重新生成」或「编辑这条提问」
- 7 个视觉模型支持真实图片输入;推理强度可调(Qwen3 / GLM-4.6 / 豆包)
数字:6749 行、29 次提交、94 个文件、发布包 55.9 MB、MIT 协议。
三个「人机协作」的瞬间
① 文本指数膨胀 流式渲染每 120ms 重绘一次,Tk 的 end 索引在带空行时差一行,删不干净就变成每帧追加——一屏文字滚成瀑布。Harness 复现后改成「纯追加 + 行缓冲」,不删就不会重复。
② 重新生成永远失败 点停止会把会话加入停止标记,但清理只在正常收尾路径执行。停在“思考中”时标记永久残留,之后每次请求收到第一个数据块就 break。这个 bug 藏了两轮,最后靠日志和复现抓出来。
③ 点击精度 「重新生成 / 编辑提问 / 展开思考」原本按行号命中,点行尾空白也会触发。改成记录字符区间、用 compare() 判断后,点文字才算数。
这些都不是“让 AI 写个函数”能解决的,需要能跑、能看、能改的闭环——这正是 Harness 的价值。
AI 写代码,人负责什么
说点实在的:
- AI 会自信地写错。比如把 cid 字符串当字典传给函数,异常被 except 吞掉,界面看起来“生效了”其实没有。这种必须靠人验收。
- 审美和取舍只能人来定。圆角多大、教程多长、哪些功能该砍,AI 没有立场。
- 环境限制要人来判断。这台机器沙箱禁止命名管道,git push 和单文件打包都会失败——是环境问题还是代码问题,得有人拍板。
所以更准确的说法是:Harness 把「实现」的成本压到接近零,把人的精力挤到「定义」和「验收」上。
获取应用
- 项目主页:https://github.com/heibaiao/personal-api-chat-client
- 下载:Releases 里的 PersonalAPIChatClient-V1.0.1-portable-win64.zip(55.9 MB,解压双击 PACC-V1.0.1.exe)
数据全部留在本机,Key 用 PBKDF2-HMAC-SHA256 加密保存,不上传任何服务器
本项目由 heibaiao 使用 DeepSeek Harness 完成主要编码与调试;产品定义、设计取舍与最终验收由作者负责。


评论前必须登录!
注册