 网硕互联帮助中心
本文介绍了知识蒸馏技术,通过大模型指导小模型训练,使小模型在特定场景中表现更佳。文章详细解释了蒸馏的概念、三代演进、LLM蒸馏与传统蒸馏的区别,并提供了实战案例。蒸馏能有效降低推理成本、满足延迟要求、支持边缘部署,是优化AI应用的重要手段。对于想提升模型性能又控制成本的开发者来说,本文提供了宝贵的参考和操作指南。
你有没有想过,为什么 7B 的小模型有时候比 70B 的大模型还好用?
答案是:知识蒸馏。
2015 年,Hinton 提出了蒸馏的概念。10 年过去了,这个技术已经从学术论文走进了生产环境。今天,我会用实战经验告诉你:如何用大模型「教会」小模型,让它在你的场景中表现更好。
什么是模型蒸馏?
一句话定义: 模型蒸馏(Knowledge Distillation)是用大模型(Teacher)的输出指导小模型(Student)训练的过程。
类比理解
想象一个老师傅带徒弟:
-
传统训练:
徒弟只看标准答案(ground truth),自己摸索
-
蒸馏训练:
徒弟不仅看答案,还看老师傅的解题思路(soft labels)
老师傅的「思路」包含了更多信息:
- 哪些选项是接近正确的
- 哪些选项完全不靠谱
- 不同答案之间的相对关系
这些信息,就是「知识」。
蒸馏的数学本质
传统训练用 hard labels:
目标分布:[0, 0, 1, 0] (猫的概率是100%)
蒸馏训练用 soft labels(经过温度缩放):
Teacher 输出:[0.05, 0.10, 0.80, 0.05]
(猫80%,狗10%,兔子5%,鸟5%)
Student 学习这个软分布,而不是只学 hard label。
温度参数 T: 控制 soft labels 的「软度」
soft_logits = logits / T
T=1: 原始 logits
T=3: 更平滑的分布
T=5: 非常平滑的分布
为什么需要蒸馏?
3 个核心理由
| GPT-4 | 未公开 | $30/M tokens | – |
| Llama-3-70B | 70B | ¥0.15/千 tokens | – |
| Llama-3-8B | 8B | ¥0.02/千 tokens | – |
| 蒸馏版 8B | 8B | ¥0.02/千 tokens | 质量接近 70B |
70B 模型的首 Token 延迟通常 200-500ms,8B 模型可以降到 50-100ms。对于实时应用(客服、代码补全),这是关键差异。
手机、IoT 设备跑不动 70B,但可以跑 3B-7B 的蒸馏模型。
蒸馏的三代演进
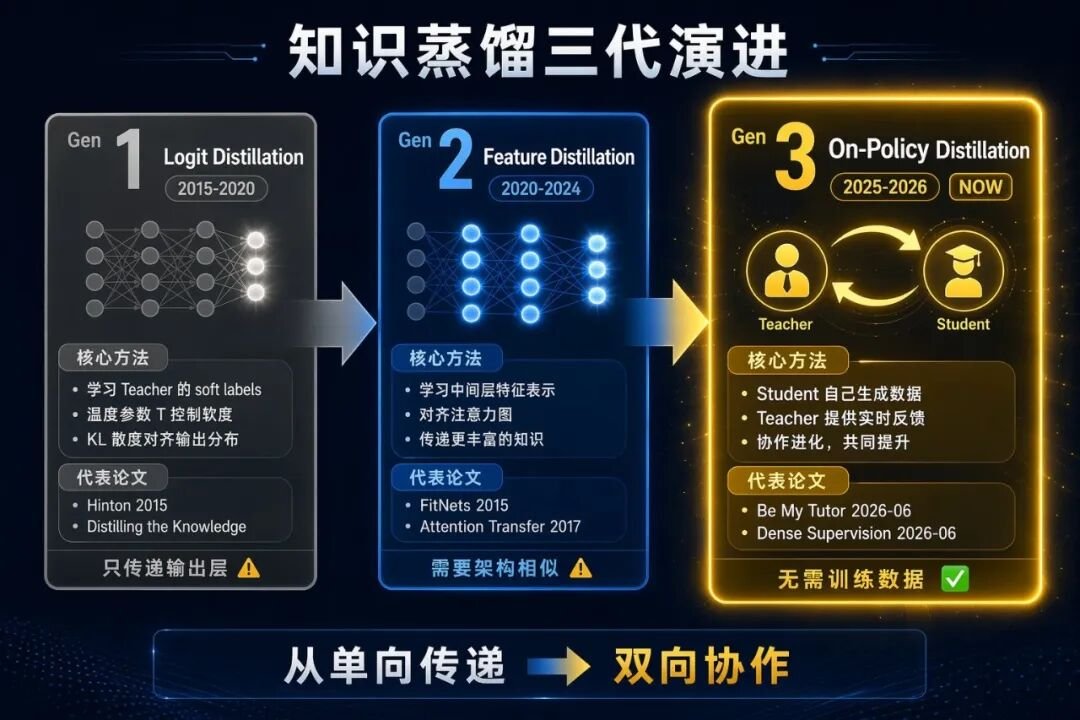
第一代:Logit Distillation(2015-2020)
代表: Hinton 的原始方法
核心: Student 学习 Teacher 的 soft logits
loss = alpha * CE(student_logits, hard_labels) +
(1-alpha) * KL(soft_student, soft_teacher)
局限: 只传递了输出层的知识,忽略了中间层的特征。
第二代:Feature Distillation(2020-2024)
代表: FitNets、Attention Transfer
核心: Student 学习 Teacher 的中间层特征
对齐中间层特征
feature_loss = MSE(student_features, teacher_features)
total_loss = task_loss + lambda * feature_loss
进步: 传递了更丰富的表示知识。
局限: 需要模型架构相似,难以跨架构蒸馏。
第三代:Data-Free & On-Policy Distillation(2025-2026)
代表: Be My Tutor(2026-06)、Dense Supervision(2026-06)
核心: 无需训练数据,或 Student 自己生成数据
突破:
-
Data-Free:
用 GAN 生成训练数据,保护隐私
-
On-Policy:
Student 自己生成样本,Teacher 提供反馈
-
Co-Distillation:
Teacher 和 Student 互相学习,共同提升
2026 年趋势: 蒸馏不再是单向的「教与学」,而是双向的「协作进化」。
LLM 蒸馏 vs 传统蒸馏
大语言模型的蒸馏,和传统 CV/NLP 模型有几个关键差异:
1. 蒸馏目标不同
传统蒸馏:
- 学习分类分布(soft labels)
- 对齐特征表示
LLM 蒸馏:
- 学习生成序列(next token prediction)
- 学习推理能力(chain-of-thought)
- 学习指令遵循(instruction following)
2. 蒸馏方法不同
传统方法:
# Logit distillation
loss = KL(student_logits / T, teacher_logits / T)
LLM 方法:
# Sequence-level distillation
teacher_outputs = teacher.generate(prompt) # 生成完整序列
student_loss = cross_entropy(student, teacher_outputs)
3. 挑战不同
| 数据量 | 小(ImageNet 1M) | 大(万亿 tokens) |
| 生成成本 | 低 | 高(Teacher 推理昂贵) |
| 评估 | 简单(准确率) | 复杂(多维能力) |
实战:用 Llama-3-70B 蒸馏 Llama-3-8B
环境准备
# 安装依赖
pip install transformers accelerate peft
pip install torch –index-url https://download.pytorch.org/whl/cu121
# 下载模型
huggingface-cli download meta-llama/Llama-3-70B-Instruct /
–local-dir ./models/teacher
huggingface-cli download meta-llama/Llama-3-8B-Instruct /
–local-dir ./models/student
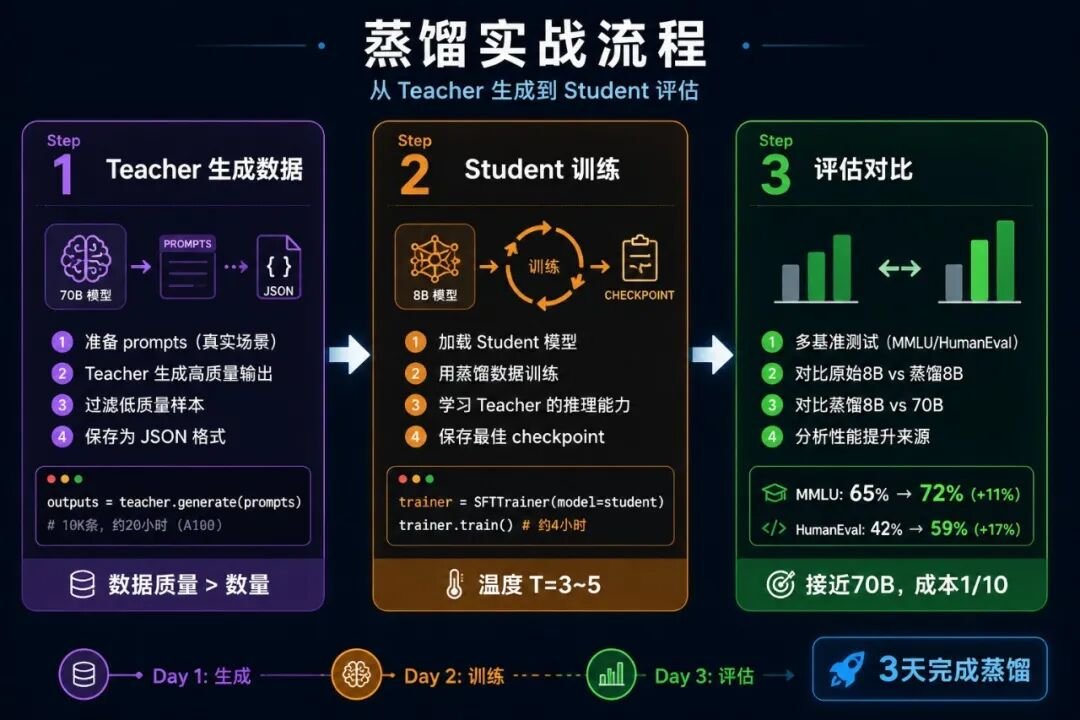
### Step 1:生成蒸馏数据
用 Teacher 模型生成高质量的训练数据:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
import json
# 加载 Teacher
teacher = AutoModelForCausalLM.from_pretrained(
"./models/teacher",
torch_dtype=torch.float16,
device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained("./models/teacher")
# 准备 prompts
prompts = [
"解释什么是注意力机制",
"用Python写一个快速排序算法",
"分析这段代码的时间复杂度…",
# … 更多 prompts
]
# 生成 Teacher 输出
distillation_data = []
for prompt in prompts:
inputs = tokenizer(prompt, return_tensors="pt").to(teacher.device)
with torch.no_grad():
outputs = teacher.generate(
inputs,
max_new_tokens=500,
temperature=0.7,
top_p=0.9
)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
distillation_data.append({
"prompt": prompt,
"response": response[len(prompt):] # 去掉 prompt 部分
})
# 保存
with open("distillation_data.json", "w") as f:
json.dump(distillation_data, f, ensure_ascii=False, indent=2)
踩坑记录:
- 生成 10K 条数据,70B 模型需要约 20 小时(单卡 A100)
- 建议用 vLLM 加速:pip install vllm,速度提升 5-10 倍
Step 2:训练 Student
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments
from trl import SFTTrainer
import json
# 加载 Student
student = AutoModelForCausalLM.from_pretrained(
"./models/student",
torch_dtype=torch.float16,
device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained("./models/student")
# 加载蒸馏数据
with open("distillation_data.json") as f:
data = json.load(f)
# 格式化数据
def format_example(example):
return f"### Instruction:/n{example['prompt']}/n/n### Response:/n{example['response']}"
train_texts = [format_example(d) for d in data[:8000]]
eval_texts = [format_example(d) for d in data[8000:]]
# 训练配置
training_args = TrainingArguments(
output_dir="./llama-3-8b-distilled",
num_train_epochs=3,
per_device_train_batch_size=4,
gradient_accumulation_steps=4,
learning_rate=2e-5,
fp16=True,
logging_steps=10,
save_strategy="epoch",
eval_strategy="epoch",
save_total_limit=2
)
# 启动训练
trainer = SFTTrainer(
model=student,
args=training_args,
train_dataset=train_texts,
eval_dataset=eval_texts,
tokenizer=tokenizer
)
trainer.train()
Step 3:评估和对比
from transformers import pipeline
# 加载模型
original = pipeline("text-generation", model="./models/student")
distilled = pipeline("text-generation", model="./llama-3-8b-distilled")
# 测试用例
test_prompts = [
"解释什么是Transformer",
"用Python实现二叉树遍历",
"分析这段代码的问题…"
]
# 对比输出
for prompt in test_prompts:
print(f"/n=== Prompt: {prompt} ===")
print("/n原始 8B:")
print(original(prompt, max_new_tokens=200)[0]['generated_text'])
print("/n蒸馏 8B:")
print(distilled(prompt, max_new_tokens=200)[0]['generated_text'])
性能对比
| MMLU 准确率 | 65.2% | 71.8% | 73.5% |
| 代码生成(HumanEval) | 42.1% | 58.7% | 62.3% |
| 数学推理(GSM8K) | 38.5% | 52.1% | 56.8% |
| 推理延迟 | 85ms | 85ms | 320ms |
| 显存占用 | 16GB | 16GB | 140GB |
关键发现: 蒸馏后的 8B 模型,在多个基准上接近 70B 的性能,但推理成本只有 1/8。
高级技巧:On-Policy Distillation
传统的蒸馏是 Off-Policy:Teacher 生成数据,Student 学习。
2026 年的新方法是 On-Policy:Student 自己生成数据,Teacher 提供反馈。
工作流程
student_output = student.generate(prompt)
score = teacher.evaluate(student_output)
if score > threshold:
reinforce(student, student_output)
else:
correct(student, teacher_output)
代码实现
from trl import PPOTrainer, PPOConfig
# 配置
config = PPOConfig(
model_name="./models/student",
learning_rate=1e-5
)
# 定义奖励函数(用 Teacher 打分)
def reward_fn(student_output):
# Teacher 评估 Student 的输出质量
score = teacher.evaluate(student_output)
return score
# On-Policy 训练
trainer = PPOTrainer(
config=config,
model=student,
reward_fn=reward_fn
)
trainer.train()
优势:
- Student 学习自己生成的分布,而不是 Teacher 的分布
- 避免了 distribution mismatch 问题
- 2026 年论文显示,On-Policy 比 Off-Policy 提升 5-10%
蒸馏踩坑记录
坑 1:温度参数选择不当
症状: 蒸馏后模型性能没有提升
原因: 温度 T 太小,soft labels 太「硬」,信息量不够
解决:
# 尝试不同的温度
for T in [2, 3, 5, 7]:
soft_logits = logits / T
# 训练并评估
经验值: T=3 到 T=5 通常效果最好。
坑 2:数据分布偏差
症状: 蒸馏数据质量好,但 Student 在真实场景表现差
原因: Teacher 生成的数据和实际使用场景不匹配
解决:
- 收集真实场景的 prompts
- 用真实 prompts 生成蒸馏数据
- 混合 50% 真实数据 + 50% 生成数据
坑 3:过拟合 Teacher
症状: Student 在蒸馏数据上表现好,但泛化能力差
原因: Student 过度模仿 Teacher,失去了自己的「思考方式」
解决:
# 降低蒸馏权重
alpha = 0.5 # 从 0.8 降到 0.5
loss = alpha * distillation_loss + (1-alpha) * task_loss
坑 4:Teacher 本身有错误
症状: Student 学会了 Teacher 的错误
原因: Teacher 在某些场景下会生成错误输出
解决:
- 过滤低质量的 Teacher 输出
- 人工审核蒸馏数据
- 用多个 Teacher 投票
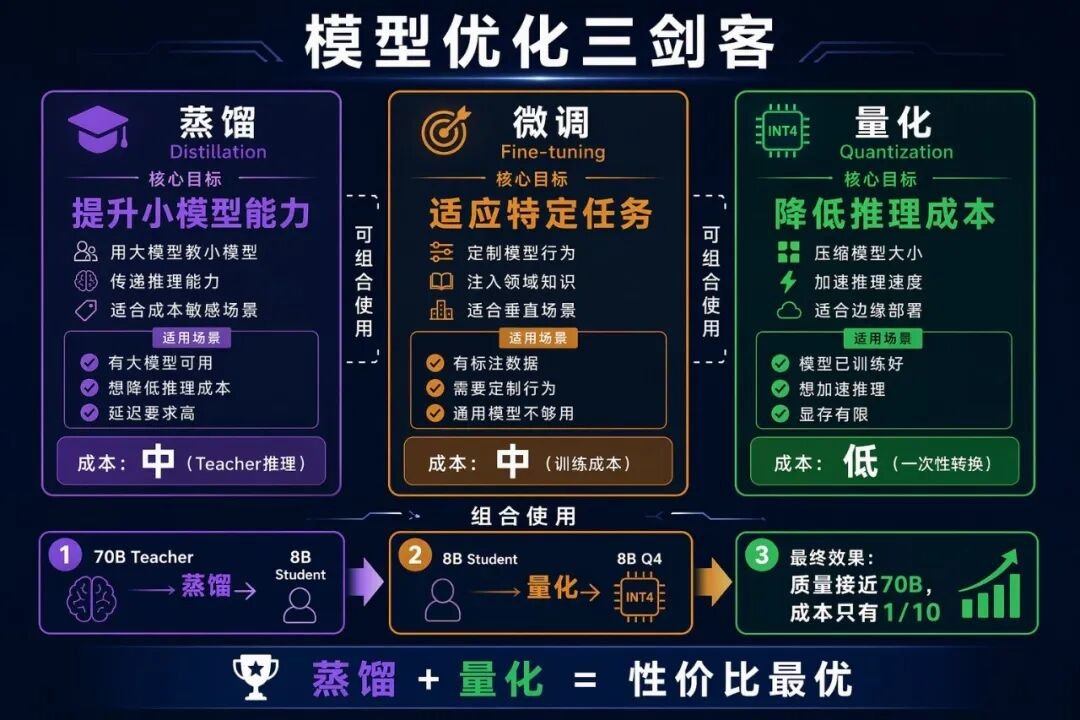
蒸馏 vs 微调 vs 量化
三种模型优化方法,如何选择?
对比总结
| 蒸馏 | 提升小模型能力 | 有大模型可用,想降低成本 | 中(需要 Teacher 推理) |
| 微调 | 适应特定任务 | 需要定制行为,有标注数据 | 中(训练成本) |
| 量化 | 降低推理成本 | 模型已训练好,想加速 | 低(一次性转换) |
组合使用
最佳实践: 蒸馏 + 量化
70B Teacher
↓ 蒸馏
8B Student(质量接近70B)
↓ 量化(Q4_K_M)
8B Q4(约5GB,可单卡部署)
效果:
- 质量:接近 70B
- 成本:只有 70B 的 1/10
- 部署:单卡 RTX 4090 可跑
对技术负责人的建议
1. 先评估是否需要蒸馏
问自己:
- 70B 模型的推理成本是否过高?
- 延迟是否不满足需求?
- 是否需要在边缘设备部署?
如果答案是「是」,考虑蒸馏。
2. 选择合适的 Teacher
原则:
- Teacher 不必是最大的模型,而是在你的场景表现最好的
- 可以用 GPT-4 API 作为 Teacher(成本可控)
- 多个小 Teacher 投票,效果可能优于单个大 Teacher
3. 数据质量是关键
经验:
- 1000 条高质量蒸馏数据 > 10000 条低质量数据
- 蒸馏数据要覆盖真实场景
- 人工审核前 100 条,确保质量
4. 持续迭代
流程:
部署 → 收集用户反馈 → 筛选高质量样本 → 重新蒸馏 → 更新模型
每月迭代一次,持续提升。
总结
模型蒸馏的本质,是「站在巨人的肩膀上」。
核心要点:
Logit → Feature → On-Policy
序列级蒸馏 + 推理能力传递
Teacher 生成数据 → Student 学习 → 评估对比
On-Policy 蒸馏,避免分布偏差
蒸馏 + 量化,性价比最优
2026 年,蒸馏技术已经从「压缩模型」进化到「协作进化」。Be My Tutor 论文展示了 Teacher 和 Student 互相学习的可能性。
对于技术负责人来说,蒸馏不是「要不要做」的问题,而是「怎么做得更聪明」的问题。
从今天开始,用大模型「教会」你的小模型吧。=
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
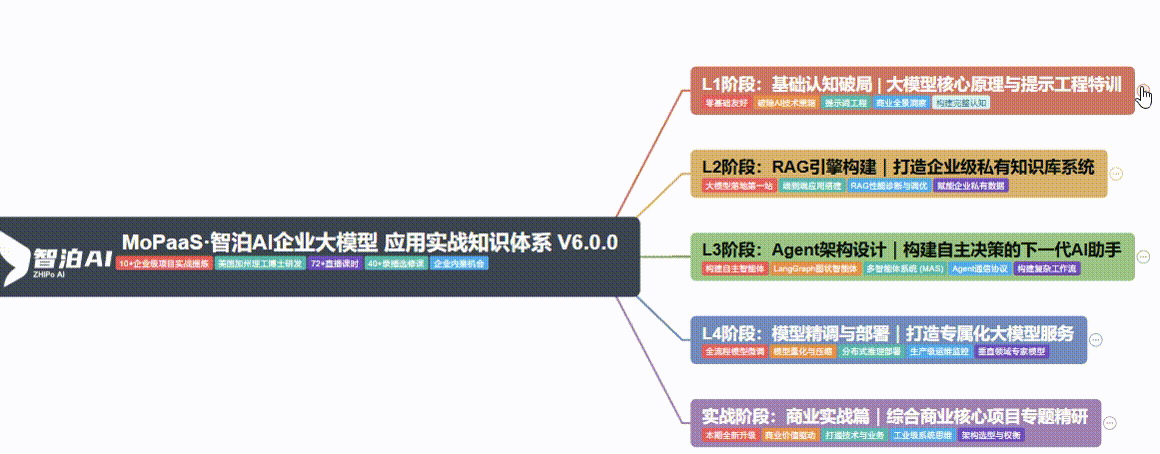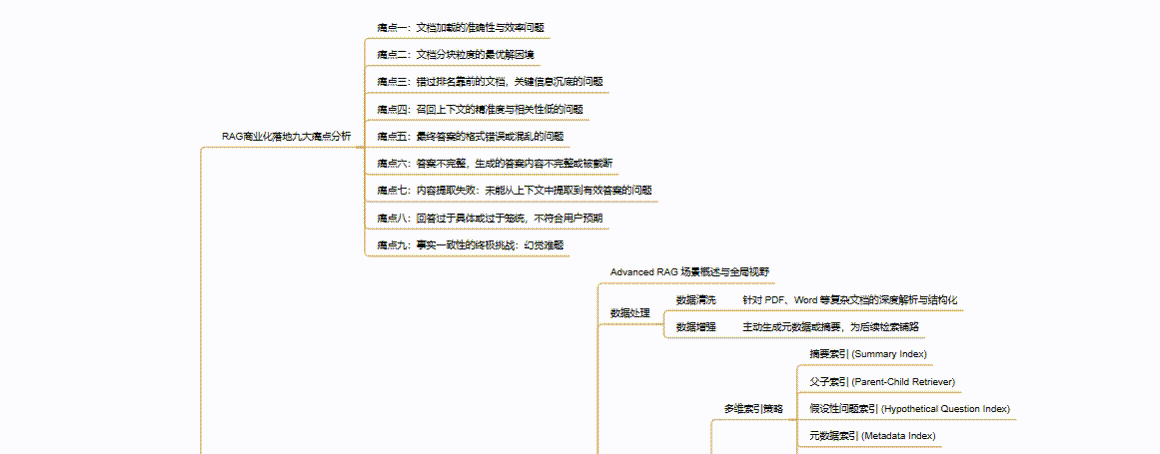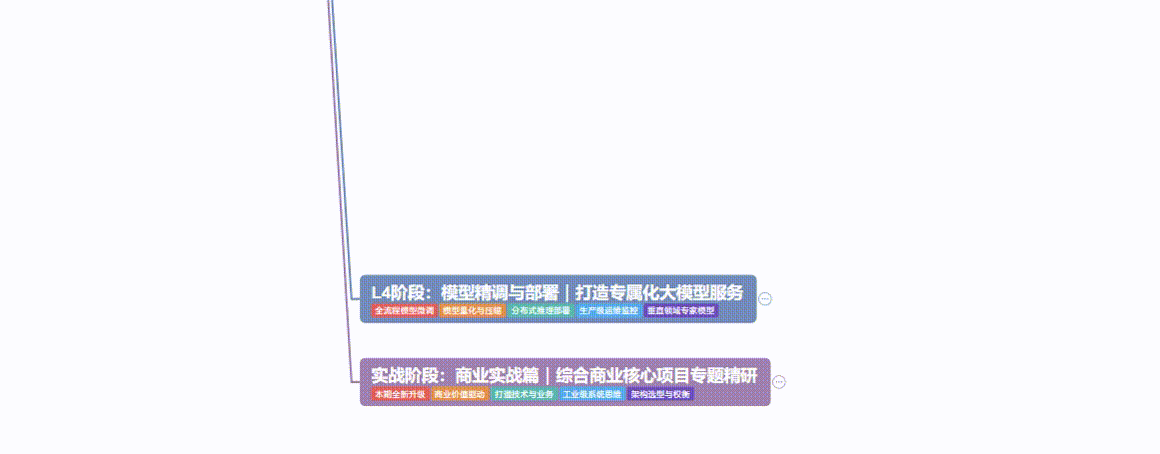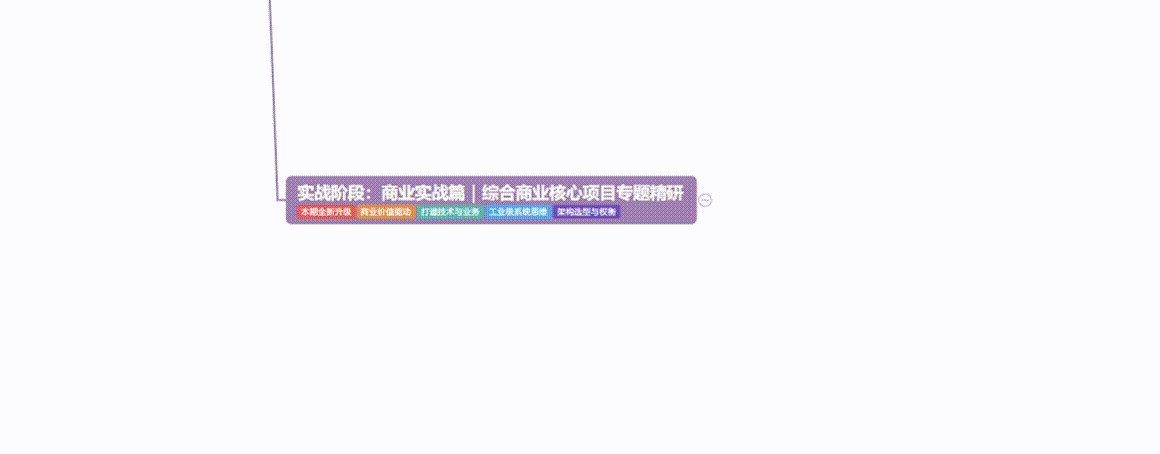
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
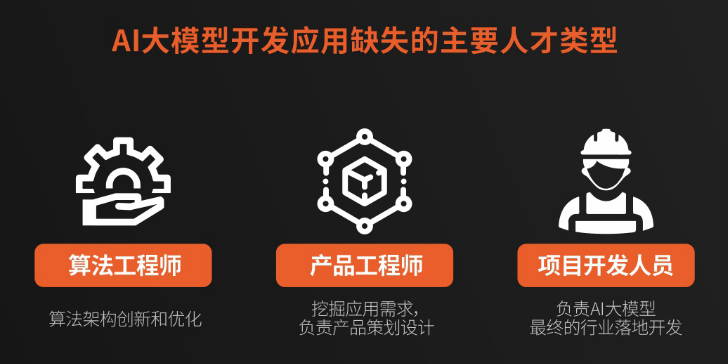
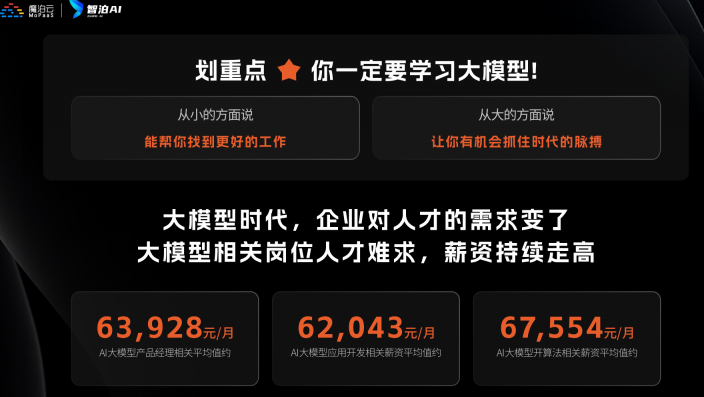
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
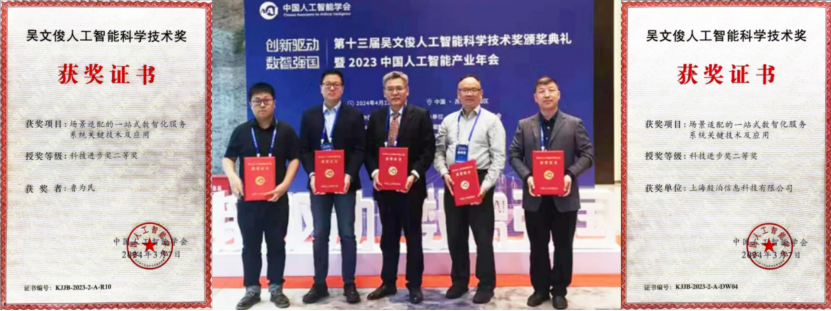
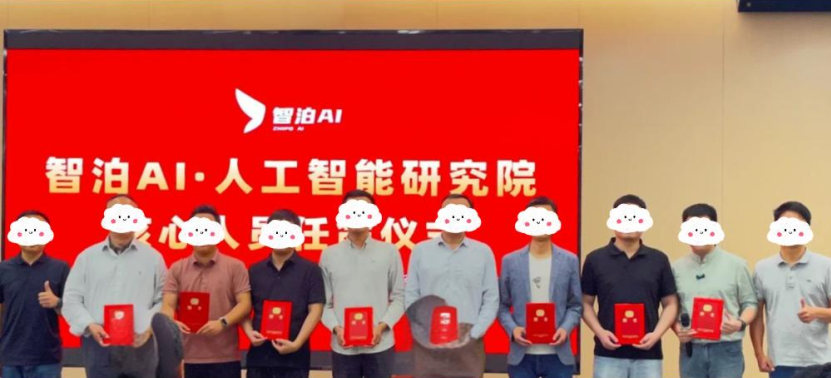
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


评论前必须登录!
注册